先交代下背景。
上个月我旁听一个客户的数据替换评审会。方案聊到一半,他们 DBA 突然抬头问:割接那天业务一分钟都不能断,你们打算怎么办?
一屋子人都不说话了。我当时坐在角落记笔记,能明显感觉到气氛变了。
前面俩小时聊的兼容性、SQL 改写、存储过程迁移率,那一瞬间基本清零。这种项目最后能不能落地,说白了看的就是同步工具。数据集成软件这东西,就是把新旧两套系统缝起来的那根线。线不结实,前面缝得再好看,也白搭。
所以这几天我把 KFS(Kingbase FlySync)的官方资料翻了个遍,白皮书、FAQ 手册、产品彩页,还有一份 89 页的技术胶片。挑值得记的写一写。判断是我自己的,你参考着看。
一、坑一般不在数据库,在管道
我见过一份迁移方案,兼容性评估的附录比正文还厚,翻到停机窗口那页,就剩一行字------采用数据同步工具进行增量同步。
坑就埋在这一行里。
传统 ETL 那套打法,我是亲眼见过的。批量抽数,定时任务,一小时一轮,或者干脆 T+1。跑报表还行。核心交易系统用它?露馅是迟早的事。
现场什么样子呢。业务方想看昨天的数,同步任务得等到夜里跑完------等着吧。两边数据对不上,三天查不清哪边是错的。抽取高峰期没人敢开,怕把生产库压垮。白皮书里列的痛点,我能一条条对上真实场景。
还有一笔账,很少有人算:脚本是人在维护的。改一张表,动一堆配置。维护的人一离职,那堆东西就成了没人敢碰的祖传代码。
国产化又加了一层。哪家单位敢一夜之间把 Oracle 拔了?没有。都是新旧并轨跑一段,稳了再切。那两套库之间的数据就得时刻对齐,还得随时退得回去。
这个能力,数据库自己给不了。
二、骨架其实很朴素
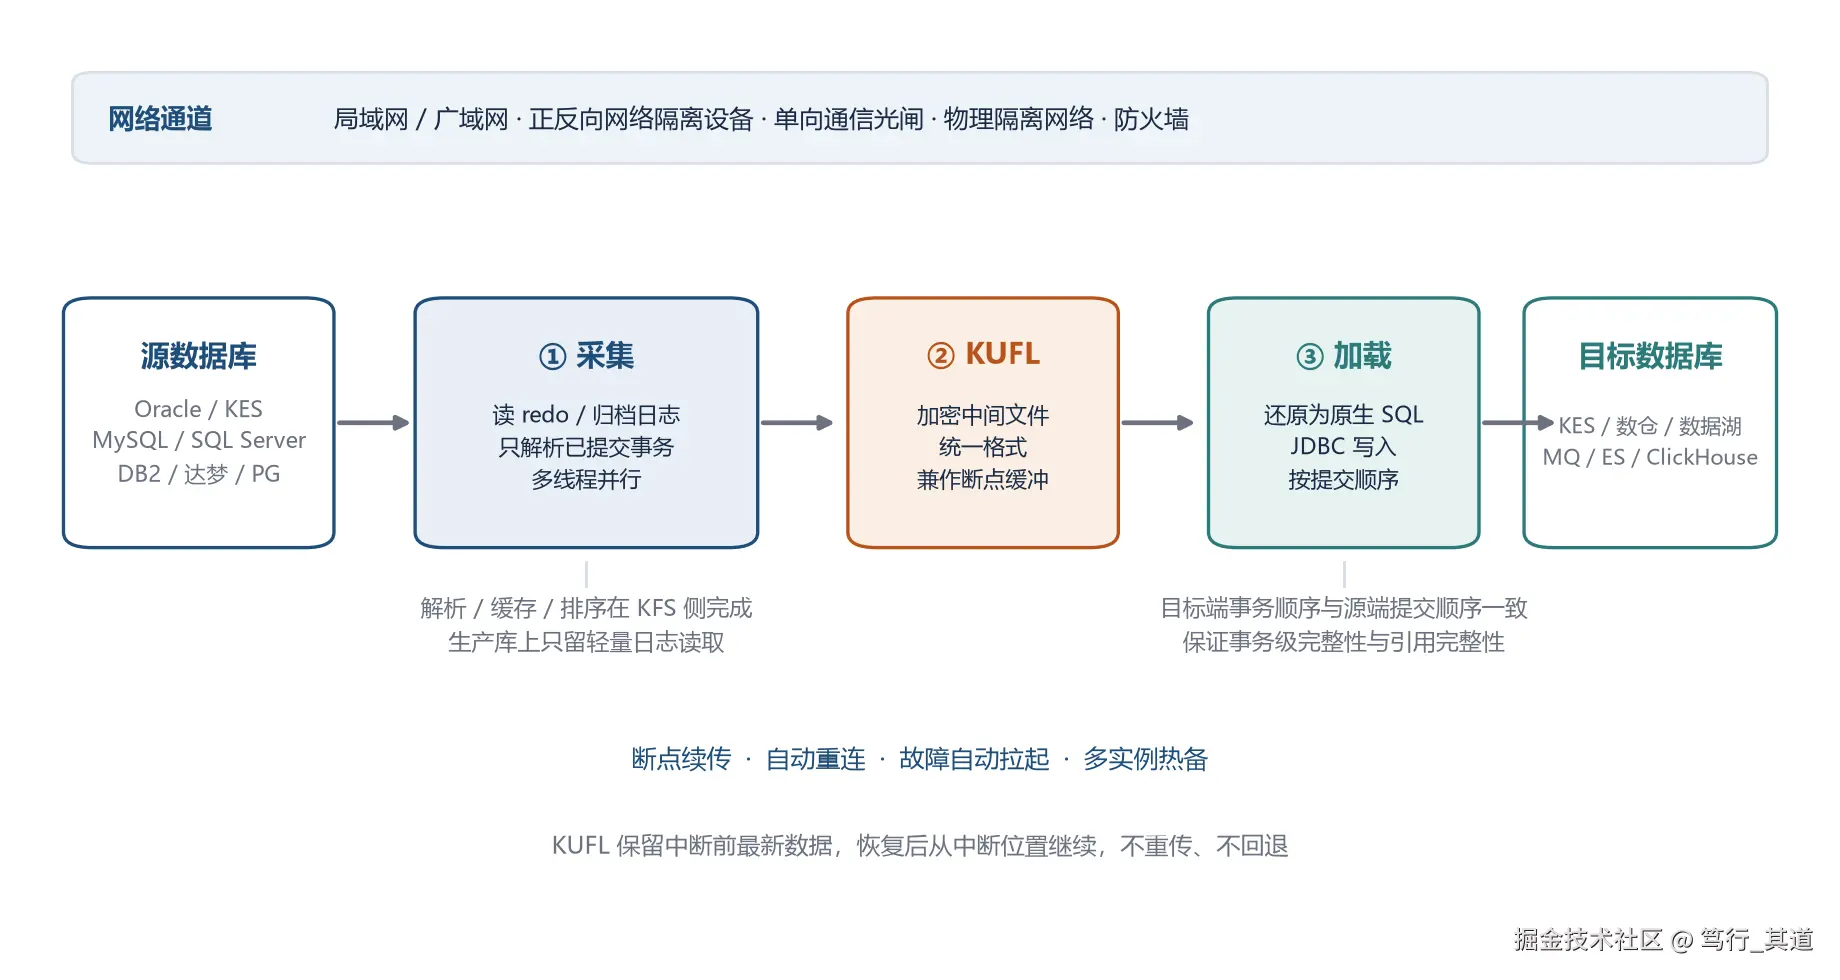
KFS 的原理,官方材料画了不少图。我盯着看了半天,拆开就三件事:采集,跟踪文件,加载。
采集模块装在源库边上,直接读 redo 日志,把增删改的结果捞出来。有个细节我挺喜欢------只解析已提交的事务。回滚的、跑到一半的,直接跳过。开销小,也不会把半截事务搬过去。
捞出来的数据不直接外发,先写进一个中间文件,叫 KUFL。加密存储。它干两件事:把各家数据库日志格式的差异抹平,顺便当缓冲区。源端断了?目标端断了?KUFL 里留着的就是断点前最新的数据。恢复以后接着走,不用重来。
加载这步,从 KUFL 读变更,翻成目标库认得的原生 SQL,走 JDBC 写进去。顺序有讲究------严格按事务在源库的提交顺序来,连事务环境一起还原。目标端的事务一致性和引用完整性,全指着这个。
三段,一条链。没有中间库,没有额外的表,采集也不需要在源库上开什么查询接口。
三、把计算搬出生产库
在我看来,这是 KFS 真正拉开差距的地方。
增量数据怎么拿?老办法是靠数据库厂商给的接口,Oracle 的 LogMiner,SQL Server 的 CDC。量小的时候没问题。量一大就露怯了------解析在生产库那台机器上跑,缓存、排序、计算全压在那儿。解析速度上不去,资源吃得还凶,业务跟着遭殃。
KFS 的思路是把解析、缓存、排序全挪到自己这边,生产库上只留一个轻量的日志读取。故障域也就分开了------同步程序挂了,生产库该跑还跑。
有个医院的例子。某市中心医院做集成平台迁移,现场记录是这么写的:X86 64 核 2.1GHz、96GB 内存的机器,KFS 单核占用不到 70%,内存稳定在 1.8 到 1.9GB 之间。
中汇亿达的项目说得更直白。增量解析只读归档文件,跟生产库没有进程级耦合,KFS 挂了不影响生产库。IO 占用极少,CPU 和内存几乎可以忽略。
这种话,我一开始是不太信的。
直到看见他们拿这套东西扛跑批。每天早上六点到七点,一个钟头 350GB 以上的批量业务,客户要求跑批结束后一个钟头内必须追平。这个量还敢说低侵入,就不是话术了。
四、几个数字
官方测试环境:6 核 6 线程 2.8GHz,16GB 内存,512GB SSD,千兆网。不算什么好机器。
Oracle 源端解析 118MB/s。KingbaseES 101MB/s。目标端加载 240MB/s 往上。端到端延时 40ms。
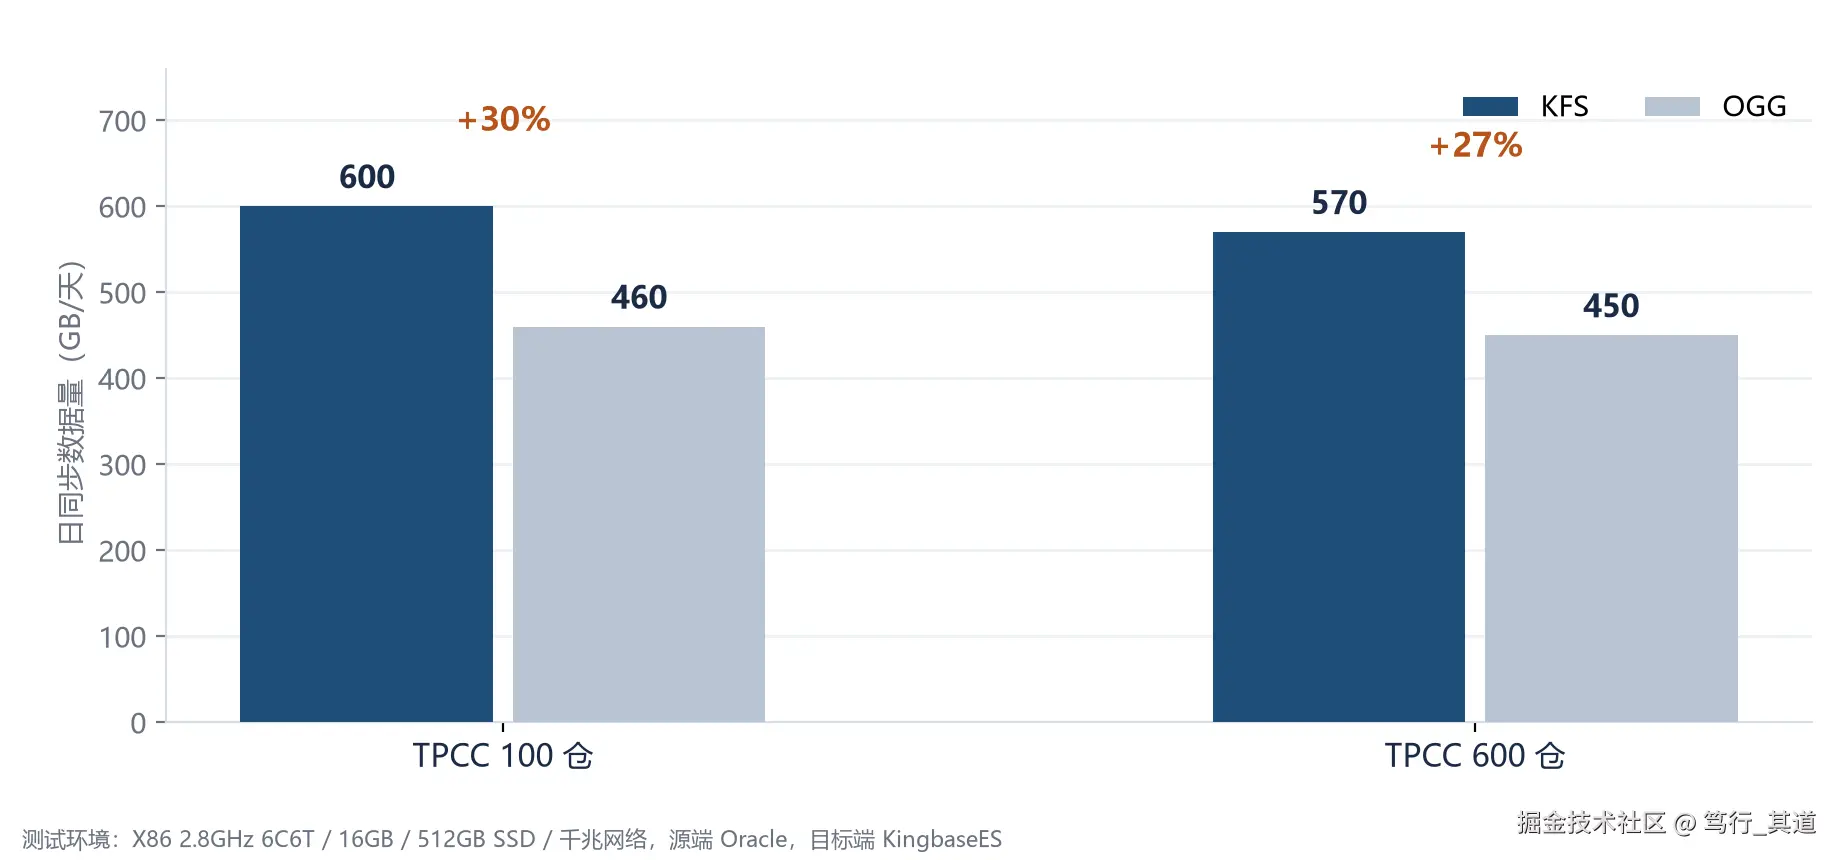
TPCC 模型,100 仓,KFS 一天能同步 600GB 往上,OGG 是 460GB 往上。600 仓呢,570 对 450。差了大概三成。彩页里那句高于业界同类产品 30%,跟这组数能对上。
跑批是另一套打法。大事务切片,化整为零,内存占用就下来了。智能过滤在日志解析动作启动之前,就把不要的数据筛掉,不做无用功。入库走分区索引多通道并发。中汇亿达最后跑出来,7 点跑批结束,7 点 05 分之前追平,延迟压在 5 分钟内,源端解析 90MB/s 往上。
当然,数字都有前提。机器一换、模型一换,全变。但对着 OGG 那组看,我觉得有点参考价值。
五、迁移方案换了三代
胶片里这部分讲得最细。我认为比性能数字有用,选型的人应该多看看。
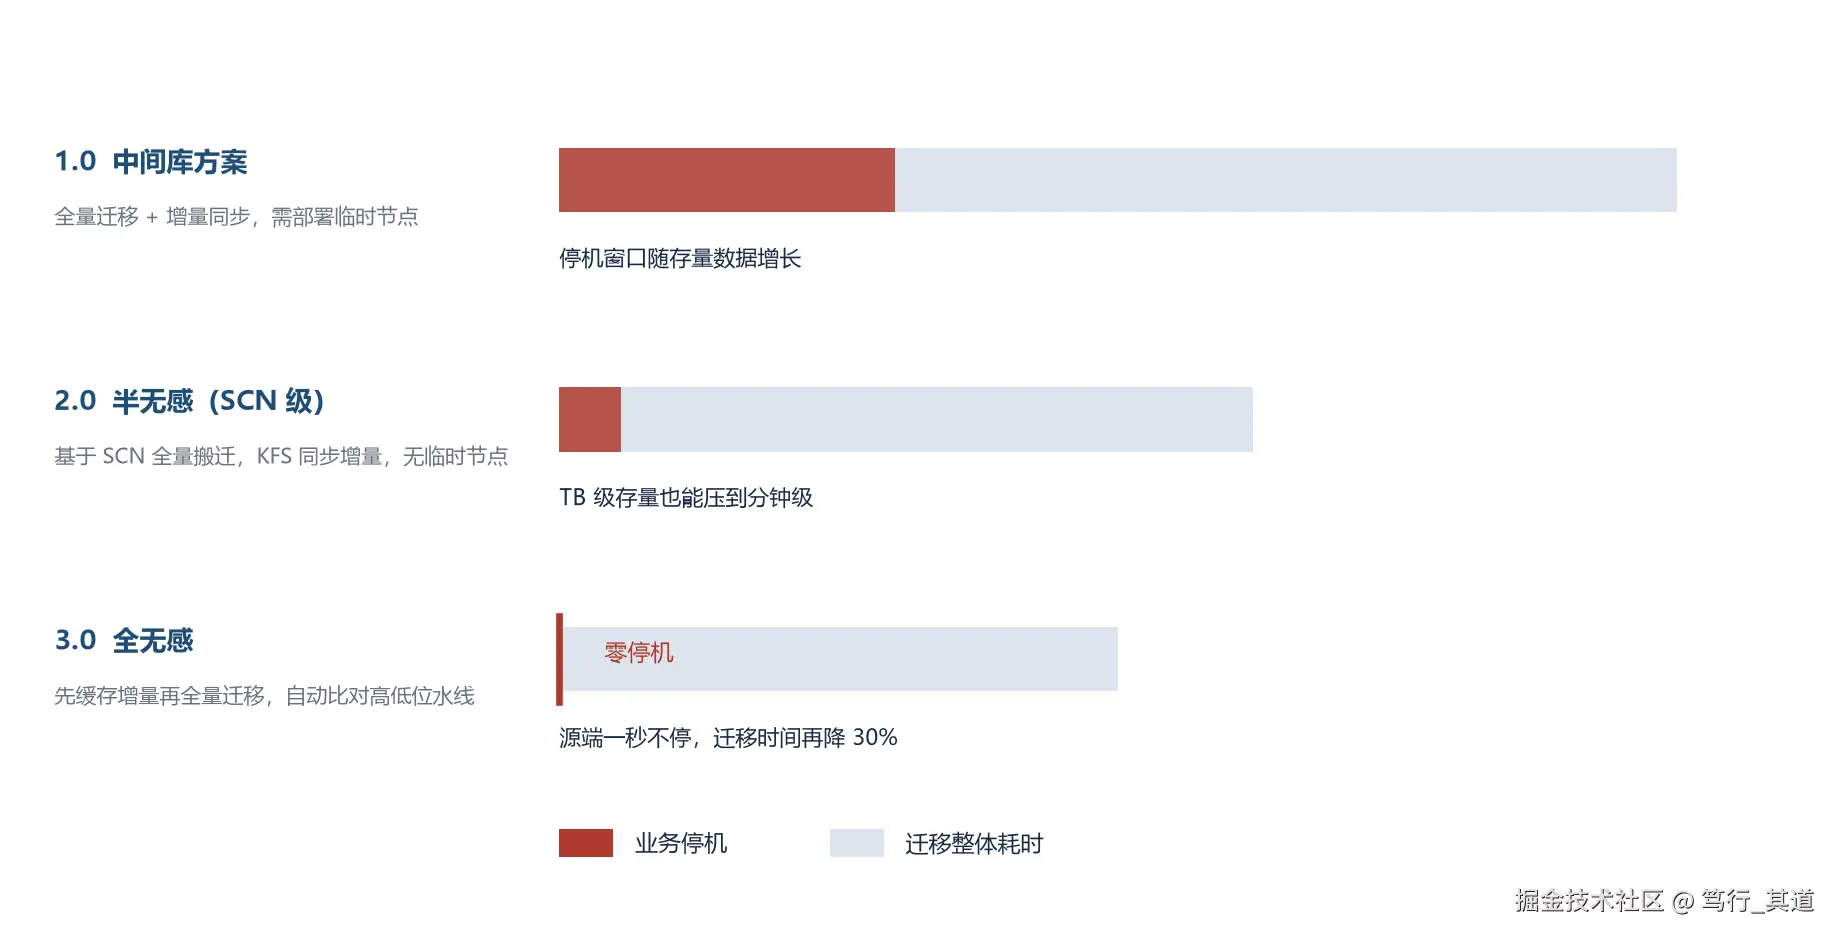
1.0,中间库方案。全量迁移加增量同步,要部署临时节点,得短暂停机。实现简单,改造少,代价是停机躲不掉。
2.0,半无感,做到 SCN 级。基于 SCN 全量搬迁,KFS 同步增量,临时节点不要了,对源端侵扰小。停机时间跟存量数据大小基本脱钩,TB 级也能压到分钟级。
3.0,全无感。顺序倒过来------先解析缓存增量,再做全量迁移,完了自动比对高低位水线,把缓存期间的变更补进去。源端一秒不停。备份还原省了,临时节点省了,硬件预算跟着省一笔。官方说迁移时间比旧方案短 30%。
三代的逻辑其实就一句话:把停机从迁移流程里一点点挤出去。1.0 挤不掉,2.0 压到分钟级,3.0 归零。
六、后悔药
国产化替换最怕什么?不是迁移失败。是迁完之后,某个业务模块在特定场景下出了问题,回不去。
双轨并行,说白了就是买一颗后悔药。
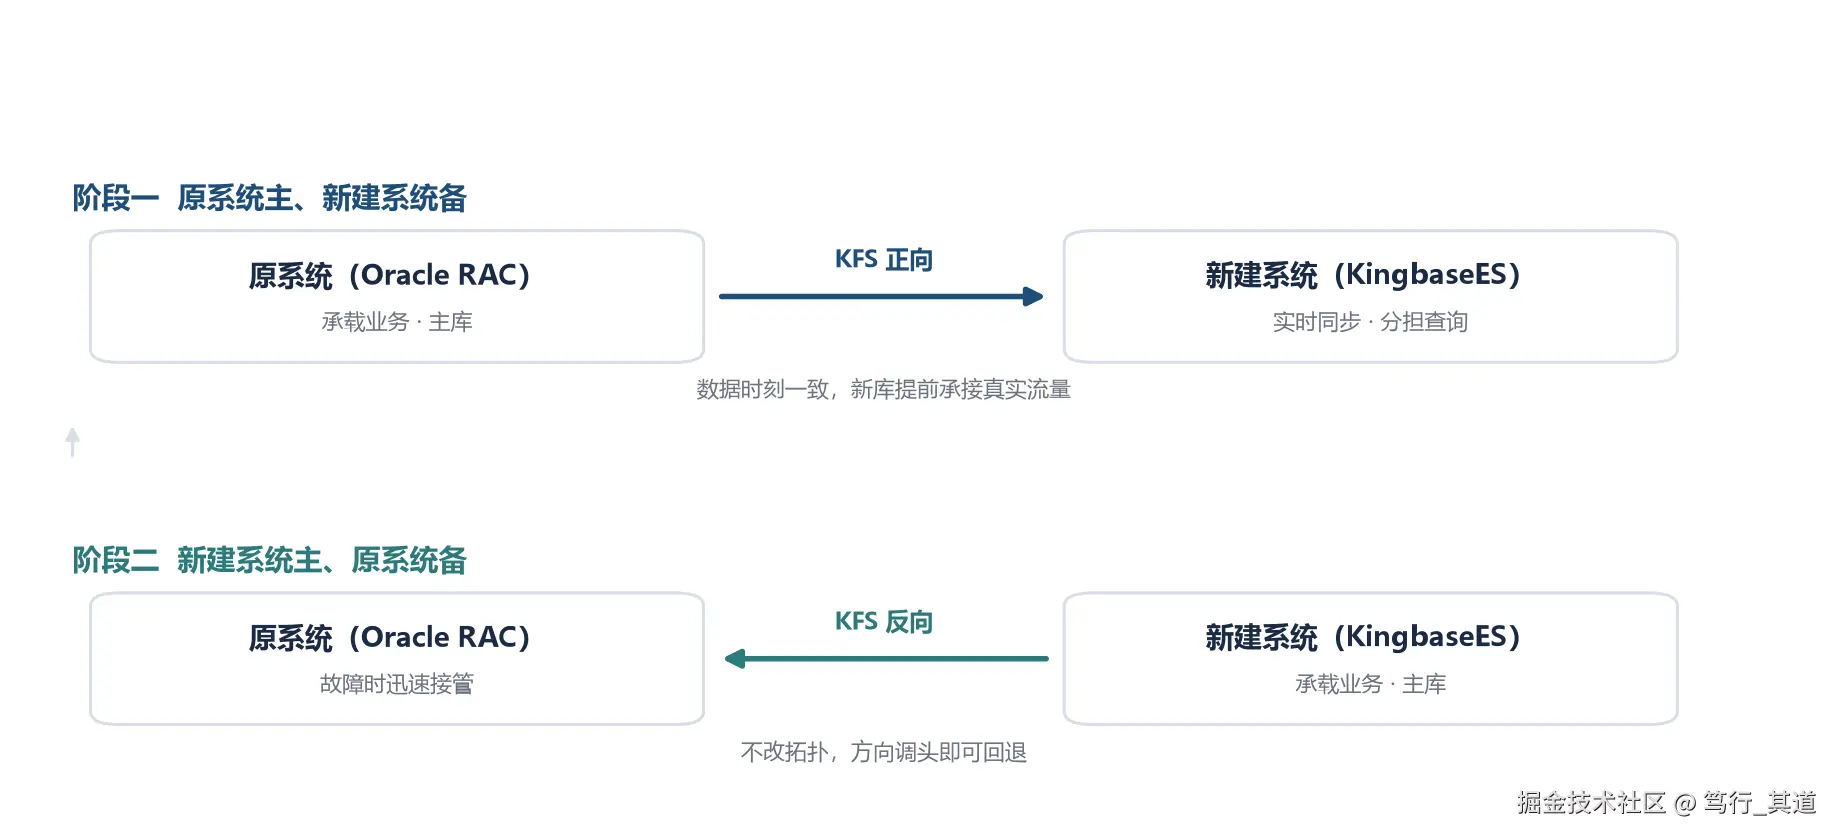
第一阶段,原系统当主库,对外承载业务。KingbaseES 当备库,KFS 把原库存量和增量实时同步过去,两边数据保持一致。备库不是干放着,可以分担查询,让新库提前接真实流量。
跑顺了,进第二阶段。拓扑不动,KingbaseES 切成主系统,原库退成备。KFS 反向同步,方向调个头就行。国产环境出了故障,原系统立刻接管。验证得差不多了,再决定老系统什么时候下线。
中汇亿达那个案子值得单独讲。六个业务模块,CMS、IMS、QTS、FIS、XMS、RMS,跑在四套 Oracle 19c RAC 上。存量 1.5T 到 3.5T 不等,日增全在 500GB 以上。
他们没一把全切。分四个阶段:先全按 Oracle 到 KES 的方向同步;然后切两个模块到 KES 上线,方向反转,剩下四个继续正向;再切两个;最后全切。每一步都可观察、可验证、可回退。
比一次性割接稳妥多了。也更符合实际项目里人的心理承受能力。
七、一致性
同步工具最怕的不是慢。是悄悄错了。
KFS 在链路上做了三道检查。源端事务的执行顺序,就是目标端的加载顺序。日志解析和目标端同步之间,有日志序号校验。持久化 I/O 的顺序被严格控制。三道凑齐,才谈得上事务级完整。
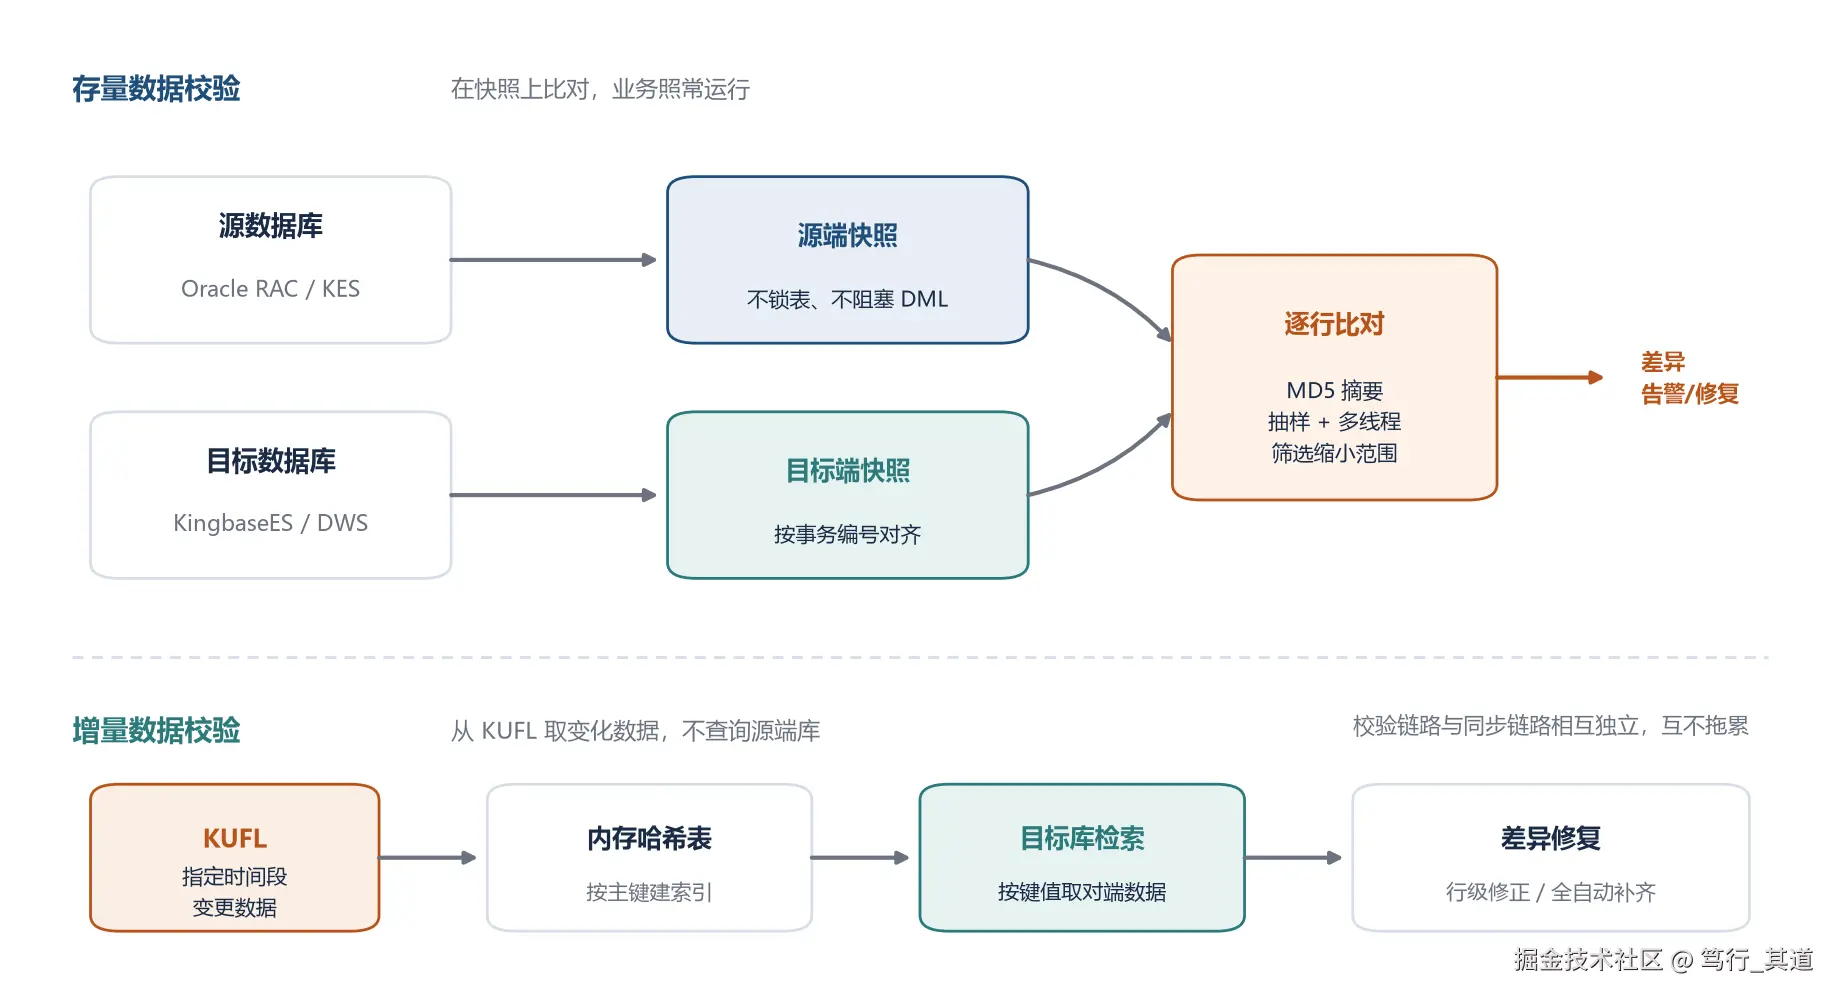
校验这块,是它跟同行拉开的一个差异点。市面上不少产品,数据比对是单独卖钱的。OGG 的 Veridata 就是独立收费组件。KFS 把校验模块直接内置了。
技术上有两个细节挺有意思。
存量校验,走源端和目标端的数据快照,在快照上比,业务照跑不误。
增量校验更巧。不查源端库。从 KUFL 里把指定时间段的变化数据捞出来,放内存哈希表,再按主键去目标库检索比对。不碰源端,业务没影响,源系统资源也不占。校验链路和同步链路分开,各跑各的,互不拖累。
落地数字记几个。301 医院数据汇聚项目,存量 5T 以上,日增 300G 以上。校验速率 98MB/s,准确性 100%。校验的时候业务机 CPU 负载增加不到 3%,内存不到 4GB。
人民银行征信中心融资服务平台,存量 4T 以上,日增 50G 以上。改造前全量校验,6 个小时往上。改成增量校验,10 分钟以内。
中汇亿达那边,每秒 25 万行。2T 数据,一个小时比完。
差异处理也不是只有报警一条路。邮件、短信、微信钉钉通知,都行。可以人工挑表,做记录级修正。也可以开全自动修复,比出来的差异自己补齐。环境不允许装图形化工具的,还留了一套命令行兜底。
八、数据源和网络
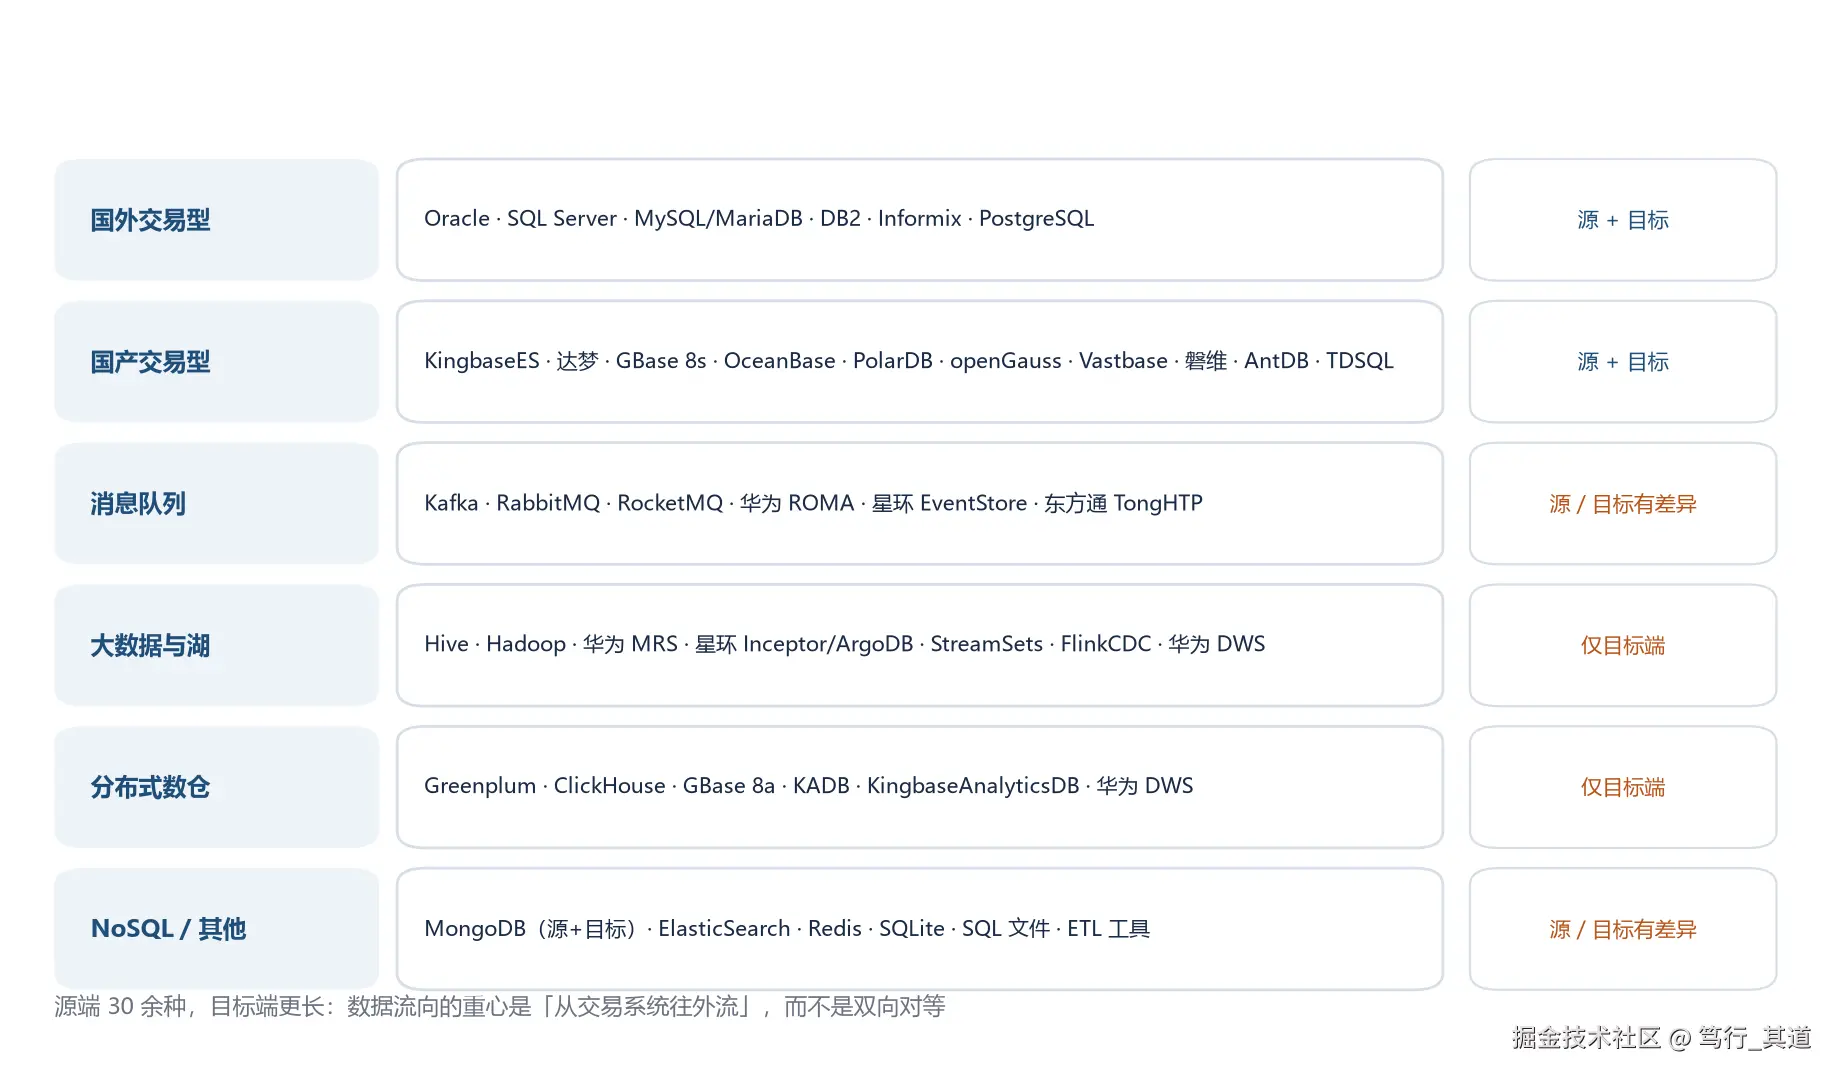
源端这边,Oracle、SQL Server、MySQL 和 MariaDB、PostgreSQL、DB2、Informix 都支持。国产的 KingbaseES、达梦、GBase 8s、OceanBase、PolarDB、openGauss、Vastbase、磐维、AntDB 也在。常见的 RDS,加上 Kafka、RabbitMQ、RocketMQ 三个消息队列。
目标端名单更长。数仓多了 Greenplum、ClickHouse、GBase 8a、华为 DWS、KingbaseAnalyticsDB。大数据多了 Hive、Hadoop、华为 MRS、星环 Inceptor/ArgoDB、StreamSets、FlinkCDC。还有 ElasticSearch、MongoDB,以及 SQL 文件和 ETL 工具。
源端短,目标端长。这个形状挺有意思------设计重心是让数据从交易系统往外流,不是双向对等。做汇聚、做入湖、做实时数仓,正好对得上。
网络这部分我挺意外。除了局域网广域网,正反向网络隔离设备、单向通信光闸、物理隔离网络、防火墙,都能跨。广域网传输做了 4 倍压缩,2M 带宽就能跑实时容灾。
人行征信那个项目,跨 1000 公里双中心双活,延迟 1 秒以内。安徽省发改委的公共资源交易平台,从合肥中心向 16 个地市一对多分发。地市侧带宽,也就是 2M 这个量级。
九、运维
同步软件装上去只是开始。成本在后面几年。
KFS 配了套 KFSMC 的图形化管理平台。按链路、按节点看同步数据量、延迟、速率。表级的同步操作分析和性能耗时分析也有。哪条链路慢,慢在解析还是慢在入库,看得出来。安装部署、启停、告警、补丁升级,都在这个界面里。
高可用靠两个组件,KFS-HA 和 replicator。一个 HA 实例,可以盯单个 replicator,也可以盯整条链路。切换时间看监听超时怎么配,实测秒级,一般 10 秒内。加上断点续传、自动重连、故障自动拉起。服务器故障、数据库故障、同步程序故障、网络故障,四类场景都有对应动作。
十、不好听的也说两句
翻完材料,我留了几个疑问。或者说,边界。
KFS 本体做的是搬,不是洗。轻量转换是支持的------大小写,模式表列名映射,行级过滤,DDL 改写。够用。但复杂的多源关联、聚合、脱敏,得靠外部 ETL,或者它的 Ultra 版本。别指望一个同步工具连数据治理的活都干了。
无主键表是个坎。中汇亿达 5000 多张表,1200 多张没主键,直接拖累入库效率。他们的解法是把其中 55 张拆出来走 T+1 定时同步------含大对象的,或者日更新删除超 10 万条的。剩下 1100 多张继续实时。注意,这是工程折中,不是产品功能。你库里无主键表占比要是偏高,这笔账得提前算。
双向同步也不是开箱即用。冲突检测有策略可选。按值大小,按最后修改时间,按作用范围。自动忽略、执行 UPDATE、只记日志,都行。但策略得人来定。定错了,就是数据错乱,还很难查。
最后,那些数字都有前提。6C6T,千兆网,特定业务模型。真上生产,网络抖动、大事务、DDL 变更叠在一起,能跑到标称值的六七成,就算不错了。
十一、收尾
翻资料的时候看到两个数。这套产品规模化交付 5000 多套,服务过 500 多家客户。人民银行征信中心、国家外汇交易中心、解放军总医院、国家电网、南方电网、三大运营商、中石化、中海油、一汽,都在名单里。光 2024 年,上半年 17 个行业核心系统上线,下半年又有 19 个。
国产化这件事,前几年比的是数据库本身替不替得动。现在比的越来越是周边------迁移工具,同步工具,运维平台,生态适配。数据库换了,管道没换,数据流不动,等于白换。
KFS 的位置,我觉得是清楚的。它不是最全能的数据集成软件。但在异构库之间把增量稳稳搬过去这件事上,做得足够扎实。选型的时候,你的核心诉求要是停机窗口、数据一致性、可控的回退路径,它值得进短名单。