前几天我的自动发片脚本突然开始"无故死亡":跑起来一行输出都没有,几秒到几分钟后进程被 SIGTERM,退出码 1。第一反应是沙箱又在乱杀进程,第二反应是 shell 环境坏了。查了两轮才发现,两件事都不是------它只是慢,慢到被前台超时按掉了。真正的凶手是一行看起来很无害的循环调用:dedup_check() 里每次都重新扫一遍已发布库。
这篇文章把这条例路径摊开:怎么从"看着像环境问题"走到"这就是 O(N×M) 次外部进程调用",以及最后把它压到一轮探测的三步改法。
表象 无输出被杀 看着像沙箱
现象本身极具误导性。脚本没有任何 stdout,没有异常栈,没有 Python traceback,只有一条被信号杀掉的退出码。这种"干净的死"在经验上指向三种原因:解释器起不来、编码炸在 import、或者被外部信号终止。
我先排查了后两种:单独跑 python -c "import daily_publish" 正常;把脚本缩成只剩三行打印,也能正常输出。于是问题被定位到"执行到某一阶段之后"------而不是启动阶段。这一步很关键:没有输出不等于什么都没做,也可能是一直在做但一次都没打印。
把调用次数数清楚 问题就露出来了
顺着选片逻辑往下读,调用链是这样的:
python
def select_next():
    files = [f for f in glob.glob(os.path.join(DOWNLOADS, "*.mp4"))
             if os.path.dirname(f) == DOWNLOADS]
    files.sort(key=ctime_of)
    chosen = files[0]
    dup, reason = dedup_check(chosen)     # 只判一条
    ...

def dedup_check(video):
    size = os.path.getsize(video)
    dur = video_duration(video)           # 起一次 ffprobe
    ledger = load_ledger()
    if dur:
        for path, s, d in published_lib():   # ← 每次调用都重扫
            if s == size and d and abs(d - dur) < 1.5:
                return True, f"与已发布文件同内容: {path}"
    ...

def published_lib():
    out = []
    for f in glob.glob(os.path.join(PUBLISHED, "*.mp4")):
        out.append((f, os.path.getsize(f), video_duration(f)))  # 每个文件一次 ffprobe
    return out
published_lib() 没有缓存,dedup_check() 每次都调它。于是单次判定的成本 = 已发布库文件数 × 一次 ffprobe 子进程。当时的批量扫描脚本对每个 候选视频都调一次 dedup_check(),于是总成本变成:
| 量 | 值 |
|---|---|
| Downloads 顶层候选 | 44 条 |
| 已发布库 | 84 条 |
| 实际 ffprobe 次数 | 44 × 84 ≈ 3696 次 |
| 单次 ffprobe(含进程启动) | 数十毫秒量级 |
| 合计 | 十几分钟 |
算术摆在这儿,就不需要再怀疑沙箱了。更要命的是这个结构会自我恶化:已发布库只增不减,候选积压只增不减,每次跑都是 O(N×M),积压一倍就是四倍时间。
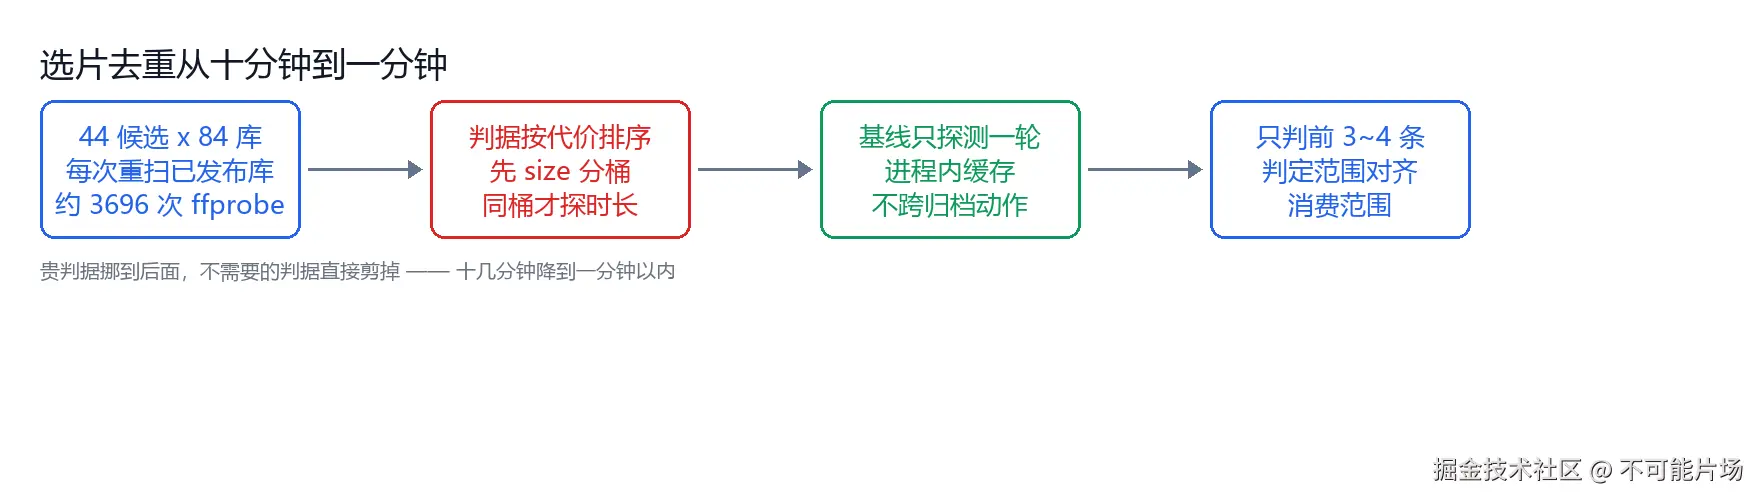
判据按代价排序 昂贵的往后放
一眼看上去的修法是加缓存,但缓存只是把常数砍掉一层------真正让成本爆掉的是判据的顺序。
去重判据是"大小相同 且 时长差小于 1.5 秒"。这两个条件的代价差了三个数量级:os.path.getsize 是纯元数据读取,微秒级;video_duration 要 fork 一个 ffprobe、解码容器头、再回收,几十毫秒。原代码却是先取时长、再进循环比大小------把最贵的操作放在了最前面。
按代价升序重排之后,判断就变成了"先按大小分桶,只有落进同一个桶的才值得去问时长":
python
def build_size_index(published):
    """size -> [path, ...],一次遍历建成,之后只读"""
    idx = {}
    for path, s, d in published:
        idx.setdefault(s, []).append((path, d))
    return idx

def dedup_indexed(video, size_index):
    size = os.path.getsize(video)          # 微秒级
    bucket = size_index.get(size) or []    # 不命中直接判否,一次 ffprobe 都不用跑
    if not bucket:
        return False, ""
    dur = video_duration(video)            # 只在有同尺寸候选时才付出这个代价
    ...
实际数据里,44 条候选和 84 条已发布重合的尺寸通常只有 0 到 1 个,分桶之后绝大多数候选连一次 ffprobe 都不需要。也就是说:不用把探测做快,只要让它在不需要的时候根本不发生。
缓存要写对 才不白写
只加索引不解决批量场景:扫描脚本还是要对 44 条候选逐个判定,而每条判定都要读一遍库。于是第二层是记忆化------把"已发布库"这个基线数据在进程内算一次:
python
_cache = {}

def plib_cached():
    if "plib" not in _cache:
        _cache["plib"] = dp.published_lib()   # 整轮只探测一次
    return _cache["plib"]
这里有两个必须想清楚的点,否则缓存会变成新的 bug 源。
第一,缓存粒度只能是进程生命周期。 每一轮扫描都是独立进程,缓存随进程消失,天然不会读到隔夜数据;反过来,如果把它持久化到磁盘(比如落一个 json),就必须处理失效------因为归档、压缩替换、人工挪文件都会改 已发布/ 的内容。为了省一分钟而引入一个需要维护失效的跨进程缓存,不划算。
第二,缓存不能跨"会改动被缓存对象"的动作。 同一个进程里如果先算库、再归档、再算库,第二次拿到的是过期快照。这条在本项目里不是假设:压缩替换会重写文件、归档会把文件搬进 已发布/,两者都改变基线的成员。所以缓存的注释里必须写清"只读场景"。
判定范围要和消费范围对齐
改到这里性能已经不是问题了,但读代码时发现一个更值得说的结构问题:select_next() 只取 files[0] 一条,dedup_check() 却按"要为整批候选服务"的假设写。批量脚本照抄这个函数,于是出现了"给 44 条候选都算了一遍去重结论、最后只用得上 1 条"的浪费。
反方向的坑同样存在,而且更隐蔽:select_next() 遇到第一条重复就直接返回 suspected_duplicate,不会去看第二条。如果 Downloads 顶层堆了几条历史重复文件,选片就会连续多次空转。正确的写法是把判定挪进循环,按 ctime 顺序逐条试,直到找到第一条不重复的;或者像快速扫描脚本那样,只对最前面 3 到 4 条做判定------留一点缓冲,但不做全量。
这条经验可以抽象成一句话:循环的边界应该由"谁会消费这个结果"决定,而不是由"手头有哪些数据"决定。 前者是需求,后者只是便利。
别拿有没有输出当卡死判据
最后是一个观测层面的教训。这次排查绕了弯路,是因为我把"没有输出"当成了"没有进展"。脚本全程在做 3696 次子进程调用,但它一句话都不打印,从外部看和僵死完全一样。
改完之后顺手加了两行计量,成本几乎为零,收益是下次不用再猜:
python
t0 = time.time()
n_probe = 0
...
log(f"[scan] candidates={len(vids)} probes={n_probe} elapsed={time.time()-t0:.1f}s")
probes 这个数字特别有用:它一眼就能告诉你判据排序有没有生效(应该接近候选数,而不是候选数乘库大小),也能在素材堆积时提前预警------当它开始随候选数线性上涨,说明某一层剪枝被绕过了。
结果
改动落在三处:published_lib() 的结果在进程内缓存一次;去重判定改成 size 分桶先行、时长探测延后;批量扫描只对 ctime 最早的 3 到 4 条候选做判定。
整轮耗时从十几分钟降到一分钟以内,稳定性也随之回来------同样的脚本,之前是"跑两次被杀两次",之后是一次跑完正常退出。
回头看不值得炫耀的部分:这次真正的错误不是"忘了加缓存",而是默认"判据很便宜"。去重判据看着是两个字段的比较,实际却是一个字段加一次外部进程;把这种判据放进双层循环,复杂度就从"看起来 O(N×M) 次比较"变成了"O(N×M) 次进程创建"。数量级差在这儿,加机器、调超时都救不回来,只有把贵的挪到后面、把不需要的剪掉,才是真的把它按下去。