那只在开发者圈里被反复猜身份的神秘兔子,MiniMax认领了,
10月19日,MiniMax正式更新M3.1 Flash。官方确认,之前匿名出现的 Space Bunny,就是M3.1 Flash的早期版本。
而且,这只兔子在亮身份前,已经处理了超过200T Token,也就是200万亿个Token。
它此前到底火到什么程度?老金我专门回头查了一遍平台的数据。
OpenCode公开的历史记录里,9月24日到10月5日,按每日Token使用量计算,它连续12天排在第一。
现在,MiniMax把正式版本和完整成绩单一起端了出来:线上推理速度提升近3倍,Agent任务综合使用成本下降70%。
更值得往下看的,是它在部分办公、编程和电脑操作评测里的位置。一个Flash模型,已经开始和旗舰模型坐在同一张表里比了。
神秘兔子此前,到底是什么水平?
先看真实使用量。
OpenCode是一款开源AI编程工具,开发者可以在里面调用不同模型。它的公开数据页保留了每日模型用量,历史上的Space Bunny现在已经被标成正式名称MiniMax-M3.1-Flash。
9月24日,它的单日用量是6.8T Token,同一天DeepSeek V4.1 Flash是6.2T,Muse Spark 1.3是5.4T。
到了9月25日,兔子涨到9.0T,另外两者分别是4.6T和5.1T。
9月30日,它的单日用量达到10T。一直到10月5日,仍以9.9T排在前面。
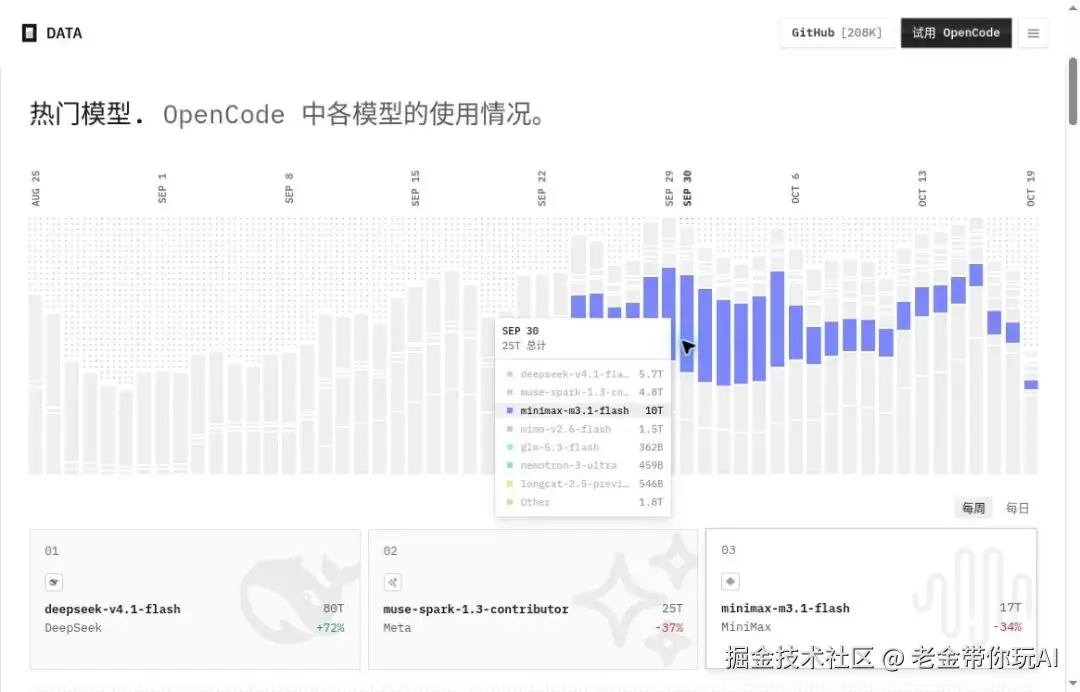
从9月24日到10月5日,连续12天。 这个结论是按OpenCode当前公开历史表逐日比较得出的。到了10月6日,Muse的单日用量已经超过它,所以这里说的是那12天的历史成绩。
还有一条当时留下来的直接记录:9月28日,OpenCode官方发帖说,Space Bunny已经连续5天位居平台第一,处理了40T Token。匿名期的热度,有平台自己的原帖可查。
调用量包含缓存Token,也会受到体验价格、活动和使用方式影响。它能说明开发者确实在大量调用这款模型,能力究竟怎么样,还要接着看任务成绩。
能力方面,也有匿名期留下来的独立记录。开发者Povilas Korop的AI Coding Daily,当前条目显示Space Bunny Max档、使用OpenCode的成绩是 57.19/80,最近评测日期标为9月30日。该站当前方法包含7个已有项目、27条提示,过程中不再追加指导;方法在10月仍有更新,这里按当前可见条目读数。
在这个榜单10月19日的快照里,Space Bunny与Gemini 4 Argon High的57.09、Kimi K3 High的56.89处在相邻位置。工具和推理档位不同,成绩要连着设置一起看。至少这份记录说明,它在匿名时已经是一位有竞争力的代码选手。
这也是这次揭晓最有意思的地方:大家先用了那只不知道是谁家的兔子,MiniMax今天才把名字贴上去。
官方披露的200T累计处理量,比单个平台的一段日榜范围更大,两组数字各看各的。
这次升级,把能力推到了哪里?
先把官方完整对比图放上来,下面逐项拆。
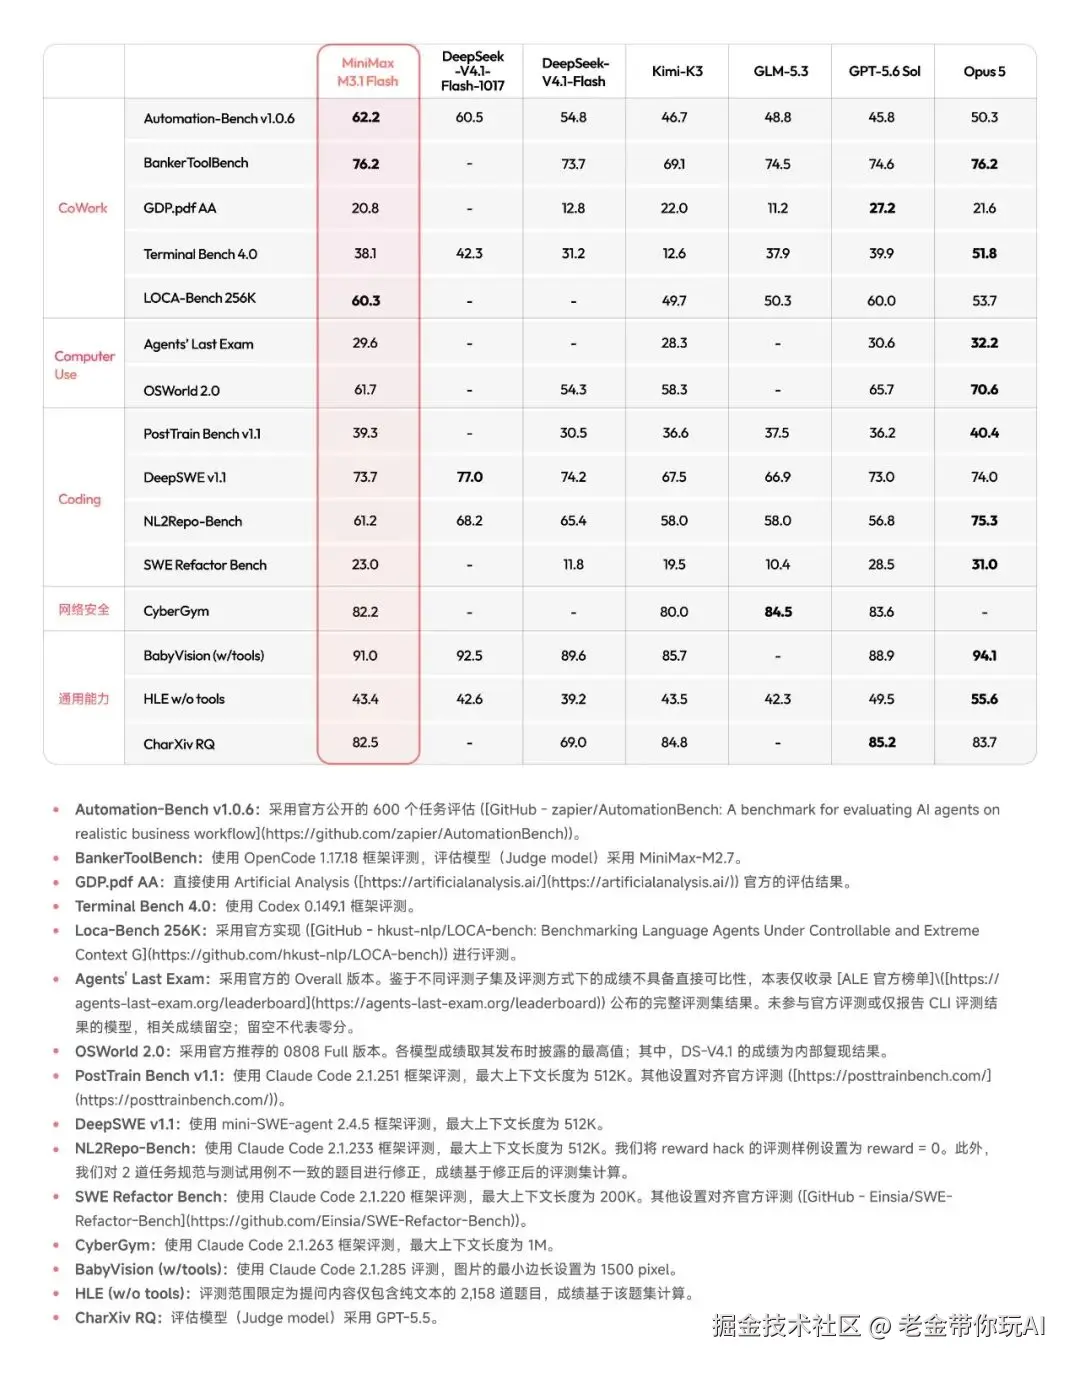
CoWork是协作办公,Computer Use是电脑操作,Coding是编程。
各行采用不同评测与工具设置,具体说明保留在原图下方。下文对照的是这张表列出的版本与成绩。
复杂办公任务,两项成绩很抢眼
一个是Automation-Bench v1.0.6。
这类评测把模型放进多步骤业务工作流里,看它能不能理解目标、连续调用工具,把事情推进下去。它涉及销售、运营、客服等工作,考验的不只是最后一句话答得好不好。
MiniMax这次公布的成绩是 62.2。
同一张官方表里,DeepSeek V4.1 Flash-1017是60.5,Opus 5是50.3,GPT-5.6 Sol是45.8。M3.1 Flash在这组对比中排在前面。
另一个是BankerToolBench,76.2分,与Opus 5并列。
它更偏金融业务中的多步骤工具任务,要在文档、文件和工具之间保持一致。对应图里,GPT-5.6 Sol是74.6,GLM-5.3是74.5,Kimi K3是69.1。
这种任务很容易出现一个问题:第一步看起来对,做到第五步,前面的约束被忘了。能把跨文件的信息接住,再连续执行工具,才有机会承担更长的工作。
官方还给了一张能力和成本放在一起的图。
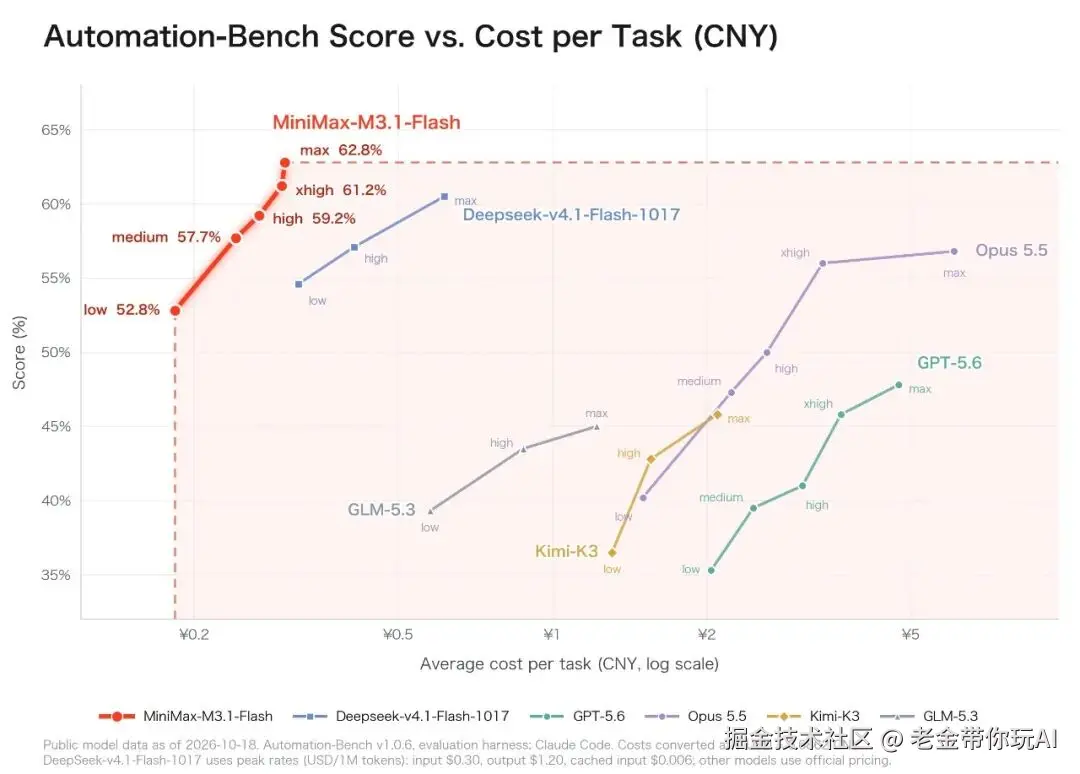
这里的纵轴越高,评测得分越高;横轴是单任务平均费用,单位人民币,采用对数刻度,越靠左越便宜。
low、medium、high、xhigh、max表示不同推理强度。
这张图想表达的重点很直接:在它公布的测试设置里,M3.1 Flash的位置更靠左上方。
也就是让完成任务的能力和成本同时变得更有竞争力。
编程73.7%,和Opus 5只差0.3个百分点
DeepSWE v1.1,M3.1 Flash拿到 73.7%。
这项评测关注复杂软件任务里的代码理解、修改和验证。对平时用AI做项目的人来说,它比只展示一页漂亮网页,更接近我们真正关心的事。
同一张总表中,GPT-5.6 Sol是73.0%,Opus 5是74.0%。两者之间,已经很近了。
DeepSeek V4.1 Flash-1017则是77.0%,仍然在前面。M3.1 Flash在这一项追到了旗舰附近,但没有拿下最高分。
接着看官方给出的编程成本曲线。
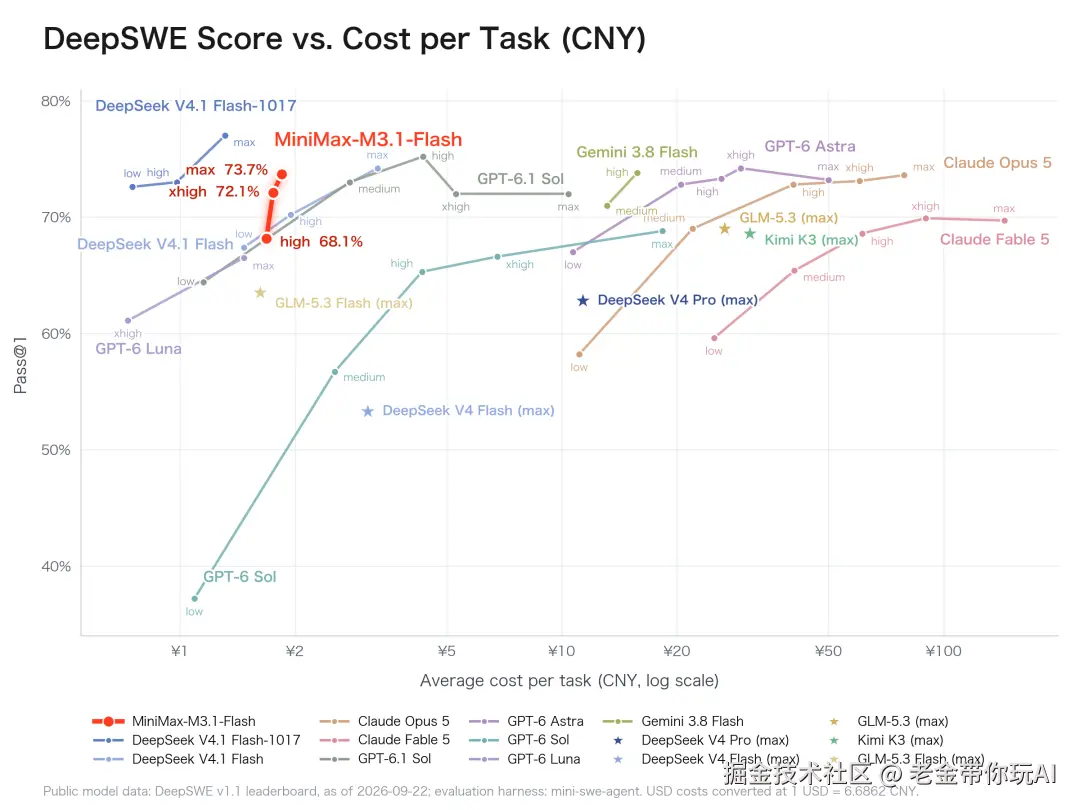
纵轴Pass@1表示一次尝试的通过表现,横轴是单任务平均成本,单位人民币,采用对数刻度。
红色为M3.1 Flash:high 68.1%、xhigh 72.1%、max 73.7%。
这张图里,老金更在意红色那一小段。
从high到xhigh,再到max,分数逐步上升,成本也跟着变化。它把思考强度这件事摆到了台面上:你可以按任务难度选档,而不是每次都用同一种配置。
不过,完整表也留着它的短板。
SWE Refactor Bench这类代码重构任务里,M3.1 Flash是23.0,GPT-5.6 Sol是28.5,Opus 5是31.0。NL2Repo-Bench里,它的61.2也低于Opus 5的75.3。
所以,这次最有分量的进步,是Flash这个成本档位,已经能在部分复杂编程任务里贴近旗舰。做重构、做长链路工程,还是要看具体任务。
电脑操作,两项成绩进入国产前列
电脑操作是另一个明显的重点。
OSWorld 2.0,M3.1 Flash得分 61.7。官方对比表中的Kimi K3是58.3,DeepSeek V4.1 Flash是54.3。GPT-5.6 Sol为65.7,Opus 5为70.6。
再看Agents' Last Exam,简称ALE。M3.1 Flash是 29.6,Kimi K3是28.3,GPT-5.6 Sol是30.6,Opus 5是32.2。
MiniMax在公告中将这两项成绩称为国产模型第一。从它给出的对比表看,M3.1 Flash也确实高于列出的国产对手。
这类评测看的是AI在电脑环境里完成任务的能力。要找到界面入口,理解当前状态,操作应用,再继续后面的步骤。日常用AI时,很多令人头疼的停顿就发生在这些地方。
ALE还有一张更直观的成本图。
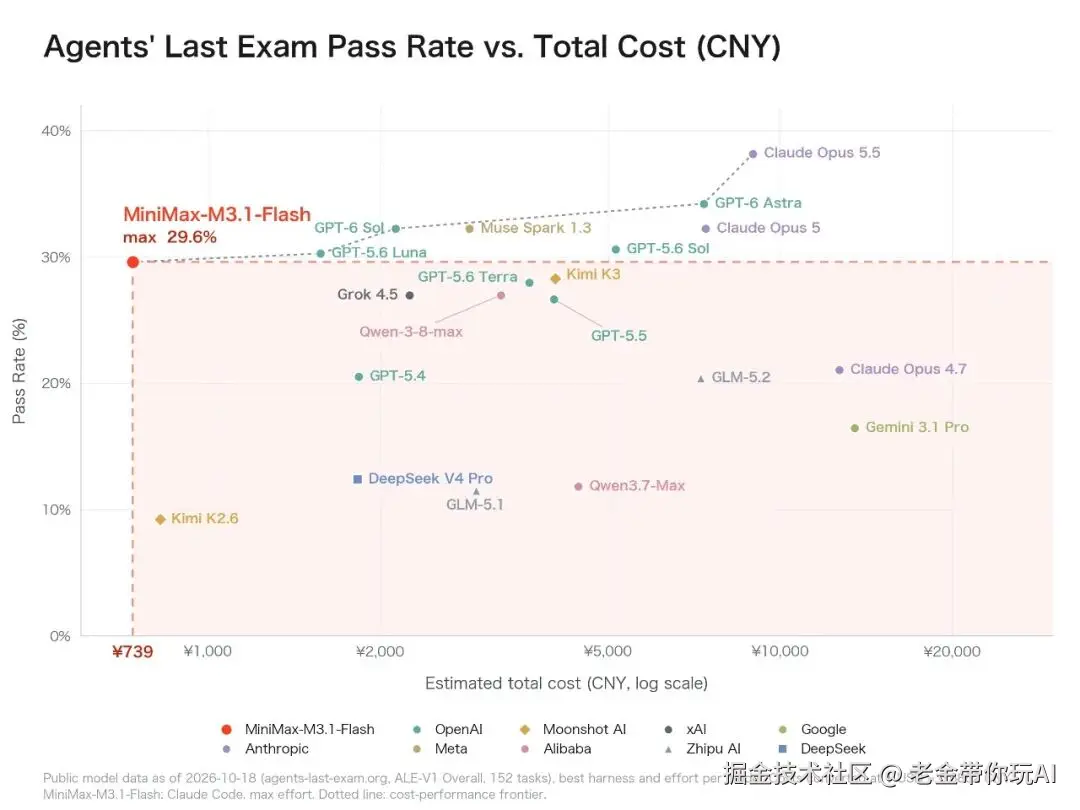
纵轴为该图标注的评测通过率,横轴为整套评测预计总成本,单位人民币、对数刻度。
M3.1 Flash红点为29.6%、739元;图注采用ALE-V1 Overall、152项任务。
739元这个数字很醒目,读图时要先看单位:它算的是整套评测的预计费用。
官方想说明的是,在这组测评里,它能以较低预算取得接近部分更贵模型的成绩。
如果电脑Agent要在后台反复执行任务,成本就很实际了。偶尔做一次和每天跑几十次,对模型价格的敏感程度完全不同。
安全和视觉,也有具体成绩
CyberGym,官方原图给出 82.2,正文取整写82%。
同表GLM-5.3是84.5,GPT-5.6 Sol是83.6,Kimi K3是80.0。M3.1 Flash已经处在靠前的一组,最高分仍是图里的GLM-5.3。
CyberGym主要考已有漏洞的复现与验证。MiniMax还披露内部安全团队评估了代码审计、漏洞修补、恶意代码分析等场景。对于安全工作,能完成验证链条比单纯输出一段看起来专业的分析更重要。
视觉相关的两项也值得扫一眼:BabyVision在使用工具的设置下达到91.0,CharXiv RQ为82.5,后者涉及图表理解。
这些能力放到电脑操作中,是能连起来的。模型先得看懂页面、图片和图表,再判断该怎么操作。视觉、工具调用、持续执行,任何一段掉链子,任务都会停。
为什么这次快了,而且更便宜?
MiniMax的解释是进一步优化推理效率,采用更激进的稀疏注意力架构。
可以粗略理解成,处理长内容时,让计算更有选择地关注相关部分,减少不必要的计算。具体效果还和模型、任务及服务设置有关。
vLLM项目的官方技术线程也补了底层信息:这次优化结合了稀疏注意力、NVFP4低精度运算,以及面向Blackwell硬件的推理内核。通俗说,既减少不必要的计算,也在每次计算和数据搬运上继续省开销。它公布的若干倍速属于具体内核测试,不能直接相乘当成整项任务的提速。
官方公布,日常输出速度可达 200+ Token/秒,中位数P50稳定在 170+ Token/秒。
Token是模型的处理单位,和汉字并不是一比一对应。这里的速度指输出过程,也不把工具运行、网页加载等等待都算成模型吐字速度。
至于近3倍提速和70%降成本,官方的比较口径是相对前代,70%对应Agent任务的综合使用成本。
单看现在国内API价目,已经非常直白了:每百万Token,输入1元,输出4元,缓存读取0.1元。
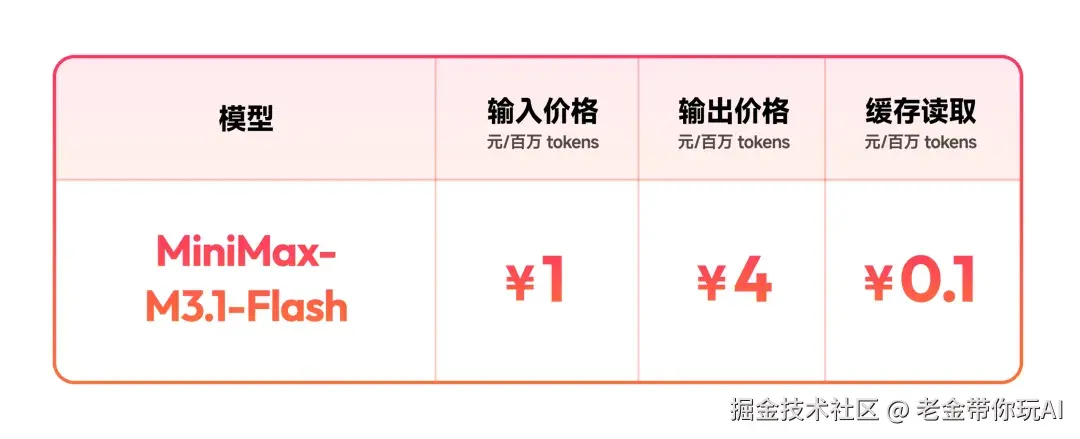
对照同页M3标准档、输入不超过512K的价格,输入和输出单价各下降约52%,缓存读取下降约76%。所以综合成本下降70%,和每一项单价都打七折或都降70%,是不同的事。
对开发者而言,更值得算的是整条任务账单。Agent做一件事会调用很多轮,模型少走几步、每步便宜一点、输出再快一点,最后的差距才会明显。
现在能用,10月23日还有一个节点
正式型号是 MiniMax-M3.1-Flash,已经可以通过MiniMax Code、M Plan和API使用,官方也提供Claude Code、Codex等工具的接入说明。
官方发布帖还明确预告:模型权重将在10月23日放出。 目前是开放计划,权重尚未发布。
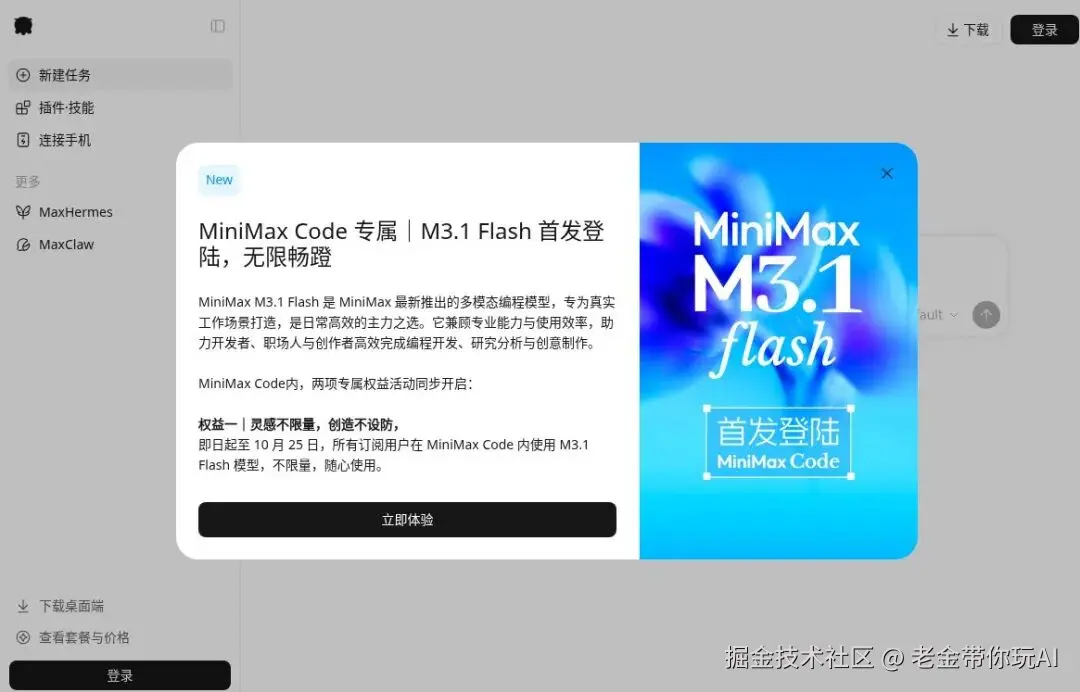
另外,MiniMax Code里现在有一个限期活动:截至10月25日,订阅用户在MiniMax Code内使用M3.1 Flash不限量。
写在最后
回头看这次发布,我觉得最有意思的是顺序。
先有一只匿名兔子,在开发者的工具里被大量调用。接着亮出身份,再把各项成绩、推理档位和任务成本一起摆出来。
调用榜说明有人在用,任务评测说明能力到了哪里,成本曲线则回答另一个问题:这种能力,能不能每天都用。
这三个问题一起看,M3.1 Flash才值得认真关注。
旗舰模型继续抬高上限,Flash模型把一部分能力带到更便宜、更快的日常使用里。对真正在做项目的人来说,选择会越来越具体:哪一段任务值得用最强的模型,哪一段已经可以交给便宜的主力。
神秘兔子亮身份之后,更值得等的,就是它在真实项目里的下一份成绩单。\ \
谢谢你读我的文章。
如果觉得不错,随手点个赞、在看、转发三连吧🙂
如果想第一时间收到推送,也可以给我个星标⭐~谢谢你看我的文章。
开源知识库(实时更新 交流群): my.feishu.cn/wiki/OhQ8wq...