一、先给结论:三个坑分别是什么
| # | 现象 | 根因 | 我的改法 |
|---|---|---|---|
| 1 | 连接数涨到几十个后,日志里开始偶发断连重连 | 集合遍历与增删并发,遍历到已被踢掉的连接 | 连接集换 CopyOnWriteArraySet,发送失败即剔除 |
| 2 | 浏览器显示"已连接"但曲线不动 | 半开连接:会话对象 isOpen() 还是 true,实际已断 |
推送抛 IOException 直接剔除连接,交给前端重连 |
| 3 | 服务端偶发 500,前端整页报错 | 快照构建异常直接抛出,把异常抛给推送线程 | 构建失败返回降级 JSON,不让异常逃逸 |
这三个坑有个共同点:**它们都不会在单连接、短时间压测里出现。**这也是为什么我写这一篇------上一篇的"实测通过"其实只验证了功能,没验证它能不能连续跑一整天。
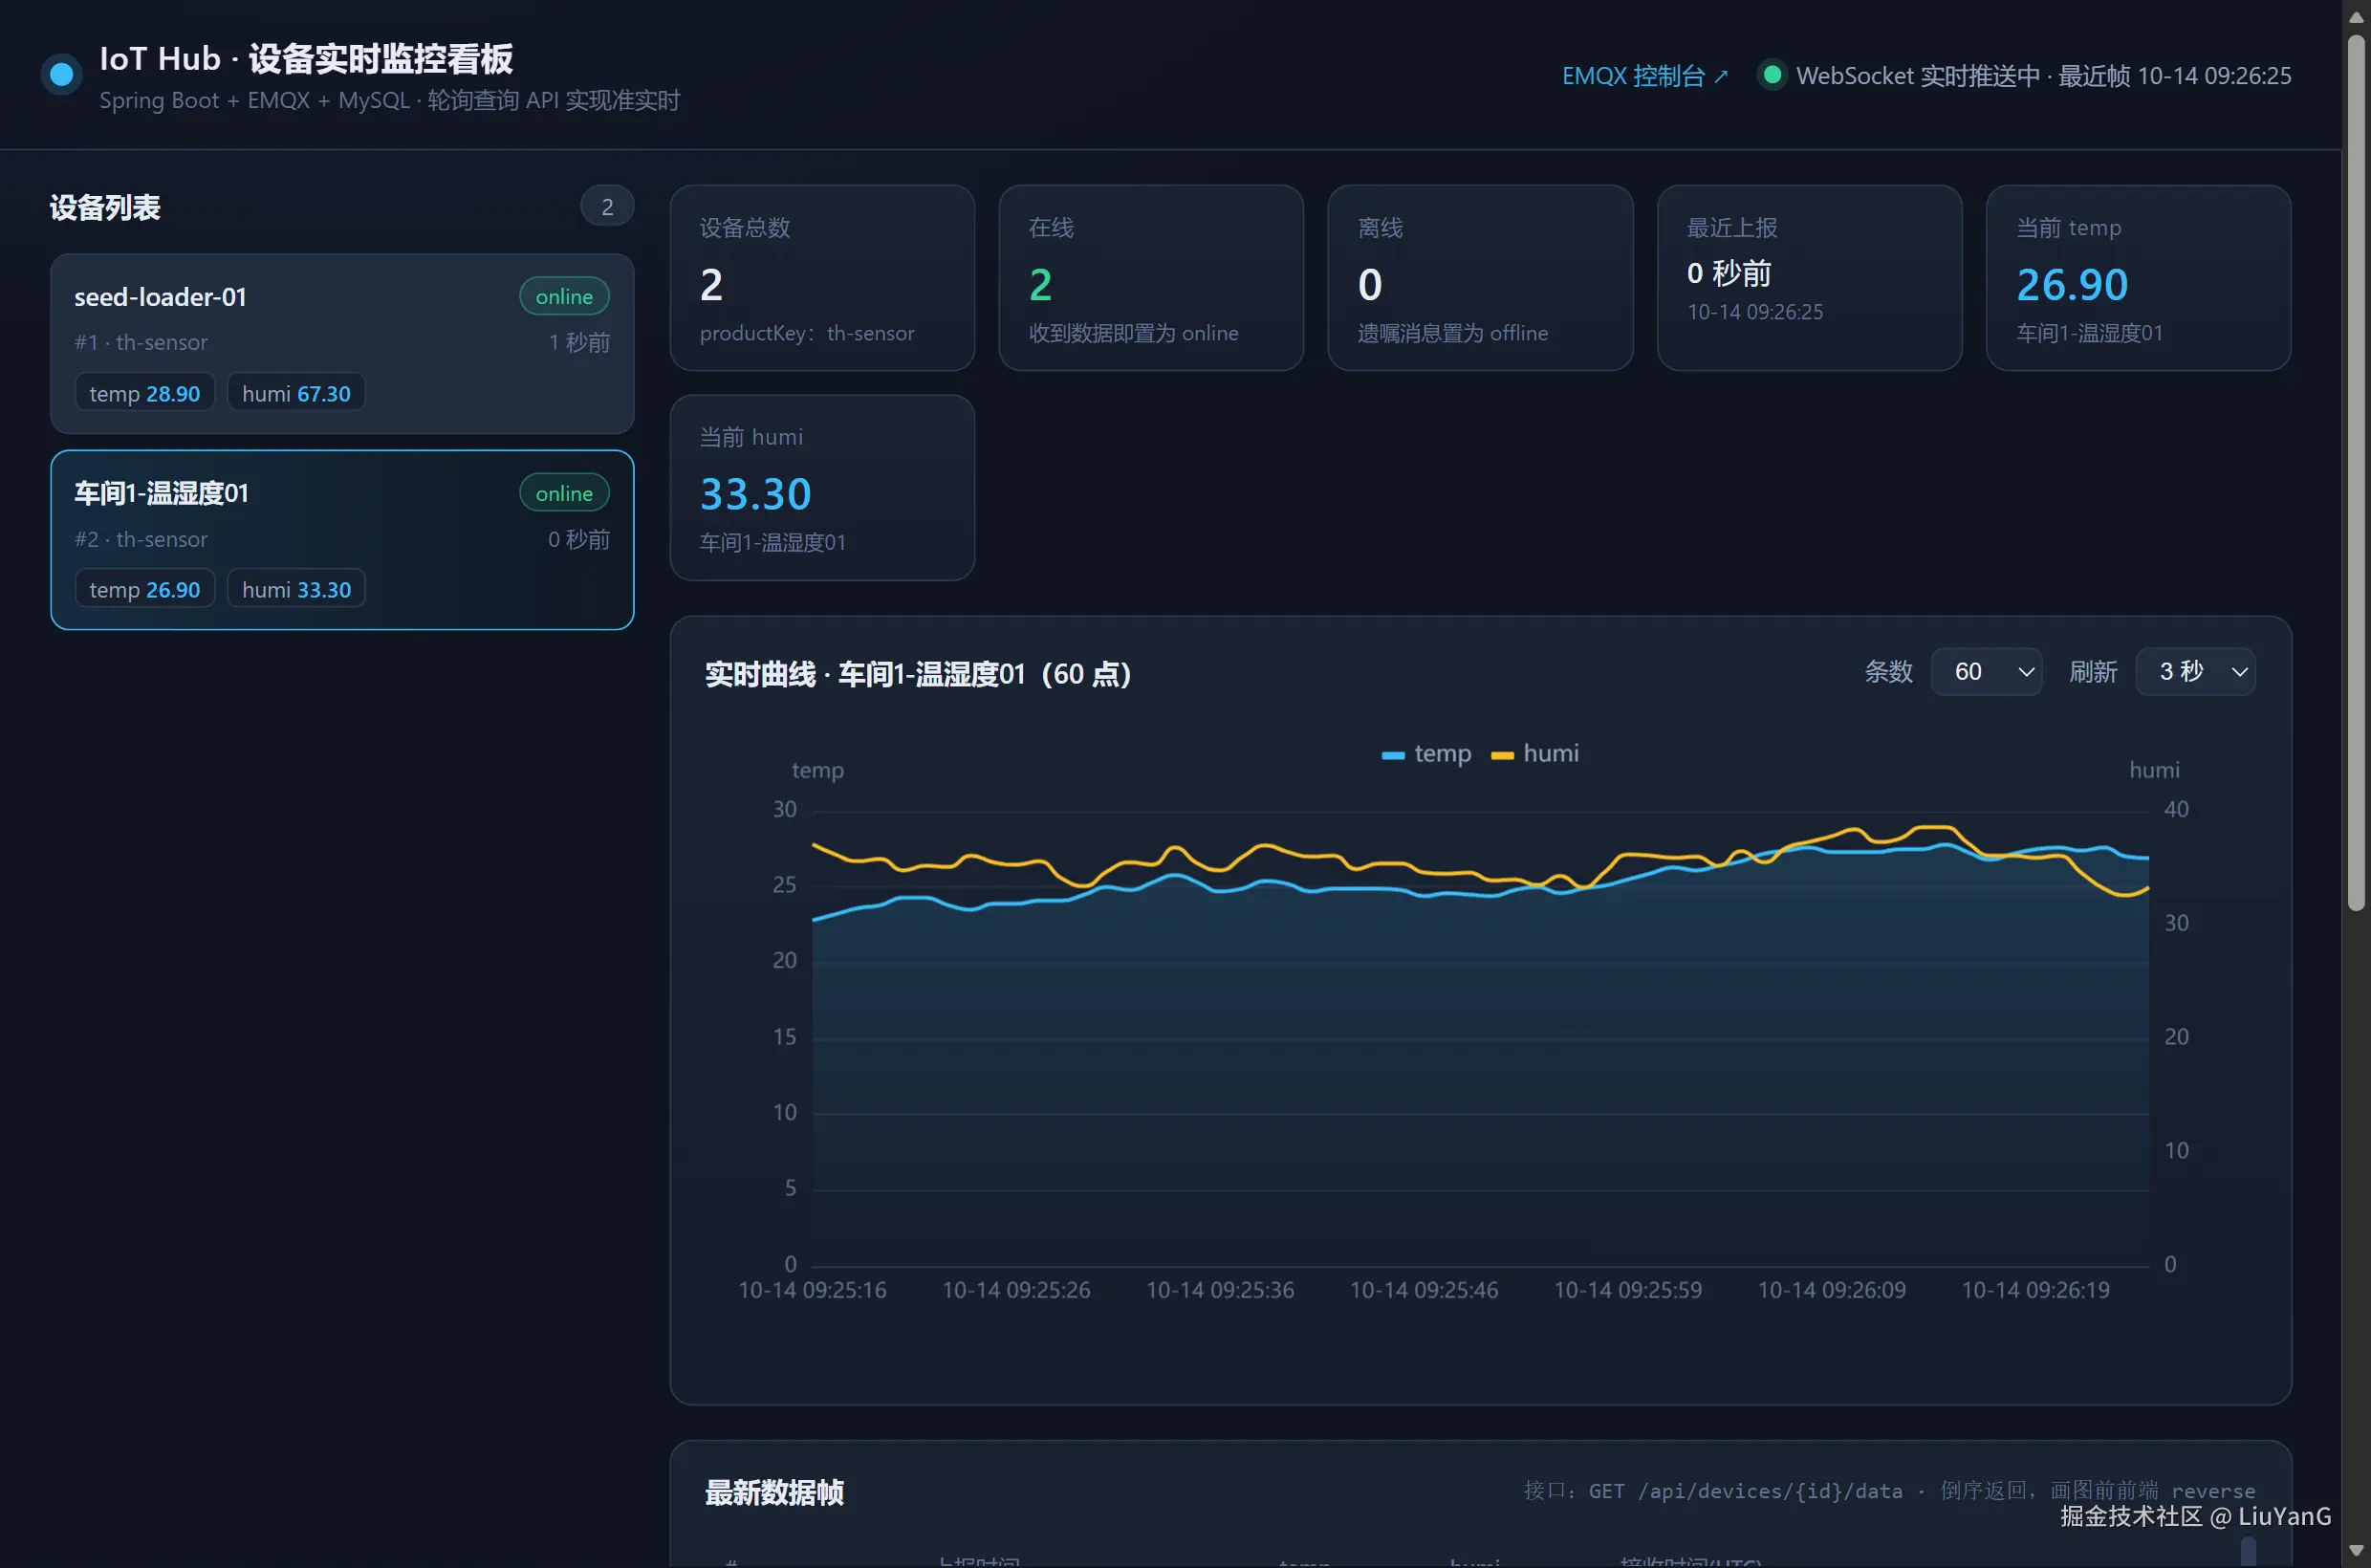
先看一眼推送链路正常运行时的样子(2026-10-14 实拍,库里有 10 万条遥测、两台设备在线):
二、坑一:连接集合不是线程安全的
2.1 先看推送有多"重"
看板的推送是一个每 2 秒执行一次、遍历所有 在线连接的定时任务(来源:src/main/java/com/iothub/ws/OverviewWebSocketHandler.java):
java
/** 每 2 秒向所有在线连接广播一次概览快照 */
@Scheduled(fixedDelayString = "${iot.ws.push-interval-ms:2000}", initialDelay = 5000)
public void broadcast() {
    if (sessions.isEmpty()) {
        return;
    }
    String payload = snapshot();
    for (WebSocketSession session : sessions) {
        try {
            if (session.isOpen()) {
                synchronized (session) {
                    session.sendMessage(new TextMessage(payload));
                }
            } else {
                sessions.remove(session);
            }
        } catch (IOException e) {
            log.warn("推送失败,剔除连接 {}: {}", session.getId(), e.getMessage());
            sessions.remove(session);
        }
    }
}
三个要点先记住,后面解释为什么这么写:
snapshot()在整个循环外只算一次------一次数据库查询、一次序列化,广播给所有连接。不是每个连接查一次库;- 发送前
synchronized (session):WebSocketSession不是线程安全的,两个线程同时往一个 session 写,底层可能串包; isOpen()为 false 或发送抛异常,都从集合里剔除。
2.2 为什么集合必须换成 CopyOnWriteArraySet
sessions 集合面临三种并发访问,而且都不加锁:
| 线程 | 在干什么 |
|---|---|
| 推送定时任务 | 遍历所有连接发送 |
| WebSocket 处理线程 | 新连接进来时 add |
| WebSocket 处理线程 | 连接断开时 remove |
如果这里用 HashSet,add/remove 正好和 for 遍历并发,可能抛 ConcurrentModificationException。而推送任务抛异常意味着这一轮广播中断------所有在线看板一起卡住。
我用的是 CopyOnWriteArraySet:
java
private final Set<WebSocketSession> sessions = new CopyOnWriteArraySet<>();选它的理由写在源码注释里:连接数少、遍历多。设备看板的在线连接通常只有个位数到几十个,但每 2 秒遍历一次------写频率极低、读频率极高,正是写时复制最划算的场景。
代价要说清楚:CopyOnWriteArraySet 每次 add/remove 都会复制整个底层数组 。如果连接数涨到几千,每次连接变更都要复制一遍,成本会显现。我的场景是几十个连接,完全可接受;如果换成万级连接,这个选择就该重新评估 (那时更合适的是 ConcurrentHashMap.newKeySet() 加上一套更严格的连接治理)。
2.3 面试怎么讲这个点
如果面试官问"你用什么集合存会话,为什么",标准答法有三层:
- 并发事实 :多线程并发 add/remove 与遍历,不能用
HashSet; - 取舍依据:连接少、遍历频繁 → 写时复制读几乎无锁;
- 知道边界:写时复制的成本随连接数线性上升,万级连接要换方案。
第 3 层是关键。能说出"这个方案在什么规模下会失效",比背下 CopyOnWriteArraySet 的定义有用得多。
三、坑二:半开连接------"连着但不发"
3.1 这是 WebSocket 最经典的坑
设备在车间、网线被踢、笔记本合盖、NAT 超时------这些情况下连接没有正常关闭 ,服务端这边的会话对象仍然是 isOpen() == true,但底层 socket 已经死了。
于是推送任务每 2 秒对着一个死连接 sendMessage,轻则数据丢了没人知道,重则抛异常。而从浏览器视角看:WebSocket 握手成功过、监听器也触发了,readyState 显示已连接,但曲线就是不动。
这个坑的恶劣之处在于它不自愈 :你不主动踢掉那个连接,它就一直躺在集合里,每一轮推送都浪费一次 sendMessage 调用。
3.2 我的处理:靠异常暴露,靠剔除自愈
代码里这段是防线:
java
} catch (IOException e) {
    log.warn("推送失败,剔除连接 {}: {}", session.getId(), e.getMessage());
    sessions.remove(session);
}
sendMessage 在对端已经消失时会抛 IOException。我不去判断"这个连接是不是半开的"(没有可靠办法),而是等它自己抛异常,然后把它踢掉,让前端重连。
配合 isOpen() 判断,等于两道防线:
| 情况 | 检测方式 | 处理 |
|---|---|---|
| 正常关闭 | afterConnectionClosed 回调 |
集合里 remove |
| 明确关闭但未回调 | session.isOpen() 为 false |
循环内 remove |
| 半开连接 | sendMessage 抛 IOException |
catch 里 remove |
连接生命周期回调在类开头:
java
@Override
public void afterConnectionEstablished(WebSocketSession session) {
    sessions.add(session);
    log.info("WebSocket 接入: {}(当前 {} 个连接)", session.getId(), sessions.size());
    sendSnapshot(session); // 连上立刻给一帧,前端不用等下一个推送周期
}

@Override
public void afterConnectionClosed(WebSocketSession session, CloseStatus status) {
    sessions.remove(session);
    log.info("WebSocket 断开: {} status={}(当前 {} 个连接)", session.getId(), status, sessions.size());
}
日志里带上 sessions.size() 是个小设计:连接数变化能第一时间看出来。如果某天这个数字只涨不跌,说明有连接没被正确清理------这是个很有用的早期信号。
还有一条容易被忽略的:afterConnectionEstablished 里我调了 sendSnapshot(session),连上就立刻推一帧,不让前端白等一个 2 秒周期。这是体感提升最明显的一个小改动。
3.3 降级:推不通的时候还有轮询
**WebSocket 不是不能失败,它只是不能是唯一选择。**这个思路和上一篇文章一致,但这次要点明它在这个坑里的作用:
java
/**
 * 设备概览 WebSocket 推送:把"前端 3 秒轮询一次"升级为"服务端 2 秒推一次"。
 *
 * 轮询没有删掉------前端连不上 WS 时自动退回轮询,功能永远可用(降级路线)。
*/坏连接被剔除后,前端会走自己的重连逻辑;如果重连一直失败(比如网关不支持 WS、代理超时太短),前端必须能退回去用 GET /api/devices/overview 轮询。两条路径返回的是同一份数据:
java
/** 与 GET /api/devices/overview 完全相同的响应结构,前端一套渲染逻辑两处复用 */
private String snapshot() {
    try {
        List<OverviewService.DeviceOverview> data = overviewService.build();
        return objectMapper.writeValueAsString(ApiResponse.ok(data));
    } catch (Exception e) {
        log.error("构建概览快照失败", e);
        return "{\"code\":500,\"message\":\"snapshot error\",\"data\":[]}";
    }
}
注意这个 snapshot() 的返回值结构:ApiResponse.ok(data) 的序列化结果,和 REST 接口的响应体一模一样 。前端不用为 WS 单独写一套解析,切换路径时只换数据来源、不换渲染逻辑。这是让降级真正能落地的前提------如果两条路径的数据结构不同,降级代码写了也不敢切。
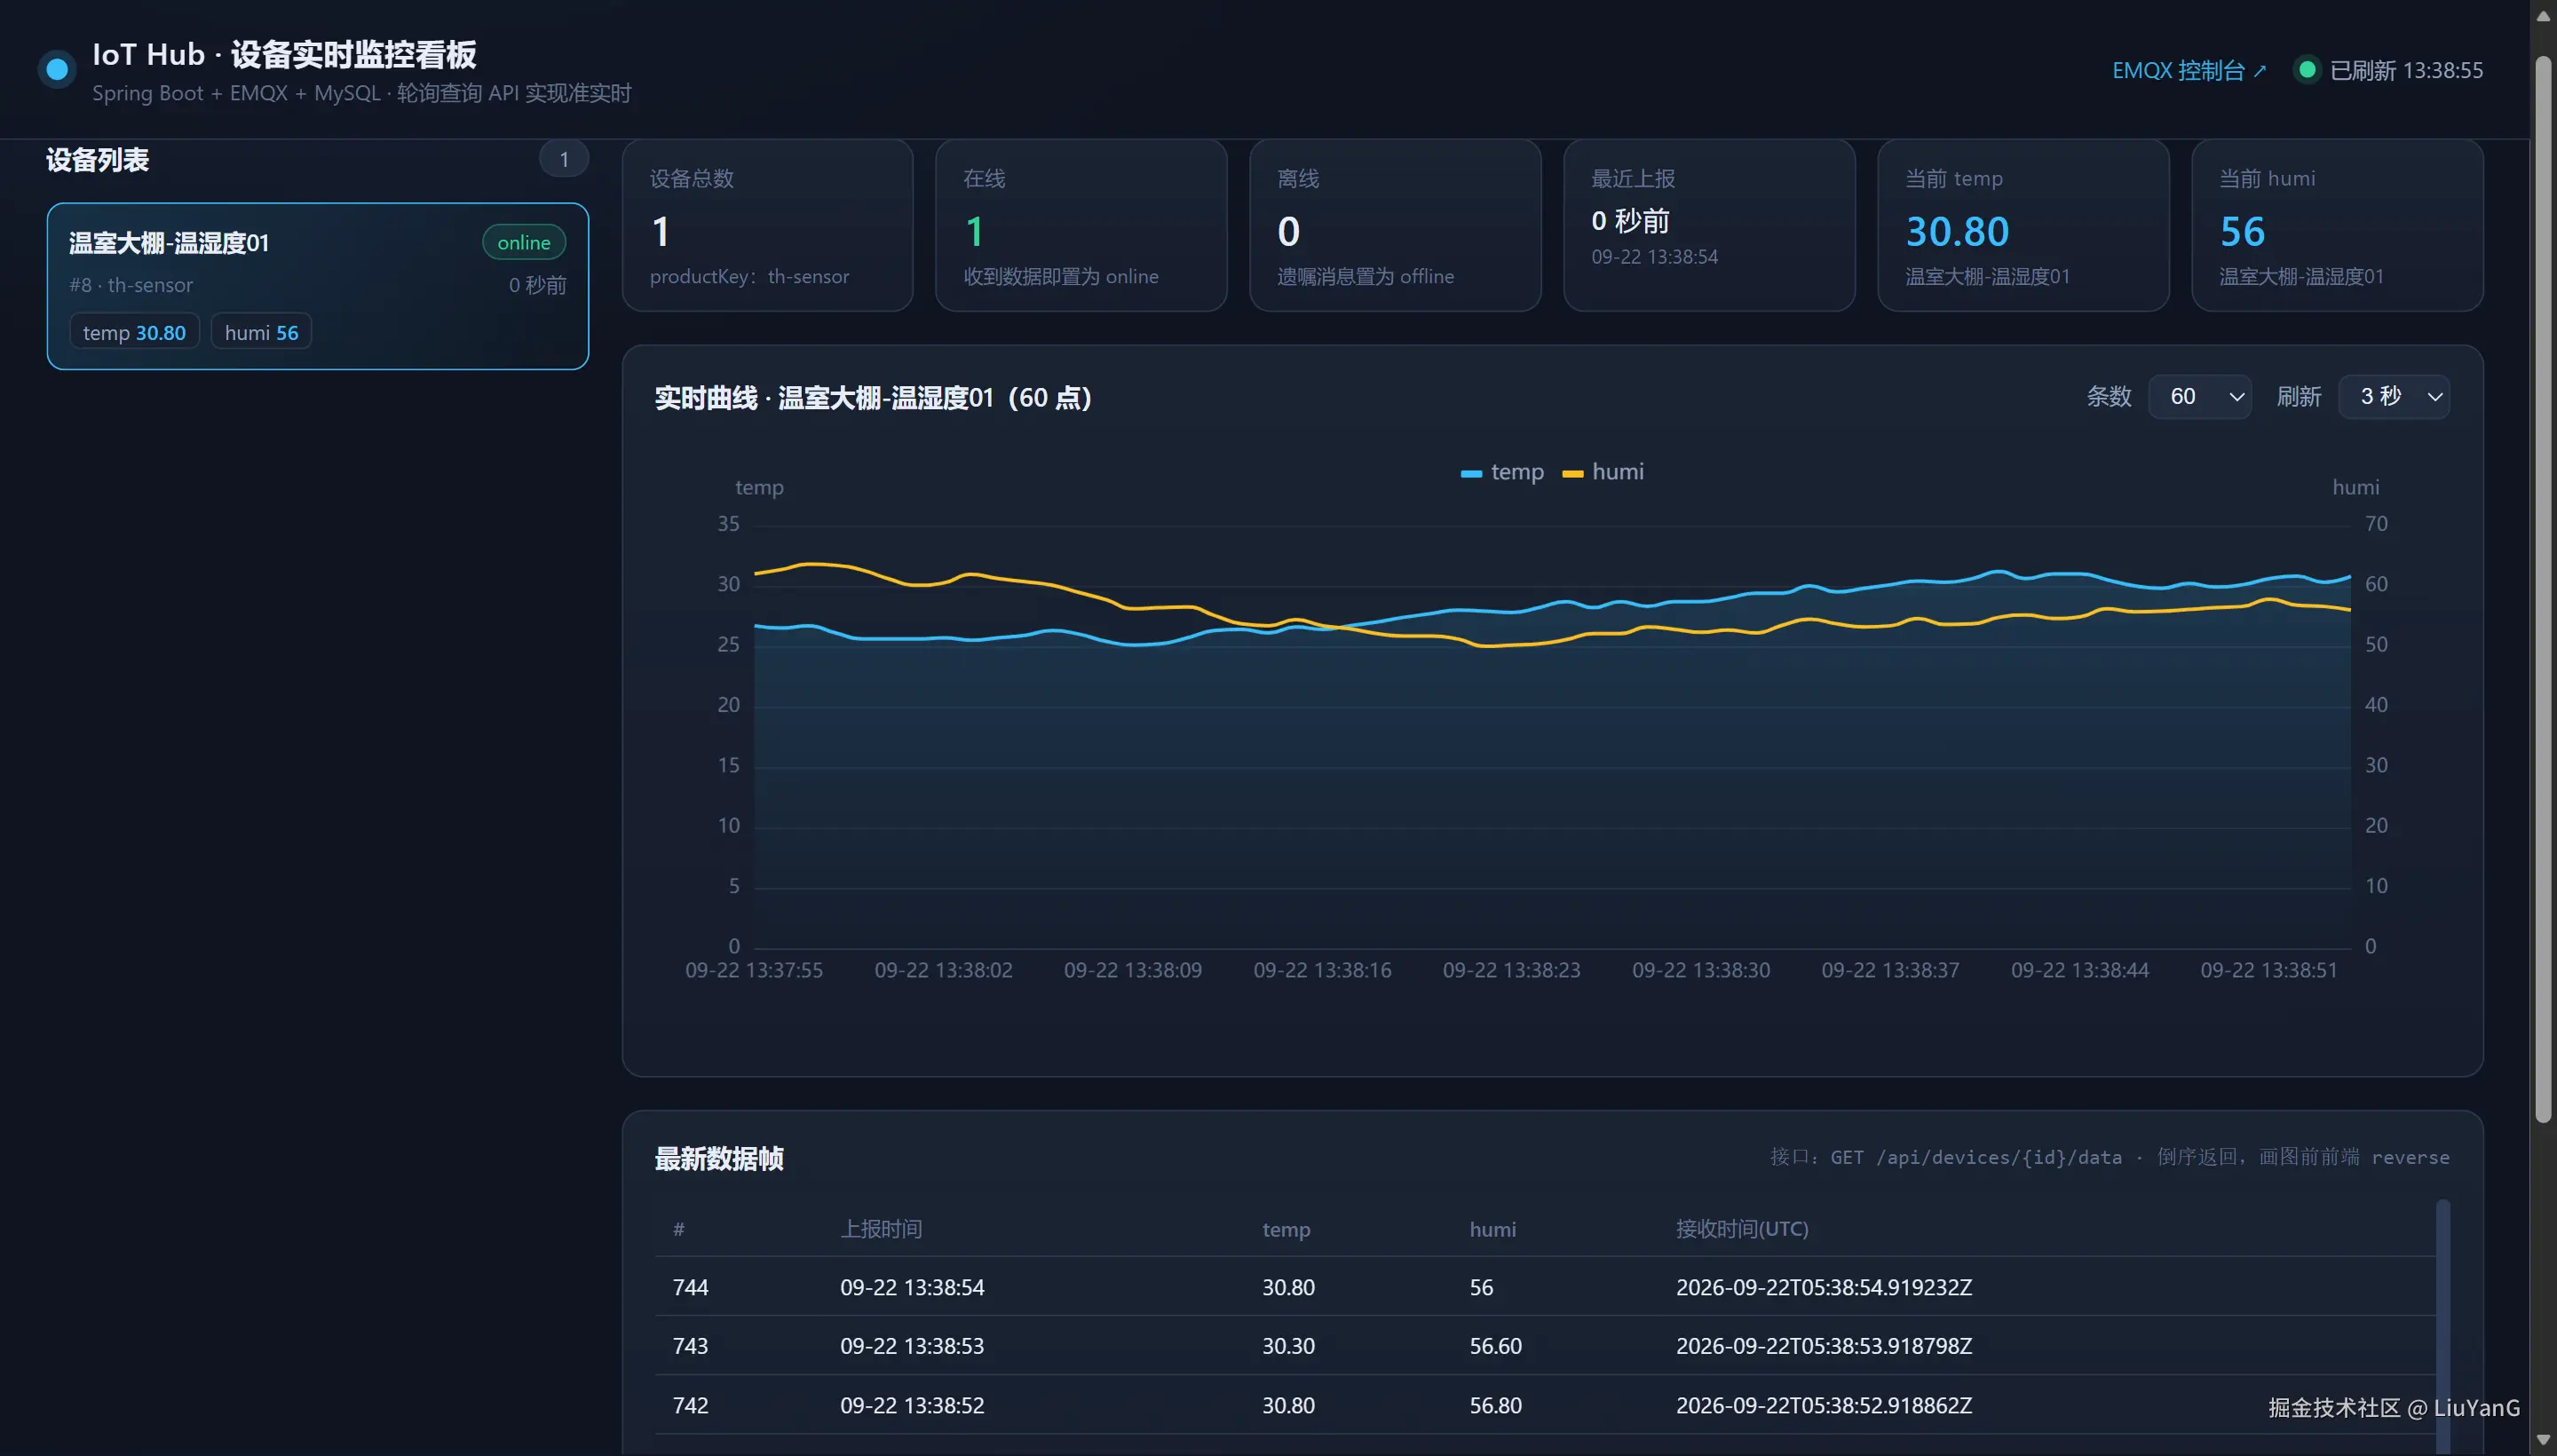
前端一套渲染逻辑吃的正是这份数据------所以不管是推送来的帧还是轮询来的响应,看板长一个样:
四、坑三:快照构建失败,把异常抛给推送线程
snapshot() 里那个 catch 不是装饰,它决定了一次数据库抖动会不会打挂整个推送:
java
} catch (Exception e) {
    log.error("构建概览快照失败", e);
    return "{\"code\":500,\"message\":\"snapshot error\",\"data\":[]}";
}
overviewService.build() 会查设备表和聚合数据。如果某次查询超时抛了异常,而这里没有 catch,异常会从 broadcast() 逃出去------@Scheduled 任务抛异常意味着本轮推送中断 ,而且 Spring 对 @Scheduled 抛异常的处理是打日志、后续调度直接停止。
这才是最严重的一个坑:一次偶发的数据库抖动,可能让整个看板推送永久停掉,而所有看板都表现为"连着但没数据"。
所以这里的原则是:推送通道本身必须永不抛异常 。构建失败就返回一个结构合法的降级响应(code:500、data 空数组),让前端按"暂时没数据"渲染,而不是抛异常让整个推送链路停摆。
同时别忘了 log.error 要留------降级是兜底,不是掩盖。不记日志的话,你只会看到"看板没数据",完全查不出是数据库抖了。
五、三个坑的共同规律
把三个坑放一起看,它们指向同一件事:
| 维度 | 单连接 demo | 多连接长时间运行 |
|---|---|---|
| 会话集合 | 1 个元素,并发问题不显现 | 几十个元素,遍历/增删并发显现 |
| 连接状态 | 客户端一直在线,不存在半开 | 网络抖动产生半开连接 |
| 数据库 | 稳定,几乎不失败 | 偶发抖动,正好撞上推送 |
| 故障表现 | 功能正常 | 看板静默卡死,且不自愈 |
三个坑里没有一个是"功能写错了",全都是在真实运行条件下才暴露的时序与状态问题。这也是我写这一篇的初衷:上一篇那篇的"实测通过"让我一度以为 WebSocket 这块已经做完了,实际跑起来才发现推送路径是最脆弱的一环。
如果让我给一条最重要的经验:**涉及"连接 + 定时任务 + 外部依赖"三者的代码,测试能验证的只是功能,而真正决定它能不能活过一个生产日的是异常路径。**推不通就踢掉、算不出来就降级、别让异常逃出去------这三条守住了,推送通道就不会静默死掉。
六、一个我还没做但该做的加固
诚实地说,这个实现还有一处不完善:没有心跳。
现在的逻辑是"发送失败就剔除",隐含假设是推送失败一定能及时被发现 。但 sendMessage 把数据写进 socket 发送缓冲区就返回了,真正的网络中断要等对端 RST 或超时才暴露。这中间可能已经推了十几轮废数据。
标准的做法是加一个 PingMessage 心跳(WebSocket 协议原生支持 ping/pong),服务端定期发 ping、约定时间内没收到 pong 就判定连接已死、主动剔除。我这一步还没做------记录在这里,等我做了再补一篇文章。
**写在这里是想说明:上面那三个坑是"已经踩到并修掉的",这一条是"知道还没修的"。**两者不要混为一谈,简历和面试里也一样------没做的不要写成做了,但知道自己该做什么,本身就是工程成熟度的信号。
我是软件工程在读(专升本),正在从零搭一套物联网设备接入平台,这个系列是项目的真实开发笔记------代码、压测数据、git 记录全部来自真实仓库,没有编造的示例。
收藏这篇能带走什么:三张对照表------「现象 / 根因 / 改法」三坑总表、三种断连方式的检测与处理表、单连接 demo 与长期运行对照表。下次看板出现"连着但没数据",按表从上往下排一遍,基本能定位到是哪个坑。加上第六节那条自查清单(连接数日志、推送状态条),就是一套现成的推送链路排查清单。
下一篇预告 :第六节留下的"没有心跳"就是下一篇的主角------服务端 PingMessage 主动探活、约定时间内没收到 pong 就判死剔除,把"靠异常暴露半开连接"升级成"主动发现半开连接"。会发在我的专栏「实时推送」里,上一篇《Spring Boot 实时数据推送怎么做》和这篇都在那个专栏,建议从专栏页按顺序看。
最后想问你一个问题:你的项目里有没有"功能测试全过,但上线跑一段时间就出问题"的经历?我这次是看板推送,另外的接口(尤其涉及线程池和超时的)大概也藏着同类的坑------你踩过哪一类?留言说说,评论我都会回。