一、引言
传统关系型数据库擅长事务处理、结构化查询和一致性约束,但在大规模全文检索、复杂文本相关性排序、日志检索和近实时分析场景中并不总是合适。例如,用户想在商品标题、描述、标签、品牌、类目中同时搜索"无线降噪耳机",系统不仅要找出包含关键词的记录,还要处理分词、相关性评分、高亮、过滤、排序、聚合和分页。关系数据库可以通过LIKE 或全文索引做一部分事情,但当数据量、字段复杂度、写入速度和搜索体验同时上升时,工程成本会迅速增加。
Elasticsearch 是一个面向搜索、分析和近实时数据检索的分布式数据存储与搜索引擎。它把 JSON 文档作为核心数据模型,通过索引、分片、副本、REST API、查询 DSL、聚合、向量检索等能力,让海量文本、日志、指标、时序数据、地理空间数据和向量数据能够被快速写入、搜索和分析。
Elasticsearch 的底层搜索能力来自 Apache Lucene。Lucene 提供倒排索引、分词、相关性评分等搜索引擎核心能力,但它本身是一个 Java 搜索库,不是开箱即用的分布式服务。Elasticsearch 在 Lucene 之上封装了分布式集群、HTTP REST API、JSON 文档模型、自动分片、副本、查询 DSL、聚合、集群管理和生态组件,从而把"搜索库"变成了"可横向扩展的搜索与分析系统"。
Elasticsearch 的兴起和以下三个趋势有关:
| 趋势 | 传统痛点 | Elasticsearch 的切入点 |
|---|---|---|
| 数据从结构化表扩展到半结构化文档 | 字段变化快,文本字段多,关系模型建模成本高 | 使用 JSON 文档作为存储和查询对象 |
| 日志和事件数据爆发 | 海量追加写入,需要秒级检索和聚合 | 支持近实时搜索、时间序列数据和聚合分析 |
| 搜索体验成为业务能力 | 关键词匹配不够,需要相关性、过滤、排序、语义检索 | 支持全文检索、Query DSL、向量搜索和混合检索 |
Elasticsearch 的价值不只是"搜索快",它更像是一套面向在线检索和分析场景的分布式查询系统:上游可以接入日志、业务事件、指标、文档和埋点数据,下游可以支撑站内搜索、日志排障、监控分析、风控检索、知识库检索和 AI 检索增强等应用。
二、核心概念
理解 Elasticsearch,先要理解几个基本对象:文档、索引、映射、设置、分片、副本和节点。索引是 Elasticsearch 的基本存储单元,也是用户与数据交互的层级;文档是 JSON 对象;映射定义字段类型和索引方式;设置控制分片数、副本数、刷新间隔等索引级行为。
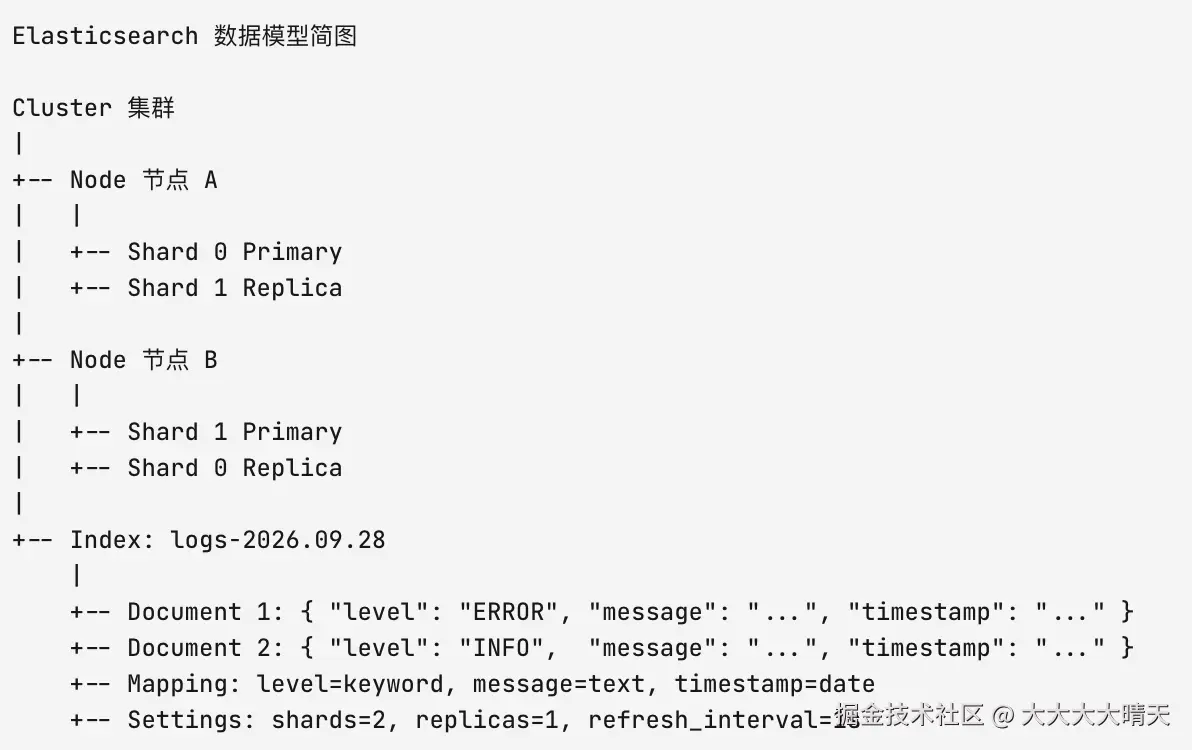
这些概念之间的关系可以这样理解:
| 概念 | 类比 | 作用 |
|---|---|---|
| Document | 一行业务记录,但以 JSON 表示 | Elasticsearch 存储和检索的基本数据单元 |
| Index | 一张逻辑表或一个数据集合 | 存储同类文档,作为查询目标 |
| Mapping | 表结构加索引规则 | 定义字段类型、分词方式和可查询能力 |
| Settings | 表级配置 | 控制分片、副本、刷新等行为 |
| Shard | 物理分区 | 把一个索引拆成多个 Lucene 索引 |
| Replica | 分片副本 | 提供冗余和读扩展 |
| Node | 集群中的服务器进程 | 承载数据、查询、协调和管理职责 |
| Cluster | 节点集合 | 对外提供统一搜索和存储能力 |
三、架构原理
Elasticsearch 集群由一个或多个节点组成。客户端可以向任意节点发送请求,接收请求的节点会承担本次请求的协调工作,因此"协调节点"通常是一个请求级角色,而不一定是专门部署的节点。
| 节点角色 | node.roles 配置值 | 核心职责 | 主要资源压力 |
|---|---|---|---|
| 候选主节点 | master | 参与主节点选举,管理集群状态、索引元数据和分片分配 | CPU、稳定网络、持久化存储 |
| 摄取节点 | ingest | 在索引前执行 Ingest Pipeline | CPU、内存 |
| 通用数据节点 | data | 保存分片,处理 CRUD、搜索和聚合 | CPU、内存、磁盘 I/O |
| 协调节点 | \[\] | 分发请求并合并分片结果 | CPU、堆内存、网络 |
sql
                         Elasticsearch 集群架构

   +----------------+       +----------------+       +----------------+
   | 业务应用 / SDK  |       |     Kibana     |       | 运维管理程序    |
   +--------+-------+       +--------+-------+       +--------+-------+
            |                        |                        |
            +------------------------+------------------------+
                                     |
                           HTTP / REST API
                                     |
                                     v
                     +-------------------------------+
                     |       接收请求的任意节点        |
                     |       Coordinating Node       |
                     |                               |
                     |  · 解析请求                    |
                     |  · 路由到目标分片               |
                     |  · 汇总、排序和返回结果          |
                     +---------------+---------------+
                                     |
                    +----------------+----------------+
                    |                |                |
                    v                v                v
+-----------------------------------------------------------------------+
|                       Elasticsearch Cluster                           |
|                                                                       |
|   +------------------+  +------------------+  +------------------+    |
|   |     ES Node 1    |  |     ES Node 2    |  |     ES Node 3    |    |
|   |                  |  |                  |  |                  |    |
|   |  Master eligible |  |  Master eligible |  |  Master eligible |    |
|   |  Data            |  |  Data            |  |  Data            |    |
|   |  Ingest          |  |  Ingest          |  |  Ingest          |    |
|   |                  |  |                  |  |                  |    |
|   |  +------------+  |  |  +------------+  |  |  +------------+  |    |
|   |  | P0 主分片   |  |  |  | P1 主分片   |  |  | P2 主分片   |  |    |
|   |  +------------+  |  |  +------------+  |  |  +------------+  |    |
|   |  +------------+  |  |  +------------+  |  |  +------------+  |    |
|   |  | R1 副本     |  |  |  | R2 副本     |  |  | R0 副本     |  |    |
|   |  +------------+  |  |  +------------+  |  |  +------------+  |    |
|   +------------------+  +------------------+  +------------------+    |
|            |                     |                     |              |
|            +---------------------+---------------------+              |
|                                  |                                    |
|                    +-------------v--------------+                     |
|                    | 当前选举产生的主节点         |                     |
|                    | Elected Master Node        |                     |
|                    |                            |                     |
|                    | · 维护集群状态              |                     |
|                    | · 管理索引元数据             |                     |
|                    | · 调度分片分配               |                     |
|                    | · 处理节点加入和离开          |                     |
|                    +----------------------------+                     |
+-----------------------------------------------------------------------+

说明:
P0、P1、P2:主分片 Primary Shard
R0、R1、R2:副本分片 Replica Shard

对应关系:
P0 <-------- 副本关系 --------> R0
P1 <-------- 副本关系 --------> R1
P2 <-------- 副本关系 --------> R2- 任意节点都能接收请求。接收请求的节点会承担协调节点职责,负责请求分发和结果归并。协调节点是请求处理角色,不一定是独立部署的专用节点。
- 主节点不等于主分片所在节点。主节点负责管理集群状态和分片分配;主分片负责处理对应复制组的写入,两者是不同概念。
- 主分片和副本分片不会分配在同一个节点上。Elasticsearch 会避免把某个主分片及其副本放到同一节点,否则节点故障时两份数据会同时丢失。
四、分片与副本
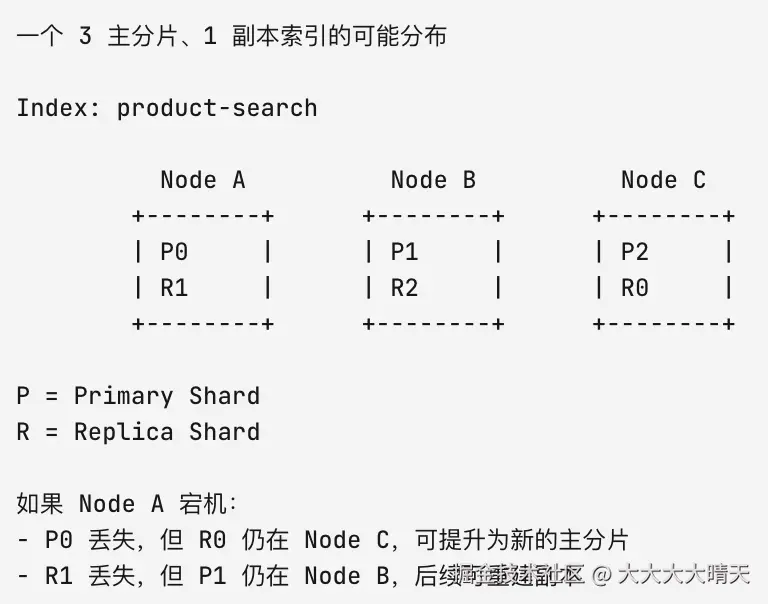
Elasticsearch 通过把索引拆成多个分片来实现水平扩展。每个分片本质上是一个自包含的 Lucene 索引,保存索引中的一部分文档;把这些分片分布到多个节点上,就可以提高写入和查询容量。分片分为主分片和副本分片:每个文档属于一个主分片,副本是主分片的拷贝,用于容错并提高读取能力。
索引创建时主分片数量固定,但副本分片数量可以在不中断写入和查询的情况下修改。这意味着主分片数是容量规划中的早期决策,副本数则更像运行期可调的可靠性和读吞吐参数。
五、写入模型
Elasticsearch 的数据复制模型基于 primary-backup 模型。每个索引操作会先通过路由定位到对应复制组,然后转发到当前主分片;主分片负责校验操作、执行本地写入,并把操作转发给当前 in-sync 副本集合;所有 in-sync 副本成功执行并响应后,主分片才向客户端确认成功。
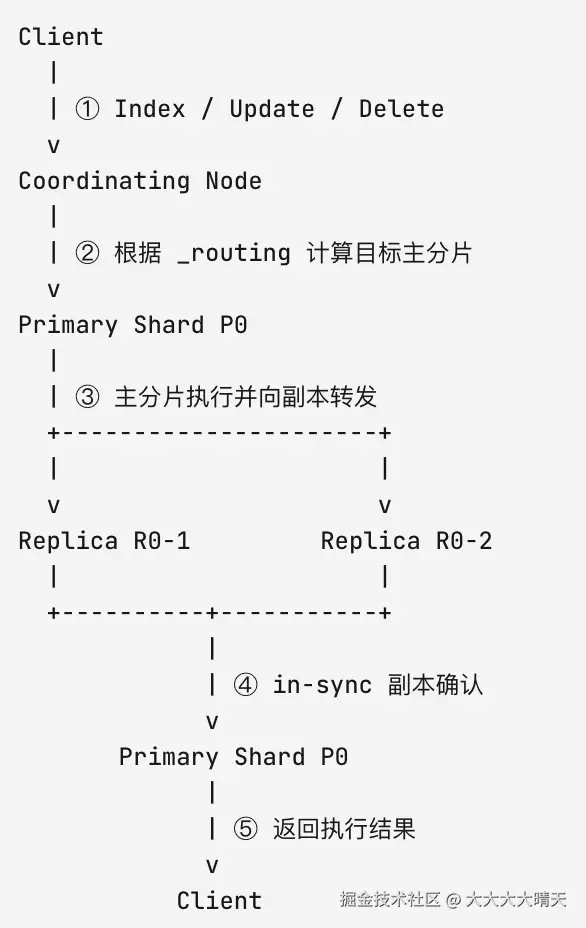
副本不是异步"随缘同步"的备份,而是写入确认链路中的参与者。副本越多,读取能力和容错能力可能增强,但写入确认链路也会更重。单个慢分片可能拖慢整个复制组的写入,这是主备模型为读取效率付出的代价。
六、读取模型
读取请求可以是按 ID 获取文档,也可以是复杂搜索和聚合。收到读取请求的节点会成为协调节点,负责解析相关分片、选择每个分片复制组中的一个活跃副本,发送分片级读取请求,然后合并结果并返回客户端;默认情况下,Elasticsearch 会使用 adaptive replica selection 选择分片副本。
搜索一般包含 Query 和 Fetch 两个阶段。Query 阶段从各分片取得候选结果并完成全局排序;Fetch 阶段再从相关分片获取最终命中文档的_source 等内容。
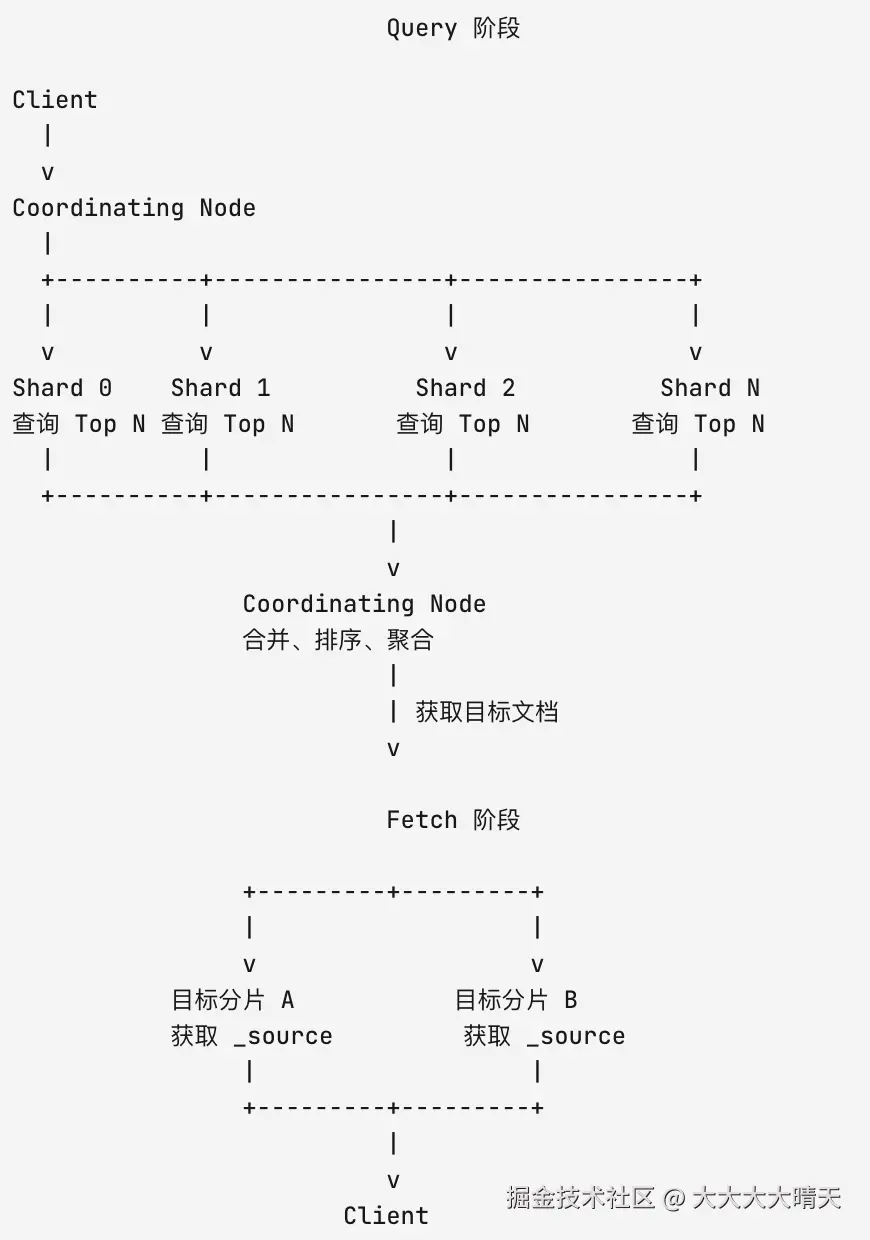
这同时解释了为什么分片数量不是越多越好。更多分片可以增加并行度,但一次查询命中过多分片时,协调节点需要分发更多请求、合并更多结果,线程池和堆内存压力都会上升。多数搜索会命中多个分片,而每个分片上的搜索通常由单个 CPU 线程执行;搜索大量分片可能耗尽节点搜索线程池,导致吞吐降低和搜索变慢。
七、功能特性与优势
| 维度 | 能力 | 说明 |
|---|---|---|
| 存 | JSON 文档、索引、映射、分片、副本 | 支持多类型数据建模和水平扩展 |
| 搜 | 全文检索、过滤、排序、高亮、相关性评分 | 支撑搜索体验和复杂检索条件 |
| 算 | Aggregations、统计、分桶、指标计算 | 支撑日志分析、运营分析、监控看板 |
| 扩 | REST API、客户端、Elastic Stack、插件生态 | 易于接入数据工程和业务系统 |
| 管 | ILM、数据流、监控、安全、快照 | 支撑生产环境运维治理 |
Elasticsearch 的优势可以概括为四点:搜索能力强、分布式扩展自然、生态完整、近实时分析友好。
第一,搜索能力是它的核心优势。倒排索引、分词、相关性评分、字段级查询、布尔查询、高亮、聚合和向量检索,使它比通用数据库更适合构建搜索体验。尤其在日志和文档场景中,用户经常需要"先模糊搜到相关范围,再逐步过滤、聚合和定位问题",这正是 Elasticsearch 的强项。
第二,分布式架构降低了横向扩展门槛。可以通过向集群添加节点增加容量,Elasticsearch 会自动在可用节点之间分布数据和查询负载,这意味着容量扩展不必完全依赖单机纵向扩容,而可以通过节点、分片、副本和数据生命周期策略组合实现。
第三,近实时分析让它适合在线运营与排障。业务日志、错误堆栈、访问行为、指标事件进入 Elasticsearch 后,通常可以很快被搜索和聚合。这一点让它在可观测性、运营分析、安全分析和客服检索中很有价值。
近年来,Elasticsearch 的定位也从传统全文检索扩展到向量数据库和混合检索。Elasticsearch 可以存储 embedding,并检索与查询向量最相似的向量;它可把向量搜索与全文搜索、过滤和聚合结合在同一个引擎中。这使它可以支撑语义搜索、RAG 检索、相似内容推荐和多模态检索等场景。
arduino
传统搜索与向量搜索的组合

用户查询:"便宜的住处"

传统全文检索:
  匹配 "便宜"、"住处"、"酒店"、"民宿" 等词项

向量语义检索:
  将查询转成 embedding
  找到语义接近的文档:
  - "budget hotels"
  - "affordable places to stay"
  - "经济型住宿"

混合检索:
  关键词召回 + 向量召回 + 过滤条件 + 排序融合
八、适用场景
Elasticsearch 适合"写入持续发生、查询需要快速返回、检索条件多样、文本或半结构化数据较多"的场景。
| 场景 | 为什么适合 | 典型数据 |
|---|---|---|
| 站内搜索 | 需要分词、相关性、过滤、排序、高亮 | 商品、文章、课程、文档 |
| 日志检索 | 写入量大,查询条件多,排障要求快 | 应用日志、Nginx 日志、错误堆栈 |
| 可观测性分析 | 需要按时间、服务、主机、级别聚合 | 指标、日志、Trace、事件 |
| 安全分析 | 需要快速检索异常行为和聚合模式 | 登录记录、审计日志、网络事件 |
| 地理空间检索 | 支持地理位置字段和距离查询 | 门店、配送、轨迹 |
| 向量与语义搜索 | 可结合全文、过滤、聚合和向量相似度 | 知识库、FAQ、文档片段、embedding |
| 实时运营分析 | 需要按维度快速聚合和过滤 | 用户行为、订单事件、埋点数据 |
但 Elasticsearch 不适合所有事情。它通常不应作为强事务数据库使用,也不适合承担复杂多表关联、强一致更新、长事务、主数据管理等关系型数据库核心职责。对于大规模离线分析,数据湖、数据仓库、Spark、Trino、ClickHouse 等系统可能更合适。Elasticsearch 更适合承担"在线检索层"和"近实时分析层"。
九、部署与使用
lua
部署形态选择

               +----------------------+
               | 是否希望自己管理机器 |
               +----------+-----------+
                          |
             +------------+------------+
             |                         |
            是                        否
             |                         |
   Self-managed / ECK          Elastic Cloud / Serverless
             |                         |
   自己负责系统参数、容量、       平台托管更多底层细节,
   分片、副本、备份、安全        更适合快速上线和降低运维负担
一个典型的入门使用流程如下:
markdown
1. 设计索引
   - 明确数据类型:日志、商品、文章、指标、向量
   - 设计 mapping:text / keyword / date / integer / dense_vector
   - 设计 settings:主分片数、副本数、refresh_interval

2. 写入数据
   - REST API
   - 官方客户端
   - Logstash / Elastic Agent / Ingest Pipeline
   - 自研同步任务

3. 查询分析
   - Query DSL
   - ES|QL
   - Aggregations
   - Kibana Discover / Dashboard

4. 生产治理
   - 数据流和 ILM
   - 快照备份
   - 监控告警
   - 分片容量和热点治理
分片设计是 Elasticsearch 中最常见的工程难点之一。分片太小、太多,会造成 oversharding,增加集群状态、堆内存、线程池和查询协调成本;分片太大,则会拖慢查询和故障恢复。通用建议是:目标分片大小在 10GB 到 50GB 之间,并让每个分片的文档数低于 2 亿。
diff
分片大小的经验区间

过小                         建议区间                         过大
|----------------------------|-------------------------------|
< 10GB                       10GB ~ 50GB                     > 50GB

问题:
- 过小:分片数量膨胀,管理和查询开销上升
- 过大:查询变慢,故障恢复时间变长
没有一套适用于所有环境的固定分片策略;好的分片策略必须考虑基础设施、用例和性能预期,并建议用生产数据、生产硬件、生产查询和写入负载进行基准测试。
| 问题 | 影响 |
|---|---|
| 单日或单索引数据量多大 | 影响主分片数量和 rollover 策略 |
| 查询通常查多久的数据 | 影响数据流、索引周期和冷热分层 |
| 查询是点查、全文检索还是聚合 | 影响字段设计、doc values、分片并发 |
| 写入吞吐是否高 | 影响 refresh、bulk、主分片数量 |
| 数据保留多久 | 影响 ILM、快照和存储成本 |
| 是否有热点租户或热点字段 | 影响 routing、索引拆分和限流策略 |
十、常见问题
- 集群状态 yellow 或 red
yellow 通常表示主分片可用但部分副本未分配,red 则表示至少有主分片不可用。常见原因包括节点不足、副本数设置不合理、磁盘水位过高、分片分配规则冲突、节点离线等。排查时应先确认_cluster/health 、_cat/shards 、磁盘水位、节点状态和 allocation explain,而不是盲目重启节点。
- 查询慢
查询慢可能来自多个层面:命中分片太多、分片过小过多、字段 mapping 不合理、对text 字段做聚合、深分页、脚本查询、复杂 wildcard、冷热数据混查、磁盘性能不足、JVM 压力过高等。每个分片搜索通常在单个 CPU 线程上执行,搜索大量分片会消耗搜索线程池并降低吞吐,这也是为什么索引规划和查询范围控制比单纯加机器更重要。
- 写入慢
写入慢常见原因包括副本过多、refresh 太频繁、bulk 批次不合理、主分片热点、磁盘 I/O 瓶颈、pipeline 处理过重、mapping 爆炸、动态字段过多等。对于日志和事件类场景,可以考虑批量写入、控制 refresh_interval、使用数据流和 ILM、提前定义 mapping,并避免无限制动态字段。
- mapping 爆炸
如果日志或 JSON 文档中存在大量动态字段,Elasticsearch 可能自动创建大量 mapping。默认情况下 Elasticsearch 会为每个文档中的每个字段自动创建 mapping,而每个 mapped field 都会带来内存和磁盘开销;生产中可以使用显式 mapping 来避免创建不会用于搜索或聚合的字段。
- 分片太多
分片太多会增加集群管理成本,也会影响搜索性能和稳定性。一般称这种情况为 oversharding,并指出太多分片会降低搜索性能、使集群不稳定;同时,过大的分片也会拖慢搜索并延长故障恢复时间。