Linux 内核运行在形态丰富、规模各异的计算基础设施之上。它的每一项机制调整,都需要同时面对性能、正确性、可维护性、硬件差异和长期兼容性等多重约束。
对我们而言,参与 Linux 社区建设,不只是把代码提交到上游。它既包括将生产环境中发现的问题抽象为通用方案,也包括参与讨论、审阅其他开发者的工作,与社区一起把有价值的改动打磨成熟。
为什么我们要参与社区?改动进入主线后,无需在每个内核版本上重复适配本地补丁,显著降低长期维护成本;社区的多轮审阅和测试也能发现内部验证遗漏的问题,让代码以更高质量反哺生产环境。更重要的是,持续贡献让我们从代码使用者转变为生态共建者,及时把握内核发展方向。这是一种更高效、更可持续的工程策略。
2026 年度,截止到 9 月底,我们团队已有 23 名工程师贡献的 198 个代码提交被 Linux 社区维护分支接收,覆盖内存管理、调度、文件系统与 I/O、RISC-V、虚拟化、IOMMU、网络、性能工具和内核测试等方向。同时,我们还参与了 113 个社区补丁的审阅与推进。从贡献自己的方案,到帮助其他开发者完善方案,这些工作共同构成了我们参与 Linux 内核社区的完整实践。
一、从生产问题出发,让通用能力进入 Linux
1. 从 16.7 毫秒到 1.56 毫秒:让等待 IPI 的过程恢复可抢占
在延迟敏感型业务中,任务能否及时获得 CPU,直接影响服务的长尾表现。即使一个实时任务拥有很高的调度优先级,如果当前 CPU 长时间处于不可抢占状态,它仍然只能等待。
我们在生产环境的 DPDK 工作负载中发现,部分 CPU 会出现毫秒级甚至十毫秒级的长时间不可抢占事件。进一步分析表明,其中的大部分长尾来自进程退出、内存释放等路径触发的远程 TLB 刷新。
在 x86 系统中,远程 TLB 刷新通常通过处理器间中断,也就是 IPI,通知其他 CPU 执行操作。Linux 原有的 smp_call_function 系列接口会在准备请求、发送 IPI,以及等待远端 CPU 完成的整个过程中关闭抢占。如果远端 CPU 暂时关闭中断,或者系统中需要等待的 CPU 较多,发起任务可能在不可抢占状态下等待数毫秒甚至更久。
原有流程可以简化为:
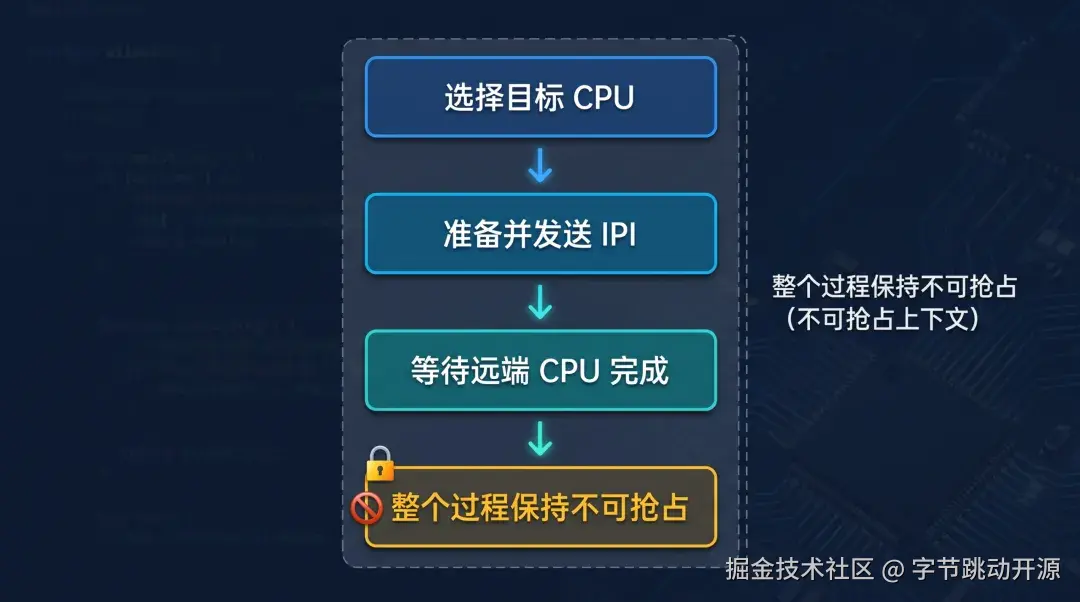
真正依赖当前 CPU 的,主要是目标选择、请求构造和 IPI 发送阶段。等待远端完成时,任务本身并不必然继续绑定在原 CPU 上。
围绕这一观察,我们提交了由 14 个补丁组成的系列,重新划分跨 CPU 调用中的抢占边界:在请求完成入队和发送后恢复抢占,让同步等待阶段变得可抢占、可迁移。
这并不是简单删除几处 preempt_disable。恢复抢占后,任务可能被切走或迁移,原本由 per-CPU 数据隐含保证的生命周期和并发关系都需要重新建立。该系列因此进一步引入 task-local IPI mask,并系统处理 CPU hotplug、CSD 存储生命周期、x86 TLB flush,以及 KVM、Xen、Hyper-V 等虚拟化后端对 CPU-local 状态的依赖。
在生产环境中,每 30 秒统计窗口内最大不可抢占时长的 P99 出现了明显下降:
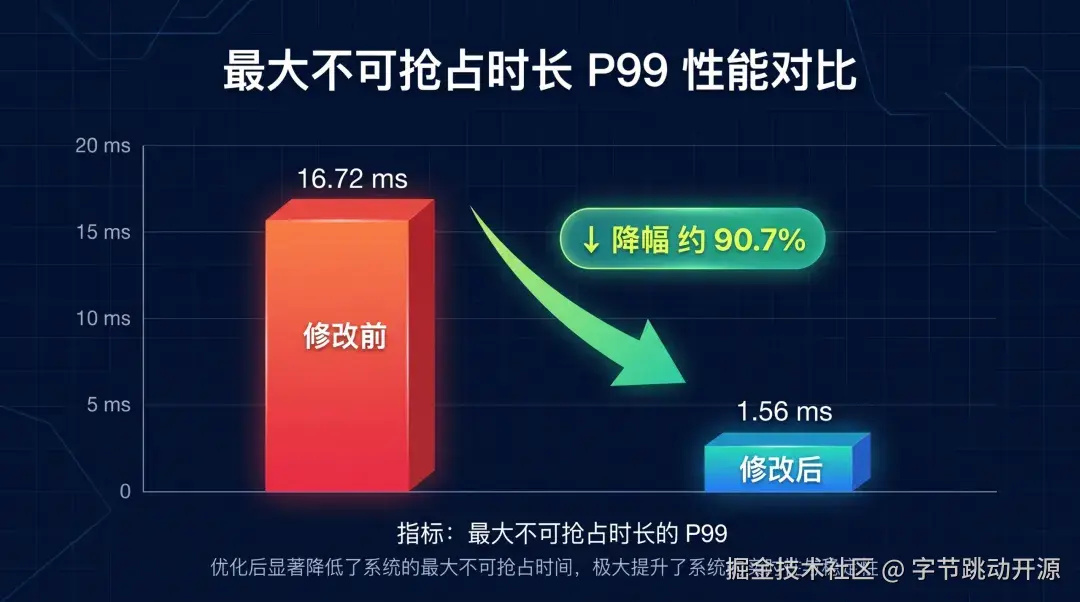
应用该系列后,在 arch_tlbbatch_flush 和 flush_tlb_mm_range 路径上不再观察到超过 1 ms 的不可抢占事件。与此同时,针对 x86 TLB flush 数据结构调整所做的微基准测试显示,新方案没有带来可测量的性能退化。
这一变化显著改善了实时任务及时获得 CPU 的基础条件。上述 90.7% 衡量的是最大不可抢占时长 P99 的降幅。
该系列经历了 10 个版本的社区迭代。来自调度、实时、x86 和 RCU 领域的多位社区开发者参与了设计讨论、代码审阅与测试。方案也从早期的栈上 cpumask 和 RCU 保护,逐步演进为边界更清晰的 task-local IPI 状态。
从生产环境中的 16 毫秒级长尾,到覆盖 SMP、x86 MM 和虚拟化路径的通用内核机制,这组工作呈现了生产实践进入开源社区的一条完整路径。
2. 容器退出之后:系统性解决 dying memory cgroup 问题
在容器环境中,一个任务或容器退出后,对应的 memory cgroup 理论上也应该完成回收。但现实要复杂得多:文件页等内存对象可能被不同任务共享,其生命周期也可能超过创建它们的 memcg。只要这些对象继续持有原 memcg 的引用,用户已经删除的 memcg 就无法真正释放,形成 dying memory cgroup。
当任务不断创建、退出,并反复访问相同文件时,文件页可能被后续实例持续使用,dying memcg 也会随之积累。这不仅消耗内存,还可能降低页面回收效率。该问题在 Linux 社区已经存在多年,也是大规模容器环境中尤其值得关注的资源生命周期问题。
我们围绕这一问题提交了 33 个补丁。我们提出的方案让 LRU folio 不再长期固定原始 memcg 的生命周期,并在 memcg 下线时重新归属相关资源;同时通过 RCU、引用计数和 lruvec 锁,保证查询、回收和重新归属过程中的并发安全。
这项改动涉及的不只是一个函数或一条回收路径,而是覆盖传统 LRU、MGLRU、workingset、writeback、zswap、页面迁移等多个核心模块。也正因为文件页可以共享、可以长期存在,且可能在任意时刻参与回收或迁移,解决 dying memcg 必须系统检查每一个获取 memcg 或 lruvec 指针的使用者。
在补丁集说明给出的复现中,连续创建并删除 2000 个 memory cgroup,同时让文件页跨越这些 cgroup 的生命周期。应用新方案后,dying memcg 的数量不再显著增长。
这项工作的意义不仅是释放一部分内核元数据,更重要的是让 Linux 在频繁创建和销毁容器的环境中,能够更准确地管理跨生命周期的文件页和回收状态。
3. 重构内存元数据基础设施:推动 HVO 走向通用化
Linux 需要为每一页物理内存维护 struct page 等元数据。系统内存越大,这部分元数据本身所占的空间就越可观。HugeTLB Vmemmap Optimization,简称 HVO,通过复用部分 vmemmap 页面,减少大页对应的元数据开销。
原有 HVO 实现包含一条服务于 HugeTLB 的特殊早期启动路径:在通用 sparse-vmemmap 流程之前预先建立优化后的映射。为了支持这条路径,通用内存初始化代码还需要维护专用状态。这使得机制难以复用,也让 bootmem、memory hotplug、Device DAX 和体系结构页表操作之间的边界更加复杂。
2026 年,我们围绕这一方向完成了四组相互衔接的工作,共计 47 个提交:
修复 vmemmap 优化在 DAX、memory hotplug 和 ZONE_DEVICE 场景中的统计与初始化错误;
重构 bootmem gigantic HugeTLB 的早期分配和初始化流程,并修复启动及架构相关问题;
将不同架构重复实现的 vmemmap PMD 操作整理为通用 helper;
在 sparse-vmemmap 中引入基于 memory section 的优化描述,并将 HugeTLB bootmem 页面迁移到这条通用路径。
在新的设计中,HugeTLB 不再自行提前建立一套特殊的 vmemmap 映射,而是把 compound page order 记录在相应的 memory section 中。通用 sparse-vmemmap population 路径根据 section 元数据决定如何分配或复用 tail vmemmap 页面。完成迁移后,原有专用的预初始化机制和一批冗余状态可以被删除。
这项工作的重点不是增加另一个局部优化,而是重新划分子系统职责:HugeTLB 描述需求,sparse-vmemmap 负责实现通用优化,体系结构代码则提供必要的页表能力。它让 HVO 的实现更容易维护,也为未来服务更多 HVO 用户建立了基础。
围绕 HugeTLB,我们还完善了大规模 NUMA 系统中的启动参数预留能力。在一台拥有 4 个 NUMA 节点、384 GB 内存的 x86 虚拟机中,相关改进使能够成功预留的 2 MiB 大页容量从不足 374 GB 提高到超过 379 GB。
这一阶段完成了 HugeTLB 向 section-based 通用框架的迁移,并为 Device DAX 等更多应用 HVO 的场景的后续演进打下基础。
4. 面对 2500 万个 struct page:加速大容量内存设备初始化
大容量 PMEM、fsdax 和 devdax 设备上线时,内核需要为对应的每个物理页初始化 struct page。对于 100 GB 的设备,这意味着大约 2500 万次高度相似的元数据初始化。相关开销直接发生在同步的设备 probe、bind 或 rebind 路径中,用户执行设备配置、热添加、恢复和重新绑定时都要等待它完成。
我们提出的方案,不再让每个 struct page 都重复走完整初始化流程,而是先生成已经正确初始化的模板,再刷新与 PFN 有关的字段并复制到后续页面。该方案同时覆盖普通 head page 和 compound tail page。
为了进一步降低写分配和缓存污染,系列还为内核引入了 memcpy_nontemporal 接口,并在 x86 上扩展固定尺寸的 MOVNTI 快速路径。没有体系结构专用后端的平台仍然回退到普通 memcpy,因此模板复用本身是一项跨架构优化。
该系列分别在虚拟机、物理机和 arm64 环境中进行了验证:
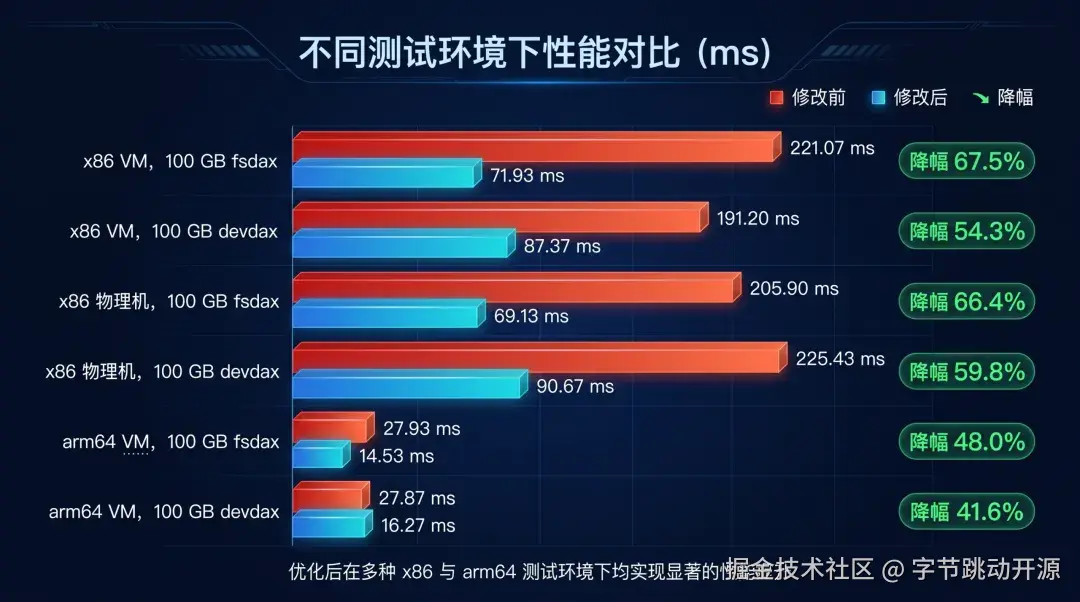
arm64 测试没有使用 x86 的 MOVNTI 快速路径,仍然获得了明显改善,这说明通用的模板复制机制本身就能为其他架构带来收益。
这些测试使用了不同的架构、页大小和设备对齐配置,验证了优化在多种环境中的有效性。表中数据均衡量 memmap_init_zone_device 阶段的耗时。
5. 当设备足够快:为小块 Direct I/O 建立 iomap 快速路径
随着 Gen5 NVMe 等高速存储设备不断提升性能,瓶颈开始从硬件转移到内核软件路径。在 4 KiB 随机读测试中,原始块设备可以达到约 320 万 IOPS,而经过 ext4 或 XFS 的 iomap Direct I/O 通用路径时,性能约为 192 万 IOPS。
性能分析显示,内存分配、iomap 状态机迭代和异步完成处理占用了相当比例的 CPU 时间。对于一个位于单个文件系统块内、无需拆分、无需加密和特殊回调的简单读请求,完整通用路径所提供的复杂能力并没有全部被使用。
我们因此为符合条件的小块只读 Direct I/O 建立了一条轻量快速路径。请求状态与 bio 使用一次分配,常见成功场景直接完成;不满足条件的复杂请求仍然进入原有通用路径,从而保持已有功能和语义。
在原始单核 io_uring poll-mode 测试中,ext4 的 4 KiB 随机读性能从约 192 万 IOPS 提升到 219 万 IOPS。在更完整的 fio 测试矩阵中:
ext4 在不同队列深度和 I/O 模式下最高提升 10.06%;
XFS 最高提升 9.76%;
在所列低队列深度测试中,性能与原有实现基本持平。
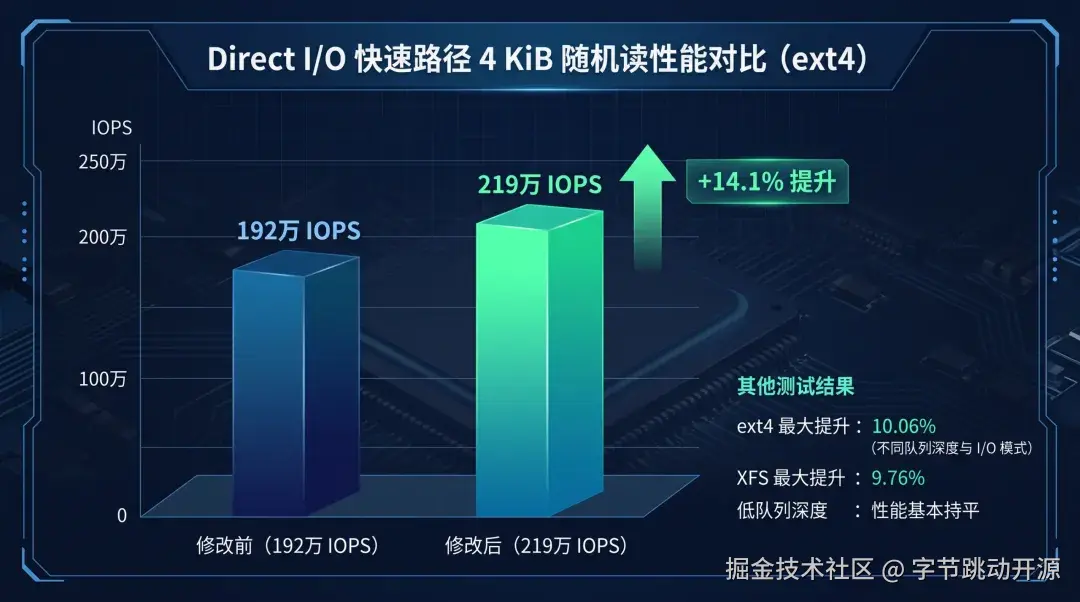
这一案例体现了 Linux 通用基础设施的价值:对 iomap 中一条公共路径的优化,可以同时惠及 ext4 和 XFS 等多个文件系统。
二、从关键机制到多元生态
从故障现场到稳定内核
除了完整的功能和优化系列,我们自 2026 年以来被社区接收的代码提交中,还有 52 个明确标记了所修复的历史变更,32 个被抄送至稳定版维护团队。这些改动覆盖崩溃、资源泄漏、并发竞争、错误计费和硬件异常等多类问题。
其中一些问题直接来自复杂生产环境。
在设备直通场景中,PCIe endpoint 的链路可能因为 surprise removal 或链路故障而失联。如果 Intel IOMMU 此时仍然向已经不可访问的设备发送 ATS invalidation,并同步等待完成,宿主机可能永久卡住。我们针对传统模式和 scalable mode 分别完善了设备可访问性检查,避免 QEMU、DPDK 等用户态设备使用场景在异常链路下将故障扩大为 hardlockup。
在 core scheduling 场景中,newidle balance 可以在暂时释放 core-wide lock 时迁移任务,导致同一个任务被两个 sibling CPU 同时选中并触发内核警告或崩溃。相关修复恢复了 core scheduling 下的正确重试语义。
其他代表性修复还包括:
修复 VDUSE 消息超时与读取并发导致的 double list deletion;
修复 HVO rollback 恢复错误的 head-page 元数据;
修复 userfaultfd 为其他进程填充 HugeTLB 时,内存被计费到 handler memcg 的问题;
修复 memory hotplug、CMA、shrinker 和 MGLRU 中的资源泄漏与竞争;
修复 ext4、EROFS、NFS、FUSE、device-mapper 和网络驱动中的正确性问题。
这些工作未必都适合单独成为一篇长故事,但它们共同构成了内核社区的重要日常:从真实故障中定位根因,将修复放回通用代码,并为稳定版内核的后续回移提供依据。
延伸到更多架构:页表回收与 RISC-V 生态
在内存回收方向,我们还将 PT_RECLAIM(页表回收) 扩展到更多体系结构。在 64 位系统中,对 100 GB 以上的大范围映射执行 madvise(MADV_DONTNEED) 后,可能留下大量空的 PTE 页表页。相关 8 个补丁完善了 Kconfig 依赖,并为 alpha、UML、parisc、MIPS 和 LoongArch 等架构补齐所需能力,使 PT_RECLAIM 可以在更多平台默认工作。
我们对 RISC-V 的贡献则覆盖内存管理、性能分析、异常处理和虚拟化等多个层面,包括:
在 update_mmu_cache 路径使用 ASID,并在可用时采用 Svinval;
修复 THP split 中 page-table-check 对临时无效 PMD 的错误统计;
完善 ftrace、stacktrace 和 kprobes 的正确性;
增加 hardware error trap handler 支持;
修复 hwprobe 与用户态启动之间的初始化时序;
完善 KVM guest interrupt file 和指令扩展支持。
与此同时,我们还向 perf、ftrace、cgroup selftests 和 livepatch selftests 等工具与测试基础设施贡献修复。内核能力能否被稳定使用,既依赖核心实现,也依赖持续演进的验证工具。
三、双向参与:既贡献方案,也为社区代码把关
Linux 内核是由全球开发者共同维护的协作工程。一个补丁从提出到合入,不仅需要作者完成设计和实现,也离不开熟悉相关子系统的开发者检查正确性、并发边界、体系结构差异和长期维护成本。
我们之所以投入精力对其他开发者的补丁进行深入审阅,是因为内核是共享的基础设施:社区贡献者提交的改进同样会进入我们使用的内核,其质量直接关系到业务的稳定性与性能。因此,这种审阅并非单向付出,而是一个共同受益的过程------它帮助贡献者发现潜在问题、厘清设计边界、验证不同配置,让方案更易长期维护;而经过打磨的改进最终也会回馈到我们的生产环境中,形成彼此促进的良性循环。
这种持续投入也体现在社区正式角色的积累上。截至目前,我们已有多位工程师被列入 Linux 内核的 MAINTAINERS 文件,在内存管理等核心子系统中担任维护者(Maintainer)或审阅者(Reviewer)。其中,团队中有工程师担任 HugeTLB 子系统的 Maintainer,并负责 memcg 与 shrinker 的 Review;其他成员还分别承担 shrinker、MGLRU(Multi-Gen LRU)、内存回收(Reclaim)、RISC-V QoS Resctrl、zswap 压缩交换缓存和 KSM(Kernel Samepage Merging)等方向的 Reviewer 工作。此外,团队中还有工程师担任 RISC-V 国际组织虚拟机管理程序特别兴趣小组(Hypervisor SIG)副主席。这些角色既是社区对我们技术能力的认可,也意味着我们需要持续投入精力保障相关子系统的代码质量与长期演进。
让长期积累的技术经验服务更多贡献者
2026 年以来,我们为社区贡献了 76 条 Reviewed-by 和 48 条 Acked-by,覆盖 113 个不同补丁。
其中,我们主要围绕内存管理核心机制参与社区审阅,相关工作覆盖 HugeTLB、memcg 与 shrinker、vmscan、sparse-vmemmap 和页表回收等领域。
从内存管理走向虚拟化、存储、调度及 RISC-V 生态
我们参与审阅的补丁中,有 82 个涉及 mm 目录。除此之外,Review 足迹还延伸到内核核心代码、VDUSE、HugeTLB 文件系统、iomap、x86 内存管理、live update 以及 RISC-V 生态建设等方向。
我们重点参与了 VDUSE、iomap、块设备 polling、scheduler cgroup migration 和 RISC-V 生态等方向的补丁审阅。这些工作将我们在生产系统中积累的虚拟化、存储和调度经验带入更广泛的社区协作。
在开放协作中共同完善方案
我们提交的工作同样在社区审阅中不断演进。允许 IPI completion waiting 恢复抢占的系列经历了 10 个版本,社区反馈推动方案调整 cpumask 存储方式、CPU hotplug 下的生命周期、x86 栈对象对齐方式和虚拟化后端的保护边界,并补充构建修复、微基准与 torture test。
HVO 相关工作则通过拆分和重组,将较大的通用化目标整理为 bootmem HugeTLB 重构、正确性修复、通用 PMD helper 和 section-based HVO 等可独立审阅的步骤。iomap 快速路径也在文件系统社区的审阅和整合下,形成了边界严格、同时适用于 ext4 和 XFS 的通用实现。
一边接受全球社区对我们代码的审阅,一边以 Reviewed-by 和 Acked-by 帮助其他开发者推进工作,我们正通过这种双向协作,持续参与 Linux 内核的长期演进。
四、持续把生产实践和技术判断沉淀为社区能力
2026 年以来,我们的 Linux 内核社区贡献既有 198 个被接收的代码提交,也有覆盖 113 个社区补丁的 Review 与 Ack。比数字本身更重要的,是这些工作形成了一条持续运转的路径:从生产环境发现并复现问题,深入核心代码寻找根因;以可维护、可验证的方式提出通用方案;在社区反馈中反复完善设计;再将积累下来的技术判断用于审阅其他开发者的工作。
从改善实时任务的调度长尾,到治理容器退出后的内存生命周期;从推动 HVO 基础设施演进,到提升大容量内存设备和高速存储的效率;从贡献自己的补丁,到帮助社区开发者完善更多有价值的改动,我们将继续参与 Linux 内核社区建设,与全球开发者一起推动基础软件长期演进。