源码锚点 :AOSP bionic(
malloc_common.cpp/malloc_heapprofd.cpp)、Perfetto(sampler.h/malloc_interceptor_bionic_hooks.cc),部分内容以 Android 17 / android-17.0.0_r1 为基准。为控制篇幅,源码片段有删减,但关键逻辑与官方源码一致。阅读收益:读完这篇,你会彻底搞懂三件事------① Native Heap 为什么难监控;② Google 官方的 heapprofd 是如何"不写一行业务代码"就拿到全进程 malloc 调用栈的;③ 线上和线下各自该用什么姿势监控与优化。
前言:Java 堆有 GC 护体,Native 堆在"裸奔"
做过内存优化的同学都知道,Java 堆出事了有 GC、有 LeakCanary、有 HPROF,工具链一应俱全。但一旦泄漏发生在 Native 堆 (C/C++ 代码里 malloc/new 出来的那部分内存),很多同学就抓瞎了:
- Bitmap 像素数据(Android 8.0+)、三方 SDK 的音视频 buffer、游戏引擎的内存池......全在 Native 堆里;
- Java 堆明明很干净,PSS 却一路上涨,最后进程被 LMK 干掉;
- 想查,却不知道是谁分配的、在哪个调用栈上分配的、为什么没释放。
这篇文章用一个贯穿全文的故事,把 Native Heap 监控的完整原理讲透:从最便宜的计数器,到自建 malloc hook,再到 Google 官方的"侦探"heapprofd,最后落到线上分层监控的落地实践。
一、故事开场:内存大饭店的仓库
把一个 App 进程想象成一家内存大饭店:
| 故事角色 | 现实对应 | 说明 |
|---|---|---|
| 饭店的仓库 | Native Heap | 存放 C/C++ 对象的地方 |
| 仓库管理员 | malloc / free(分配器 Scudo) |
负责发货架、收货架 |
| 国土资源局 | 内核 | 管理地皮(虚拟内存),按"页"划地 |
| 仓库向国土局租的地 | mmap 映射的页 | 分配器向内核要的内存 |
| 仓库门口的计数器 | mallinfo() |
便宜,但只报总数 |
| 电表读数 | RSS | 实际占用的物理内存 |
| 楼里各家分摊的水费 | PSS | 共享页按比例分摊 |
| 各部门自己记的台账 | owner counters | 业务组件自己数的资源 |
| 总部派来的侦探 | heapprofd | 随机抽查登记,账本记在总部 |
饭店开业后,生意火爆。但某天你发现一个诡异的现象:仓库占地(RSS)只涨不跌。
你去找仓库管理员对账,管理员一脸无辜:"我账上(allocator 视角)确实收了一批货架没还回来,但你看门口计数器,数字对得上啊!"
问题出在哪?你根本不知道是哪个部门、哪一天、为了存什么货、从哪个门把货架搬进来的。
这就是 Native 内存泄漏的困境:只进不出、无人登记、无人认领。而 Native Heap 监控的本质,就是解决三个问题:
- 哪类内存在涨? (allocator?mmap?图形内存?)
- 是谁分配的? (调用栈归因)
- 是不是该释放而没释放? (对照业务生命周期)
二、第一课:先分清"四本账",否则监控必翻车
这是小白最容易翻车的地方,也是全文最重要的一节。很多人把四个数字都叫"Native 内存",于是告警互相打架,定位南辕北辙。
2.1 四本账各自记的是什么
css
┌─────────────────────────────────────────────────────────┐
│  国土资源局(内核)视角:进程的虚拟地址空间                │
│                                                         │
│  [anon:scudo:*] ← 分配器租的地(Native Allocator)        │
│  [heap]          ← 传统 brk 堆(现代 Android 很少用)      │
│  dalvik-*        ← Java 堆                              │
│  [anon:业务命名]  ← 自研内存池(直接 mmap,绕过管理员!)    │
│  dmabuf/GPU      ← 图形缓冲区                            │
└─────────────────────────────────────────────────────────┘| 维度 | 典型来源 | 能回答的问题 | 不能回答的问题 |
|---|---|---|---|
| allocator live bytes | mallinfo().uordblks、Debug.getNativeHeapAllocatedSize() |
管理员认为还有多少货架没还 | 哪个对象该释放;mmap/GPU 占用 |
| RSS | /proc/self/status |
当前实际占用多少物理内存 | 共享页归属、分配调用栈 |
| PSS | smaps_rollup、dumpsys meminfo |
共享页分摊后的进程占用 | 一次分配的调用栈 |
| mmap / 图形内存 | smaps、memtrack、dmabuf_dump |
绕过 malloc 的内存在哪 | malloc 内部细节 |
三个经典误判,请刻在 DNA 里:
- RSS 涨 ≠ 泄漏。新触达的代码页、文件页、线程栈、分配器保留页都会抬高 RSS;
uordblks回落而 RSS 不回落 ≠ free 失效。Scudo 这个"仓库管理员"很节俭,还回来的货架他先留在自己手里(页缓存),不一定马上退租给国土局;- Native Heap 平稳 ≠ Native 内存平稳 。自研内存池
mmap(MAP_ANONYMOUS)、GraphicBuffer、dma-buf 全都绕过 malloc,管理员账上根本看不到。
2.2 门口计数器:mallinfo 的源码真相
mallinfo() 就是仓库门口那个便宜的计数器。看 Android 17 bionic 里 Scudo 是怎么填充它的(scudo 的 C 包装层):
arduino
// 各字段的实际语义(Android 17 Scudo 实现):
//   uordblks  → allocated bytes(在用字节)
//   fordblks  → free bytes(空闲字节)
//   hblkhd    → mapped bytes(向内核映射的字节)
//   usmblks   → mapped bytes(同 hblkhd)
//   fsmblks   → free bytes
Java 侧大家常用的 Debug.getNativeHeapAllocatedSize(),本质就是它------frameworks/base 的 android_os_Debug.cpp 里直接调 mallinfo() 返回 uordblks:
ruby
// frameworks/base/core/jni/android_os_Debug.cpp(逻辑摘录)
// getNativeHeapAllocatedSize() → mallinfo().uordblks
// getNativeHeapSize()          → mallinfo().usmblks
// getNativeHeapFreeSize()      → mallinfo().fordblks
注意:bionic 头文件官方吐槽它是 "inherently unreliable" (天然不可靠)------不同 allocator、不同 sanitizer 下语义会变。但它足够便宜 (不涉及栈回溯、不涉及 I/O),所以它是线上 L0 常驻监控的不二之选:
arduino
#include <malloc.h>
#include <cstdint>
struct NativeAllocatorSnapshot {
uint64_t allocated_bytes;
uint64_t free_bytes;
uint64_t mapped_bytes;
};
// 低频采集(秒级/分钟级),配合单调时钟记录趋势
NativeAllocatorSnapshot ReadNativeAllocatorSnapshot() {
const struct mallinfo info = mallinfo();
return {
.allocated_bytes = static_cast<uint64_t>(info.uordblks),
.free_bytes = static_cast<uint64_t>(info.fordblks),
.mapped_bytes = static_cast<uint64_t>(info.hblkhd),
};
}顺带一个 Android 17 的冷知识:bionic 里 struct mallinfo 的字段已经是 size_t,所谓解决 64 位溢出的 mallinfo2() 只是 __RENAME(mallinfo) 指向同一个符号------别把 glibc 的版本经验套到 bionic 上。
小结 :mallinfo 是趋势计数器,不是泄漏证明。它回答"哪类内存在涨"中的第一环:allocator 视角的内存涨没涨。
三、监控流派一:给搬运工发登记牌(自建 malloc hook)
门口计数器只能报总数,想知道"谁 搬进来的",第一个直觉是:在每个入口安插保安,登记每个进出的人。这就是 malloc/free hook。
3.1 PLT/GOT Hook 的原理
Android 上三方 App 可控的主流方案是 PLT/GOT Hook (xhook、bhook、ByteHook、ShadowHook 的 PLT 模式)。原理一句话:不改仓库管理员,改各部门的通讯录。
每个 .so(ELF 文件)对外部函数(如 malloc)的调用,都要经过一张"通讯录"------GOT 表(Global Offset Table)。动态链接器 linker 装载时把 malloc 的真实地址填进 GOT 槽位。Hook 框架做的事,就是把槽位里的地址偷换成保安(proxy 函数)的地址:
c
libfoo.so 内部调用 malloc()
        │
        ▼
查 libfoo.so 自己的 GOT 槽位 ──── 原本指向 libc 的 malloc
        │(Hook 后)
        ▼
proxy 函数(保安):登记 → 调原函数 → 放行
用源码说话,Android 17 linker(linker/soinfo.cpp)装载时通过重定位填槽:
scss
// bionic/linker/soinfo.cpp --- process_relocation_impl() fast path
if (r_type == R_GENERIC_JUMP_SLOT) {
  const ElfW(Addr) result = sym_addr + get_addend_norel();
  *static_cast<ElfW(Addr)*>(rel_target) = result;  // 把 malloc 地址写入 GOT 槽
  return true;
}
Hook 框架的安装流程(自建时必须完整走一遍,漏一步都是线上事故):
c
dl_iterate_phdr() 枚举 ELF
  → 解析 PT_DYNAMIC(DT_JMPREL / DT_SYMTAB / DT_STRTAB)
  → 定位 R_AARCH64_JUMP_SLOT 且符号名为 malloc/free 的槽
  → 读取槽所在页的原权限,mprotect 加写权限(注意 RELRO 已把 GOT 改为只读!)
  → 保存 orig(原函数地址,必须先于新槽值发布)
  → 原子写(对齐指针写)更新槽位为 proxy 地址
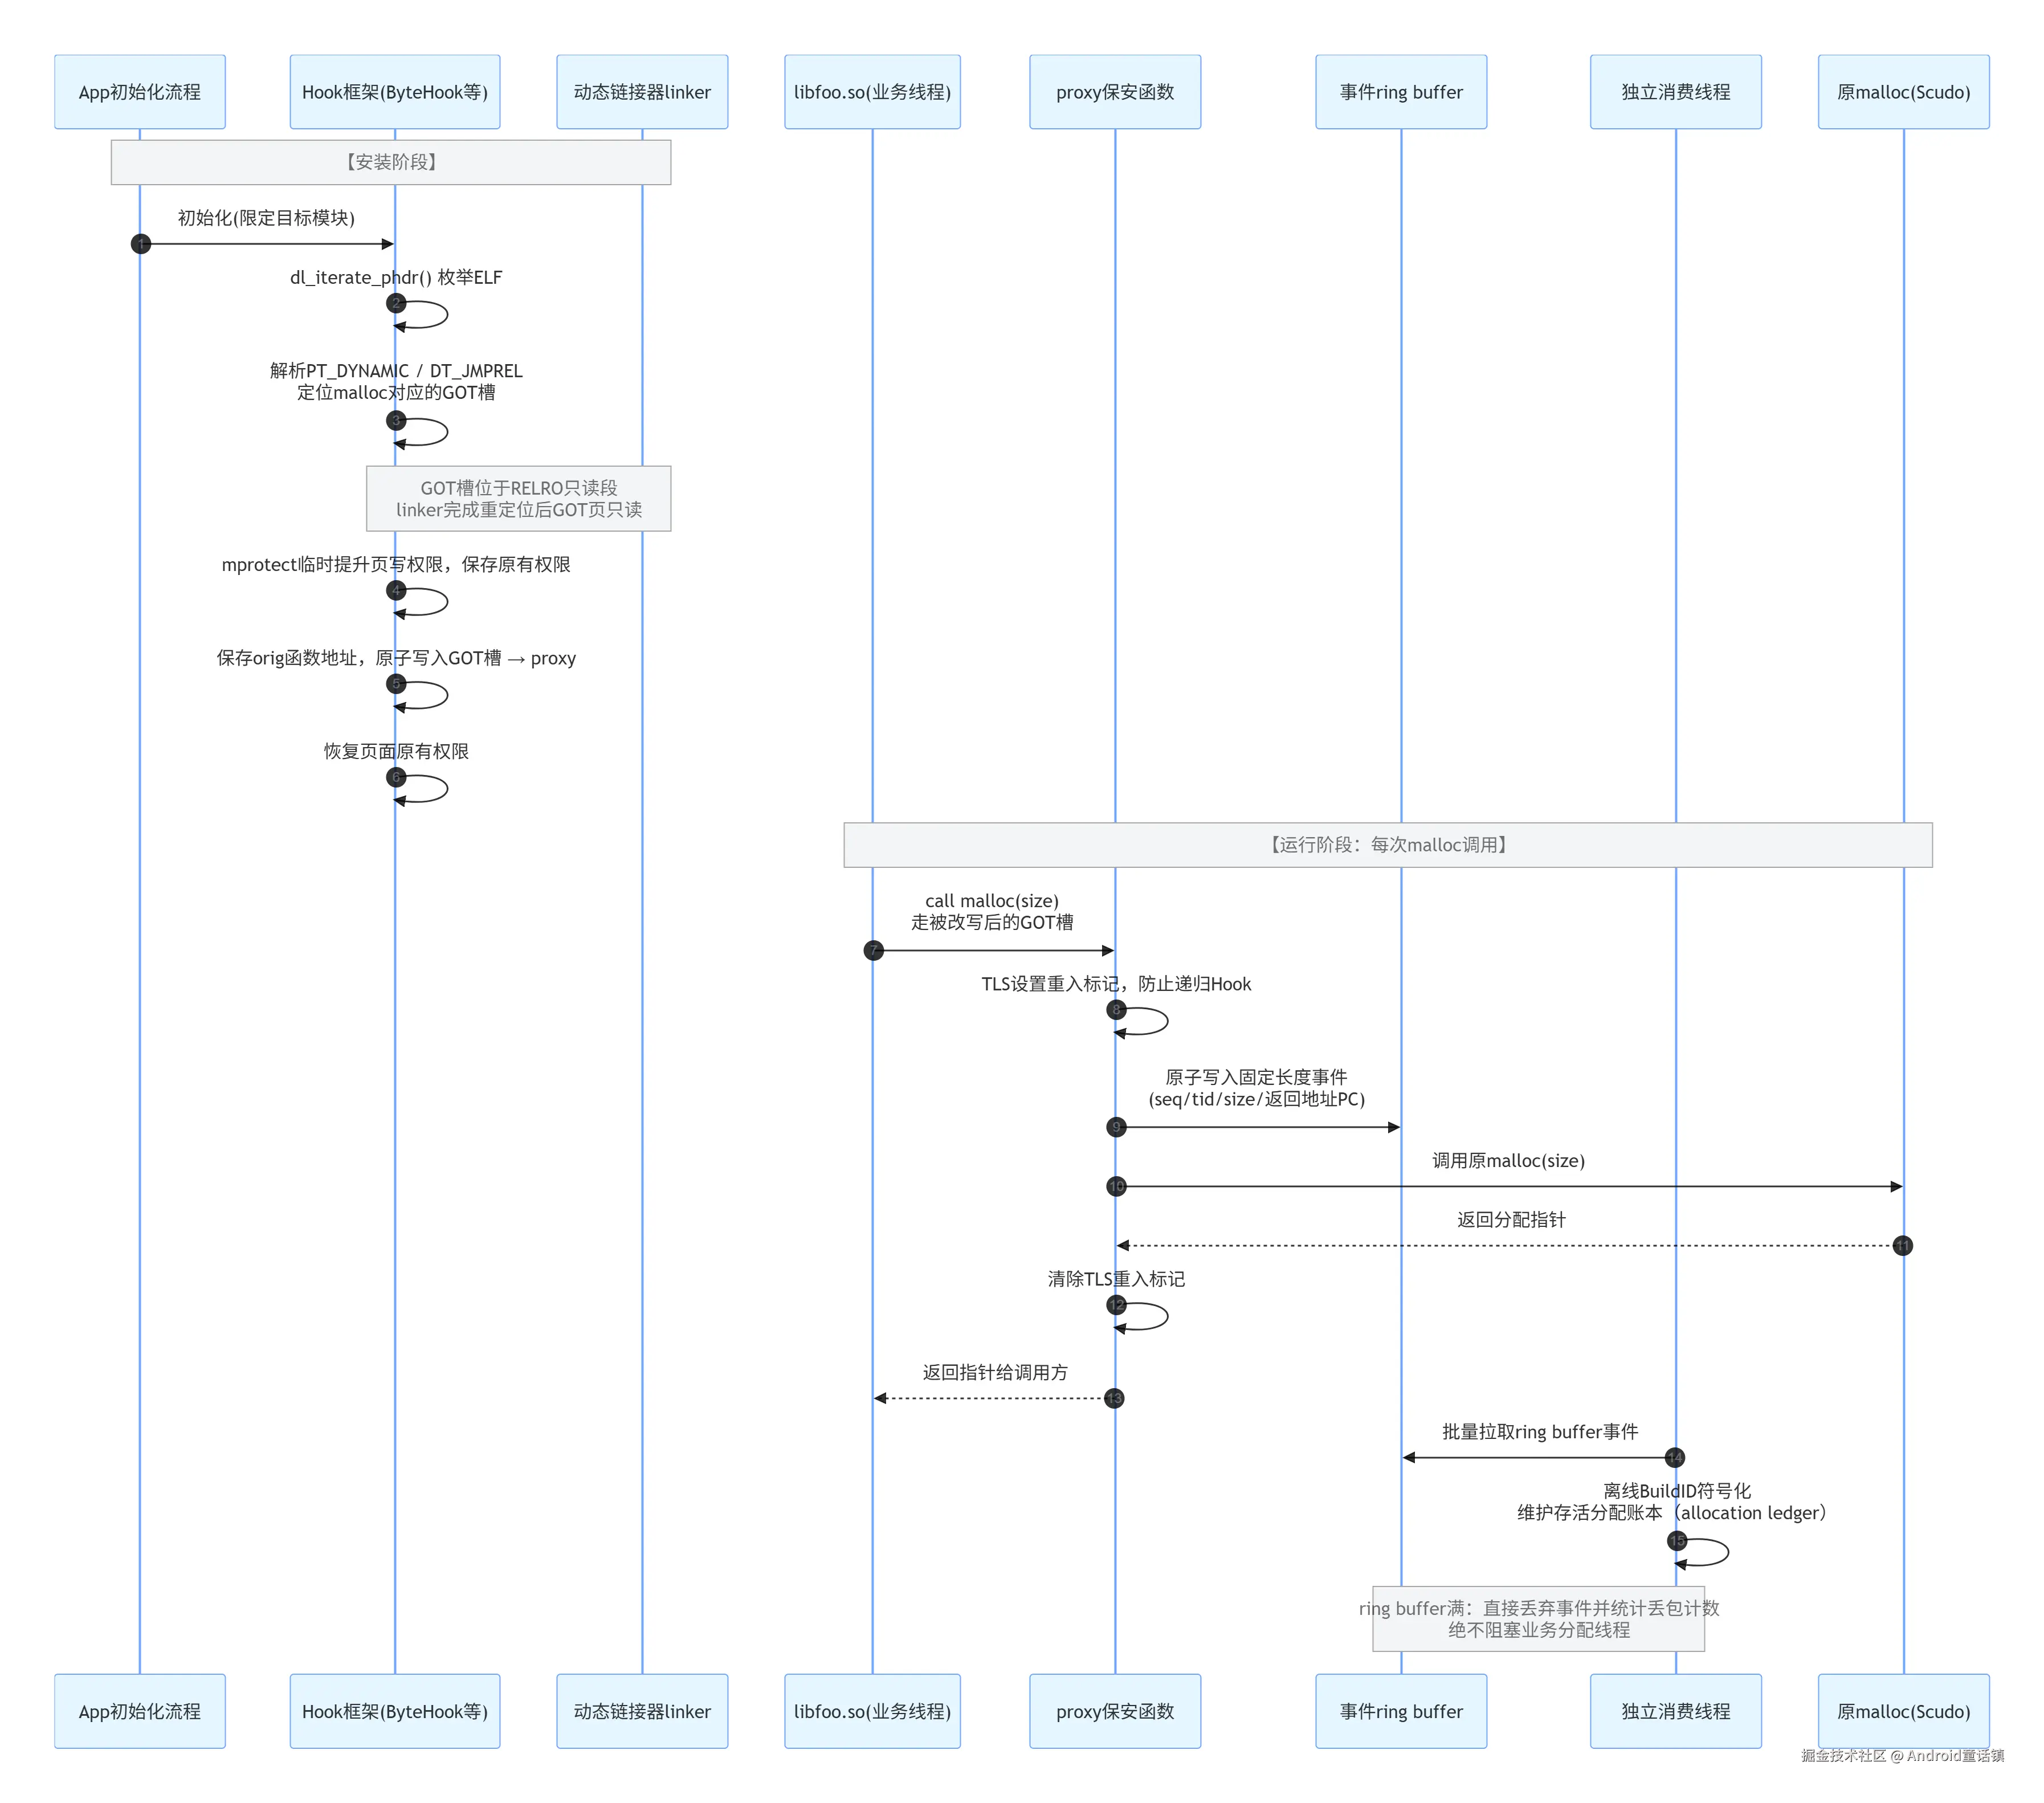
3.2 时序图:PLT/GOT Hook 自建监控的完整过程
scss
App初始化流程Hook框架(ByteHook等)动态链接器linkerlibfoo.so(业务线程)proxy保安函数事件ring buffer独立消费线程原malloc(Scudo)安装阶段初始化(限定目标模块)1dl_iterate_phdr() 枚举ELF2解析PT_DYNAMIC/DT_JMPREL定位malloc的GOT槽3槽位于RELRO只读段(linker已把GOT改只读)记录原页权限, mprotect临时加写权限4保存orig → 原子写GOT槽=proxy5恢复(或记录)页权限6运行阶段(每次调用)call malloc(size)(经被改写的GOT槽)7TLS重入标记(防递归)8原子写入固定长度事件(seq/tid/size/返回地址PC)9调原函数malloc(size)10返回指针11返回指针12批量取事件13离线按Build ID符号化维护"存活分配"账本14buffer满→丢弃并计数,绝不阻塞分配线程App初始化流程Hook框架(ByteHook等)动态链接器linkerlibfoo.so(业务线程)proxy保安函数事件ring buffer独立消费线程原malloc(Scudo)3.3 保安的四个坑(自建 hook 的血泪史)
故事里保安看着简单,实操全是坑,每一条都对应真实的线上事故:
坑一:只 hook malloc/free 会记错账。 完整的"存活分配"账本至少要覆盖:calloc、realloc、posix_memalign、aligned_alloc、C++ 的 new/delete 全家桶。其中 realloc 的语义最容易写错------传 nullptr 等价于 malloc;失败返回 nullptr 时旧分配仍有效;成功后地址可能原地不动也可能搬家。
坑二:覆盖范围永远不完整。 PLT hook 只能改写"选定的那几个 ELF 经由 GOT 发出的调用"。这些情况全部漏掉:编译器内联、-Bsymbolic 本地绑定、dlsym 拿到函数指针后直接调用、hook 安装之后 dlopen 进来的新模块、自带内存池的引擎。而且 Android 17 linker 不支持 RTLD_LAZY (DT_PLTGOT 分支直接注释 Ignored (because RTLD_LAZY is not supported) ),所有重定位在装载期就完成------所以"新装进来的库"必须重新扫描,否则就是盲区。
坑三:保安自己不能动仓库。 proxy 函数里绝不能 出现可能再分配内存的东西:std::string、STL 容器、日志格式化、在线符号化。否则保安登记时又去搬货架,无限递归直接爆栈。稳妥做法:
diff
TLS 线程局部重入标记
+ 预分配有界 ring buffer
+ 固定长度事件(原子写,只存少量原始 PC)
+ 独立消费线程
+ 离线按 Build ID 符号化
+ 缓冲满 → 丢弃并计数,不阻塞分配线程
+ 远程开关、时限、白名单、崩溃熔断
坑四:"每 1000 次抽 1 次"的采样有偏。 按次数采样会偏向高频小对象:一次 64MB 的分配和一次 32B 的分配入样概率相同。要么按尺寸分层,要么按字节权重采样------而这个问题的"标准答案",正是下一节官方侦探 heapprofd 的核心算法。
四、主角登场:heapprofd,总部派来的侦探
自建 hook 是"散装保安",问题多、成本高、覆盖窄。那有没有一套系统级、不侵入业务代码、自带采样算法的方案?
有。heapprofd ------Perfetto 的 Native 堆采样器,Android 10 起内置,Android 17 持续演进。它能做到:给任意目标进程的 malloc/free 按调用栈采样,回答"采集窗口内,哪些调用栈产生了仍未释放的 native 分配"。
4.1 整体架构:总部、侦探与卧底
先看角色分工(故事继续):
| 组件 | 故事角色 | 职责 |
|---|---|---|
traced |
监控中心总部 | 管理 Perfetto 跟踪会话,接收配置 |
heapprofd daemon |
外派侦探 | 找到目标、下达指令、还原调用栈、记账 |
| 目标进程内的 heapprofd client | 卧底 | 拦截 malloc/free、采样、写入共享内存 |
| 共享内存 ring buffer | 死信箱 | 卧底与侦探的传纸条通道 |
| unwinder + bookkeeping | 侦探的账本 | 栈还原 + 按调用栈聚合的"存活分配"账 |
关键设计:卧底只做最轻的活 (采样判定 + 写共享内存),重活全在侦探侧(栈还原、聚合、落盘)。这是它能做到低开销的根本原因。
4.2 一切的钥匙:bionic 的 MallocDispatch 分发表
heapprofd 能"不碰一行业务代码"就拦截全进程 malloc,靠的是 bionic 官方预留的 hook 机制 ------malloc dispatch(分发表)。
打开 bionic/libc/bionic/malloc_common.cpp,每个分配函数都长这样:
scss
// bionic/libc/bionic/malloc_common.cpp(核心路由逻辑)
void* malloc(size_t bytes) {
  auto dispatch_table = GetDispatchTable();   // 当前生效的分发表
  void* result;
  if (__predict_false(dispatch_table != nullptr)) {
    result = dispatch_table->malloc(bytes);   // 表非空 → 走 hook(heapprofd/debug...)
  } else {
    result = Malloc(bytes);                   // 表为空 → 走默认分配器(Scudo)
  }
  return MaybeTagPointer(result);
}
GetDispatchTable() 非空时,所有分配都被转发到分发表里的实现。这条机制同时服务于:heapprofd(采样分析)、malloc debug(调试检查)、GWP-ASan(内存安全抽样检测)。这是官方正门,不是野路子------它和修改 PLT 的三方 hook 有本质区别:分发表是进程级的,一个槽都不漏(只要走 libc 分配接口)。
4.3 一条神秘信号 __SIGRTMIN + 4:卧底是怎么上岗的
detective 上岗流程堪称教科书级的"信号驱动 + 延迟安装"。看 bionic 的 malloc_heapprofd.cpp:
arduino
// bionic/libc/bionic/malloc_heapprofd.cpp(关键常量与逻辑)
static constexpr char kHeapprofdSharedLib[] = "heapprofd_client.so";
static constexpr char kHeapprofdPropertyEnable[] = "heapprofd.enable";
constexpr char kHeapprofdProgramPropertyPrefix[] = "heapprofd.enable.";
// 侦探与卧底约定的暗号信号:实时信号 __SIGRTMIN + 4,且载荷 si_value 必须为 0
static constexpr int kHeapprofdSignal = __SIGRTMIN + 4;
信号处理函数 HandleHeapprofdSignal() 做的事极其克制 :通过 CAS 状态机切换到 kInstallingEphemeralHook 态,把临时钩子挂上分发表(gEphemeralDispatch.malloc = MallocInitHeapprofdHook),然后立刻返回 。为什么不在信号处理函数里直接安装?因为 signal handler 必须是 async-signal-safe 的------dlopen 这种大家伙绝不能在里面干。于是真正的安装被推迟到下一次 malloc:临时钩子被命中后,拉起一条专用初始化线程去干重活:
scss
// bionic malloc_heapprofd.cpp --- CommonInstallHooks()(逻辑摘录)
impl_handle = LoadSharedLibrary(kHeapprofdSharedLib,   // dlopen("heapprofd_client.so")
                                kHeapprofdPrefix,
                                &globals->malloc_dispatch_table);
FinishInstallHooks(globals, nullptr, kHeapprofdPrefix); // 整表替换 dispatch
heapprofd_client.so 的初始化函数(heapprofd_initialize)则来自 Perfetto 侧(src/profiling/memory/malloc_interceptor_bionic_hooks.cc):
less
// perfetto src/profiling/memory/malloc_interceptor_bionic_hooks.cc(逻辑摘录)
// 1) 把"真分配器"的分发表原子保存下来,之后每次拦截都要靠它调真函数
g_dispatch.store(malloc_dispatch);
// 2) 注册名为 "libc.malloc" 的 heap,并挂上禁用回调
AHeapProfile_registerHeap(
    AHeapInfo_setDisabledCallback(AHeapInfo_create("libc.malloc"), ...));
// 3) 禁用时通过 android_mallopt(M_RESET_HOOKS) 让 bionic 自行卸载钩子
还有一个启动期入口:侦探在会话开始时设置系统属性 heapprofd.enable.<进程名>,新进程在初始化期间就会主动接入(适合抓启动期泄漏);no_startup / no_running 两个开关可以分别关掉启动期接入或跳过已运行进程。
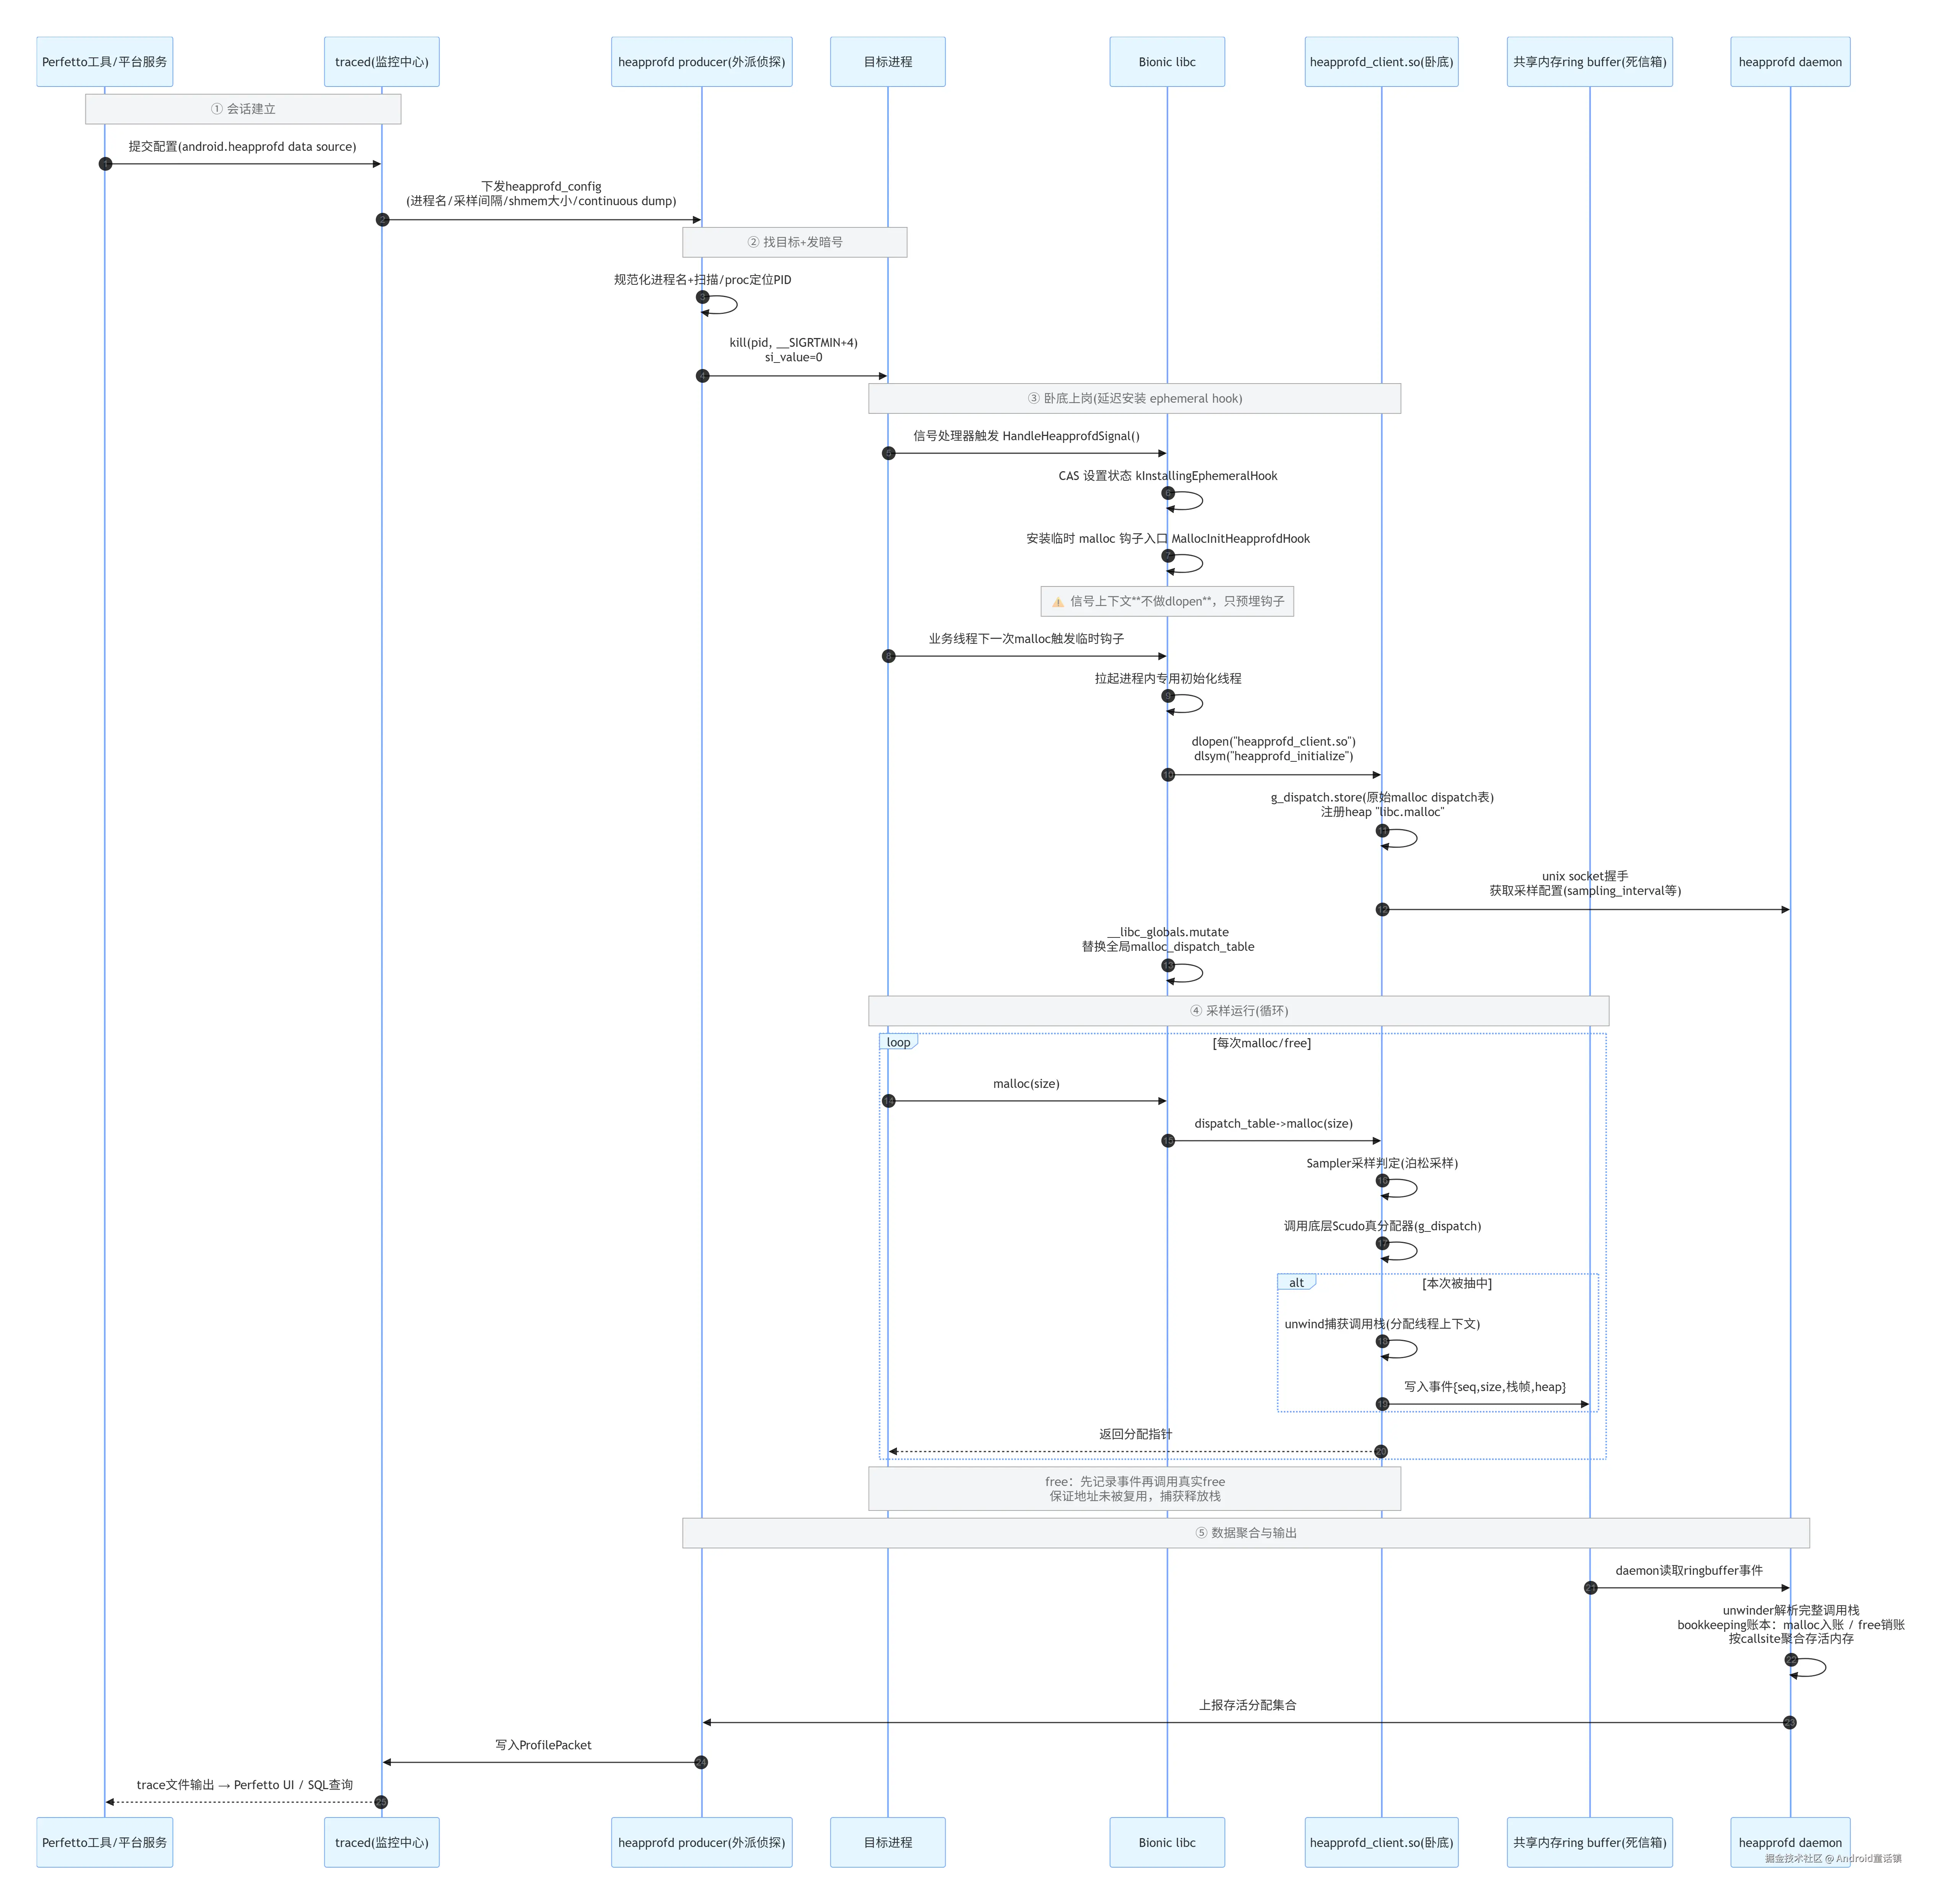
4.4 主时序图:heapprofd 从配置到出账的完整调用链
这张图是全文核心,建议对照 4.2/4.3 的源码逐行看:
scss
Perfetto工具/平台服务traced(监控中心)heapprofd producer(外派侦探)目标进程Bionic libcheapprofd_client.so(卧底)共享内存ring buffer(死信箱)heapprofd daemon① 会话建立提交配置(android.heapprofd data source)1下发heapprofd_config(进程名/采样间隔/shmem大小/continuous dump)2② 找目标+发暗号规范化进程名+扫描/proc定位PID3kill(pid, __SIGRTMIN+4)si_value=04③ 卧底上岗(延迟安装)HandleHeapprofdSignal()CAS→kInstallingEphemeralHook5gEphemeralDispatch.malloc=MallocInitHeapprofdHook6业务线程下一次malloc7临时钩子触发→拉起专用初始化线程8dlopen("heapprofd_client.so")dlsym("heapprofd_initialize")9g_dispatch.store(原dispatch)注册heap "libc.malloc"10连接/socket握手获取采样配置(sampling_interval等)11__libc_globals.mutate整表替换malloc_dispatch_table12④ 采样运行(循环)malloc(size)13dispatch_table->malloc(size)14Sampler采样判定(见4.5)15调真分配器(经g_dispatch→Scudo)16unwind调用栈(在分配线程)17写入{seq,size,栈帧,heap}18alt[本次被抽中]返回指针19loop[每次malloc/free]free在真free之前先记账(保证地址未被复用)⑤ 还原与出账侦探读取事件20unwinder还原调用栈bookkeeping维护存活账本(malloc入账/free销账,按callsite聚合)21报告存活分配集合22写ProfilePacket23trace文件→Perfetto UI/SQL分析24Perfetto工具/平台服务traced(监控中心)heapprofd producer(外派侦探)目标进程Bionic libcheapprofd_client.so(卧底)共享内存ring buffer(死信箱)heapprofd daemon4.5 灵魂拷问:为什么是"随机抽查"而不是全量记录?
全量记录每次 malloc 的调用栈?分配热的进程(如图片解码)每秒几十万次分配,开销会吃掉你的帧预算。heapprofd 的答案:按字节权重的不重置抽样(泊松采样) ------海关不搜查每个箱子,而是"平均每 N 元货值抽查 1 元"。
看 Perfetto 的 sampler.h(这是我认为全链路里最优雅的一段代码):
c
// perfetto src/profiling/memory/sampler.h(核心逻辑,Apache-2.0)
void SetSamplingInterval(uint64_t sampling_interval) {
sampling_rate_ = 1.0 / static_cast<double>(sampling_interval);
// 初始化时随机决定"距下一次抽样的字节数"
interval_to_next_sample_ = NextSampleInterval();
}
// 抽样间隔服从指数分布(泊松过程的几何近似):
// 平均每 sampling_interval 字节抽一次,但间隔完全随机
int64_t NextSampleInterval() {
std::exponential_distribution<double> dist(sampling_rate_);
return static_cast<int64_t>(dist(GetGlobalRandomEngineLocked())) + 1;
}
// 每次分配消耗"倒计时",归零即抽中
size_t NumberOfSamples(size_t alloc_sz) {
interval_to_next_sample_ -= alloc_sz;
size_t num_samples = 0;
while (PERFETTO_UNLIKELY(interval_to_next_sample_ <= 0)) {
interval_to_next_sample_ += NextSampleInterval();
++num_samples; // 超大分配一次可能"抽中多次"
}
return num_samples;
}
// 被抽中的分配按 sampling_interval × 次数 记账(无偏估计!)
size_t SampleSize(size_t alloc_sz) {
if (PERFETTO_UNLIKELY(alloc_sz >= sampling_interval_))
return alloc_sz; // ≥ 采样间隔的大对象:100% 全量记录
return static_cast<size_t>(sampling_interval_ * NumberOfSamples(alloc_sz));
}这段算法精妙在三点,值得展开讲:
- 指数分布倒计时 :不是死板的"每 4096B 抽一次",而是每次抽中后重新随机掷一个"下次还差多少字节才抽"。这样任何分配(不管它落在位置序列的哪里)被抽中的概率只和它的大小成正比------无偏;
- 大对象必抽 :
alloc_sz >= sampling_interval(默认 4096B)时直接全量记录,保证泄漏大户不会漏网; - 按权重还原总量 :抽中的分配按
sampling_interval × num_samples记账。一个 1KB 的分配被抽中后记 4KB 份额------统计意义上精确还原了总分配量,这就是官方文档说 "平均每分配 N 字节产生一个样本" 的数学含义。
对比第 3.3 节自建 hook 的"每 1000 次抽 1 次":按次数采样对字节归因是有偏的(小对象刷屏、大对象漏掉),heapprofd 的按字节泊松采样才是字节归因的正确姿势。
4.6 一个极易被忽略的细节:free 要"先记账,再放行"
arduino
// perfetto malloc_interceptor_bionic_hooks.cc(注释原意)
// 在调用真正的 free 之前先记录释放事件------
// 保证处理期间这个地址还归当前所有者独占,不会被新分配复用
为什么?如果先执行真 free 再记账,中间任何线程 malloc 都可能拿到同一个地址,侦探的账本上就会出现"张冠李戴"------A 的释放算到 B 头上。分布式系统里的"先持久化事件再应用状态",和这里是同一个思想。
4.7 侦探的账本:bookkeeping 与"未释放"视图
daemon 侧对每个事件做两件事:
- unwinder:把卧底记录的裸 PC 地址还原成完整调用栈(需要符号表/eh_frame 信息);
- bookkeeping :按 callsite(调用栈节点)维护一颗前缀树(trie) ,malloc 入账、free 按序号配对销账。
于是每次 continuous dump (周期性快照)输出的就是:当前每个调用栈上还挂着的未释放字节数 。这正是排查泄漏需要的视图------"Foo::decodeImage 这个栈上已经堆了 200MB 没释放,且三轮场景下来只涨不跌"。
用 SQL 直接查(Perfetto trace processor):
sql
-- 按 dump、进程、调用栈汇总净存活字节(正数=分配多于释放)
SELECT ts, upid, heap_name, callsite_id,
       SUM(size)  AS net_live_bytes,
       SUM(count) AS net_live_count
FROM heap_profile_allocation
GROUP BY ts, upid, heap_name, callsite_id
HAVING SUM(size) > 0
ORDER BY ts, net_live_bytes DESC;
heap_profile_allocation里正数是分配样本、负数是释放样本。同一个调用栈跨 dump 持续增长、场景退出后不回落、多轮复现一致,才构成较强的泄漏线索。
五、怎么"合法上岗":权限模型与三种采集姿势
侦探不是想当就能当的,尤其 user build(量产机) 。Android 17 的 CanProfileAndroid() 判定规则:
| 场景 | user build 上的要求 |
|---|---|
| shell 发起会话(adb / heap_profile 脚本) | 目标声明 profileable android:shell="true" 或 debuggable |
| 受信系统服务发起(trusted-system) | 目标声明 <profileable>(enabled)或 debuggable |
| 平台 UID(< AID_APP_START) | 仅 trusted-system 可采 |
| SDK sandbox 进程 | UID 映射回宿主 App 后按 profileable 判定 |
| isolated process | 从严:trusted-system + packages.list 中相关包全部允许 |
release 包最小声明(供 QA 用 adb 采线上同款包):
xml
<application ...>
    <profileable android:shell="true" />
</application>
5.1 三种采集入口
姿势一:本地开发 / QA 复现(官方脚本)
bash
# 采集 120 秒,每 30 秒 dump 一次,采样间隔 4KiB
python3 tools/heap_profile android \
  -n com.example.app \
  -i 4096 \
  -d 120000 \
  -c 30000
姿势二:手写 Perfetto textproto(把 heap profile 与调度、RSS、业务 marker 放进同一会话):
yaml
buffers { size_kb: 63488  fill_policy: RING_BUFFER }
data_sources {
  config {
    name: "android.heapprofd"
    target_buffer: 0
    heapprofd_config {
      process_cmdline: "com.example.app"      # 多进程要逐个精确填写,不支持glob!
      process_cmdline: "com.example.app:remote"
      sampling_interval_bytes: 4096           # 平均每4KiB分配抽一个样本
      shmem_size_bytes: 8388608               # 共享buffer,默认8MiB
      continuous_dump_config {
        dump_phase_ms: 30000
        dump_interval_ms: 30000
      }
    }
  }
}
duration_ms: 120000
姿势三:线上 App 自助采集(Android 15+ ProfilingManager) ------这是普通 App 在用户手机上采自己 Native 堆的唯一官方通道:
kotlin
@RequiresApi(35)
fun requestNativeHeapProfile(
    context: Context,
    executor: Executor,
    listener: Consumer<ProfilingResult>,
): CancellationSignal {
    val stopSignal = CancellationSignal()
    val request = HeapProfileRequestBuilder()
        .setTrackJavaAllocations(false)
        .setTag("native-heap")
        .setCancellationSignal(stopSignal)
        .build()
    requestProfiling(context, request, executor, listener)
    return stopSignal
}
// 场景结束后 stopSignal.cancel();结果文件在应用 files 目录
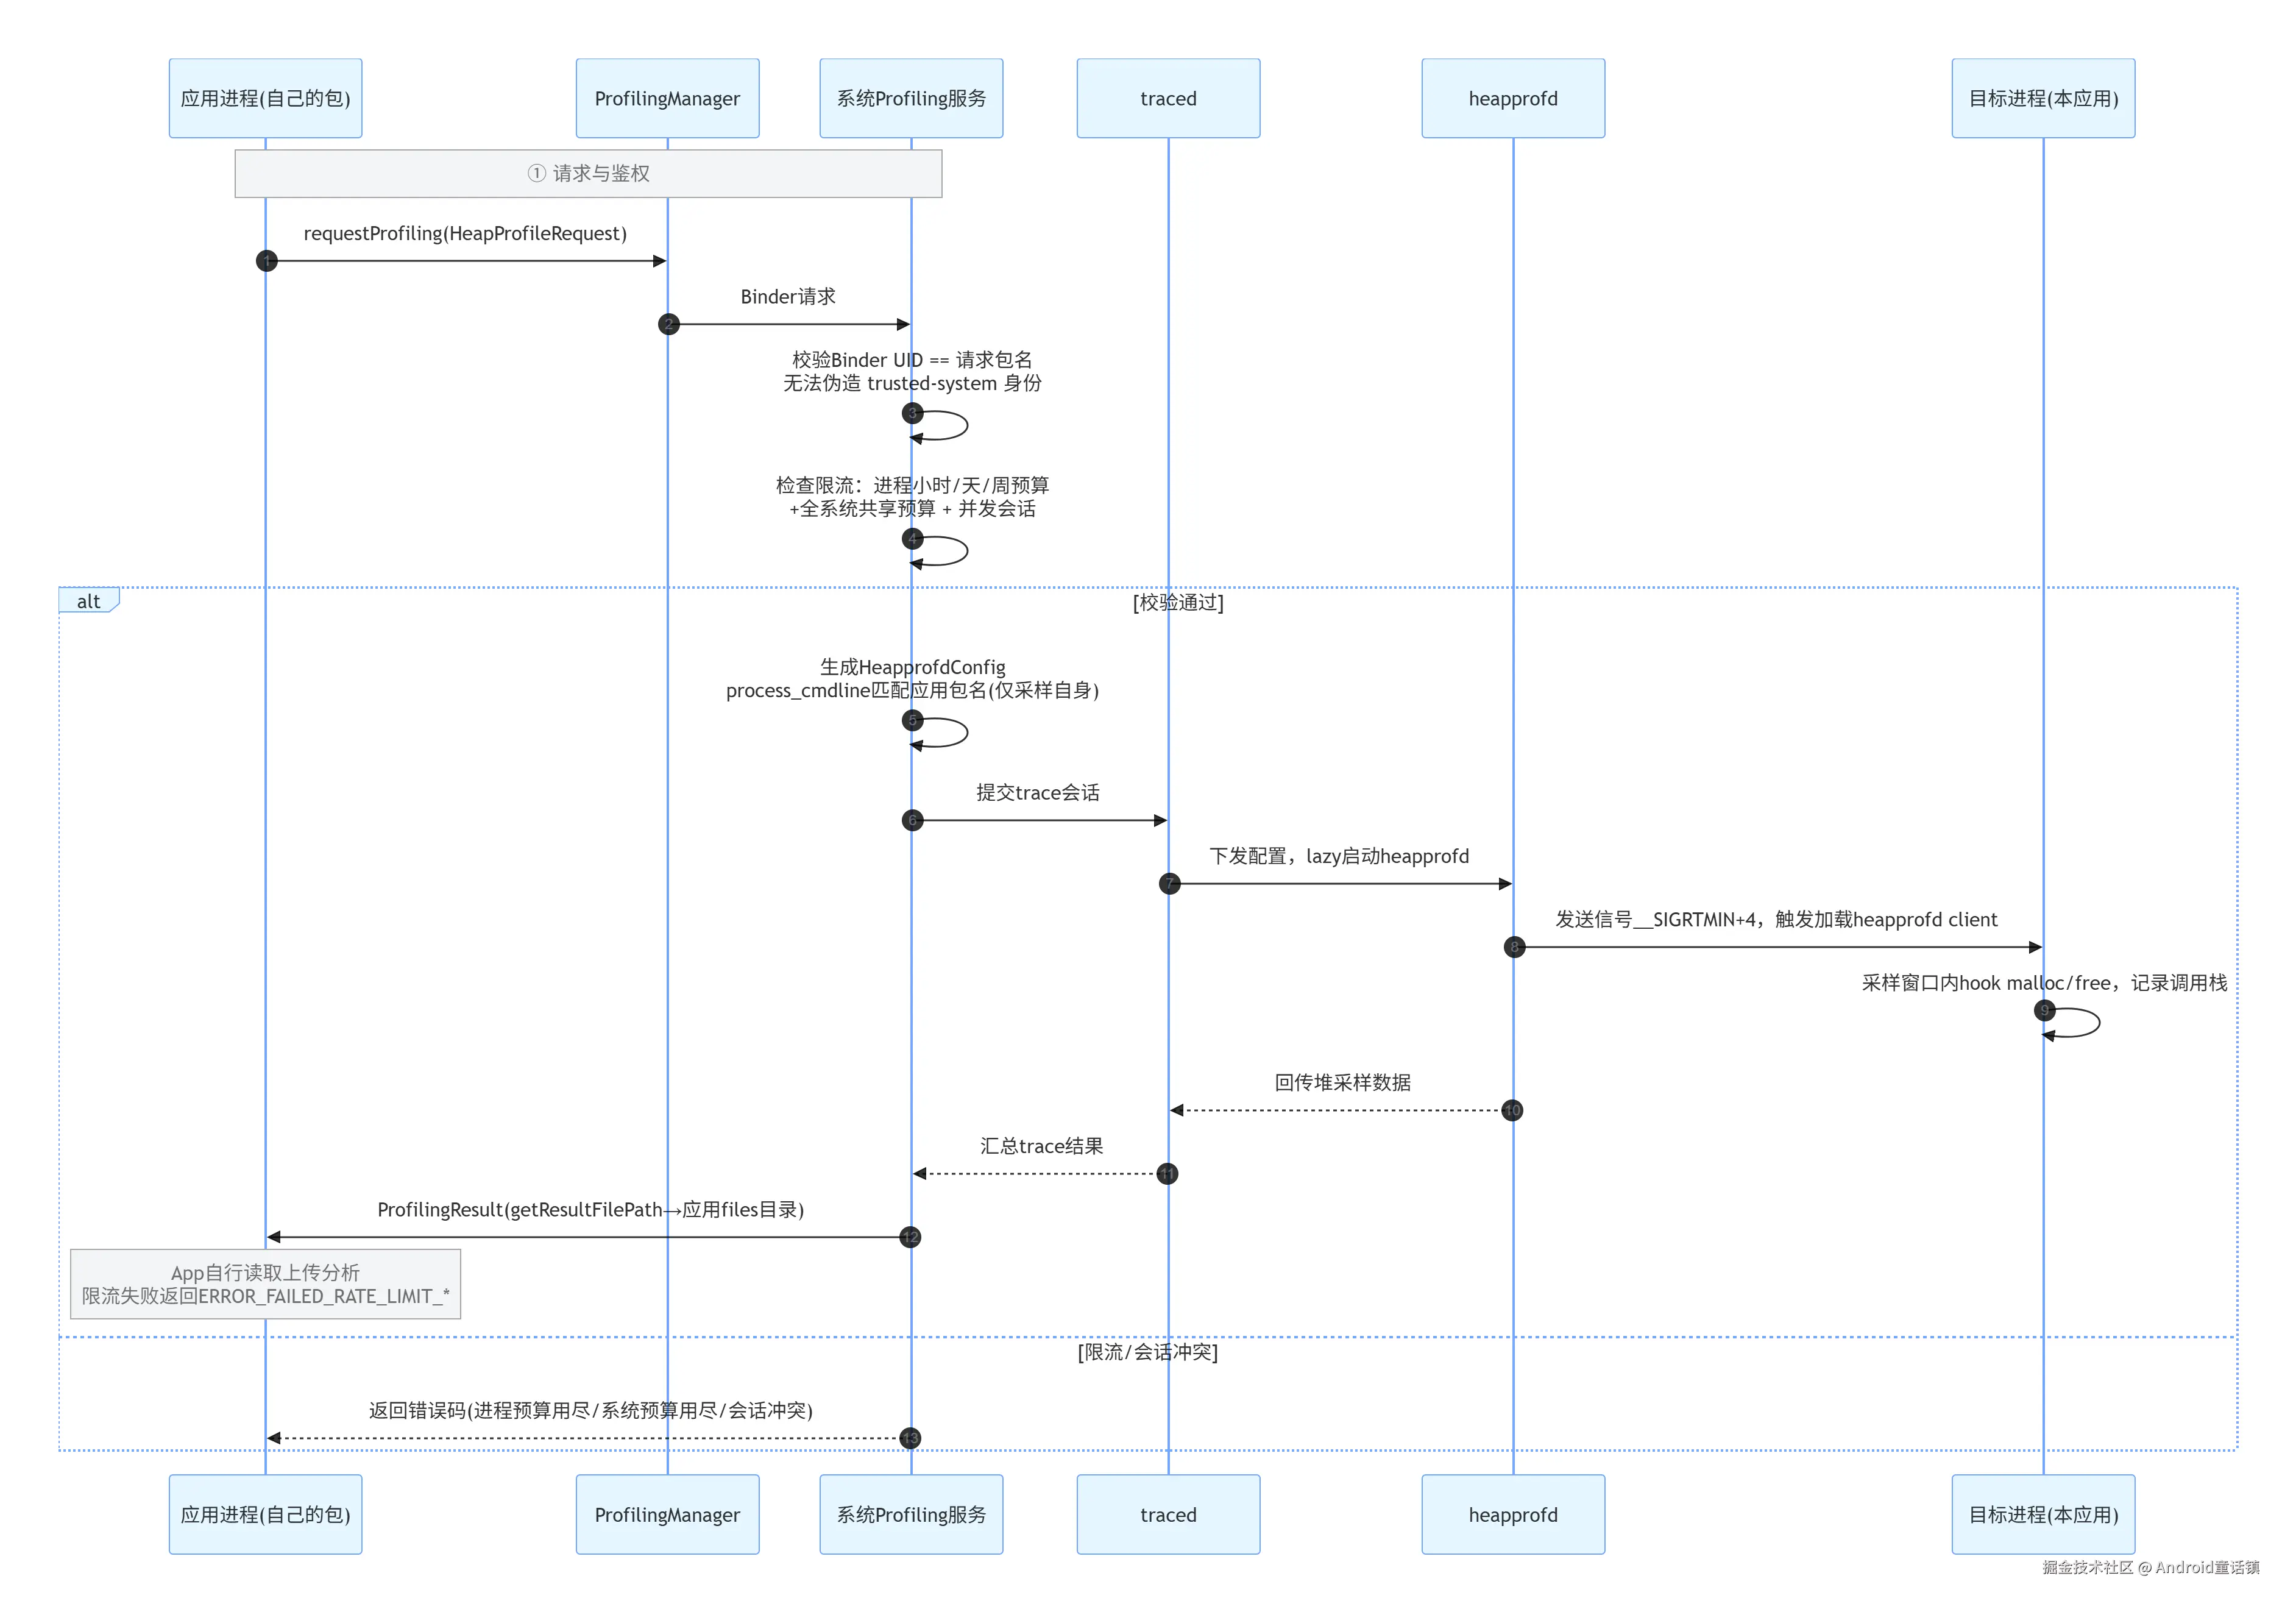
5.2 时序图:ProfilingManager 线上自助采集全流程
scss
应用进程(自己的包)ProfilingManager系统Profiling服务tracedheapprofd目标进程(卧底)① 请求与鉴权requestProfiling(HeapProfileRequest)1Binder请求2校验Binder UID==请求包名(拿不到也不能伪造trusted-system身份)3检查限流(进程小时/天/周预算+全系统共享预算)与并发会话4生成HeapprofdConfigprocess_cmdline固定为调用方包名5提交会话6下发配置(lazy启动heapprofd)7信号__SIGRTMIN+4 → 安装client8采样窗口内malloc/free记录调用栈9profile数据10ProfilingResult(getResultFilePath→files目录)11自行上传分析/失败时记录ERROR_FAILED_RATE_LIMIT_*错误码错误码(进程预算用尽/系统预算用尽/会话冲突)12alt[通过][限流/冲突]应用进程(自己的包)ProfilingManager系统Profiling服务tracedheapprofd目标进程(卧底)注意 Android 12--14 没有 ProfilingManager,普通 App 无法在用户手机上自主启动系统级 heapprofd,只能退回应用内指标 + 自建 hook 的组合拳。
六、Android 17 新玩家:MemoryLimiter,国土局开始主动管仓库了
Android 17 引入 App Memory Limits:系统随应用进程状态(前台/缓存等)动态调整 cgroup v2 约束:
memory.high:内存高水位,越过后触发直接回收并拖慢新分配;memory.swap.max:swap 上限(zram 承载);- 匿名内存 + swap 超过组合阈值 → 上报
TRIGGER_TYPE_ANOMALY,随后系统延迟 30 秒结束进程。
App 可以在下次启动时通过 ApplicationExitInfo 识别这种死法并单独归因:
kotlin
fun findRecentMemoryLimiterExit(context: Context): ApplicationExitInfo? {
    val am = context.getSystemService(ActivityManager::class.java)
    return am.getHistoricalProcessExitReasons(context.packageName, 0, 16)
        .firstOrNull {
            it.reason == ApplicationExitInfo.REASON_OTHER &&
                it.description?.contains("MemoryLimiter:AnonSwap") == true
        }
}
命中只能说明"系统因匿名内存/swap 约束结束了进程",不能直接证明 malloc 泄漏 ------匿名 mmap、线程栈、图形内存都可能参与增长。但它是个绝佳的线上触发器:进程死前若已通过 ProfilingManager 注册了触发器,系统可能帮你保存一份异常时刻的 profile。
七、查到泄漏之后:优化三板斧
7.1 治本:归还对象的所有权
按调用栈定位到泄漏源后,修复思路回归常识:给每个 Native 资源找主人,主人的生命周期结束时必须释放。典型如音视频组件------排查时按 owner(创建/持有/释放资源的组件)检查:
MediaCodec、ImageReader是否按生命周期close()/release();- 队列中 outstanding buffer(交出未归还)数量是否持续增加;
stop/release后资源是否回到可复用基线。
7.2 治标:mallopt 主动 purge(别把它当修复!)
分配器很节俭,free 过的页会先自留复用。API 层面可以催它还:
arduino
#include <android/api-level.h>
#include <malloc.h>
bool RequestFastNativeHeapPurge() {
// M_DECAY_TIME: API 27 调整空闲页归还节奏
// M_PURGE: API 28 主动归还空闲页
// M_PURGE_ALL: API 34 更广的 purge
// M_PURGE_FAST: API 37(Android 17) 新增,低成本快速释放部分空闲页
if (android_get_device_api_level() < 37) {
return mallopt(M_PURGE, 0) == 1; // 旧设备退回普通purge
}
return mallopt(M_PURGE_FAST, 0) == 1;
}注意:purge 只能归还已经空闲 的页。仍被引用的泄漏块不会因此消失;碎片也会让部分页无法释放。若每次 purge 后 RSS 暂时下降又持续上升------继续查对象生命周期,不要把周期性 purge 包装成"修复"。
7.3 验证闭环:多轮场景回落测试
构建"冷启动 → 场景预热 → 重复 N 轮 → 回到稳态"的时间线,比较相同稳态下的差值。判定泄漏的三条硬标准:同一调用栈跨 dump 增长 + 场景退出不回落 + 多轮复现一致。
八、落地:一套 L0--L3 线上分层监控体系
最后把全文收拢成可以直接抄作业的分层架构(成本与证据深度逐层递增):
| 层级 | 手段 | 回答的问题 | 关键要点 |
|---|---|---|---|
| L0 常驻 | mallinfo().uordblks + RSS + Java committed + 线程数 + owner counters |
哪类内存在涨? | 秒/分钟级,不阻塞主线程;owner counters 是你自建内存池/图片池/解码器的唯一账本 |
| L1 确认 | 异常后追加:smaps_rollup、完整 smaps(按 [anon:scudo:*] 等映射语义分类)、malloc_info() 附件 |
增长落在哪类映射? | malloc_info 会暂停 allocator 并遍历 chunks,不能进信号处理器和高频路径 |
| L2 定位 | heapprofd 短窗口采样(灰度/异常触发,Android 15+ 走 ProfilingManager);受控模块的自建 PLT hook | 哪个调用栈在涨? | 记录窗口边界、Build ID、采样参数;hook 必须带熔断和远程开关 |
| L3 复现 | 实验室:HWASan(UAF/越界)、MTE(硬件标签)、GWP-ASan(线上小概率内存安全错误) | 根因是什么? | 它们检测的是内存安全错误,不是泄漏工具;泄漏结论必须"稳定增长+未释放栈+生命周期吻合"三证合一 |
线上触发链完整闭环:
L0 发现 uordblks 稳态斜率异常
  → L1 确认是 allocator 涨(而非 mmap/图形/线程栈)
  → L2 heapprofd 采样窗口拿调用栈
  → ApplicationExitInfo 识别 MemoryLimiter 退出归因
  → 符号化(按 APK version + ABI + Build ID 定位符号文件)
  → 归因到组件/SDK → L3 复现修复 → 验证回落
九、尾声:三类常见误判( detective 的翻车现场)
- attach 前的存量缺失 :heapprofd 是"事件账本",接入前已存在的分配没有事件,第一次 dump 不代表完整堆。想看全量,要么进程启动时就接(
no_startup不设),要么做基线对照; - 分配器缓存仍留页面:应用已经 free,Scudo 仍可能保留 arena/page------存活字节数已回落而 RSS 不动,这不是泄漏;
- 增长来自 mmap 或图形内存 :PSS 涨而 heapprofd 平稳 → 立刻转查匿名映射、DMA-BUF、GPU 内存。继续加大 malloc 采样率不会产生任何有效证据。
十、总结
用故事收个尾:
- mallinfo 是仓库门口的计数器:便宜、常开、只能报总数------负责发现"仓库在膨胀";
- 自建 PLT hook 是给搬运工发登记牌:灵活但坑多,覆盖永远不完整------适合受控灰度和特定模块;
- heapprofd 是总部派来的侦探:靠
__SIGRTMIN + 4的暗号上岗,卧底在分配线程里按泊松采样记录调用栈写进死信箱,侦探在后方还原栈、按 callsite 记账------官方正门、低开销、按字节无偏归因; - MemoryLimiter 是开始主动管仓库的国土局:超标先回收、再限流,最后清退------你要学会读它的退出归因。
四类证据(低成本计数器 → 带调用栈的采样 → owner 生命周期 → 内存安全工具)各司其职、互相校验,才能在 Scudo、mmap、图形内存和系统限流同时存在时,得出可复核的结论。
参考资料
- AOSP bionic:
libc/bionic/malloc_common.cpp(malloc dispatch 路由)、libc/bionic/malloc_heapprofd.cpp(信号接入与 hook 安装) - Perfetto:
src/profiling/memory/sampler.h(泊松采样算法)、src/profiling/memory/malloc_interceptor_bionic_hooks.cc(client 侧 hook)、heapprofd 官方文档 - Android 17:App memory limits(MemoryLimiter)、Trigger-based profiling(ProfilingManager)
- Android NDK:Memory error debugging and mitigation(Scudo / GWP-ASan / HWASan / MTE)
- 《Android 技术内幕:系统机制、性能优化与工具实战》(Gracker / android-internals-wiki)相关章节