Agent拆解系列之DeerFlow 2.0
Agent拆解系列的目的:(1)目的之一,他山之石,从优秀开源 Agent 设计中汲取启发。(2)目的之二,萃取多个优秀开源智能体工程实践,总结沉淀可复用方法论。从DeerFlow 2.0开始,后续会有ClaudeCode、Openclaw、Deepseek Harness、Pi、Hermes等系列。
一句话定位*:以 DeerFlow 2.0 的真实源码为证据链,带你从「会用 Agent」进阶到「能造 Agent 运行时」。学完你能独立读懂、改造、并二次开发一套生产级 Agent 系统。
〇、为什么从 DeerFlow 2.0 开始
市面上 Agent 框架不少,为什么第一个拆的是 DeerFlow 2.0?不是因为它最流行,而是因为它恰好踩中了「从会用 Agent 到能造 Agent 运行时」这条进阶路上最值得学的那几个点:
-
Python 技术栈,最经典的 Agent 底座 。DeerFlow 2.0 的核心是 LangChain + LangGraph ------
create_agent的中间件模型、ThreadState的会话状态、图式编排。这是当前 Agent 工程最主流的范式,学它等于把整个 Python Agent 生态「一鱼多吃」:看懂一套,LangChain/LangGraph 的很多概念就通了。 -
Harness 设计有极强的借鉴意义 。DeerFlow 把「Agent 运行时」抽成了一个独立发布的
deerflow-harness包(packages/harness/),与后端应用层(app/)通过严格的依赖边界隔离。这种**「框架内核 / 应用外壳」分层**,正是复用性和可维护性的关键,也是你在自研框架时最值得照抄的分工。 -
它的中间设计,与「未来智能体运行时」的架构是相通的 。状态、中间件编排、工具/记忆/沙箱扩展、安全护栏、可观测------这些不是 DeerFlow 私有发明,而是几乎所有生产级 Agent 运行时都要回答的通用问题。DeerFlow 只是把答案落进了源码。看懂它,你就拿到了「未来智能体运行时」的一张通用地图,将来换到任何新框架都能迁移认知。
-
它把工程化抽离出去,让 AI 开发者只关注业务 。这是它最打动人的设计哲学:模型调用、上下文压缩、流式输出、安全隔离、配置重载......这些「脏活」都被封进运行时和中间件里,应用层开发者不需要碰 ,只要关心「我的 Agent 要做什么、接哪些工具、用什么记忆」。这正是智能体平台该有的样子------把复杂度下沉到框架,把创造力留给业务。我们拆它,就是要看清这个「下沉」是怎么做到的。
一句话:选 DeerFlow 2.0 当开篇,是因为它在**「技术栈主流、架构有范例、思想可迁移、工程可落地」**四个维度上都足够典型------拿它当第一块「他山之石」,性价比最高。
一、该系列主要分享什么
市面上讲 Agent 的课程大多停在「调 API + 拼 Prompt」。但真正把 Agent 做成产品,难点从来不在模型调用,而在于下面这些工程问题:
- 运行时怎么设计 ------ 一次对话里,状态、工具、记忆、流式输出如何协同?
- 中间件怎么编排 ------ 上下文压缩、循环检测、安全护栏、标题生成,谁先谁后?
- 能力怎么扩展 ------ 工具、MCP、Skill、扩展、社区提供方如何插拔?
- 安全怎么兜底 ------ 沙箱隔离、权限、认证、多用户数据隔离如何落地?
- 工程怎么交付 ------ 配置、可观测、测试、部署如何体系化?
DeerFlow 恰好把这些问题都做进了源码。本课程就是把它拆开讲透。
1.1 适合谁
| 画像 | 收获 |
|---|---|
| 后端 / 全栈工程师 | 掌握一套可复用的 Agent 运行时架构范式 |
| AI 应用开发者 | 从「用框架」升级到「懂框架、改框架」 |
| 架构师 / 技术负责人 | 获得生产级 Agent 系统的设计决策参考 |
| 面试备战者 | 用真实源码建立对 Agent 系统的深度认知 |
1.2 需要什么基础
- Python 熟练(异步、类型注解、装饰器)
- 了解 FastAPI / Pydantic 基础
- 了解 LLM 基本概念(Token、上下文窗口、Tool Calling)
- 不要求事先精通 LangGraph ------ 课程会从源码角度补齐
1.3 学完你能做到
- 画出 DeerFlow 的完整系统架构图,并解释每个组件的职责边界
- 说清
make_lead_agent从入参到产出 Agent 的完整链路 - 独立新增一个中间件,并理解它在链中的正确位置
- 接入一个自定义工具、一个 MCP Server、一个 Skill
- 讲清沙箱隔离、护栏、认证、多用户隔离的实现方式
- 基于源码改造出一个自己的 Agent 应用并部署上线
二、知识地图
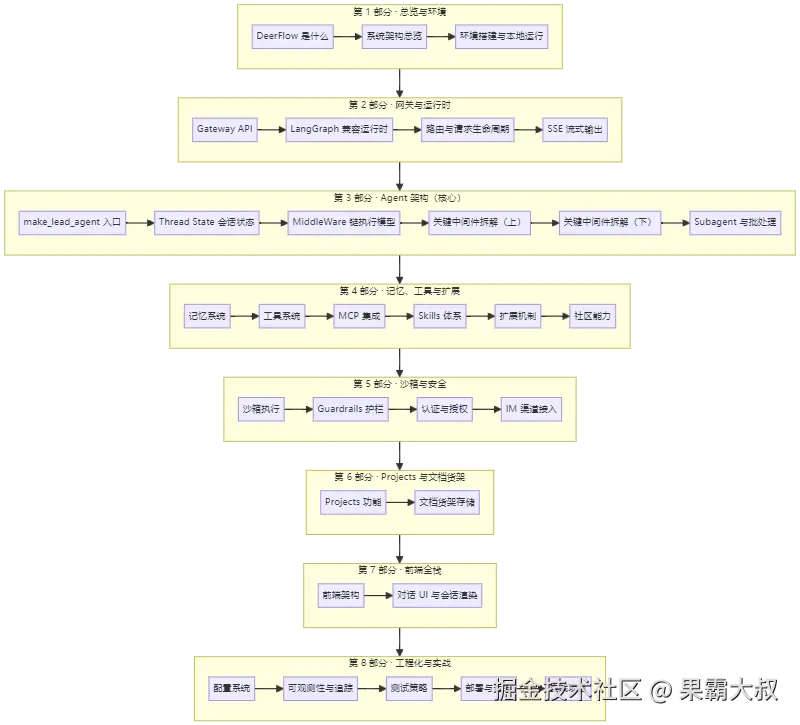
> **学习路径**:第 1~2 部分是热身,第 3 部分是主战场(占了全课重心),第 4 部分开始「横向扩展」,第 5 部分补安全,最后两部分的工程化内容用于落地。你可以顺着读,也可以按需跳。
三、源码地图
先建立对仓库的「空间感」。本课程基于 2.0.0 工作区 (不是更新的 2.1.0 快照),源码根目录是 backend/(框架本体)+ frontend/(前端)。
bash
deer-flow/
├── backend/                        # 后端主体
│   ├── app/                        # 应用层
│   │   ├── gateway/                # Gateway API(FastAPI 入口 + 鉴权 + 路由)
│   │   └── channels/               # IM 渠道接入
│   ├── packages/harness/deerflow/  # ★ 核心 harness 包(本课程主战场)
│   │   ├── agents/                 # Agent 工厂、lead_agent、thread_state、中间件、memory
│   │   ├── subagents/              # 子 Agent 执行引擎(executor / registry / status)
│   │   ├── config/                 # 类型安全配置(数十个 *_config.py)
│   │   ├── mcp/                    # MCP 集成(client / tools / session_pool)
│   │   ├── skills/                 # Skill 体系 + storage
│   │   ├── tools/                  # 工具声明 / builtins / tool_search
│   │   ├── community/              # 可替换的提供方(搜索 / 沙箱 / RAG)
│   │   ├── guardrails/             # 安全护栏(builtin / middleware / provider)
│   │   ├── sandbox/                # 沙箱与安全
│   │   ├── models/                 # 模型适配(deepseek / openai / ...)
│   │   ├── persistence/            # 持久化(checkpointer / store)
│   │   ├── runtime/                # 运行时(run journal / 序列化 / 用户上下文)
│   │   ├── tracing/                # 追踪
│   │   ├── uploads/                # 文件上传
│   │   └── reflection/             # 自省解析
│   ├── docs/                       # ★ 官方设计文档(约 33 篇)
│   ├── langgraph.json              # LangGraph 兼容入口
│   ├── tests/                      # 后端测试
│   └── Makefile                    # 统一构建入口
├── frontend/                       # Next.js / React 前端
│   └── src/{app,components,core,hooks,lib}
├── skills/                         # 技能库
├── docs/                           # 课程文档
├── scripts/                        # 脚本
├── tests/                          # 集成测试
├── config.yaml                     # 共享配置(模型 / 工具 / 沙箱 / 摘要)
└── extensions_config.example.json  # 扩展配置示例(MCP / 技能状态)
学习提示 :
backend/packages/harness/deerflow/是全课的「主战场」,backend/docs/是官方给的「地图」,两者对照着看效率最高。
第一部分 · 总览与环境
Agent拆解系列【DeerFlow2.0】第 1 篇 DeerFlow 是什么?
本章目标:建立对 DeerFlow 的整体认知,分清它「不是」什么。
- 1.1 从「Agent 框架」到「Agent 运行时」:定位差异
- 1.2 DeerFlow 的能力全景:对话、工具、MCP、Skill、沙箱、记忆、多用户
- 1.3 与 LangGraph / LangChain 的关系:DeerFlow 在它们之上做了什么
- 1.4 仓库结构导览(对照上文「源码地图」)
- 1.5 读源码的方法论:先读 docs,再读入口,最后读实现
涉及源码 :README.md、backend/docs/README.md、AGENTS.md
动手 :克隆仓库,跑通 Makefile,用一句话说清 DeerFlow 与 LangGraph 的分工。
Agent拆解系列【DeerFlow2.0】第 2 篇 系统架构总览
本章目标:画出并讲清 DeerFlow 的端到端架构。
- 2.1 请求全链路:Client → Nginx → Gateway / Frontend
- 2.2 统一反代设计:Nginx(2026 端口)如何分流
/api/langgraph/*→ Gateway LangGraph 兼容运行时/api/*→ Gateway REST APIs/*→ Frontend(3000)
- 2.3 三大主体:Gateway API、Agent Runtime、Frontend(3000)
- 2.4 共享配置层:
config.yaml+extensions_config.example.json - 2.5 架构图精读与「为什么这样分层」
涉及源码 :backend/docs/ARCHITECTURE.md
动手:本地启动,用浏览器 DevTools 观察三类请求分别打到哪个端口。
Agent拆解系列【DeerFlow2.0】第 3 篇 环境搭建与本地运行
本章目标:把环境跑起来,为后续读源码提供「可调试」的基础。
- 3.1 依赖清单与版本要求
- 3.2
Makefile命令体系解读 - 3.3 配置文件准备:
config.yaml、.env、extensions_config.example.json - 3.4 后端单独启动与前端单独启动
- 3.5 常见启动问题排查
涉及源码 :Install.md、backend/docs/SETUP.md、Makefile、frontend/README.md
动手:完成一次「改一行代码 → 重启 → 观察变化」的闭环。
第二部分 · 网关与 Agent 运行时
Agent拆解系列【DeerFlow2.0】第 4 篇 Gateway API 设计
本章目标:理解 Gateway 作为「统一入口」的职责与实现。
- 4.1 FastAPI 应用入口:
app/gateway/app.py - 4.2 路由总览:models、agents、threads、runs、mcp、skills、uploads、artifacts、suggestions 等
- 4.3 请求/响应模型与 Pydantic 校验
- 4.4 依赖注入与中间件(FastAPI 层)
- 4.5 错误处理与统一响应格式
涉及源码 :backend/app/gateway/、backend/docs/API.md
动手:用 curl / HTTPie 调用 3 个不同分组的接口,记录请求与响应结构。
Agent拆解系列【DeerFlow2.0】第 5 篇 LangGraph 兼容运行时
本章目标:理解 DeerFlow 为何要「内嵌」一个 LangGraph 兼容运行时。
- 5.1 什么是 LangGraph 兼容层,为什么需要它
- 5.2
langgraph.json的角色:工具链 / Studio 兼容,而非默认入口 - 5.3 默认入口与兼容入口的差异
- 5.4 运行时如何被 FastAPI 承载
- 5.5 与 LangGraph Platform 的对比
涉及源码 :backend/langgraph.json、backend/app/gateway/、backend/docs/ARCHITECTURE.md
动手:分别通过兼容端点与 REST 端点发起一次对话,对比差异。
Agent拆解系列【DeerFlow2.0】第 6 篇 路由与请求生命周期
本章目标:追踪一次请求从进入到返回的完整生命周期。
- 6.1 Nginx 分流规则详解
- 6.2 Gateway 内部路由匹配
- 6.3 从 HTTP 请求到 Agent 调用的转换
- 6.4 请求上下文与用户身份传递
- 6.5 响应组装与返回
涉及源码 :backend/app/gateway/、Nginx 配置、backend/docs/README.md
动手:在关键节点加日志,打印一次完整请求的流转路径。
Agent拆解系列【DeerFlow2.0】第 7 篇 SSE 流式输出
本章目标:讲透 Token 级流式输出的设计与实现。
- 7.1 为什么要流式:体验与工程收益
- 7.2 Gateway 路径 vs DeerFlowClient 路径的差异
- 7.3
stream_mode语义详解 - 7.4 按 id 去重机制
- 7.5 持久化的 run 事件流契约
- 7.6 已知缺口与改进方向
涉及源码 :backend/docs/STREAMING.md
动手 :用 curl -N 观察原始 SSE 帧,解析出事件类型。
第三部分 · Agent 架构(核心篇)
这是全课程的重心。DeerFlow 的「灵魂」在
agents/目录里。
Agent拆解系列【DeerFlow2.0】第 8 篇 入口:make_lead_agent
本章目标:读懂 Agent 是如何被「造」出来的。
- 8.1 入口函数定位:
agents/lead_agent/agent.py:make_lead_agent - 8.2 入参
config的解析与校验 - 8.3 Agent 创建流程:模型装配 → 工具装配 → 中间件装配 → 图编译
- 8.4
create_deerflow_agent与make_lead_agent的关系 - 8.5
RuntimeFeatures特性开关如何决定「装哪些中间件」 - 8.6 系统提示词构造:
lead_agent/prompt.py
涉及源码 :agents/lead_agent/agent.py、agents/lead_agent/prompt.py、agents/factory.py
动手 :打印 make_lead_agent 返回对象的结构,列出它挂载了哪些工具。
Agent拆解系列【DeerFlow2.0】第 9 篇 Thread State:会话状态设计
本章目标:理解 Agent 在「一次会话」中携带哪些状态。
- 9.1
thread_state.py中的状态定义 - 9.2 状态字段逐个解析:messages、文件、沙箱句柄、待办、记忆等
- 9.3 reducer:为什么每个字段都要一个「合并器」
- 9.4 状态在中间件间的读写约定
- 9.5 状态与持久化(checkpointer vs store)的关系
涉及源码 :agents/thread_state.py
动手 :在一次对话中,于 after_model 钩子打印 state 的关键字段变化。
Agent拆解系列【DeerFlow2.0】第 10 篇 Middleware 链:执行模型
本章目标:吃透中间件链的执行顺序与钩子语义。
- 10.1 LangChain
create_agent的钩子体系:before_agent/before_model/after_model/after_agent/wrap_model_call/wrap_tool_call - 10.2 正序 vs 反序 规则:
before_*正序 0→N,after_*反序 N→0 - 10.3 主 Agent 的中间件链:9 个基础层 + 14 个 Lead 层
- 10.4 子 Agent 的中间件:8 个固定 + 视配置再加(不是「4 个」)
- 10.5 「始终开启」vs「按特性开关」的中间件分类
- 10.6 完整执行流程图精读
涉及源码 :backend/docs/middleware-execution-flow.md、agents/middlewares/
动手:对照文档,手绘一遍中间件执行时序图并标注每个钩子的副作用。
Agent拆解系列【DeerFlow2.0】第 11 篇 关键中间件拆解(上):上下文与工具
本章目标:逐个拆解「管上下文、管工具」的中间件。
- 11.1
SummarizationMiddleware:上下文压缩的触发与实现 - 11.2
TokenUsageMiddleware:Token 计量与归因(注意:它不做预算) - 11.3
ToolOutputBudgetMiddleware:工具输出超长怎么办(落盘 / 截断 / 放行) - 11.4
ToolErrorHandlingMiddleware:工具报错的兜底 - 11.5
DanglingToolCallMiddleware:修复「悬空」的 ToolMessage - 11.6
LLMErrorHandlingMiddleware:模型侧的重试 + 熔断(大纲没列,但很关键) - 11.7
DeferredToolFilterMiddleware:不给 schema,省上下文的另一条路
涉及源码 :agents/middlewares/summarization_middleware.py、token_usage_middleware.py、tool_output_budget_middleware.py、tool_error_handling_middleware.py、dangling_tool_call_middleware.py、llm_error_handling_middleware.py、deferred_tool_filter_middleware.py
动手:故意让一个工具返回超大文本,观察输出预算中间件如何截断/摘要。
Agent拆解系列【DeerFlow2.0】第 12 篇 关键中间件拆解(下):安全、记忆与体验
本章目标:拆解「管安全、管记忆、管体验」的中间件。
- 12.1
GuardrailMiddleware:护栏如何嵌入调用链 - 12.2 输入脱敏与清洗:仓库没有这一层,若想补该怎么挂
- 12.3
LoopDetectionMiddleware:循环检测的四种钩子(warning 排队 / 硬停 / 清理) - 12.4
MemoryMiddleware:记忆入队时机(after_agent) - 12.5
TitleMiddleware:自动标题生成及三个典型坑 - 12.6
TodoMiddleware:Plan 模式与待办清单 - 12.7
ClarificationMiddleware:为什么它必须「始终最后」 - 12.8
ViewImageMiddleware:图片注入(注意:它会写 state)
涉及源码 :agents/middlewares/loop_detection_middleware.py、memory_middleware.py、title_middleware.py、todo_middleware.py、clarification_middleware.py、view_image_middleware.py、agents/guardrails/
动手:构造一个会触发循环的场景,观察 LoopDetection 的 warning 与 hard-stop 行为。
Agent拆解系列【DeerFlow2.0】第 13 篇 Subagent 与批处理
本章目标:理解「主 Agent 派发子任务」的机制。
- 13.1 Subagent 的定位:任务分解与并行
- 13.2
SubagentLimitMiddleware:截断多余 task - 13.3 「委派账本」的现实形态:
executor._background_tasks+SubagentResult(2.0.0 没有delegation_ledger.py) - 13.4 「批处理编排」的现实形态:三线程调度池 + 常驻隔离事件循环(2.0.0 没有
app/subagent_batches/) - 13.5 子 Agent 与主 Agent 的中间件差异(8 固定 + 条件,不是「4 个」)
- 13.6 子任务结果如何回传主 Agent
涉及源码 :agents/subagents/executor.py、registry.py、config.py、status_contract.py、token_collector.py、agents/middlewares/subagent_limit_middleware.py、tools/builtins/task_tool.py
动手:给出一个可分解的任务,观察主 Agent 如何拆成多个子任务并汇总。
第四部分 · 记忆、工具与扩展
Agent拆解系列【DeerFlow2.0】第 14 篇 记忆系统
本章目标:讲透 Agent 的「长期记忆」如何沉淀与召回。
- 14.1 记忆的写入时机与存储结构
- 14.2
agents/memory/模块解析(queue / storage / updater / summarization_hook) - 14.3 记忆改进设计
- 14.4 记忆与 Thread State 的边界
- 14.5 记忆设置与用户可控项
涉及源码 :agents/memory/、backend/docs/MEMORY_IMPROVEMENTS.md、config/memory_config.py
动手:多轮对话后,验证记忆是否被写入并在后续对话中生效。
Agent拆解系列【DeerFlow2.0】第 15 篇 工具系统
本章目标:理解 Agent 的工具从「声明」到「执行」的完整链路。
- 15.1 工具声明与 Schema(
tools/tools.py、tools/types.py) - 15.2 工具调用参数与元数据(
tools/+middlewares/tool_call_metadata.py) - 15.3 工具结果处理与转换
- 15.4 内置工具(
tools/builtins/:task_tool、tool_search、clarification_tool 等) - 15.5 工具搜索与动态发现(
tool_search) - 15.6 新增一个自定义工具的路子
涉及源码 :agents/tools/、agents/middlewares/tool_call_metadata.py、config/tool_config.py
动手:新增一个自定义工具,接入 Agent 并验证调用链。
Agent拆解系列【DeerFlow2.0】第 16 篇 MCP 集成
本章目标:理解 MCP(Model Context Protocol)如何接入 Agent。
- 16.1 MCP 是什么,DeerFlow 如何抽象它
- 16.2
mcp/模块解析:client / tools / session_pool / oauth / cache - 16.3 MCP Server 的配置与加载
- 16.4 MCP 工具如何被网关/运行时暴露与路由
- 16.5 多 MCP Server 的命名空间与冲突处理
- 16.6 MCP 工具元数据(
tools/mcp_metadata.py)
涉及源码 :agents/mcp/、agents/tools/mcp_metadata.py、backend/docs/MCP_SERVER.md
动手:接入一个第三方 MCP Server,让 Agent 调用其工具。
Agent拆解系列【DeerFlow2.0】第 17 篇 Skills 体系
本章目标:理解 Skill 如何成为 Agent 的「可插拔能力包」。
- 17.1 Skill 的定位:从「工具」到「能力包」
- 17.2
skill_activation_middleware.py:技能激活 - 17.3 技能工具策略(
skills/tool_policy.py与skill_manage_tool.py) - 17.4 技能的安全扫描与校验(
skills/security_scanner.py、validation.py) - 17.5 技能存储与演进(
skills/storage/、skill_evolution_config.py) - 17.6 技能状态管理(
extensions_config.example.json)
涉及源码 :agents/skills/、config/skills_config.py、config/skill_evolution_config.py、extensions_config.example.json
动手:编写一个 Skill,让 Agent 在特定场景自动激活它。
Agent拆解系列【DeerFlow2.0】第 18 篇 扩展机制(Extensions)
说明 :2.0.0 工作区还没有 独立的
extensions/包;本主题作为「设计蓝图 / 演进方向」来讲,帮你理解 DeerFlow 将来如何支持插件化扩展。
本章目标:理解 DeerFlow 的插件化扩展思路。
- 18.1 扩展是什么:在 Agent 生命周期中注入自定义逻辑
- 18.2 扩展点分类:模型访问、模型调用、策略、注入、隔离
- 18.3 当前唯一的扩展载体:
config/extensions_config.py - 18.4 扩展与中间件的边界与取舍
- 18.5 扩展的加载与生命周期(构想)
涉及源码 :config/extensions_config.py、extensions_config.example.json
动手:写一个最小扩展思路,在模型调用前后打印日志(先在中间件层面实现)。
Agent拆解系列【DeerFlow2.0】第 19 篇 社区能力与知识库
本章目标:了解 DeerFlow 内置的「开箱即用」能力提供方。
- 19.1
community/全景:搜索、沙箱、RAG 提供方 - 19.2 搜索提供方:Tavily、Brave、Exa、Firecrawl、SearXNG、DDG、Serper、Jina、Browserless 等
- 19.3 沙箱提供方:
community/aio_sandbox - 19.4 RAG / 知识库:
community/无独立knowledge/包(作为演进方向) - 19.5 提供方抽象与可替换性设计
- 19.6 沙箱与检索的协作
涉及源码 :agents/community/(提供方子目录)、backend/docs/README.md
动手:配置一个搜索提供方,验证 Agent 能联网检索。
第五部分 · 沙箱与安全
Agent拆解系列【DeerFlow2.0】第 20 篇 沙箱执行
本章目标:理解 Agent 执行代码/命令时的隔离机制。
- 20.1 为什么需要沙箱:不可信代码与工具执行
- 20.2
SandboxMiddleware:沙箱的获取与释放(before_agent/after_agent) - 20.3 沙箱提供方抽象(
sandbox/sandbox_provider.py)与community/aio_sandbox - 20.4 沙箱内存画像与性能(
SANDBOX_MEMORY_PROFILING.md) - 20.5 沙箱审计(
sandbox_audit_middleware.py) - 20.6 沙箱与文件系统的关系
涉及源码 :agents/sandbox/、agents/middlewares/sandbox_audit_middleware.py、config/sandbox_config.py、backend/docs/SANDBOX_MEMORY_PROFILING.md
动手:让 Agent 在沙箱中执行一段代码,观察隔离边界。
Agent拆解系列【DeerFlow2.0】第 21 篇 Guardrails 安全护栏
本章目标:理解护栏如何拦截不安全行为。
- 21.1 Guardrails 的定位与触发时机
- 21.2
guardrails/模块:builtin、middleware、provider - 21.3 内置护栏能力
- 21.4 自定义护栏提供方
- 21.5 护栏与中间件链的协作
- 21.6 护栏的误报与放行策略
涉及源码 :agents/guardrails/、config/guardrails_config.py、backend/docs/GUARDRAILS.md
动手:配置一个自定义护栏,验证其对特定输入的拦截。
Agent拆解系列【DeerFlow2.0】第 22 篇 认证与授权
说明 :2.0.0 无独立的
authz/包;认证与授权是 Gateway 层的一部分(app/gateway/authz.py、auth_middleware.py等)。本主题按当前实现讲清多用户隔离,并把 OIDC / SSO 作为演进方向。
本章目标:理解多用户系统的身份与权限设计。
- 22.1 认证方案总览:用户认证、CSRF、平台信任(IM / Internal Auth)
- 22.2 每用户数据隔离的实现
- 22.3 认证升级路径与测试计划(顺带看
AUTH_UPGRADE.md、AUTH_TEST_PLAN.md) - 22.4 授权模块:
app/gateway/authz.py - 22.5 安全边界与常见风险
涉及源码 :backend/app/gateway/authz.py、auth_middleware.py、csrf_middleware.py、internal_auth.py、langgraph_auth.py、backend/docs/AUTH_DESIGN.md
动手:配置两个用户,验证两个用户的数据互不可见。
Agent拆解系列【DeerFlow2.0】第 23 篇 IM 渠道接入
说明 :2.0.0 有
app/channels/,但integrations/lark_*(飞书集成)不在工作区,作为演进方向。
本章目标:理解 Agent 如何接入 IM(即时通讯)渠道。
- 23.1
channels/渠道抽象 - 23.2 渠道用户绑定(
channel_connections) - 23.3 平台信任(IM / Internal Auth)
- 23.4 多渠道消息路由
- 23.5 接入一个新渠道的路子
涉及源码 :backend/app/channels/、backend/docs/IM_CHANNEL_CONNECTIONS.md
动手:接入一个 IM 渠道,让用户通过 IM 与 Agent 对话。
第六部分 · Projects 与文档货架
说明 :2.0.0 工作区的
app/下没有独立的 projects 路由;本主题作为知识管理方向的「设计蓝图」来讲。
Agent拆解系列【DeerFlow2.0】第 24 篇 Projects 功能
本章目标:理解「项目 + 文档货架」这一知识管理特性。
- 24.1 Projects 的定位:固定上下文 + 文档货架
- 24.2 运行开始时的上下文固定(pinning)
- 24.3 角色权限(谁可以固定/读取)
- 24.4 文档货架的存储:内容寻址(content-addressed)
- 24.5 有界实时读取(bounded live reads)
- 24.6 文档摘要(opt-in LLM 一句话摘要)
涉及源码 :backend/docs/ARCHITECTURE.md、app/(现象:无 projects 路由,见演进说明)
动手:创建一个 Project,固定文档,验证 Agent 在对话中引用货架内容。
Agent拆解系列【DeerFlow2.0】第 25 篇 文档货架存储实现
本章目标:深入文档货架的存储与读取实现思路。
- 25.1 内容寻址存储的原理与好处
- 25.2 有界实时读取的边界控制
- 25.3 文档摘要的生成与缓存
- 25.4 与文件上传、blob 存储的关系
涉及源码 :backend/docs/FILE_UPLOAD.md、agents/uploads/
动手:上传大文档,观察货架如何分块/寻址/读取。
第七部分 · 前端全栈
Agent拆解系列【DeerFlow2.0】第 26 篇 前端架构
本章目标:理解 Next.js / React 前端的组织结构。
- 26.1 技术栈:Next.js、React、TypeScript
- 26.2 目录结构:
src/app、src/components、src/core、src/hooks、src/lib - 26.3 路由与页面组织
- 26.4 状态管理与数据获取
- 26.5 组件库与样式方案
涉及源码 :frontend/src/、frontend/README.md
动手:新增一个页面,打通到后端的接口调用。
Agent拆解系列【DeerFlow2.0】第 27 篇 对话 UI 与流式渲染
本章目标:理解前端如何消费流式输出并渲染对话。
- 27.1 对话 UI 的所有权设计
- 27.2 SSE / 流式数据的消费
- 27.3 消息渲染与 Markdown / 代码块
- 27.4 工具调用状态的可视化
- 27.5 前后端集成契约
涉及源码 :frontend/src/、backend/docs/STREAMING.md
动手:修改消息渲染逻辑,自定义一种消息样式。
第八部分 · 工程化与实战
Agent拆解系列【DeerFlow2.0】第 28 篇 配置系统
本章目标:理解 DeerFlow「类型安全配置」的设计哲学。
- 28.1 配置分层:
config.yaml+extensions_config.example.json+ 环境变量 - 28.2 类型安全配置基座(众多
config/*_config.py,Pydantic 校验) - 28.3 配置模块全景:模型、工具、沙箱、摘要、记忆、子代理、Token、追踪、验证......
- 28.4 配置加载与校验流程
- 28.5 默认值与覆盖规则
涉及源码 :agents/config/、backend/docs/CONFIGURATION.md
动手:新增一个配置项,从 yaml 一路贯通到代码消费。
Agent拆解系列【DeerFlow2.0】第 29 篇 可观测性与追踪
本章目标:让 Agent 系统「可观测」。
- 29.1 追踪配置(
tracing_config.py)与tracing/模块 - 29.2 日志体系
- 29.3 Token 用量与成本观测
- 29.4 运行事件 / run journal(
runtime/journal.py)作为观测数据源 - 29.5 运行时上下文(
runtime/user_context.py、serialization.py)
涉及源码 :agents/tracing/、agents/runtime/、config/tracing_config.py
动手:接入一次追踪,导出并分析一次完整运行的链路。
Agent拆解系列【DeerFlow2.0】第 30 篇 测试策略
本章目标:理解如何为 Agent 系统写测试。
- 30.1 后端测试组织(
backend/tests/) - 30.2 前端测试:单元、E2E、真实后端 E2E
- 30.3 回放与端到端测试(
REPLAY_E2E.md) - 30.4 阻塞 IO 检测(
BLOCKING_IO_DETECTION.md) - 30.5 认证测试计划(
AUTH_TEST_PLAN.md、AUTH_TEST_DOCKER_GAP.md)
涉及源码 :backend/tests/、frontend/tests/、backend/docs/REPLAY_E2E.md、BLOCKING_IO_DETECTION.md
动手:为一个中间件补一个单元测试。
Agent拆解系列【DeerFlow2.0】第 31 篇 部署与运维
本章目标:把系统真正跑在生产环境。
- 31.1 Docker 化:后端 / 前端镜像
- 31.2 Nginx 统一反代配置
- 31.3 容器方案(含 Apple Container 说明)
- 31.4 环境变量与密钥管理
- 31.5 升级与迁移
涉及源码 :Dockerfile、frontend/Dockerfile、backend/docs/APPLE_CONTAINER.md、Makefile
动手:用 Docker Compose 一键起全栈。
Agent拆解系列【DeerFlow2.0】第 32 篇 实战项目:使用vibe Coding开发一个高仿深度探索智能体 BeerFlow
本章目标 :综合运用全课程知识,从零复刻一个简化版的深度探索智能体 BeerFlow ------只复刻 DeerFlow 的核心能力 (任务分解 → 子 Agent 并行研究 → 结果汇总),不搬它的基础设施(网关 / 前端 / Nginx / 容器)。MVP 优先:先跑通最小可运行 demo,再逐步补齐能力。
项目定位:
- 名称:BeerFlow(高仿 DeerFlow 的深度探索智能体)
- 原则:只复刻功能,不复制架构负担 。网关、前端、Nginx、Docker、IM 渠道、MCP、护栏、遥测、数据库持久化、checkpointer------这些全部不做,用纯 Python + LangGraph + 命令行驱动即可。
- 主线:deep-research 模式(拆解 → 并行子任务 → 搜集 → 综述),而不是通用聊天。
里程碑(每个都可运行、可演示):
- M0 · 核心闭环(MVP,~100 行) :
python beerflow.py "问题"直接出答案。一个search工具 + 任务分解 node + 结果汇总 node。不装记忆、不装中间件、不装沙箱。这是本章的起点,跑通就算成功。 - M1 · 子 Agent 委派 :加
task工具 + 一个简单的子 Agent 执行器(后台跑、MAX_CONCURRENT_SUBAGENTS限流),真正「并行研究」。复刻subagents/executor.py的线程池思路。 - M2 · 记忆 :加「事实抽取 + 注入」的最小记忆系统(复刻
agents/memory/的队列防抖 +format_memory_for_injection按 budget 注入),跑通「多轮后记得你」。 - M3 · 中间件链(进阶) :用 LangGraph
create_agent的中间件挂载,复刻 DeerFlow 的中间件组合模型 (after_model逆序、after_agent收尾),挂 1-2 个自研中间件,体会「composition 顺序」的威力。
明确不做(并在文中说明理由) :Gateway(FastAPI)、Next.js 前端、Nginx 反代、Docker、MCP 集成、IM 渠道、护栏、langfuse/langsmith 遥测、alembic/DB 持久化、远程沙箱(用本地 subprocess/LocalSandbox 思路即可)。
交付要求:
- 一份架构说明(画图 + 说明「复刻了 DeerFlow 的哪一块、砍掉了哪一块、为什么砍」)
- 可运行的代码(每个里程碑一个分支/标签,均能跑出 demo)
- 一段演示(录屏或截图:以一个真实 deep-research 问题为例)
- 一份「踩坑与设计取舍」总结(对照 DeerFlow 源码,说明你的简化取舍)
附录
附录 A · 源码阅读路线图
附录 B · 官方文档索引(对照学习,仅收录 2.0.0 工作区存在的文档)
| 主题 | 文档 |
|---|---|
| 系统架构 | ARCHITECTURE.md |
| API 参考 | API.md |
| 配置 | CONFIGURATION.md |
| 流式输出 | STREAMING.md |
| 中间件执行流 | middleware-execution-flow.md |
| 认证 | AUTH_DESIGN.md、AUTH_UPGRADE.md、AUTH_TEST_PLAN.md |
| 沙箱 | SANDBOX_MEMORY_PROFILING.md |
| 护栏 | GUARDRAILS.md |
| 记忆 | MEMORY_IMPROVEMENTS.md、MEMORY_SETTINGS_REVIEW.md |
| MCP | MCP_SERVER.md |
| 文件上传 | FILE_UPLOAD.md |
| 计划模式 | plan_mode_usage.md |
| 自动标题 | AUTO_TITLE_GENERATION.md、TITLE_GENERATION_IMPLEMENTATION.md |
| 回放 / 端到端 | REPLAY_E2E.md |
| 阻塞 IO 检测 | BLOCKING_IO_DETECTION.md |
| 渠道接入 | IM_CHANNEL_CONNECTIONS.md |
| 环境搭建 | SETUP.md、README.md |
附录 C · 每章统一结构
为保证学习体验一致,每章建议按以下结构组织:
- 本章目标(一句话)
- 核心讲解(配 Mermaid 图)
- 关键代码精读(贴真实代码片段)
- 动手实验(可验证的小任务)
- 本章小结 + 面试/实战问答
c
结语:读懂一套生产级 Agent 系统的源码,比读十篇框架介绍更有价值。DeerFlow 的价值不在于它用了什么模型,而在于它把「运行时、中间件、沙箱、安全、工程化」这些硬骨头都啃了一遍。这门课,就是带你把这套骨头一根根拆开看。
查看竞品系列: