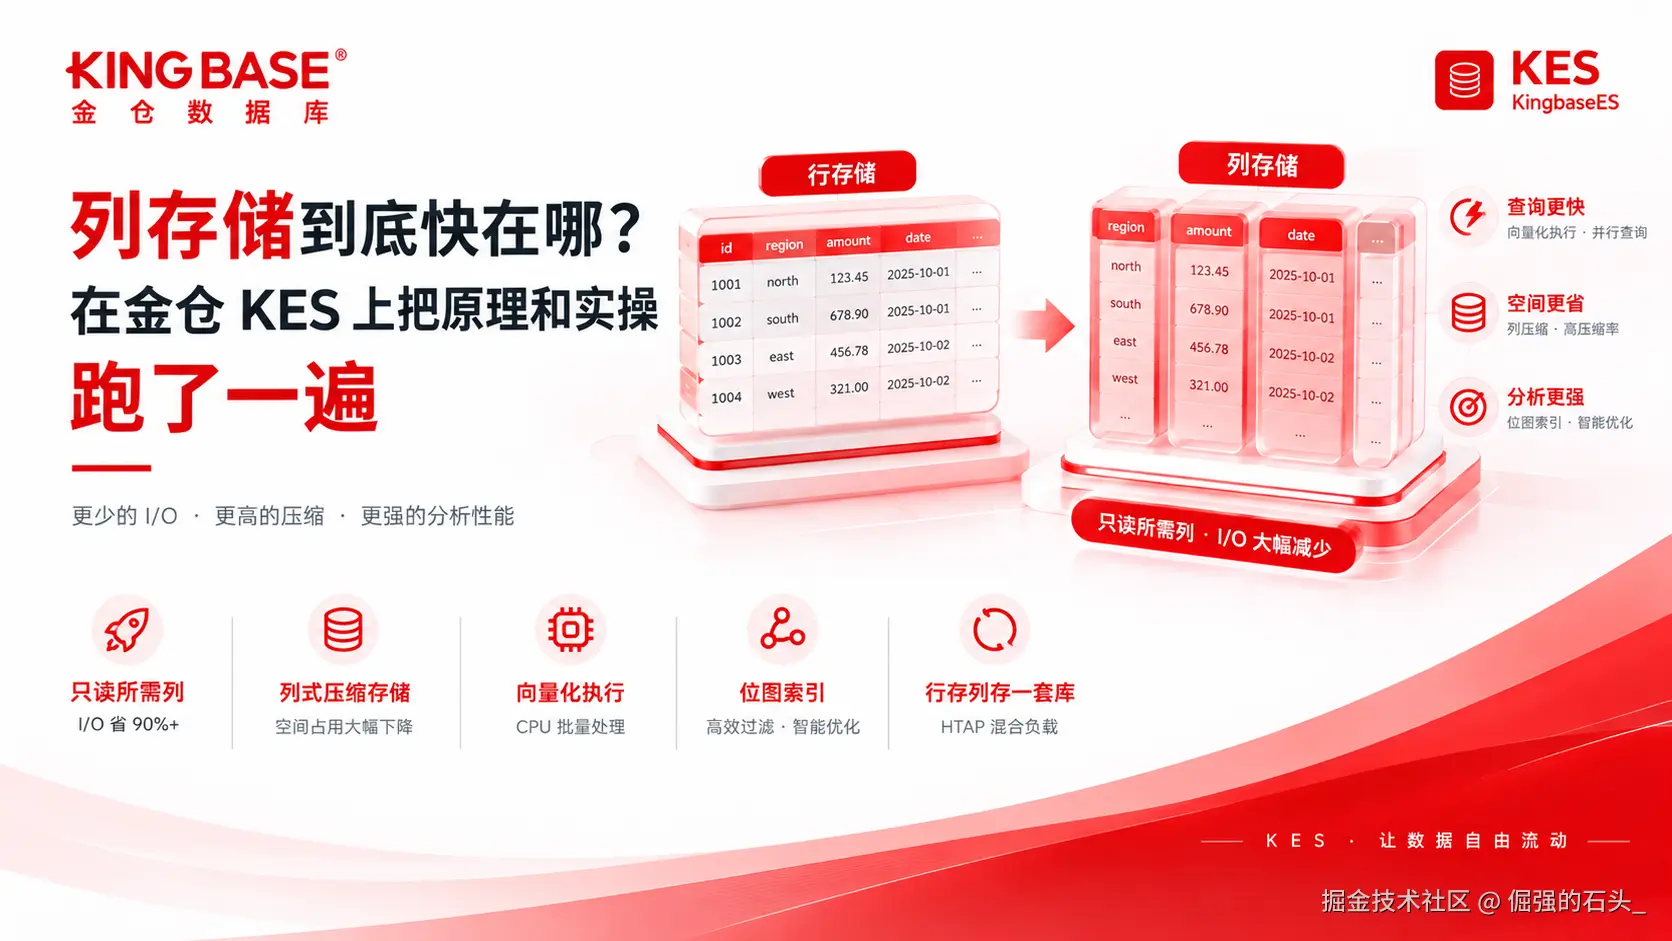
这篇要聊的,是 KingbaseES(下文简称 KES)V9 的列存储能力。为什么同样是聚合查询,列存表就是能比行存快那么多呢?我先把原理讲透,然后给一份能直接照着做的实操记录。最后的话,再聊聊哪些场景该用、哪些场景就别用了。
@toc
从一句被吐槽的 SQL 说起
做过数据分析平台的朋友,估计都碰到过这样的对话:业务方拿着一个报表页面过来找你,说:"这个查询要跑四十秒,能不能想办法快点?"你把执行计划打开一看,一张几亿行的大宽表在跑全表扫描,上面还挂着一堆聚合函数。那索引呢?基本帮不上什么忙。
这类查询其实有个共同的特点:表很宽(几十上百个列)、行数又特别大,但每次查询呢,往往仅仅只关心其中少数几列。举个例子,一张订单事实表有 60 列,报表那边只按"区域 + 金额 + 日期"这三个字段做聚合。
那问题到底出在哪呢?其实就出在存储方式上。传统数据库默认用的是行存储:一行数据的所有字段,在磁盘上是连续放在一起的。你要查这三个字段的话,数据库就必须把整行都读出来------包括那 57 个根本用不上的字段。也就是说,I/O 里头 90% 以上干的都是无效功。数据量一旦到了亿级的情况,这个无效开销就扛不住了。
列存储就是针对这个问题来的。它的思路是什么呢?把数据按列来组织。所有行的"金额"存在一起,所有行的"日期"也存在一起。查询的时候只读参与计算的那几列,I/O 量直接就降了一个数量级。金仓 KES V9 里内置了列存储引擎,而且是"行存列存一套库"这种形态------这个后面再细说,咱们先看原理。
原理拆解:列存为什么快
我把列存的性能优势总结成了四个来源。这四点不是互相孤立的,前面几点往往是后面几点的基础。
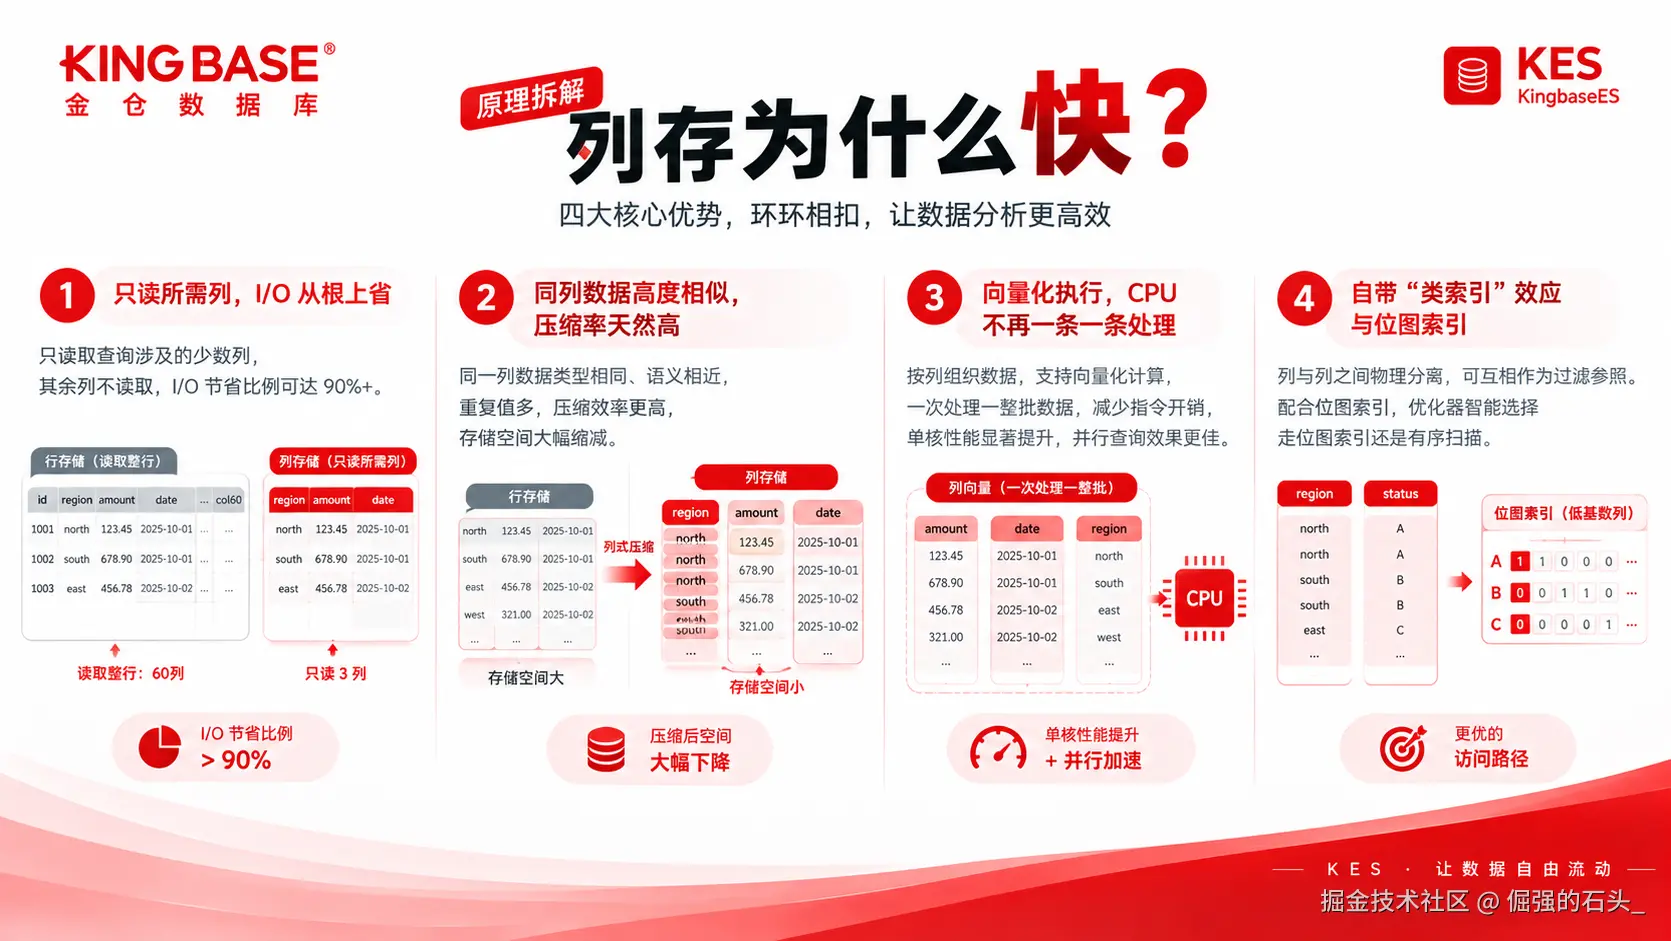
1. 只读所需列,I/O 从根上省
还是拿那张 60 列的订单表来说。你要按区域聚合金额、再按日期过滤的话,列存引擎就只去读 region、amount、sale_date 这三个列的数据块。剩下那 57 列呢?碰都不会碰一下。分析型查询里 I/O 能省多少,大致就等于 (总列数 - 查询列数) / 总列数。在宽表这种场景下,超过 90% 是很轻松的。
2. 同列数据高度相似,压缩率天然高
同一列里存的东西,类型一样、含义也相近------"金额"列里全是数字,"区域"列呢,大量都是重复值。所以 KES 按列做压缩的话,效率要比行存高不少。压缩完之后呢,I/O 进一步变少了,存储成本也跟着往下走。这也是很多客户上列存之后感受最直接的一个收益:表空间占用一下子少了一大截。
3. 向量化执行,CPU 不再一条一条处理
数据按列组织好之后,查询引擎就可以做向量化计算了。用大白话来讲就是:把一整列数据,以紧凑的列向量形式装进内存,然后 CPU 一次处理一整批。比如"销售额 > 1000"这种过滤条件,CPU 直接对整列做批量比较就行了,不用一行一行、一个字段一个字段地去判断。这种流水线式的处理办法,把指令周期上的开销给省了下来。所以单核性能就有很明显的提升。你要是再叠加并行查询的话,加速效果还能成倍往上翻。
4. 自带"类索引"效应与位图索引
列与列在物理上分开存放之后,每一列天然就能互相当作过滤的参照物。然后再配合位图索引------这个东西用很小的空间,就能表示低基数列(比如"区域""状态"这种重复值很多的列)的值分布情况------优化器就可以自己去评估了:是走位图索引,还是直接做有序扫描。在海量数据的复杂分析里,它总能挑到一个相对划算的访问路径。
KES 列存的两个实现细节
通用的原理看完了,KES 的实现里还有两个设计,我觉得值得单独拎出来讲一下。它们要解决的,其实就是列存的一个经典短板------写性能差的问题。
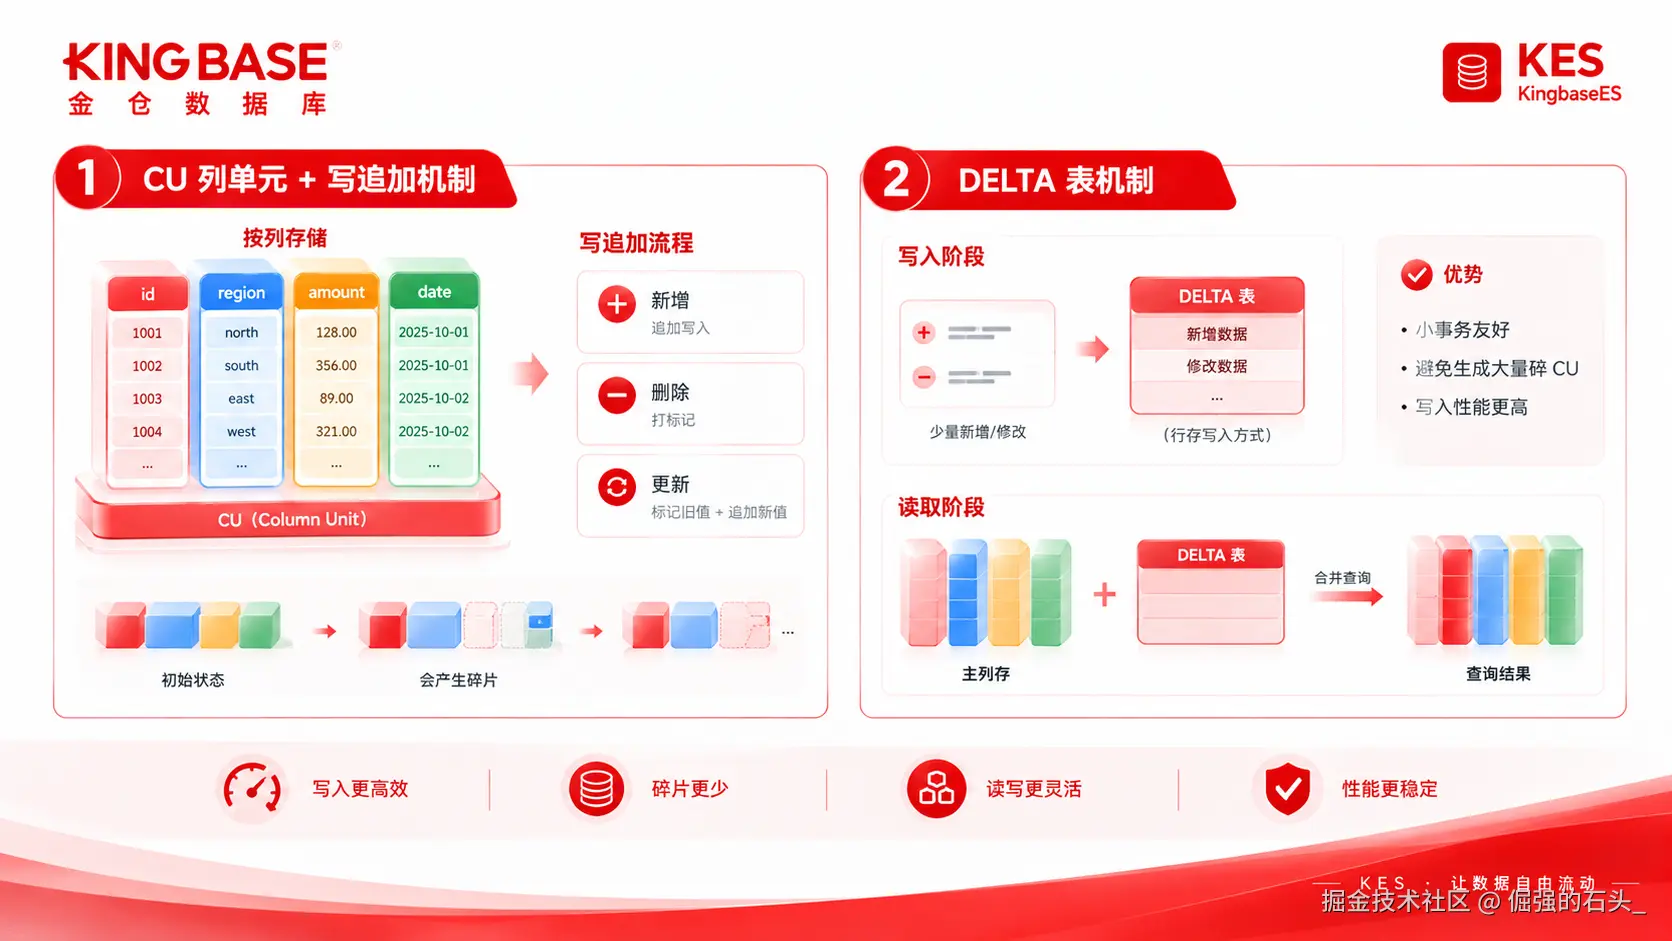
第一个,KES 的列存表在磁盘上,是按列切成一个个 CU(Column Unit,列单元)来组织的。CU 的修改用的是写追加的方式:删除呢,就是打个标记;更新呢,就是把旧值标记掉,再把新值追加进去。这样一来,写入路径就很简单,效率也高。但它是有代价的,会产生碎片。
第二个,KES 给列存表引入了 DELTA 表机制。少量新增、修改的数据呢,先放到 DELTA 表里(它的写入方式跟普通行存表是一致的,对小事务很友好),这样就不会为了几十条数据专门生成一个碎 CU 了。那些写多读少的变化,先在 DELTA 里缓冲着。等到读的时候,再跟主列存做合并。有了这套机制,列存表就不再仅仅只适合"一次导入、然后只读查询"这种理想情况了。就算是持续有增量写入的业务,它也能把性能稳住。
实操:行存 vs 列存,跑一遍就知道
下面这套流程是我自己整理的完整实操记录。语法呢,以 KES V9R1C10 为参考(不同的小版本,建表参数名会有一点点差异,具体以你在用的那个版本的官方文档为准)。
第一步:准备两张对照表
sql
-- 行存储表(对照组)
CREATE TABLE sales_row (
    sale_id       BIGINT,
    product_id    BIGINT,
    region        VARCHAR(50),
    amount        NUMERIC(18,2),
    sale_date     DATE,
    customer_name VARCHAR(100)
);

-- 列存储表(实验组)
CREATE TABLE sales_col (
    sale_id       BIGINT,
    product_id    BIGINT,
    region        VARCHAR(50),
    amount        NUMERIC(18,2),
    sale_date     DATE,
    customer_name VARCHAR(100)
) WITH (storage_format='column');
建完之后呢,用 \d+ sales_col(就是 ksql 命令行)或者 KStudio 看一眼表属性,确认存储格式已经变成 column 了。
第二步:灌入同样的数据
sql
-- 两张表插入相同的模拟数据(示例为批量生成)
INSERT INTO sales_row
SELECT gs, gs % 1000,
       CASE gs % 6 WHEN 0 THEN 'north' WHEN 1 THEN 'south'
                   WHEN 2 THEN 'east'  WHEN 3 THEN 'west'
                   WHEN 4 THEN 'center' ELSE 'overseas' END,
       (gs % 10000) + 0.99,
       DATE '2024-01-01' + (gs % 365),
       'customer_' || gs
  FROM generate_series(1, 100000000) AS gs;

INSERT INTO sales_col SELECT * FROM sales_row;一亿行数据灌完之后,先来看第一个收益------空间占用。把两张表占的磁盘空间对比一下,通常来说,列存表会下降得比较明显。而且列的重复度越高(比如 region 这种只有 6 个取值的列),压缩效果就越明显。
想验证存储确实是按列组织的,接着就看执行计划的差异。这一步我建议大家养成一个习惯------做任何存储优化,都要拿执行计划来说话,别光凭感觉:
sql
EXPLAIN SELECT region, SUM(amount)
  FROM sales_col
 WHERE sale_date >= DATE '2024-06-01'
 GROUP BY region;
行存表的执行计划里,通常是一个把全部列都覆盖到的全表扫描节点,扫描的块数跟表的总大小是成正比的。那列存表的计划呢?它只涉及查询里引用到的那三个列的扫描单元,代价估算明显要低不少。你对比着看一次,列存"按需读列"这个原理,就不那么抽象了。
第三步:跑同一组聚合查询
sql
-- 查询1:按区域汇总
SELECT region, SUM(amount) AS total_amt, COUNT(*) AS cnt
  FROM sales_row            -- 第二次跑换成 sales_col
 WHERE sale_date >= DATE '2024-06-01'
 GROUP BY region
 ORDER BY total_amt DESC;

-- 查询2:多条件过滤后取 TOP N
SELECT product_id, SUM(amount) AS total_amt
  FROM sales_row
 WHERE sale_date BETWEEN DATE '2024-03-01' AND DATE '2024-09-30'
   AND region IN ('north', 'east')
 GROUP BY product_id
 ORDER BY total_amt DESC
 LIMIT 10;
同一份数据、同一组查询,放到列存表上跑,耗时通常能有几倍到几十倍的差距。查询的列越少、表越宽的话,这个差距拉得就越大。执行计划里也能看到这些差异:行存表走的是全表扫描,列存表呢,只扫参与计算的那几列。
第四步:导入后的例行维护
大批量导入做完之后,建议做一次清理,顺便把统计信息也更新一下。目的有两个:一是让列存引擎把数据块重新组织一遍,二是让优化器能拿到准确的统计信息:
sql
VACUUM ANALYZE sales_col;日常运维里呢,金仓的智能运维体系(就是 KES OPS 这类管控平台)可以实时监控列存表的压缩率,还有查询表现。哪些表空间省得最多、哪些查询用上了向量化执行,在可视化界面里都能看得很清楚。
第五步(可选):并行查询叠加 buff
分析场景还可以把并行查询的能力再叠加上去,让多个 worker 一起去处理同一条查询:
sql
SET parallel_degree = 8;

SELECT dept_id, COUNT(*), AVG(amount)
  FROM sales_col
 WHERE sale_date >= DATE '2024-01-01'
 GROUP BY dept_id
 ORDER BY 2 DESC
 LIMIT 10;
优化器会根据统计信息,还有当前的负载情况,动态去决定并行度。金仓官方技术博客对这套并行计算框架的描述是:"查询级自动并行决策 + 运行时资源弹性调度",支持跨节点、跨磁盘、跨 CPU NUMA 域的多级并行。金仓社区的实测结论也印证了这个收益------很多查询用上并行之后,速度能提升两倍以上,部分场景能到四倍,甚至还要更多。
三个常见疑问,这里先统一答一下
在实操之前呢,我先把评论区大概率会出现的这三类问题,统一答一遍。
问:列存表能直接当业务表用吗? 我的答案是:不建议这么做。列存的写入路径(CU 追加、更新就是标记加追加)决定了它不擅长高频的单行增删改。像订单主表这种每秒几十次更新的表,你要是放到列存上的话,性能反而会不如行存。那么列存的正确位置在哪呢?在分析这一侧:报表表、汇总表、事实表、归档表,这些才是它该待的地方。
问:已有的行存大表要怎么迁到列存? 两条路可以走。小表的话,直接 INSERT INTO 列存表 SELECT * FROM 行存表,挑个窗口期执行一下就行。大表呢,建议放在低峰期分批去迁,迁完做一次 VACUUM ANALYZE,然后再把查询切过去。迁移期间呢,用金仓的同步工具,把行存表的增量数据持续补到列存表里,业务这边基本感觉不到什么。
问:列存和分区能不能一起用? 能用,而且我建议你一起用。时间范围分区 + 列存这个组合,在分析场景里基本就是标配了:按月做分区,查询就能直接把无关的时间段剪掉;然后列存再把无关的列剪掉。两层剪枝叠在一起,扫描量能压到原来的一百分之一这个量级。唯一要注意的一点是,分区键要贴合你最常用的那个过滤条件。通常来说,就是时间列。
行存列存怎么搭配:我的决策清单
列存不是万能的,这一点要先说清楚。它牺牲了高频单行更新的性能,点查(就是按主键找一行)也不是它擅长的东西。我的选型清单是这样的:
| 场景 | 推荐存储 | 理由 |
|---|---|---|
| 交易表:高频增删改、单行点查 | 行存 | 写入路径最优,行存 + 索引足够 |
| 大宽表报表、BI 分析 | 列存 | I/O 剪枝 + 向量化,收益最大 |
| 亿级聚合(SUM/COUNT/AVG) | 列存 | 这就是列存的强项 |
| 历史数据归档分析 | 列存 | 高压缩率还能省一大笔存储成本 |
| 持续写入 + 边写边分析 | 列存(依赖 DELTA 机制) | 小事务进 DELTA 表,性能稳定 |
| 一张表既要 OLTP 又要 OLAP | 行存为主 + 列存副本/同步 | 混合负载分开来承载 |
最后这种混合负载(HTAP)的场景,值得展开讲一讲。在 KES V9 的架构里,行存和列存是可以在同一个数据库体系内协同工作的。热数据留在行存表里,这样交易的实时性就有保障了。分析负载呢,通过读写分离,路由到只读节点上的列存结构去跑。或者呢,用金仓的同步工具,把行存的业务数据实时同步到列存分析表里。也就是说,你不需要把数据导出去、再导回来,一份数据在库内就把 TP 和 AP 的分工给完成了。
这种"一套库扛两类负载"的架构价值,要是放到国产化改造这个语境下,就更明显了。传统做法里头,交易库和分析库是两套异构系统,中间还隔着 ETL 或者同步链路。运维这边呢,要维护两套技术栈、两套账号权限,还有两套备份策略。数据链路里的每一段,其实都是一个潜在的故障点。那在 KES 里呢?行存和列存共享同一套 SQL 引擎、同一套权限模型,还有同一套元数据和运维体系。DBA 要操心的东西,一下子少了很多。对预算和人力都比较有限的团队来说,这种把架构做简化的方式,本身就是很实在的收益。
另外再补两个实操里的小经验。第一个,列存表上的索引要克制一点:列存自身已经有很强的过滤能力了,你在低基数列上加普通索引的话,意义其实不大。优化器会自己去评估是走位图索引、还是直接扫描,你盲目地堆索引,反而会把导入速度拖慢。第二个,批量导入的时候尽量攒成大事务:列存的 CU 机制决定了,攒批写入的效率比逐行提交要高得多。同样是一亿行数据,分一万次提交和分十次提交,性能差异马上就能看出来。这两点再跟 DELTA 机制配合起来,就是列存表在生产环境里保持稳定表现的基本功了。
落地效果与选型建议
从公开的案例来看,KES 列存在真实业务里的收益是相当直观的:某省级的政务大数据平台,把 12 亿条人口轨迹表从行存转成列存之后,空间占用下降了 62%。SUM/COUNT/DISTINCT 这类聚合查询的响应时间,也达到了跟原来 Oracle 分析环境差不多的水平。对正在做 Oracle 分析型负载国产化替代的团队来说,这个对标能力很关键------替代这件事不是"能跑起来就行",核心分析查询的性能,是不能出现明显下滑的。
最后总结一下我的建议。如果你的业务里有"宽表 + 大数据量 + 少数几个列做聚合"这种情况的话,那就别犹豫了,把 KES 的列存拉进 POC 清单里,用真实数据跑一遍行存和列存的对照实验------就像本文的实操那样,半个小时就能拿到属于你自己的结论。技术选型这种事呢,别人说一万句"很快",都不如在你自己环境里跑一次 EXPLAIN 来得实在。