作者:来自 Elastic Tia Milosevic, Jason Rhodes
使用 Kibana 通用告警将 ES|QL 查询转化为告警数据,并在同一视图中对经典告警、外部告警和通用告警进行分类处理
Kibana 通用告警是构建和维护告警及通知的一种新选择。无论你从引导式构建器入手,还是直接使用 ES|QL,都可以精确选择要查询的内容、每条告警存储的数据,以及所有规则中需要通知的对象。每条告警都以时间序列数据的形式存储,让你能够在同一个地方搜索、分析和分类处理所有告警。下文介绍的六项调节手段可以帮助你调整每一个环节。
Kibana 通用告警将于2026年10月20日在 Elastic 云端无服务器服务中正式发布并默认启用,也将在适用于 Elastic 云端托管服务和自托管部署的 Elastic Stack 9.6 中正式发布。你已经在 Kibana 中配置了告警?新系统会与你现有的经典告警系统并行运行,因此你可以按照自己的节奏采用所需功能。
Kibana 经典告警仍然能够很好地处理常见场景。你可以像往常一样选择规则类型、填写参数并附加操作。经典告警依然简单可靠。通用告警则更进一步,让你能够将任何 ES|QL 查询用作告警规则,通过告警延迟和恢复延迟控制告警状态反复 切换 ,使用自定义恢复查询,按需调整告警数据,并安排能够跨规则响应和分组告警的操作。
何时适合使用通用告警
如果符合以下一项或多项情况,通用告警就很适合你:
- 你的告警场景超出了经典告警所能提供的范围,例如自定义严重级别、由工作流驱动的操作、告警数据控制、对恢复过程的完全控制等。
- 你希望能够灵活地使用简化的查询构建器创建规则,之后再 "深入底层",编辑和扩展生成的 ES|QL。
- 你的告警来自多个系统,而你希望在同一视图中对它们进行分类处理和分析。
- 你需要精细控制通知,例如通知谁、通知频率、跨规则分组和处理等。
- 你的团队希望充分利用发现、ES|QL 和工作流提供的全部灵活性。通用告警与这些 Elastic 基础功能紧密集成,并依赖这些功能运行。
如果某种经典告警规则类型已经能够满足你的场景,就继续使用它。我们将在本文后面并排比较这两个系统。
通用告警的工作原理:从 ES|QL 查询规则到告警数据
通用告警规则按计划运行 ES|QL 查询。每条结果都会作为规则事件写入专用数据流 .rule-events。该系统由四个核心理念构成:
- 规则就是 ES|QL 查询,因此无需选择规则类型。查询返回的每一行都通过其所属分组进行标识,并成为一条规则事件,返回的各列则随事件一同存储。查询决定了告警的数据结构。
- 告警即数据。无论规则事件来自 Kibana 告警规则还是外部工具,它们都存储在具有明确架构文档的常规数据流中。你可以在发现中搜索它们,在仪表板上将其绘制成图表,也可以将其用作其他规则的输入。
- 一条告警会在整个生命周期(待触发、活跃、恢复中、未激活)中持续跟踪同一个问题,并将其所有底层规则事件归集为告警历史。规则不会在每次运行时都触发新告警,也不会更新现有告警文档。规则事件可以在不触发告警的情况下被捕获,仅作为数据收集。
- 操作策略独立于规则。它们根据告警数据进行匹配,对告警进行分组和限流,并将其发送到工作流。更改通知对象时,无需逐条编辑规则中的操作。
以上各项都是独立组件,每个组件都提供了各自的灵活性和控制能力。
站点可靠性工程师的工作流程:编写并调整一条规则
假设你在多个可用区运行生产主机。你的目标是在主机持续高负载时发出告警,并提供值班工程师所需的严重级别和可用区信息。短暂的负载峰值不应触发告警。主机示例使用 Elastic agent 系统集成中的指标(system.* 字段),后面的容器组示例则使用 Kubernetes 集成(kubernetes.* 字段)。你可以根据需要替换为自己的字段。
编写:按照你熟悉的查询方式编写一条 ES|QL 规则
这条规则计算每台主机的平均处理器利用率,分配严重级别,并仅返回值得关注的主机:
sql
`
1. /*
2. Average CPU per host, with a severity and a minimum-sample guard.
3. */
4. FROM metrics-*
5. | WHERE system.cpu.total.norm.pct IS NOT NULL
6. | STATS
7. avg_cpu_pct = ROUND(AVG(system.cpu.total.norm.pct) * 100, 0),
8. samples = COUNT(*)
9. BY host.name, cloud.availability_zone
10. /* A column named severity sets the alert's built-in severity field
11. (info, low, medium, high or critical). Hosts below every threshold get
12. no severity, and the WHERE below drops them. The other returned
13. columns, such as avg_cpu_pct and the zone, are stored on the alert and
14. available to action policies and dashboards later. */
15. | EVAL severity = CASE(avg_cpu_pct > 95, "critical", avg_cpu_pct > 90, "high", avg_cpu_pct > 85, "medium")
16. | WHERE samples >= 10 AND severity IS NOT NULL
17. /* A minimum-sample guard skips hosts that just came up and have only
18. reported a few data points. */
19. | KEEP host.name, cloud.availability_zone, avg_cpu_pct, severity, samples
`AI代码解释调整:决定告警随时间变化的行为
查询决定哪些结果符合条件。规则定义决定当符合条件的结果出现和消失时会发生什么。下面以 YAML 格式展示同一条规则,将其拆分为基础查询、触发条件和恢复条件:
yaml
`
1. kind: alert
3. metadata:
4. name: host-cpu-saturation
5. routing_tags: [infra] # links this rule to action policies (lever 5)
7. schedule:
8. every: 1m
9. lookback: 5m
11. query:
12. base: |
13. FROM metrics-*
14. | WHERE system.cpu.total.norm.pct IS NOT NULL
15. | STATS
16. avg_cpu_pct = ROUND(AVG(system.cpu.total.norm.pct) * 100, 0),
17. samples = COUNT(*)
18. BY host.name, cloud.availability_zone
19. | EVAL severity = CASE(avg_cpu_pct > 95, "critical", avg_cpu_pct > 90, "high", avg_cpu_pct > 85, "medium")
20. breach:
21. segment: WHERE samples >= 10 AND severity IS NOT NULL
23. recovery:
24. strategy: condition
25. segment: WHERE avg_cpu_pct < 70 # recover well below the breach threshold
27. no_data:
28. strategy: keep_last # a host that is rebooting keeps its last known status
30. state_transition:
31. pending:
32. count: 2 # alert delay: the alert goes active on the third consecutive breach
33. recovering:
34. count: 2 # recovery delay: the alert goes inactive on the third consecutive recovery
36. grouping:
37. fields: [host.name, cloud.availability_zone] # one alert per host
`AI代码解释恢复、状态转换、分组和无数据处理均可调整,下文的第1至第4项调节手段涵盖了这些方面。第5和第6项则在告警激活后发挥作用:通知谁,以及响应人员如何对告警进行分类处理。
精细调整告警的六项调节手段
通用告警在处理流程的每个阶段都提供了控制选项,下面按从前到后的顺序列出。只需使用具体场景所需的选项。
1. 查询:精确定义哪些情况符合条件
ES|QL 具备精确定义条件所需的全部能力。WHERE 用于限定范围,最小样本数保护机制用于忽略刚启动的主机,CASE 用于分配严重级别,而 SORT 配合 LIMIT 则将告警限制在问题最严重的对象上。
sql
`
1. /*
2. Alert on only the three hottest pods, not every pod above the line.
3. */
4. FROM metrics-*
5. | WHERE kubernetes.pod.cpu.usage.node.pct IS NOT NULL
6. | STATS avg_cpu_pct = ROUND(AVG(kubernetes.pod.cpu.usage.node.pct) * 100, 1) BY kubernetes.pod.name
7. | SORT avg_cpu_pct DESC
8. | KEEP kubernetes.pod.name, avg_cpu_pct
9. | LIMIT 3
10. /* LIMIT caps the number of alerts a single run can produce.
11. Use it when "the worst few" is the question you care about. */
`AI代码解释LIMIT 有一个需要提前考虑的副作用。当某个容器组跌出前三名时,它就会从结果中消失。使用 no_breach 恢复策略时,这会被视为已恢复;如果该容器组重新进入前三名,告警就可能再次激活。如果这会影响你的规则,请将 LIMIT 与恢复延迟(第3项调节手段)配合使用。
2. 分组:选择告警的单位
STATS ... BY 定义了单条告警所对应的对象。按 host.name 分组,每台主机对应一条告警;按 service.name 分组,每项服务对应一条告警。请选择便于采取行动的单位:分组范围过大会掩盖问题,过小则会使告警数量激增。如果某些文档缺少分组字段,这些行会归入同一个空值分组,共用一条告警,而其他分组仍各自拥有独立的告警。如果这会产生影响,请在查询中显式处理缺失值。
除非你设置了 LIMIT,否则告警规则最多返回1,000行。如果单次运行可能产生更多分组,请显式添加 LIMIT。
3. 告警延迟和恢复延迟:定义告警如何开始和结束
超过阈值 30 秒并不一定意味着发生了故障。一次恢复也不一定代表真正恢复。这种状态反复切换是告警噪声的主要来源之一,而两项延迟配置无需修改查询即可处理这一问题。
告警延迟(state_transition.pending)指定告警在激活前需要处于待触发状态的评估次数。设置 count: 2 时,告警会在连续第三次满足触发条件时激活,因此短暂的峰值只会停留在待触发状态,不会成为正式告警。
恢复延迟(state_transition.recovering)对告警转为未激活状态前的恢复中状态起到相同作用。在阈值附近上下波动的信号会始终对应同一条告警。每个阶段都可以设置 count、timeframe 或同时设置两者,还可以通过 operator(and 或 or)指定必须同时满足两个条件,还是只需满足其中一个。
恢复是一项独立设置,每条告警规则都必须指定恢复策略(默认为 no_breach):
no_breach:当告警所属分组不再出现在触发结果中时,告警恢复。condition:当同一基础查询满足另一个恢复条件(区别于告警条件)时,告警恢复,如上面的规则所示。query:当单独的 ES|QL 查询返回告警所属分组时,告警恢复。恢复按分组进行,因此每条告警只有在查询返回其所属分组时才会恢复。manual:告警不会自动恢复,会一直保持活跃状态,直到有人手动将其解决。
一种常见做法是将恢复阈值设置得明显低于触发阈值;例如,处理器利用率达到90%时触发告警,低于67%时恢复。这样,指标刚降到阈值以下时,告警就不会立即关闭。而且,由于 query 恢复策略可以运行独立的 ES|QL 查询,因此它可以检查与触发条件不同的值。下面的示例要求处理器利用率和平均负载都恢复正常后,告警才会关闭:
markdown
`
1. # 恢复查询检查的内容比触发查询更多。
2. recovery:
3. strategy: query
4. query: |
5. FROM metrics-*
6. | STATS
7. avg_cpu_pct = ROUND(AVG(system.cpu.total.norm.pct) * 100, 0),
8. load_avg_5m = AVG(system.load.5)
9. BY host.name, cloud.availability_zone
10. | WHERE avg_cpu_pct < 67 AND load_avg_5m < 4
11. | KEEP host.name, cloud.availability_zone
`AI代码解释4. 无数据处理:决定数据缺失意味着什么
当一条活跃告警所属的分组不再出现在触发结果中时,可能有两种截然不同的原因:问题已经消除,或数据源停止了上报。仅凭告警条件无法区分这两种情况。无数据处理允许你为每条规则决定此时应采取的行为,避免指标 agent 故障导致真实告警悄然恢复。
通过 no_data.strategy 或规则构建器中的无数据设置进行配置:
| 选项 | no_data.strategy |
具体行为 |
|---|---|---|
| 保持上次状态 | keep_last |
保持最后已知的状态。活跃告警保持活跃,恢复中的告警保持恢复中。向数据流写入一条 status:no_data 规则事件。 |
| 恢复 | resolve |
首次发现无数据时立即关闭告警,直接将其转为未激活状态,无需等待恢复延迟。向数据流写入一条 status:no_data 规则事件。 |
| 不采取任何操作 | ignore |
跳过无数据检查。使用 no_breach 恢复策略时,数据中断会被视为恢复。使用 condition 或 query 恢复策略时,不写入任何事件,告警保持活跃。 |
正确的选择取决于数据缺失对该规则意味着什么。对于基础设施的处理器利用率,使用 "保持上次状态":如果 agent 停止发送数据,已触发的处理器利用率告警会保持活跃,直到数据恢复上报。对于作业积压过多时触发告警的规则,选择 "恢复" 则更合理。队列清空后,查询没有结果可返回,告警随之关闭。
5. 操作策略:路由、分组和限流
规则本身不包含操作。操作策略负责选择告警,将其打包为载荷,控制重复通知的频率,并将其分发到工作流。一个操作策略可以涵盖多条规则的告警,因此,更改上百条规则的呼叫通知对象只需编辑一次。
策略范围决定操作策略处理哪些告警,由两个可以组合使用的部分构成。路由标签将操作策略的适用范围限制为带有至少一个指定标签的规则所产生的告警。在"高级匹配"中,KQL 表达式根据 severity、group_hash 或 data.* 等告警字段进行筛选。同时设置两者时,告警必须同时满足这两个条件。
路由标签将操作策略与规则关联起来。在规则表单"操作"步骤的"路由标签"字段中添加标签,然后在操作策略表单中选择相同的标签。此后,该操作策略便适用于所有带有其中任一标签的规则,包括以后创建的规则。规则表单中的"已应用策略"面板会列出所有与该规则匹配的操作策略,便于验证关联。若要仅针对某条规则,请为其设置一个其他规则都不使用的路由标签。之后,只需编辑规则的路由标签,即可将其关联到操作策略或解除关联,无需更改操作策略本身。
路由标签与规则的普通标签不同。普通标签用于在规则列表中对规则进行分组和筛选,不影响通知,因此,为规则添加普通标签不会将操作策略关联到该规则。
另外两项设置用于调整通知方式。"通知单位"控制通知如何打包:每条告警发送一条通知;将不同规则中具有相同字段值(例如可用区)的告警分为一组,每组发送一条通知;或将操作策略匹配的所有告警汇总为一条 摘要 。"频率"限制重复通知,例如最多每30分钟通知一次。
下面是针对处理器利用率规则的两个操作策略,以界面中选择的设置形式展示。两者都通过规则的 infra 路由标签与其关联:
bash
`
1. # 仅针对处于严重级别的主机呼叫值班工程师,每个可用区发送一次呼叫通知。
3. 名称: infra-oncall-pager
4. 策略范围: 路由标签:infra
5. 高级匹配(KQL):severity : "critical"
6. 通知单位: 分组,按 data.cloud.availability_zone
7. 频率: 最多每30分钟一次
8. 目标: pagerduty-infra 工作流
10. # 将较低严重级别的告警发送到基础设施频道,按可用区批量汇总,最多每小时一次。
12. 名称: infra-team-digest
13. 策略范围: 路由标签:infra
14. 高级匹配(KQL):severity : "high" or severity : "medium"
15. 通知单位: 分组,按 data.cloud.availability_zone
16. 频率: 最多每1小时一次
17. 目标: slack-infra-team 工作流
`AI代码解释一条告警可以匹配多个操作策略,每个策略分别应用自己的分组和频率设置。如果整个可用区都处于高负载状态,呼叫系统会收到一条分组通知,而不是每台主机各发一条;团队频道则会每小时收到一份包含高、中严重级别主机的摘要。
操作策略也可以跨规则使用。为处理器、内存和磁盘规则设置相同的路由标签,在操作策略中选择该标签,并将"通知单位"设为按 data.cloud.availability_zone 分组。当某个可用区同时触发这三条规则时,只会发送一次呼叫通知,而不是三次。将"通知单位"切换为"摘要"后,操作策略便会为其匹配的所有告警发送一条汇总通知。若要针对这种模式本身触发告警,请参阅基于告警构建规则。展开评论对第 R230 行发表评论已解决这些示例中的每个目标都是一个调用连接器的工作流,例如调用 Slack 或 PagerDuty 连接器。要了解如何构建并启用工作流,请参阅工作流文档。
6. 分类处理控制和维护窗口:主动保持安静
告警激活后,响应人员可以确认告警、将该告警序列暂停通知一段时间,或将其解决。被抑制的告警不会进入通知渠道,但仍保留在数据中。任何内容都不会被删除,所有记录均可审计。例如,在计划内的发布过程中,暂停该告警序列的通知,可以使其在暂停期结束前不再进入通知渠道。维护窗口对计划内的工作提供相同的控制,并同时适用于通用告警和经典告警规则。
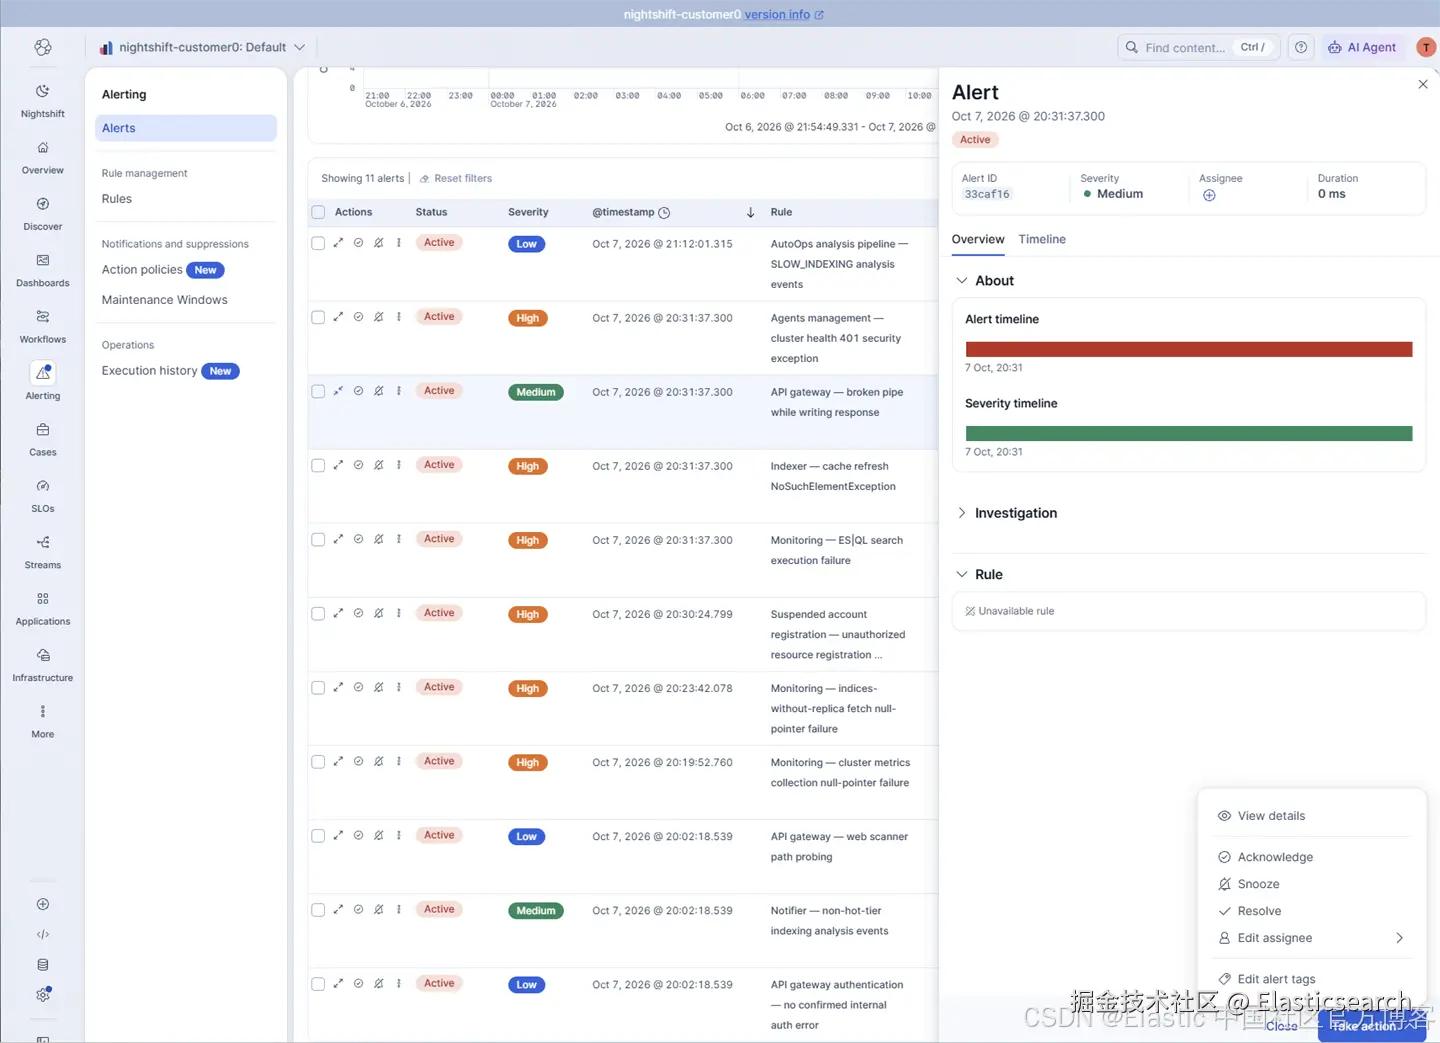
在同一个地方处理所有告警:经典告警、通用告警,甚至外部告警
很少有团队的告警只来自单一来源。有些来自经典告警规则,有些来自通用告警规则,还有些来自其他监控工具。我们全新的告警视图让响应人员能够通过统一队列处理所有告警。
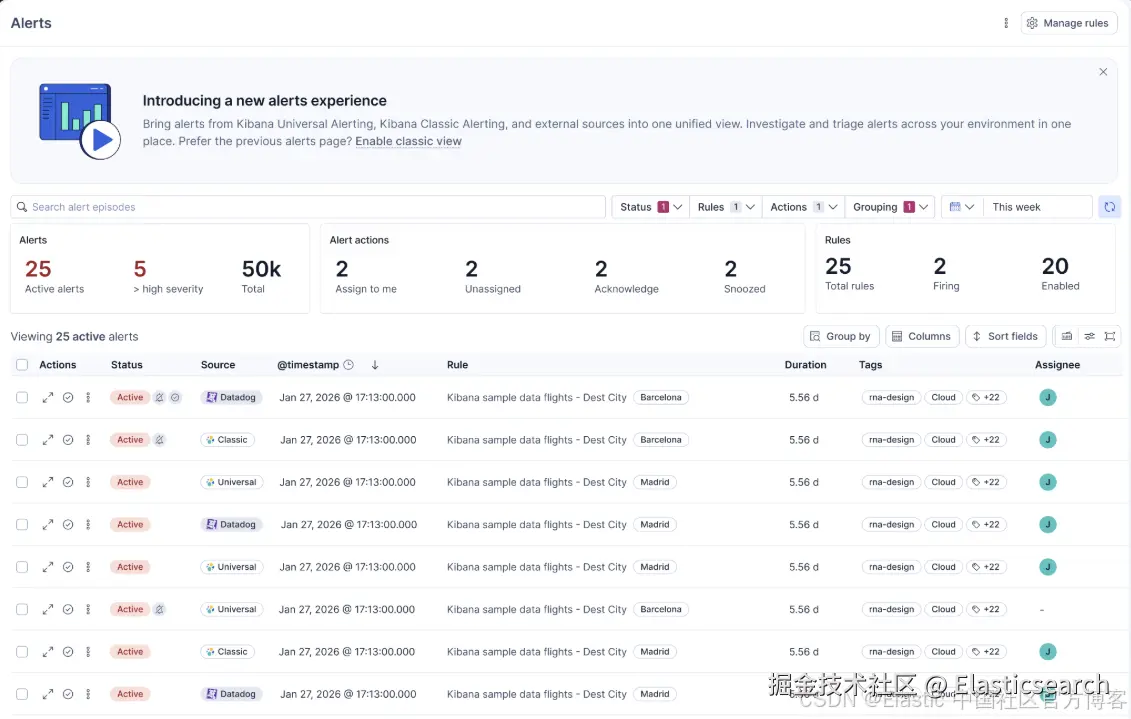
将其他工具的告警作为数据处理
外部监控工具的告警会进入与 Elastic 生成的告警相同的数据流,并以相同的方式进行搜索、路由和分类处理。工作流通过 alerting.create_alert 步骤写入每条告警,source 字段则记录其来源。对于值班工程师来说,这意味着只需在一个地方查看,无需为每个工具分别打开一个标签页。外部告警接入是一项实验性功能,因此,随着我们了解其使用情况,该功能还会不断变化和改进。
通用告警与经典告警的功能比较
两个系统的目标相同,但取舍不同。经典告警侧重于为已知场景提供引导式配置,通用告警则侧重于灵活性和控制能力。
| 功能 | 经典告警 | 通用告警 |
|---|---|---|
| 提供参数配置引导的预置规则类型 | ✓ | 部分支持,后续将增加更多 |
| 以 ES|QL 查询编写规则 | ✓ | ✓ |
| 基本阈值规则 | ✓ | ✓ |
| 异常检测和应用性能监控异常规则 | ✓ | 即将推出 |
| 机器学习作业运行状况和转换运行状况规则 | ✓ | 即将推出 |
| 服务等级目标消耗率规则 | ✓ | 即将推出 |
| 合成监测的监视器状态规则 | ✓ | 即将推出 |
| 由规则查询定义告警字段 | ✓ | |
| 每次运行的告警事件历史数据 | ✓ | |
| 告警延迟(告警激活前连续满足触发条件) | ✓ | ✓ |
| 恢复延迟(告警自动恢复前连续满足恢复条件) | ✓ | |
| 自定义恢复条件或恢复查询 | ✓ | |
| 操作附加到每条规则,并直接发送到连接器 | ✓ | |
| 多条规则共享可复用的操作策略,支持分组和限流 | ✓ | |
| 从外部工具导入告警(实验性功能) | ✓ | |
| 在统一的告警页面中进行分类处理和分析 | ✓ | ✓ |
| 维护窗口 | ✓ | ✓ |
通用告警和经典告警会一同显示在统一的告警页面中,因此响应人员可以在同一视图中对所有告警进行分类处理。经典告警继续按照当前方式运行。两个系统共享维护窗口、连接器和工作流。
新的告警能力正在通用告警中积极开发。经典规则仍然适用于其原本面向的标准场景,你可以按照自己的节奏,逐条规则采用通用告警。
通用告警目前尚不支持的功能
通用告警尚未完全具备经典告警的所有功能。我们希望你现在就了解这些差距,避免在处理故障的过程中才发现,因此,在迁移规则前,请了解以下事项。
- 并非每种经典规则类型都有对应的通用规则。通用规则是手动编写或由规则构建器生成的 ES|QL 查询。自定义阈值、指标阈值、日志阈值和索引阈值等阈值类规则,很适合通过阈值规则构建器实现,许多其他条件也可以直接用 ES|QL 编写。依赖技术栈中其他部分计算结果的规则类型,例如异常检测,目前还没有对应的通用规则,因此暂时仍需使用经典告警。上面的比较表列出了这些规则类型,路线图中的规则库将为常见模式提供现成的起点。
- 服务等级目标和合成监测规则需要额外工作。可以使用 ES|QL 针对服务等级目标和合成监测数据编写条件,但经典规则中的多窗口消耗率逻辑和每个监视器的设置都需要手动重建。除非你需要额外的控制能力,否则请继续使用经典告警中的这些规则。
- 经典规则不会自动迁移到通用告警系统。它们会保持不变并继续运行;将某条规则迁移到通用告警,意味着需要将其条件重新构建为 ES|QL 规则。
- 通用告警的操作依赖工作流。经典规则将操作直接发送到连接器。通用规则本身没有操作:操作策略将告警交给工作流,而工作流是唯一支持的目标类型,随后由工作流调用 Slack、PagerDuty 或其他连接器。通用规则要向任何人发送通知,必须先创建并启用至少一个工作流。
- 在 Elastic 云端托管服务和自托管部署中,工作流需要企业版许可证。没有该许可证,通用规则仍会运行,告警仍会写入,但操作策略无法向任何目标发送告警,因此不会发出通知。现有操作策略仍可查看、禁用、暂停通知和删除。
- 通用告警不提供状态反复切换的配置。要避免噪声告警过于频繁地触发,可以使用告警延迟、恢复延迟和自定义恢复(第3项调节手段)。
- 两种告警类型的字段名称可能不同。针对
group_hash等通用告警字段的查询不会匹配任何经典告警。我们的统一告警表基本隐藏了这种差异,但在你自己的组合查询中,请使用共享筛选条件(状态、严重级别、规则、标签),或分别查询两个系统。
有两项通知投递细节适用于所有操作策略。通知采用至少投递一次的机制,因此在极少数情况下,例如在分发后、记录前发生重启,同一条通知可能会收到两次。请确保工作流具有幂等性。通知还会按照较短的轮询间隔分发,而非即时发送,因此请勿依赖低于一秒的呼叫通知延迟。
使用 ES|QL 了解你的告警情况
告警及其历史记录都是数据流中的文档,因此,定义规则所用的语言也可以用来解答有关告警的问题。你可以从告警跳转到发现,进一步查看该主机的指标和日志,无需使用其他工具。下面的两个示例都查询 .rule-events 数据流。
scss
`
1. /*
2. The ten rules that activated the most alerts in the last 7 days.
3. rule.id is the rule's saved object ID, not its name.
4. */
5. FROM .rule-events
6. | STATS alerts = COUNT_DISTINCT(alert.id) BY rule.id
7. | SORT alerts DESC
8. | LIMIT 10
9. /* Rules at the top are good candidates for tuning. Adjust a threshold,
10. raise the alert delay or change the grouping, then re-run this. */
`AI代码解释
less
`

1.  /*
2.    Alert volume per day for one rule, to confirm a change had the effect you wanted.
3.    rule.id is the rule's saved object ID, not its name.
4.  */
5.  FROM .rule-events
6.  | WHERE rule.id == "<your-rule-id>" AND type == "alert"
7.  | STATS alerts = COUNT_DISTINCT(alert.id) BY day = BUCKET(@timestamp, 1 day)
8.  | SORT day ASC

`AI代码解释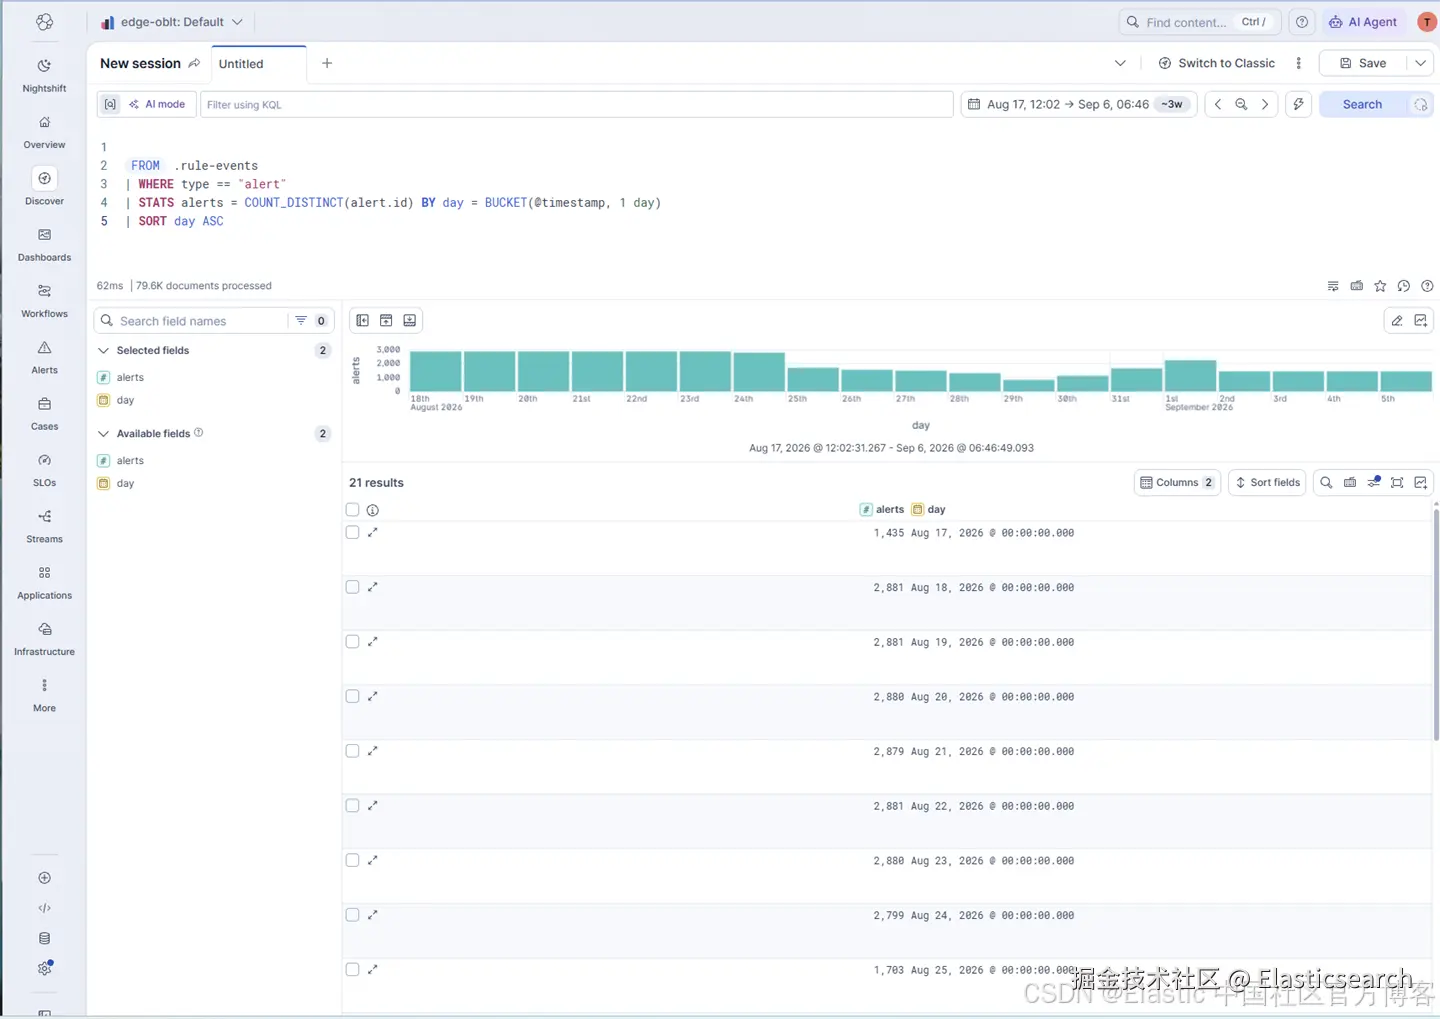
基于告警构建规则
既然告警是数据,规则也可以针对告警运行。针对告警数据的规则就是普通的 ES|QL 规则,只是读取 .rule-events,而非日志和指标。这让它能够捕捉单条告警无法体现的模式,例如同一可用区内有三条或更多规则触发。通用规则和外部工具产生的告警在这里的处理方式相同,因为它们都进入同一数据流,并使用相同的字段。此类规则生成的告警与其他告警一样,拥有相同的生命周期、操作策略和分类处理控制。
信号规则是实现这一功能的基础。设置了 kind: signal 的规则(在界面中标为"事件")会将触发和恢复事件记录为数据,不会触发告警或通知任何人。对于主要在组合出现时才有意义的条件,例如同一主机上处理器利用率过高、可用磁盘空间不足和输入输出等待时间增加,可以使用信号规则。然后编写一条告警规则,在多个信号同时出现时触发。
我们接下来的工作
按空间试用即将推出的功能
Kibana 通用告警的新功能和即将推出的功能将通过实验性功能开关提供,让团队能够在向所有人启用之前进行试用。该开关对应 "Universal Alerting: Experimental Features/通用告警:实验性功能 "设置(alerting:v2:experimentalFeatures)。它默认关闭,并按 Kibana 空间单独设置,因此你可以在测试或预发布空间中启用,同时保持生产空间的现有设置。更改此设置后需要重新加载页面。
该开关控制所有即将推出的通用告警功能。正式发布时提供的所有功能均无需启用此开关即可使用。
即将推出的功能
虽然我们尚未承诺任何具体日期,但以下是正式发布后我们重点关注的方向:
- 序列规则构建器正式发布:通过引导式操作构建规则,检测按特定顺序发生的事件,无需手动编写完整查询(目前已可通过"实验性功能"使用)。
- 更多规则构建器:提供更多引导式方式来构建规则查询,例如服务等级目标、合成监测、异常检测等。
- 规则库:提供现成规则,供你直接使用并调整,让新规则不必从空白查询开始。
- 告警删除:删除不再需要的告警。
- 外部告警导入正式发布,并简化配置和管理。
- 与外部系统双向同步告警,让一个系统中的操作能够反映到另一个系统中。
- 更多"无数据"相关功能。
如果其中某项对你尤为重要,请告诉我们。这有助于我们决定优先开发哪些功能。
开始使用
通用告警已在 Elastic 云端无服务器服务中正式发布,并从 Elastic Stack 9.6 起在 Elastic 云端托管服务和自托管部署中正式发布。在 Elastic 云端托管服务和自托管部署中,基于工作流的操作策略需要企业版许可证,其中包含每月10,000次工作流执行额度(请参阅订阅)。在无服务器服务中,Elastic 负责管理告警系统。
为团队授予访问权限
访问权限通过 Kibana 功能权限控制,在"技术栈管理 > 角色 "中按角色设置。通用告警新增了四项权限,列在角色编辑器的"通用告警"下,每项都可分别设置为"全部 "或"读取":
| 权限 | 读取 | 全部 |
|---|---|---|
| 规则 | 查看规则 | 创建、编辑和删除规则 |
| 告警 | 查看告警 | 对告警进行分类处理 |
| 操作策略 | 查看操作策略 | 创建和编辑操作策略 |
| 执行历史记录 | 查看执行历史记录 | 与"读取"相同 |
大多数响应人员需要"告警:全部"和"规则:读取"权限。规则编写者需要"规则:全部"权限;如果还负责管理通知,则还需要"操作策略:全部"权限。通知通过工作流运行,因此,构建或编辑工作流的人员还需要"分析 > 工作流 "的"全部 "权限。有关工作流权限的完整列表,请参阅设置工作流。
权限控制用户可以管理哪些内容,并不决定规则可以读取哪些数据。每条规则都使用最后保存该规则的用户的应用程序编程接口密钥运行,该密钥决定规则可以查询哪些数据。请使用有权读取规则所查询索引的用户身份保存规则。有关规则、操作策略和工作流的授权方式,请参阅授权文档。
创建你的第一条规则
打开"通用规则"标签页,创建你的第一条规则,并告诉我们你的发现。如果遇到本文未涉及的情况,我们希望听到你的反馈。
还没有部署?开始免费试用 Elastic 云服务。
原文:Kibana Universal Alerting: ES|QL alerts as data | Elastic Observability Labs