过去一年,大模型不再只关注参数与榜单,训练范式本身正在被重写。Pre-training、Post-training、Test-time 三段并重,RL 成为模型定制的主路径。
范式一变,"训练"这件事也被重新定义:它不再只是"跑得动一个更大的模型",而是要在万卡规模上把算力、网络、存储、框架、服务组织成一套精密系统工程;不再只是离线一次跑完,而是要在 Rollout、Train、Eval、Env 多角色协同下让反馈闭环持续流动;也不再只服务 token 世界,还要承接来自视觉、状态、动作与真实物理过程的信号。
面对这些变化,PAI 在 2026 云栖大会围绕训练做了一次系统性升级:把万卡训练做成精密系统工程,一站式跑通 Agentic RL,把训练能力延伸到仿真风洞与物理世界------三层升级共同构成面向 Agentic AI 时代的训练基础设施。
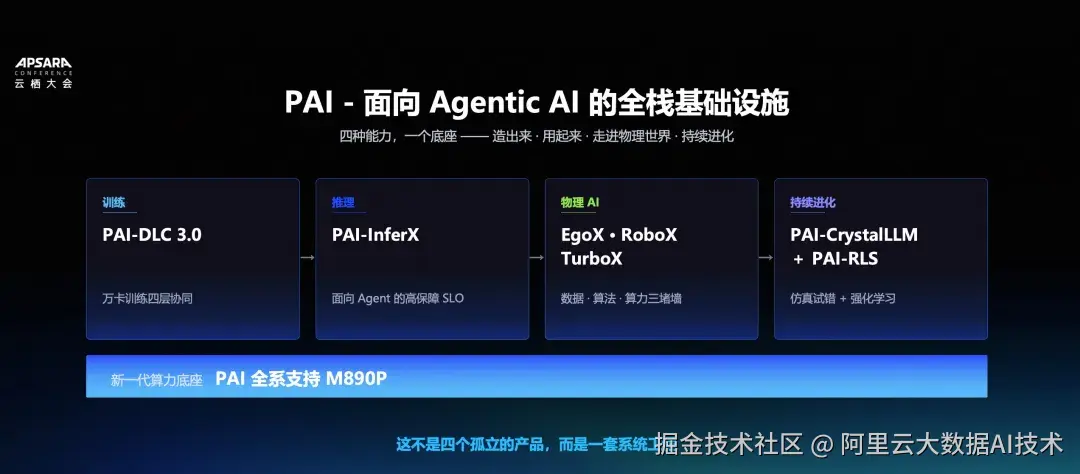
PAI-DLC 3.0:超节点算力底座与四层协同,加速从算力堆叠到训练确定性的跃迁
应对大规模分布式训练的效率挑战,PAI-DLC 3.0 正式发布。训练的确定性,来自算力、网络、存储、框架四层协同,而不是某一层的单点突破。 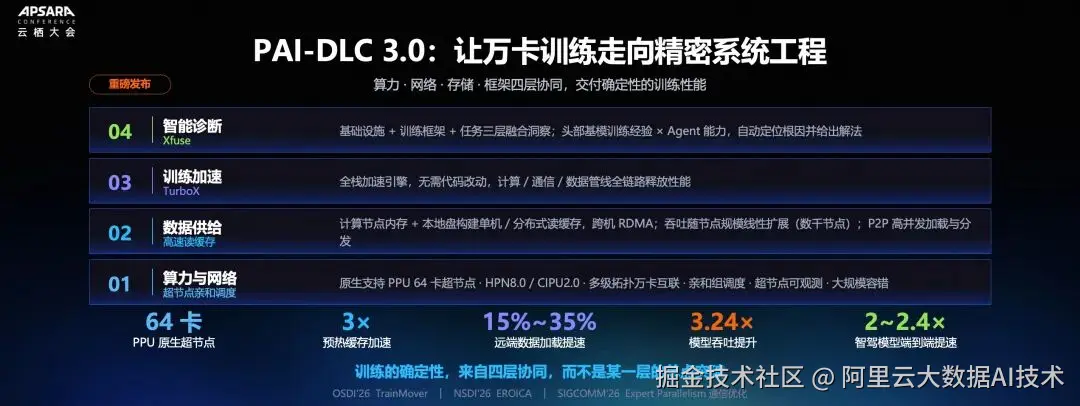
算力与网络层,PAI-DLC 3.0 原生支持 PPU 64 卡超节点,结合 HPN 8.0 与 CIPU 2.0,构建多级拓扑、万卡互联的算力底座;配合亲和组调度、超节点可观测与大规模容错,让万卡不再只是"堆得多",而是"协同得起来"。
数据供给层 ,PAI-DLC 3.0 用计算节点内存与本地盘构建单机 / 分布式读缓存,跨机 RDMA 打通节点边界,P2P 高并发加载与分发让吞吐随节点规模线性扩展到数千节点。实测中,预热缓存带来 3 倍加速,远端数据加载提速 15%~35%。
训练加速层 ,全栈加速引擎 TurboX 无需修改代码,即可在计算、通信、数据管线全链路释放性能。在真实业务负载下,模型吞吐提升 3.24 倍,智驾模型端到端训练提速 2~2.4 倍。
智能诊断层,全新推出的 XFuse 模块融合算力底座、训练框架、任务运行三层洞察,将头部基模团队训练经验与 Agent 能力结合,自动定位根因并给出解法,让万卡训练不再依赖"专家盯屏"。
PAI-DLC 3.0 背后是多年的系统研究积累:TrainMover(OSDI'26)解决训练中断的秒级恢复,EROICA(NSDI'26)做在线性能排障,Expert Parallelism 通信优化(SIGCOMM'26)攻克 MoE 专家并行的通信瓶颈。这些论文成果共同沉淀为 PAI-DLC 3.0 中可开箱即用的产品能力。
PAI-RLS:一站式跑通 Agentic RL,从实验到规模化生产
如果说 PAI-DLC 3.0 回答的是"如何在万卡规模上把训练跑得稳、跑得快",那么当训练进入以 RL 为主路径的后训练阶段,还有一个更棘手的问题:如何让 Rollout、Train、Eval、Env 多角色协同的反馈闭环规模化跑起来。模型竞争的焦点正在从"单次训练规模"转向"反馈闭环的速度、质量与可靠性",企业要把 Agent 落到自己的数据和场景上,RL 是实现这一目标的主路径,也是整个链路中工程难度最高的部分。
本次云栖大会预发布的 PAI-RLS,提供开箱即用的高性能强化学习训练服务,帮助企业降低 Agentic RL 的工程复杂度,把 RL 从实验落地到规模化生产。基于自研 RL 引擎实现训推解耦与高并发沙箱调度,以全链路观测与智能诊断保障训练稳健、可观测、可优化。
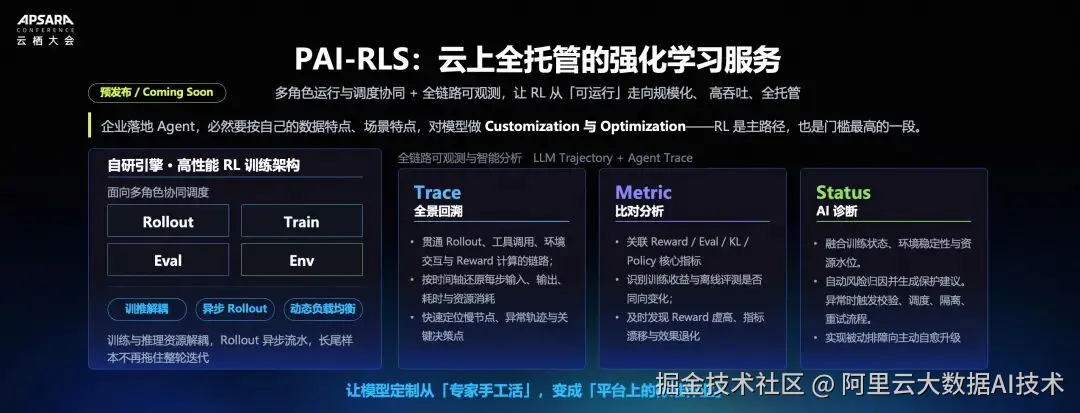
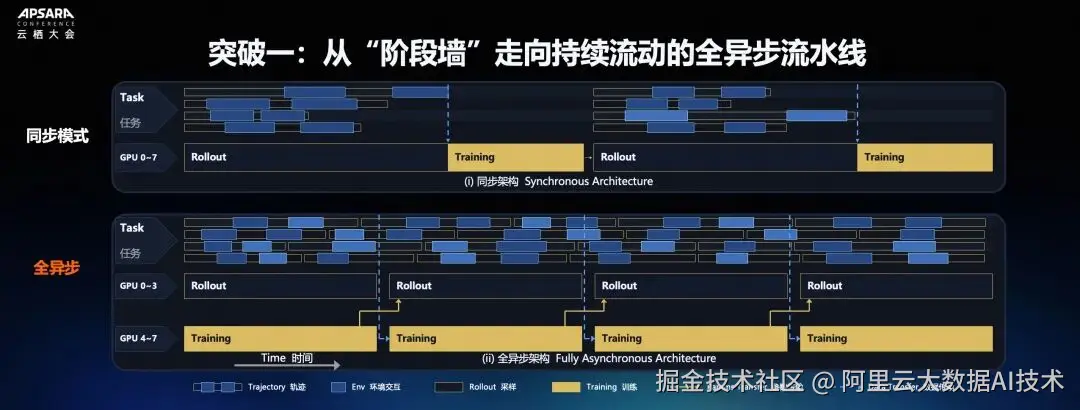
突破一,从"阶段墙"到全异步流水线。 同步 RL 像一场接力赛,Rollout、Reward、Training 每一棒都必须等前一棒完全结束,最慢任务被放大成全局等待,GPU 出现明显气泡。PAI-RLS 采用训推分离架构,让 Rollout、Reward、Training 和权重同步各自持续运行,通过回放队列和版本管理连接。为避免异步带来的样本陈旧度问题,PAI-RLS 用 max_version_diff 建立"版本边界",配合 Chunk 调度把长轨迹切成可调度单元,优先回收已完成结果。在长序列 RL 场景实测中,32K / 64K / 128K 三种配置下,端到端训练时间在各自组内分别取得 1.82×、2.65×、3.16× 的加速。
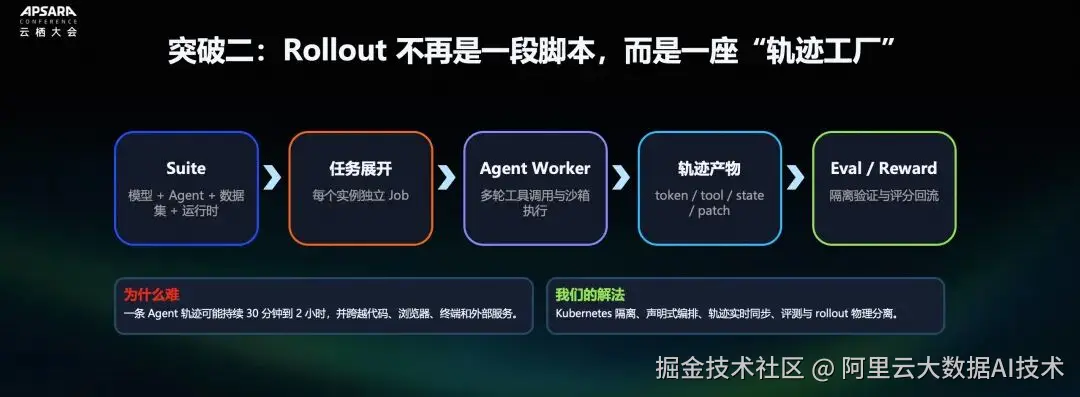
突破二,Rollout 从"一段脚本"到"一座轨迹工厂"。 一条 Agent 轨迹可能持续 30 分钟到 2 小时,跨越代码仓库、浏览器、终端和外部服务,传统"每个团队写一段脚本"的方式根本无法规模化。PAI-RLS 把它变成一座声明式轨迹工厂:用户提交 Suite(模型 + Agent + 数据集 + 运行时),平台完成任务展开、调度执行、产物归档与评分回流;Rollout 与 Eval 物理隔离,支持 Replay 与关键轨迹审计。目前平台已覆盖 12 种主流 Agent 框架、28 类隔离环境、30+ 权威基准评测,支持千级并发任务编排。
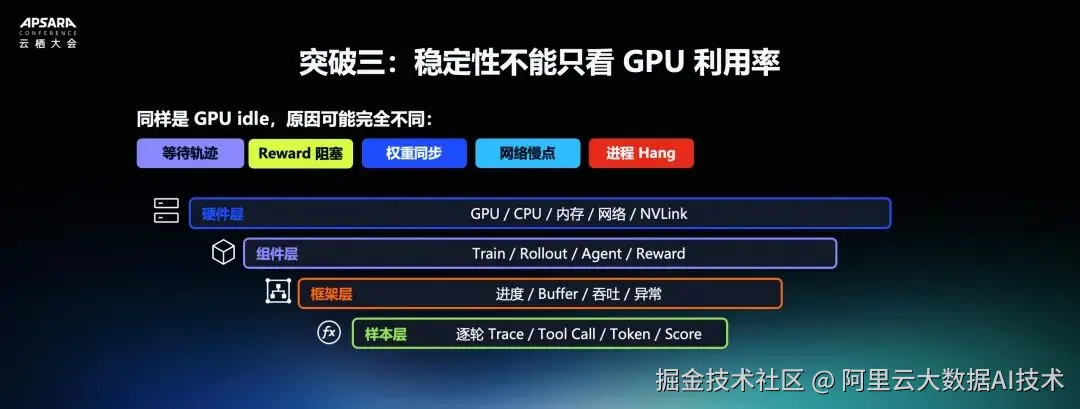
突破三,可观测性从"看 GPU 利用率"到"看每一条轨迹"。 RL 任务里,GPU idle 只是现象,背后可能是 Rollout 没产出、Reward 阻塞、权重同步、网络慢点或进程 Hang。XFuse 把观测做成硬件、组件、框架、样本四层,配合角色感知的 Hang 诊断和逐轮 Trace,让"模型效果问题"与"系统性能问题"在同一条时间线上对齐,让算法工程师与系统工程师围绕同一个事实定位问题。
除此之外,PAI-RLS 在生产级可靠性上做了系统性设计:任务、状态写入、客户端多级重试;断点续跑识别已完成与在途任务,只回捞缺失部分;训练状态覆盖 step、权重、优化器与轨迹消费进度,保证跨角色的一致性恢复。
PAI-CrystalLLM :仿真万卡训练
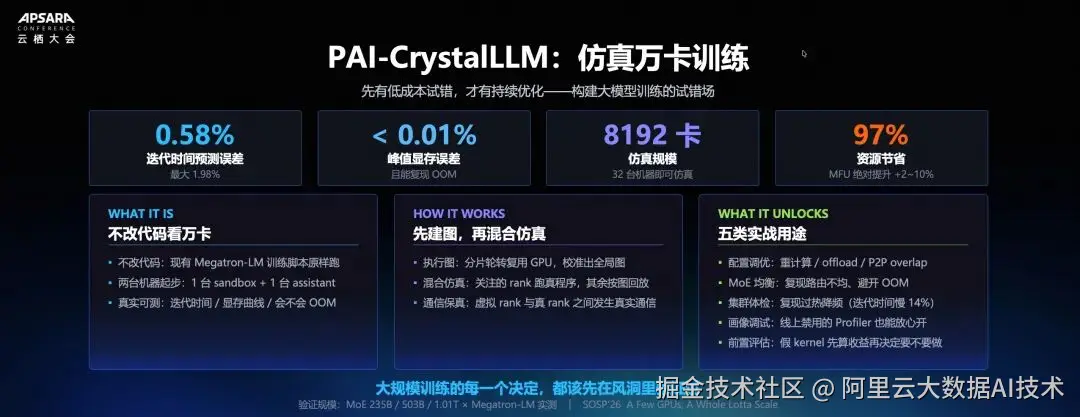
PAI-CrystalLLM,让每一个训练决定先在"风洞"里验证过。大规模训练的每一次配置调整------重计算、offload、P2P overlap、MoE 均衡、集群体检------都代价高昂。CrystalLLM 用"先建图,再混合仿真"的思路,让现有 Megatron-LM 训练脚本原样跑,两台机器起步(1 台 sandbox + 1 台 assistant),关注的 rank 跑真程序、其余按图回放,虚拟 rank 与真 rank 之间发生真实通信。实测中,只用 32 台机器即可仿真 8192 卡规模,资源节省 97%;迭代时间预测误差 0.58%(最大 1.98%),峰值显存误差 <0.01% 且能复现 OOM;在 MoE 235B / 503B / 1.01T 模型上完成 Megatron-LM 实测,MFU 绝对提升 2~10%。相关工作发表于 SOSP'26。
VLA 后训练:加速从数字世界到物理世界的延伸
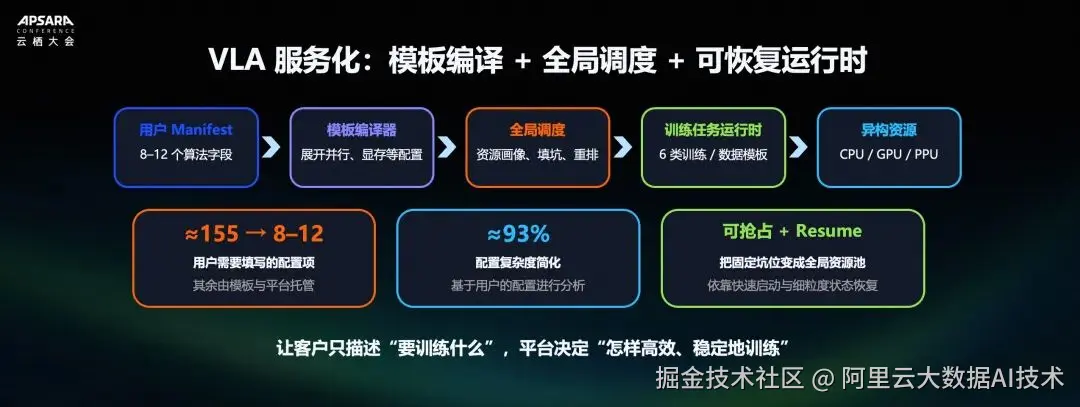
VLA 后训练,让同一套反馈基础设施从 token 世界延伸到物理世界。 相比 LLM,VLA 后训练面临三重挑战:多模态状态与动作让显存波动更难预测;一条轨迹可能同时消耗 CPU 仿真、GPU 渲染与 GPU / PPU 推理;真实环境中的控制器、传感器又随时可能阻塞。PAI 的解法是把"环境本身"纳入系统调度:用户只填写 8--12 个算法字段,模板编译器自动展开并行度、offload、micro-batch、显存切分和后端选择,全局调度按 CPU / GPU / PPU 资源画像做填坑与重排,运行时负责快速启动、checkpoint 与 resume。基于对 151 份 RLinf 配置的分析,用户需要填写的字段从典型约 155 个压缩到 8--12 个,配置复杂度简化约 93%。目前,该方案已在 RLinf 与 LIBERO-10 仿真环境中完成端到端流程跑通。
训练不再是"跑得动",而是"跑得稳、跑得快、跑得可信"
过去一年,使用模型的方式已经彻底改变。
PAI-DLC 3.0 用算力、网络、存储、框架四层协同,把万卡训练做成了精密系统工程;PAI-RLS 用全异步流水线、轨迹工厂、四层可观测三大突破,一站式跑通 Agentic RL,从实验到规模化生产,并在 Qwen 3.8 上验证了 3.8 倍端到端吞吐提升;PAI-CrystalLLM 让每一个训练决定先在风洞里验证过;VLA 后训练则把同一套反馈基础设施,从 token 世界延伸到物理世界。而这一切,都跑在新一代 PPU 1.5 底座之上。
从算力到智能体,PAI 把 AI 训练基础设施,整体推进到了下一代。客户拿到的不是一张新卡,也不是一次实验的成功,而是一条能被持续复制的生产线。