订单系统的明细表通常按交易写入:一笔订单一行,客户、渠道、金额、时间和状态放在同一条记录里。这样的行存布局适合新增订单、修改状态、按订单号查详情。等到月底做经营分析,查询只需要日期、区域和金额,却要把整张宽表一行行读出来,磁盘和内存都在为没有用到的列付出代价。
列存储解决的是另一类问题:同一列的数据连续组织,分析查询可以只读取参与过滤、分组和聚合的列。金仓数据库 KingbaseES 的产品简介把列存与并行计算放在分析型场景中介绍,也强调事务处理和分析处理可以按不同负载组织。实际落地时,我先把交易表、历史数据和分析宽表分开看,再决定哪些表适合列存。
先判断这张表到底在服务谁
在线订单表每天都有写入,客服会按订单号查详情,支付回调会更新状态。这类访问需要一行一行地拿到完整记录,行存更符合访问方式。历史订单汇总表则不同:它通常按月追加,查询读取的只是日期、区域、渠道和金额,写入很少,扫描和聚合占主要时间。
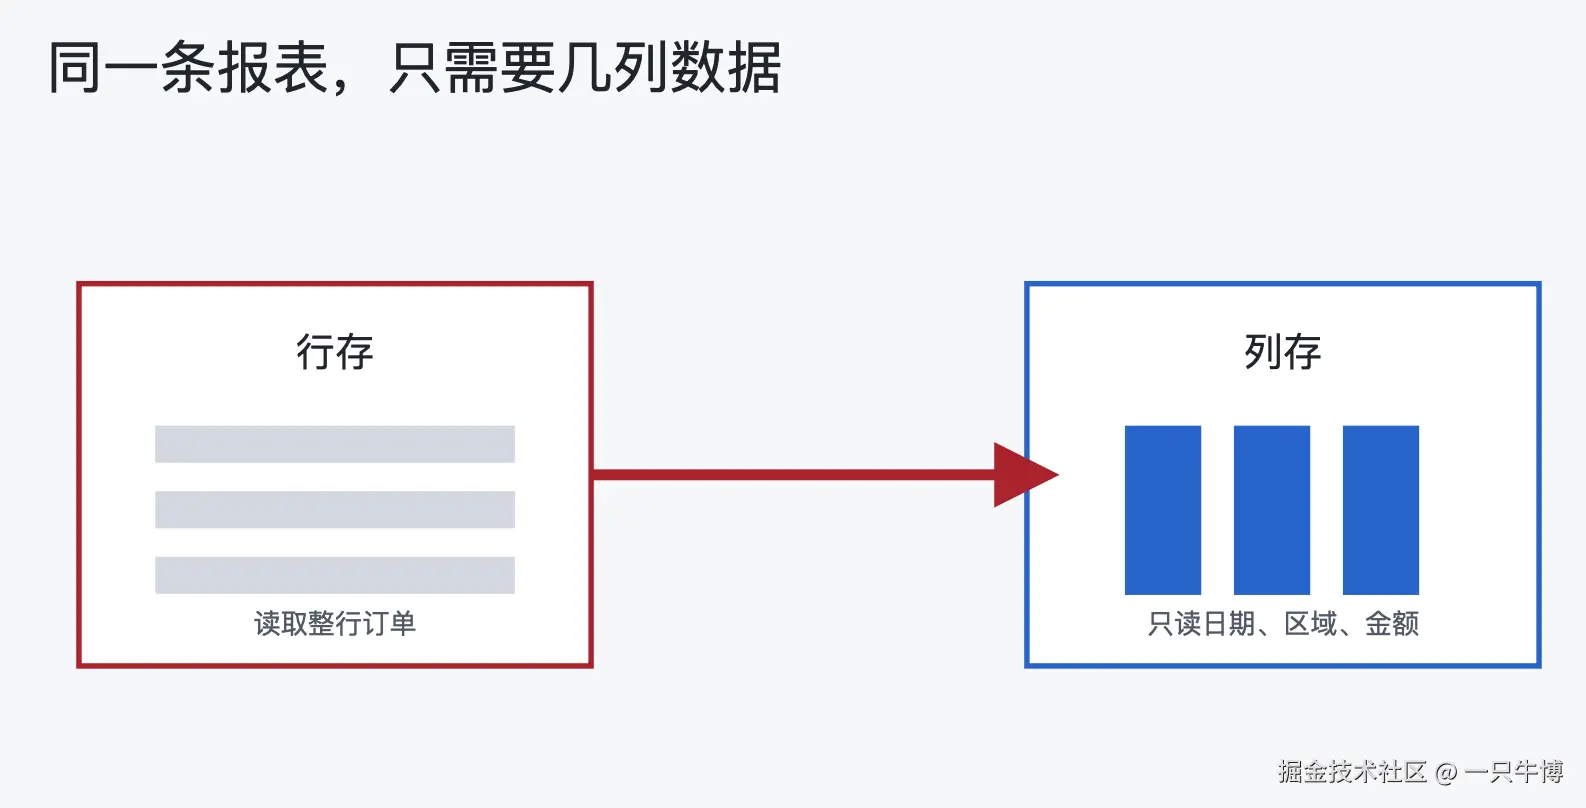
可以先用一条 SQL 看报表真正读取了哪些列:
sql
SELECT order_date,
       region_code,
       channel_code,
       SUM(order_amount) AS amount_sum,
       COUNT(*) AS order_count
FROM fact_order_history
WHERE order_date >= DATE '2026-09-01'
  AND order_date <  DATE '2026-10-01'
GROUP BY order_date, region_code, channel_code
ORDER BY order_date, region_code, channel_code;
如果历史表还有几十个客户描述、收货地址、营销标签字段,这条查询并不需要它们。列存的收益来自"少读不相关列",不是来自把 SQL 写得更复杂。
先按时间切开历史数据
大表的存储方式和分区方式可以一起设计。KingbaseES 支持按范围、列表和哈希等方式划分大表,日期范围分区适合历史订单这类按月查询的场景。先按月份分区,报表查询只访问目标月份,后续归档和备份也能按分区处理:
sql
CREATE TABLE fact_order_history (
    order_id      BIGINT NOT NULL,
    order_date    DATE NOT NULL,
    region_code   VARCHAR(16) NOT NULL,
    channel_code  VARCHAR(16) NOT NULL,
    customer_id   BIGINT NOT NULL,
    order_amount  DECIMAL(14, 2) NOT NULL,
    order_status  VARCHAR(16) NOT NULL
)
PARTITION BY RANGE (order_date) (
    PARTITION p202609 VALUES LESS THAN (DATE '2026-10-01'),
    PARTITION p202610 VALUES LESS THAN (DATE '2026-11-01'),
    PARTITION p202611 VALUES LESS THAN (DATE '2026-12-01')
);
分区解决的是访问范围和管理边界,列存解决的是分区内部读取哪些列。二者不是互相替代的关系。只建了分区而没有减少列读取,宽表扫描仍然可能很重;只把整张表改成列存而没有合理的时间边界,查询仍可能扫过大量历史数据。
列存表先用在低频更新的分析数据
对于已经封存的月份,可以将订单明细整理为只读分析数据。具体的列存实现和创建方式与 KingbaseES 版本、组件安装情况有关,目标环境应先确认列存扩展是否可用。以官方插件手册中的 cstore_fdw 示例为例,创建外部列式表时需要明确文件位置和压缩方式:
sql
CREATE EXTENSION cstore_fdw;
CREATE SERVER cstore_server
FOREIGN DATA WRAPPER cstore_fdw;

CREATE FOREIGN TABLE fact_order_column (
    order_date    DATE,
    region_code   TEXT,
    channel_code  TEXT,
    order_amount  NUMERIC(14, 2),
    order_status  TEXT
)
SERVER cstore_server
OPTIONS (
    filename '/data/kingbase/column/fact_order_202609.cstore',
    compression 'zstd'
);
上面的 DDL 我只拿来说明两个参数:列式文件放在哪里、压缩方式写在哪里。真正落到生产环境前,我会先确认目标版本能否使用对应扩展,再检查数据库运行用户对目录的权限、备份任务能否覆盖这些文件,以及报表和归档任务是否会同时访问。若 CREATE EXTENSION 就无法执行,先处理组件和授权,不能直接把这段语句当成通用建表脚本。
报表 SQL 也按实际字段来写,先只取这次聚合需要的列:
sql
SELECT region_code,
       channel_code,
       SUM(order_amount) AS amount_sum,
       COUNT(*) AS order_count
FROM fact_order_column
WHERE order_date >= DATE '2026-09-01'
  AND order_date <  DATE '2026-10-01'
  AND order_status = 'PAID'
GROUP BY region_code, channel_code
ORDER BY region_code, channel_code;
把查询改成 SELECT * 后,数据库还要读取那些报表根本用不到的列。报表需要哪些字段就写哪些字段;确实要看一笔订单的完整内容时,再拿订单号回到行存主表查询。
最近的订单和封存数据分开处理
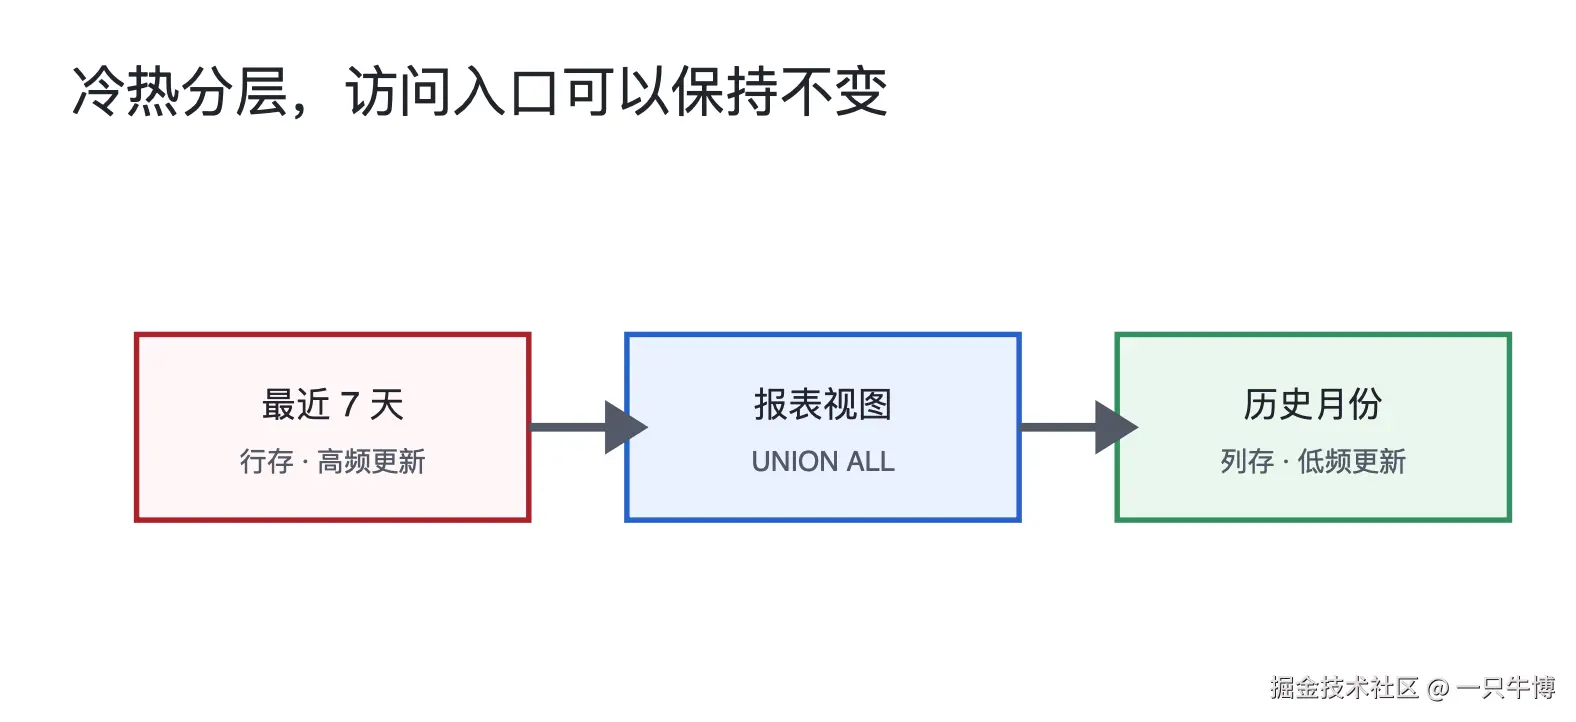
最近七天的订单会不断更新,适合留在行存主表;超过结算周期的订单很少修改,可以转入历史分析层。查询入口可以用一个视图把两部分合在一起:
sql
CREATE VIEW v_order_for_report AS
SELECT order_id,
       order_date,
       region_code,
       channel_code,
       order_amount,
       order_status
FROM fact_order_current
WHERE order_date >= CURRENT_DATE - 7

UNION ALL

SELECT order_id,
       order_date,
       region_code,
       channel_code,
       order_amount,
       order_status
FROM fact_order_column;
视图只统一访问入口,不会自动让两个存储层拥有相同的更新能力。历史表如果按月封存,就不要让在线应用通过这个视图随意修改历史数据;写入和归档仍应使用单独的任务和权限。
冷热分层完成后,可以按月份核对两边的数量和金额,确认归档没有漏行:
sql
SELECT 'current' AS data_layer,
       COUNT(*) AS row_count,
       SUM(order_amount) AS amount_sum,
       MIN(order_date) AS first_date,
       MAX(order_date) AS last_date
FROM fact_order_current
UNION ALL
SELECT 'history',
       COUNT(*),
       SUM(order_amount),
       MIN(order_date),
       MAX(order_date)
FROM fact_order_column;
数量和金额对不上时,先查归档批次、时间边界和重复订单,不要直接重新导入整个月的数据。列存文件通常是批量装载的结果,重复装载会让后面更难分辨哪一批数据是正确的。
列存不是所有查询的加速按钮
列存更适合少列扫描、批量聚合和历史分析。按订单号查一行、频繁更新支付状态、需要同时返回几十列的详情接口,仍然更适合行存。即使是同一张表,报表查询和交易查询的访问方式也不同,不能只凭"列存"两个字就替业务作结论。
在 KingbaseES 中,最终要结合执行计划、实际数据量和存储设备确认结果。先看查询是否命中了目标分区,再看读取的列和聚合节点,最后比较冷缓存与热缓存下的耗时。没有这些信息时,只能说列存适合这种访问模式,不能直接写成固定倍数的性能承诺。
我会把列存落地拆成三件事:在线交易表保持稳定写入,历史分析数据按时间分层,报表 SQL 只读取需要的列。表的组织方式跟着访问方式走,改造范围也更容易控制。