TL;DR :2026-10-20 的 PyTorch Conference 上,Google 与 Meta 联合宣布 TorchTPU 正式开源 ------一个运行时零 JAX 依赖、eager 优先的 PyTorch 原生 TPU 后端。官方口径是:
model.to("cuda")改成model.to("tpu")就能开箱跑(拿峰值性能当然还得调);已持续验证约 5000 个 Hugging Face 高频模型,Qwen3 235B MoE 训练一路扩到 8192 芯片的 TPU Pod,第三方 InferenceX 基准上拿下推理成本 Pareto 前沿。vLLM、SGLang、TorchTitan、TorchRec、Ray 同步接入。仓库:google-pytorch/torch_tpu。
旧方案有多难受,新方案就有多大解脱
PyTorch 用户想上 TPU,此前的标准姿势是 PyTorch/XLA------2020 年的 Lazy Tensor 路线。用过的都懂:要侵入式改源码圈出编译区域,编译等待长,eager 调试基本告别,分布式原语跟进也慢。另一条路 TorchAX 则是把 PyTorch 塞进 JAX 的执行模型,相当于换种范式写代码。
TorchTPU 官方立的原则就叫 PyTorch Citizenship :运行时零 JAX 依赖;eager 模式是一等公民;torch.compile(model, backend="tpu") 走的是 Torch Dynamo 前端(不是 Lazy Tensor);DDP/FSDP/DTensor 这些分布式惯用法靠在 Process Group API 层实现的 TPU 集合通信原生支持------没有 NCCL,集合通信直接以 StableHLO 算子下沉到芯片。
迁移的官方口径简单到离谱:
python
device = torch.device("cuda")            # → torch.device("tpu")
dist.init_process_group(backend="nccl")  # → dist.init_process_group(backend="tpu_dist")
model = model.to(device)
⚠️ 注意别被带偏:官方同时明说,只改这一行「能跑」但拿不到峰值性能------模型的形状、切分、算子选择都是偏 GPU 架构的,要榨干 MXU 还得做 TPU 特定调优(自定义 Pallas 内核、topology_aware_mesh 等)。
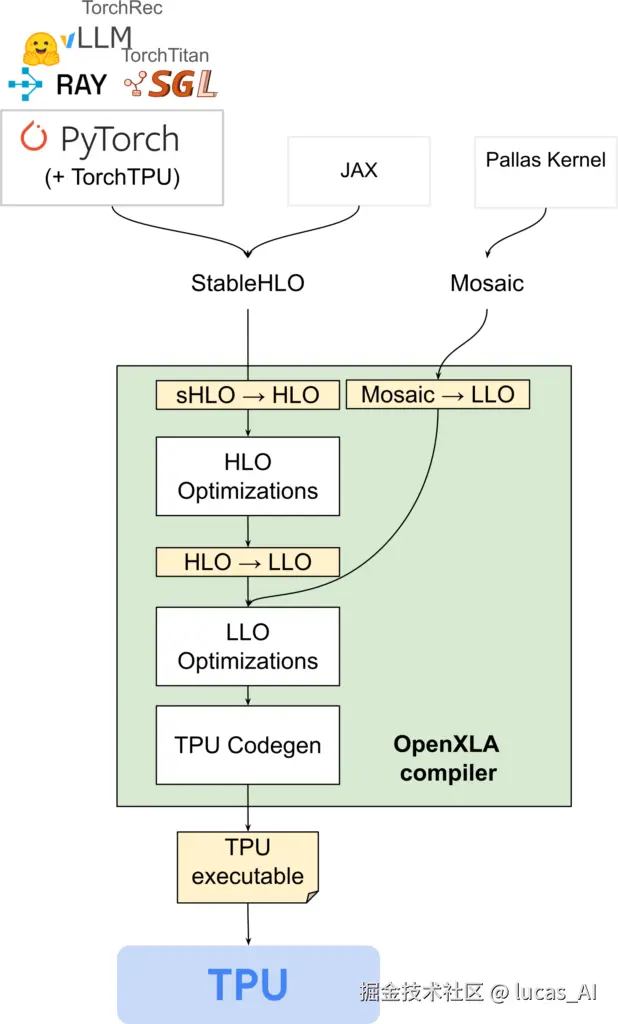
底下做了什么硬活
几个值得工程人知道的细节:
- eager 三模式 :默认 Strict(逐算子异步下发);Debug(同步执行,等价 CUDA_LAUNCH_BLOCKING);以及新发明的 DeferAndFuse ------把多个算子推迟到「物化点」(比如
.to("cpu"))聚合编译,官方数据比 Strict eager 快 50% 以上,还因算子融合降低了 HBM 峰值内存。 - 三级编译缓存:进程内 → 本机跨进程共享内存 → 远端持久化(GCS),用 192-bit 指纹做键,Colab/数据中心场景重启也能复用编译产物。
- Bounded Dynamism :XLA 传统上静态 shape,变长序列就得重编译;TorchTPU 在做「有界动态 shape」,编译一次自动处理 padding/slicing(
torch.compile暂时强制dynamic=False,是已知的临时限制)。 - view 语义魔法:StableHLO 是不可变、无原地写的函数式 IR,TorchTPU 用 view 分解 + 反转实现了 PyTorch 的 view/原地写语义------分布式训练的拼接参数数组这类模式因此可用。
- 精度默认 medium:BF16 矩阵乘 + FP32 累加(跟 CUDA 默认 highest FP32 不同);要 FP32 精度得用 3-pass/6-pass 算法分解,代价约 3×/6× MXU 算力------从 GPU 搬过来的 FP32 代码在 TPU 上会「悄悄」降精度,这是迁移时最值得盯的一个坑。
- 自定义内核走 Pallas :生产路线是 JAX/Pallas 写内核、
torch.tpu.pallas.jax_op包成原生 PyTorch 函数;OpenXLA 的 Tokamax 内核库(MoE grouped matmul、paged attention、MLA 等)直接可用。
官方给出的验证数据
模型覆盖是这次发布最实的部分:持续验证约 5000 个 HF 高频模型,4917 个端到端验证,Tier-1 无崩溃通过率 98%,Tier-2 架构代表模型与 GPU 基线的数值一致性 97%(638/657)。Qwen、DeepSeek、Gemma、Llama、Whisper、CLIP、BERT 系全在列表里。
性能数字(均为官方或 SemiAnalysis 提交基准,可以当「厂商成绩单」读):
| 场景 | 配置 | 结果 |
|---|---|---|
| 纯 PyTorch prefill | Muse Glimmer 30B,TPUv7 单芯片 | ~25.7k tokens/s,MFU 59%(seq 5120) |
| 纯 PyTorch 训练 | 同模型,4 芯片 FSDP | ~5.6k tokens/s/芯片,MFU 38% |
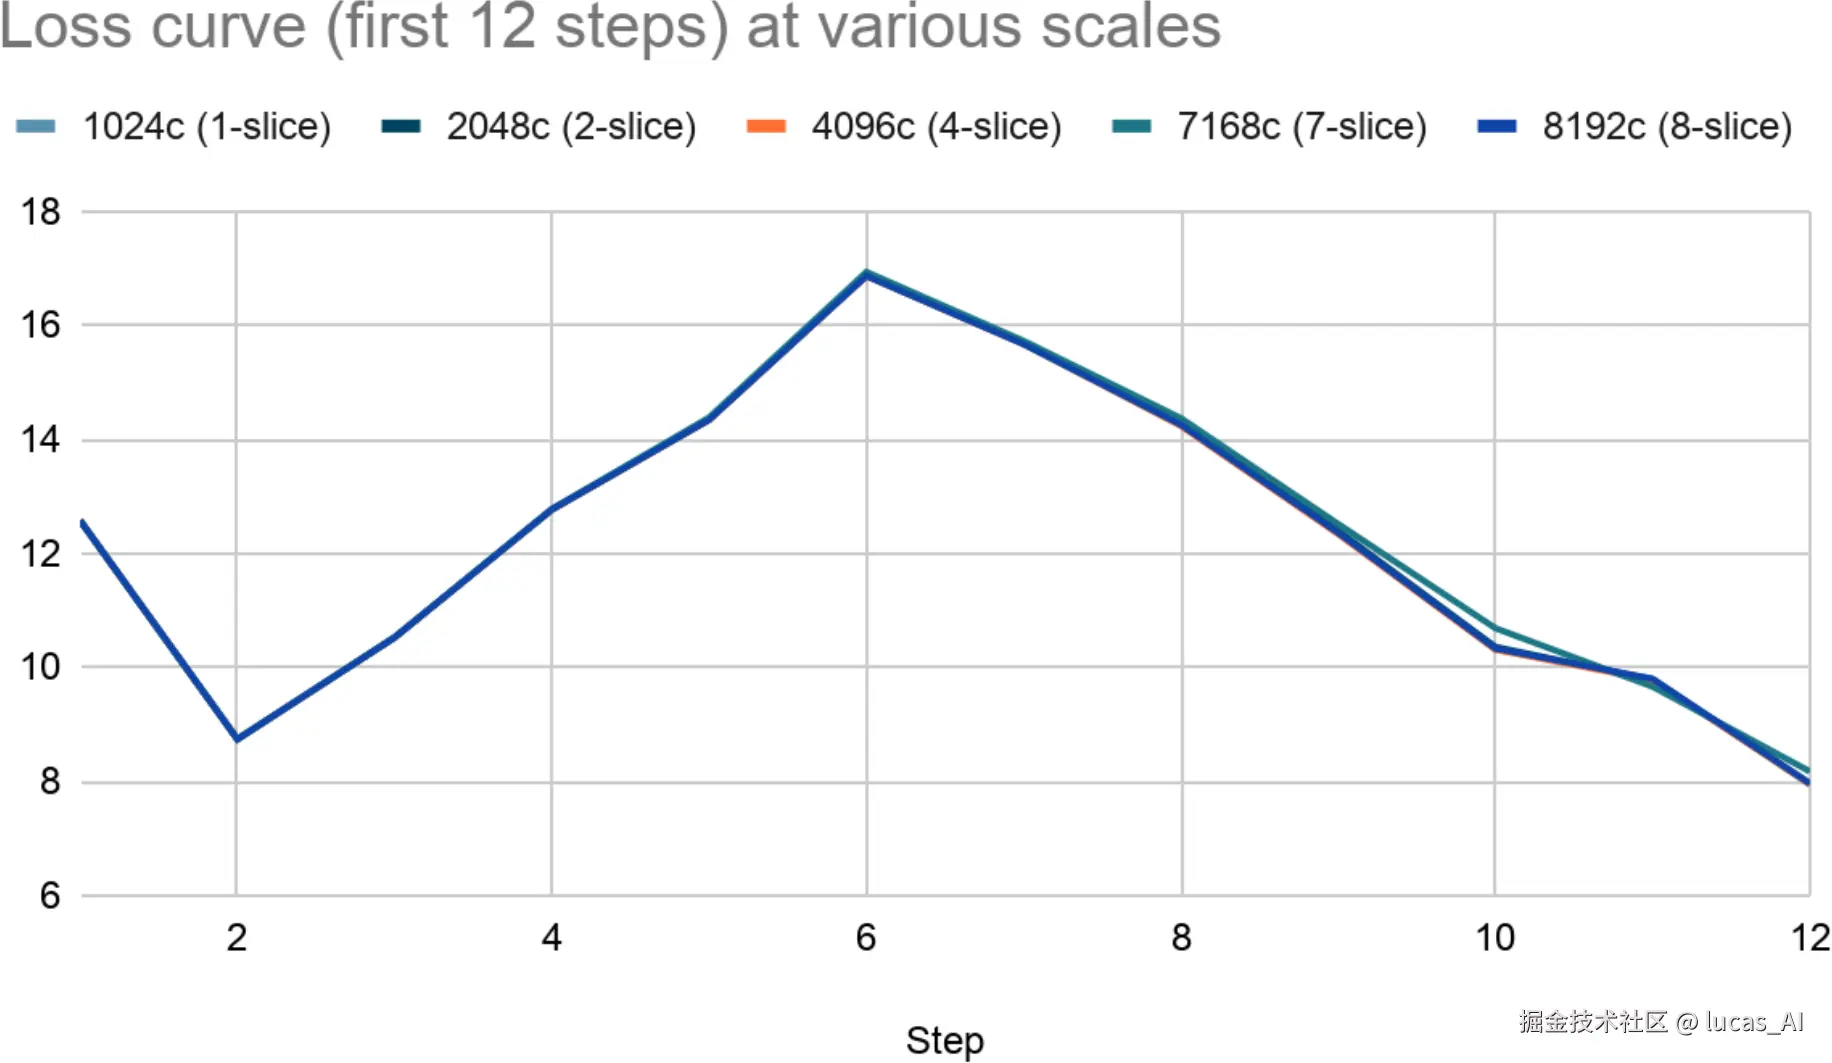
| Pod 级训练 | Qwen3 235B MoE,8192 芯片 v7 | 2104 tokens/s/TensorCore,MFU 27.1%,1024→8192 芯片 MFU 基本持平 |
| 大模型训练 | Llama 3 405B,1024 芯片 v7x,8K ctx | 500 tokens/s/芯片,MFU 50%+ |
| 推理成本 | SemiAnalysis InferenceX,Qwen 3.5 + vLLM | 2.01 美分/百万 token(8K/1K),AgentX 0.83 美分 + SOTA 交互性 |
| 推荐系统 | DLRM v2 + TorchRec,32 芯片 | 18.3ms/step,与 JAX 基线 100% 打平 |
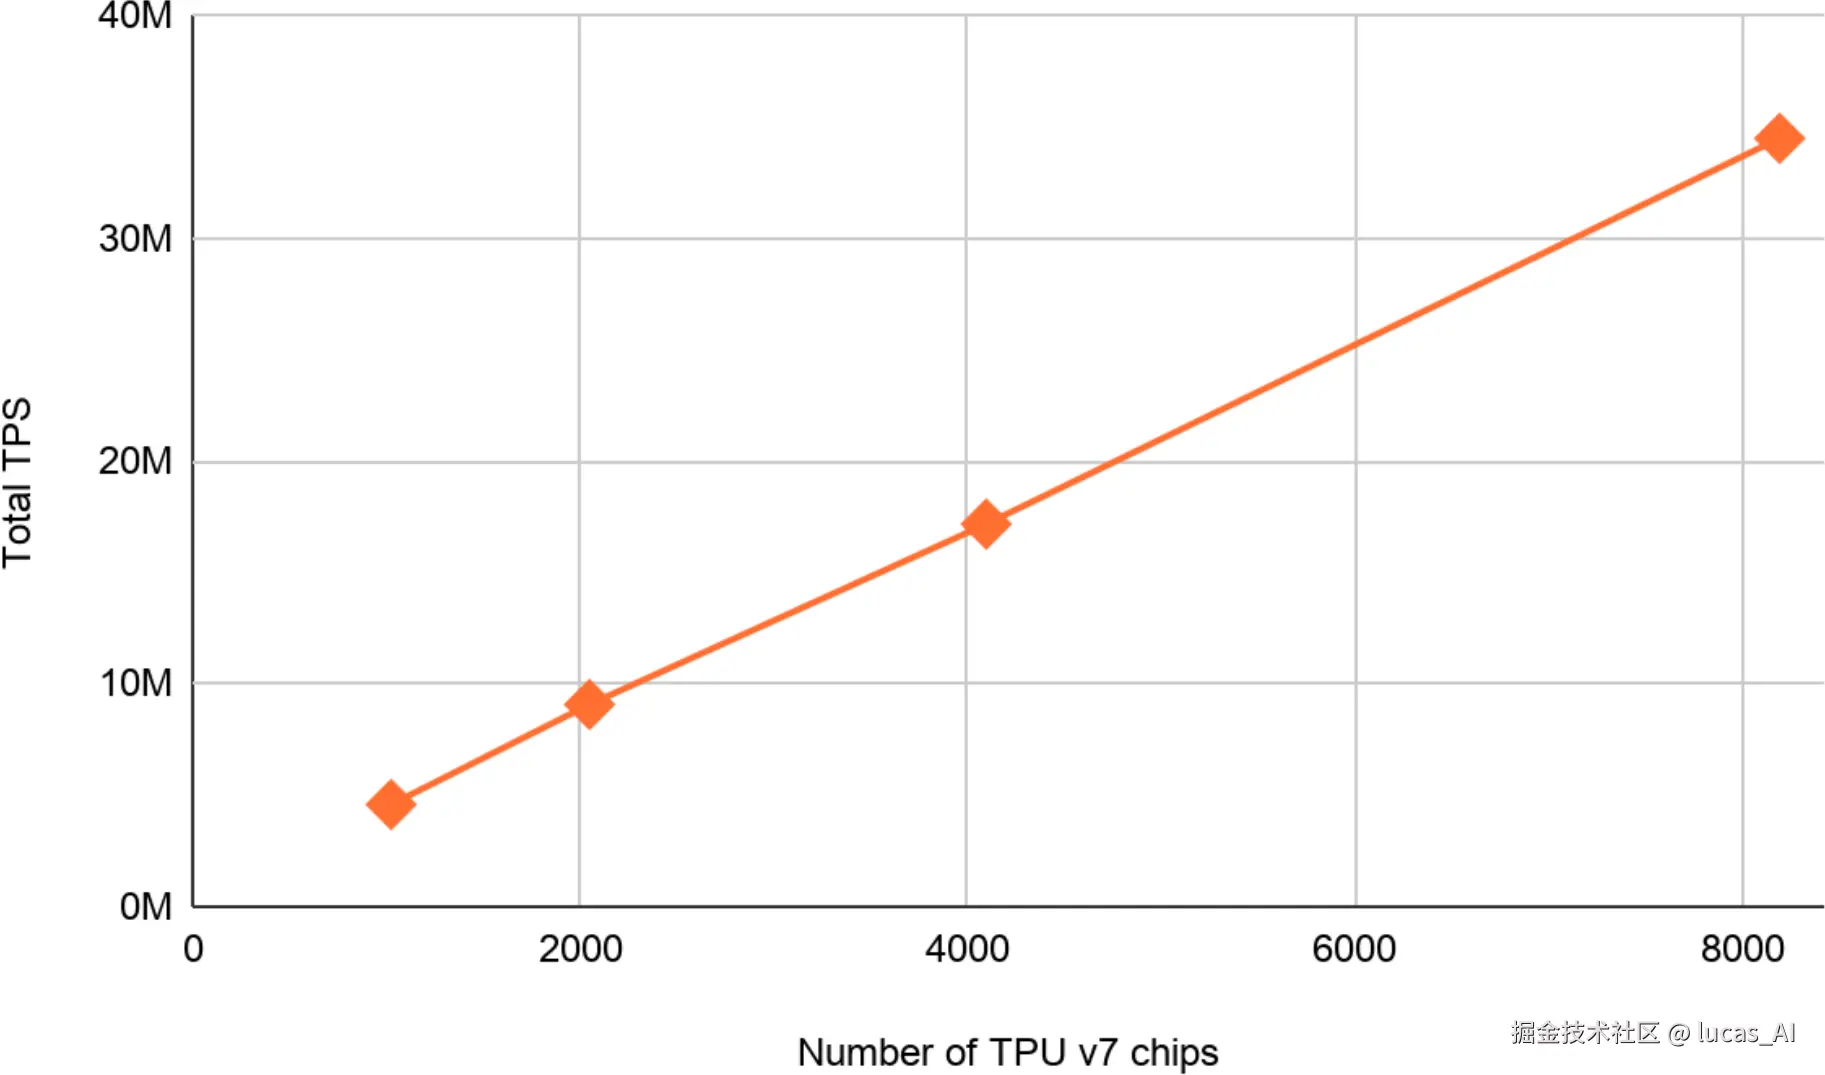
两处值得点名的澄清:一是 64 芯片上 PyTorch/TorchTitan 跑 Qwen3 235B MoE 拿到 1828 TPS,对 JAX/MaxText 的 1937 TPS------约 94%,「接近但还差一点」比「追平」更准确;二是 InferenceX/AgentX 属于厂商提交成绩的第三方基准,目前还没有中立机构做过 TorchTPU 与 PyTorch/CUDA 同任务对比的独立评测,这点官方博客也没回避。
怎么看这件事
时间线拼起来挺有意思:2020 年 PyTorch/XLA → 2025 年中项目启动 → 2025-12 Reuters 独家报道(「Google 联合 Meta 削弱 Nvidia CUDA 软件优势」)→ 2026-10 PyTorch Conference 官宣开源四仓库(运行时 + vLLM/SGLang/TorchTitan 的 TPU 支持)。发布节点选在 PyTorch 而非 Google 自己的大会,生态卡的意味很明显:TPU 过去是「JAX 专属硬件」,现在要变成「PyTorch 又一个 device」。
对开发者的实际影响:手里有 PyTorch 技术栈(vLLM/FSDP/DTensor)又想试试 TPU 成本的团队,迁移门槛从「学一套范式」降到了「改 device 字符串 + 做性能调优」。要注意的粗糙边缘:算子覆盖约 450 个 Aten 算子(结构性/复合算子跳过)、RL colocation 暂不支持(每设备单进程限制)、FP8/FP4 量化还在 roadmap 上、MPMD 场景需要 @spmd_safe 标注或编译握手。官方给未来 6-12 个月定的主题就是「生产加固」。
一句话总结:CUDA 护城河最深处第一次被正面挖开了口子------挖得好不好,接下来看社区用脚投票。
参考来源
- Introducing TorchTPU --- PyTorch 官方博客(技术长文,本文主要依据)
- TorchTPU is now open source --- Google Cloud Blog
- google-pytorch/torch_tpu --- GitHub
- Hugging Face ❤️ TorchTPU: TPUs, Natively
- TorchTPU: Running PyTorch Natively on TPUs at Google Scale --- Google Developers Blog
- Reuters:Google works to erode Nvidia's software advantage with Meta's help
- SemiAnalysis:TPU InferenceX --- Full Steam Ahead
- 图片来源:pytorch.org 官方博客配图(Fig 1-3)