做过文档解析的人多半有过这种体验:VLM(视觉语言模型,能同时看图读字的模型)把一份三百页研报的标题、表格、公式抽得干干净净,每个标题前还贴心地标好了 # 的数量------然后你把整份 Markdown 拼起来一看,二级标题挂在一级标题上面,第三章的小节跑去做附录的孩子了。单页看页页正确,合起来全盘错乱。
这不只是强迫症问题。RAG(检索增强生成,让大模型答题前先查资料)里按标题层级切 chunk(切块),层级错了,切出来的块有的臃肿如整章、有的细碎如半句,检索粒度全乱;目录导航、结构化问答更是直接塌方。阿里 Qwen DianJin 团队的这篇新论文,盯上的正是这个「页内很准、页间失忆」的夹缝:提出分层多模态记忆,在页级解析之上把长文档的标题层级重新排对,顺手还发了个更难的长文档基准。
💡 一句话总结 :VLM 逐页抽元素没问题,缺的是「我现在在第几层」的文档级记忆。这套方法给每个已出现的层级只留一个「最近代表标题」当锚点,预测新标题层级时只带锚点所在页------历史上下文的规模由树的深度(比如十几层)决定,而不是文档页数(几百页)。最长 387 页的基准上 Micro-STEDS 领先次优 7.46 分。
📄 论文:Heading Hierarchy Reconstruction for Complex and Long Documents with Level-Wise Multimodal Memory (arXiv 2610.18238)
一、痛点:逐页都对,合起来就是乱的
先说清楚任务。标题层级重建(heading hierarchy reconstruction)假设上游已经把标题找出来了------文本、所在页、边界框(bbox,标题在页面上的位置矩形)都有了,要做的是给每个标题定一个全局一致的层级数:1. 引言 是 1 级,1.1 背景 是 2 级,依此类推,最后按「l 级挂到最近的 l−1 级标题下面」的规则就能确定性建出整棵标题树。难就难在「全局一致」四个字。
为什么 VLM 干不好这事?直觉上让模型看一眼「上一个标题是几级」不就行了,但现实是分辨率和上下文长度的双重天花板。一份文档几十上百页,把所有页图一起塞进一次推理根本不可行;于是各显神通,结果各有各的伤。
现有两条主流路线可以这样盘点:MinerU-Popo 的动态分块,把若干页竖向拼成一张长图,靠块间重叠同步层级------长图一拼,单页视觉细节被稀释,重叠区也修不平块内的非均匀误差;LingDT-VL-OCR 的伪目录(Pseudo-ToC),把所有标题裁剪拼成目录样子的图,让 VLM 一次性还原层级------标题一多,输入图和输出层级都越拉越长,超长文档上就容易漏、重、乱。两条路的死因其实是同一个:想保历史,就得付出上下文随页数线性膨胀的代价。
那能不能不背全部历史,还把层级排对?这就是论文要回答的问题。
二、思路(🛠️):每个层级只记一个「最近代表」
作者的核心观察是:预测一个新标题的层级,你真正需要的历史信息其实很薄。要判断「2.2 节」该是几级,最有用的参照是最近的「第 2 章」和最近的「2.1 节」,而不是文档开头那张很久之前的「第 1 章」------参照物按层级各留一个最新的就够了。
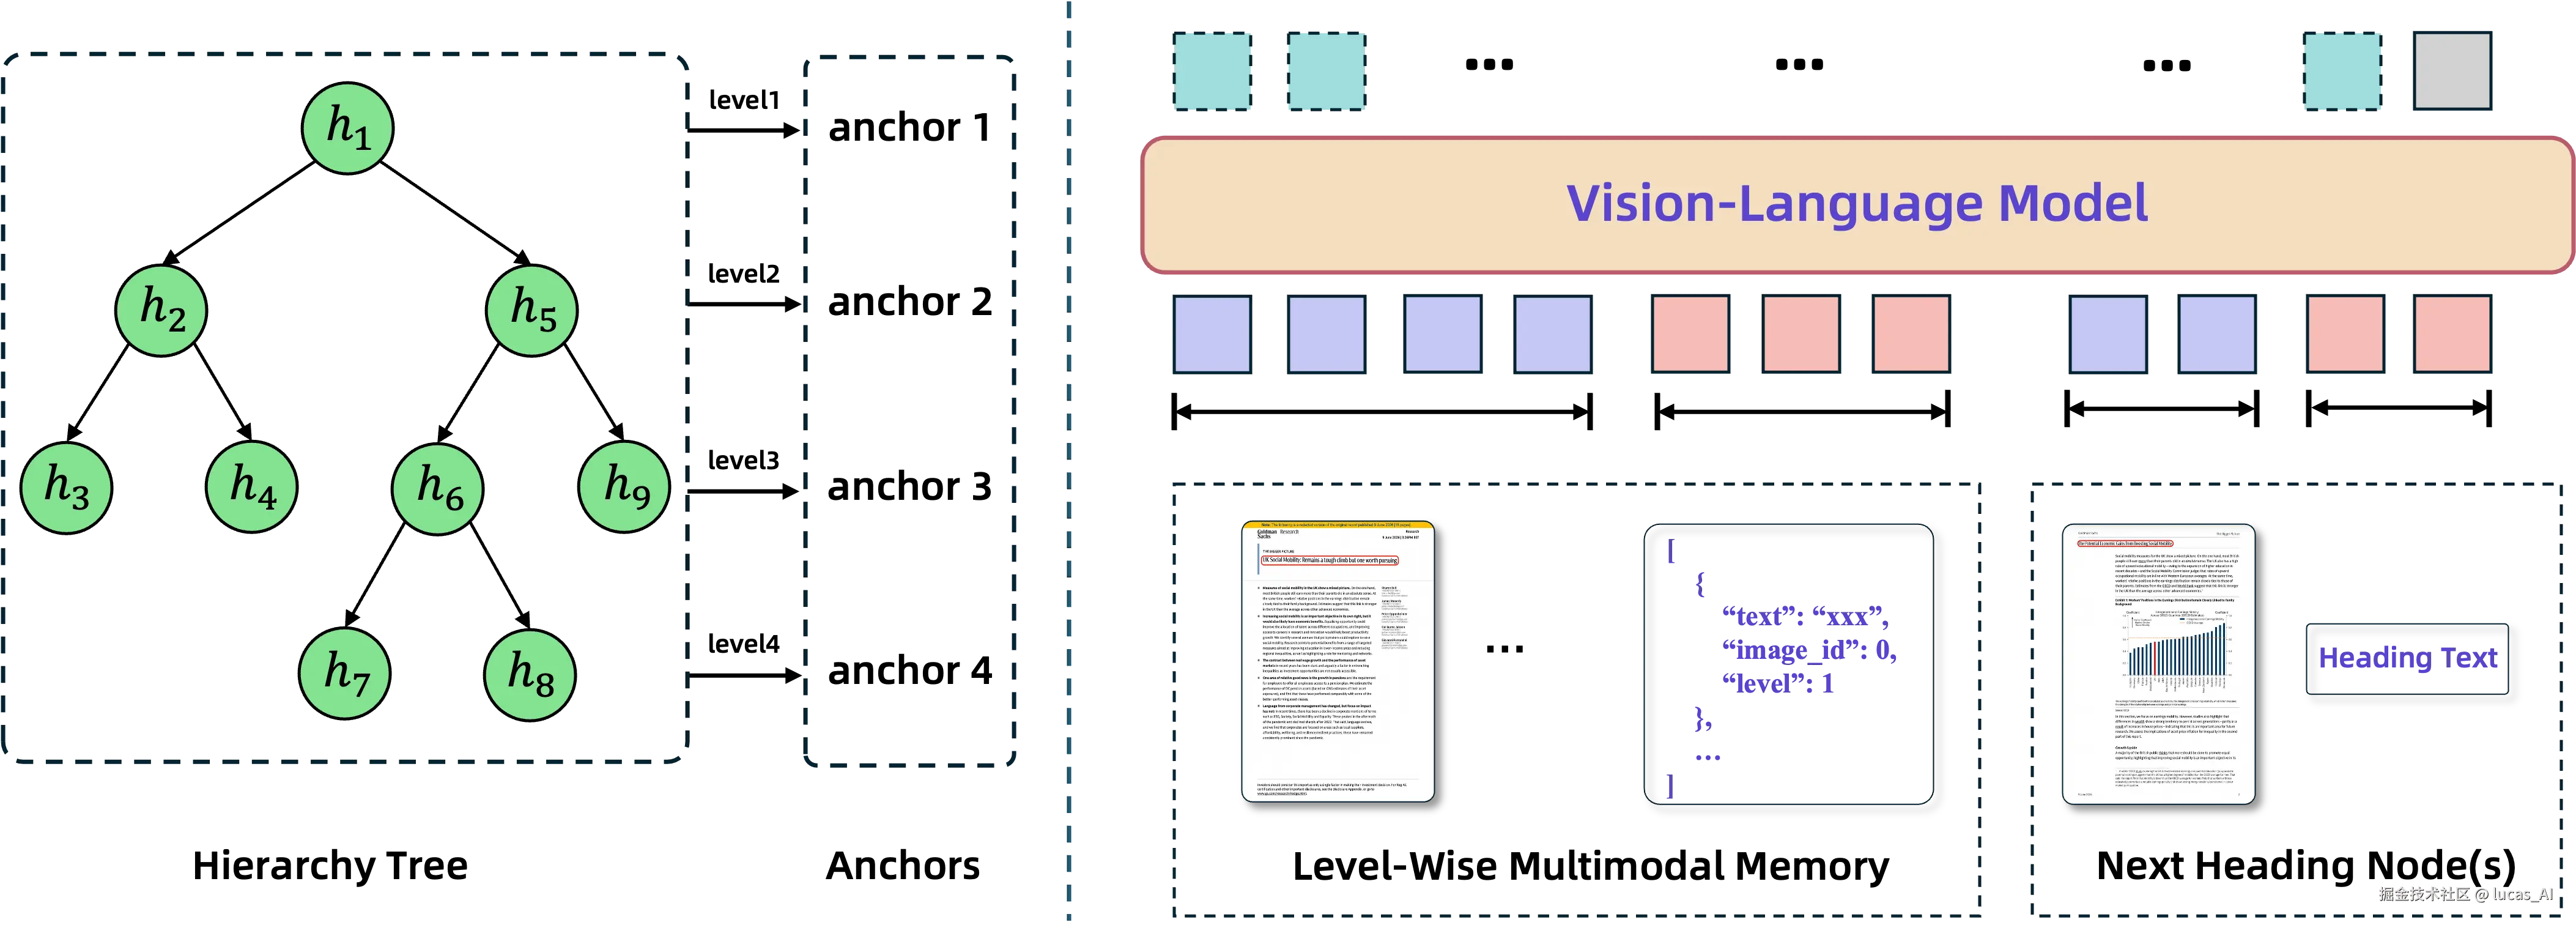
具体机制分三步。第一步,建记忆 :每处理完一批标题,就在已构建的标题树里,给每个出现过的层级保留「最近预测的那个标题」作为锚点(anchor,参照锚定节点),把这些锚点所在的页面挑出来,连同页面上全部已处理标题的文本、边界框和预测层级,打包成多模态记忆。锚点只负责选页,页上其他标题照样是免费的结构参照。由于每层至多一个锚点,记忆页数始终不超过树深------387 页的巨卷,如果标题树只有十层深,每步推理最多也就带十张历史页。
第二步,喂得聪明 :目标标题的边界框直接画在页面图上,坐标数字不写进文本 prompt。模型自己「看」到红框在哪,比读一串 (x_min, y_min, x_max, y_max) 更贴近它预训练时见过的人类排版世界。
第三步,带着镣铐生成:候选层级被约束在「上一标题层级 +1 以内」(禁止跳级),输出必须是合法 JSON,不合法就重试至多两次,还不行就投影回合法区间。整套流程不需要任何训练,套在现成 VLM 上就能跑;上下文在单步内固定,还顺带支持一次预测整页甚至连续四页的标题,摊薄调用成本,组内靠后的标题还能给靠前的提供「前瞻」线索。
顺带修了一个老毛病:早先把层级当「父子关系预测」来做的方法,默认第一个标题是根,后文再出现同级大标题就没法处理;这套方法第一个标题直接定 1 级,后面爱出几个 1 级出几个。
三、效果(📈):新基准上长文档优势拉开 7 分
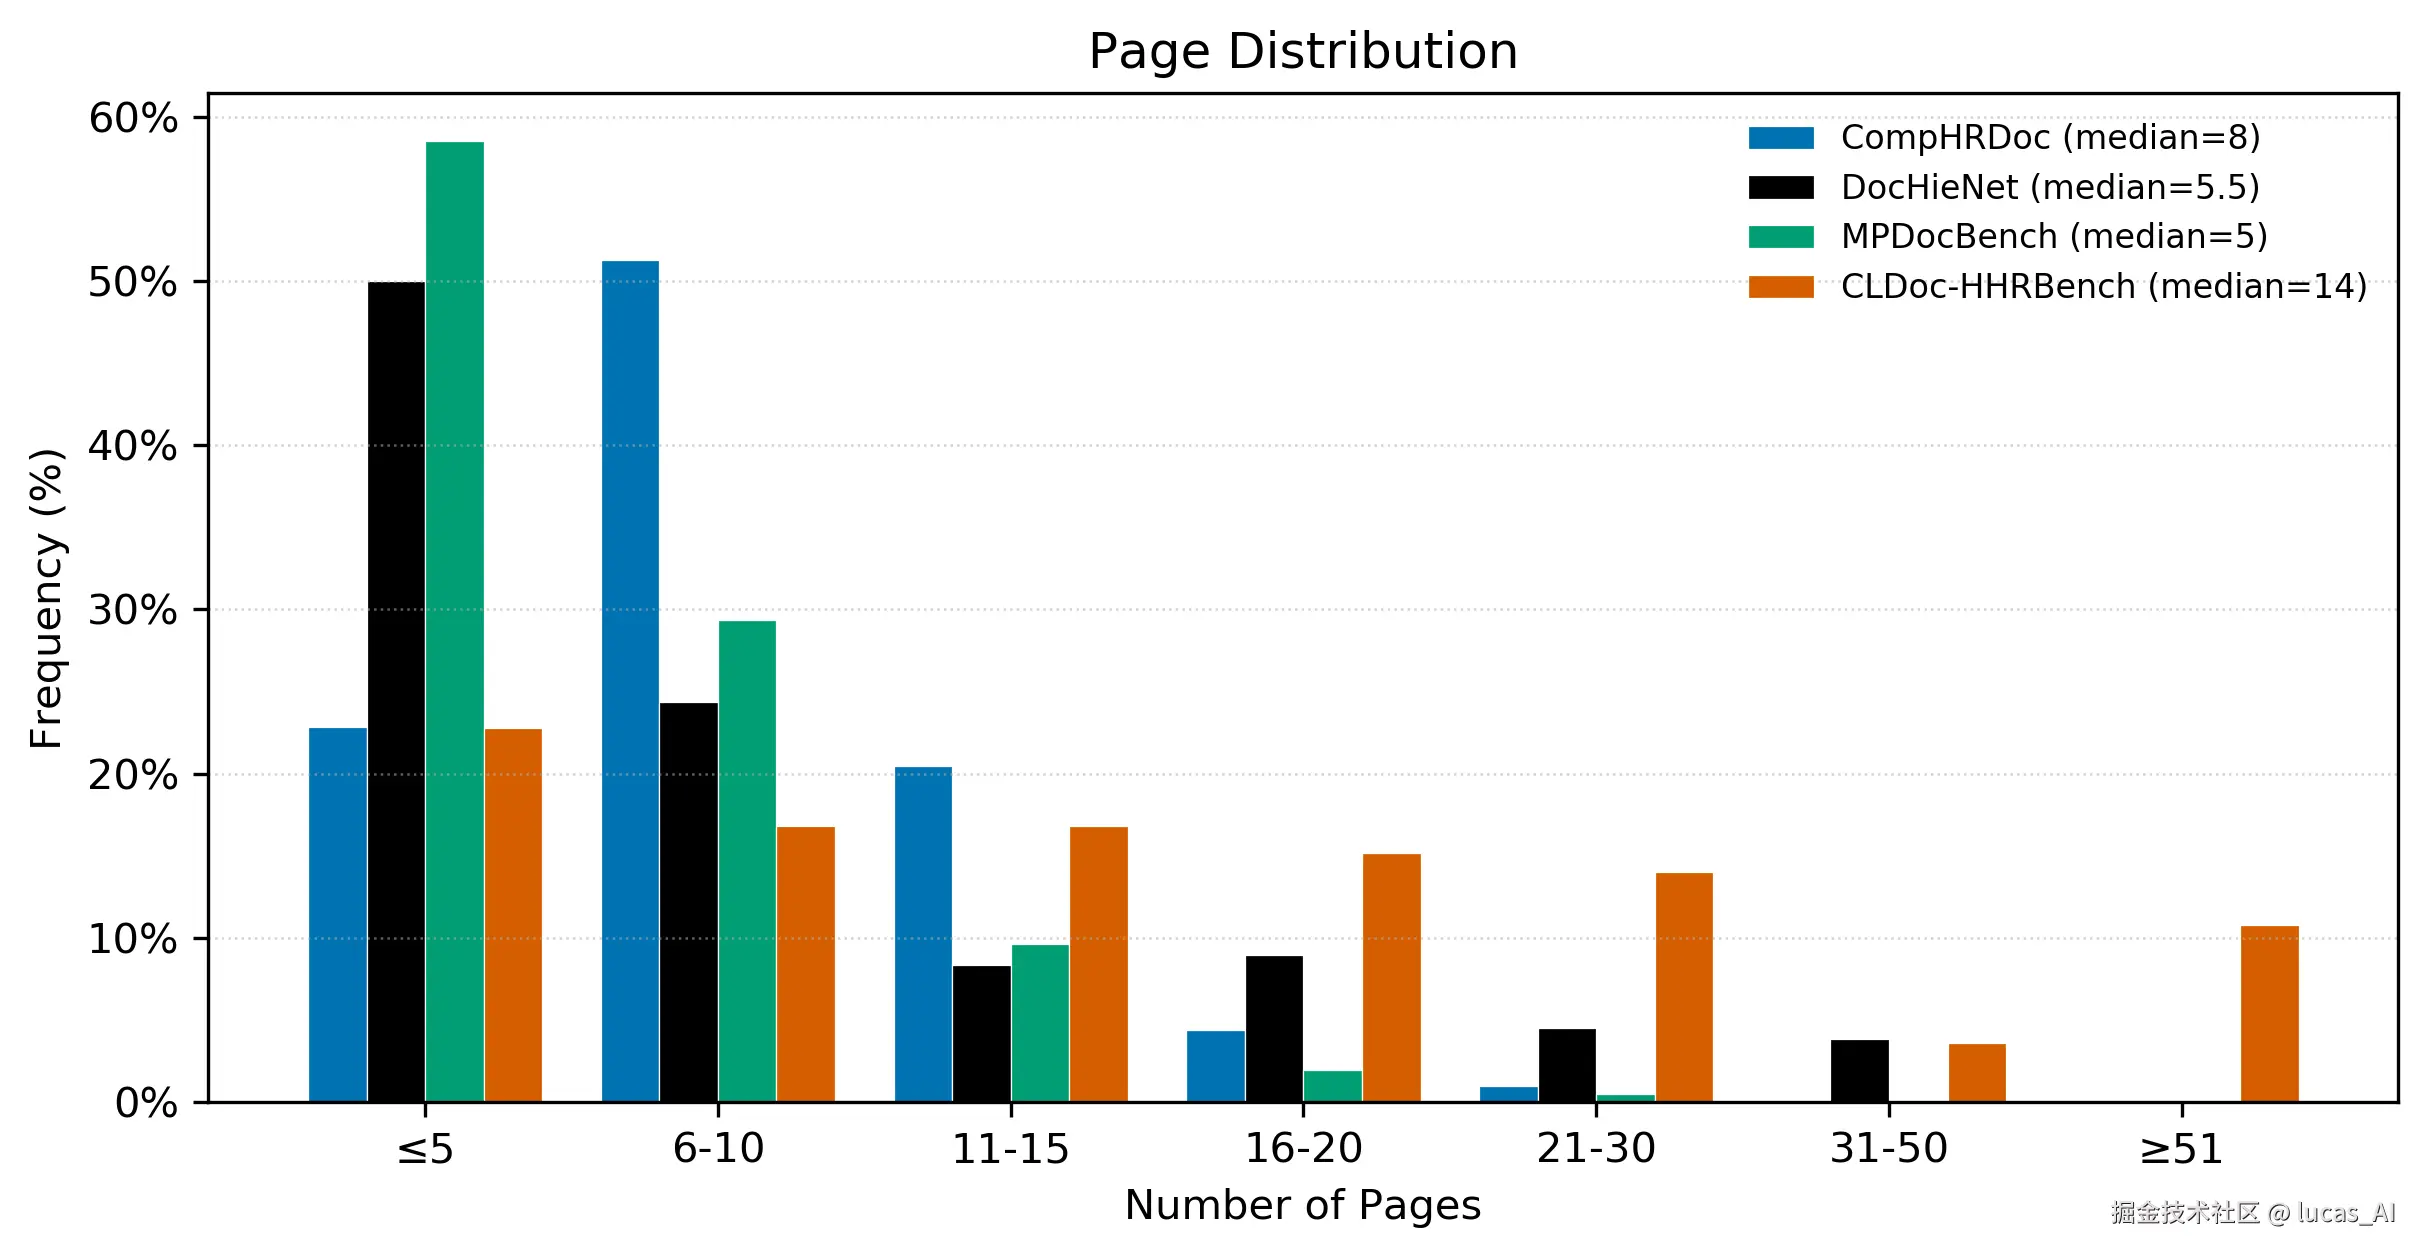
先看考场。现有基准要么全是学术论文(Comp-HRDoc,500 份测试文档平均 14 页、树深最高 3 级),要么覆盖面够广但普遍短浅(DocHieNet 平均 14 页、MPDocBench 平均 7.5 页)。作者新建的 CLDoc-HHRBench 专挑又长又杂的:250 份文档、11,212 页、10 类文档(研报占 43.6%,另有财报、产品手册、保险条款、法规等),平均 44.85 页、最长 387 页,标题最多的一份有 1,772 个,树深最深 10 级。
标注也不是拍脑袋:六个标注员加三位专家,约 800 人时,双人独立盲标再专家逐项裁定,裁定前层级一致性(STEDS,基于树编辑距离的相似度指标,1 为完全一致)就有 0.9673。
主战场成绩:统一用 Qwen3.6-Plus 当骨干、只比策略差异,四个基准合起来看,这套方法 Macro/Micro-STEDS 拿到 84.73/88.68,比最强对手分别高出 1.09 和 5.97 分;而在最长最杂的 CLDoc-HHRBench 上,91.07 对次优 83.61,领先 7.46 分。规则法的 PaddleX 只在学术论文基准上还能打,换到杂牌文档立刻现形;纯靠文本标题序列的 MinerU 整体弱于多模态方案------版式字号这些视觉线索,文本里真没有。
这张优势从哪来的?按文档长度分组看最清楚。
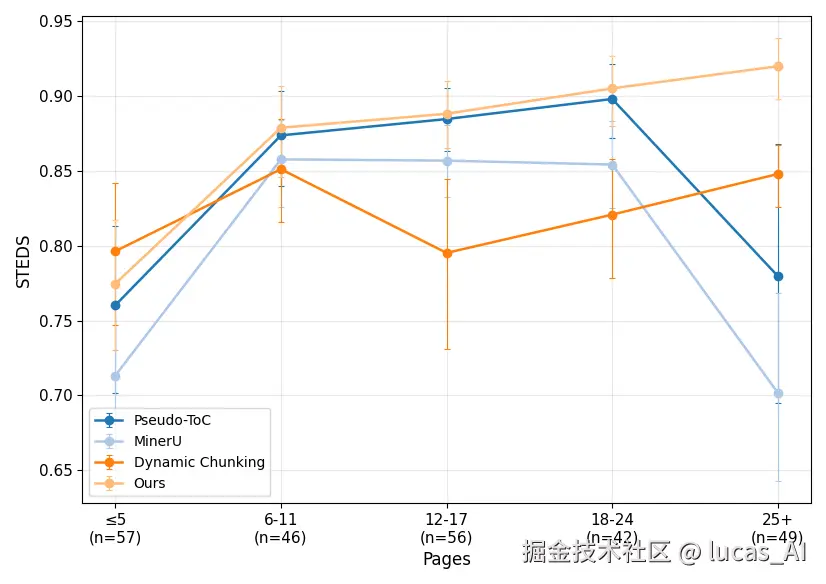
规律很直白:短文档上大家半斤八两,含标题页数一过 25 页,对手集体下滑,这套方法几乎不掉------记忆上下文不随页数膨胀,正是为这种场面设计的。
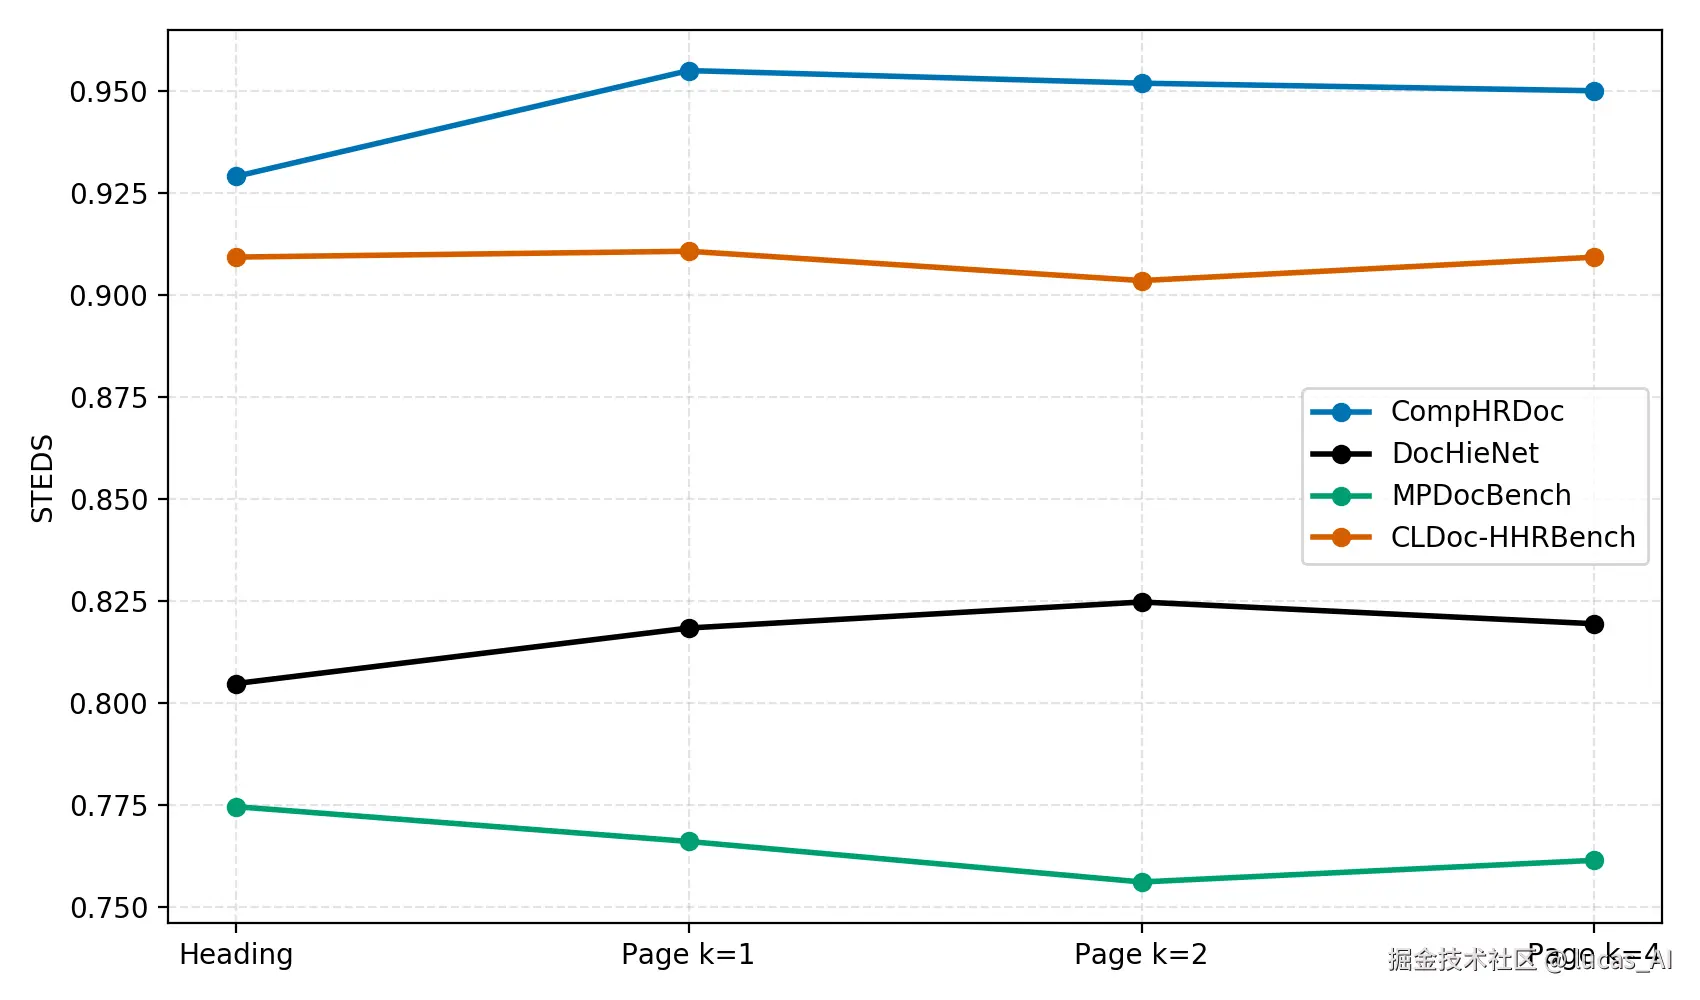
消融实验进一步确认了两个设计选择的必要性。换记忆策略:每层留最近代表(88.68)好于固定带前 3 个标题(87.47),远好于每层随机挑一个(78.22)------历史上下文「选谁」很关键;去掉页图只留文字:整体从 88.68 掉到 83.47,四个基准全线下滑------视觉信息不是装饰,是刚需。预测粒度上,一次一个标题和一次一页、两页、四页成绩基本持平,工程上可以放心用粗粒度省调用。
还有个务实的彩蛋:用 1 万个标注实例微调 Qwen3.5-0.8B 小模型,Overall Micro-STEDS 到 85.32,比单独训练的 4B 参照模型 MinerU-Popo(84.06)还高------框架的收益可以蒸馏进很小的模型(当然论文也老实标注了,后者是外部参照,不是严格受控对比)。
四、怎么用:三件事现在就能做
如果你的场景是「长 PDF 进、结构化 Markdown 出」,这套思路可以这样接。
其一,把它当解析管线的第二级。页级解析照旧交给 MinerU、PaddleOCR-VL 这类工具,把抽出的标题(文本 + 页码 + 框)交给这层增量重排,主流程不用推翻重来。其二,小成本自托管。如果不想为层级重建调用旗舰大模型,0.8B 微调到 85.32 的结果说明:拿几千到一万个自己领域的标注实例,三张 A100 训一轮,小模型就够用。其三,等等开源。论文承诺发布 CLDoc-HHRBench 的标注与来源信息,方法代码暂未见仓库------想在生产里用,近期更现实的路径是按论文 Appendix C 的 prompt 格式自行复刻,机制本身并不复杂。
举个具体算账的例子:一份 387 页的研报,标题树深约 10 级,那么每预测一个标题,上下文就是「至多 10 张锚点历史页 + 当前目标页」。页数翻了三倍,上下文一寸没涨------这就是「上下文随结构复杂度、而非数据量增长」在真金白银地省 token。
五、泼冷水(🧊)
数字好看,但有几处要泼点冷水,免得直接搬进生产踩坑。
最大的隐含假设是禁止跳级:每个标题只能比前一个深一层。方法靠约束解码强制、评测基准也全部满足此假设(标注协议里就禁了跳级)。可现实中的脏文档------尤其是多人拼凑的 PPT 导出稿、扫描旧档------标题跳级并不罕见,方法对这类情况没有任何处理机制,所有性能数字都产生于满足假设的数据上,外推要小心。
其次是误差累积。串行增量预测意味着一步定错层级,后面的约束和记忆都会跟着歪。论文做了个诊断:把历史状态全部换成真值,整体父节点准确率从 83.89% 升到 88.73%------总体无雪崩,但在长文档基准 CLDoc 上这个差距是 84.84% 对 91.59%,接近 7 分,说明长文档里历史误差的影响不可忽视。
再看几处实验设定:43.6% 的研报占比让基准偏向金融文档排版风格;与基线比较的是「同骨干复现的策略」而非各家原始模型,策略差异结论可信,但不能直接换算成「打赢了 MinerU-Popo 原版」;单标题粒度下 387 页文档要调几百次模型,长文档的推理开销得靠多页粒度摊。
六、理性看待(💡)
抛开分数,这篇论文最值得带走的是一个朴素洞察:长文档结构任务所需的历史上下文,量级由结构复杂度决定,而不是数据量决定。几百页的文档,标题树可能只有十层深------把「每个结构状态留一个最新代表」当记忆,上下文就从 O(页数) 压到了 O(深度),这招对大纲生成、对话状态跟踪、日志归并等一切「沿长序列做结构化预测」的任务都值得一试。
至于「纲举目张」这四个字,古人诚不我欺:纲举了,目自然张------前提是你得记得住纲长什么样。VLM 们缺的从来不是眼力,而是这份按层级归档的记性。
💡 本文为个人精读笔记与通俗解读,数字与结论均出自论文原文,图表引自论文 HTML 版;解读性段落为作者推测,欢迎指正。