💡 一句话总结 :AI 阅卷离落地差的那一步,可能不是「认字」而是「认涂改」。一个学生先写了个错误公式、划掉、在旁边重写------人类阅卷老师扫一眼就跳过叉号,而文档解析模型会把划痕里的幽灵字符照单全收,混进解题步骤里。暨南大学团队发布的 HANS 数据集第一次把这个问题系统化:真实考试答题卡、像素级涂改标注、加上一条对阅卷至关重要的约定------被删掉的内容不算答案。
导语:学生答题卡是文档解析的「地狱难度」
看看现有的文档解析榜单都在考什么:OmniDocBench 考印刷版式的论文和教材,CROHME 考孤立的手写公式,IAM 考规整的手写文本行。而真实的初中数学答题卡是这些考验的合体再加一码:
- 公式和文字交错:一行推导里「因为三角形全等」和 ΔABD≌ΔCBD 混排,还有多行推导、方程链、跨行的中间结果;
- 手绘表格:格子里文字公式都有;
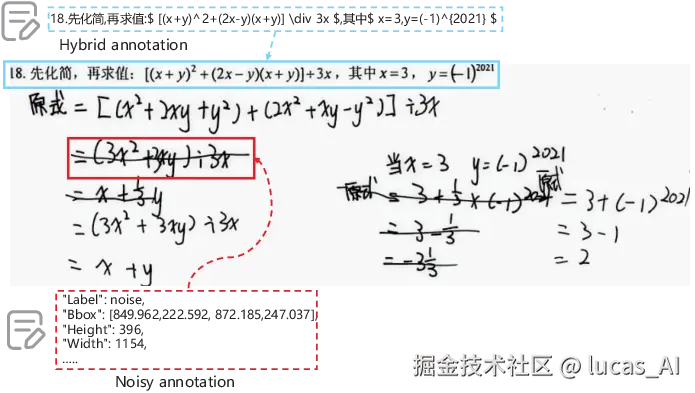
- 最致命的:噪声。学生写错了会划线、会擦、会叠着重写------删除线把有效笔画切成两段,擦除留下幽灵残迹,覆盖重写让两套笔画叠影。人类老师对这些噪声有天然的「注意力过滤器」,模型没有。
现在的解析模型遇到答题卡会怎样?HANS 团队用数据说话:最强的通用 VLM(Qwen3-VL)F1 只有 0.724;专攻文档解析的 DeepSeek-OCR2 在强噪声区域甚至会出现整段重复生成------同一个公式无限循环,整道题的识别直接报废。而文档解析管线工具(MinerU、PP-Structure)更是只有 0.44-0.57。
想自己动手试?
- 📄 论文:arXiv 2610.12363
它的思路是什么?
第一步:把「噪声」变成被标注的对象。 HANS 的数据来自中国某市三个学期初二数学质量检测的真实答题卡扫描件:5,213 张开放式解答题的答题区域图、745 名学生、18 种题型(个人信息已裁剪脱敏)。每张图配两类标注:
- 解答过程完整转写 :按语义行分段、保留学生的原始换行。关键的约定是------被学生删除的内容不进转写。这个细节对下游自动评分是本质性的:评分要的是学生最终认可的推导,不是他走过的弯路。
- 噪声区域像素级标注:块状的划线删除用矩形框、不规则的涂改用多边形勾边;覆盖重写要同时框住废弃内容和叠加笔画但保住最终可读的字;擦除要覆盖残留痕迹和因擦除而不可读的区域。边界处理采用保守拟合,宁少勿错地盖住有效推导。
标注管线很务实:YOLOv8 自动定位涂改区域 + DeepSeek-OCR 预识别内容打底,标注员逐字符修正,领域专家终审。对照现有数据集:HANS 是唯一同时具备「页级 + 手写公式 + 手写文本 + 噪声标注」的------OmniDocBench 只有 116 页手写样本且无噪声标注,CROHME 有 8,836 个公式行但没有文本、没有噪声。
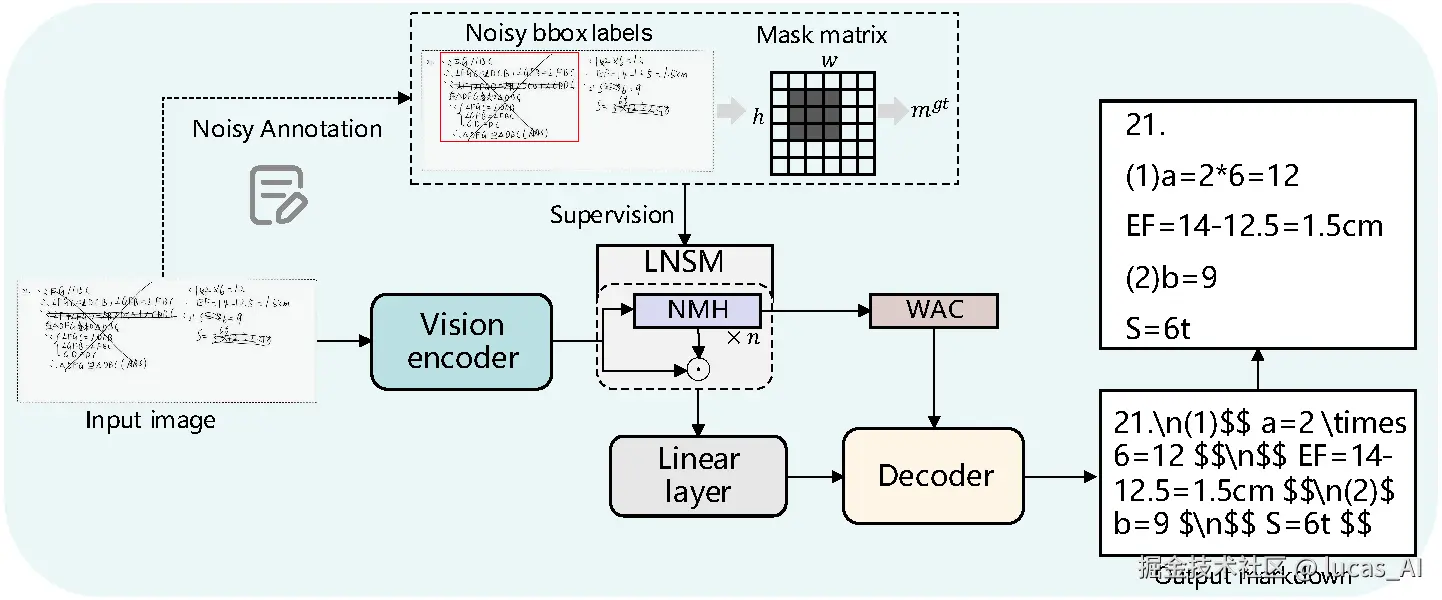
第二步:给模型装上「涂改过滤器」。 配套的 NA-GOT 框架在 GOT 架构上加了两段轻量机制:
- 特征级(LNSM):把噪声标注转成 patch 级噪声占比标签,训练一个只有两层 MLP 的噪声预测头(NMH)估计每个视觉 patch 是噪声的概率,然后按概率做 token 门控------噪声越像,特征幅度压得越狠(α=0.7)。推理时不需要任何人工标注输入。
- 解码级(WAC):在解码器自注意力里给高噪声概率的 patch 加负偏置(b=−β·p,β=2.0),softmax 之后它们天然拿不到注意力。
一个管特征幅度,一个管注意力分配,成本几乎可以忽略------NMH 就是个两层 MLP。
效果到底怎么样?
HANS 测试集上的 F1 格局(这是模型第一次面对这类「混合噪声手写」):
- 管线工具全军覆没:PP-StructureV3 0.566、MinerU-pipeline 0.439------为印刷文档设计的分栏切图逻辑在这种乱糟糟的手写页上寸步难行;
- 通用 VLM 里 Qwen3-VL 一枝独秀(0.724),验证了大模型的通用文档理解力,但可视化分析显示它在噪声边界附近会误读形近变量和数字;
- 专用解析 VLM(Paddle-VL、DeepSeek-OCR2、MinerU-VLM)0.63-0.68,其中 DeepSeek-OCR2 在强噪声下触发重复生成失效;
- 领域微调是分水岭:GOT 直接迁移只有 0.409,在 HANS 上微调后跳到 0.801------光靠标注就能把模型拉上一个台阶;
- NA-GOT 微调后 0.810,BLEU 0.594、编辑距离 0.306,全指标最佳;消融显示特征级门控(去掉它掉到 0.803)比注意力校正(去掉掉到 0.808)贡献略大,两者互补。
泼冷水时间
- 增益很小:NA-GOT 相对微调 GOT 的提升是 0.801→0.810,绝对值只有 0.009------在测试集规模下这个差距的证据强度有限,说服力更多来自可视化案例中重噪子集上的稳定性改善。
- 域窄:一个城市学区、初二数学、18 种题型;「发表后公开」意味着目前无法独立验证。
- 噪声标注自身有模型预标的底子(YOLOv8+DeepSeek-OCR),预标偏差可能传导进「真值」。
- 没有下游闭环:识别指标改善对真实自动评分准确率的影响未测------「读得更准」和「分打得更对」之间还隔着一整个评分模型。
- 「被删内容不进转写」是合理但值得讨论的约定:教育诊断场景里,修正轨迹本身(先错后对)可能正是最有价值的诊断信息。
理性看待
HANS 的价值首先在于「命名了一个问题」:在文档解析的语境里,手写噪声一直存在却从没有被当成一个正式的 benchmark 维度。给它像素级标注、给它「删除内容不进转写」的任务定义、给它一个两段式去噪的基线解法------这三件事让「答题卡解析」从印象派的痛点变成了可以刷的刻度。
方法层面,两层 MLP 的噪声头 + token 门控 + 注意力负偏置这套组合拳便宜到不像话,任何做文档 VLM 的团队都可以低成本抄走。而那个更普适的观察值得每个垂直场景的落地者记住:通用 VLM 0.72、直接迁移 0.41、领域微调 0.81------在偏离互联网图文分布的真实场景里,微调依然是不可替代的那一步。
至于 AI 阅卷这件事本身,HANS 只解决了「读懂」的前半程。后半程------从读懂的步骤里诊断出错误原因、给出个性化反馈------才是这个领域的真正考场。
(数据与结论均来自论文原文,解读部分为作者观点,欢迎交流。)