主线:单机崩溃可恢复 → 数据复制到备库 → GTID 让复制认得清 → 主备安全切换 → Orchestrator 自动容错。 面向 DBA / 后端工程师,偏原理。
引言:为什么要做数据库高可用。
数据库是有状态的服务,它站在应用链路的最末端,却决定了整条链路能不能"落袋为安"。缓存挂了可以回源,网关挂了可以切流量,但数据库挂了------写入丢、读取错、主从乱,这些问题会造成难以挽回的损失。
这些年因为数据库不高可用炸掉的案例,比想象中密集得多:
•GitHub 主库脑裂:网络分区导致主库和备库同时可写,自动切换脚本失效,人工介入花了 24 小时才恢复,全球开发者推送、PR、CI 全部停摆,公开事后报告里承认"我们的 HA 机制在这次故障里没起作用"。
•AWS RDS/Aurora 某可用区故障:依赖单 AZ 部署的 RDS 实例直接不可用,备库在另一个 AZ 但没开自动 failover,业务侧只能干等 AWS 修复,电商客户当天订单丢失、退款工单爆仓。
•阿里云香港 Region 可用区 C --- RDS/PolarDB 不可用(2022-12-18,>15h) :跨 AZ 切换的 RDS 实例因为代理服务部署在同一个可用区 C,代理挂了导致无法通过代理地址访问、切换流程起不来;单 AZ 高可用版实例更是直接卡死。部分客户宕机超 24h,澳门金管局/银河/澳觅等一连串客户中招。阿里云自己承认是"运营十多年来持续时间最长的一次大规模故障"。
全景:一条主线串起五层
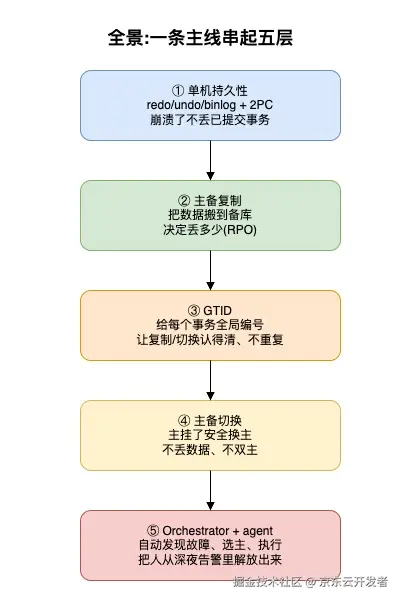
高可用不是单一技术,而是层层叠加的保证。每一层完成一定程度的高可用,全部叠加才是最完整的状态:
| 层 | 回答的问题 | 关键词 |
|---|---|---|
| ① 单机 | 机器断电,已提交的事务还在吗? | WAL、2PC、崩溃恢复 |
| ② 复制 | 主库数据怎么到备库?会丢多少? | 异步 / 半同步、RPO |
| ③ GTID | 切换后备库怎么知道自己缺哪些事务? | 全局事务号、auto-position |
| ④ 切换 | 主挂了怎么换,才能不丢、不脑裂? | 追平、fencing、PRS/ERS |
| ⑤ 自动化 | 谁来发现、谁来决策、谁来执行? | 选主、probe-agent |
第 1 章 单机一致性:一条事务如何"崩溃不丢、可恢复"
高可用的地基是单机持久性:一台 MySQL 断电重启后,已经告诉客户端"提交成功"的事务绝不能丢,没提交的绝不能残留。这靠三种日志 + 两阶段提交实现。
1.1 三种日志的分工
很多人把 redo、undo、binlog 搞混,其实分工清晰:
| 日志 | 所在层 | 类型 | 作用 | 谁写 |
|---|---|---|---|---|
| redo log | InnoDB 引擎层 | 物理日志(某页某偏移改成什么) | 崩溃后前滚已提交事务,实现持久性 | InnoDB |
| undo log | InnoDB 引擎层 | 方向日志(反向操作) | 回滚 未提交事务、支撑 MVCC 快照读 | InnoDB |
| binlog | MySQL Server 层 | 逻辑日志(行/语句变更) | 主从复制 + 时间点恢复(PITR) | Server |
关键区别:redo 是"引擎的内部账本",binlog 是"对外广播的变更流" 。redo 大小固定、循环覆盖;binlog 持续追加、可归档。复制和恢复到某时刻靠 binlog,崩溃恢复靠 redo。
1.2 WAL:先写日志,再刷数据页
InnoDB 遵循 WAL(Write-Ahead Logging,预写日志) :改数据时,不急着把数据页刷回磁盘(随机 IO 慢),而是先把"改了什么"顺序写进 redo log(顺序 IO 快),数据页可以晚点再刷。
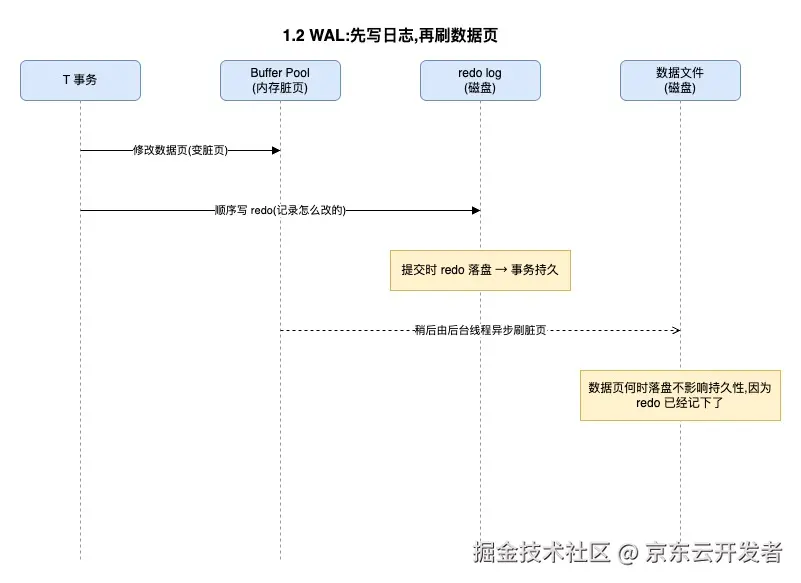
好处:提交只需等 redo 顺序落盘,不必等数据页随机落盘,大幅提速;即使数据页还没刷、机器就崩了,重启时也能用 redo 把它"前滚"回来。
1.3 2pc:redo 与 binlog 的两阶段提交
问题来了:redo(引擎层)和 binlog(Server 层)是两份独立的日志。如果只写了一份就崩溃,主库和备库就会不一致(比如 redo 提交了、binlog 没写,备库就永远缺这条)。
MySQL 用内部两阶段提交保证两份日志"要么都生效、要么都不生效":
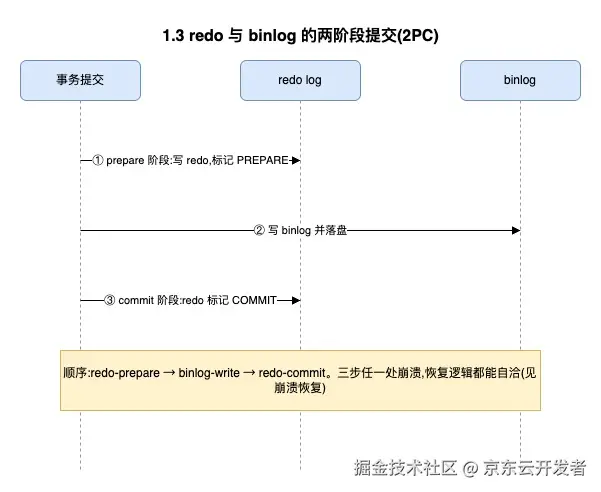
顺序是关键:redo-prepare → binlog-write → redo-commit。binlog 写成功是"提交点"的核心依据。
1.4 崩溃恢复:怎么决定 prepare 事务的命运
重启后,InnoDB 扫描 redo,对处于 PREPARE 状态(有 prepare 但没 commit)的事务这样处理:
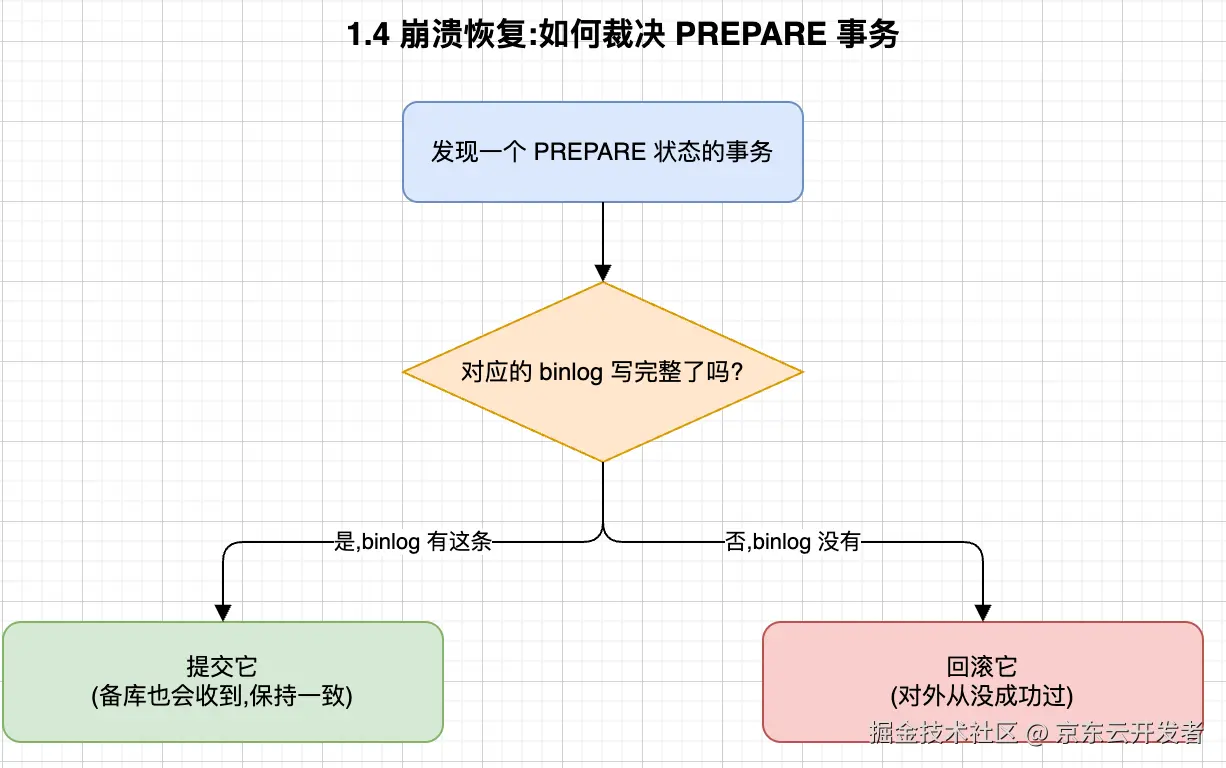
结论:以 binlog 是否完整落盘,作为"这个事务到底算不算提交"的最终裁决。这样主库的恢复结果,和"备库通过 binlog 看到的",永远一致。
1.5 关键参数:什么是"双 1"
大家都经常听到说数据库的双1,那双1指的是什么呢?指的是以下两个参数设置为1:
| 参数 | =1(最安全) | ≠1(更快但可能丢) |
|---|---|---|
innodb_flush_log_at_trx_commit |
每次提交都把 redo 刷盘 | 0/2:攒着刷,崩溃丢最近 1 秒 |
sync_binlog |
每次提交都把 binlog 刷盘 | 0/N:攒着刷,崩溃丢最近若干条 |
"双 1"(都设为 1)= 单机不丢已提交事务的前提。生产核心库必须双 1;代价是每次提交两次 fsync。
小结:单机层用 WAL 提速、用 2PC 保证 redo/binlog 一致、用崩溃恢复裁决半成品事务、用双 1 兜底持久性。这一层保证的是"一台机器自己不丢"------但机器整个挂了怎么办?这就要靠复制。
第 2 章 主备复制:数据如何从主库到备库
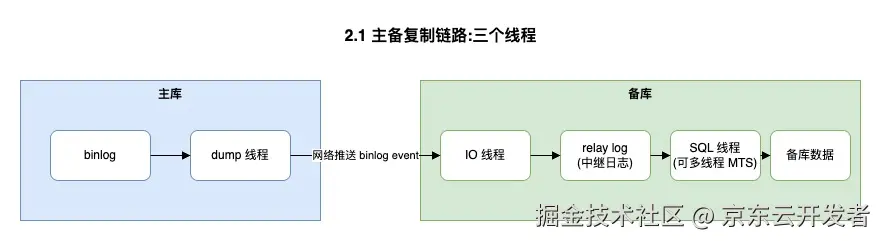
单机再可靠,机器宕了、磁盘坏了,数据就没了。所以要把数据实时复制到备库 。复制的本质:把主库的 binlog 搬到备库重放一遍。
2.1 复制链路:三个线程
2.2 异步复制:默认、最快、可能丢
默认模式:主库提交后立刻返回客户端,不等备库。
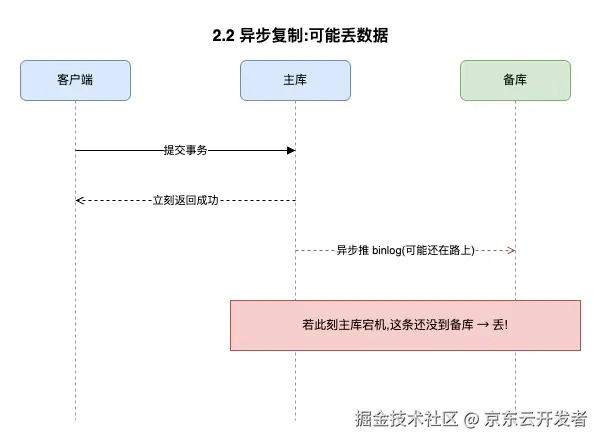
优点:快,主库不受备库拖累。缺点:主库宕机瞬间,已返回成功但没送达备库的事务全丢------丢多少取决于当时的复制延迟。
2.3 半同步复制:至少一个备确认
为压缩丢数据窗口,引入半同步(semi-sync) :主库提交后,要等至少 N 个备库确认收到 binlog,才返回客户端。
两个时机(rpl_semi_sync_master_wait_point):
| 模式 | 等待时机 | 一致性 | 风险 |
|---|---|---|---|
| AFTER_SYNC(5.7+ 默认,推荐) | 主库 binlog 落盘后、引擎提交前就等备库确认 | 强:确认了才对外可见 | 幽灵读更少 |
| AFTER_COMMIT | 主库引擎提交后再等备库确认 | 弱:主库已可见但备库可能还没有 | 主库能读到、备库却没有的"幽灵" |
关键参数:
•rpl_semi_sync_master_wait_for_slave_count:要等几个备确认,现网配置为1。
•rpl_semi_sync_master_timeout:等待超时(毫秒)。超时后退化为异步! ------ 这是半同步"名义强、实则可能悄悄降级"的坑:网络一抖,它就变回异步。现网所有的核心系统都设置成了8640000,也就是可以认为半同步不退化,叠加三机房部署保障了RPO=0。
小结:复制把"单机不丢"扩展成"一台挂了另一台还在"。异步快但丢得多,半同步用一次网络往返换不丢数据。可是------主库真挂了,备库怎么知道自己缺哪些事务、从哪儿接着复制?这就要靠 GTID。
第 3 章 GTID 模式原理:让复制和切换"认得清、不重复"
3.1 传统 binlog 定位的痛点
GTID 之前,备库靠 binlog 文件名 + 位点(position) 记录"复制到哪了",比如 mysql-bin.000123:4567。问题:
•位点是主库本地的,换了新主,同一个事务在新主的 binlog 里位点完全不同。
•切换时,DBA 得人肉找"备库最后那条事务,对应新主 binlog 的哪个位点"------极易错,错了就丢数据或重复执行。
3.2 GTID:给每个事务发一个全局身份证
GTID(Global Transaction ID)= server_uuid:transaction_id,例如 3E11FA47-...:23。
•server_uuid:最初执行这个事务的实例的唯一标识。
•transaction_id:在该实例上的递增序号。
•一个事务的 GTID 全局唯一且终身不变------不管它被复制到哪台机器,身份证号不变。
备库维护一个 GTID 集合,用区间紧凑表示已执行的事务:
ini
gtid_executed = 3E11FA47-...:1-100:102-105
                        (缺了 101 这条)
3.3 auto-position:切换后自动对齐
开启 GTID 后,备库连主库时用 MASTER_AUTO_POSITION=1:
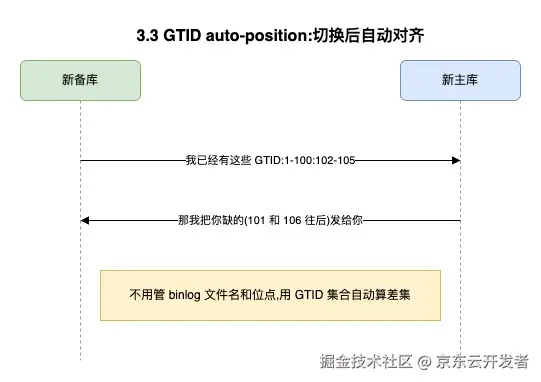
核心价值:切换新主后,各备库不用人肉找位点,报出自己的 GTID 集合,新主自动补差集。 这正是自动化切换(Orchestrator)能安全 repoint 的基础。
3.4 幂等:不重复执行
备库应用一条事务前,先看它的 GTID 是否已在 gtid_executed 里------在就跳过。这保证同一事务不会重放两次(比如切换后拓扑变动导致某条被推送两次)。
小结:GTID 把"复制到哪了"从"主库本地位点"升级为"全局事务身份证集合",让切换后各备库能自动对齐、不重复。有了 GTID,我们终于可以安全地谈"主挂了怎么换主"。
第 4 章 主备切换一致性:不丢数据、不双主
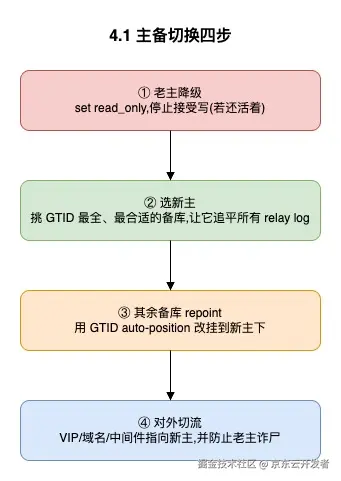
主库挂了(或计划内维护要换主),要把某个备库提升为新主,并让其余备库改挂到新主下。这个过程最怕两件事:丢数据 和双主(脑裂) 。
4.1 切换三步
4.3 fencing:防止老主"诈尸"
最危险的场景:老主并没真死(只是网络分区/假死),切换后它又活过来继续接受写 ------此时新主也在写,就是双主,两边数据分叉,极难修复。
fencing(隔离/围栏)= 确保老主再也写不进去,手段:
•老主一侧 set read_only / 杀连接 / 注销元数据;
4.4 计划内(PRS)vs 紧急(ERS)
Vitess/orchestrator 体系里两种 reparent:
| PRS(Planned Reparent) | ERS(Emergency Reparent) | |
|---|---|---|
| 触发 | 计划内(维护、升级) | 主库已挂 |
| 老主 | 还活着,能配合降级 | 可能已失联 |
| RTO | 可做到接近0( 先追平再切) | 尽量小(选延迟最小者) |
| 关键 | 有序、无损 | 快、防脑裂优先 |
小结:切换的一致性 = fencing(不双主)。GTID 让 repoint 变简单,fencing 让老主不能写入。但------谁来判断"主真的挂了"?谁来决定选哪个备?谁来执行这三步?人肉半夜爬起来太慢也易错。这就是 Orchestrator 要解决的。
第 5 章 Orchestrator 如何选主,以及 probe-agent 的作用
前四章讲清了"怎么才能安全切换"。但真到凌晨主库宕机,靠人来"发现→判断→选主→执行"太慢也太容易错。Orchestrator(orc)就是把这套动作自动化的大脑 ;而 probe-agent 是它派驻在每台 DB 主机上的"眼睛和手" 。
5.1 拓扑发现:先画出复制关系图
orc 不需要你手工登记主从关系。给它任意一个实例,它就顺着 SHOW SLAVE HOSTS / SHOW SLAVE STATUS主动爬取,把整个复制拓扑(谁是主、谁挂在谁下面)发现出来并持续刷新。这是后面一切判断的基础。
5.2 故障检测的精髓:反证法(orc 最值得学的一点)
最容易踩的坑:orc 自己连不上 master,就判定 master 死了 → 误切。 网络抖动、orc 到 master 的单条链路故障,都会造成误判,而误切的代价极高(可能引发不必要的切换甚至双主)。
orc 的解法是反证法(holistic / cross-check) :判断 master 是否真死,不只看 orc 自己能不能连,更看"master 的那些 replica 还连得上它吗" 。
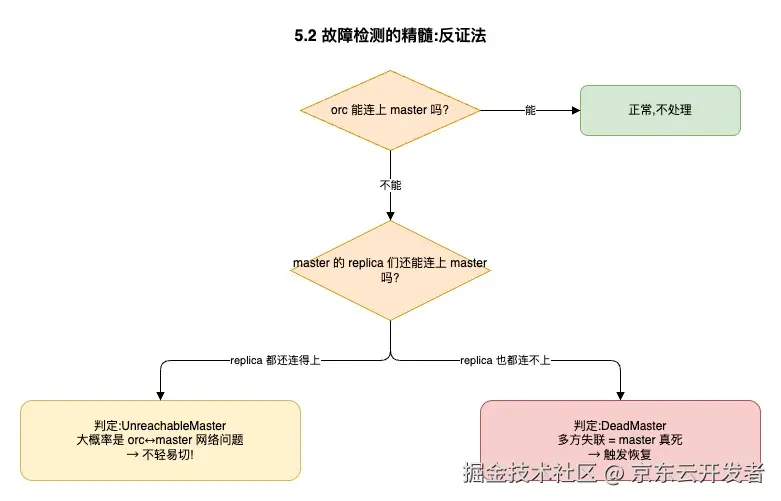
| AnalysisCode | 含义 | 是否触发切换 |
|---|---|---|
DeadMaster |
master 连不上,且 replica 也连不上 | 是(真死) |
DeadMasterAndSomeReplicas |
master 死,部分 replica 也失联 | 是 |
DeadMasterAndReplicas |
master 死,replica 全失联 | 是 |
DeadMasterWithoutReplicas |
master 死且没有 replica | 视配置 |
UnreachableMaster |
orc 连不上,但 replica 还连得上 | 否(疑似网络问题) |
UnreachableMasterWithLaggingReplicas |
连不上 + replica 延迟增大 | 观察 |
LockedSemiSyncMaster |
半同步锁死(等不到备确认,写被卡) | 是(专门处理) |
MasterNotWriteAble |
master 活着但不可写(如误设 read_only) | 视情况 |
5.3 候选选择:选谁当新主
判定要切之后,orc 从存活 replica 里挑新主,综合考虑:
•数据最全:优先选 GTID 集合最完整、复制位点最靠前的(丢得最少)。
•promotion rule :管理员给实例打的提升优先级------must / prefer / neutral / prefer_not / must_not。比如把某台标 must_not(如跨机房只读备)就永不选它。
•candidate 标记 :candidate_database_instance里登记的优选候选。
•同机房/同 cell、版本兼容:尽量同 region 提升(减少跨机房延迟),且新主版本不能低于其 replica(否则复制不兼容)。
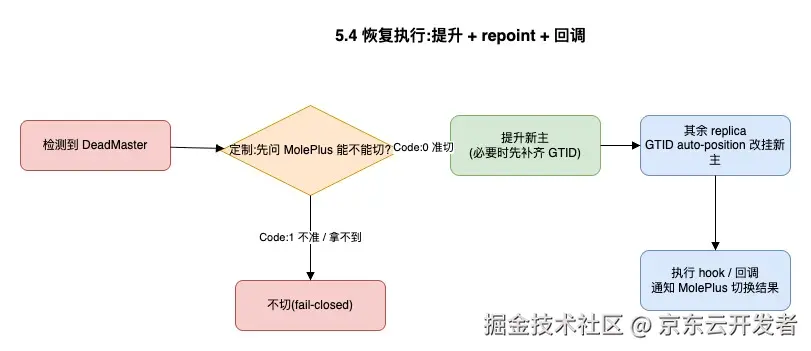
5.4 切换执行:提升 + repoint + 回调
5.5 probe-agent(orc-agent)的作用:补上"内部视角 + 执行手"
orc 是"外部观察者",从远端探测有两个天生短板,probe-agent正是来补的:
短板 1:外部探测看不到主机内部真相。 orc 从外面连不上,分不清是"DB 真挂了"还是"网络断了""DB 太忙没响应"。probe-agent 跑在 DB 主机本地,能看到内部:
| probe-agent 文件 | 职责 | 为什么 orc 从外部做不到 |
|---|---|---|
heartbeat.go |
定时上报心跳(hostname -I 取本机 IP + 时间戳)给 orc |
主机侧"我还活着"的主动证明,区分"DB 死"与"网络断" |
load_checker.go |
检查本机负载(连接数、线程等)NewConfigurableLoadChecker |
外部看不到实时主机真实负载 |
big_transaction.go |
用主备 GTID 差 判断是否有大事务在跑(GtidComparisonChecker),并记录失败时刻主/备 GTID 快照 |
切换前必须知道:有大事务时切换会拖很久、风险高 |
disk_check.go |
磁盘探测(磁盘故障是京东数据库最多的宿主机故障) | 写本地磁盘 |
probe_agent.go |
总装:写探测(enableWriteDetect)、连续失败计数(consecutiveFailures) |
本地"能不能真的写"比外部 ping 可信得多 |
短板 2:orc 决策了,需要有"手"在主机侧执行/兜底。
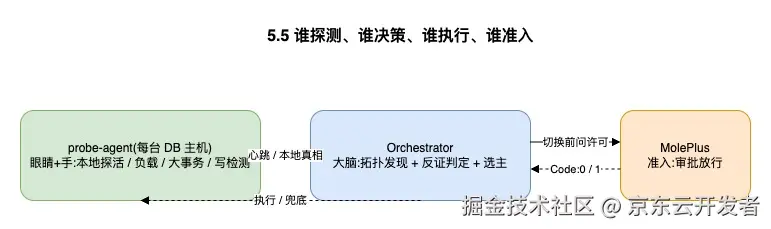
总结分工:
结语:分层的高可用
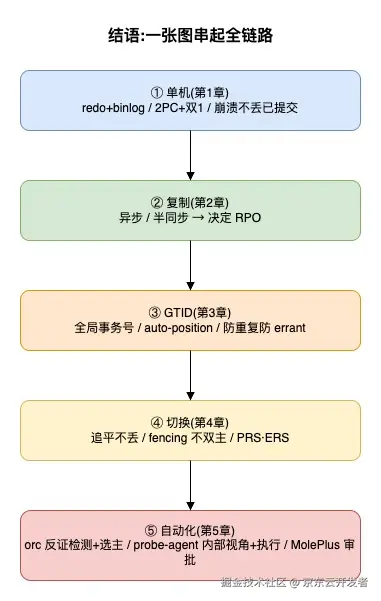
我们通过分层的设计,每一层都做到极致,尽可能的提升高可用能力。现网通过将数据库设置成半同步不退化,保障了RPO为0;未来通过三机房的建设,提供机房级容灾的能力。但是,就到此为止了吗?
数据库高可用不只是数据库的事,应用也要参与
既然数据库总有"短暂不可写"的窗口,如果应用把每一次写都设计成"必须同步写库成功、否则就报错给用户",那数据库抖一下,应用就跟着抖。 真正健壮的系统,是应用和数据库一起做高可用------在 DB 不可用的那几十秒里,应用能不能优雅降级,而不是直接雪崩?
几种常见的应用侧兜底思路:
| 手段 | 思路 | 适用场景 |
|---|---|---|
| 异步化 + MQ 削峰 | 写请求先进消息队列,应用快速返回"已受理";后台消费者慢慢落库,DB 抖动时消息积压而非丢失 | 可接受"稍后落库"的写(下单后处理、日志、通知) |
| 最终一致性 | 不强求"写完立刻全局可见",允许各方在一段时间后收敛一致 | 计数、状态同步、跨系统数据分发 |
| 读降级 | 主库不可用时,读请求走备库/缓存,返回稍旧但可用的数据 | 读多写少、能容忍短暂 stale 的展示类场景 |
| 写降级 / 兜底存储 | DB 写不进时,先落本地/缓存/兜底表,恢复后补偿回放 | 不能丢、但能容忍延迟的关键写 |
| 快速失败 + 熔断 | DB 探测到不可用就立即失败并熔断,避免连接池被慢查询占满拖垮整个应用 | 所有场景的基本自我保护 |
最后一句
数据库这一侧,把高可用一层层做到极致,是为了把"不可用窗口"压到最小;应用那一侧,建立"数据库随时可能短暂不可用"的意识、准备好降级预案,是为了在那个窗口里不被拖垮。 两个系统双向奔赴,系统才真正称得上高可用------这也是把数据库高可用当作"数据头等大事"的完整含义。