国产模型 Flash 盛行,DeepSeek,智谱GLM,阿里Qwen,小米Mimo 到底选哪个好?
哪个模型擅长哪种场景?哪个模型性价比最高? 哪个模型又快又好?
我也很想知道,所以我专门做了一个 Flash 系列测试!
具体的测试方法和演示,在上一篇中已经介绍过了!
今天来完整地展示一下第一个测试例子。测试结果让我很意外,中间遇到的问题也很关键。
能力、费用、时间,几乎都和想的不一样!
为了让结果更接近真实情况,我花两天时间跑了 5 轮!
下面先让"美豆哥"Gemini4 给大家打个样:
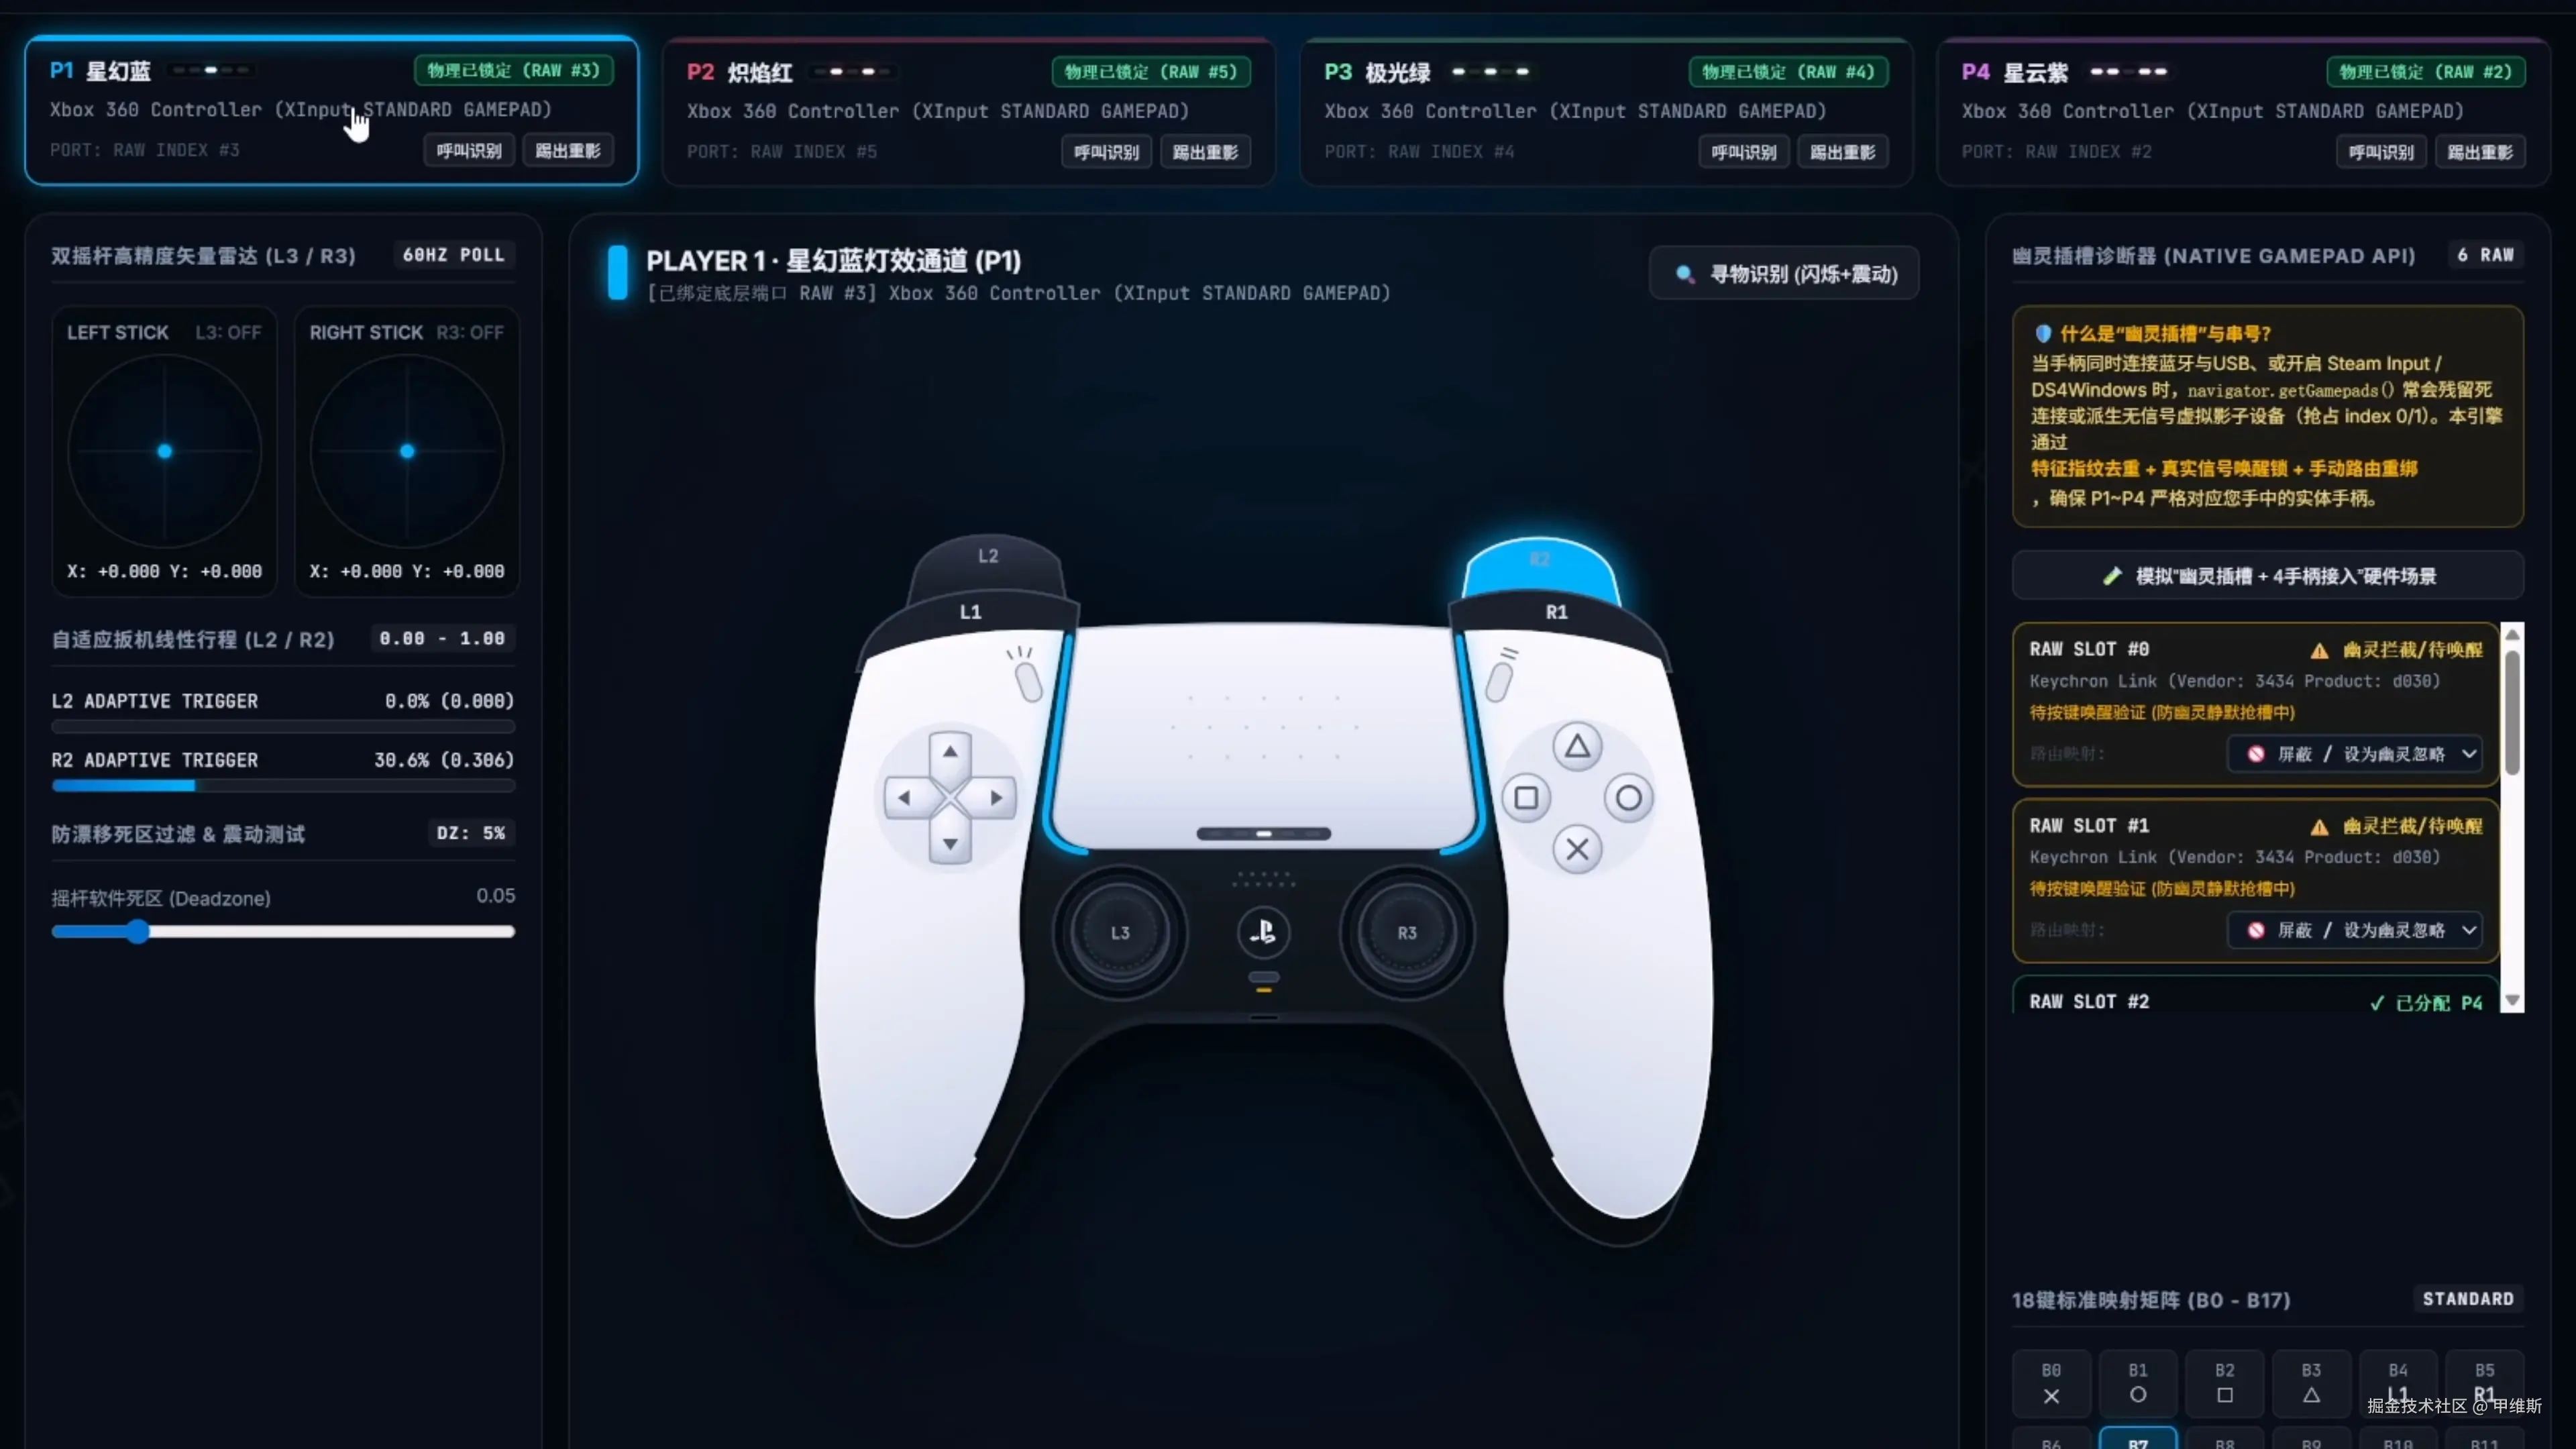
G4 无论是 SVG 手柄,还是接入手柄控制功能都做得非常不错!
代码健壮性比 Sonnet5.5 弱一些!
我们这个系列的主要的测试对象是:
DeepSeek V4.1 Flash
MiniMax M3.1 Flash
GLM 5.3 Flash
Qwen3.8 Flash
MiMo V2.6 Flash
另外我也会拉一些人来陪练:
K3、GLM5.3、Luna、Haiku!
下面进入正题!
1、测试题目
开始之前,先把题目说清楚。
这次的测试题目是这样的:
帮我在网页上画PS手柄,然后支持真实的手柄接入,按相应的按钮,会做出对应的反应。

要考虑到多手柄接入,我最多会接入四个手柄。

核心要求:

1、网页制作漂亮,匹配主题,有设计感

2、手柄轮廓和样式要高度还原

3、要考虑幽灵插槽的问题,能分清楚不同的手柄。核心考点:网页设计好不好? 手柄画得好不好?4 手柄接入控制逻辑好不好?
第一点还算简单,第二点目前还有点难度,第三点有很多坑特别吃"经验"。
我的环境是:Windows+Chrome+4 个 USB 接入的游戏手柄。
测试智能体统一采用 OpenCode,模型全部来自它的 Go 套餐!
别问为啥不用官方智能体和官方 API,问就是......要单独安装参差不齐的 Agent,要单独去充钱获取 API,这事情搞起来工作量太大了,我其实也没那么闲哈 。
用 Go 套餐是因为里面这几个模型都有,而且几乎免费,而且都配置好了,用 Claude 直接串行或者并行调用 OpenCode 很方便。
这么一来,我只要设计一套测试系统,就可以无限测,你们想测什么就测什么。
2、汇总报告
为了可视化这个报告,我也是烧了好多脑细胞和 tokens!
细节还是挺多,过程非常枯燥。我就直接上结果吧,然后再慢慢分解!
我先给大家在文章里展示一下核心数据,另外我已经把所有细节上传到网站上了!
目前做了三项测试:
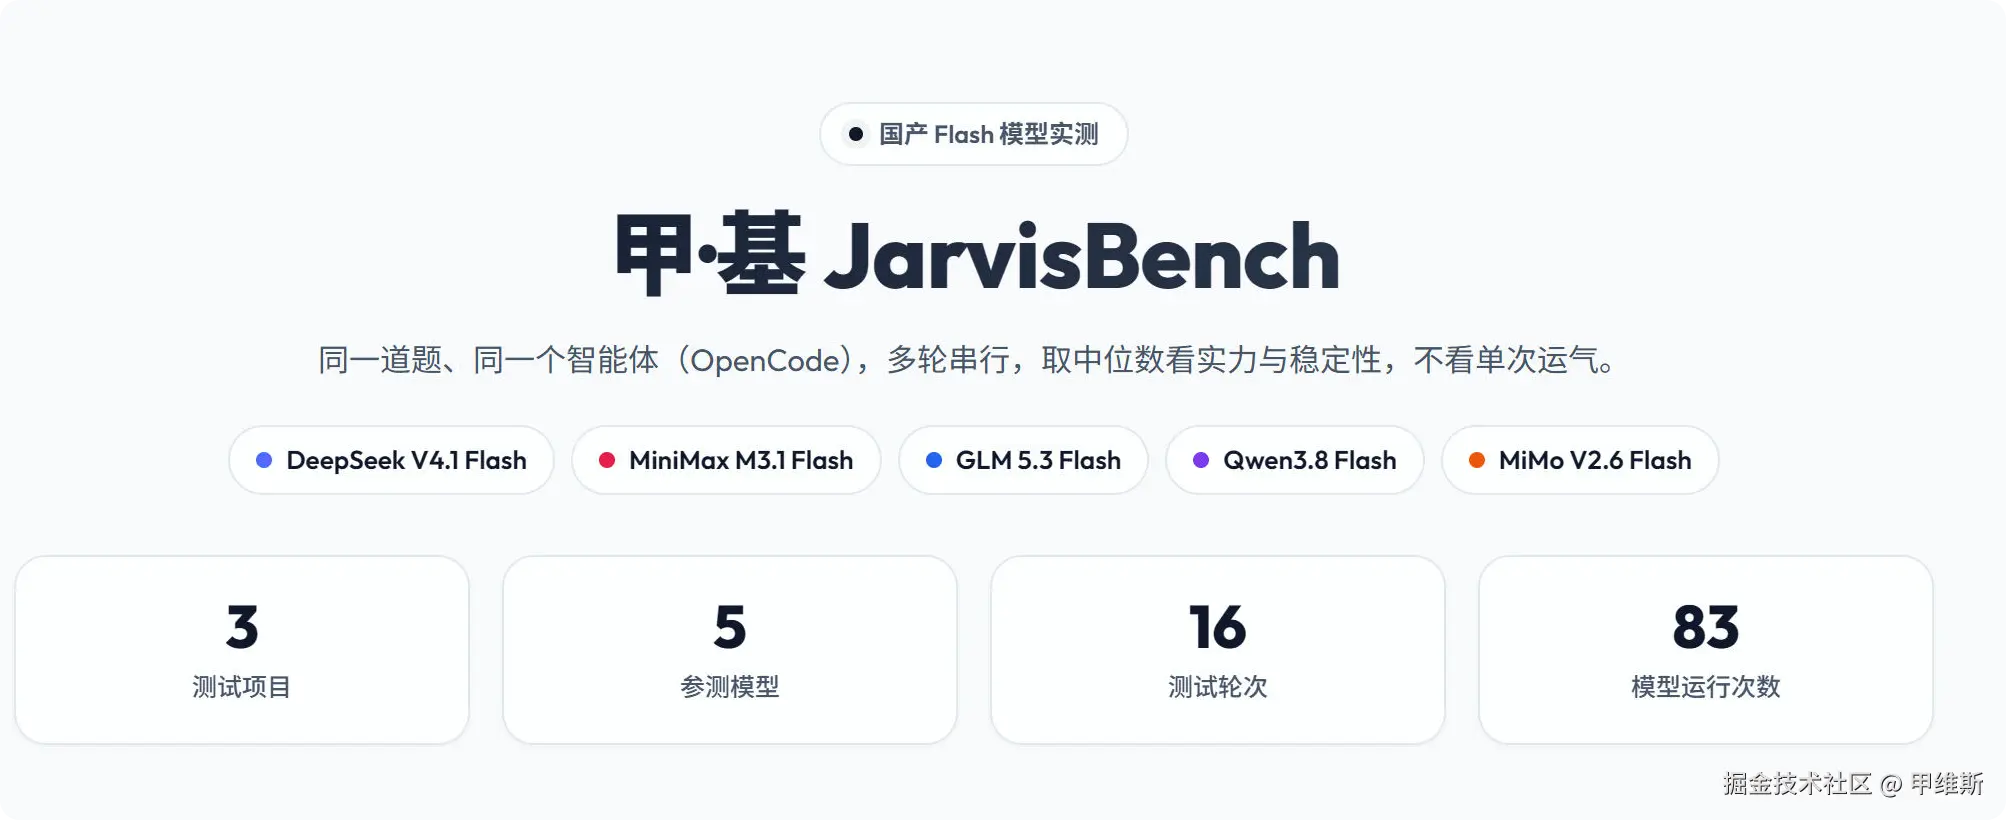
我把这些测试都做了汇总!
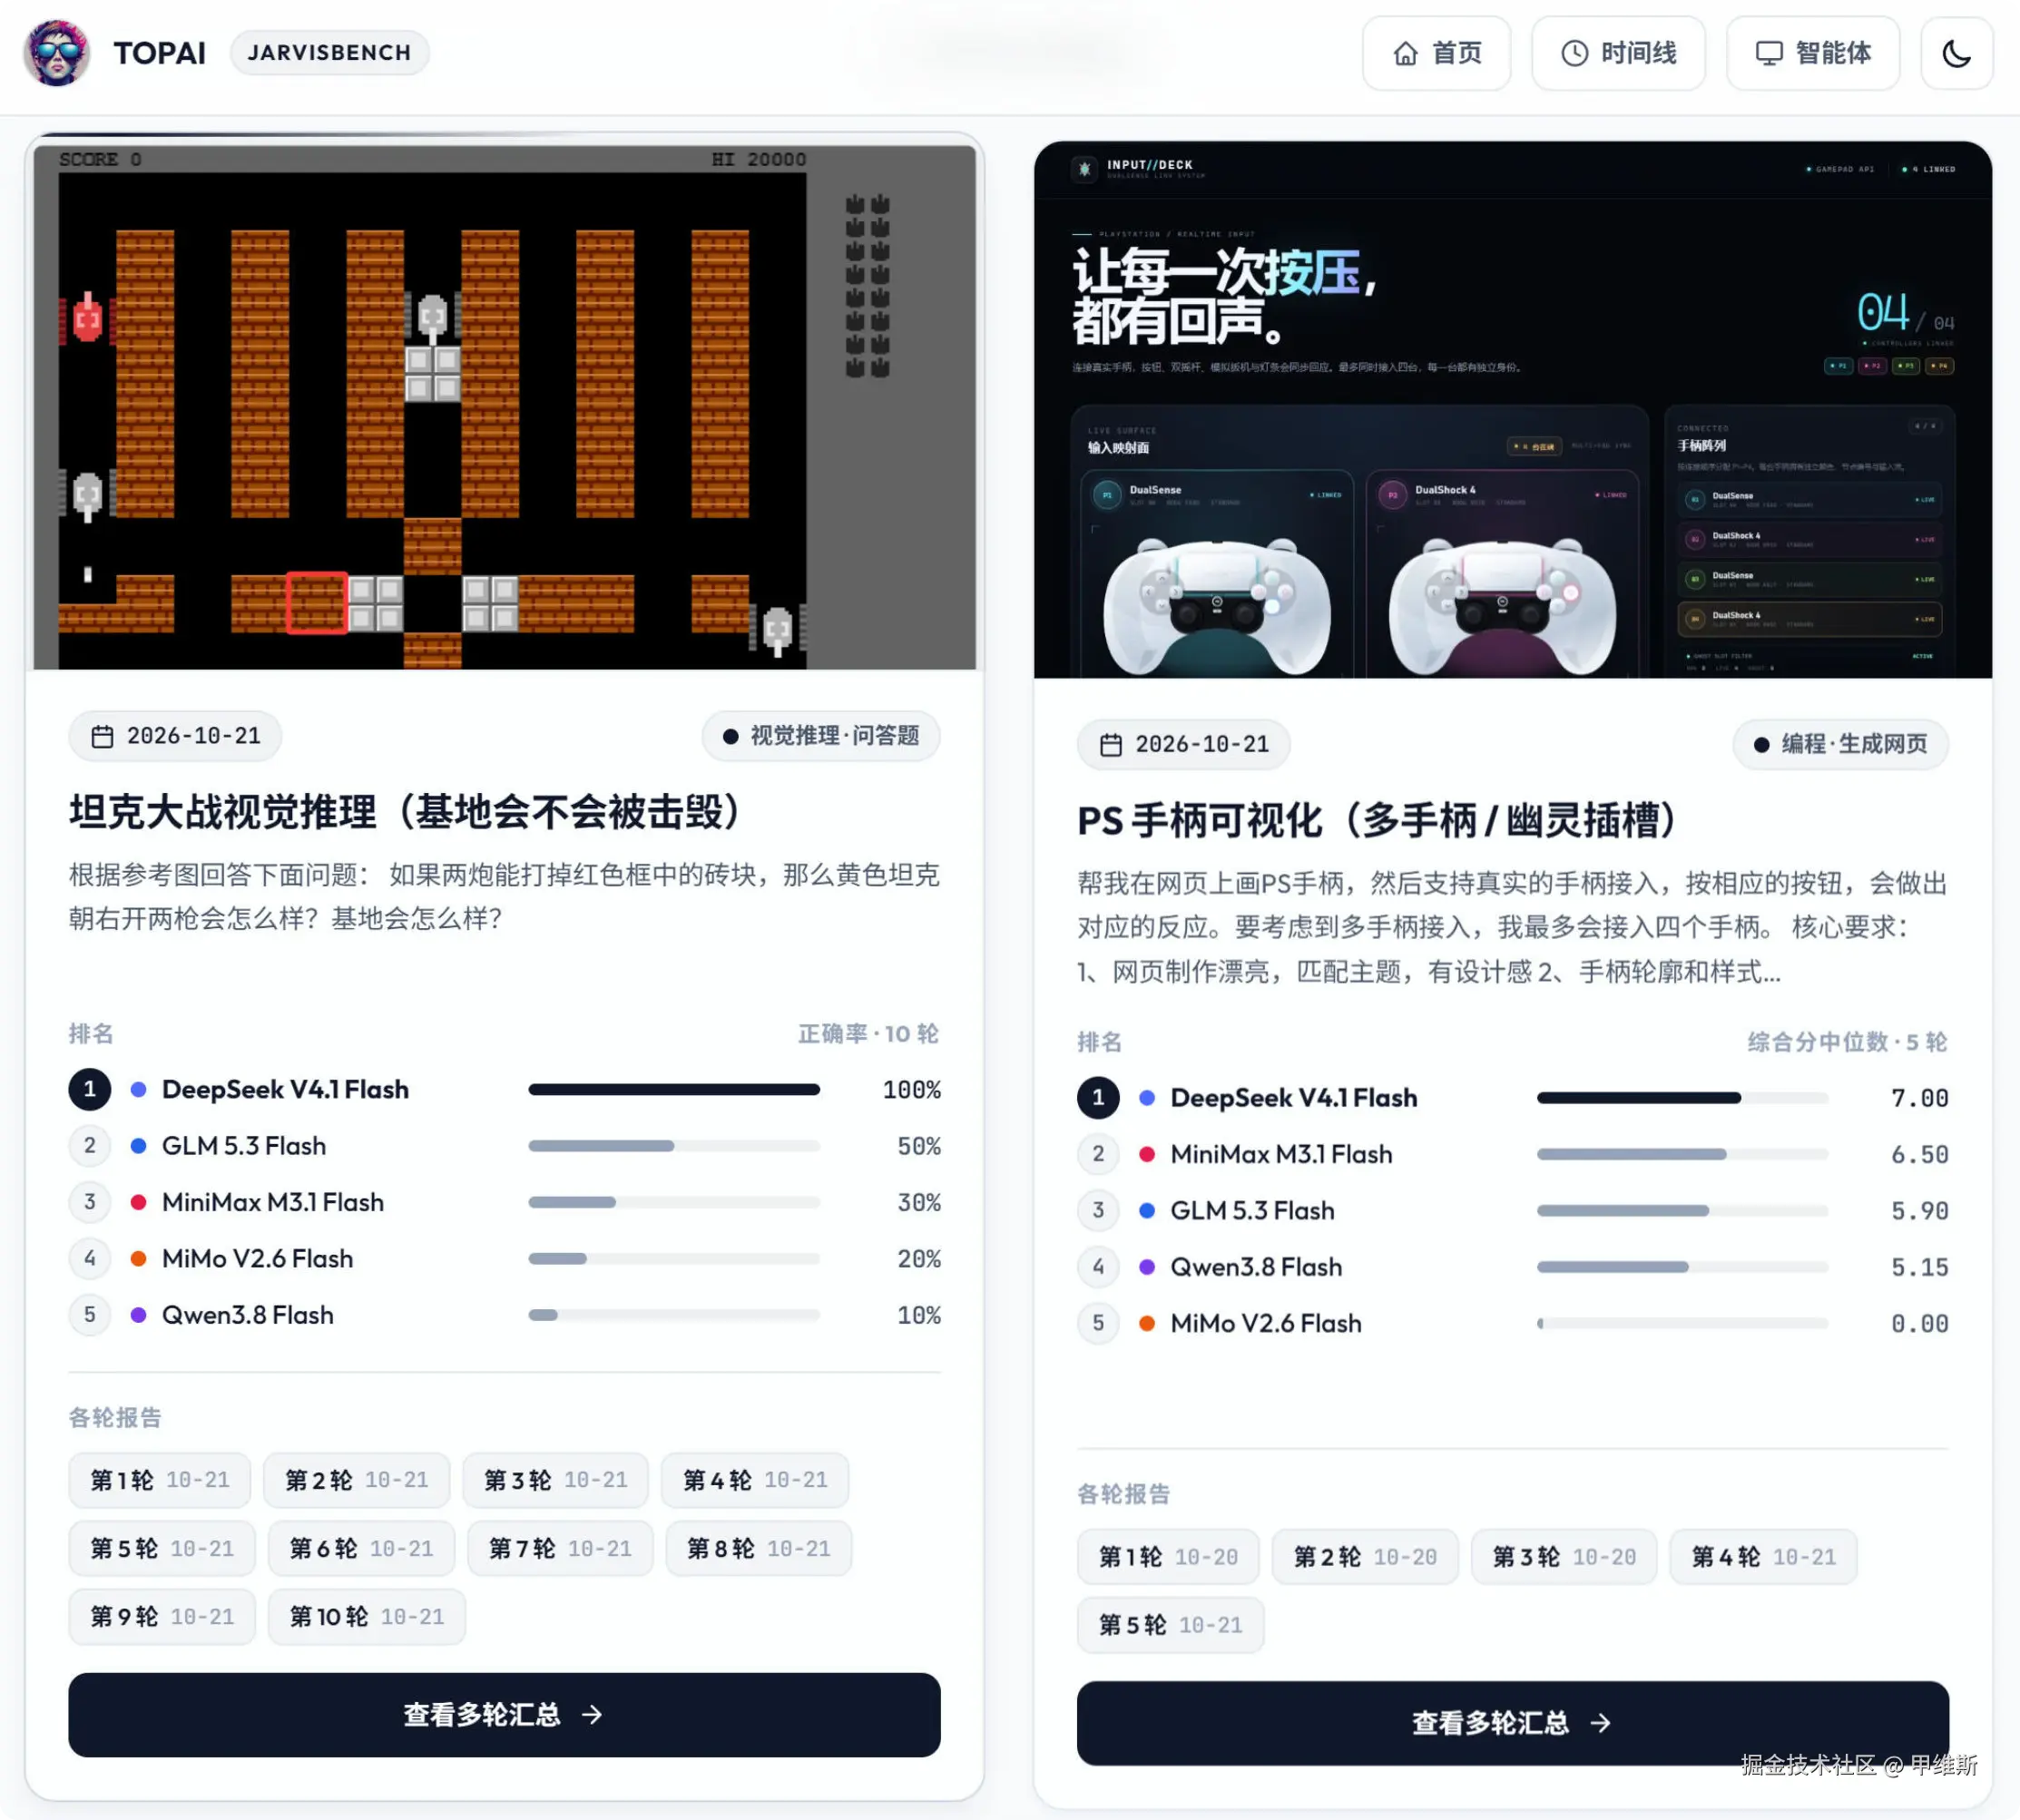
打开之后立马可以看到关键信息了,比如说这个题目是什么?考察内容是什么?排名是什么?总共测了多少轮?
然后,点击查看多轮汇总,可以查看某项测试的汇总页!
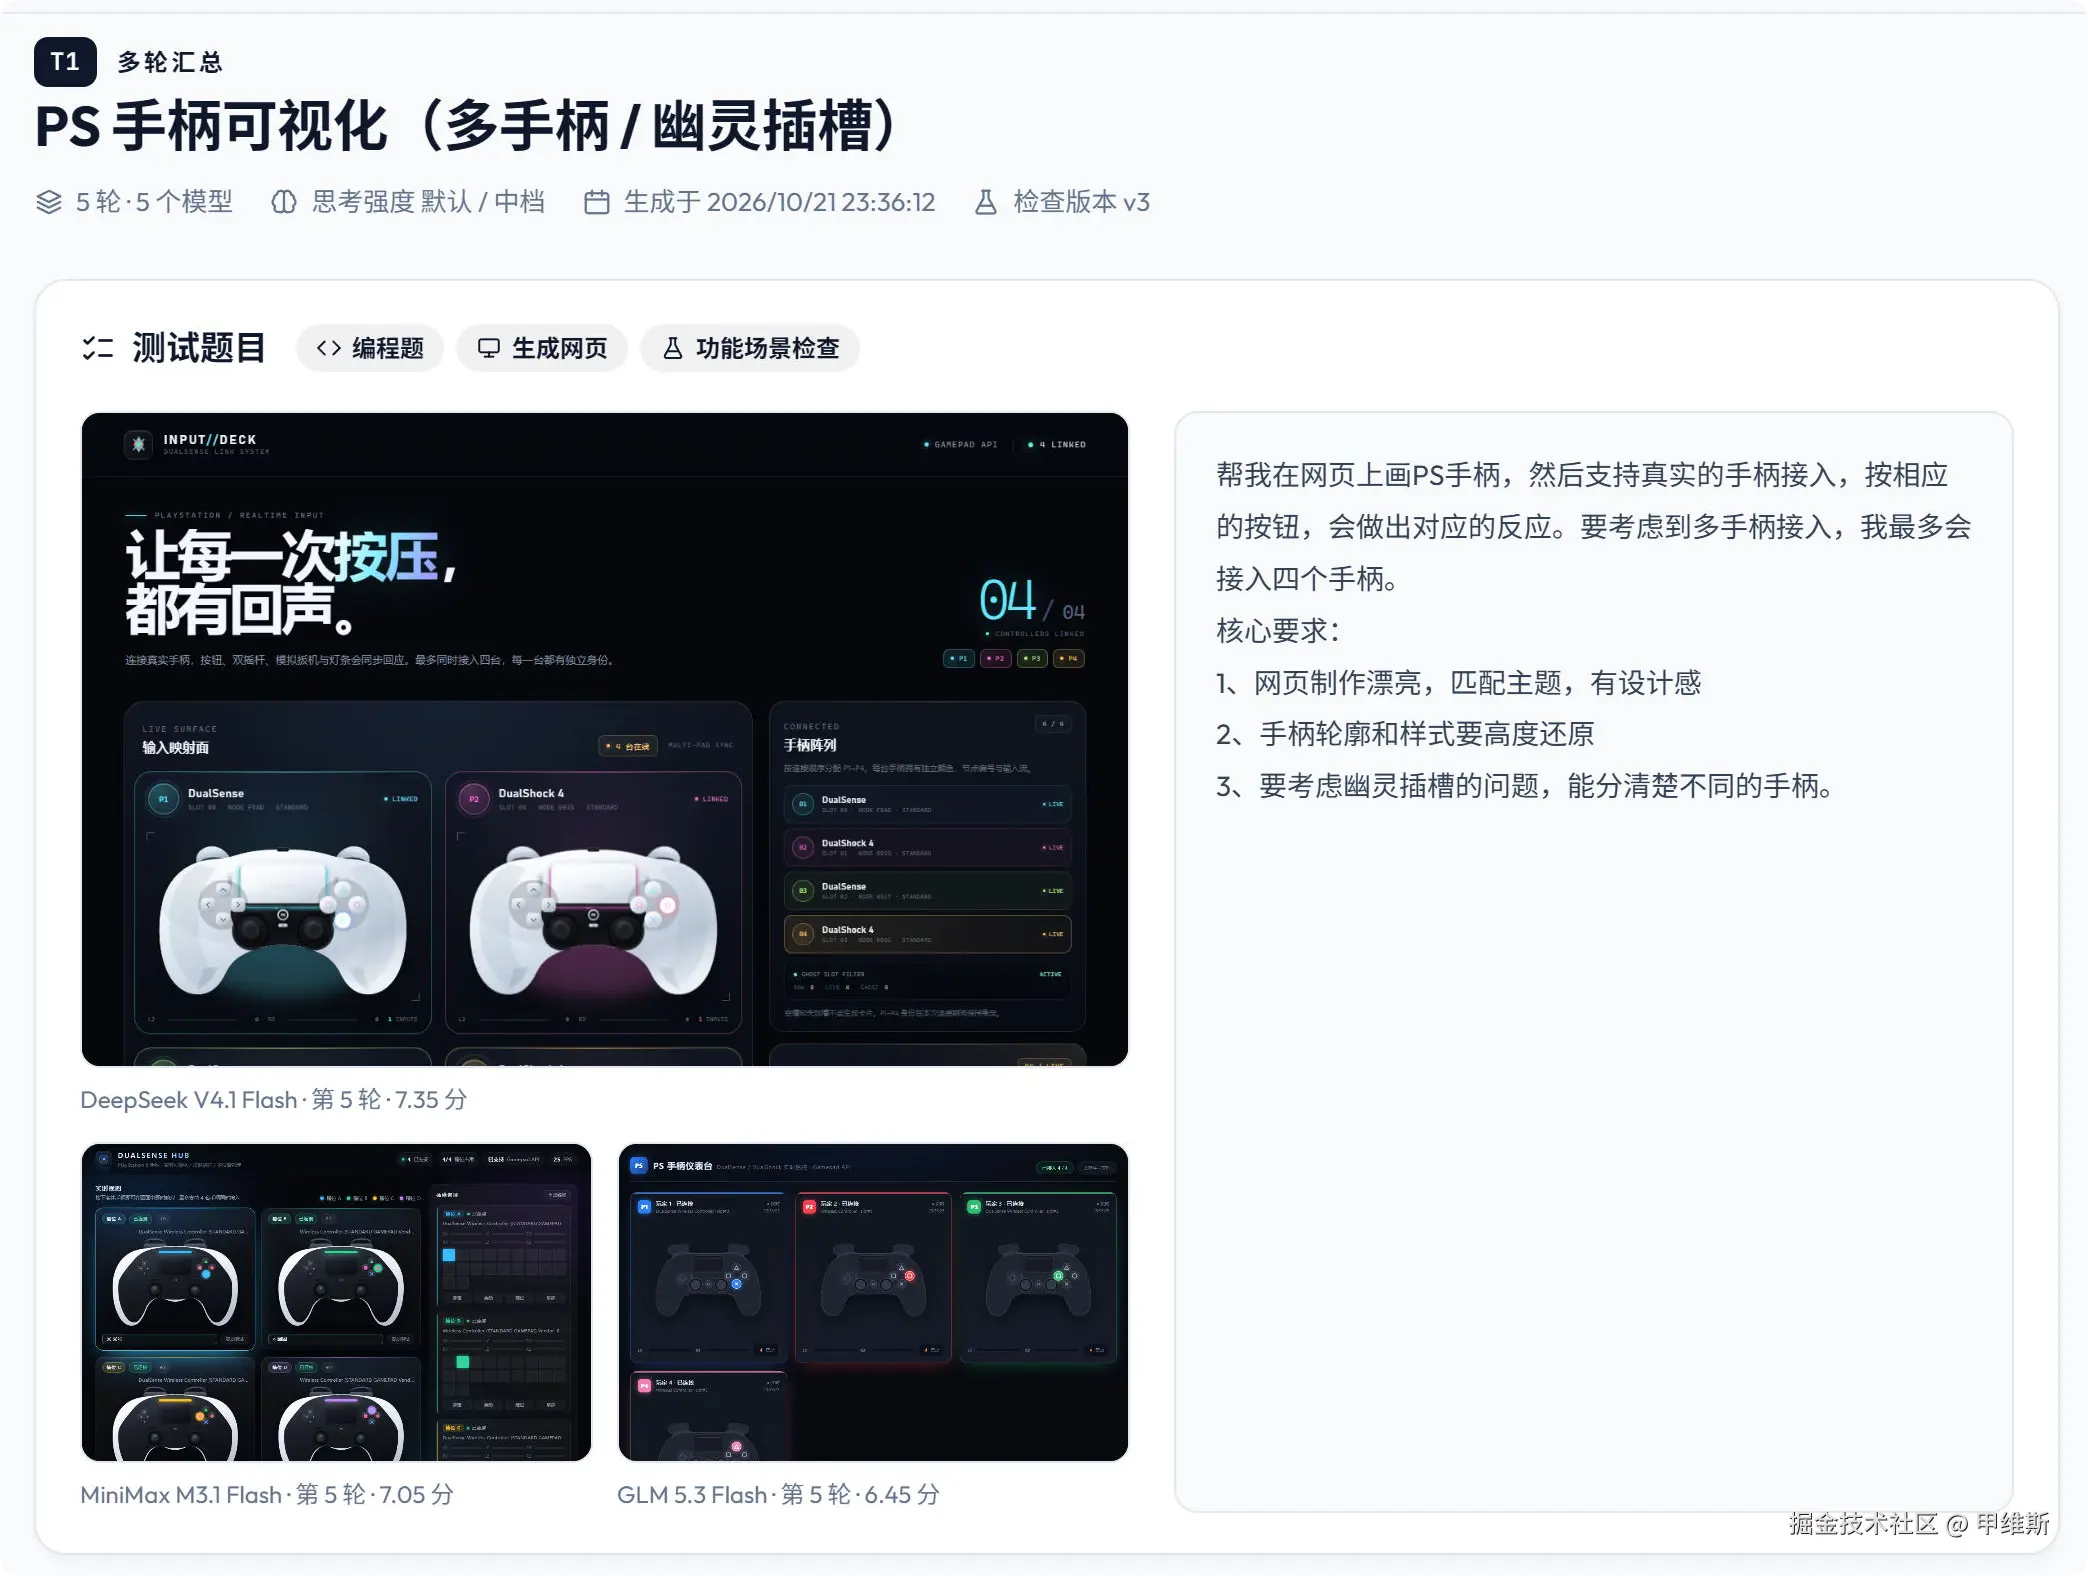
这里面包含了测试题目以及测试截图!
然后下面是具体的测试结果,我们可以正式进入看数据环节。
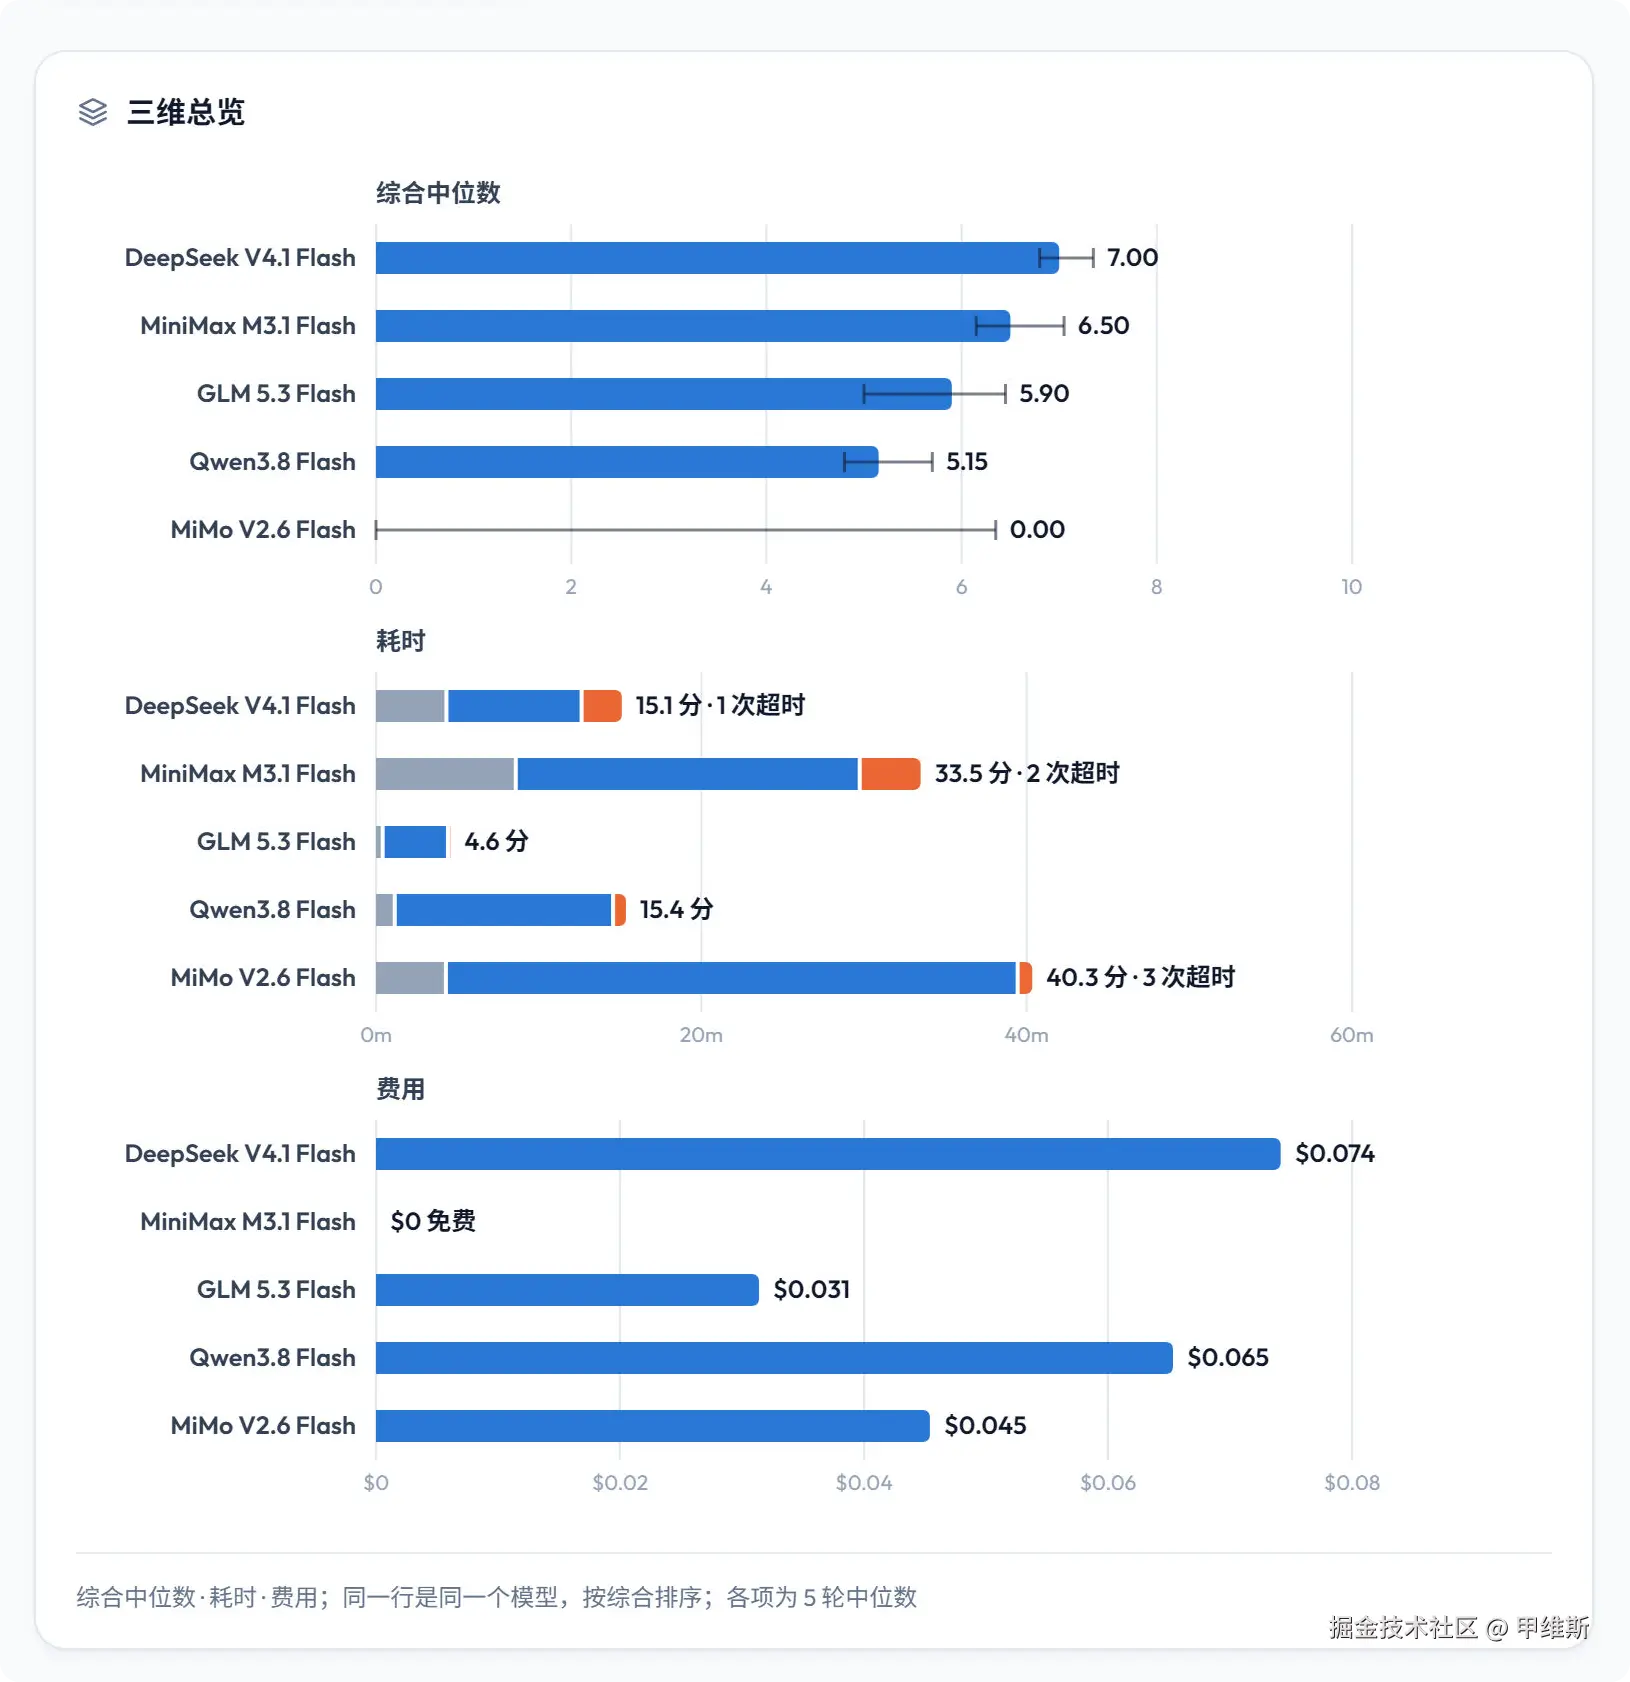
看到这个结果惊不惊喜?意不意外?
先把压力给到 Opus5.5!
测试题目和标准是我们一起定的,但是具体的评判都是它做的。如果有人不满意,可以去找这个"外国人"。
这个结果也是完全出乎我的意料的!
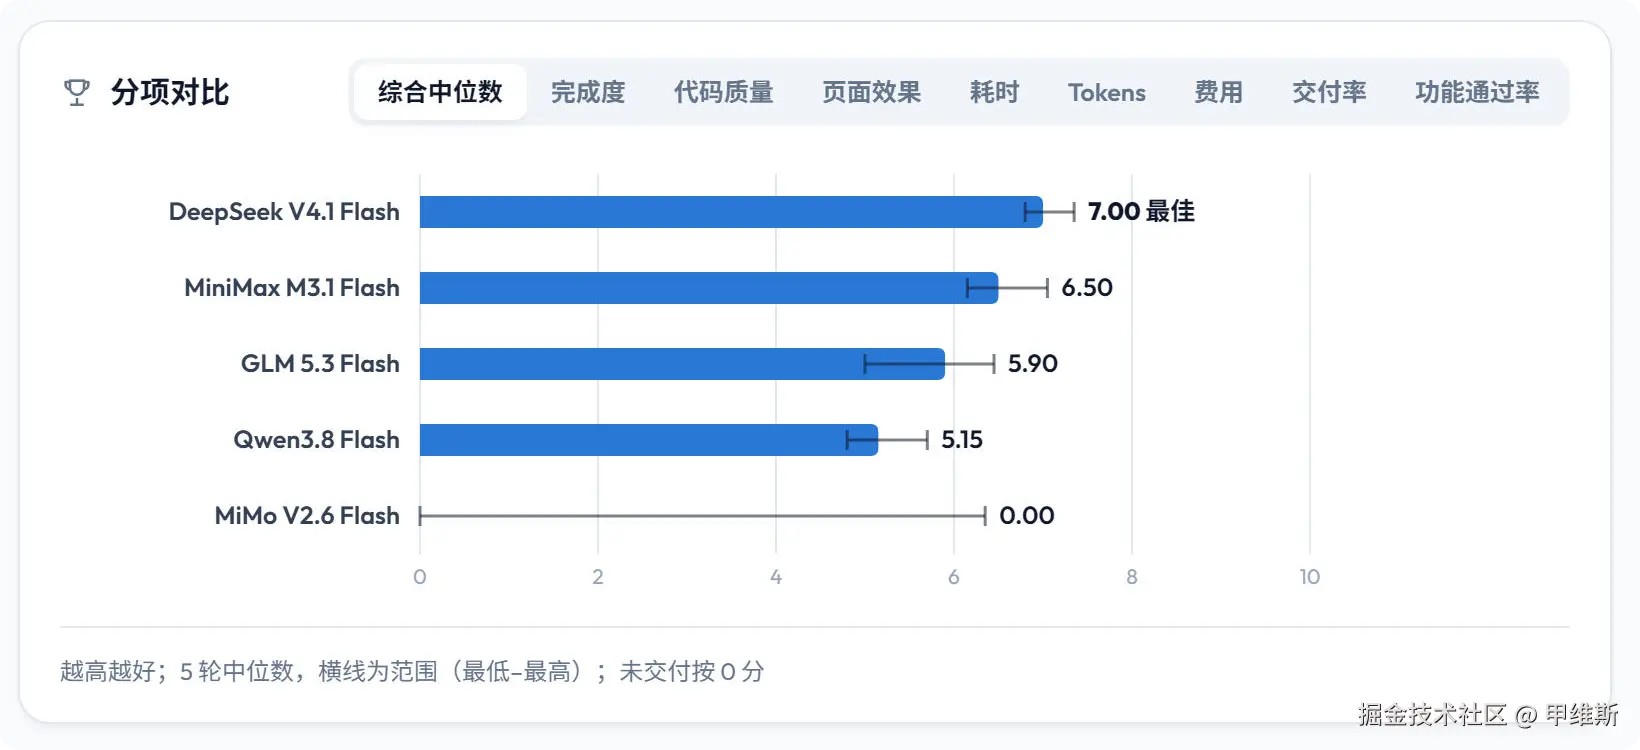
DeepSeek V4.1 Flash 拿下了中位数第一和最稳定模型的称号。
GLM 5.3 Flash 获得了交付最可靠和有效时间最短称号。
MiniMax 3.1 Flash 在评分上得到了第二名!
MiMo ...
我先不过多评论,我们一项一项来看!
综合评分和中位数:
多轮结果的分布情况:
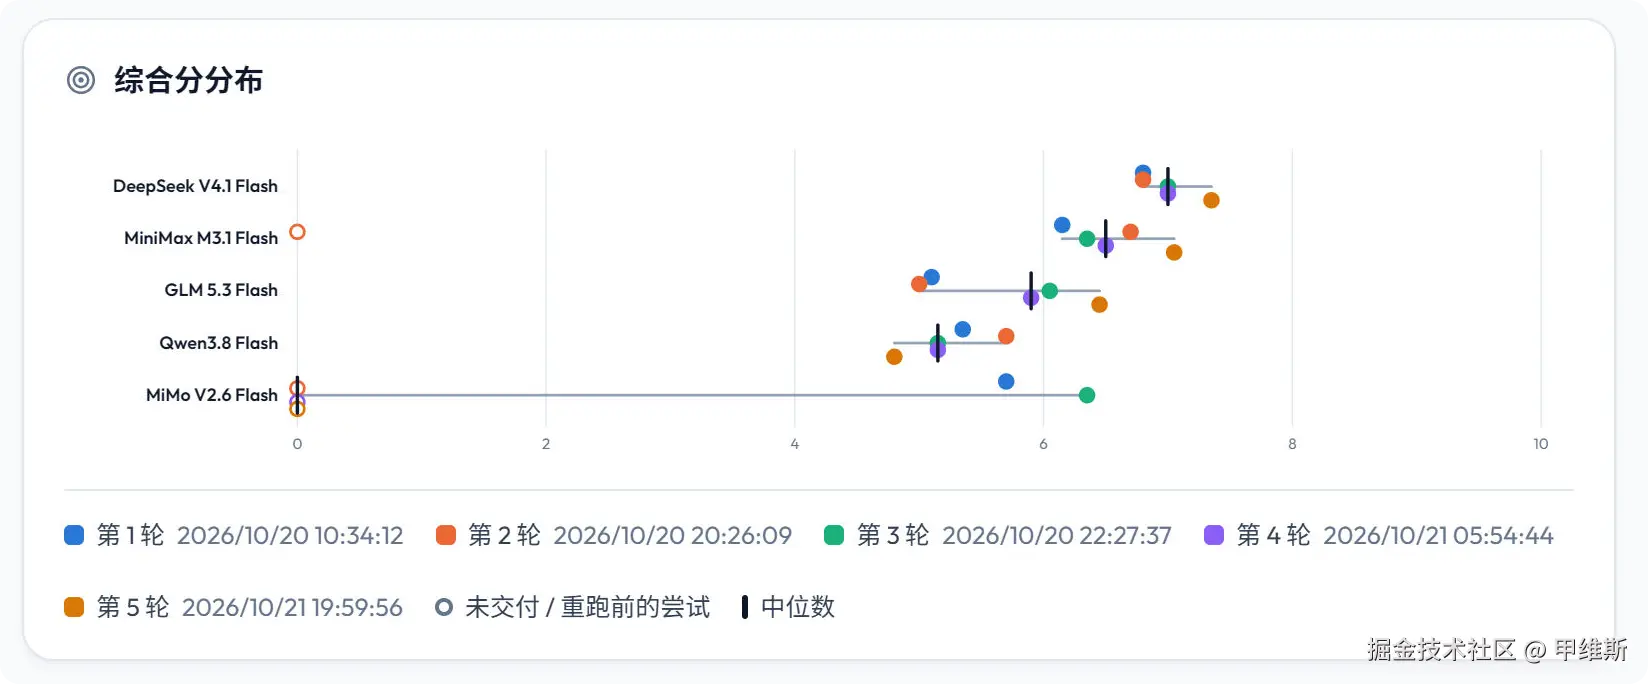
这两张图结果应该很清楚!不用我说!
完成度情况:
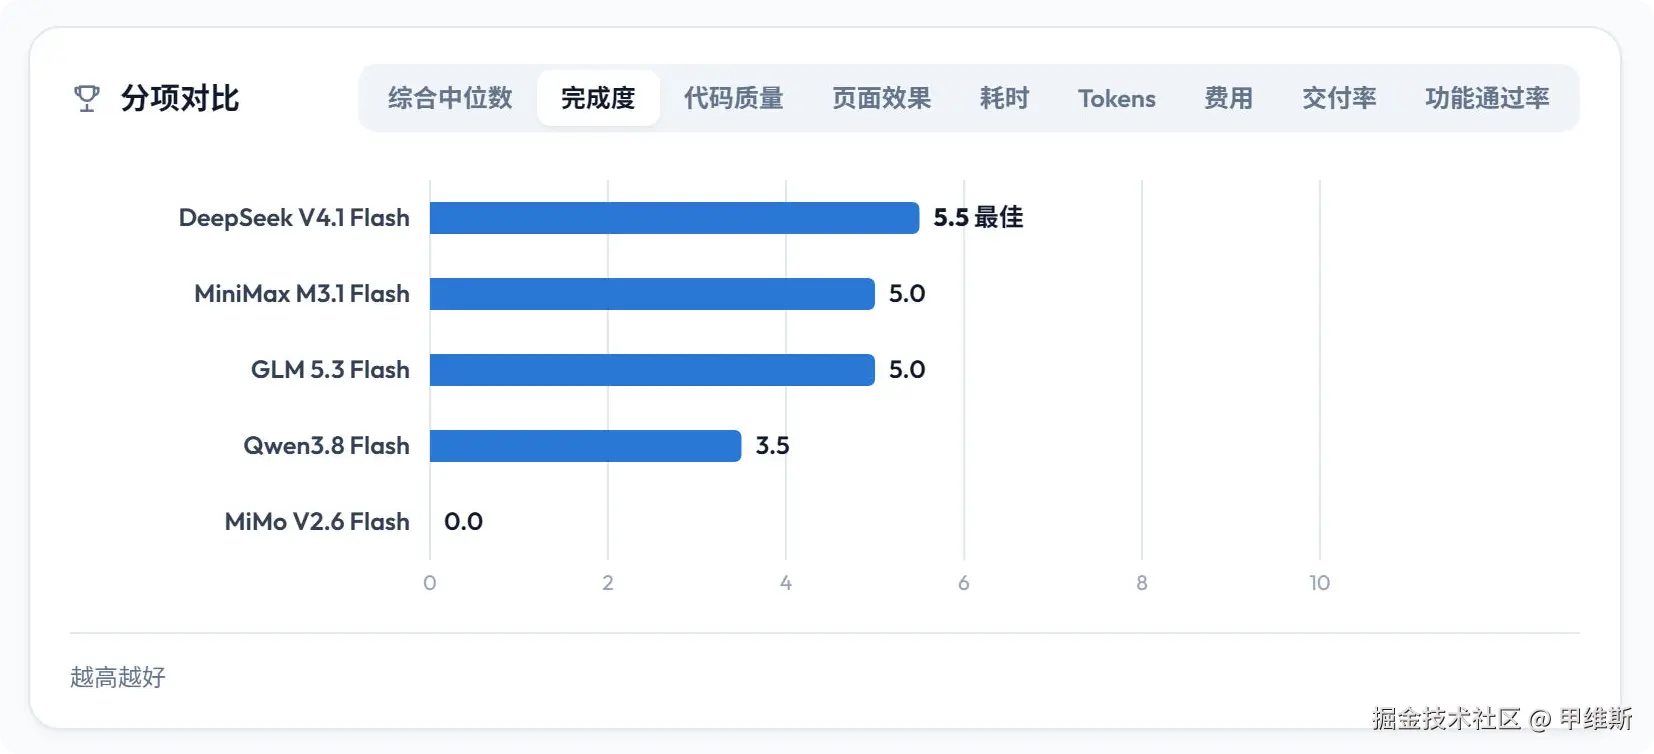
虽然排名有先后,但其实它们完成度都不是太高!
最强的 DS 都没有达到 6 分。如果按我们考试的标准,6 分是及格的话,它还没有达到及格线!
Qwen3.8 这个排名是我意料之中的。
至于这个 MiMo......军哥,你莫要怪我,主要是 MiMo 太"出众",评价都是 Claude 评的!
页面效果:
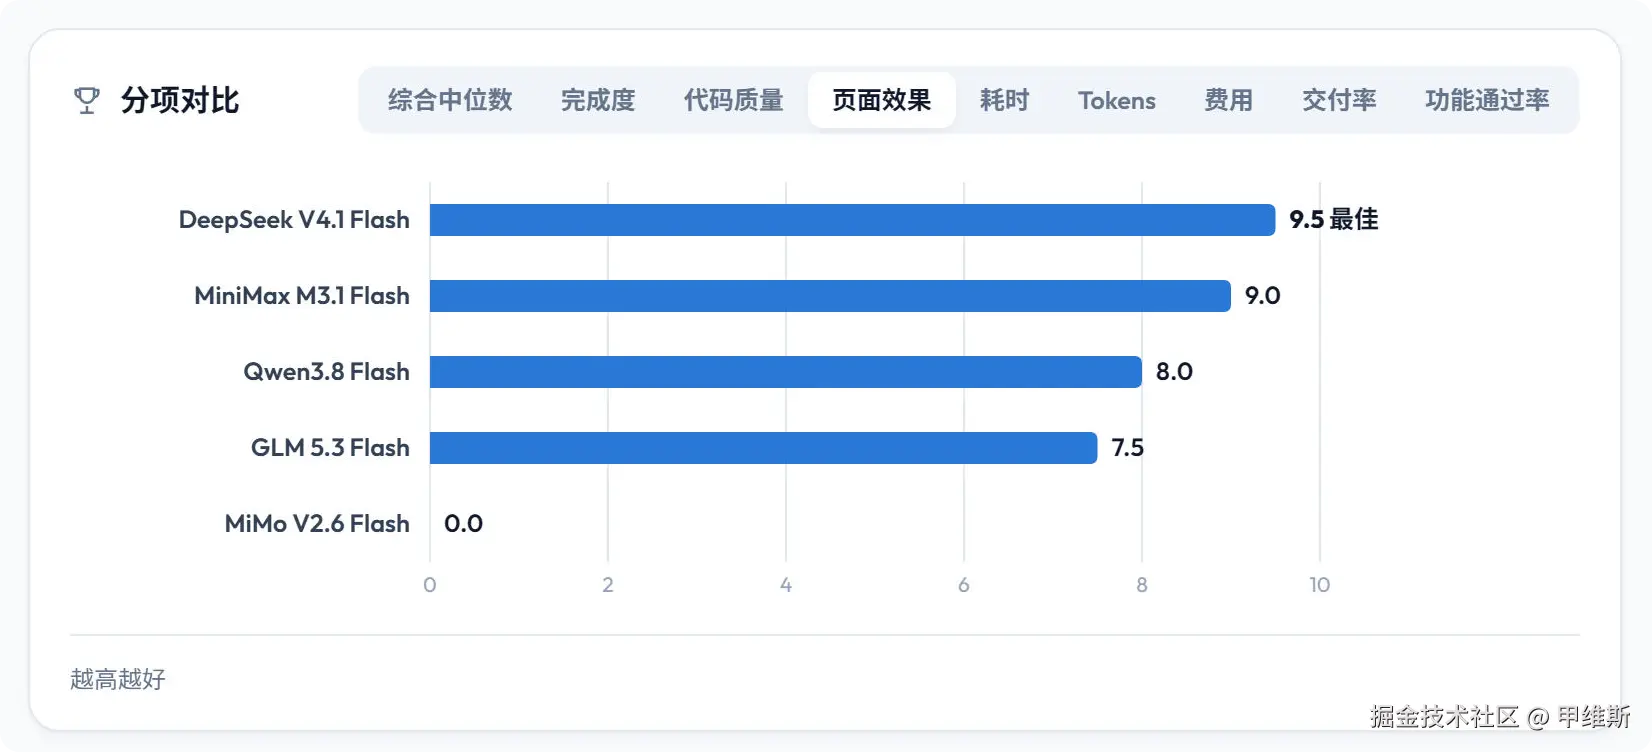
这次 DS 和 MiniMax 拿下第一第二,贡献最大的是页面效果这一项。整整为他们争取到了 0.5-1 分的空间。
谁能想到这两位是靠颜值取胜呢? DS 部分,它确实在实力上也略胜一筹。
Qwen3.8 和 GLM5.3 好像不太擅长画这个 SVG 手柄图,应该是新出的模型更有优势!
MiMo 完成度是零,页面得分也是零。
大家可能会觉得有点奇怪,我也有同样的疑问。
我看了一下记录,它有两轮是正常生成了页面的,按理说应该有分数才对。
我找 Claude 确认了一下,它一语点醒了我:
"哥,我们选的是中位数:0、0、0、5.70、6.35"
Claude 完整的思路:
MiMo 汇总分显示 0,是我们定的计算规则造成的,不是数据错了。

MiMo 在 t1 的 5 轮成绩依次是 5.70、✗、6.35、✗、✗,只有 2 轮交出了页面:

第 2 轮:跑满 60 分钟,只做规划,零产出。

第 4 轮:写完方案就停下等人确认,零产出。

第 5 轮:花了 55 分钟下载图片、描像素轮廓,超时,零产出。


汇总规则是"没交付按 0 分计入中位数",所以参与计算的 5 个数是 0、0、0、5.70、6.35。排序后中间那个数是 0,中位数自然是 0。范围显示"0.00--6.35",交付率显示"2/5",这两个数字反映的是同一件事。

这样设计,是为了让中位数同时体现水平和稳定性。

如果只算交付的轮次,MiMo 的中位数约为 6.03,会排在 MiniMax 和 GLM Flash 之间。

可它 5 轮有 3 轮交白卷,排在这个位置会误导读者。
看出来了,Claude 还是很在意交白卷的问题的!
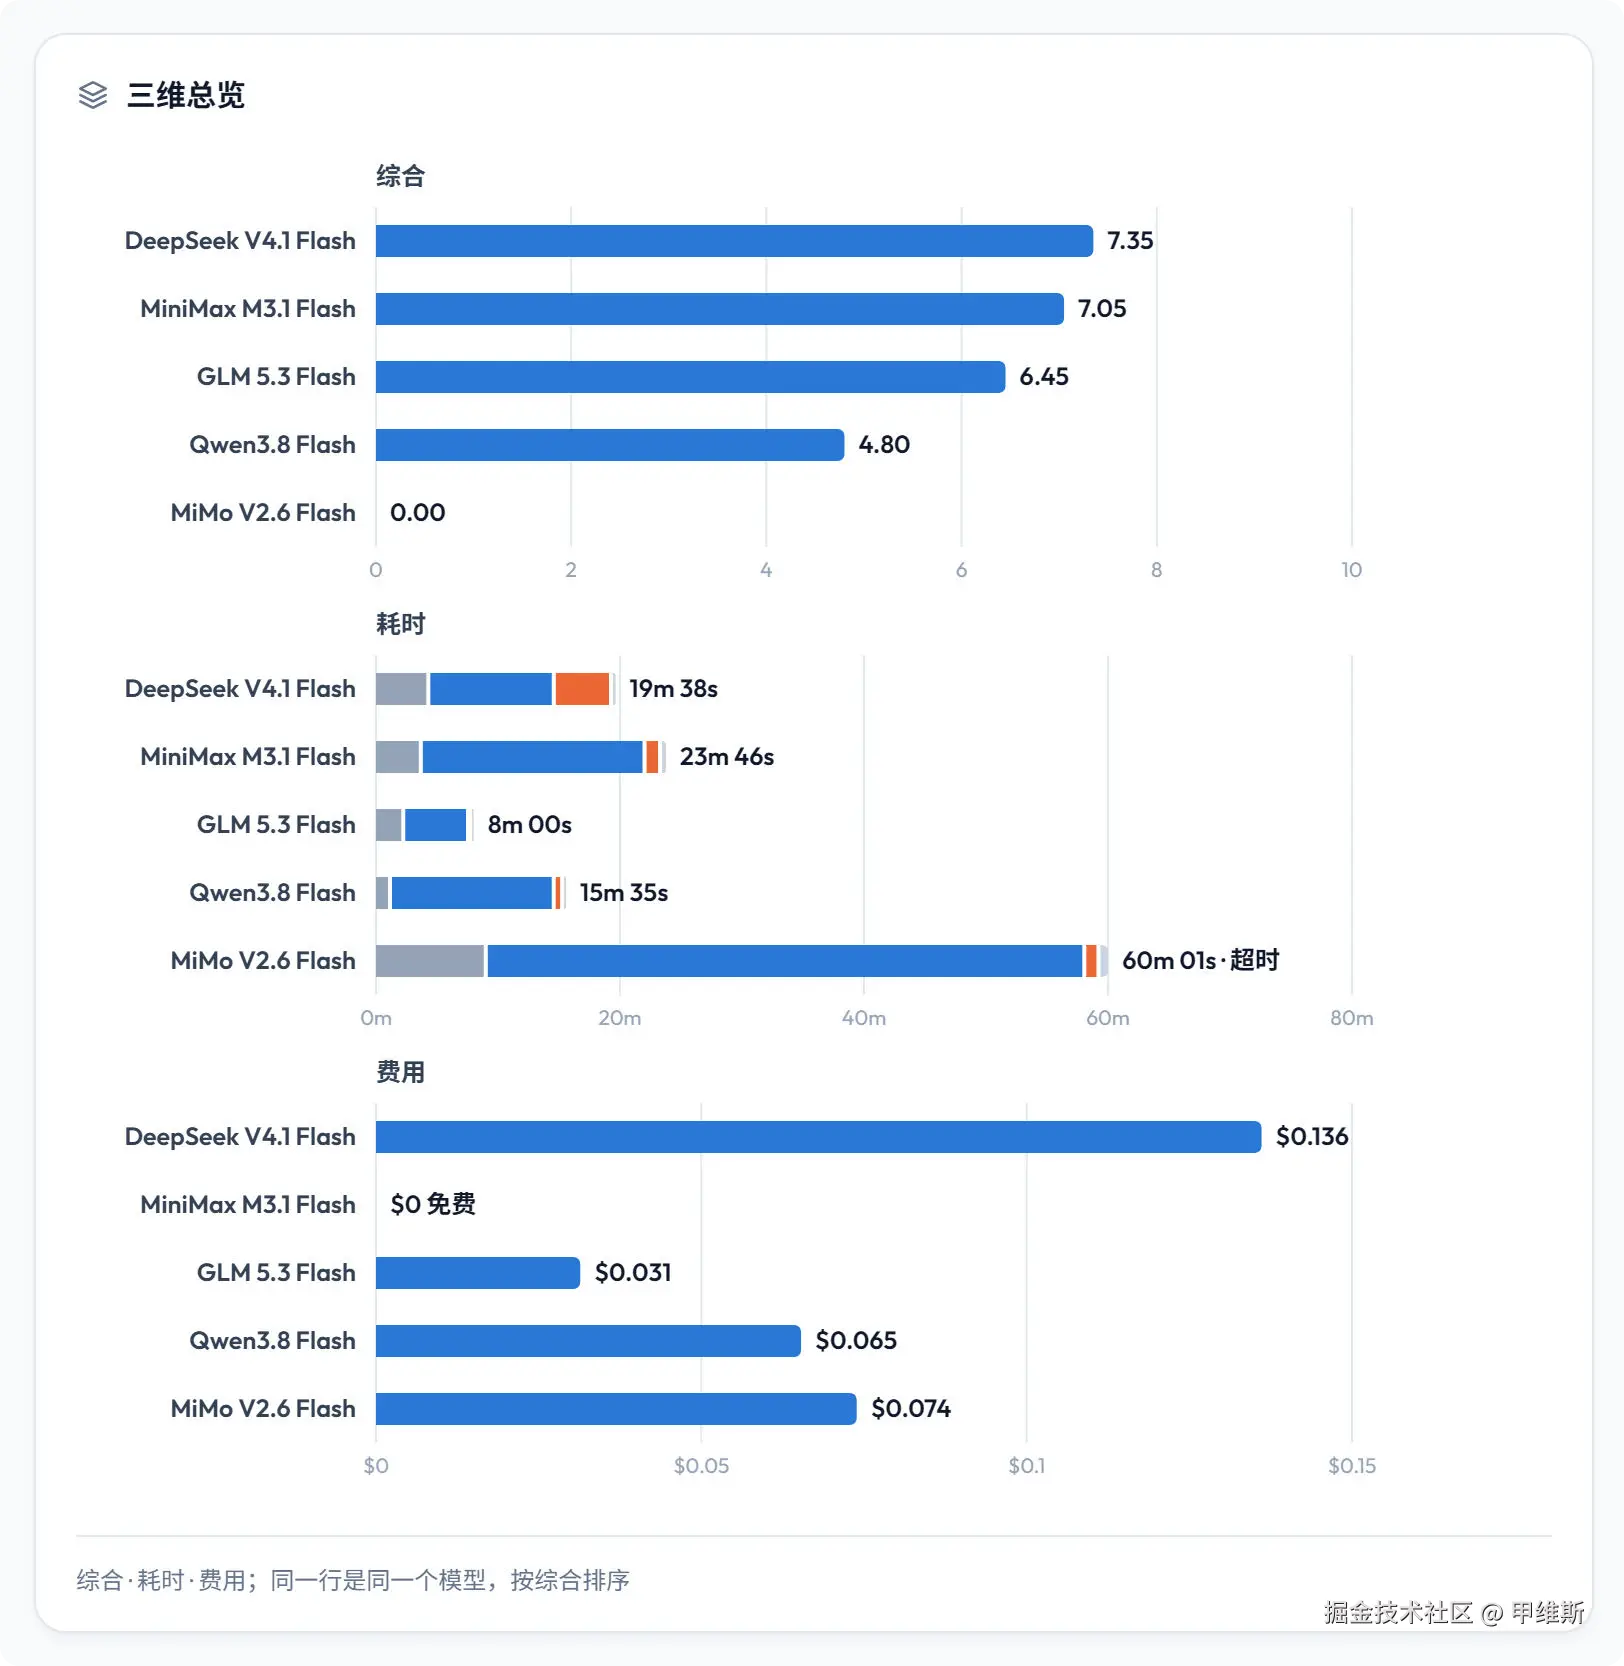
耗时数据:
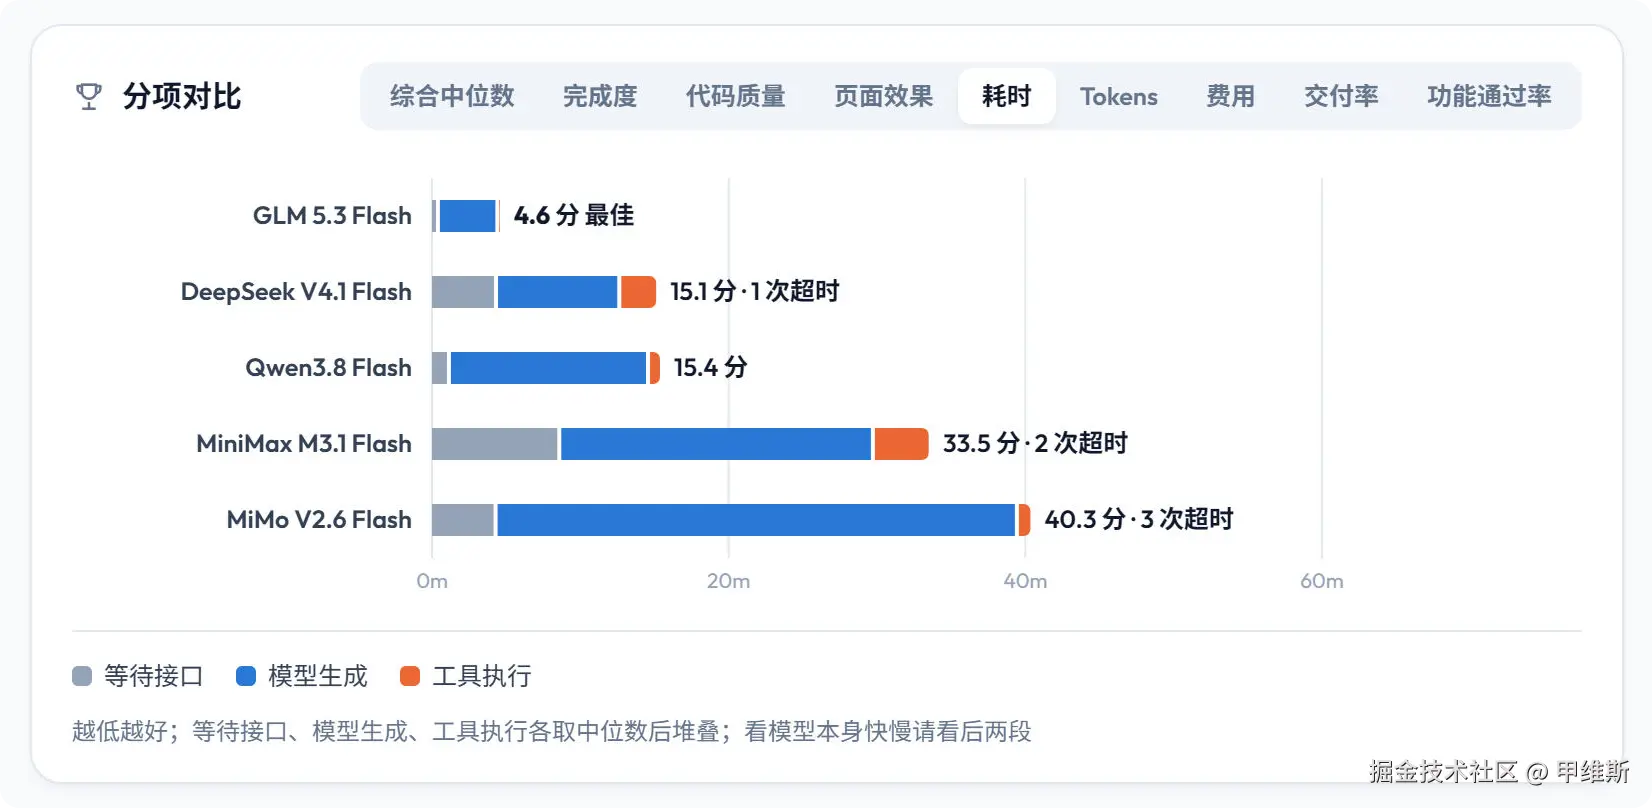
我们开头说了能力很重要,时间也很重要!
我是非常关注时间的,浪费我时间的模型,我都会痛骂它一顿!
看到这个耗时数据,大家是不是又很惊讶?反正我是很惊讶!
最快的居然是 GLM 5.3 Flash!
我以前在 ZCode 里面用,感觉它每一项任务都很慢。我也有在 ZCode 里面单独测试了这个项目,它大概用了 40 多分钟,结果是差不多的。我不确定是什么造成了这种差异,我只能给大家反馈一下这个情况。
DS 的 token 速率可以达到 200 多,但在实际任务中,并没有想象的那么快。
这里最慢的两个就是 MiniMax M3.1 和 MiMo V2.6 了。
MiMo 是直接3 次超时,这个超时的意思就是我给了它 3 个小时,它连一个页面都没有生成!
它一直在大脑里研究怎么画好这个 SVG,各种资料准备,技法推演,就是不动手!
MiniMax 也特别喜欢反复思考和验证!
为了更好的分析时间消耗情况,时间部分我做了细致的划分:一个是等待接口,一个是模型生成,一个是工具执行!
等待接口这一部分呢,跟模型本身速度没有关系!
重点是模型生成和工具执行这一部分。
从数据中可以发现这个 DS 和 MiniMax 它们在工具执行这一步消耗比例是较大的!
GLM 5.3 Flash 就很好,它大部分都是在模型生成部分。
tokens 消耗:
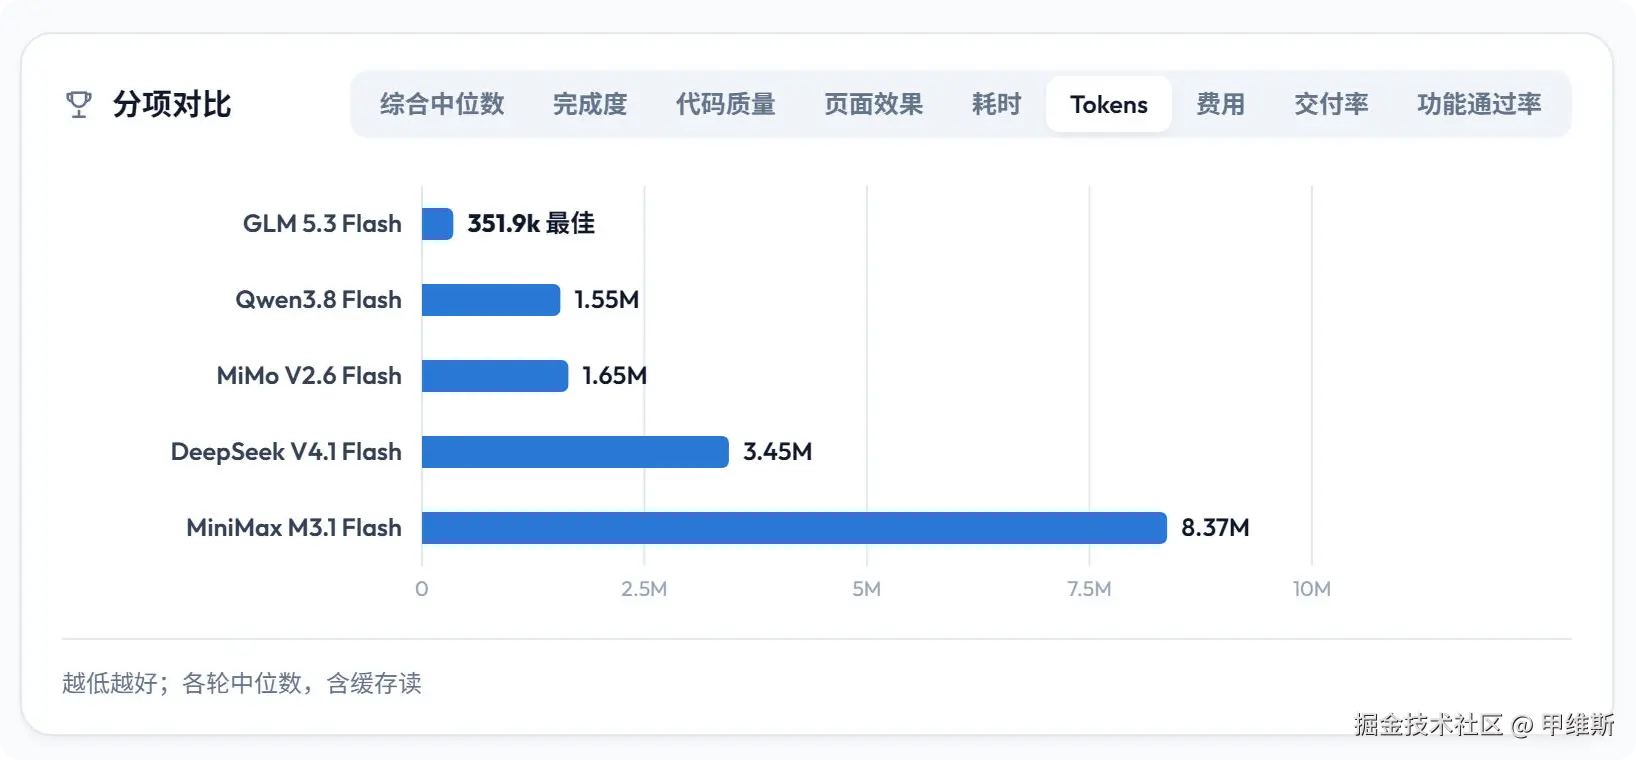
tokens 消耗最少的是 GLM 5.3 Flash。
最多的是 MiniMax M3.1 Flash。
从这里可以看出来, MiniMax 和 DeepSeek 它们的 tokens 消耗量其实是非常高的!
第一名和最后一名之间的差距非常巨大。
注意:这个是完全一样的任务,一模一样的提示词。
费用:
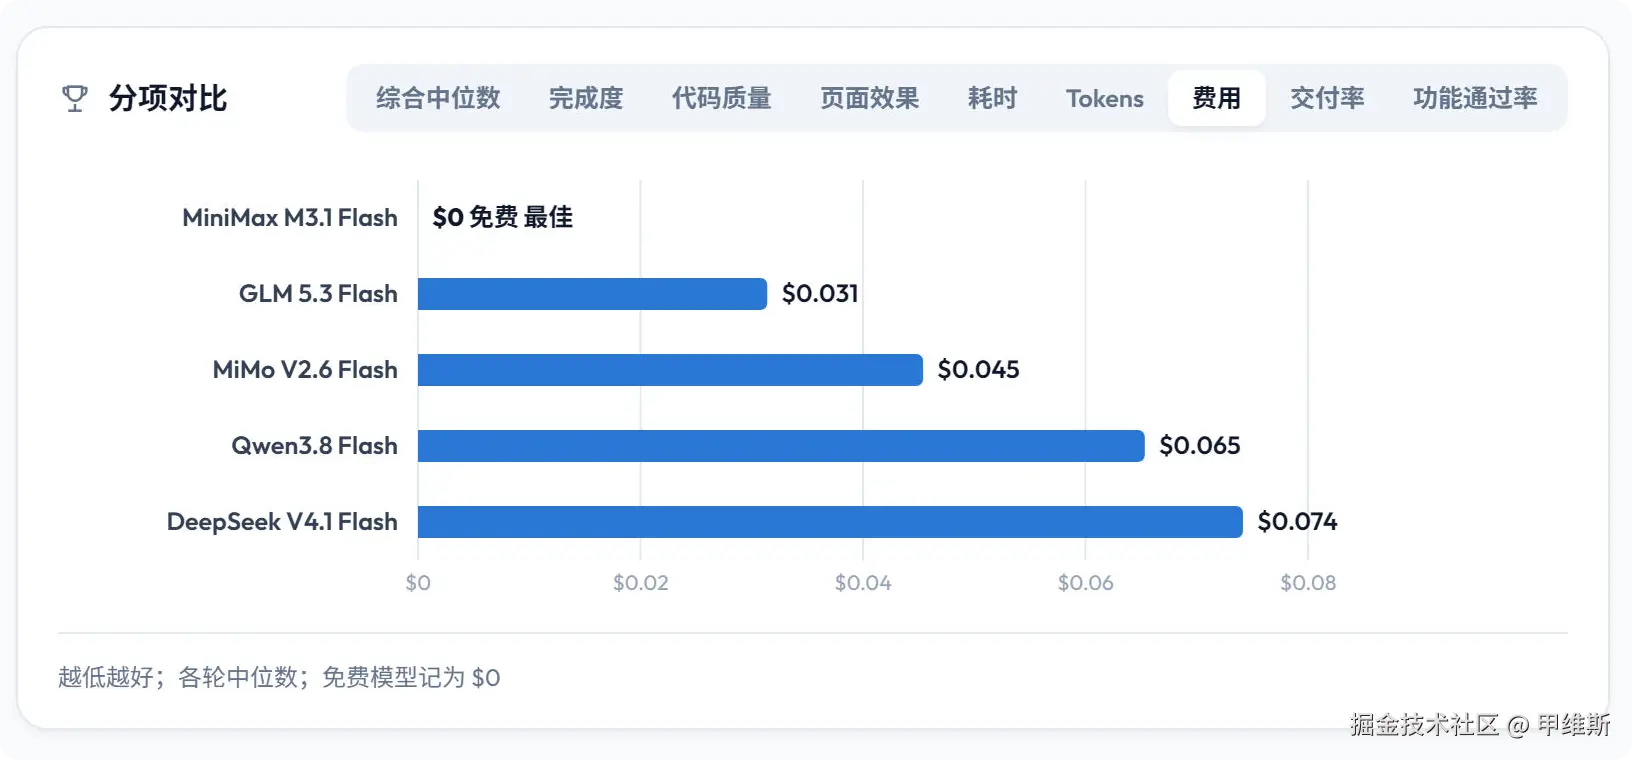
反常识的又来了啊,DS 是最贵的!
费用部分的话,基本上是和 tokens 消耗对齐的!
只是这里有个特殊情况,因为 MiniMax 现在是免费的,所以它不要钱。
GLM5.3 因为 tokens 消耗少,所以它肯定便宜了。
整体来说,价格差距好像比 tokens 消耗差距要小一些。
然后还有一些代码质量啊、交付率啊、通过率啊,这些我就不展示。有兴趣的可以去网页上自己看!
各轮明细:
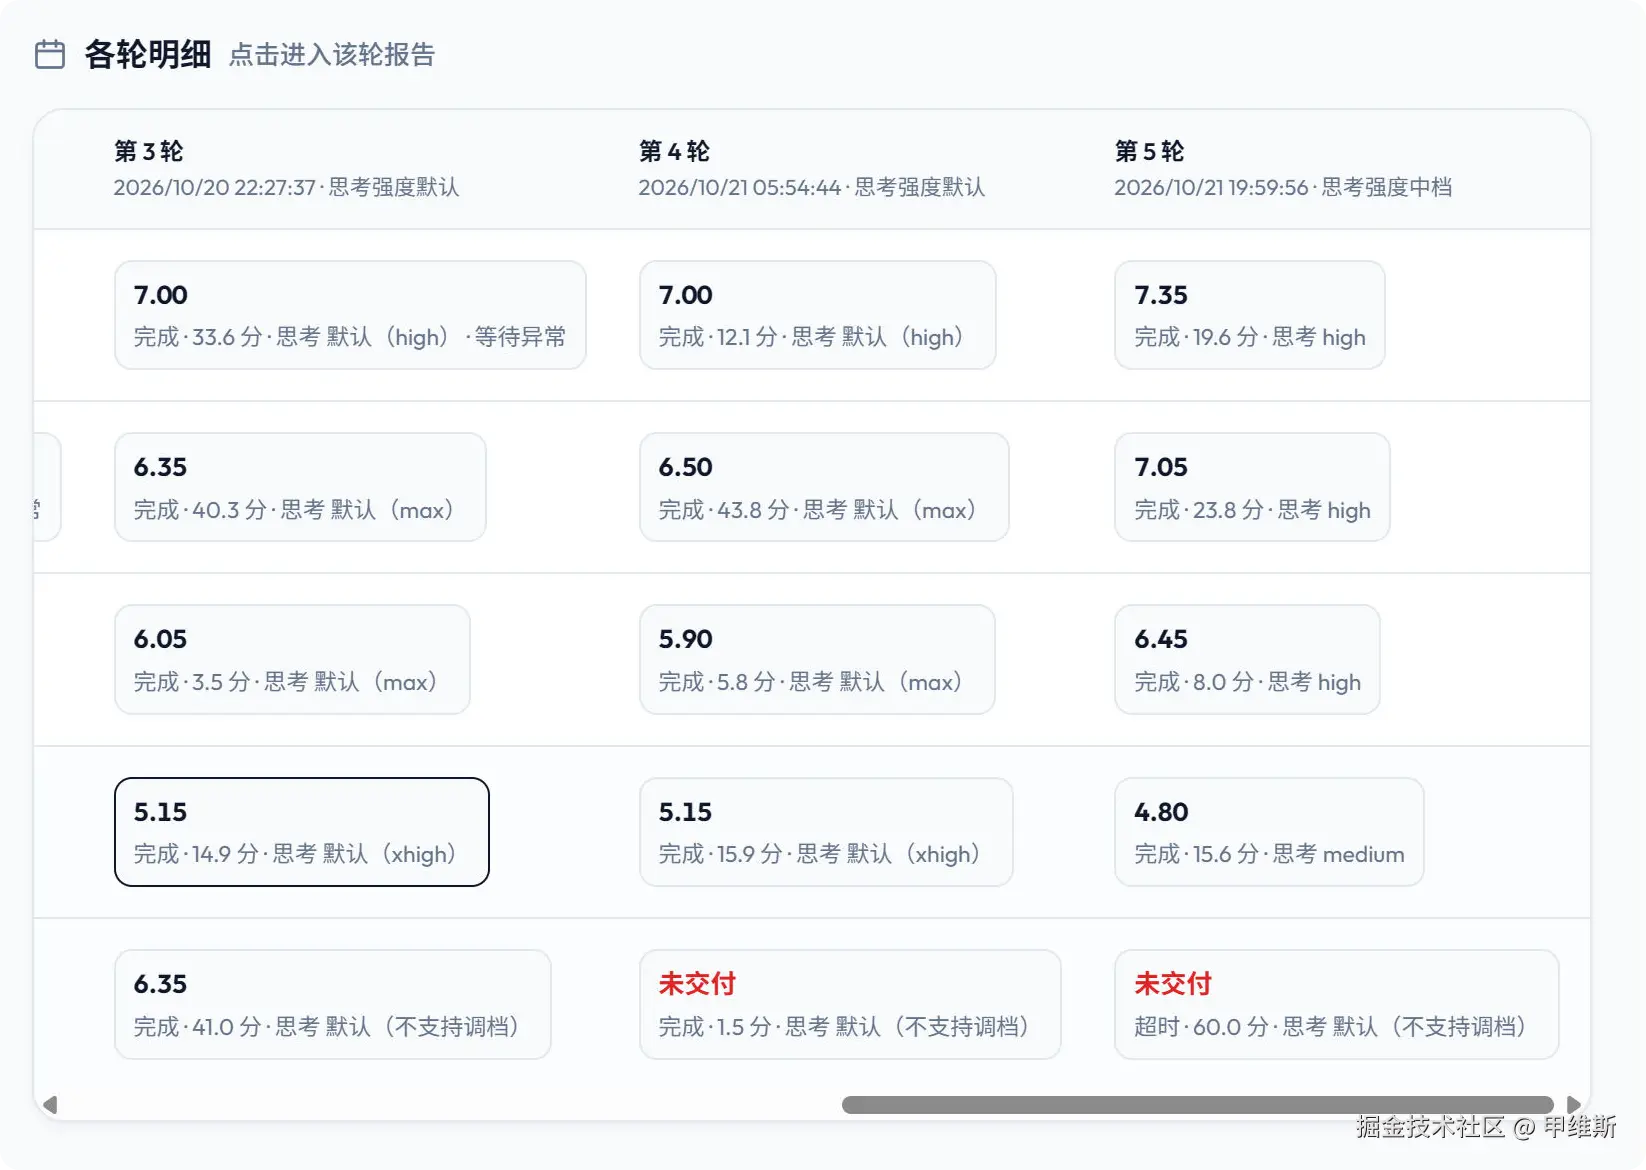
通过汇总页是可以查到每一轮的明细的。包括它们的得分、时间、思考强度、异常情况。
每一轮点进去都有这样的汇总报告:
然后每一轮中每个模型都有具体的评价:
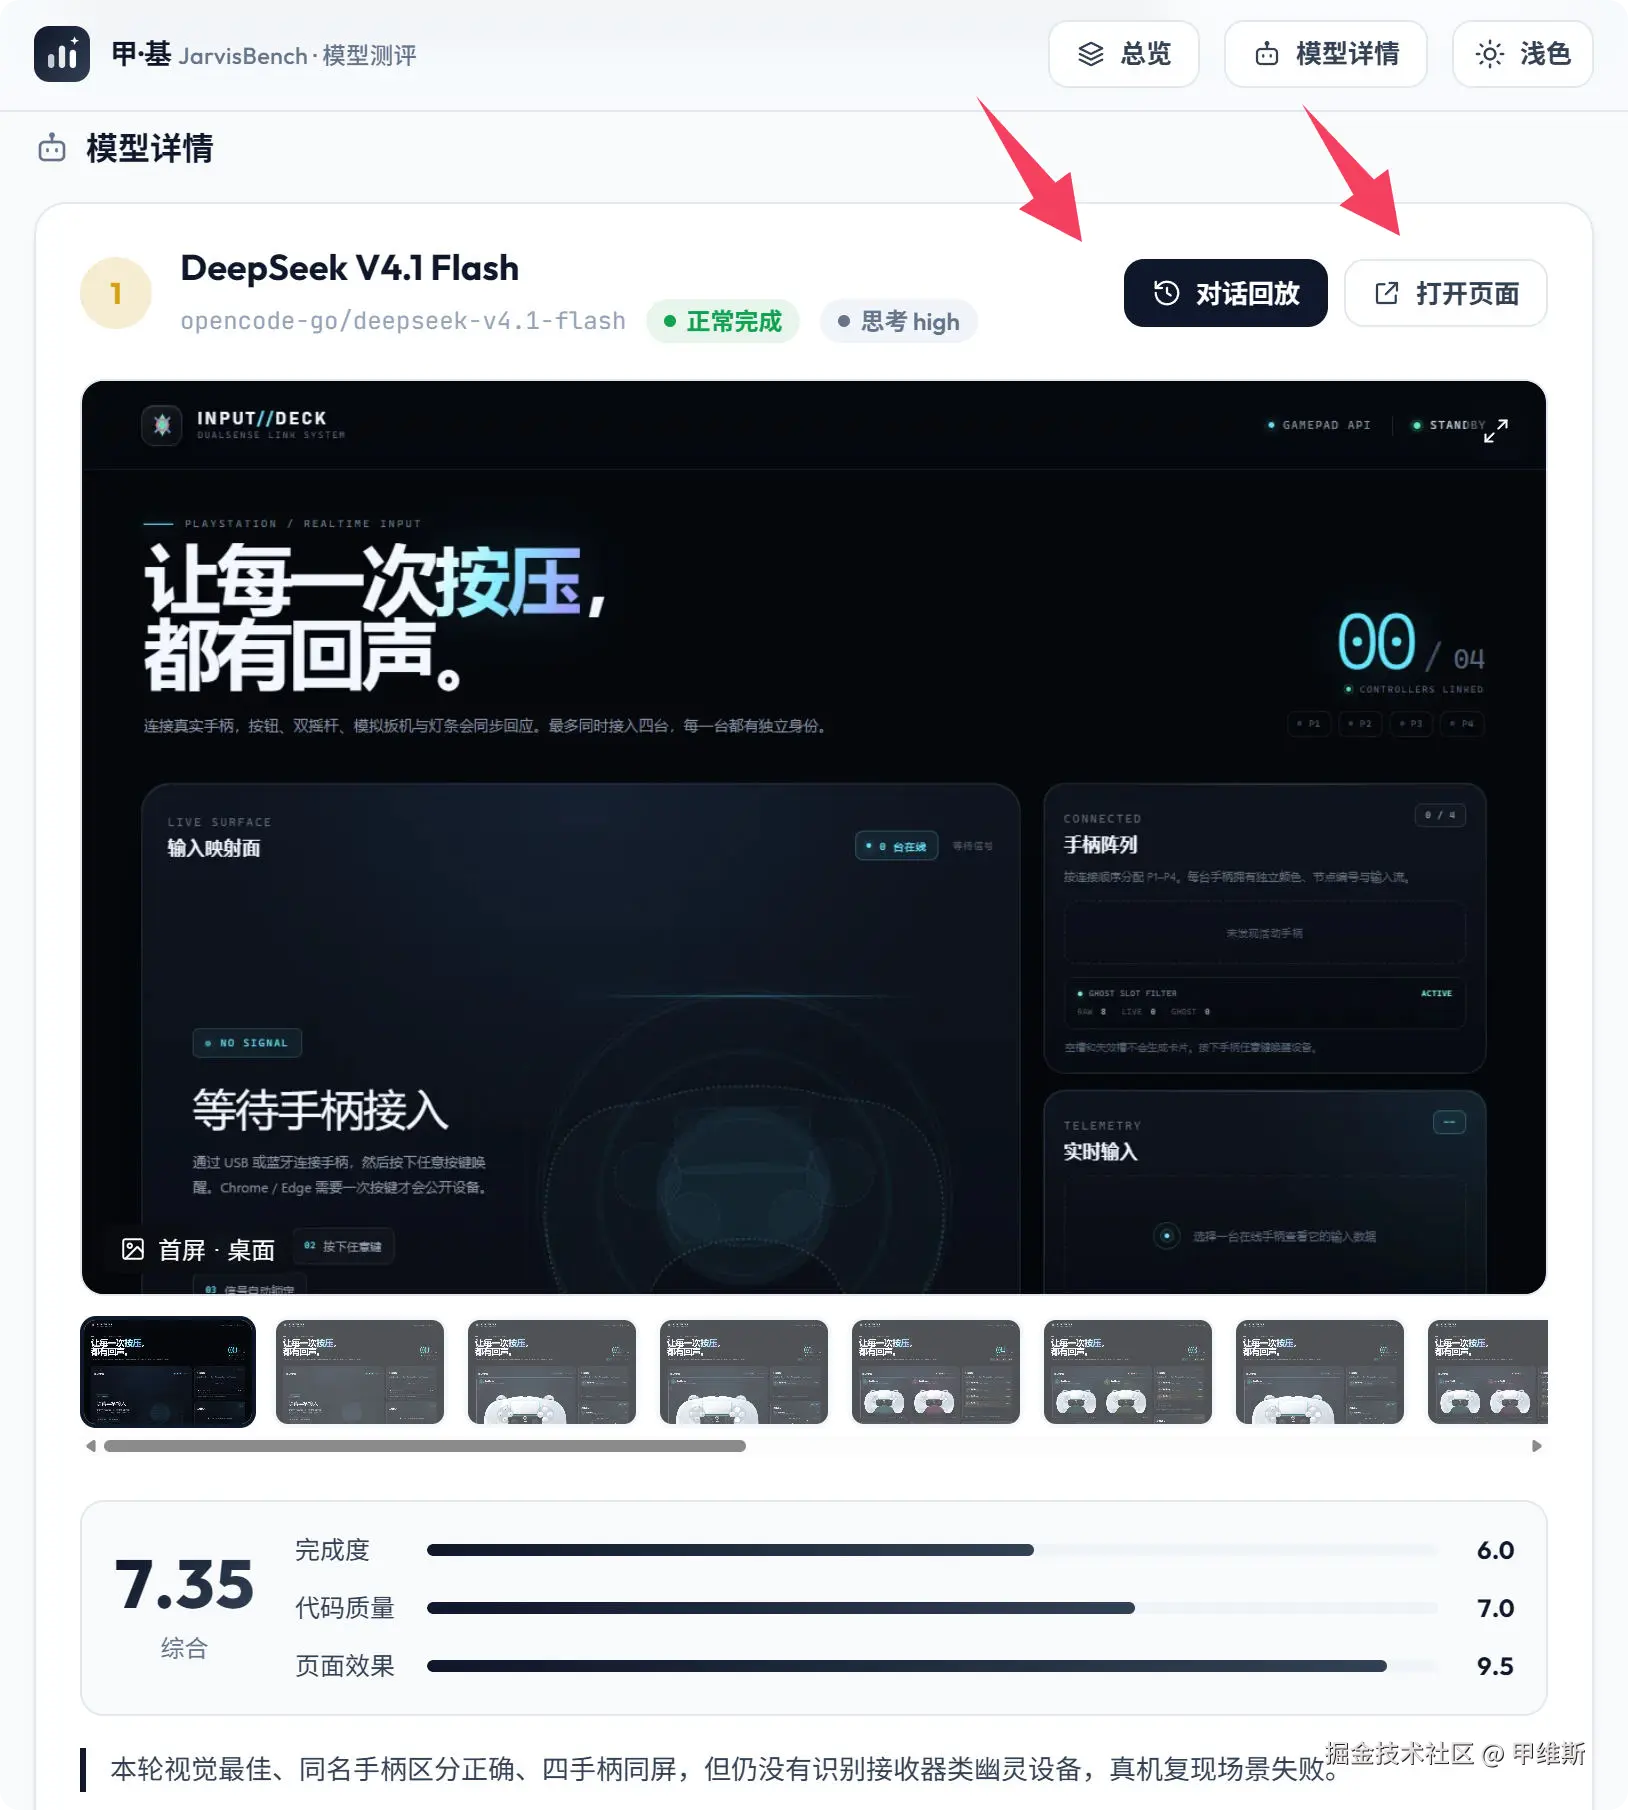
可以看到用例测试的截图,各维度的评分以及总结!
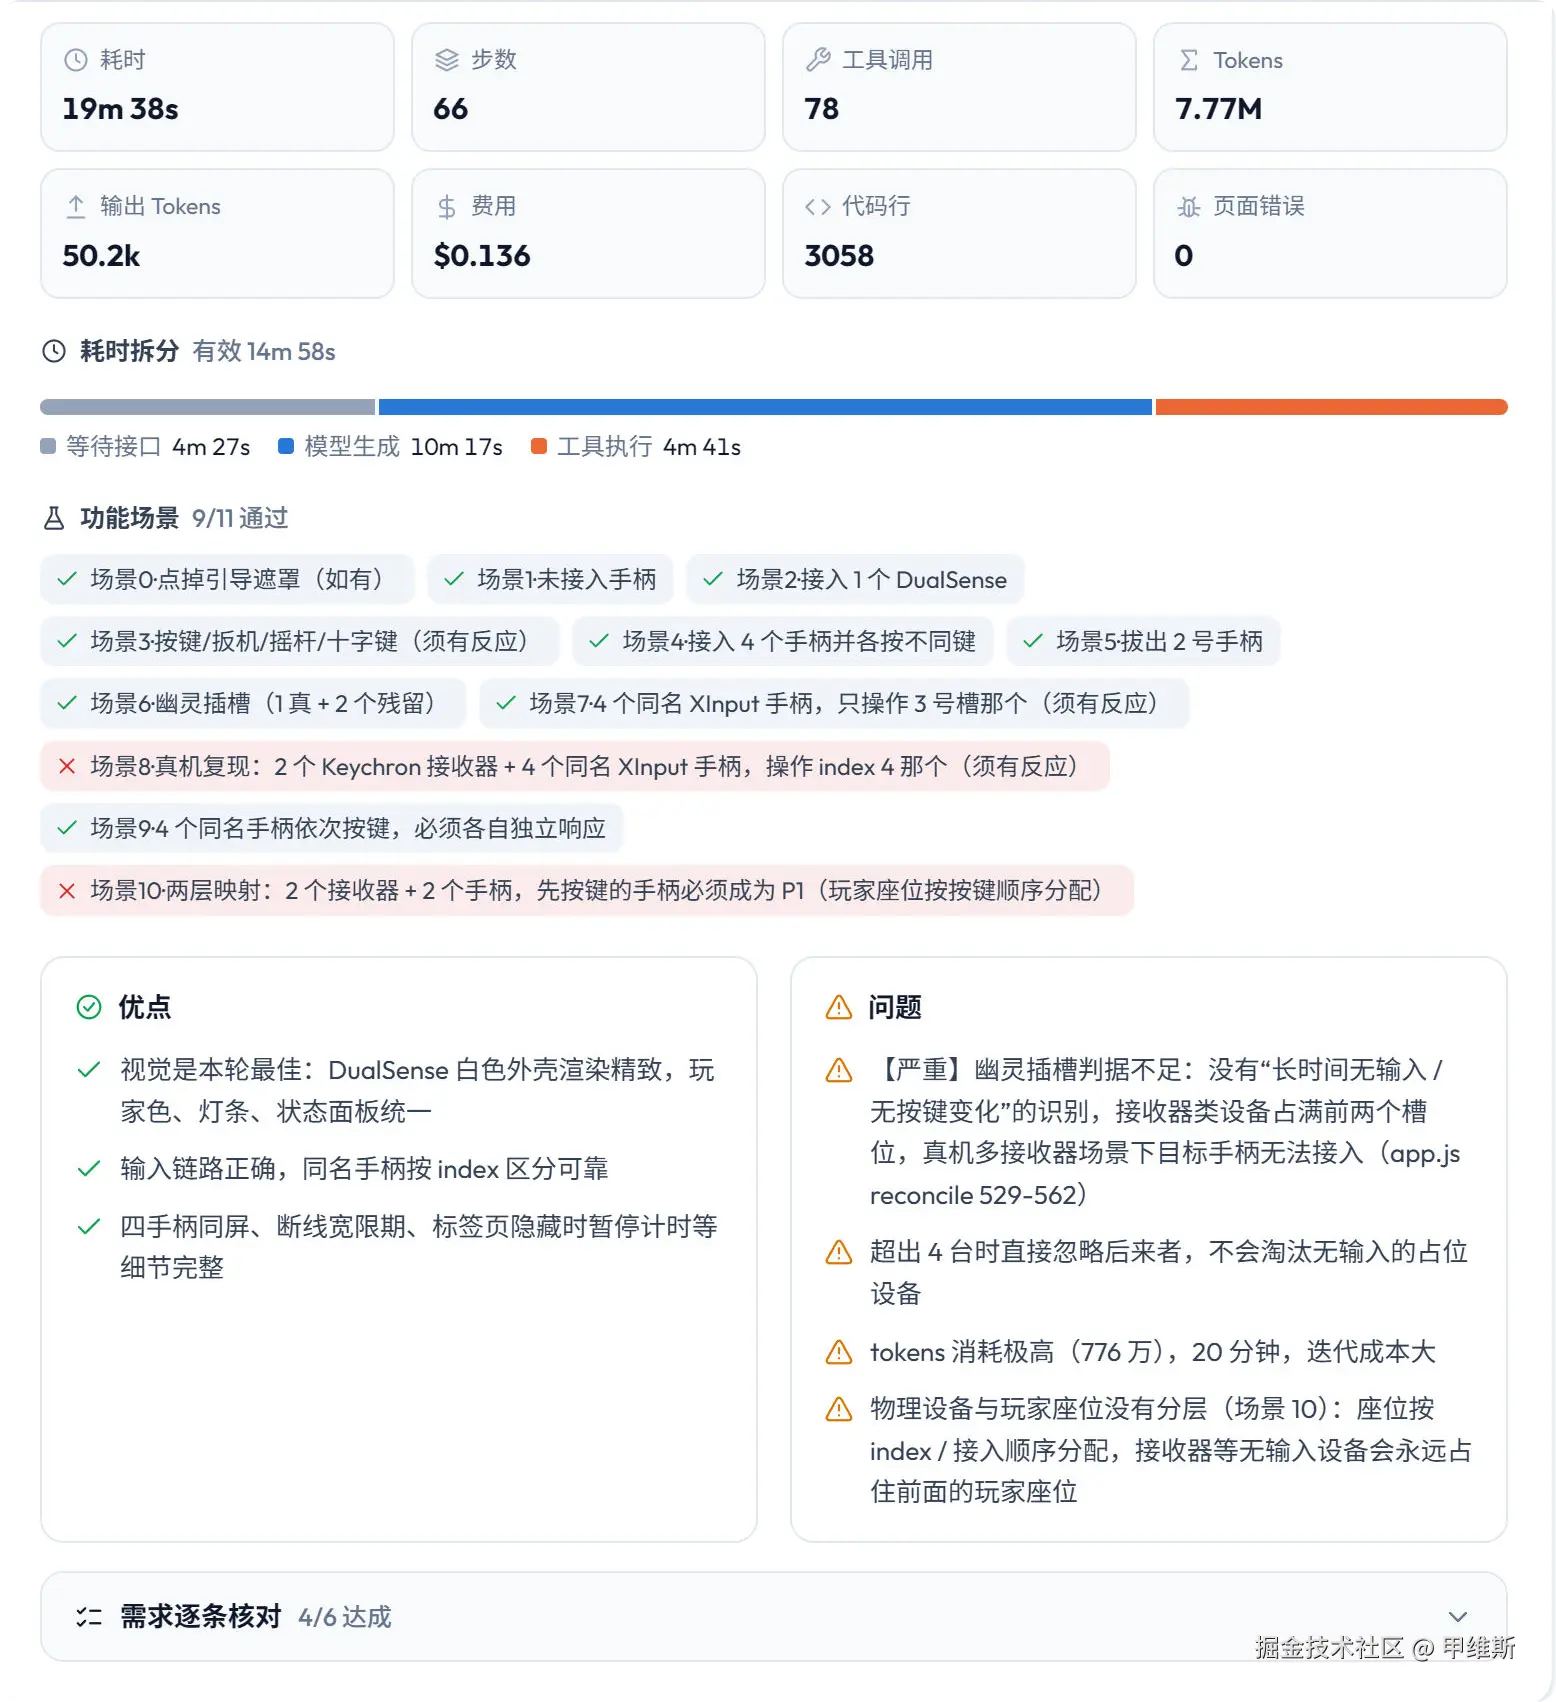
反正是 Claude 来做,我就让它做得详细了一点咯,人做的话,工作量还是巨大的!
如果这些汇总信息看得还不过瘾,那么可以点击右上角的打开页面和对话回放!
通过对话回放可以查看完整的开发过程:
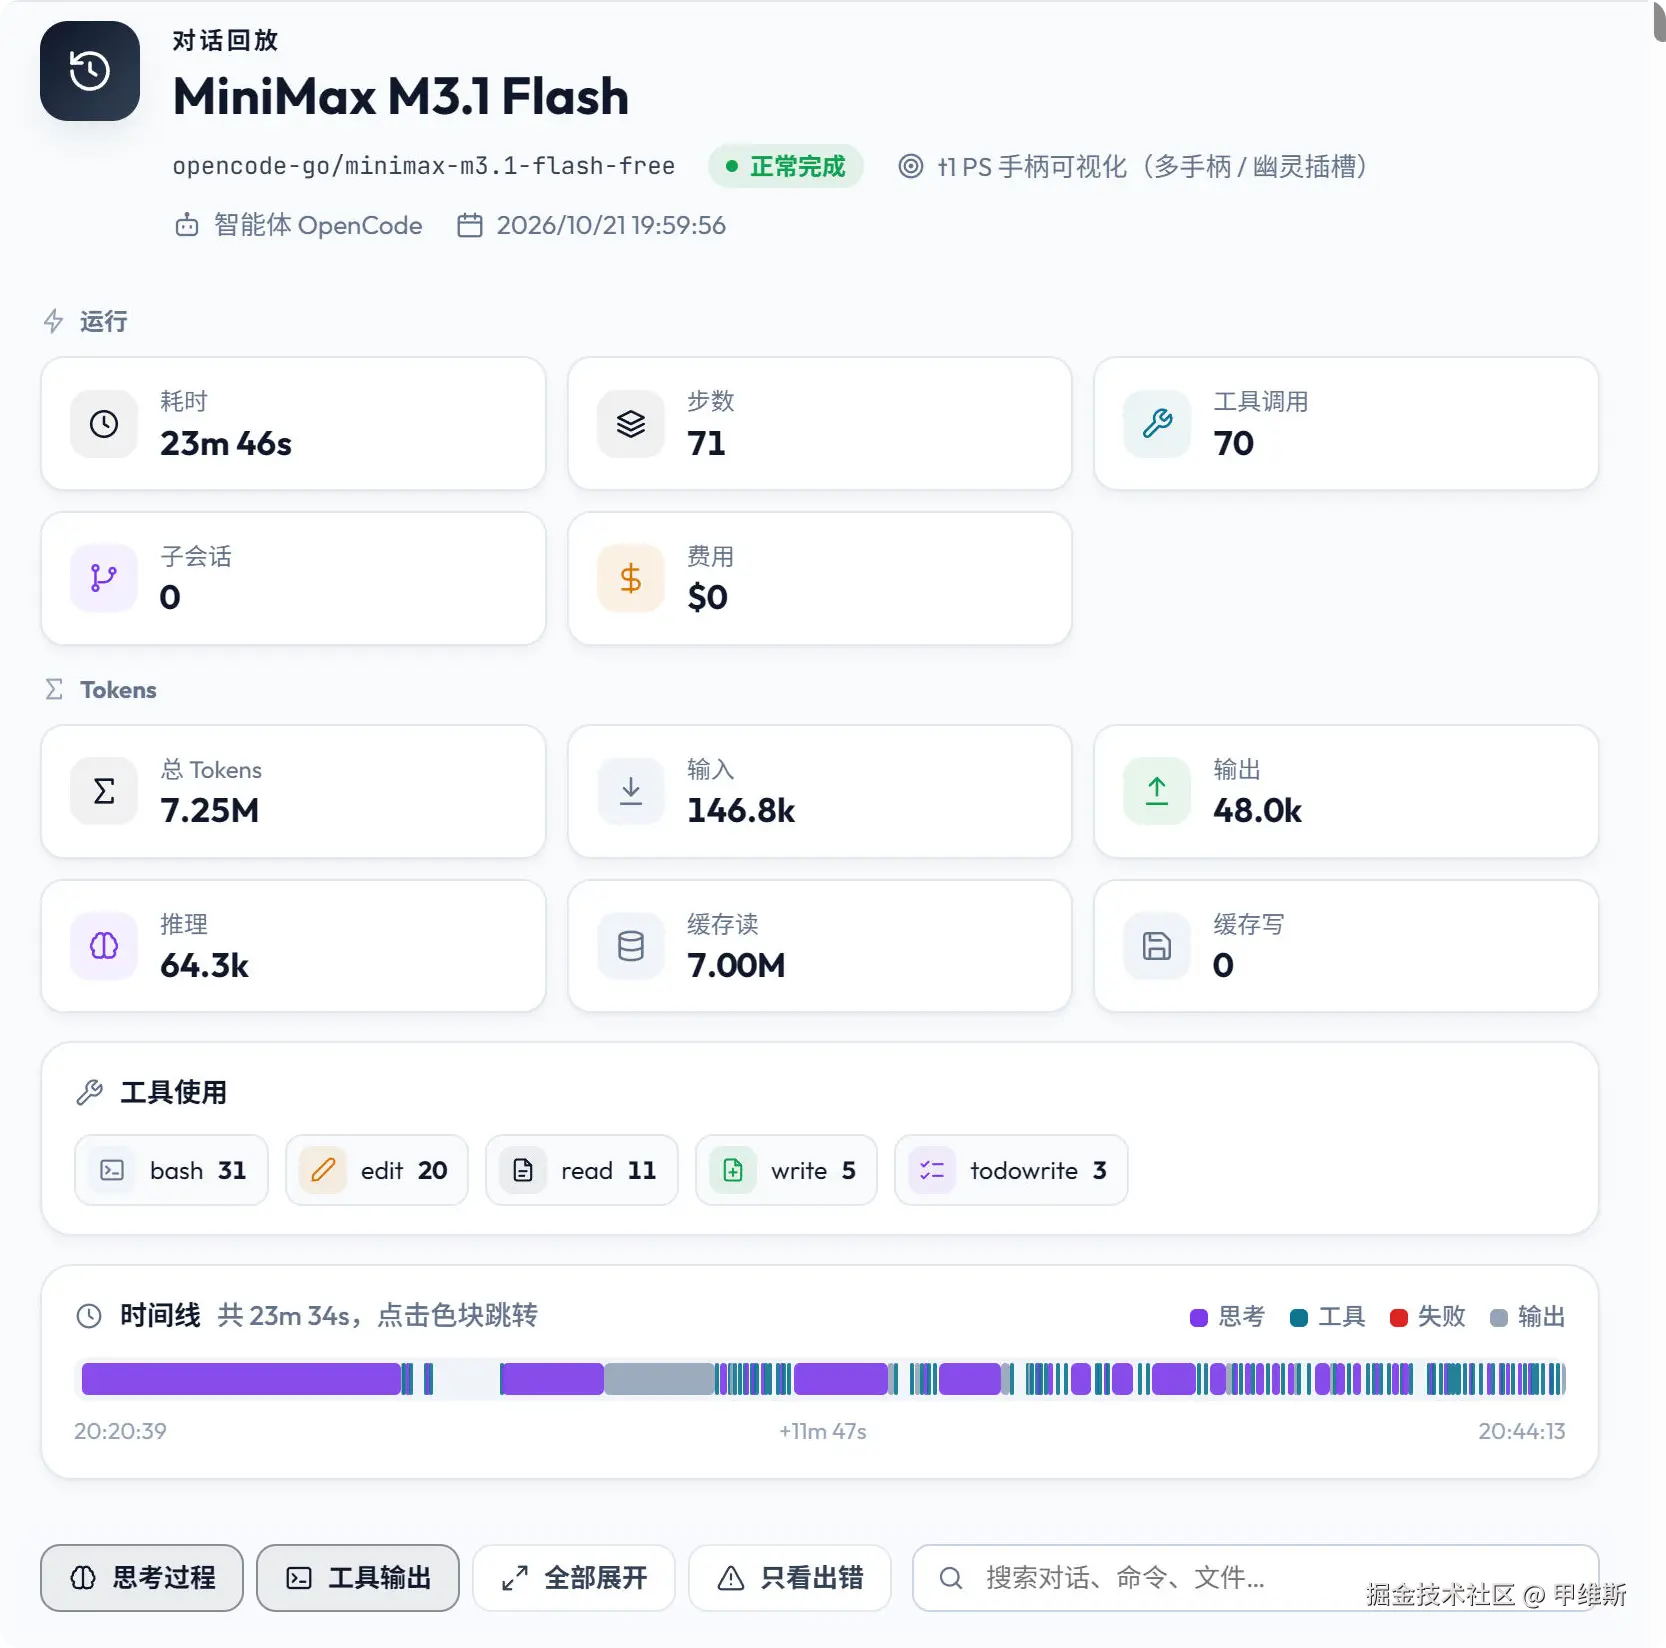
通过页面可以直接看它的生成结果:
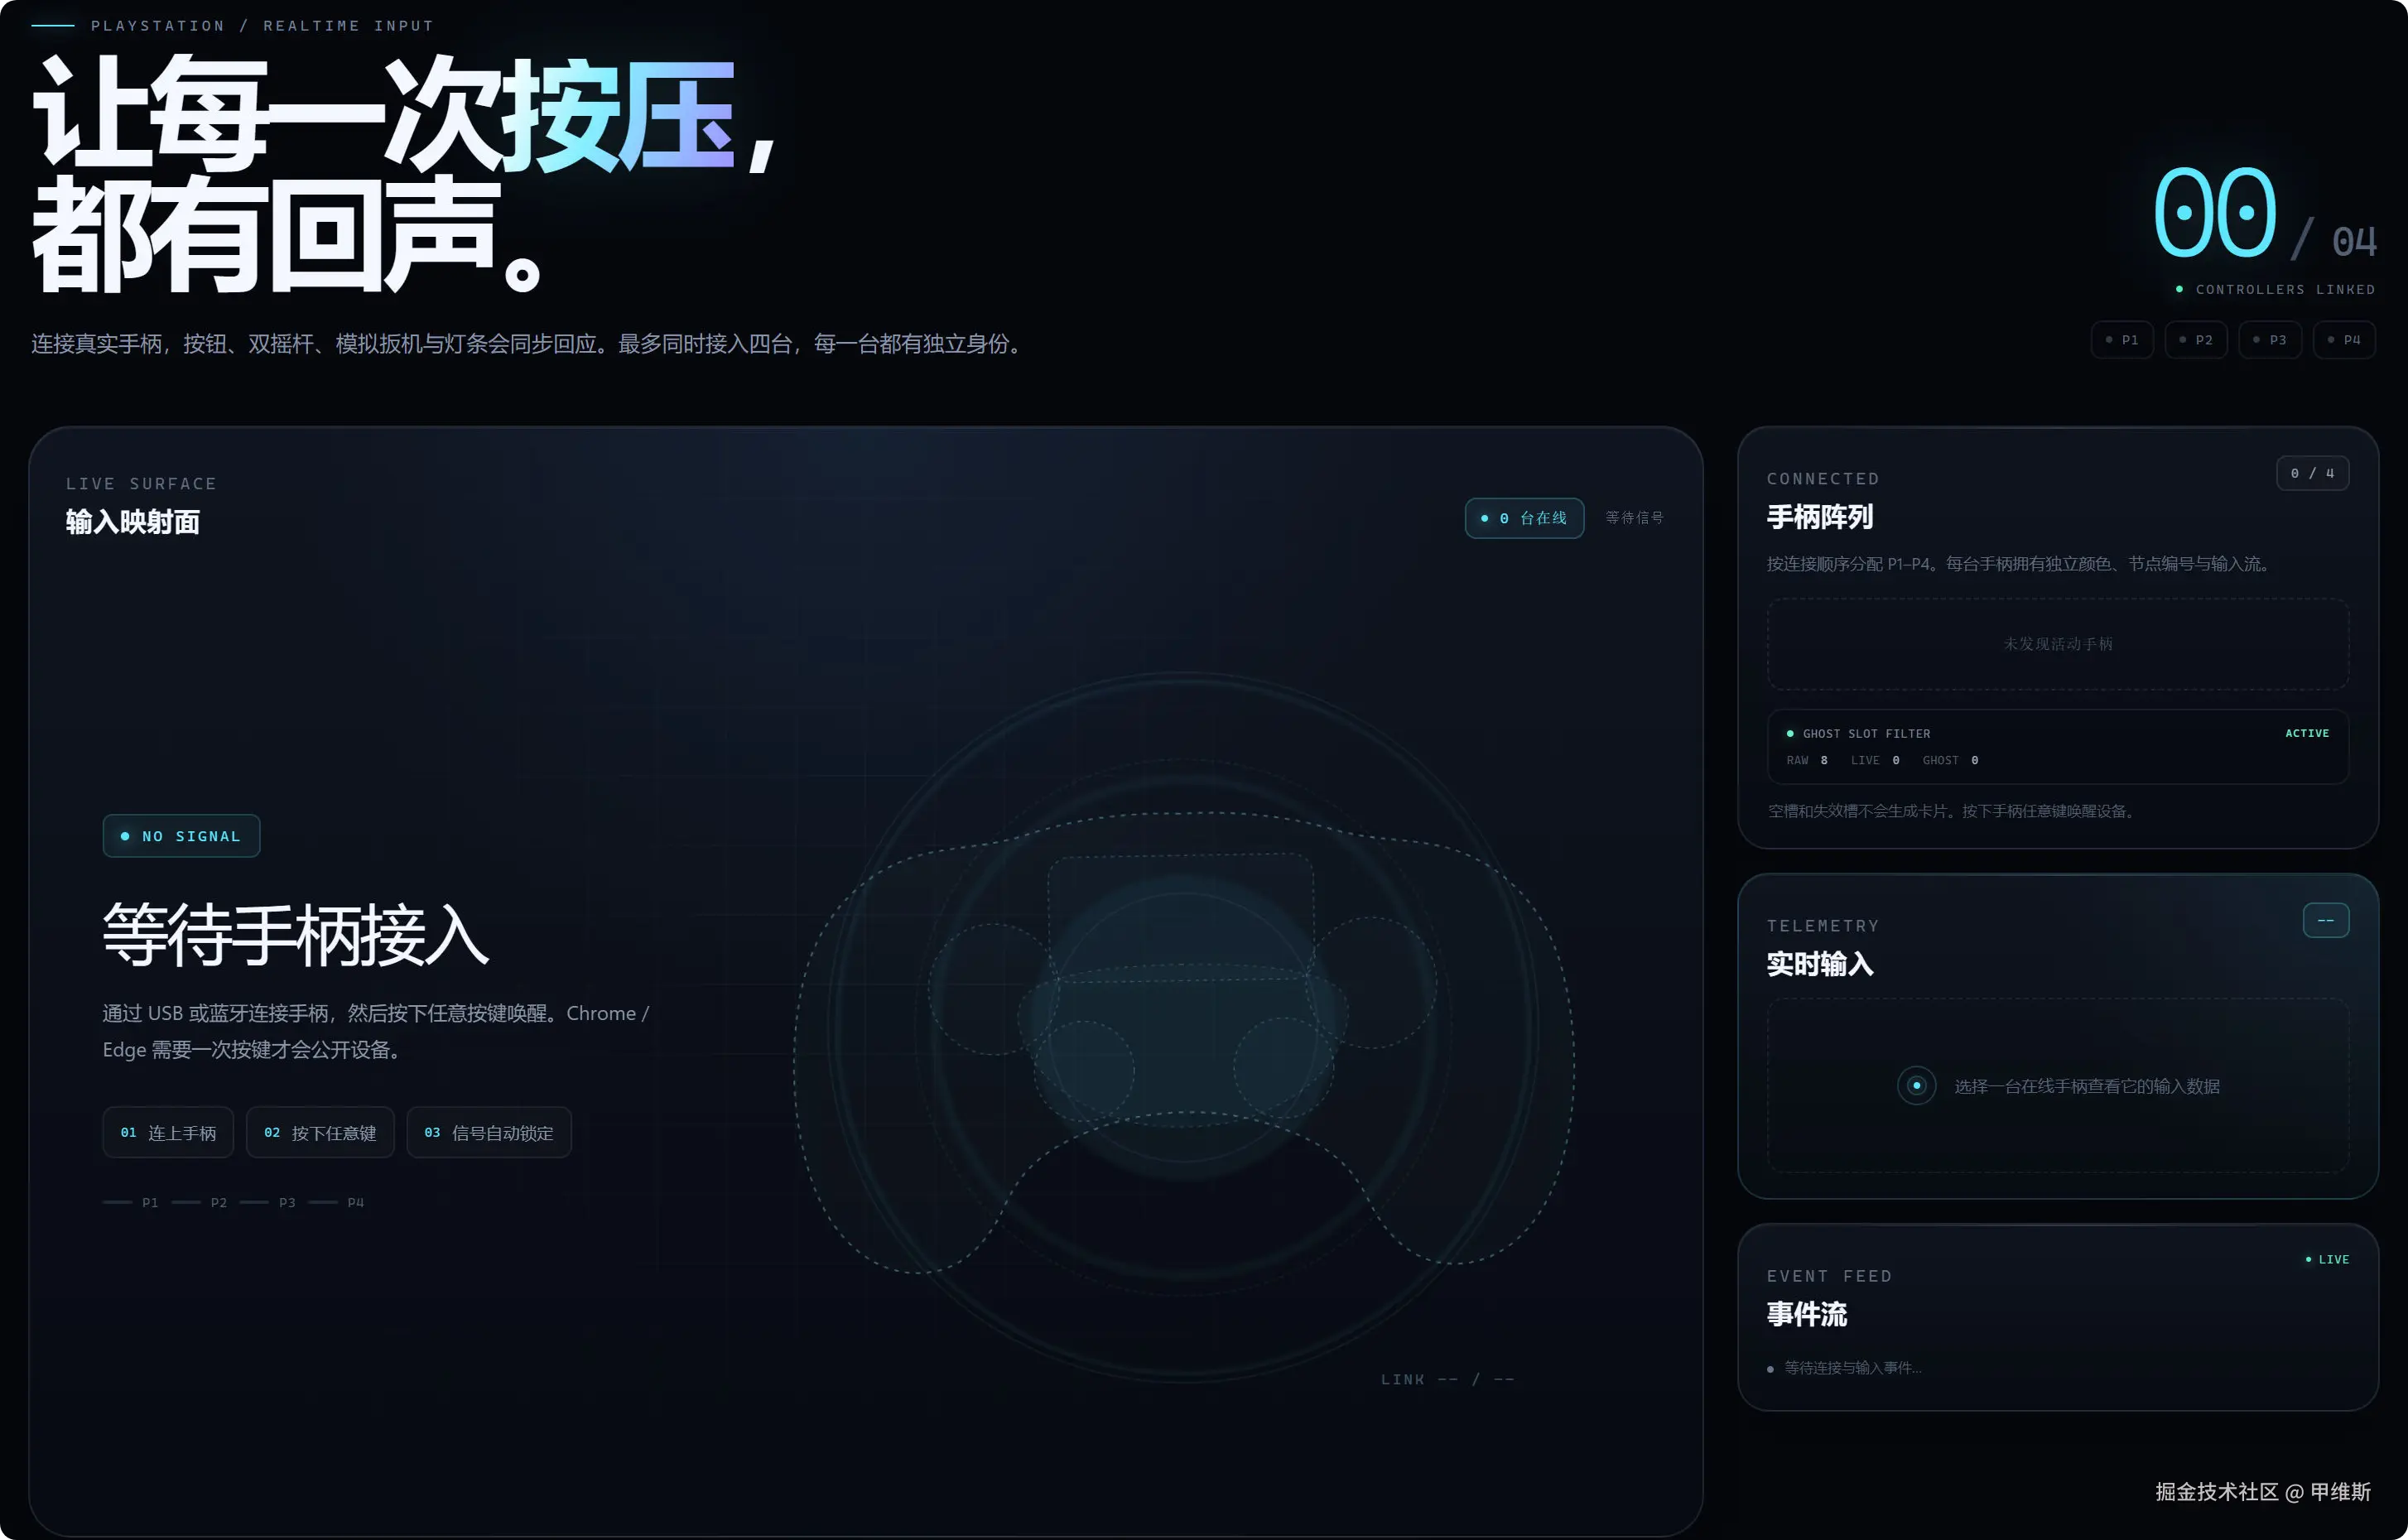
这是 DS 4.1 的一个结果。
看到这个页面风格吧,很像一个模型!
尤其是你们看这个标题的换行和间距。有种稳稳地兜住我的感觉!
不要误会啊,不是豆姐,豆姐也是学别人的。
当然,这只是我的一种感觉,可能就是殊途同归,也可能是偶然碰巧了。
总共有 25 份报告,我实在是没办法全部给大家展示,我的大脑都快宕机了。
虽然这个报告既不是工作,也不是任务,但我还是非常认真做的,都做到上火了,中途也是遇到了非常多的问题。
3、各种问题
刚开始有了一个想法,非常兴奋。到了实操环节就有点深陷泥潭的感觉。
中途遇到了非常多的问题,包括测试系统的问题啊,包括测试工具的问题啊,包括测试对象的问题啊。其中最大的一个问题是"概念问题"。
核心概念问题
就是大家有没有好奇一点,为什么 Gemini 和 Sonnet 成功了,而其他的 Flash 模型全部失败了?这个浏览器到底是如何管理这些手柄的?
其实这里最核心的是一个叫Gamepad的东西!
网页只能通过浏览器的 Gamepad API 读手柄,调用 navigator.getGamepads() 会返回一个数组。
这里有几个特性:
markdown
- 数组长度固定。Chrome 在 Windows 上实测是 8

- 每一格要么是 `null`(空位),要么是一个 Gamepad 对象,里面有 `index`(第几格)、`id`(设备名)、`connected`、`buttons`、`axes`、`timestamp`等字段

- 每调用一次,返回的都是一份新的快照,旧对象不会跟着刷新。所以页面要每帧重新调用一次。
我写上一篇文章的时候,就对三个数字产生了很大的好奇,它们分别是 8、6、4!
我也专门问了一下,这到底是什么意思!
| 数字 | 是什么 | 谁决定的 |
|---|---|---|
| 8 | 浏览器手柄列表的长度,可以理解为浏览器的"插口数" | 浏览器(Chrome),Windows 上实测是 8 |
| 6 | 一共接入的设备数:2 个 Keychron 接收器加 4 个手柄 | 由测试的实际硬件环境决定 |
| 4 | 页面上显示的"玩家槽位"P1--P4 | 题目要求最多四个手柄,由被测模型写的页面决定 |
这里还有个小问题:为什么我鼠标和键盘的接收器也被列在了里面?
分析如下:
ini
Keychron 的键盘/鼠标接收器会被 Windows 识别成 HID 游戏控制器,浏览器把它们也放进了这个列表。

它们的特点是:

显示为已连接(connected=true),设备名正常,比如 Keychron Link (Vendor: 3434 Product: d030);
永远不会有任何按键或摇杆输入;
而且先占掉 index 0 和 1。

所以场景 8 照真机布局复现:index 0、1 是两个接收器,index 2--5 是 4 个同名的 Xbox 手柄。
8 格里占了 6 格,剩下 2 格是空的。
为什么这个题目会这么难?关键就在这里!
因为这个队列里混入了两个"占着茅坑不拉屎的"。
我们页面上设计了 4 个手柄,相当于四个玩家,然后浏览器返回的是 6 个对象。
模型如果不够聪明,大概率只能匹配到两个手柄,另外两个是没法用的。
很多模型写代码的时候是不管这些的,它就是取了前面 4 个,绑定到了页面上的 4 个手柄。
这个时候,如果我用的是 3 号位手柄,那就能正常接入页面上的一个手柄。
如果我开了 5 号位手柄,那么它就没有绑定页面上任何一个手柄,自然也无法联动显示各种按钮效果了。
同样的问题,我也让 Claude Haiku5.5 和 GPT-6 Luna 做了,这两个模型也很便宜,甚至比上面的 Flash 都便宜,它们的结果也不是很理想,核心问题也是没搞对。 这就是Flash这一类模型的思维局限了!
由于它们不是在 OpenCode 中生成的,我就不比具体的分数了。我们还是关起门来,让国内选手友好交流比较好!
这个手柄的测试我也让 GLM 5.3 做了两轮。
从第一个测试结果来看,它可以正常绑定 4 个手柄,并且正常操控每个手柄,这一点比 Flash 确实厉害喽。
但是它采用的思维是,一个萝卜一个坑。
而 G4 和 Sonnet 它们采用了先到先得的逻辑。
这两种逻辑其实也是两个级别。
假设我们玩一个游戏需要两个手柄。
如果是事先锁死的情况,就是一号手柄对一号玩家,二号手柄对二号玩家,三号四号手柄对不上玩家。
而采用先到先得的逻辑的话:
1 号手柄先接入,就先匹配 1 号玩家,3 号手柄第二个接入,那就直接匹配 2 号玩家。
这样一来,你只要接入两个手柄就能玩游戏。
这个时候把 1 号和 3 号手柄断掉,把 2 号和 4 号手柄打开,它们就会自动绑定一号和二号玩家,照样可以正常玩游戏。
这大概是我的理解,你们有没有理解我的理解?
所以这个问题还是挺吃那个开发经验和实战经验的,老程序员一想到这个场景就知道会有什么问题,新程序员大概率就会遇到问题,一旦遇到这个问题就很难跳出来,除非你完整的了解了这个机制。
当然智商高能力强的人(模型),他是可以通过现象和测试分析出原因并制定解决方案的!
这个题目中有六种常见错误做法:
- 按 index 直接对应玩家座位;
- 只读列表前 4 位;
- 用设备名当身份;
- 保存旧快照反复读;
- 能认出幽灵设备,但不让它让出座位;
- 按名字去重、只留时间戳最新的那个。
这个经验,也是我和 Claude 反复讨论研究观摩总结出来的!
测试的问题
这次测试最难的不是测试对象的选择,而是测试本身!就是为了测好,花了很长的时间。
其中因为串行和并行的问题、思考强度的问题、输出长度的问题,多测了好多次。
串行和并行的问题特别浪费时间。
第一次为了图快,我是直接开的并行测试的,然后也没出错,但是就是跑了好一会儿没结果。
我怀疑会有互相影响,就只能用串行跑了一次。
串行跑的话时间就比较久了,每个模型给它一个小时的上限,5 个模型如果都跑满的话,就得 5 个小时。
有条件最好是用官方 API 一波撸了,我是有计划都用 API 接入 Claude Code 来测试,结果可能会更好一些。
这个技术方面是可以搞定,主要是和财力相关,容我三思!
思考强度的问题也花了一些时间。
我刚开始没想到这个问题,测到后来才想起来,我好像没有跟 Claude 强调过这个问题。
然后我就查了一下这些模型的思考等级:
| 模型 | 思考强度档位 |
|---|---|
| DeepSeek V4.1 Flash | low / high / max |
| MiniMax M3.1 Flash | low / medium / high / xhigh / max |
| GLM 5.3 Flash | low / high / max |
| Qwen3.8 Flash | low / medium / xhigh |
| MiMo V2.6 Flash | 无 |
| GLM-5.3 | low / high / max |
| Kimi K3 | none / low / high / max |
好难啊!
有的是有 5 档,有的是 3 档,有的是 4 档,有的是没有。
如果全部拉满,我又等不起。
所以我的逻辑就是选中间档。五档的就选第三档,三档的就选第二档。
重新把所有的模型再串行测几轮的话,我就快要吐了,所以我只刷新测了第五轮!
这个思考强度好像对 GLM 5.3 Flash 影响大一点,其他的和默认设置差不太多。
输出长度问题!
除了上面两个问题,我还遇到了这个输出长度的问题。
我本来呢是只打算测国产的 5 个 Flash 模型的。
但是呢,有朋友说,你是不是把 Kimi 忘了?3 个月前还是"小甜甜",可以直接"干翻"Fable ,即便现在在国内也应该很能打吧?
说实话,这个模型迭代速度这么快,现在能不能打,我真的不清楚!
所以只能测了才知道,那既然 要测K3 ,顺带把 GLM5.3 也测一下!
然后测 GLM5.3 的时候就遇到了"输出长度"的问题!
这家伙拿到问题之后就是雷霆大思考,很久不输出东西,一输出就超过 OpenCode 默认的输出长度了。
测了两次都在 8 分钟左右断掉了。后来一看是输出长度的问题,然后又测了一次。
整体结果吧,还不错,比如Flash强!
K3 的测试结果,我给大家留个悬念,你们可以猜一下,它大概排在哪里!
最后我申明一下:我这纯粹是业余测试,仅供参考! 能力时间财力都比较有限,没法做到特别严谨。
我只能保证我是很认真的在做这个事情,也是花了大量的时间和钱来做这个事情。
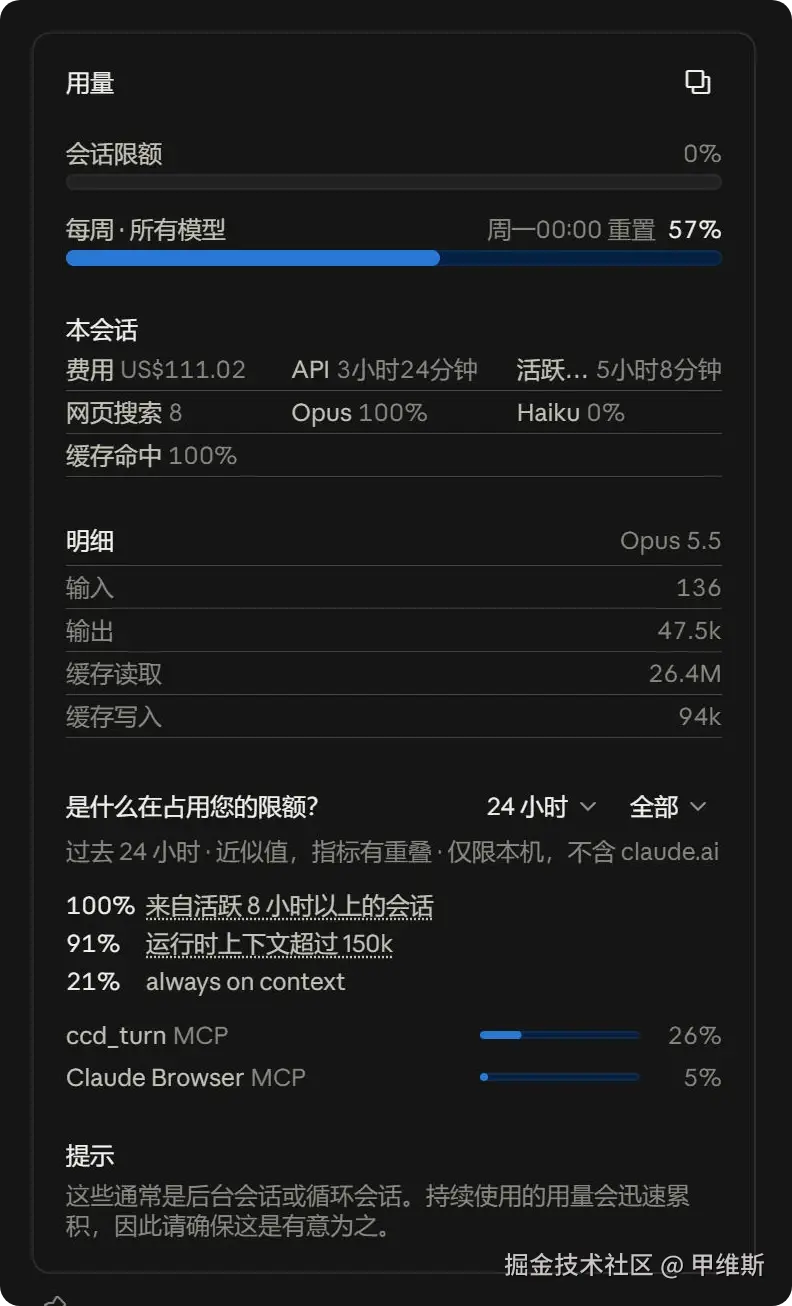
我看了一下我跟 Claude 的对话记录啊,单纯 Opus 5.5 的消耗就达到了 111 美元!
如果我不用 Opus 5.5 的话,这个测试周期可能还要长一倍。它在处理这些任务的时候,确实非常强。我可以同时给它三个任务,不需要切换窗口,它自动来管理。
比如说我一方面在串行测试 5 个模型,同时又可以让它帮我设计网页,帮我修改报告的样式,同时我还可以问它各种问题。甚至同时我还可以让它再做一个并行测试。这些任务都能在后台运行,该通知我的时候就会通知我,该做总结的时候就会做总结。
测试脚本,测评报告,网页制作,网站发布,后期的调整更新,全部一条龙搞定。
我根本不需要关心后面的细节,这种体验其他 Agent 很难做到!
哎呀,不说了不说了,说多了又让大家心痒痒,让有些人牙痒痒!哈哈哈
所有结果都已经上传了!
包括汇总页,具体每轮测试的记录和所有运行日志!
其实测完这个 Flash 模型之后,我就特别想测一下其他模型,但是一旦上升到 Pro 模型以及国外的模型的话,成本就非常高。我想想还是收手了,人生总是要有取舍嘛!
先把Flash搞清楚,也是挺好的。