TL;DR :让 AI 助手回答「这个函数为什么这么写」的问题,难点从来不是模型不够聪明,而是它够不着你那几百万行的仓库。把整个仓库塞进上下文?贵、慢、而且长上下文性能会衰减。爱立信研究院的 Code Comprehensor 给出一条工程化路线:离线 用 LLM 沿着调用图把仓库文档化一遍,再把文档「榨」成一个语义检索索引;在线 检索只要 50 毫秒,完整回答一个问题 3-5 秒。在 OpenCV 和一个 500 万行的电信私有库上,分层文档监督把文本找代码的 Top-1 命中率从 66% 抬到 80.6%。一句话:别让 LLM 每次都重新读仓库,让它读一次、记住、然后随叫随到。
论文信息
- 标题:Code Comprehensor: Hierarchical Documentation and Cross-Modal Retrieval for Large Repositories
- 作者:Sujoy Roychowdhury、Joseph H. R. Isaac、Jiangning Gao、Martin Klitte、Diarmuid Corcoran(爱立信 R&D)
- arXiv :2610.30016(2026-10-21,cs.SE)
- 评测对象:OpenCV(约 120 万行)+ 一个 500 万行的电信私有 C 代码库
老大难:为什么 LLM 读不了大仓库
每个在大厂维护过祖传代码的人都懂:理解一个巨型仓库,靠的是几个资深工程师脑子里那张「谁调用谁、谁依赖谁」的活地图。新人 onboarding、重构、影响分析,全都卡在这张地图的获取成本上。
大模型出现后,大家自然想:让 LLM 当这张地图不就行了?现实很快打脸,论文开头就把三盆冷水泼得很清楚:
- 装不下。现代模型上下文窗口看着很大,但代码仓库的 token 数往往远超窗口。论文里那个私有仓库,比公开统计里绝大多数知名 monorepo 还大。
- 装得下也白装。已经有不少实证研究(论文引了 2025 年的两篇)表明:上下文越长,检索完美的情况下性能照样衰减。「大海捞针」捞得到,不代表「大海理解」。
- 不可靠、不可复现 。仓库里到处是同名方法、相似文件。拿概率机器去回答「这个
process()是哪一个 process」,同一个问题问两遍可能得到不同答案------这在工程场景里是致命的。
已有的开源方案各有短板:RepoAgent 只管生成文档;CodeRetriever、CoCoSoDa 这类对比检索模型在孤立代码片段上训练,不理解方法之间的调用关系,而且没有 C/C++ 的公开实现;Google 今年发布的 Code Wiki 产品化做得早,但设计没公开。
思路:把「贵的一次性文档」变成「便宜的无限次检索」
Code Comprehensor 的核心洞察是一条成本套利:LLM 读仓库很贵,但这种贵只需要付一次。把这次昂贵产出的文档,变成一个可无限次廉价查询的检索索引,摊薄成本。
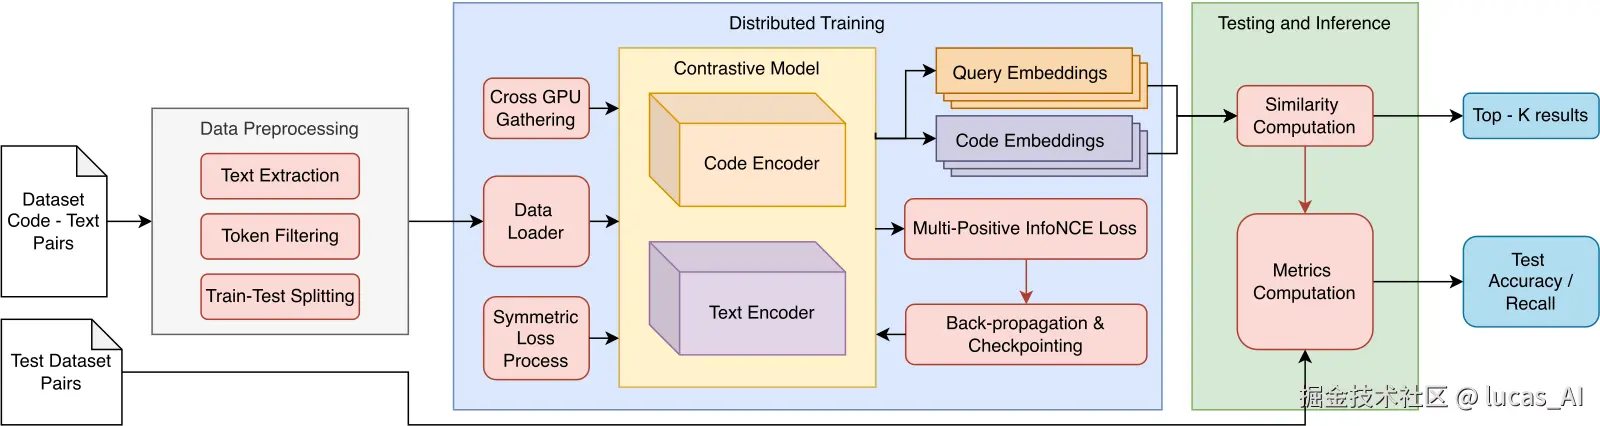
整个系统是三件套加一个编排层,看架构图:
CodeGraph:先给仓库画「地铁图」
静态分析走起:用 Tree-Sitter 解析所有代码文件,抽方法签名、注释、方法体,建出调用图。每个方法是图上一个节点,命名为 方法名:::文件名(面向对象语言再加行号,处理运算符重载的同名方法)。图存成 NetworkX 对象,再用 FastAPI 暴露 BFS/DFS/调用边正反向遍历接口------后面所有组件都通过这套 API 消费图结构。
CodeScribe:让 LLM 沿着调用图写文档
这是系统里最有「工程味」的部分。CodeScribe 按目录结构组织文档(开发者本来就按目录导航代码),每个目录可以配多个「章节视角」:代码描述、算法、数据流、接口。
生成流程:找到调用图里入度为零的起点方法(被外部系统直接调用的那些),对每个起点做 DFS 遍历拿到完整调用树,把树喂给 LLM 写文档。
问题来了:调用树经常大到超出上下文窗口。CodeScribe 的解法是递归后序分块 + 滚动摘要:
- 后序遍历,先把所有子节点处理完;
- 当前节点加上子节点的剩余块如果塞得进窗口,就合并;
- 塞不下,子块各自定稿,只留当前节点;
- 上一块的输出作为摘要滚进下一块的上下文。
效果是:LLM 写父方法文档时,虽然看不见全部子方法的源码,但手里有每个子树的功能摘要------相当于先让实习生读完整个模块写小结,再让架构师基于小结写综述。
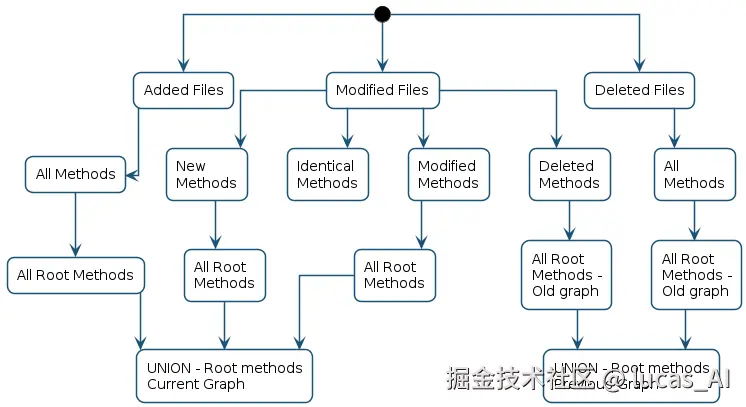
还有个容易被忽略但非常关键的细节:增量更新。CodeScribe 记录处理过的 git commit,新提交来了先定位改动的文件和方法,再顺着调用图反查受影响的起点方法,只重新生成这些方法的文档。这意味着文档化可以挂进 CI/CD 流水线按任意频率跑,不用每次全量重烧。
从 Markdown 到训练数据:把文档「榨」出结构
CodeScribe 的输出是模仿仓库目录结构的 Markdown 文件。接下来这条解析管线是我觉得整篇论文最「值钱」的部分:
- Markdown 转嵌套 JSON,标题层级变成 JSON 键;
- 代码块从正文剥离,分成三类:带方法名/路径元数据的真代码 、PlantUML 图 、无标注的伪代码;
- 利用文档的层级深度(1.2.3 式路径),给每个代码单元配上父上下文 (上层描述)、兄弟上下文 (同层方法的名与注释)、模块级注释------「一个代码单元、多种文本视图」的结构就出来了;
- 再用 LLM 批量生成开发者风格的合成问题:每个方法生成 3 条,硬性约束必须含行为动词锚点(validate/convert/decode 这类)、参数术语、领域术语各若干,禁止照抄代码、禁止带函数名(防词汇捷径泄漏)。
这套约束的用心之处在于防两个极端:既不让问题空洞得没法检索,也不让问题退化成关键词堆砌。
CodeContrast:CLIP 的老配方,代码检索的新用法
训练环节用的是 CLIP 同款双塔:一个编码器吃文本,一个吃代码,各自映射到同一向量空间做余弦相似度。backbone 用 SBERT 或 BERT,多卡训练走 PyTorch FSDP,可微 all-gather 把所有 GPU 的嵌入聚成全局相似度矩阵------等效于超大 batch,负样本管够。
损失函数是多正样本对称 InfoNCE:因为同一个方法对应多个文本视图(docstring、自注释、父/兄弟上下文、合成问题),这些视图与该方法的配对都算正样本,用 log-sum-exp 聚合。对称意思是文本找代码、代码找文本两个方向一起优化。
Master Agent:把三个组件串成会话
最终交互入口是一个 MCP 网关后面的编排 agent:用户提问 → CodeContrast 毫秒级检索定位相关代码 → CodeGraph 拉调用层级 → CodeScribe 的 RAG 取文档 → 组装成带图带码的回答。用户追问「解释一下这个文件」时走反向检索(代码找文本)。
数字说话:文档质量直接兑换成检索精度
论文在两个仓库上做了三层监督的消融(D1=只有 docstring,D2=加自注释,D3=再加父子/兄弟上下文和合成 QA):
| 仓库 | 配置 | 合成问题 Top-1(文本→代码) | 对比 |
|---|---|---|---|
| OpenCV | D2 | 66.05% | 基线 |
| OpenCV | D3 | 80.64% | +14.59pp |
| 私有库(5M LOC) | D2 | 67.46% | 基线 |
| 私有库(5M LOC) | D3 | 76.18% | +8.72pp |
更有意思的是反例:在人类写的注释(doc_brief_merged 类)上,D2 的 Top-1 到了 96.43%,反而比 D3 的 93.94% 高。也就是说,监督信号不是越丰富越好------如果用户的查询本来就贴近文档原文,加合成数据反而引入噪声。作者的务实建议:查询分布决定配置,文档搜索型场景用 D2,开放式开发者提问用 D3。
分查询类型看,收益最大的恰恰是最难的:跨方法、间接描述的合成问题(qa_doc_gen 57.39%→78.38%,qa_sibling 44.78%→63.93%)------父/兄弟上下文教的正是「这个方法和邻居们怎么协作」。
端到端评测用 RAGAS:忠实度 93-95 分(回答不瞎编),正确性 F1 只有 60-76 分(作者归因于 claim 少、指标敏感------这个解释见仁见智)。
成本账也算得透明:OpenCV(120 万行)文档化花 48 小时、3200 美元 API 费(Claude Sonnet 4.5);私有库 8 天、几千美元;CodeContrast 训练 4 张 A100 跑 24 小时。之后每次查询:检索 50 毫秒,全流程 3-5 秒。一次性投入换无限次查询,这笔账在企业场景是成立的。
实际用起来什么样
论文展示了 OpenCV Calib3d(三维标定)模块的输出:CodeScribe 生成的模块图把标定模块的子组件和每个组件的职责拆得一清二楚,信息密度比 Google Code Wiki 对应页面更高:
一个典型工作流:新人问「怎么做相机标定」,Master Agent 检索到相关方法,拉出调用层级和文档,回答里直接附上组件图和代码块;追问「这个文件里 cvCalibrateCamera2 和整体什么关系」,走代码找文本的反向检索,连带调用层级一起解释。资深工程师的经验,第一次变成可查询的基础设施。
泼冷水:四盆
- 语言泛化纯属声明。实验只有 C 和 C++ 两个仓库,同属系统编程域。Java/Python/Go 一个没测。论文自己承认这是「significant limitation」。小众语言在 LLM 训练分布里稀疏,文档化质量存疑------方法语言无关,实证不是。
- 消融缺口。D3 同时加了父子/兄弟上下文和合成 QA,两样各贡献多少?没有中间配置,归不了因。你抄作业时只能整包抄。
- 合成问题的同源偏差。文档是 Sonnet 4.5 写的,问题也是 Sonnet 4.0 造的,同一家模型的风格自洽可能让合成检索的收益虚高。换成真实用户的野路子提问,76-80% 的 Top-1 未必守得住。
- 成本门槛不低。3200 美元 + 48 小时 + 4×A100×24h 是 120 万行的价钱,5M 行翻几倍。中型团队要不要上,得先算查询频率值不值这笔一次性投入。
另外那个「正确性 F1 60-76 分」也值得盯一眼:忠实度高说明回答基于检索内容 ,不说明回答正确------检索对了、组织错了的可能性没有被排除干净。
理性看待
Code Comprehensor 没有发明任何单点新技术------调用图、递归文档化、CLIP 双塔、InfoNCE 都是现成的。它的价值在于把这条链焊死了:文档结构变成训练监督,监督变成检索精度,检索精度变成毫秒级问答,还配上了增量更新和成本清单。这是典型的「系统论文」:单点看都是常识,拼起来就是别家没有的东西。
对要做 repo 级编程助手、企业代码问答的团队,这篇论文的可抄作业清单其实很长:后序分块 + 滚动摘要驯服超大调用树;「一个代码单元对多文本视图」的多正样本监督结构;合成问题生成的术语锚点约束;按查询分布选配置而不是迷信单一榜单。就算不抄整套系统,「LLM 离线文档化 → 在线毫秒检索」这套成本套利思路,放到 API 文档、运维手册、法规库上照样成立。
上下文窗口还会继续变大,但「把仓库塞进窗口」和「让系统理解仓库」之间,可能永远隔着一个工程化的距离。这篇论文值得精读的,正是这段距离的修法。