一句话看懂
项目地址:github.com/Acelogic/Sn...
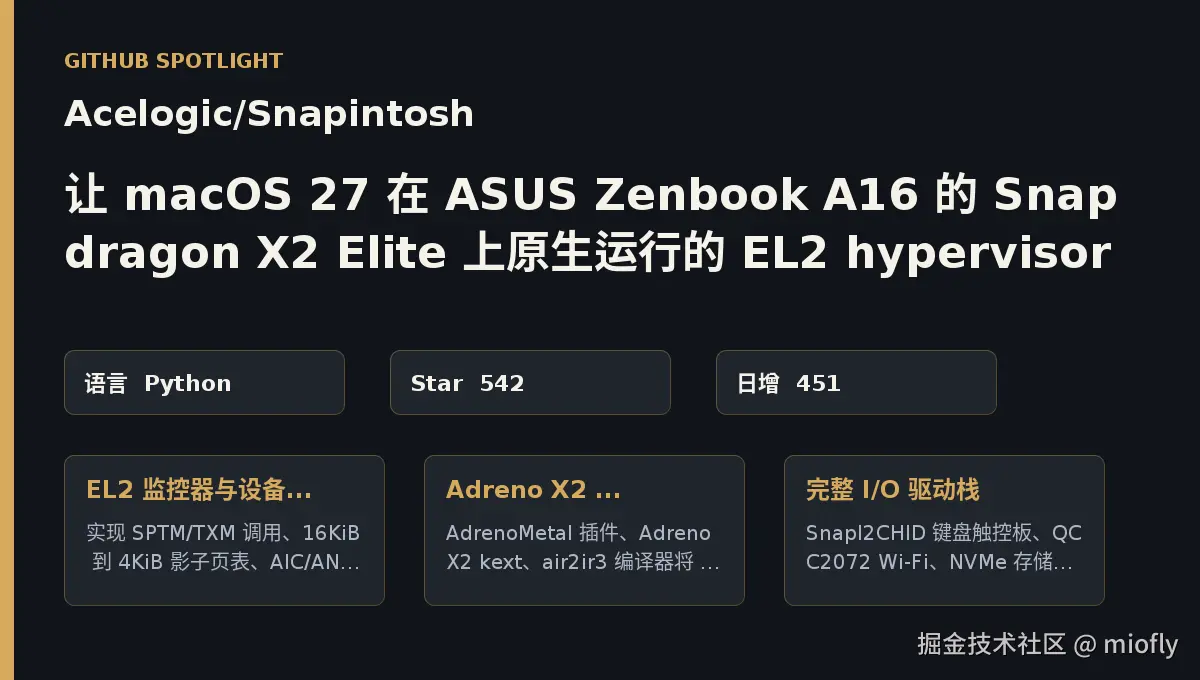
Snapintosh 让搭载高通 Snapdragon X2 Elite 芯片的华硕 Zenbook A16 跑起 macOS 27 桌面。它不是虚拟机,而是运行在 ARM EL2(CPU 特权等级中介于固件和操作系统之间的一层)的监控器,直接在裸机上接管硬件,把 Apple Silicon 平台的调用契约在非 Apple 芯片上重新实现,骗过未经修改的 macOS 内核。项目当日新增 451 星,目前共 542 星,Fork 32 次,主语言 Python,但核心代码以 C、Objective-C、C++、Assembly、Swift 为主。
它解决什么问题
macOS 只为 Apple 自家芯片编译,内核启动时会调用只存在于 Apple Silicon 上的底层接口,比如 SPTM(安全页表监视器)和 TXM(信任执行监视器)。普通 ARM 笔记本没有这些接口,内核一启动就会死机。Snapintosh 在 EL2 层伪造这些接口,让内核镜像以为仍运行在真正的 Apple 硬件上。
macOS 需要的存储控制器 ANS2、中断控制器 AIC、内存管理单元 DART 都是 Apple 自研模块,骁龙平台不存在对应硬件,Snapintosh 用软件模拟这些设备的寄存器行为。GPU 方面更棘手,macOS 图形渲染走 Metal,设备上的显卡是高通 Adreno X2,两者着色器指令集完全不同,项目为此写了运行时编译器,把 Metal 中间代码翻译成 Adreno 能执行的指令。
这个项目解决跨芯片架构的操作系统移植问题,在没有源码、不修改内核二进制的前提下,靠底层模拟层把一套硬件伪装成另一套。
核心概念速览
EL2 monitor:ARM 架构把 CPU 特权分成几个 Exception Level,EL2 通常跑虚拟化监控器。Snapintosh 的 monitor 介于固件代理 q1n1 和运行在 EL1 的 macOS 内核之间,拦截并响应内核发出的平台调用,向上呈现完整的 Apple Silicon 契约。
SPTM/TXM:负责内存安全和代码签名校验的子系统,正常由 Apple 芯片固件实现。Snapintosh 的 monitor 模拟这些调用的返回行为,让内核在做安全检查时拿到预期结果。
16 KiB 到 4 KiB 影子页表:XNU 内核按 16 KiB 为单位管理内存页,但骁龙 X2 的硬件 MMU 只认 4 KiB 页。shadow 目录的代码做页表翻译,把内核的 16 KiB 页映射转换成硬件实际认可的 4 KiB 页表项。
air2ir3:着色器编译器,把 Apple 的中间表示 AIR 转换成 Mesa 项目 ir3 后端认识的指令,ir3 后端是给 Adreno GPU 系列写的开源驱动组件。有了它,WindowServer 调用 Metal 画界面时,着色器才能在 Adreno X2 上跑起来。
架构拆解
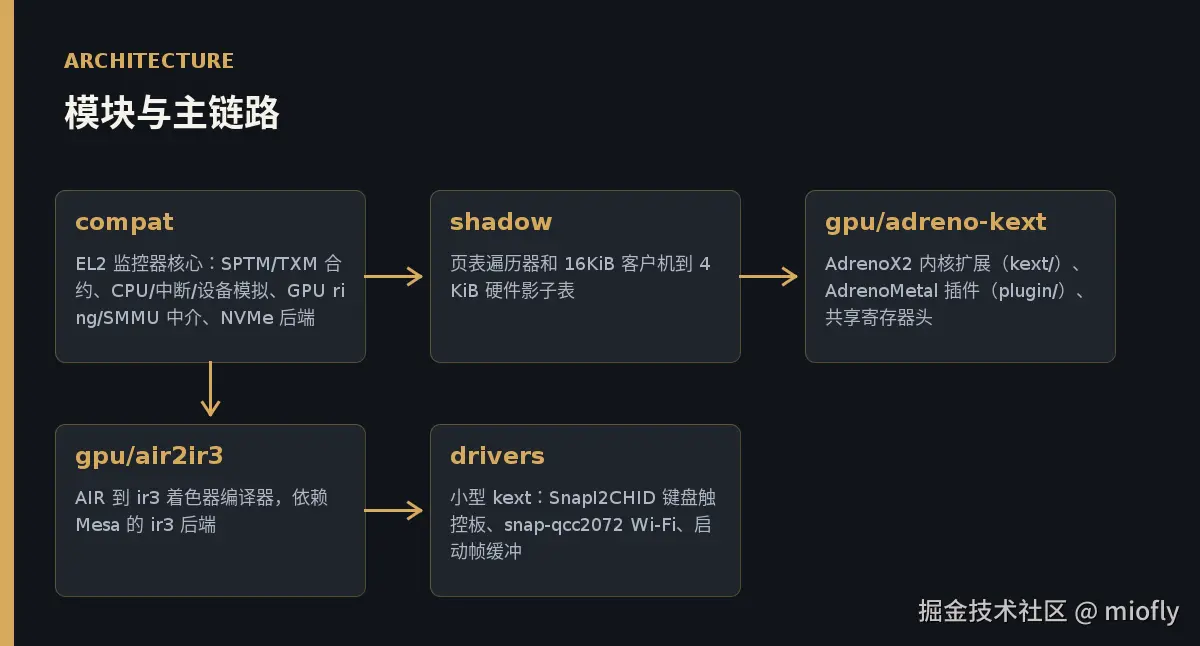
系统分五个模块:compat、shadow、gpu/adreno-kext、gpu/air2ir3、drivers。
compat 是监控器核心,实现 SPTM/TXM 调用契约、CPU 和中断模拟、设备模型,还要在 GPU 指令环和 SMMU 映射之间做中介,同时提供 NVMe 存储后端支持。
shadow 单独处理页表翻译,页表遍历器要正确处理内核各种粒度的内存映射请求,再落到硬件认可的 4 KiB 页表项。
gpu/adreno-kext 放了两块代码,kext 子目录是内核扩展 AdrenoX2,plugin 子目录是用户空间加载的 AdrenoMetal.bundle,两者分别负责内核态和用户态的 GPU 操作。
gpu/air2ir3 是独立编译器工程,依赖 Mesa 的 ir3 后端完成最终指令生成,靠编译产物对接。
drivers 目录是几个体量较小的 kext,SnapI2CHID 管键盘触控板,snap-qcc2072 管 Wi-Fi 芯片,还有一个启动阶段的帧缓冲驱动。
调用链是:固件把机器切到 EL2,q1n1(Asahi Linux m1n1 代理协议的 fork 版本)接管这一层,通过 USB-C 的 NCM 网络协议和 Mac 主机通信。Mac 主机上的 cycle.py 把编译好的监控器镜像传过去,monitor 启动后调用影子页表模块做地址翻译,同时中介 GPU 指令提交,转发给 AdrenoX2 kext,kext 再和用户态的 AdrenoMetal.bundle 配合,后者调用 air2ir3 完成着色器编译。
关键实现走读
看两段代码,SPTM 类型转换和 GPU 参数校验,对应监控器的两个核心职责。
第一段来自 compat/sptm.c:
c
int sptm_mac_apple_retype(uint64_t old_type,uint64_t new_type)
{
    static const uint64_t words[48]={
        [11]=0x8000042ee3f7c802UL,[14]=0x800,[15]=0x800,[16]=0x800,[17]=0x800,
        [18]=0x80800,[19]=0x800,[20]=0x800,[21]=0x800,[24]=0x800,[25]=0x800,
        [32]=0x800,[33]=0x800,[34]=0x800,[35]=0x800000800UL,[37]=0x800,[41]=0x800,
        [42]=0x1802000000000000UL};
    return old_type<48 && new_type<64 && ((words[old_type]>>new_type)&1);
}
这是内存页类型转换的合法性检查。XNU 内核给每一页标注类型(内核专用、用户可写、设备映射等),转换类型前要先问 SPTM 是否允许。这里用位图表示所有合法转换路径,old_type 是行索引,new_type 是列索引,查表取一个比特就知道允许不允许。表里的数字是从真实 Apple 芯片的 SPTM 固件行为逆向推导出来的。用位运算查表而不是写一长串 if-else,是性能和代码体积的权衡。没有它,内核做内存保护升级或降级操作时会立刻被拒绝,整个启动流程会在内存初始化阶段卡死。
第二段来自 compat/adreno.c:
c
int adreno_adopt(const struct adreno_ops *o, const struct adreno_params *p,
                 struct adreno_state *s, uint64_t mem_low, uint64_t mem_high)
{
    if (s->quiesce) return ADRENO_E_PARAMS;
    uint64_t end = p->arena_base + p->arena_size, root = p->cb0_ttbr0 & ADRENO_PTE_ADDR;
    const uint64_t in[4][2] = {{p->pool_pa, ADRENO_POOL_BYTES}, {p->ring_pa, p->ring_dwords * 4},
                               {p->fence_pa, 4}, {root, 0x1000}};
    int e = ADRENO_E_PARAMS;
    if ((p->flags & ~(uint64_t)ADRENO_F_ALL) || !(p->flags & ADRENO_F_ENABLE) ||
        (p->gicd & 0xffff) || !p->arena_base || ((p->arena_base | p->arena_size | p->pool_pa) & 0xfff) ||
        end < p->arena_base || (p->arena_base < mem_high && mem_low < end) ||
        (p->fence_pa & 3) || (p->fence_va >> 30) || p->ring_wptr >= p->ring_dwords || p->ring_dwords > 0x2000 ||
        (root >= p->pool_pa && root < p->pool_pa + ADRENO_POOL_BYTES))
        goto out;
这是 GPU 初始化时的参数校验。adreno_adopt 在接手 GPU 控制权之前,确认传入的内存布局参数正确,内存池地址、指令环大小、fence 同步槽地址、页表根地址,每一项都要检查对齐、范围和相互重叠。GPU 操作物理内存地址,一旦某个地址算错或和已有内存区域重叠,轻则渲染花屏,重则写坏内核数据导致系统崩溃。这里把所有检查条件压缩进一个 if 判断,arena 结束地址不能小于起始地址,fence 地址必须 4 字节对齐,ring 队列不能超过 0x2000 大小,页表根地址不能落在内存池区间内。如果跳过检查直接初始化 GPU,上层传入参数有误时 GPU 就会按错误地址读写显存,结果是画面错乱或整机死机。
动手上手
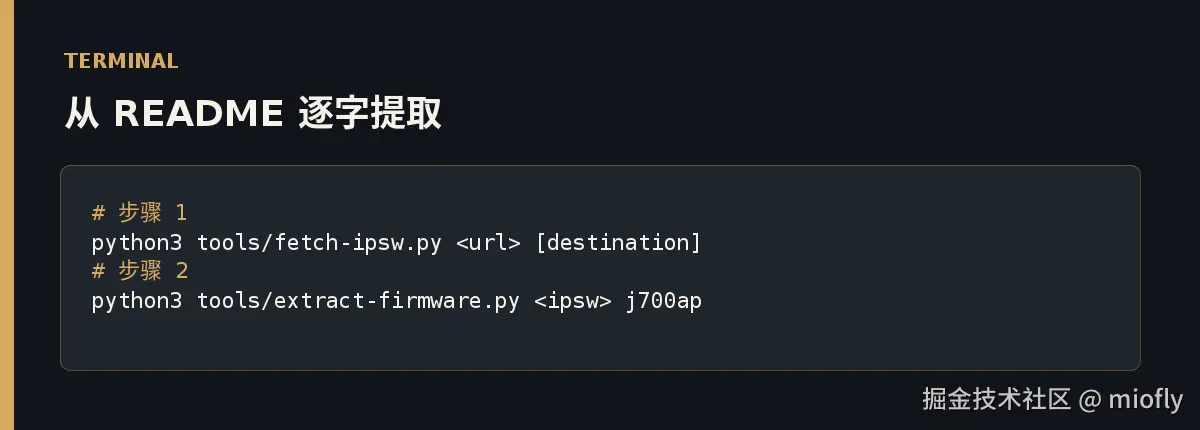
项目本身不提供可直接运行的二进制,固件和系统镜像需要用户自己准备。README 给出的前置步骤是下载 IPSW 固件包并解包:
bash
python3 tools/fetch-ipsw.py <url> [destination]
python3 tools/extract-firmware.py <ipsw> j700ap
第一条命令从指定链接下载 IPSW 镜像包,第二条命令从 IPSW 里把 j700ap 设备标识对应的固件组件抽取出来,J700 是该机型对应的内部代号。
接下来搭建 GPU 编译器开发环境,air2ir3 依赖 Mesa 的 ir3 后端,需要 Homebrew 安装 LLVM、Meson、Ninja 工具链,再用项目自带的 mesa-setup.sh 拉取并打补丁 Mesa 源码。
完整的开机流程还需要 Mac 主机通过 USB-C 连接 A16 笔记本,由 q1n1 建立 USB NCM 网络链路,再用 tools/cycle.py 把编译好的监控器和 kext 上传到设备。
应用场景
第一类场景是在 A16 上启动 macOS 桌面。操作方式是用 Mac 主机通过 USB-C 连接设备,cycle.py 上传监控器和各个 kext,q1n1 负责把 XNU 内核启动起来。这条路径目前能跑到桌面并且 GPU 加速生效,但交互谈不上流畅,而且必须接 AC 电源。
第二类场景是研究 Apple Silicon 的兼容性。研究者可以观察 SPTM/TXM 契约具体是怎么被模拟出来的,以及各驱动模块的实际行为,用来理解 Apple 平台底层机制。这套环境仅限于这一台特定型号硬件。
第三类场景是调试 Metal 着色器的跨平台编译。air2ir3 在运行时把 AIR 中间代码翻译成 Mesa ir3 后端认识的指令,适合研究图形编译器实现的人参考。
独立分析
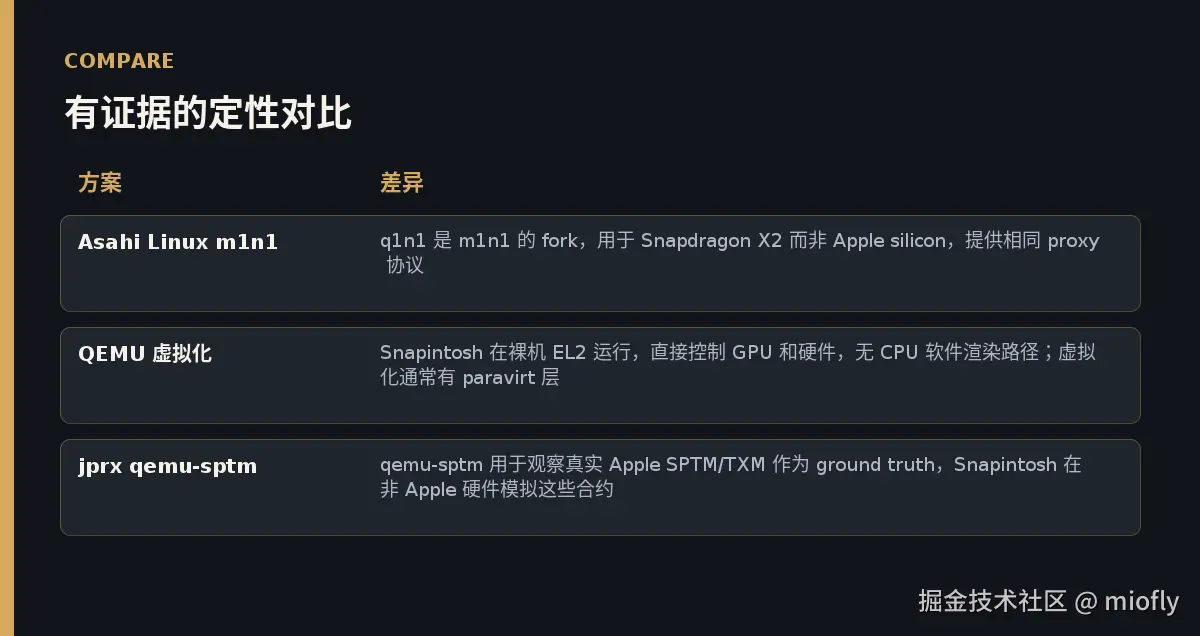
这个项目值得关注的地方在于它选择的实现路径,在裸机 EL2 层直接接管硬件,而不是走虚拟化中间层。对比常见的 QEMU 虚拟化方案,Snapintosh 没有 CPU 软件渲染这条退路,GPU 加速完全依赖对 Adreno X2 硬件寄存器的直接操作,调试难度明显更高,但换来的是真机性能而不是虚拟化损耗。
跟 Asahi Linux 的 m1n1 比较会更有意思。q1n1 本身就是 m1n1 的 fork,提供同样的 proxy 协议,但服务对象从 Apple Silicon 变成了骁龙 X2,说明底层调试代理协议本身具备跨芯片移植的可能性。项目还提到参考了 jprx 的 qemu-sptm 工程来获取真实 SPTM/TXM 行为的 ground truth,这是典型的逆向工程方法,先在受控环境观察真实硬件的响应,再在目标硬件上重建同样的响应。
当日新增 451 星对一个刚创建没几天、仅支持单一型号笔记本的实验性项目来说是相当高的关注度,这背后大概率是硬件改机和黑苹果社区的传统关注力在起作用。
局限与风险
硬件适配范围极窄,只支持华硕 Zenbook A16 这一个具体型号,X2E-96-100,寄存器地址和时钟参数都是针对这台机器专门调校的。
功能缺口不小,音频、摄像头、蓝牙、睡眠、外接显示这几项都还没实现,目前只能当一台没有声音也不能休眠的桌面机使用。
交互流畅度没有达到稳定的目标帧率,README 和状态文档都提到桌面能跑、GPU 加速能跑,但流畅度还在打磨阶段。
启动方式依赖外部设备,必须有一台 Mac 主机通过 USB-C 连接才能把监控器和内核传上去,没有独立引导能力。
项目本身不含任何 Apple、高通、华硕的固件和系统镜像,用户需要自己从正规渠道获取 IPSW 文件和设备固件,这一步法律和合规风险需要使用者自己把握。
结论卡片
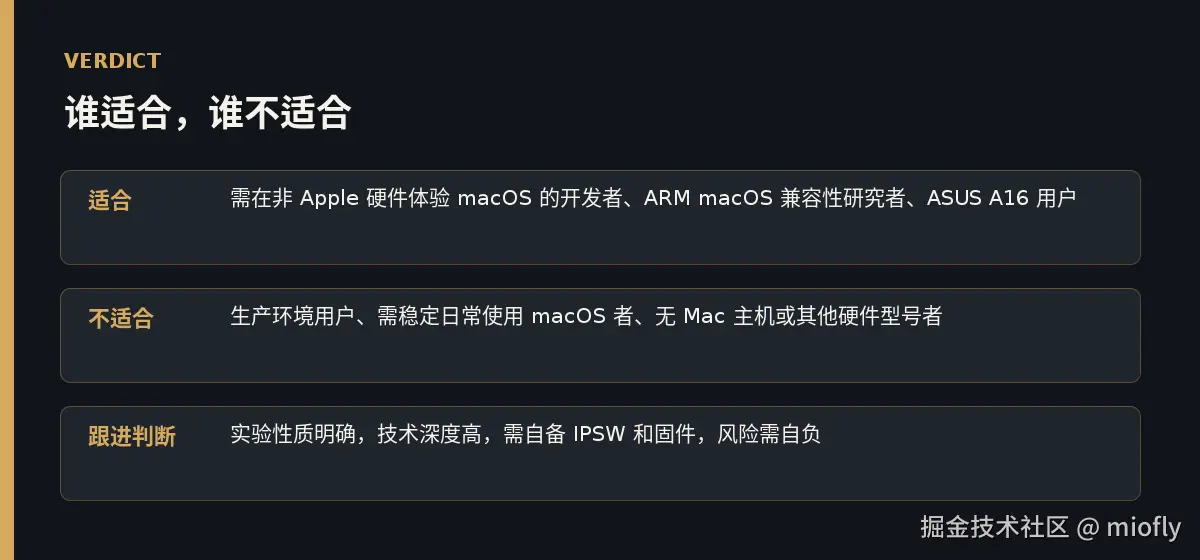
适合谁:对 ARM 架构下的 macOS 兼容性感兴趣的研究者,愿意折腾实验性硬件项目的技术爱好者,刚好手头有这台特定型号华硕笔记本的人。
不适合谁:需要稳定日常使用 macOS 的用户,生产环境场景,没有 Mac 主机或者用的是其他型号硬件的人。
跟进建议:这是一个技术深度很高但受众很窄的实验项目,需要自备 IPSW 和固件才能跑,功能还有明显缺口,适合先看 docs/STATUS.md 了解当前实现到哪一步,再决定是否投入时间配置环境。
项目地址:github.com/Acelogic/Sn...
原文地址:tools.wflynn.cn/aitools/git...
关注公众号「YourTools」,每天推送 GitHub 趋势与开源工具速报: