华夏银行在明道云(HAP 超级应用平台)的分享中提到了定时任务性能问题,计算运行日志里的峰值并发,可以把每次执行拆成开始和结束两个事件,按时间扫描累计。这里用JavaScript演示一个只读区间数组的函数,明确同一时刻先结束再开始;它回答"最多有几次执行重叠",不估计服务器容量,也不是华夏银行或HAP运行日志的实测分析。
案例速览 企业:华夏银行;角色:客户自建,总行建设和管理平台。 平台:明道云(HAP 超级应用平台),行内称为"i助手"。 分享人:易永丰,时任信息科技部副总经理;场合:明道云伙伴大会2023。 本篇取材:推广后出现性能问题,随后补充搭建规范、准入投产变更审核及增长预估;来自本地字幕12:11---13:13的转述。 证据边界:公开分享支持问题背景,不证明下文模型已经在该行实施;不采用客户成效数字,不引用未核音轨的原话。
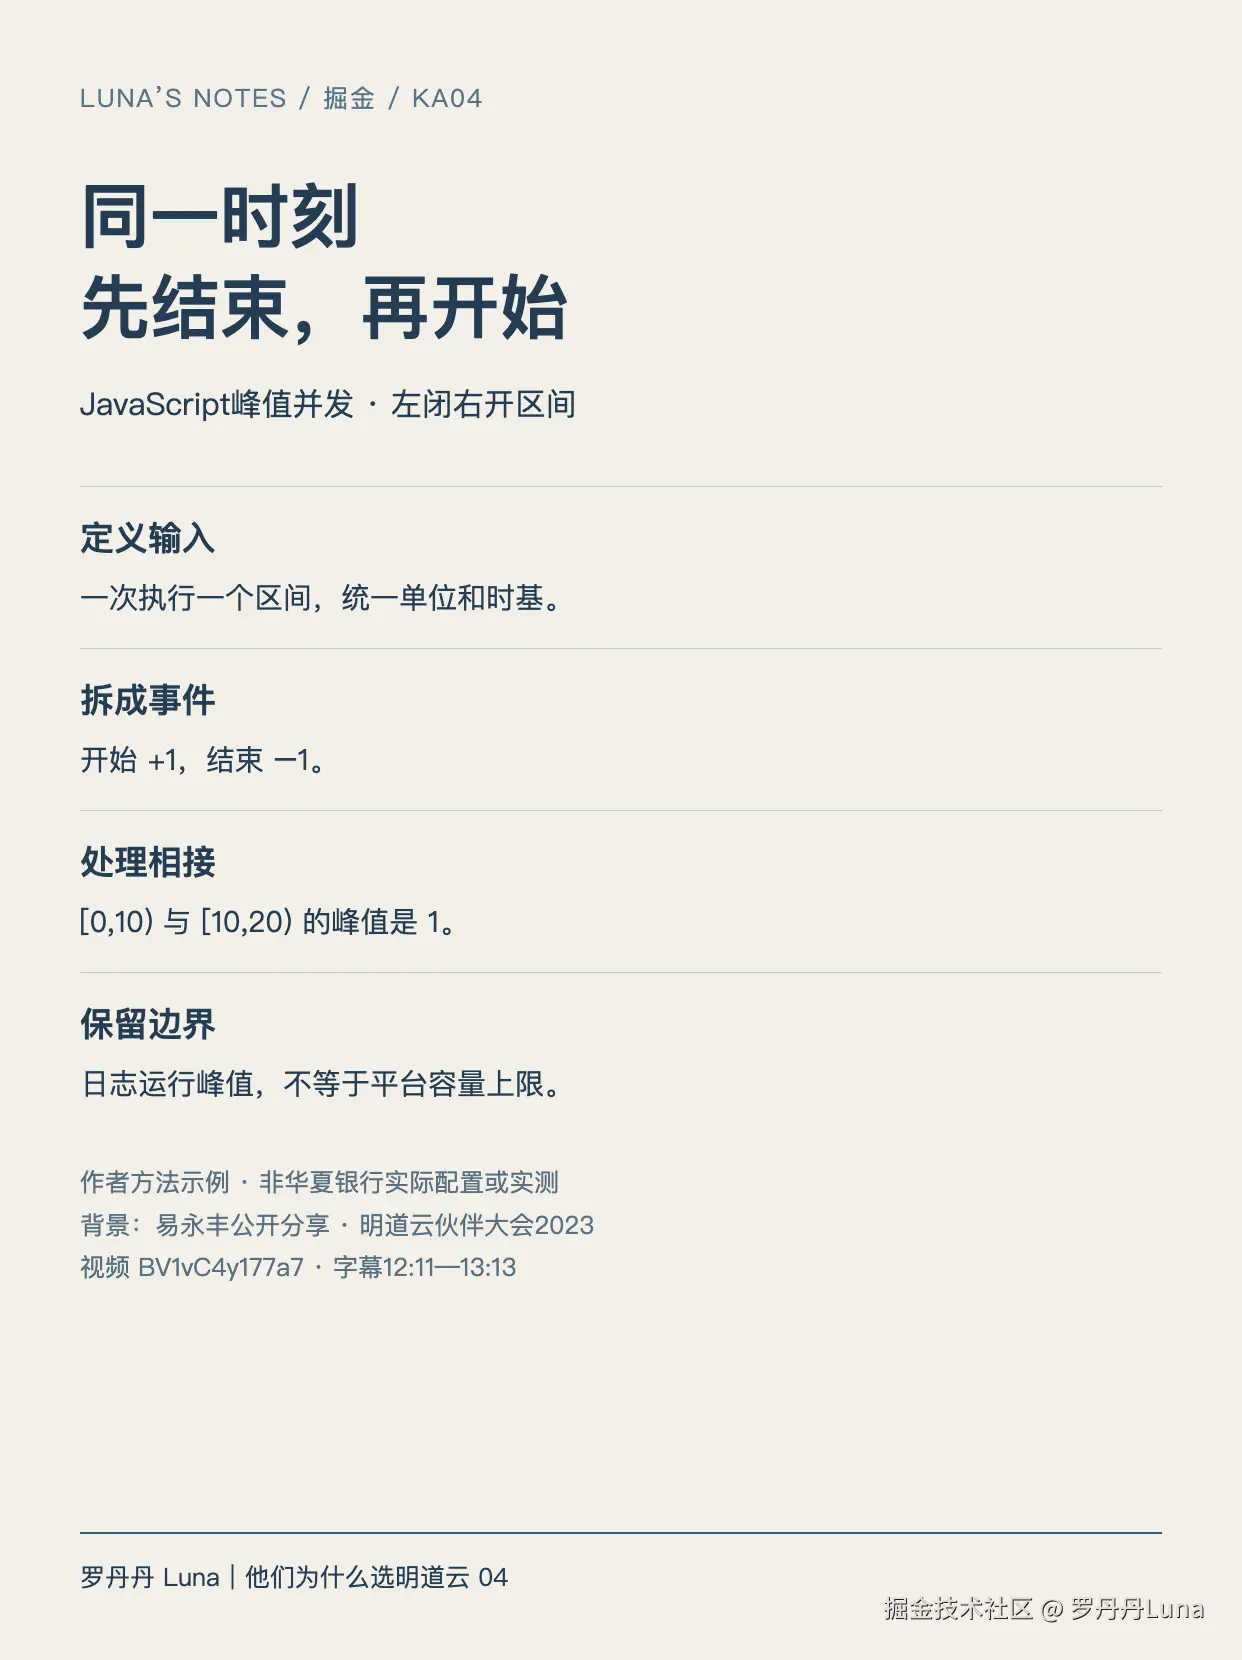
图:执行区间边界与事件扫描。作者方法示例,非华夏银行实际配置或实测;要点亦见正文。
两个任务碰到同一时刻,算不算重叠
我把案例里的运行问题拆成一个可以复算的小问题。假设日志里有两次执行:A从零秒运行到十秒,B从十秒运行到二十秒。它们在时间轴上接在一起。如果统计程序在十秒时先加一、后减一,就会凭空得到一个瞬时并发二。
这个例子是人工构造的,不来自银行日志。先把这种边界说清楚,后面的图表才不会每次刷新都换一种解释。
**峰值并发是选定统计范围内、同一时刻处于运行状态的执行实例数量的最大值。**本文采用左闭右开区间,也就是[start, end):开始时刻计入,结束时刻不计入。相邻但不重叠的执行因此只算一个并发。
输入里的每一项代表一次执行,不是一个任务名称。同一个任务重复运行三次,就有三个区间。函数不根据名称去重,否则恰好会丢掉想观察的同任务重叠。
先约定输入,别在函数里猜时间格式
函数只接受有限数值表示的开始和结束时刻,并要求结束大于开始。可以统一用相对秒数,也可以统一用毫秒时间戳,但不能混用。演示使用相对秒数,避免日期格式与时区掩盖核心问题。
字符串、缺少结束时刻、零时长和逆序区间都拒绝。零时长也可以设计成忽略,但那是另一份数据契约;这里选择让调用者先检查日志精度或异常记录,不悄悄改数据。
仍在运行的任务尤其要小心。没有end并不意味着运行已经结束。如果要分析一个截至某时刻的窗口,可以在独立的数据准备阶段按明确规则截断,并记录这是截断区间。本文函数不自动用当前时间补齐,保证相同输入有相同结果。
JavaScript用事件扫描计算峰值并发
每个区间生成两个事件:开始加一,结束减一。先按时刻升序排序,时刻相同时让负一排在正一前面。随后沿时间轴累计当前运行数,保存遇到的最大值。
javascript
function peakConcurrency(intervals) {
  if (!Array.isArray(intervals)) throw new TypeError("expected array");
  const events = [];
  for (const item of intervals) {
    if (item === null || typeof item !== "object") {
      throw new TypeError("expected interval object");
    }
    const { start, end } = item;
    if (!Number.isFinite(start) || !Number.isFinite(end) || end <= start) {
      throw new RangeError("require finite start < end");
    }
    events.push([start, 1], [end, -1]);
  }
  // 同一时刻先结束再开始,区间为 [start, end)。
  events.sort((a, b) => a[0] - b[0] || a[1] - b[1]);
  let active = 0;
  let peak = 0;
  for (const [, delta] of events) {
    active += delta;
    peak = Math.max(peak, active);
  }
  return peak;
}

const sample = [
  { start: 0, end: 10 },
  { start: 10, end: 20 },
  { start: 5, end: 15 }
];
console.log(peakConcurrency(sample)); // 2
在这个人工例子里,零到五秒只有一个任务;五到十秒有两个;十到十五秒仍有两个;十五到二十秒回到一个。十秒时先结束第一项,再开始第二项,计数不会短暂升到三。
排序只修改新建的events数组,不修改调用者传进来的intervals及其对象。这样同一份输入还可以交给别的分析函数,不会因为本次统计改变原始顺序。
MDN说明Array.prototype.sort会原地排序,数字排序需要提供比较函数;这里使用数值比较,第二级比较处理同一时间的结束与开始。Array.prototype.sort文档,访问2026-10-22。
函数为n个区间建立2n个事件,额外事件数组规模随输入线性增长。排序通常是主要成本,但JavaScript标准库不承诺sort在所有实现上的具体时间与空间复杂度;不能据此声称任意大日志都能在浏览器里瞬间完成。
用最容易算错的样例验证
只测一次三个区间的正常例子不够。可以把下面这组人工数据放进本地测试,先用手画时间线,再和函数输出比较。
| 输入关系 | 预期峰值 | 为什么 |
|---|---|---|
| 空数组 | 0 | 没有执行 |
| 两个首尾相接区间 | 1 | 结束时刻不计入 |
| 三个完全相同区间 | 3 | 三次执行都要计数 |
| 一个长区间包住两个相邻短区间 | 2 | 短区间相接处不额外重叠 |
| 三个区间部分交叠 | 由时间线确定 | 不能只比较开始时刻 |
| 缺失结束时刻或字符串数字 | 抛错 | 不隐式猜测输入含义 |
还应检查输入是否保持不变。测试前保存序列化结果,调用后再次序列化比较即可;生产日志含更复杂对象时可以采用更严格的不可变检查。本文配套测试只使用没有隐私的人工对象。
这些测试证明的是函数遵守这份区间契约,不证明日志完整。若日志丢失了慢任务,计算结果仍可能偏低。若重复采集了同一次执行,则可能偏高。应该用执行实例标识在上游排查采集问题,不能为了让数值好看随意去掉重叠项。
算出来之后,怎样避免误读结果
我最想保留的边界是:运行并发与资源饱和不是同一个指标。十个等待外部服务的任务,与十个正在密集计算的任务,可能有相同并发数,资源表现却不同。
这个函数也不统计排队。start应当是实际开始执行的时刻;若把计划触发时刻填进start,算出的就是另一种含等待过程的区间。两种口径都可能有分析价值,但不能混在一起比较。
多个执行节点的时钟偏差、日志时间精度和观察窗口都会影响边界。本文把这些问题留在数据准备阶段,由采集者说明条件,函数只做明确输入上的运算。不要把一个纯函数包装成完整监控系统。
可以收藏这张"运行区间分析前检查单":
- 一项数据代表一次执行,重复采集与重复运行能分清。
- 所有时刻使用同一单位、同一时基;start是实际启动时间。
- 缺失结束时刻单独处理,窗口截断规则写在报告里。
- 统一采用[start, end),并验证同一时刻先结束后开始。
- 输出同时注明采样范围与日志完整性;不把峰值并发当容量上限。
常见问题
为什么不直接数每一分钟启动了多少任务?
启动次数是流量,运行并发是某一时刻仍在执行的数量。一个持续跨越多分钟的任务,在后续分钟没有新启动事件,但仍占一个运行位置。
需要返回峰值发生的时段怎么办?
本文只返回峰值数量。如果要返回持续时段,应把同一时刻的变化聚合后,记录到下一个事件之间的区间,再处理多个并列峰值段;不要把扫描中间的瞬时计数直接当一个持续时段。
可以直接放进HAP代码块运行吗?
本文没有验证具体HAP代码块的输入输出约定或运行限制。先在本地验证算法;需要接入时,再由技术人员按照实际环境适配。它不调用API、不读取线上日志,也不改变任务频率。
来源与说明
- 易永丰《春芽结硕果,点滴汇洪流》,明道云伙伴大会2023:公开视频。本文转述依据本地AI字幕12:11---13:13,未重新核对音轨。
- 大会官方回顾,页面更新2023-11-09,核对分享人、职务和活动;访问2026-10-22。
- 华夏银行官方案例,页面更新2024-05-22,核对总行搭台与i助手背景;访问2026-10-22。该页开头与成果段的人才数字分类不一致,本文不使用,也不与2023年演讲数字拼接。
作者罗丹丹 Luna 在明道云工作,本文基于公开资料讨论技术方法,不代表参与华夏银行项目交付。本文使用AI辅助整理与示例编写,发布前由作者审阅。
你更容易遇到哪种日志问题:结束时刻缺失,还是同一次执行被重复采集?