一、每个程序员都有一个死去的笔记库
我的 Notion 里有 300 多条笔记,上次打开是 8 个月前。
不是懒,是因为维护成本太高------写进去容易,要用的时候根本找不到;找到了,已经和现在的认知脱节了;想更新,得重新整理结构。恶性循环,最后彻底放弃。
直到我看到 Andrej Karpathy 分享的一个框架,才想通了问题所在:
传统知识库让你「存」,但没人帮你「维护」。
解法:让 LLM 来做那个维护知识库的人。
二、核心理念:LLM 是维护者,不是检索器
大多数人用 AI + 知识库的姿势是这样的:
塞一堆文档进去 → 问 AI 问题 → AI 去检索 → 给你答案这个模式的问题:每次都从原始文档检索,知识库本身不会变得更智能。
我换了一种思路:
提供新材料 → AI 阅读提炼 → AI 写/更新 wiki 页面 → wiki 越来越丰富Wiki 是 LLM 持续构建的结构化知识快照,而不是原始文档的向量仓库。
角色分工很清晰:
- 我:提供源材料、引导分析方向、做出最终判断
- Claude Code:归档基础设施、维护交叉引用、保持一致性------那些会导致知识库被放弃的繁琐工作
三、系统架构(10 分钟搭完)
c
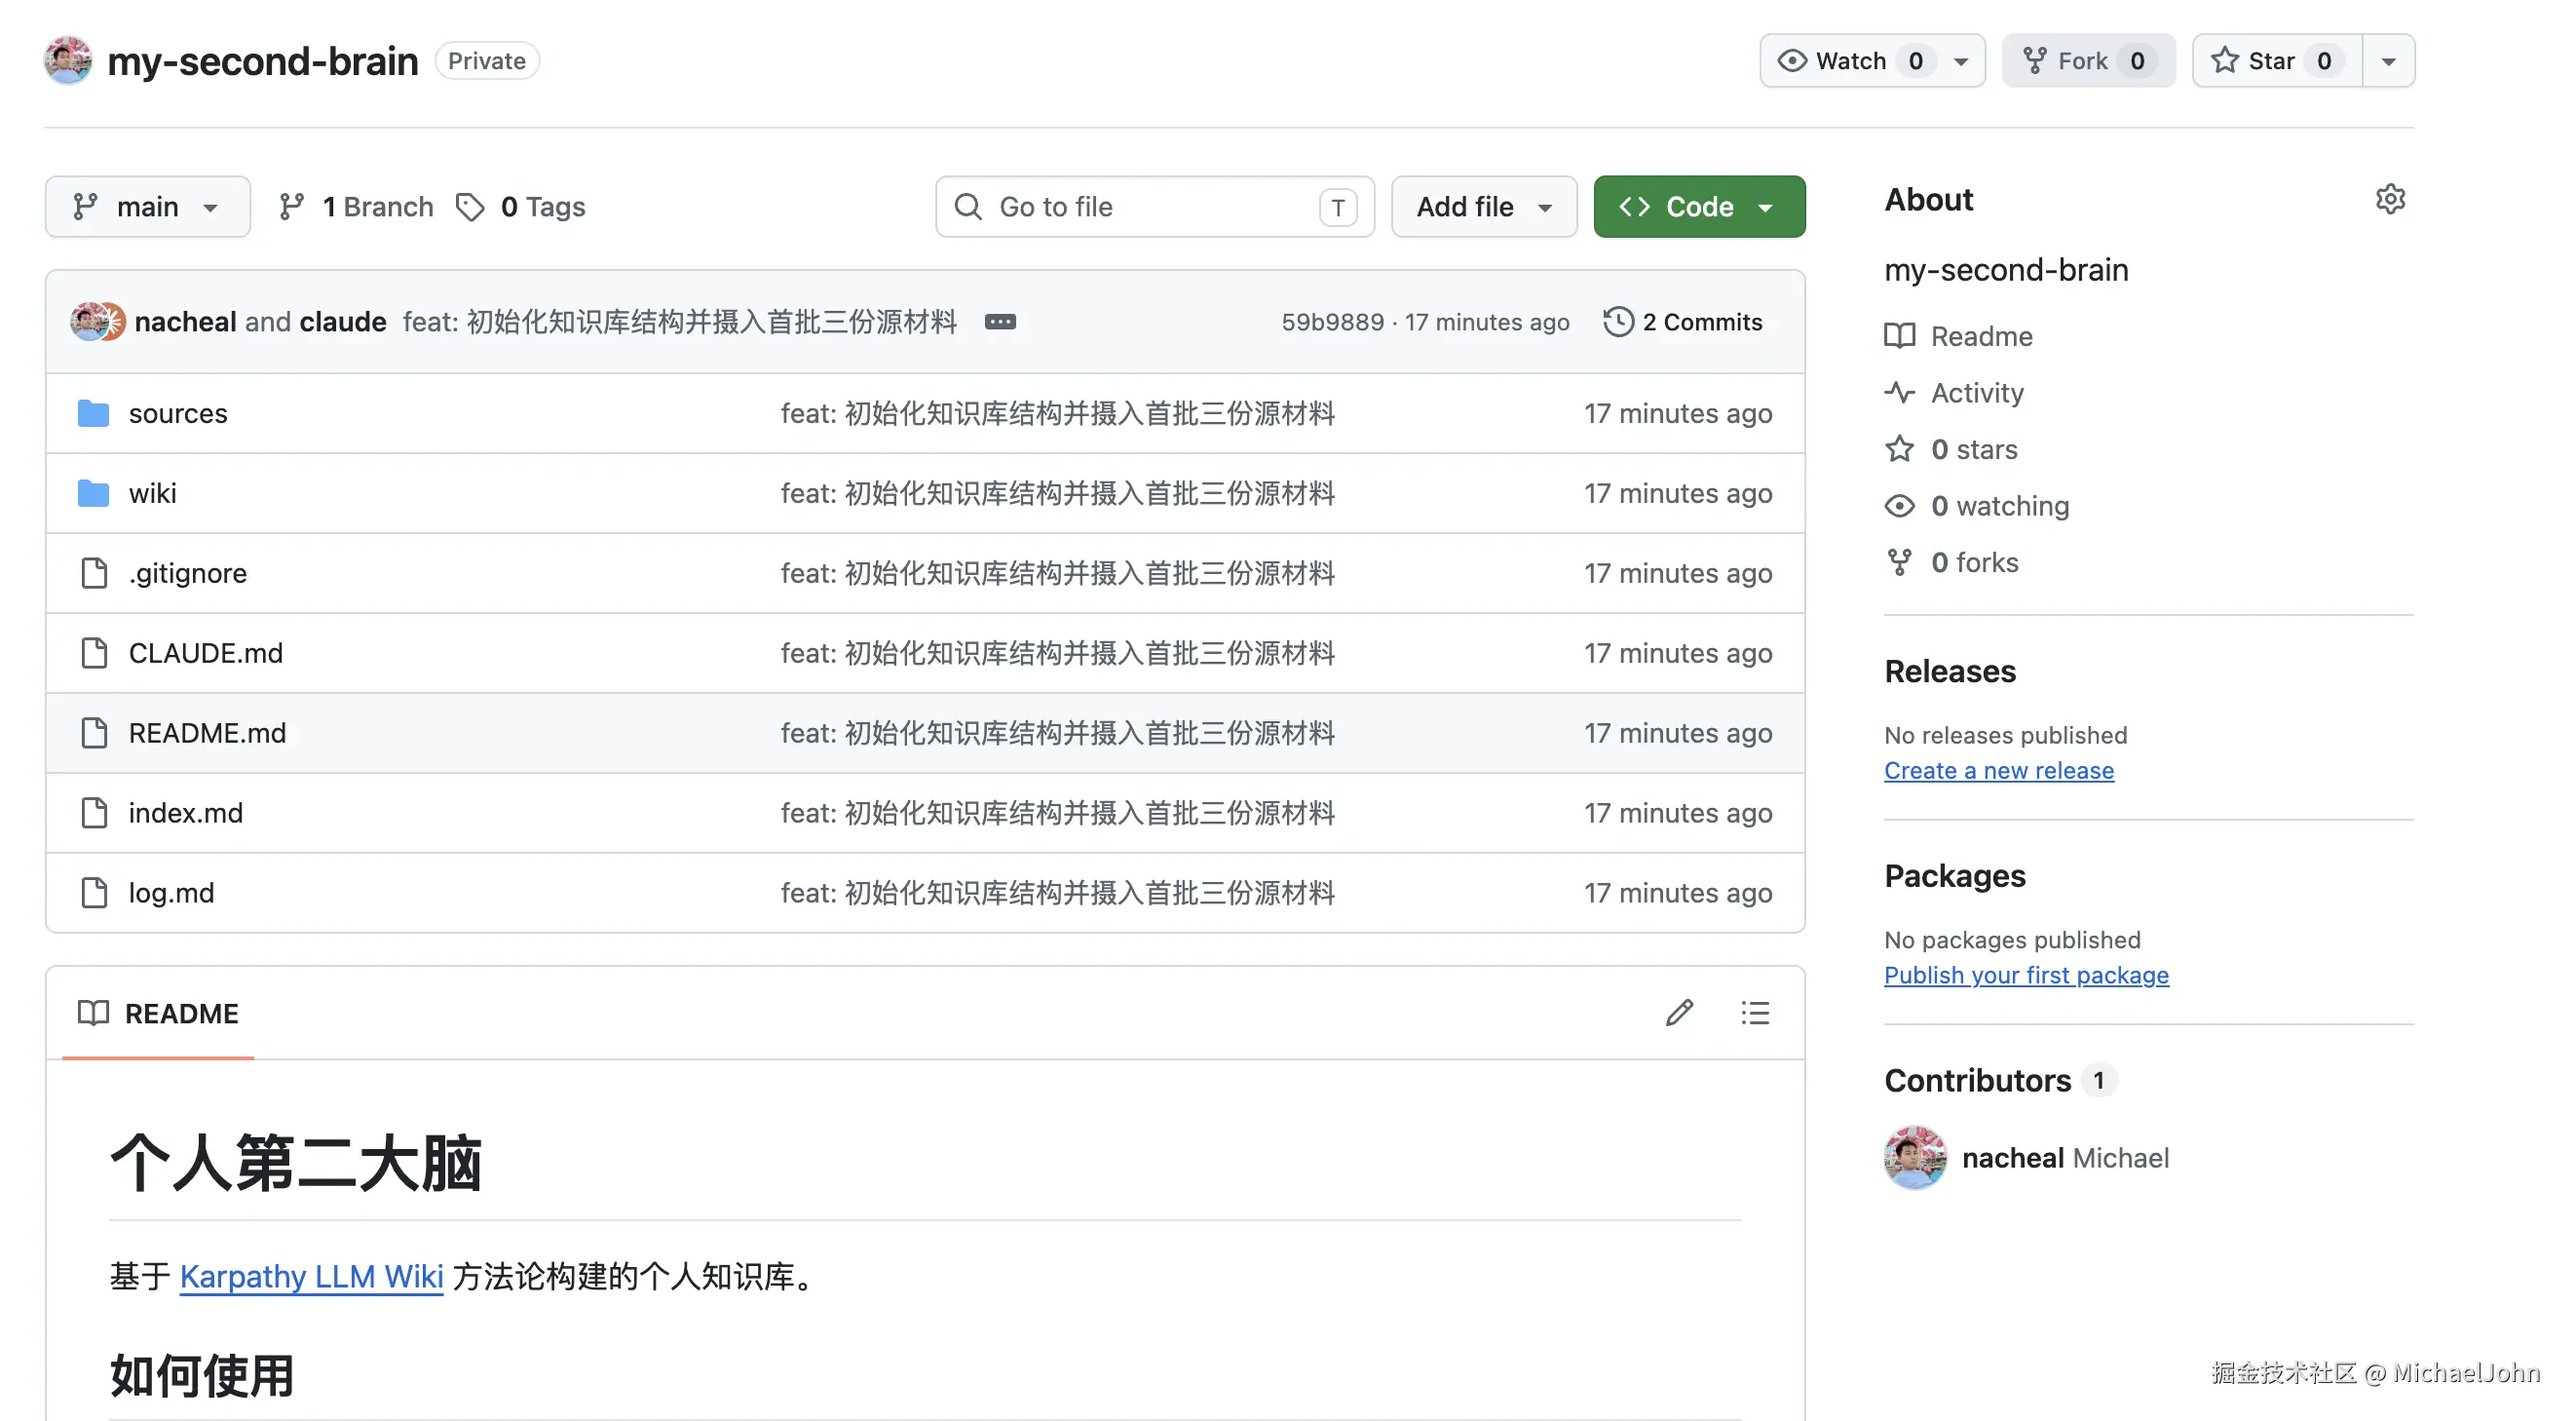
my-second-brain/
├── CLAUDE.md          ← 大脑宪法(告诉 Claude 怎么工作)
├── index.md           ← 知识目录(自动维护)
├── log.md             ← 操作日志(只追加)
├── sources/           ← 原始资料(不可变,权威参考)
└── wiki/              ← Claude 生成并维护的 wiki
    ├── people/        ← 人物页面
    ├── concepts/      ← 概念与方法论
    ├── projects/      ← 项目
    ├── resources/     ← 书籍、视频、工具
    └── areas/         ← 生活领域
工具选型:
| 工具 | 角色 |
|---|---|
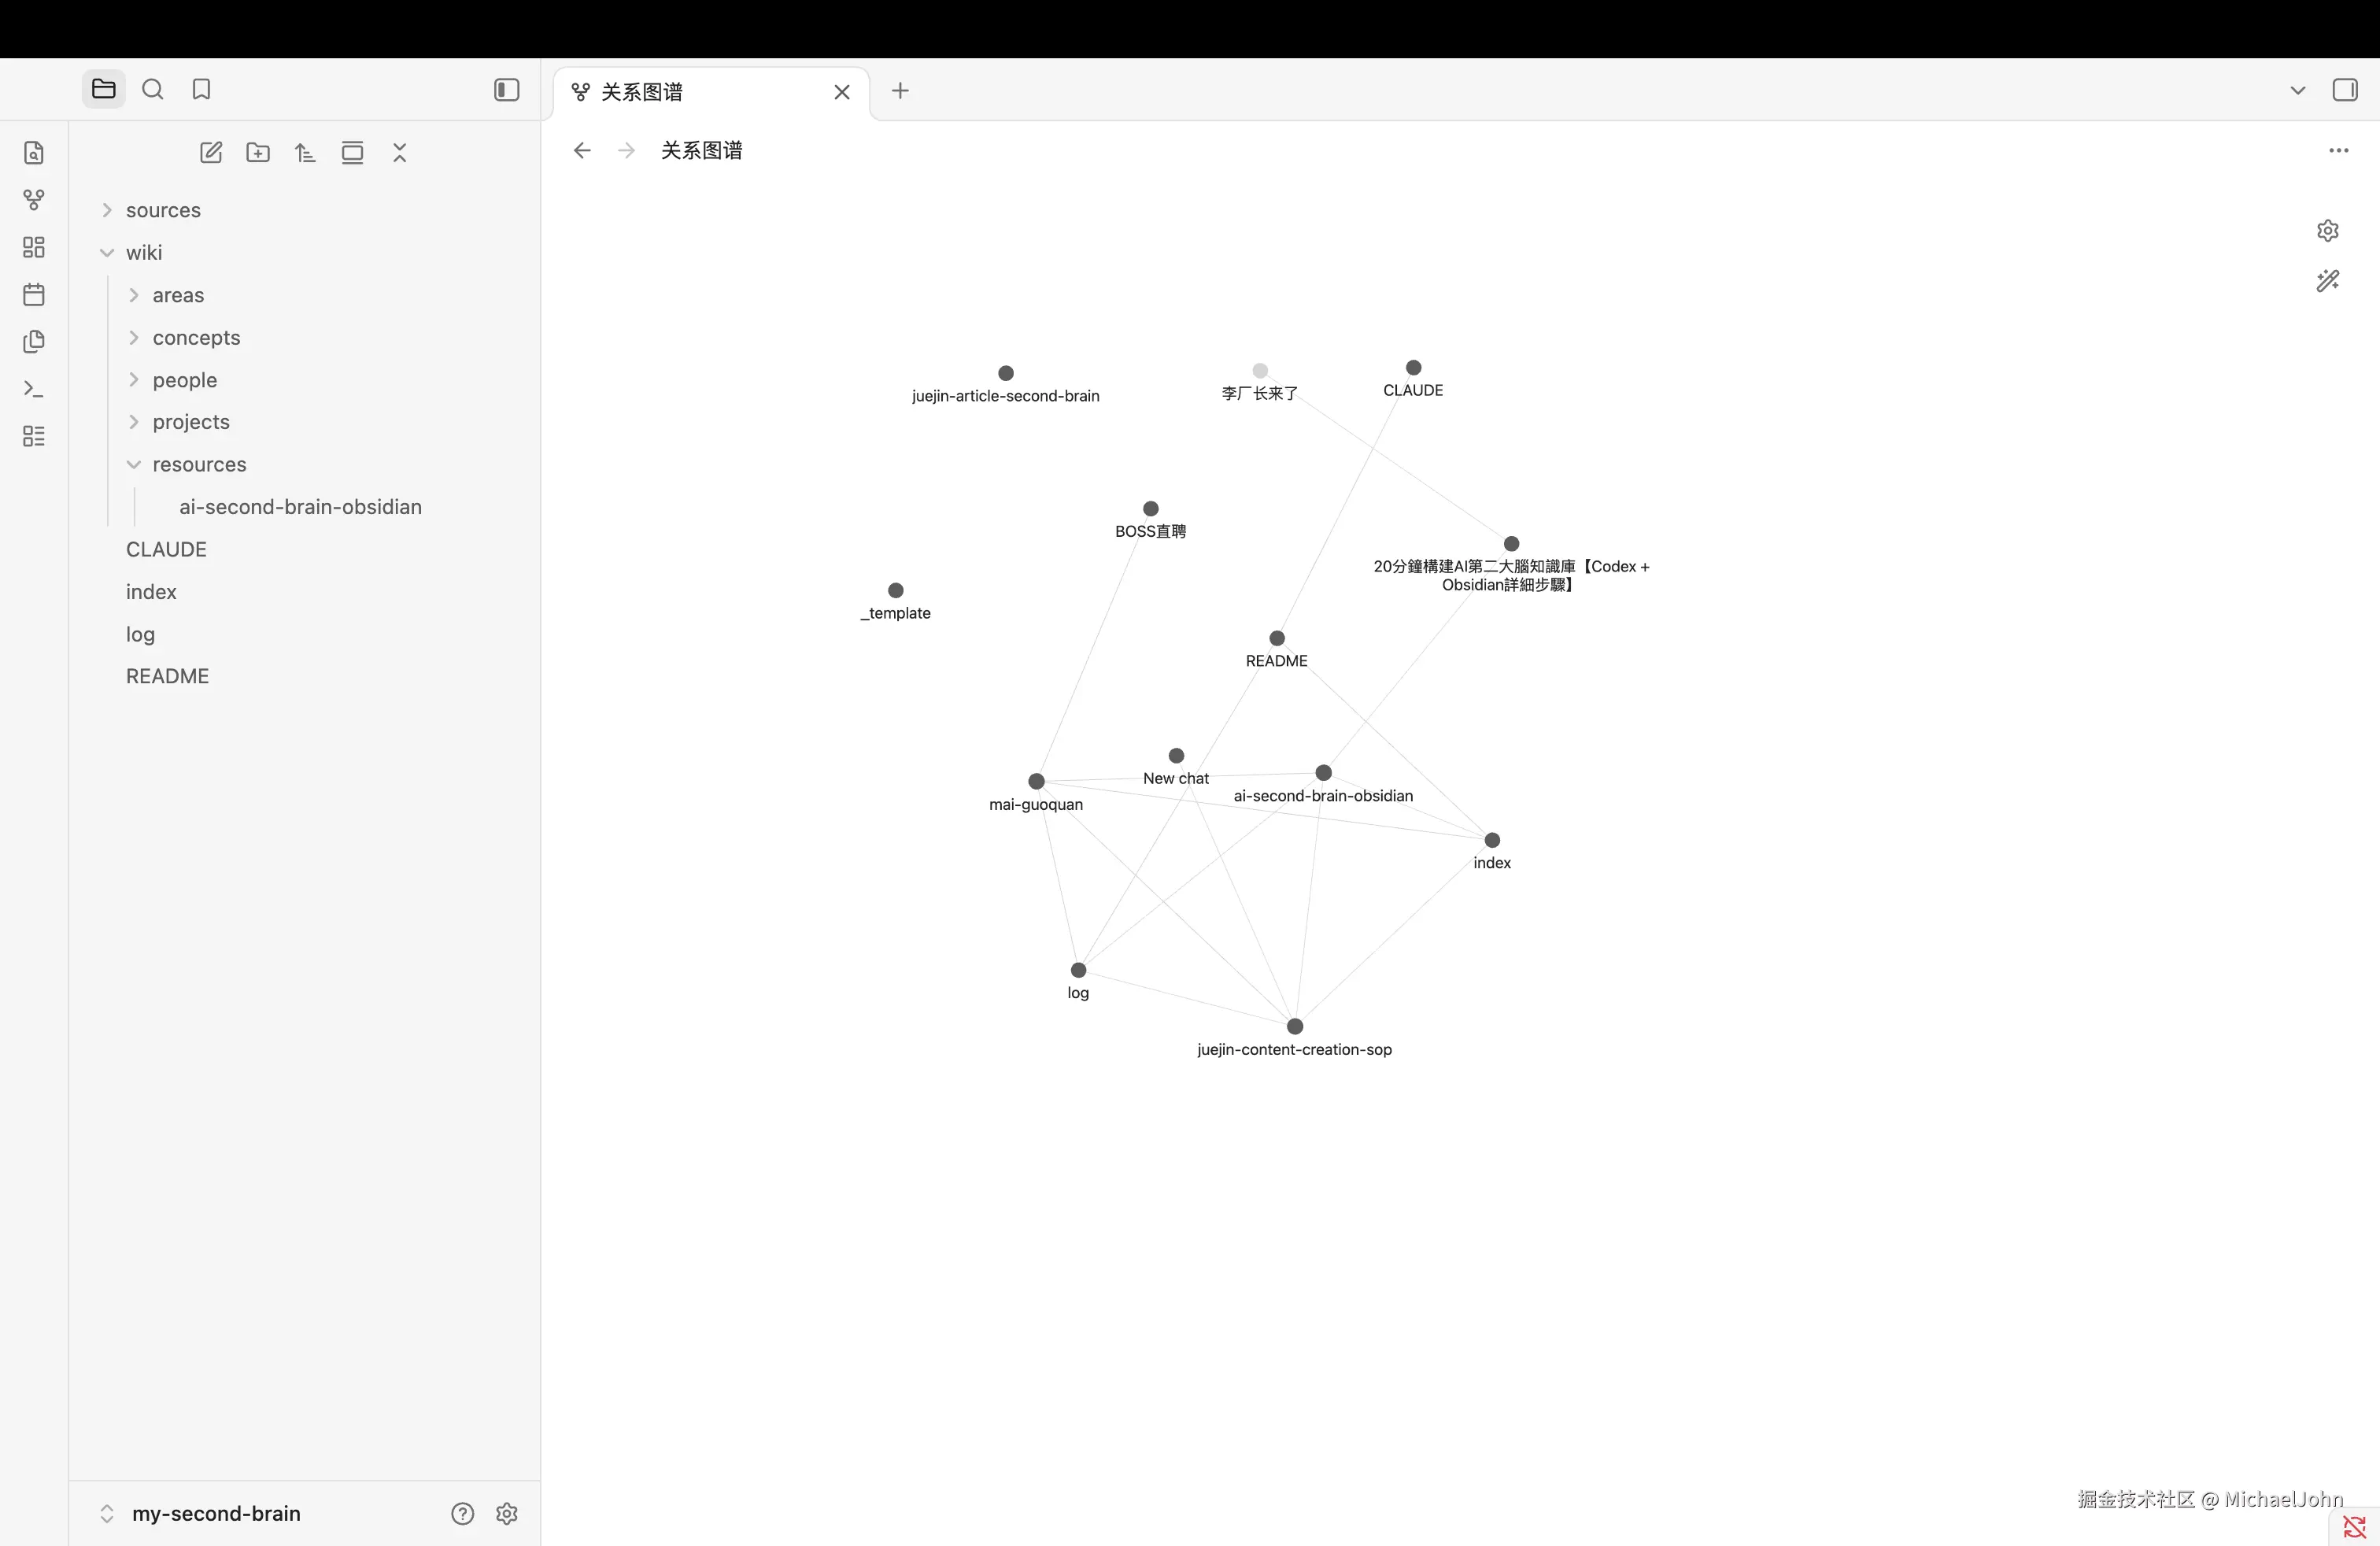
| Obsidian | 本地查看 / 双链图谱 / Markdown 渲染 |
| Claude Code | AI 处理引擎(在终端里跑) |
| GitHub | 版本控制 / 多端同步 / 备份 |
四、最关键的一步:写好 CLAUDE.md
这是整个系统的核心。CLAUDE.md 就是你给 Claude Code 的「工作手册」,告诉它三件事该怎么做。
把以下内容复制到 CLAUDE.md,直接可用:
markdown
# 个人第二大脑 --- 操作规范

## 概念

这是一个由 LLM 增量维护的持久化个人知识库(wiki)。核心理念:**不在每次查询时从原始文档中检索,而是让 LLM 持续构建并维护一个结构化的 wiki**,它随着每次摄入而愈加丰富。

角色分工:
- **我(用户)**:提供源材料、引导分析方向、做出判断和决策
- **LLM**:负责归档基础设施、维护交叉引用、保持一致性

---

## 目录结构

```
my-second-brain/
├── CLAUDE.md
├── index.md
├── log.md
├── sources/
└── wiki/
    ├── people/
    ├── concepts/
    ├── projects/
    ├── resources/
    └── areas/
```

---

## 三大核心操作

### 1. Ingest(摄入新资料)

当我提供新源材料时,执行以下步骤:

1. **阅读**源材料,提取关键洞察、事实、观点
2. **讨论**重要发现(如有必要)
3. **撰写或更新** wiki 页面:
   - 优先扩展现有页面,而非创建重复页面
   - 遇到冲突信息时,**不得静默覆盖**------在页面中明确标注冲突
   - 重写摘要而非简单追加,保持页面整洁
4. **更新 index.md**:在对应分类下添加或更新条目
5. **写入 log.md**:以 `[YYYY-MM-DD] [INGEST]` 为前缀记录摄入内容
6. **更新交叉引用**:检查并补充相关页面之间的链接
7. **标记 source 文件为已处理**:在 source 文件 frontmatter 中添加 `ingested: YYYY-MM-DD`,防止重复摄入

### 2. Query(查询知识库)

当我提问时:

1. **搜索**相关 wiki 页面
2. **综合**回答,附带页面引用(`[[页面名]]` 格式)
3. **记录发现**:如果本次查询产生了有价值的新洞察,将其写入相关 wiki 页面
4. **写入 log.md**:以 `[YYYY-MM-DD] [QUERY]` 为前缀记录查询与关键发现

### 3. Lint(审计知识库)

1. 检查**矛盾**:同一主题在不同页面之间的冲突信息
2. 标记**孤立页面**:没有被任何其他页面链接的页面
3. 修复**缺失的交叉引用**
4. 识别**过时内容**
5. 写入 log.md:以 `[YYYY-MM-DD] [LINT]` 为前缀记录审计结果

---

## 启动对话的方式

- **摄入**:「帮我摄入这篇文章:[内容]」或直接粘贴内容
- **查询**:直接提问
- **审计**:「请对知识库做一次 lint」
- **浏览**:「给我看 index.md」
五、实际操作演示
摄入一篇文章
在终端 cd 到知识库目录,启动 Claude Code,然后:
lua
你:帮我摄入这篇文章:[粘贴内容]

Claude Code:
✓ 阅读完毕,核心洞察:...
✓ 新建 wiki/concepts/llm-agents.md
✓ 更新 index.md
✓ 写入 log.md:[2026-10-22] [INGEST] 摄入《...》,新建 [[llm-agents]]
✓ 在 source 文件标记 ingested: 2026-10-22
查询知识库
lua
你:我之前看过哪些关于 AI agent 的资料?有什么结论?

Claude Code:
根据 [[llm-agents]] 和 [[ai-workflow]] 页面综合来看...
[结构化回答,附带 wiki 页面引用]
定期 Lint
lua
你:请对知识库做一次 lint

Claude Code:
发现 2 个孤立页面(没有任何页面链接它们)
发现 1 处内容矛盾:[[react-hooks]] 和 [[frontend-patterns]] 对 useEffect 的描述不一致
已修复 3 处缺失交叉引用
写入 log.md:[2026-10-22] [LINT] 审计完成...
六、GitHub 同步:多端访问
bash
# 初始化
cd my-second-brain
git init
git remote add origin https://github.com/你的用户名/second-brain.git

# .gitignore 排除大文件
echo "*.pdf\n*.mp4\n*.zip" > .gitignore

# 每次摄入后提交
git add .
git commit -m "ingest: 摄入《文章标题》"
git push
手机端:iOS 用 Working Copy 拉取仓库,Obsidian Mobile 打开同一目录,随时查阅。
七、用了一段时间后,真实感受
好的地方:
- Wiki 越摄越厚,而且是结构化的知识提炼,不是原始材料的堆砌
- 交叉引用自动维护,Obsidian 的双链图谱直接可用,不用手动整理
log.md记录了所有操作历史,能看到知识库的「成长轨迹」- 再也不怕知识库「烂掉」------因为维护的活是 Claude 干的
踩过的坑:
CLAUDE.md必须写清楚,描述模糊 Claude 会乱建页面、结构混乱- Source 文件要标记
ingested字段,否则下次对话会重复摄入 - 页面之间有冲突时,Claude 会标注但不会自动解决,最终判断还是你来做
- 私密内容建议用私有仓库,或者敏感部分本地不推送
八、和市面上方案的对比
| 方案 | 核心问题 |
|---|---|
| Notion AI | 检索型,wiki 本身不会生长 |
| RAG + 向量数据库 | 技术门槛高,知识不被提炼,原始文档直接作为上下文 |
| 普通 Obsidian 插件 | 还是靠人工维护,时间长了依然会烂 |
| 本方案 | LLM 是维护者,知识库增量生长,维护成本接近于零 |
九、完整搭建步骤(速查)
bash
# 1. 新建目录
mkdir my-second-brain && cd my-second-brain
mkdir -p wiki/{people,concepts,projects,resources,areas} sources

# 2. 创建 CLAUDE.md(复制上面的内容)

# 3. 创建空文件
touch index.md log.md

# 4. 初始化 git
git init && git remote add origin [你的仓库地址]

# 5. 用 Obsidian 打开这个文件夹

# 6. 在终端 cd 到这个目录,启动 Claude Code
claude
然后直接跟 Claude Code 说:「帮我摄入这篇文章」,它会按 CLAUDE.md 的规范自动完成所有操作。
总结
这套系统的本质:把知识库的维护工作外包给 LLM,你只负责提供材料和最终判断。
核心框架来自 Andrej Karpathy,我在他的基础上加入了 Claude Code 作为本地 agent、GitHub 做版本控制、Obsidian 做可视化层。
搭建时间:30 分钟内。长期维护成本:几乎为零。
你现在用什么方式管理个人知识?知识库最后是怎么烂掉的?欢迎评论区聊聊。