Rust Book 编译版 17 · 异步编程基础:async、await、Future 与 Stream
编译自 The Rust Programming Language(2024 edition),在原文基础上做了删减与补充。© The Rust Project Developers,依据 MIT OR Apache-2.0 许可编译转载。
开始之前
第 16 章的无畏并发给了我们操作系统线程。线程是通用工具,但每一根都不便宜:Linux 上每个线程默认要预留数 MB 的栈内存,切换还要陷入内核做上下文保存;一万条并发连接就是一万个线程,内存与调度开销会先把机器压垮。更关键的是,多数并发场景里 CPU 其实在「等」:等网络、等磁盘、等用户------下载一个视频时占着线程干等纯属浪费(视频导出那种 CPU 密集型任务是另一回事,那是真在用满算力)。
而本文要介绍的 async 的思路是把「等待」变成语言里可表达的东西:用「可能的暂停点」和「最终结果」来写代码,协调细节交给一层抽象,编译器再把它落成一台可随时暂停、恢复的状态机------前面的不明白不重要,只需要知道这种机制下少量线程就能驱动海量并发任务。
本章是 2024 版全新重写的一章,内容密度不低。我按三条主线把它理顺:
Future为什么是惰性的(不 await 就不执行)- 运行时为什么在 Rust 里是「外挂」而非语言内置
async fn背后到底生成了什么。
第 16 章用线程做过的并发习题------计数、消息传递、等待汇合------本章会用 future 原样重演一遍,两相对照,差异一目了然。
前置知识 :第 16 章「无畏并发」(thread::spawn、通道、move 闭包、Send 与 Sync)。
你会学到:
- 分清并行(parallelism)与并发(concurrency),以及 async 属于哪一种
- 用
async/await写一个并发网页抓取器,理解 Future 的惰性与运行时的角色 - 用
spawn_task、async 通道、join/join!、select重做第 16 章的并发练习 - 弄清
Pin与Unpin为什么存在------自引用结构与安全移动的难题 - 掌握「什么时候用线程、什么时候用 async、什么时候两个都用」的判断依据
并行与并发
第 16 章我们把这两个词当近义词混着用,动真格之前先把它们拆开。
用团队分工类比:一名成员同时推着几个没做完的任务,做烦了就切换到另一个------这是并发(concurrency):任何时刻只有一个任务在动,但在多个任务间来回跳,每个都能慢慢往前走(图 17-1)。把任务拆开、每人各领一个同时推进------这是并行(parallelism):多个任务在同一时刻真正各自前进(图 17-2)。
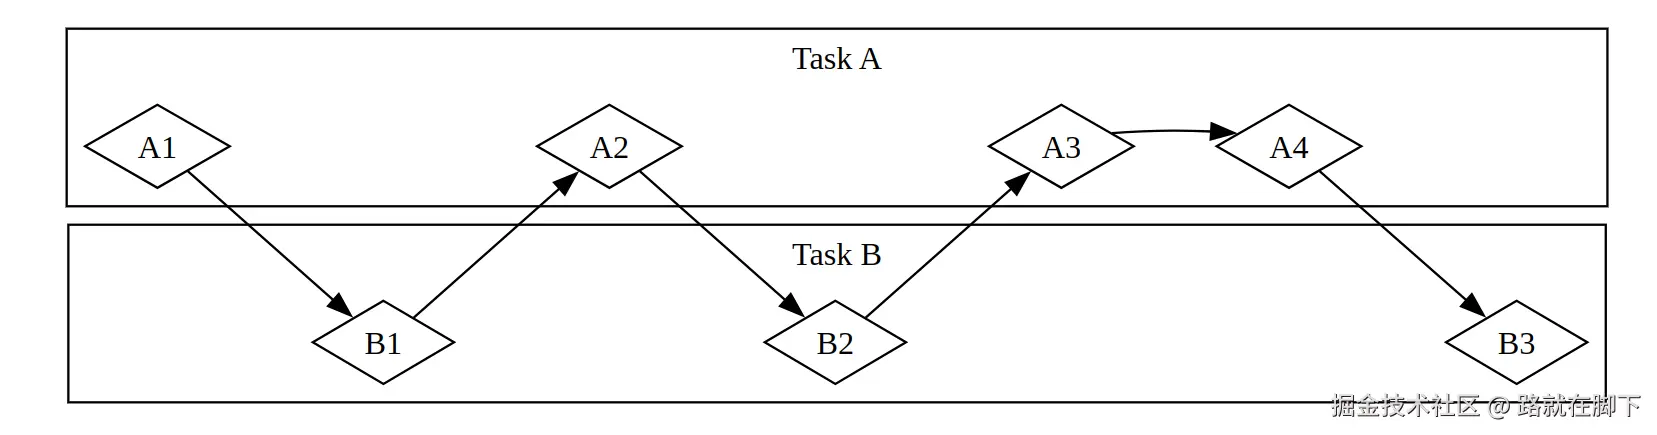
图 17-1:并发工作流,在任务 A 与任务 B 之间切换
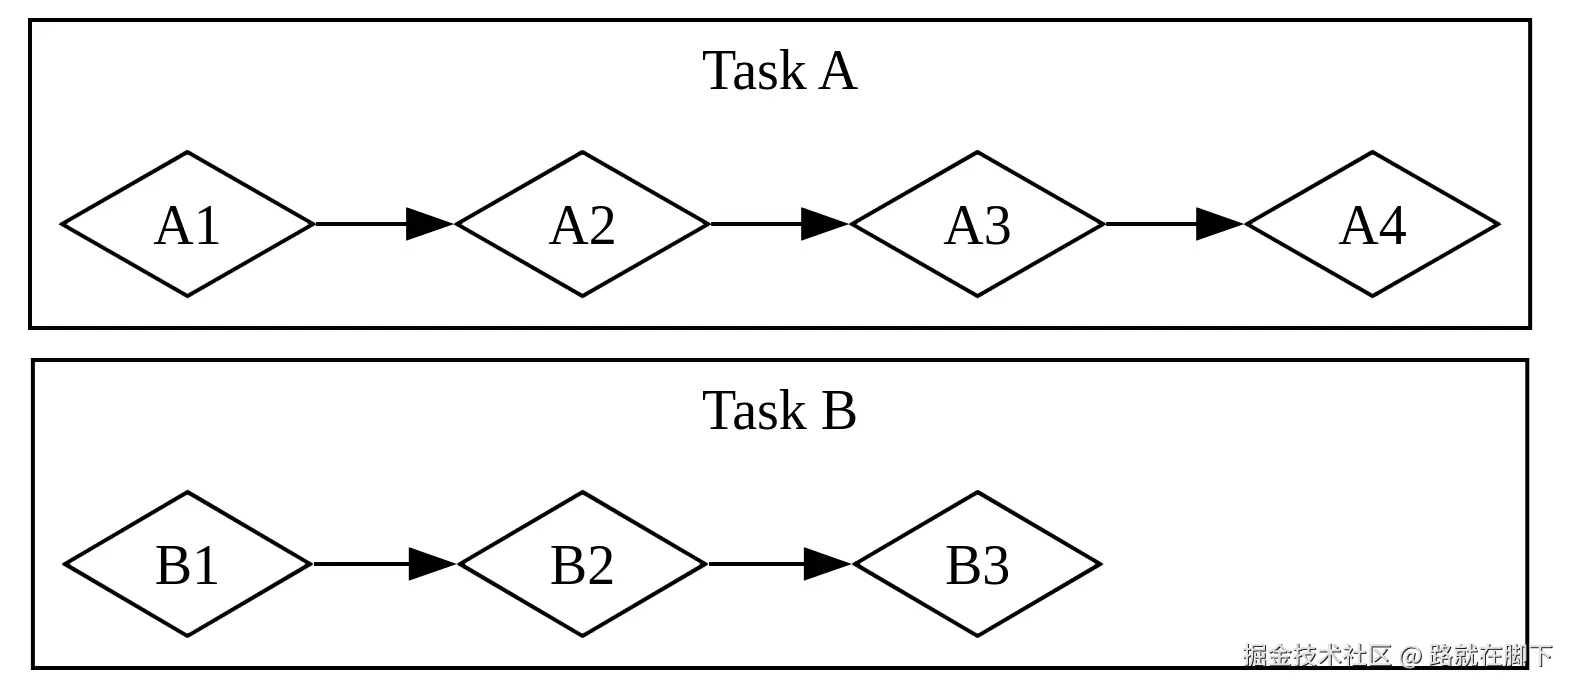
图 17-2:并行工作流,任务 A 与任务 B 的推进彼此独立
两种工作流都免不了协调:你以为分出去的任务彼此独立,实际某个任务要等同事先交付他那份------这部分工作就是串行(serial)的,只能按先后次序发生(图 17-3)。并发内部同样有串行:如果你的一个任务依赖你自己的另一个任务,来回切换就失去了意义。
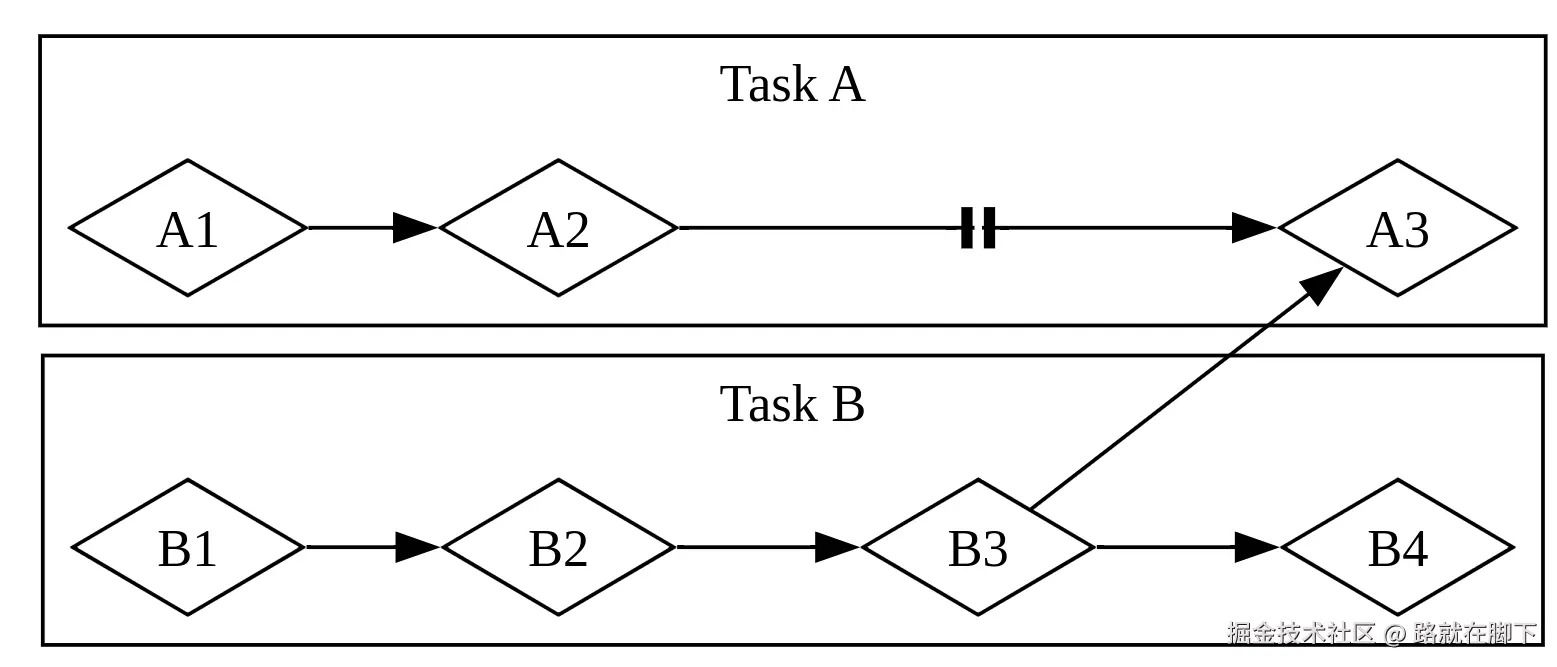
图 17-3:部分并行的工作流:任务 A 与任务 B 先各自独立推进,直到 A3 被阻塞,等待 B3 的结果。
映射到软硬件也是同一规律:单核 CPU 一次只能执行一个操作,但借助线程、进程和 async 仍能并发------暂停一项活动、切换到别的、最后再绕回来;多核机器才能真正并行,一个核心执行某个任务的同时,另一个核心执行一个毫不相干的任务。Rust 的 async 代码通常以并发方式运行,视硬件、操作系统和所用运行时而定,这种并发在底层也可能用上并行。
Future 与 async 语法
Rust 异步编程的三块基石:future ,以及 async 和 await 关键字。
future 是一种现在可能尚未就绪、将来某个时刻才会就绪的值(其他语言里也常见 task、promise 之类的名字)。Rust 为它提供了 Future trait 作为统一接口:不同的异步操作用不同的数据结构实现,却共用同一套接口。在 Rust 里,future 就是实现了 Future trait 的类型,每个 future 都自带「目前进展到哪一步」「怎样才算就绪」的信息。
async 关键字标在块或函数上,表示它们可以被中断、也能恢复执行;在 async 块或函数内部,用 await 关键字等待(await)一个 future 到就绪。每一个 await 的位置,都是该块或函数可能暂停、再恢复的地方;向 future 查询「值是否已经可用」的过程叫轮询(polling)。
C#、JavaScript 也用 async/await 这对关键字,但 Rust 的处理方式有明显不同------后面会看到理由。日常写 async 代码时你几乎只用这两个关键字:Rust 把它们编译成使用 Future trait 的等价代码,正如它把 for 循环编译成使用 Iterator trait 的等价代码;需要时也可以为自己的类型实现 Future,本章末尾会回到这个 trait 的定义深入剖析,眼下的信息已足够开工。
第一个项目:小型网页抓取器(web scraper)------从命令行传入两个 URL,并发抓取,返回先完成者的结果。会碰到不少新语法,边走边讲。
我们的第一个 async 程序
为了让本章专注 async 本身、而不是在生态各部件之间疲于奔命,原书专门做了 trpl crate(The Rust Programming Language 的缩写),重新导出所需的所有类型、trait 和函数,主要来自 futures 和 tokio 两个 crate:futures 是官方的异步实验场,Future trait 最初就在那里设计成型;tokio 是当今使用最广泛的 async 运行时,尤其在 Web 应用领域------还有其他优秀运行时,也许更适合你。trpl 底层用 tokio(久经测试、应用广泛),个别地方重命名或包装了原始 API,想深究可以直接读它的源代码。
新建项目并添加依赖:
bash
cargo new hello-async
cd hello-async
cargo add trpl
目标:抓取两个网页,分别取出其中的 <title> 元素,打印率先完成整个流程的那个页面的标题。
定义 page_title 函数
先写一个函数:接收页面 URL,发起请求,返回该页面 <title> 元素的文本(示例 17-1)。
rust
use trpl::Html;

async fn page_title(url: &str) -> Option<String> {
    let response = trpl::get(url).await;
    let response_text = response.text().await;
    Html::parse(&response_text)
        .select_first("title")
        .map(|title| title.inner_html())
}
示例 17-1:定义一个从 HTML 页面获取 title 元素的 async 函数
page_title 用 async 标记,函数体里两次 await:trpl::get 要等服务器返回响应的第一部分(HTTP 头、cookie 等,可能与响应体分开送达);text 方法要等响应体完整到达------响应体很大时需要时间,所以它也是 async 的。
注意这两步都必须显式 await,因为 Rust 的 future 是惰性(lazy)的:不用 await 驱动,它们就什么也不做(创建后弃置不用,编译器还会警告)。第 13 章讲迭代器时见过同款设计:不调 next 就什么都不发生------无论是直接调用,还是通过 for 循环或 map 这类间接方式。future 同理:不明确要求就不动弹。这种惰性让 Rust 不必在实际需要之前就运行 async 代码。
编译注: 惰性是 Rust 与主流 async 语言最经典的分歧点。JavaScript 的 Promise 是「热」的:
new Promise(...)的 executor 在构造瞬间就开始执行,你事后.then只是补挂回调;C++20 的协程在「调用即执行还是先挂起」上由库通过 promise 的初始挂起点配置,常见 task 类型也有惰性的,但那是库的约定而非语言保证。Rust 在语言层面统一规定:调用async fn一行代码都不执行,只构造 future------与第 16 章thread::spawn传入闭包立即开跑也不同。把 future 当「待发动的闭包」理解最不容易踩坑。
拿到 response_text 后,Html::parse 把原始字符串解析成 Html 类型------一个能把 HTML 当数据结构处理的类型。select_first("title") 查找第一个匹配 CSS 选择器的元素,可能不存在,所以返回 Option<ElementRef>;Option::map 有值才处理(比 match 更符合惯例),函数体里对 title 调 inner_html 取出内容。兜兜转转,最终得到 Option<String>。
此处完全没有必要深究Html这个包的具体使用,只需要知道这段代码在干什么即可。
另外注意:Rust 的 await 是后缀(postfix)关键字,放在被等待表达式的后面而非前面。初见可能不习惯,但它让方法链写得顺手,比如把 page_title 的函数体改成链式(示例 17-2)。
rust
let response_text = trpl::get(url).await.text().await;示例 17-2:用 await 关键字进行链式调用
第一个 async 函数写出来了。往 main 里加调用之前,先弄明白刚写下的东西是什么。
Rust 遇到 async 块,会把它编译成一个实现了 Future trait 的独一无二的匿名数据类型;遇到 async 函数,会把它编译成一个非 async 函数,其函数体就是这个 async 块。换句话说,async fn 等价于一个「返回 future」的函数。在编译器看来,示例 17-1 的 async fn page_title 大致等价于下面这个非 async 函数:
rust
use std::future::Future;
use trpl::Html;

fn page_title(url: &str) -> impl Future<Output = Option<String>> {
    async move {
        let text = trpl::get(url).await.text().await;
        Html::parse(&text)
            .select_first("title")
            .map(|title| title.inner_html())
    }
}
逐项过一遍:
- 使用第 10 章讨论过的
impl Trait语法; - 返回值实现
Futuretrait,关联类型Output是Option<String>,与async fn版本的原始返回类型一致; - 原函数体的全部代码被包进
async move块(块也是表达式,整个块就是返回值),产出一个Option<String>,与Output吻合; - 之所以是
async move,与它使用url参数的方式有关,async与async move的区别本章稍后详谈。
编译注: 「
async fn是返回 Future 的语法糖」可以拆得很实:调用page_title(url)什么都没执行,只是构造出那个匿名类型的值。想真跑起来,要么在 async 上下文里.await它,要么交给运行时。C++20 用co_await/co_return加编译器生成的协程帧表达同一件事,Rust 选择了更保守的路线------future 就是个普通值,能存进变量、装进Vec、从函数返回。这个决定把内存分配的主动权留给了你(栈上放、装箱、塞集合都行),代价是本章后半部分要处理的Pin问题。
现在可以在 main 中调用 page_title 了。
用运行时执行 async 函数
先获取单个页面的标题(示例 17-3)------遗憾的是编译不过。
rust
async fn main() {
    let args: Vec<String> = std::env::args().collect();
    let url = &args[1];
    match page_title(url).await {
        Some(title) => println!("The title for {url} was {title}"),
        None => println!("{url} had no title"),
    }
}
示例 17-3:在 main 中用用户提供的参数调用 page_title 函数
命令行参数的写法沿用第 12 章;page_title 返回的 future 产出 Option<String>,用 match 分别处理有无 <title>。问题出在 main:await 只能用在 async 函数或 async 块里,而 Rust 不允许把特殊的 main 标成 async:
text
error[E0752]: `main` function is not allowed to be `async`
 --> src/main.rs:6:1
  |
6 | async fn main() {
  | ^^^^^^^^^^^^^^^ `main` function is not allowed to be `async`
原因在于:async 代码需要一个运行时(runtime)------一个负责管理异步代码执行细节的 Rust crate。main 可以初始化一个运行时,但它本身不是运行时。每个执行 async 代码的 Rust 程序,都至少要有一处把运行 future 的运行时搭起来。
大多数支持 async 的语言内置了运行时,Rust 没有:市面上有多种运行时可选,各自针对目标场景做了取舍------多核大内存的高吞吐 Web 服务器,与单核、少内存、无堆分配的微控制器,需求天差地别。这些运行时 crate 通常还附带常见功能(文件、网络 I/O)的 async 版本。
本章统一用 trpl::block_on:接收一个 future,阻塞当前线程直到它运行完毕,幕后借助 tokio 搭建运行时。直接把 page_title 的 future 传给它也行,但本章多数示例(以及现实中的 async 代码)要做的远不止一次 async 调用,所以我们统一传入一个 async 块、在其中显式 await(示例 17-4)。
rust
fn main() {
    let args: Vec<String> = std::env::args().collect();

    trpl::block_on(async {
        let url = &args[1];
        match page_title(url).await {
            Some(title) => println!("The title for {url} was {title}"),
            None => println!("{url} had no title"),
        }
    })
}
示例 17-4:用 trpl::block_on 等待一个 async 块
运行这段代码,得到最初期望的行为:
bash
cargo run -- "https://www.rust-lang.org"
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.05s
     Running `target/debug/async_await 'https://www.rust-lang.org'`
The title for https://www.rust-lang.org was
            Rust Programming Language
呼------能跑的 async 代码有了。加竞速之前,回顾一下 future 的工作方式。
每个 await 点都是一处把控制权交还运行时的位置。为此,Rust 需要记录 async 块涉及的状态,运行时才能先去做别的工作、回头再来推进它。这是一台看不见的状态机,就好比你为每个 await 点手写一个这样的 enum 来保存当前状态:
rust
enum PageTitleFuture<'a> {
    Initial { url: &'a str },
    GetAwaitPoint { url: &'a str },
    TextAwaitPoint { response: trpl::Response },
}
手工编写状态转移的代码枯燥又容易出错,尤其日后要加更多功能、更多状态时------好在编译器会自动创建并管理这些状态机数据结构,常规的借用与所有权规则照常生效、照常由编译器检查(本章稍后会分析几条相关报错)。而归根结底,总得有什么东西来执行这台状态机,那就是运行时(研究运行时时常见「执行器(executor)」一词:运行时中负责执行 async 代码的那部分)。这也解释了为什么编译器阻止我们把 main 写成 async:main 是程序起点,若它是 async 函数,就得有别的什么来管理它的状态机------那是无源之水。所以做法是在 main 里调 trpl::block_on 搭建运行时,把 async 块的 future 一路运行到完成。
提示: 有些运行时提供宏,让你确实能写出 async 的
main。宏展开后做的事与示例 17-4 手工做的完全一样:调用一个像block_on那样把 future 运行到完成的函数。
现在把部件拼起来,写并发代码。
让两个 URL 并发竞速
示例 17-5 用命令行传入的两个不同 URL 分别调用 page_title,让两个 future 竞速,取先完成者。
rust
use trpl::{Either, Html};

fn main() {
    let args: Vec<String> = std::env::args().collect();

    trpl::block_on(async {
        let title_fut_1 = page_title(&args[1]);
        let title_fut_2 = page_title(&args[2]);

        let (url, maybe_title) =
            match trpl::select(title_fut_1, title_fut_2).await {
                Either::Left(left) => left,
                Either::Right(right) => right,
            };

        println!("{url} returned first");
        match maybe_title {
            Some(title) => println!("Its page title was: '{title}'"),
            None => println!("It had no title."),
        }
    })
}

async fn page_title(url: &str) -> (&str, Option<String>) {
    let response_text = trpl::get(url).await.text().await;
    let title = Html::parse(&response_text)
        .select_first("title")
        .map(|title| title.inner_html());
    (url, title)
}
示例 17-5:对两个 URL 调用 page_title,看哪个先返回
先各调用一次 page_title,把 future 存为 title_fut_1 和 title_fut_2------记住,此刻它们什么都没做,因为 future 是惰性的、还没被 await。接着把它们传给 trpl::select,它会返回一个值,指明哪个 future 先完成。
两个 future 谁都有资格赢,用 Result 不合适;select 返回的是 trpl::Either------长得像 Result,也有两种情形,但没有成功/失败的含义,只有 Left/Right 的「二者之一」:
rust
enum Either<A, B> {
    Left(A),
    Right(B),
}
第一个参数赢则返回 Left(内含其输出),第二个赢则返回 Right,与参数出现顺序吻合。我们还更新了 page_title,让它把传入的 URL 原样返回------这样即便先完成的页面没有 <title>,也能打印出有意义的信息;最后让 println! 既报告谁先完成,也报告它的 <title>(如果有的话)。
一个能用的小型网页抓取器就成了。挑几个 URL 跑跑看:某些站点总是更快?还是每次运行都有变化?更重要的是,future 的基础已经打牢,可以往深处走了。
用 async 实现并发
本节把 async 用到第 16 章用线程解决过的同类并发难题上。关键概念那里都讲过了,这里聚焦线程与 future 的差异:两者的 API 时而相似、时而迥异;即便长得像,行为和性能特征往往也不同。
用 spawn_task 创建新任务
第 16 章的第一个练习是在两个独立线程上计数,现在用 async 重做。trpl 提供了 spawn_task 函数(外形酷似 thread::spawn)和 sleep 函数(thread::sleep 的 async 版),组合起来就是示例 17-6。
rust
use std::time::Duration;

fn main() {
    trpl::block_on(async {
        trpl::spawn_task(async {
            for i in 1..10 {
                println!("hi number {i} from the first task!");
                trpl::sleep(Duration::from_millis(500)).await;
            }
        });

        for i in 1..5 {
            println!("hi number {i} from the second task!");
            trpl::sleep(Duration::from_millis(500)).await;
        }
    });
}
示例 17-6:创建一个新任务打印一些内容,同时主任务打印另一些内容
main 照例用 trpl::block_on 包装出 async 上下文;块里两个循环各带一次 500 毫秒的 trpl::sleep,一个放进 spawn_task 的函数体,另一个留在顶层 for 循环里,每次 sleep 之后都 await。行为与线程版相近------包括:在你自己的终端上运行,消息顺序可能不同:
text
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
主 for 循环一结束程序就停了,因为 main 结束时 spawn_task 启动的任务也会被关停。想跑完整个任务,需要一个联结句柄(join handle):线程版我们对 JoinHandle 调 join 方法阻塞等待,这里用 await 即可------任务句柄本身就是一个 future,Output 类型是 Result,所以 await 之后还要 unwrap(示例 17-7)。
rust
let handle = trpl::spawn_task(async {
    for i in 1..10 {
        println!("hi number {i} from the first task!");
        trpl::sleep(Duration::from_millis(500)).await;
    }
});

for i in 1..5 {
    println!("hi number {i} from the second task!");
    trpl::sleep(Duration::from_millis(500)).await;
}

handle.await.unwrap();
示例 17-7:对联结句柄使用 await,让任务运行到完成
更新后的版本会跑完两个循环:
text
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
到目前,async 与线程的结果几乎一样,只是语法不同:await 取代联结句柄上的 join,sleep 调用也要 await。真正的区别是:我们没有为此再启动一个 OS 线程。事实上连任务都不必启动------async 块本来就是匿名 future,把两个循环各放进一个 async 块,用 trpl::join 函数让运行时把二者都运行到完成即可(示例 17-8)。
trpl::join 与第 16 章对 std::thread::spawn 返回的 JoinHandle 调 join 类似,只是面向 future:给它两个 future,它产出一个单一的新 future,输出是一个元组,装着两个 future 各自的输出,两个都完成它才完成。注意我们 await 的不是 fut1 和 fut2 本身,而是 trpl::join 产出的那个新 future(输出被忽略,它只是装着两个单元值的元组)。
rust
let fut1 = async {
    for i in 1..10 {
        println!("hi number {i} from the first task!");
        trpl::sleep(Duration::from_millis(500)).await;
    }
};

let fut2 = async {
    for i in 1..5 {
        println!("hi number {i} from the second task!");
        trpl::sleep(Duration::from_millis(500)).await;
    }
};

trpl::join(fut1, fut2).await;
示例 17-8:用 trpl::join 等待两个匿名 future
text
hi number 1 from the first task!
hi number 1 from the second task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
这次每次运行顺序都完全相同,与线程版和 spawn_task 版都不同。原因在于 trpl::join 是公平(fair)的:以同等频率轮询每个 future、在二者之间交替,只要另一个已就绪,就绝不放任一个抢先跑。线程的世界里,由操作系统决定调度哪个线程、跑多久;async 的世界里,由运行时决定调度哪个任务(实践中更复杂------运行时底层可能也用 OS 线程,保障公平更费劲,但做得到)。对任何给定的操作,运行时并不必须保证公平,通常也会提供不同的 API 让你自选。
**编译注:**如果你把借用局部变量的 future 直接喂给
spawn_task------比如 spawn 一个引用了args的任务------会撞上熟悉的报错。trpl::spawn_task底层就是tokio::spawn,约束是F: Future + Send + 'static:与第 16 章thread::spawn的'static要求如出一辙。任务可能活过当前函数返回(还可能被搬到别的线程),编译器无法保证栈上的借用仍然有效,所以被 spawn 的 future 必须自带数据或只借用'static数据;在当前上下文就地await(如select的用法)则没有这个约束。
试着改变 await 这些 future 的方式,观察结果:
- 去掉套在一个或两个循环外层的 async 块;
- 每定义一个 async 块就立即 await 它;
- 只把第一个循环包进 async 块,在第二个循环的函数体之后再 await 它。
加点挑战:能不能在运行代码之前就推断出每种情况的输出?
用消息传递在两个任务之间发送数据
future 之间共享数据,还是用消息传递,只是换成相关类型和函数的 async 版本。路线与第 16 章略有不同,正好展示线程并发与 future 并发的关键差异。示例 17-9 从一个 async 块起步------不像之前那样另起线程、也不另起任务。
rust
let (tx, mut rx) = trpl::channel();

let val = String::from("hi");
tx.send(val).unwrap();

let received = rx.recv().await.unwrap();
println!("received '{received}'");
示例 17-9:创建一个 async 通道,并把它的两端分别赋给 tx 和 rx
trpl::channel 是第 16 章配合线程使用的那个多生产者、单消费者通道 API 的 async 版。API 差异不大但值得注意:接收端 rx 是可变的而不是不可变的;recv 方法产出的不是值,而是一个需要 await 的 future。不必另起线程、甚至不必另起任务,await rx.recv 调用即可。
同步版 Receiver::recv 会一直阻塞到收到消息;trpl::Receiver::recv 不会,因为它是 async 的------它把控制权交还运行时,直到消息到达或发送端关闭。反过来,send 不需要 await:我们用的这条通道是无界的,发送不会阻塞。
**提示:**这些 async 代码都跑在
trpl::block_on调用的一个 async 块里,块内的一切都可以不阻塞;真正阻塞的是块外等待block_on返回的代码。这正是block_on的意义:由你选择在何处阻塞一段 async 代码,把同步与异步世界的交界定在哪里。
这个示例有两点值得注意:其一,消息立刻到达;其二,虽然用到了 future,却还没有任何并发------一切按顺序发生,仿佛 future 不存在。
先解决第一点:发送一系列消息,每两条之间休眠(示例 17-10)。
rust
let (tx, mut rx) = trpl::channel();

let vals = vec![
    String::from("hi"),
    String::from("from"),
    String::from("the"),
    String::from("future"),
];

for val in vals {
    tx.send(val).unwrap();
    trpl::sleep(Duration::from_millis(500)).await;
}

while let Some(value) = rx.recv().await {
    println!("received '{value}'");
}
示例 17-10:在 async 通道上发送并接收多条消息,每条消息之间用 await 休眠
现实世界里要等的通常是未知数量的消息,所以得一直等到确定不会再有为止。第 16 章处理同步通道用 for 循环,但 Rust 目前还不能对异步产出的一系列条目用 for,需要一种没见过的循环:while let 条件循环------第 6 章 if let 结构的循环版本,只要指定的模式持续匹配值就一直执行。
rx.recv() 产出一个 future,我们对它 await;有消息到达就解析为 Some(message),来多少次解析多少次;通道关闭则改为 None,表示不会再有值,应停止轮询(即停止 await)。while let 把这些串了起来:结果是 Some 就拿消息进循环体(与 if let 如出一辙),是 None 就结束循环;每跑完一轮都会再次撞上 await 点,运行时把它暂停直到下一条消息到达。
现在消息能全部收发了,但还有两个问题:其一,消息不是每半秒到一条,而是程序启动 2 秒后一口气全部到达;其二,程序永远不退出,你得用 Ctrl-C 关掉它。
同一个 async 块内的代码线性执行
先看为什么消息会延迟后齐涌而非逐条到达:在一个给定的 async 块内,await 关键字在代码中出现的顺序,就是程序运行时它们被执行的顺序。
示例 17-10 只有一个 async 块,所以其中一切线性运行,依然没有并发:所有 tx.send 依次发生、中间穿插全部 trpl::sleep 及其 await 点,全做完之后,while let 循环才有机会碰到 recv 调用上的那些 await 点。
要得到想要的行为------让休眠延迟落在每两条消息之间------就把 tx 和 rx 的操作分别放进各自的 async 块(示例 17-11),让运行时像示例 17-8 那样用 trpl::join 分别执行。再次提醒:我们 await 的是调用 trpl::join 的结果,而不是各个 future 本身------按顺序逐个 await 就又回到串行执行了,那恰恰是我们竭力避免的。
rust
let tx_fut = async {
    let vals = vec![
        String::from("hi"),
        String::from("from"),
        String::from("the"),
        String::from("future"),
    ];

    for val in vals {
        tx.send(val).unwrap();
        trpl::sleep(Duration::from_millis(500)).await;
    }
};

let rx_fut = async {
    while let Some(value) = rx.recv().await {
        println!("received '{value}'");
    }
};

trpl::join(tx_fut, rx_fut).await;
示例 17-11:把 send 和 recv 分进各自的 async 块,并等待这些块产生的 future
换成这版代码,消息就以 500 毫秒间隔逐条打印,而不是等上 2 秒后一股脑儿全出来。
把所有权移入 async 块
程序仍不退出,问题出在 while let 循环与 trpl::join 的相互作用:
trpl::join返回的 future,要在传给它的两个 future 都完成后才完成;- 发送 future 在发完
vals最后一条消息、结束休眠后即告完成; - 接收 future 要等
while let循环结束才完成; while let要等 awaitrx.recv产出None才结束;recv().await只有通道另一端关闭后才返回None;- 通道只有在调用
rx.close或发送端tx被 drop 时才关闭; - 我们没在任何地方调
rx.close,而tx要等传给block_on的最外层 async 块结束才被 drop; - 这个块又阻塞在
trpl::join的完成上------绕回了本列表第一条。
目前发送块只是借用(borrow)tx,因为发送消息不需要所有权;但把 tx 移动(move)进块,块一结束它就会被 drop。第 13 章你学过闭包上的 move 关键字,第 16 章在线程上经常用它把数据移进闭包------同样的机制适用于 async 块,move 用在两者上如出一辙。示例 17-12 把发送消息的块从 async 改成 async move。
rust
let (tx, mut rx) = trpl::channel();

let tx_fut = async move {
    // --省略--
示例 17-12:对示例 17-11 代码的修订版,完成后能正确退出
运行这个版本,程序会在最后一条消息发送并接收完毕后优雅退出。
用 join! 宏联结多个 Future
这条 async 通道是多生产者通道,想从多个 future 发消息,对 tx 调用 clone 即可(示例 17-13)。
rust
let (tx, mut rx) = trpl::channel();

let tx1 = tx.clone();
let tx1_fut = async move {
    let vals = vec![
        String::from("hi"),
        String::from("from"),
        String::from("the"),
        String::from("future"),
    ];

    for val in vals {
        tx1.send(val).unwrap();
        trpl::sleep(Duration::from_millis(500)).await;
    }
};

let rx_fut = async {
    while let Some(value) = rx.recv().await {
        println!("received '{value}'");
    }
};

let tx_fut = async move {
    let vals = vec![
        String::from("more"),
        String::from("messages"),
        String::from("for"),
        String::from("you"),
    ];

    for val in vals {
        tx.send(val).unwrap();
        trpl::sleep(Duration::from_millis(1500)).await;
    }
};

trpl::join!(tx1_fut, tx_fut, rx_fut);
示例 17-13:在多个 async 块中使用多个生产者
先克隆出 tx1,在第一个 async 块外创建、再移进块里;随后把原始 tx 移进一个新 async 块,以稍慢的节奏发送更多消息(这个新块恰好放在接收块之后,放前面也一样------关键在于 future 被 await 的顺序,而不是创建的顺序)。两个发送块都必须是 async move,tx 和 tx1 才会在各自块结束时被 drop,否则又是那个永不退出的死循环。最后从 trpl::join 换成 trpl::join! 宏:它可以 await 任意数量的 future,前提是数量在编译期已知------如何 await 数量未知的一组 future,本章稍后讨论。
现在两个发送方的消息都能收到,且因发送节奏略有不同,到达间隔也相应不同:
text
received 'hi'
received 'more'
received 'from'
received 'the'
received 'messages'
received 'future'
received 'for'
received 'you'
消息传递、async 块内的顺序执行、所有权移入块、联结多个 future------这些都探索完了。接下来:如何以及为什么要告诉运行时「可以切换到别的任务了」。
把控制权交还给运行时
回顾「我们的第一个 async 程序」:每个 await 点上,如果被等待的 future 还没就绪,Rust 就有机会暂停当前任务、切换到另一个。反过来也成立:Rust 只在 await 点暂停 async 块并交还控制权------两个 await 点之间的所有代码都是同步执行的。
这意味着,如果 async 块里是一大段没有 await 的工作,这个 future 就会挡住其他所有 future,不让它们取得任何进展------你有时会听到人们把这说成让其他 future「挨饿」。偶尔无伤大雅,但昂贵的初始化、长时间运行的工作、无限期执行某任务的 future,就必须认真考虑何时、何地把控制权交还运行时。
模拟一个长操作来说明「挨饿」问题:示例 17-14 引入 slow 函数。
rust
fn slow(name: &str, ms: u64) {
    thread::sleep(Duration::from_millis(ms));
    println!("'{name}' ran for {ms}ms");
}
示例 17-14:使用 thread::sleep 模拟慢速操作
它用 std::thread::sleep 而不是 trpl::sleep,这样调用 slow 就会真把当前线程阻塞若干毫秒------用它代指现实世界中既耗时又阻塞的操作。示例 17-15 用 slow 在一对 future 里模拟 CPU 密集型工作。
rust
let a = async {
    println!("'a' started.");
    slow("a", 30);
    slow("a", 10);
    slow("a", 20);
    trpl::sleep(Duration::from_millis(50)).await;
    println!("'a' finished.");
};

let b = async {
    println!("'b' started.");
    slow("b", 75);
    slow("b", 10);
    slow("b", 15);
    slow("b", 350);
    trpl::sleep(Duration::from_millis(50)).await;
    println!("'b' finished.");
};

trpl::select(a, b).await;
示例 17-15:调用 slow 函数模拟慢速操作
每个 future 都是在执行完一大批慢操作之后,才把控制权交还运行时。运行输出:
text
'a' started.
'a' ran for 30ms
'a' ran for 10ms
'a' ran for 20ms
'b' started.
'b' ran for 75ms
'b' ran for 10ms
'b' ran for 15ms
'b' ran for 350ms
'a' finished.
如同示例 17-5 中 select 竞速两个抓取任务时那样,select 仍在 a 一完成时就立即结束;但两个 future 里对 slow 的调用并没有交错------a 先做完它全部的工作直到 trpl::sleep 被 await,然后 b 做完全部工作直到自己的 sleep 被 await,最后 a 完成。想让两个 future 在各自的慢任务之间都推进,就需要 await 点来交还控制权------也就是说,需要某种可以 await 的东西!交接的迹象在示例 17-15 里就有:去掉 a 末尾的 trpl::sleep,它会直接完成,b 根本不会运行。
先试着把 trpl::sleep 当作让操作轮流推进的起点(示例 17-16)。
rust
let one_ms = Duration::from_millis(1);

let a = async {
    println!("'a' started.");
    slow("a", 30);
    trpl::sleep(one_ms).await;
    slow("a", 10);
    trpl::sleep(one_ms).await;
    slow("a", 20);
    trpl::sleep(one_ms).await;
    println!("'a' finished.");
};

let b = async {
    println!("'b' started.");
    slow("b", 75);
    trpl::sleep(one_ms).await;
    slow("b", 10);
    trpl::sleep(one_ms).await;
    slow("b", 15);
    trpl::sleep(one_ms).await;
    slow("b", 350);
    trpl::sleep(one_ms).await;
    println!("'b' finished.");
};
示例 17-16:使用 trpl::sleep 让操作轮流推进
在每次调用 slow 之间都插入了带 await 点的 trpl::sleep,两个 future 的工作就交错起来了:
text
'a' started.
'a' ran for 30ms
'b' started.
'b' ran for 75ms
'a' ran for 10ms
'b' ran for 10ms
'a' ran for 20ms
'b' ran for 15ms
'a' finished.
a 在把控制权交给 b 之前仍会先跑一小段(它先调了 slow 才 sleep),但此后每当一个 future 碰到 await 点,两个就来回切换。这里每步都插 await 点只是示意,实际完全可以按任何合理的方式拆分工作。
不过我们并不是真想睡一觉,只想尽快推进------把控制权交还运行时。trpl::yield_now 函数就是干这个的。示例 17-17 把那些 trpl::sleep 全部替换成 trpl::yield_now。
rust
let a = async {
    println!("'a' started.");
    slow("a", 30);
    trpl::yield_now().await;
    slow("a", 10);
    trpl::yield_now().await;
    slow("a", 20);
    trpl::yield_now().await;
    println!("'a' finished.");
};

let b = async {
    println!("'b' started.");
    slow("b", 75);
    trpl::yield_now().await;
    slow("b", 10);
    trpl::yield_now().await;
    slow("b", 15);
    trpl::yield_now().await;
    slow("b", 350);
    trpl::yield_now().await;
    println!("'b' finished.");
};
示例 17-17:使用 yield_now 让操作轮流推进
这版代码意图更清晰,也可能快得多:sleep 依赖的计时器往往有粒度下限,我们用的这版 sleep 至少睡 1 毫秒,哪怕传给它 1 纳秒也是如此------再说一遍,现代计算机非常快,1 毫秒之内能做很多事情。
这意味着即便对计算密集型任务,async 也可能派上用场(取决于程序还在做什么):它提供了一种组织程序各部分关系的有用工具,代价是异步状态机的开销。这是协作式多任务(cooperative multitasking)------每个 future 都有权通过 await 点决定何时交出控制权,也因此有责任避免阻塞太久。在一些基于 Rust 的嵌入式操作系统中,这甚至是唯一的多任务形式。
当然,真实代码里你不会让每行函数调用都与 await 点交替出现:让出控制权的开销虽低但不是零;许多时候拆分计算密集型任务反而更慢,让一个操作短暂阻塞对整体性能可能更好。永远以实测定位真正的瓶颈------但当你看到一大堆本以为会并发的工作在串行进行时,记得想想这背后的机制。
构建我们自己的异步抽象
future 还能组合出新模式:用手头的异步积木搭一个 timeout 函数,搭好之后它本身又成为新积木,可以构建更多异步抽象。示例 17-18 展示期望中它配合一个慢速 future 的表现。
rust
let slow = async {
    trpl::sleep(Duration::from_secs(5)).await;
    "Finally finished"
};

match timeout(slow, Duration::from_secs(2)).await {
    Ok(message) => println!("Succeeded with '{message}'"),
    Err(duration) => {
        println!("Failed after {} seconds", duration.as_secs())
    }
}
示例 17-18:用我们设想中的 timeout 按时间限制运行一个慢速操作
来实现它。先想 API 该长什么样:
- 本身是 async 函数,这样才能 await 它;
- 第一个参数是要运行的 future,做成泛型,配合任何 future 工作;
- 第二个参数是最长等待时间,用
Duration方便传给trpl::sleep; - 返回
Result:future 成功完成为Ok(携带其产出的值),超时先到为Err(携带超时时长)。
示例 17-19 给出声明。
rust
async fn timeout<F: Future>(
    future_to_try: F,
    max_time: Duration,
) -> Result<F::Output, Duration> {
    // 实现代码将写在这里!
}
示例 17-19:定义 timeout 的签名
类型目标满足了。行为上,我们要让传入的 future 与时长赛跑:用 trpl::sleep 把时长变成一个计时器 future,再用 trpl::select 让计时器与调用者的 future 一起运行,对 await 结果做 match(示例 17-20)。
rust
use trpl::Either;

// --省略--

async fn timeout<F: Future>(
    future_to_try: F,
    max_time: Duration,
) -> Result<F::Output, Duration> {
    match trpl::select(future_to_try, trpl::sleep(max_time)).await {
        Either::Left(output) => Ok(output),
        Either::Right(_) => Err(max_time),
    }
}
示例 17-20:用 select 和 sleep 定义 timeout
trpl::select 的实现并不公平:它总是按参数传入的顺序轮询(其他一些 select 实现会随机选先轮询哪个参数)。因此把 future_to_try 放在前面传,这样即便 max_time 非常短,它也有机会完成。目标 future 先结束,select 返回 Left,携带其输出,于是返回 Ok(output);计时器先到,返回 Right(()),用 _ 忽略那个 (),改而返回 Err(max_time)。
用另外两个异步小工具拼出了能用的 timeout。运行代码,超时后打印失败结果:
text
Failed after 2 secondsfuture 可以与其他 future 组合,小积木能搭出强大的工具------比如把超时与重试结合,再套到网络调用(示例 17-5 那种)上。实践中你通常直接用 async 和 await,其次才用 select 这样的函数、join! 这样的宏来控制最外层 future 的执行方式。
**编译注:**真实项目里更常接触到的是宏形态的竞速:
tokio::select!(以及futurescrate 的select!)用分支语法同时等待多个 future,先完成者胜、其余丢弃------本章的trpl::select是构建在futures::future::select之上的函数化简化版。顺带一提,timeout在 tokio 里也有现成的(tokio::time::timeout),只是参数顺序相反、Err里装的是Elapsed而非Duration;手写一遍的价值在于看清「竞速」不过是 select 加 sleep 的组合。
同时处理多个 future 的方式见过不少了。接下来看如何用流(stream)按时间先后依次处理一系列值。
流:按序排列的 Future
回看「消息传递」一节:异步的 recv 方法会随时间推移产生一系列项------这是流(stream)模式的一个实例。天然适合建模成流的东西很多:队列中陆续可用的项、数据集大到内存装不下时从文件系统增量读取的数据块、随网络陆续到达的数据。由于流本身就是 future,可以与其他任何 future 组合出有趣的用法:把事件攒批避免过多网络调用、给一系列长操作设置超时、给 UI 事件节流避免无谓的工作。
第 13 章学 Iterator trait 时就见过「一系列项」。迭代器与异步通道接收端有两点区别:一是时间维度------迭代器是同步的,接收端是异步的;二是 API------直接用 Iterator 时调用同步的 next,面对 trpl::Receiver 这个流则调用异步的 recv。这份相似并非巧合:流就像异步形式的迭代,只是通用流 API 的覆盖面比「专门等接收消息」宽得多------它像 Iterator 那样提供下一个项,只不过以异步的方式。
迭代器与流的相似性意味着:可以从任何迭代器创建流。用法也像使用迭代器------调用流的 next 方法再 await 其输出(示例 17-21),这段代码暂时编译不过。
rust
let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
let iter = values.iter().map(|n| n * 2);
let mut stream = trpl::stream_from_iter(iter);

while let Some(value) = stream.next().await {
    println!("The value was: {value}");
}
示例 17-21:从迭代器创建流并打印其值
从数字数组出发,转成迭代器,map 把所有值翻倍,trpl::stream_from_iter 把迭代器转换成流,while let 循环在项陆续到达时逐个遍历。遗憾的是编译器报没有可用的 next 方法:
text
error[E0599]: no method named `next` found for struct `tokio_stream::iter::Iter` in the current scope
  --> src/main.rs:10:40
   |
10 |         while let Some(value) = stream.next().await {
   |                                        ^^^^
   |
   = help: items from traits can only be used if the trait is in scope
help: the following traits which provide `next` are implemented but not in scope; perhaps you want to import one of them
   |
1  + use crate::trpl::StreamExt;
   |
1  + use futures_util::stream::stream::StreamExt;
   |
1  + use std::iter::Iterator;
   |
1  + use std::str::pattern::Searcher;
   |
help: there is a method `try_next` with a similar name
   |
10 |         while let Some(value) = stream.try_next().await {
   |                                        ~~~~~~~~
错误信息说得明白:要让 next 可用,相应的 trait 必须在作用域内。基于前面的讨论,你可能以为是 Stream,实际是 StreamExt------Ext 是 extension(扩展)的缩写,Rust 社区用另一个 trait 扩展某个 trait 的常见模式。
Stream 定义了一个底层接口,实际上把 Iterator 和 Future 两个 trait 合并到了一起;StreamExt 在其上提供一组更高层的 API,包括 next 方法,以及与 Iterator 工具方法相似的其他实用方法。两者目前都不在 Rust 标准库里,但生态中大多数 crate 采用类似的定义。修法是像示例 17-22 那样加一条引入 trpl::StreamExt 的 use 语句。
rust
use trpl::StreamExt;

fn main() {
    trpl::block_on(async {
        let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
        // --省略--
示例 17-22:成功地以迭代器为基础使用流
把这些部分拼到一起,代码就能按期望工作了。更棒的是,StreamExt 已在作用域内,它的全部工具方法都能像迭代器那样用。
细看异步相关 trait
本章以各种方式用了 Future、Stream、StreamExt 这些 trait,但一直回避它们如何工作、如何配合的细节------日常 Rust 开发大多不需要。偶尔你会撞上需要更多细节的场景,连带 Pin 类型和 Unpin trait。本节深入到恰好够用的程度,真正的深潜留给其他文档。
Future trait
先仔细看 Future trait 的定义:
rust
use std::pin::Pin;
use std::task::{Context, Poll};

pub trait Future {
    type Output;

    fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
一堆新类型加没见过的语法,逐块讲。
关联类型 Output 说明这个 future 最终会解析成什么,与 Iterator 的关联类型 Item 类似。Future 有一个 poll 方法:接收一个特殊的 Pin 引用作为 self、一个指向 Context 类型的可变引用,返回 Poll<Self::Output>。Pin 和 Context 稍后讨论,先看返回值 Poll:
rust
pub enum Poll<T> {
    Ready(T),
    Pending,
}
Poll 与 Option 相似:一个变体携带值(Ready(T)),另一个不携带(Pending),含义却大不相同------Pending 表示 future 还有工作要做、调用者稍后需要再查;Ready 表示工作已完成、T 值可用。
**提示:**很少需要直接调
poll。若真要调,记住:对大多数 future 来说,一旦返回过Ready,调用者就不应再次轮询------许多 future 就绪后再被轮询会 panic,可安全反复轮询的会在其文档中写明。这与Iterator::next的行为类似。
看到使用 await 的代码时,Rust 在底层会把它编译成调用 poll 的代码。回看示例 17-4(单个 URL 解析完成后打印标题),它大致(但不完全)会被编译成:
rust
match page_title(url).poll() {
    Ready(page_title) => match page_title {
        Some(title) => println!("The title for {url} was {title}"),
        None => println!("{url} had no title"),
    }
    Pending => {
        // 但这里该放什么?
    }
}
future 还是 Pending 时该做什么?需要某种方式一次又一次地重试,直到最终就绪------换句话说,需要一个循环:
rust
let mut page_title_fut = page_title(url);
loop {
    match page_title_fut.poll() {
        Ready(value) => match page_title {
            Some(title) => println!("The title for {url} was {title}"),
            None => println!("{url} had no title"),
        }
        Pending => {
            // 继续
        }
    }
}
可如果 Rust 恰恰编译成这样,每个 await 都会阻塞------与目标背道而驰。实际上,Rust 确保这个循环把控制权移交给某个「东西」,由它暂停对这个 future 的工作、去处理别的 future,之后再回头检查这一个。这个「东西」就是异步运行时,调度与协调正是它的主要工作之一。
回到「消息传递」一节等待 rx.recv 的情形:recv 调用返回一个 future,await 它就是在轮询它。有了对 Future trait(尤其 Future::poll)的理解,现在能说清了:poll 返回 Poll::Pending,运行时知道未就绪;返回 Poll::Ready(Some(message)) 或 Poll::Ready(None),运行时知道已就绪并推进它。运行时究竟如何做到,细节超出本书范围,但基本机制就一句:运行时轮询它负责的每一个 future,未就绪就让它们继续休眠。
Pin 类型与 Unpin trait
示例 17-13 用 trpl::join! 宏 await 了三个 future,但更常见的情形是数量要到运行时才能确定的集合(比如 vector)。把示例 17-13 改成示例 17-23:三个 future 放进 vector,改调 trpl::join_all 函数------这段代码暂时无法编译。
rust
let tx_fut = async move {
    // --省略--
};

let futures: Vec<Box<dyn Future<Output = ()>>> =
    vec![Box::new(tx1_fut), Box::new(rx_fut), Box::new(tx_fut)];

trpl::join_all(futures).await;
示例 17-23:await 集合中的多个 future
我们把每个 future 放进 Box 变成 trait 对象(trait object,第 12 章用过、第 18 章详讲),这样就能把这些匿名 future 当作同一种类型对待------它们都实现了 Future。意外之处在于:这些 async 块哪个都不返回值,个个都是 Future<Output = ()>,为什么不能混放?因为 Future 是 trait,编译器为每个 async 块创建独一无二的枚举,即使输出类型完全相同------正如你不能把两个不同的手写结构体放进同一个 Vec。
把集合传给 trpl::join_all 并 await 结果,无法编译,错误信息相关部分如下:
text
error[E0277]: `dyn Future<Output = ()>` cannot be unpinned
  --> src/main.rs:48:33
   |
48 |         trpl::join_all(futures).await;
   |                                 ^^^^^ the trait `Unpin` is not implemented for `dyn Future<Output = ()>`
   |
   = note: consider using the `pin!` macro
           consider using `Box::pin` if you need to access the pinned value outside of the current scope
   = note: required for `Box<dyn Future<Output = ()>>` to implement `Future`
note: required by a bound in `futures_util::future::join_all::JoinAll`
  --> file:///home/.cargo/registry/src/index.crates.io-1949cf8c6b5b557f/futures-util-0.3.30/src/future/join_all.rs:29:8
   |
27 | pub struct JoinAll<F>
   |            ------- required by a bound in this struct
28 | where
29 |     F: Future,
   |        ^^^^^^ required by this bound in `JoinAll`
提示告诉我们应该用 pin! 宏来钉住这些值:放进 Pin 类型,由它保证这些值不会在内存中被移动。之所以要求钉住,是因为 dyn Future<Output = ()> 需要实现 Unpin trait 而它没有。join_all 返回的 JoinAll 结构体对类型 F 泛型,约束 F: Future;用 await 直接等待一个 future 时会隐式钉住它,所以我们并非在每个 await 处都得写 pin!。但这里不是直接 await,而是把 future 集合传给 join_all 构造了一个新 future:其签名要求集合各项实现 Future,而 Box<T> 只有在包装的 T 是实现了 Unpin 的 future 时,才实现 Future。
要消化的不少。为了真正理解,再往深处看一点 Future 实际如何工作,尤其是钉住的部分。重看定义:
rust
use std::pin::Pin;
use std::task::{Context, Poll};

pub trait Future {
    type Output;

    // 必须实现的方法
    fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
cx 参数及其 Context 类型,是运行时在保持惰性的同时还能知道何时该检查某个 future 的关键,细节超出本章范围,一般只有编写自定义 Future 实现时才需要考虑。重点看 self 的类型------这是我们第一次见到 self 带类型标注的方法。它与其他参数类型标注原理相同,但有两点关键区别:
- 它告诉 Rust,要调用这个方法,
self必须是什么类型; - 它不能是任意类型,只能是:实现该方法的类型本身、指向该类型的引用或智能指针,或者包裹着指向该类型引用的
Pin。
这种语法第 18 章还会见到更多。眼下只需知道:要轮询一个 future、检查它是 Pending 还是 Ready(Output),我们需要一个被 Pin 包裹的、指向该类型的可变引用。
Pin 是一类「指针式」类型(&、&mut、Box、Rc......严格说,适用于实现了 Deref 或 DerefMut 的类型)的包装器。Pin 本身不是指针,也不像 Rc/Arc 那样自带引用计数之类的行为,纯粹是编译器对指针用法施加约束的工具。
想起 await 是通过调用 poll 实现的,我们开始能解释先前那条错误信息了------只是它从 Unpin 的角度说的。那 Pin 与 Unpin 究竟是什么关系?为什么 Future 要求 self 处于 Pin 之中才能调用 poll?
本章前面讲过:future 中的一系列 await 点会被编译成状态机,编译器确保这台状态机遵守 Rust 的全部常规安全规则(包括借用与所有权)。为此,Rust 考察从一个 await 点到下一个 await 点(或块尾)之间需要哪些数据,在状态机中创建对应的变体;每个变体获得它对那段代码所用数据所需的访问权------要么取得所有权,要么获得可变或不可变引用。到这一步都没问题:块内的所有权、引用错误,借用检查器照常兜底。麻烦出在想要移动与该块对应的 future 时------比如把它移进一个 Vec 传给 join_all。
移动 future 时------无论压进数据结构、供 join_all 使用,还是从函数返回------移动的其实是 Rust 为我们创建的那台状态机。而与 Rust 中大多数类型不同,async 块生成的 future 可能在某个给定变体的字段中持有指向自身的引用,如图 17-4 的简化示意。
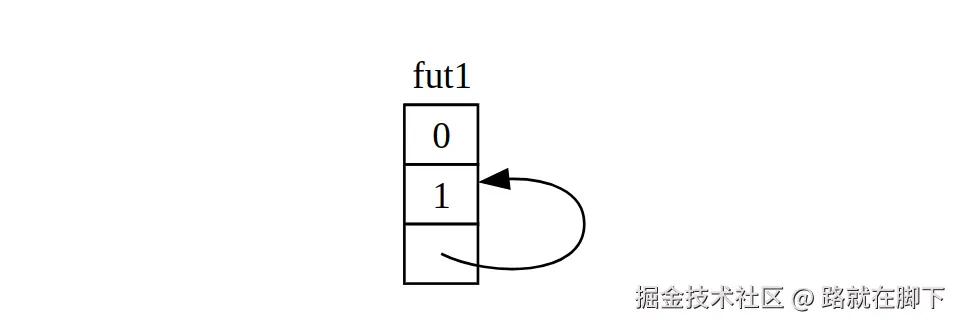
图 17-4:一个自引用的数据类型
自身持有引用的对象,默认不能安全移动:引用总是指向目标物的实际内存地址,数据结构一挪,内部引用还指着老位置------那块内存已经失效:一来,修改数据结构时那里的值不会再被更新;二来(更重要),计算机从此可以随意把那块内存用于其他用途,稍后你读到的可能是完全不相干的数据(图 17-5)。
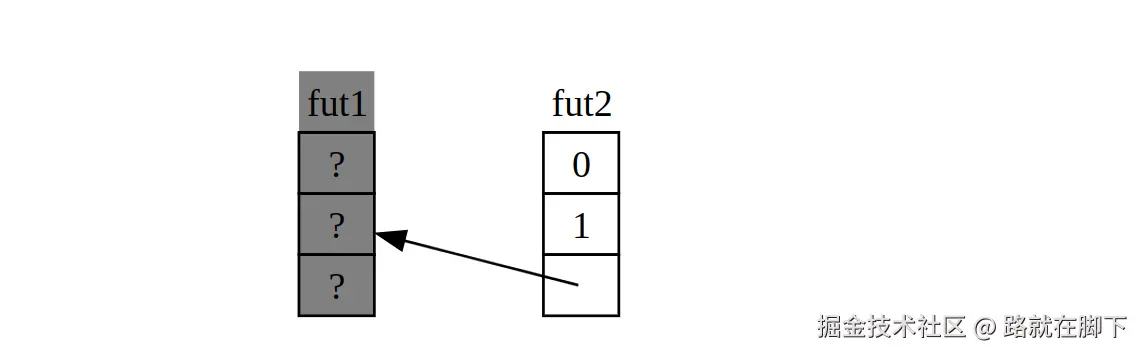
图 17-5:移动一个自引用数据类型的不安全结果
理论上,编译器可以尝试在对象每次移动时更新指向它的每一个引用,但开销可能很大------尤其当需要更新的是一大片相互交织的引用时。反过来,只要确保数据结构不在内存中移动,就根本不必更新任何引用。这正是借用检查器的意义:在安全代码中,它阻止你移动任何存在活跃引用的项。
Pin 在此基础上更进一步,给出恰好需要的保证:用 Pin 包裹一个指向某值的指针从而钉住该值,它就不能再移动。因此 Pin<Box<SomeType>> 里实际被钉住的是 SomeType 这个值,而不是 Box 指针(图 17-6)。
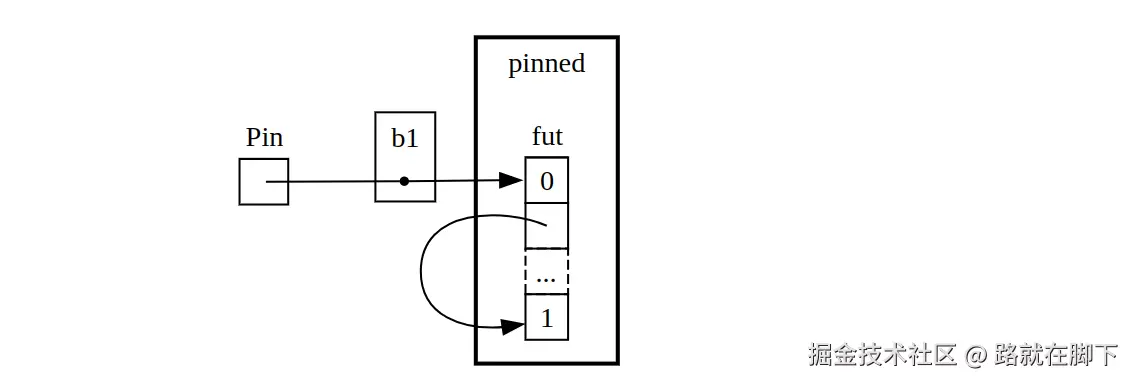
图 17-6:钉住一个指向自引用 future 类型的 Box
Box 指针仍然可以自由移动:我们关心的是确保最终被引用的数据留在原地------指针动了、它指向的数据还在原处,就没有潜在问题(图 17-7;作为独立练习,可查阅这些类型及 std::pin 模块的文档,想清楚如何用包裹着 Box 的 Pin 做到)。关键是自引用类型本身被钉着,不能移动。
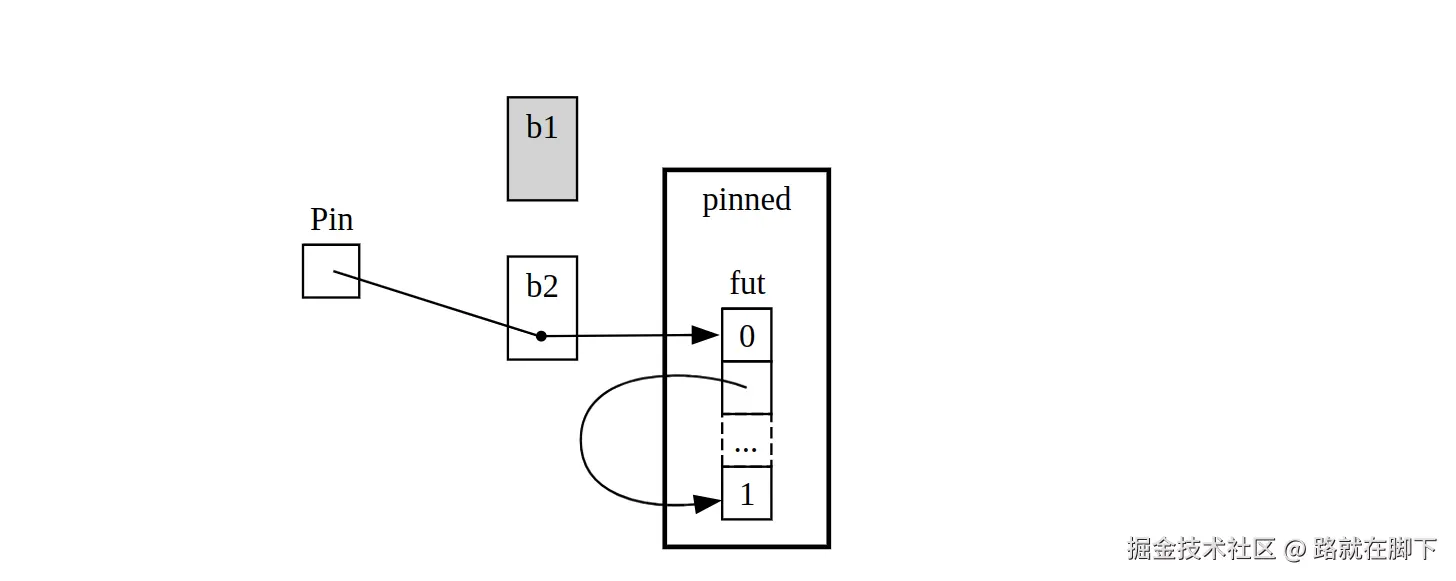
图 17-7:移动一个指向自引用 future 类型的 Box
不过,大多数类型即便碰巧位于 Pin 指针之后,移动起来也完全安全:只有当项内部存在引用时才需要考虑钉住。数字、布尔这样的原始值显然安全------它们没有任何内部引用;你日常打交道的大多数类型同样如此,比如移动一个 Vec 毫无顾虑。于是尴尬出现了:拿着 Pin<Vec<String>>,明明 Vec<String> 永远可以安全移动,却只能用 Pin 那套安全但受限的 API。需要一种方式告诉编译器「这类情况移动没问题」------这正是 Unpin 的用武之地。
Unpin 是一个标记 trait(marker trait),与第 16 章的 Send 和 Sync 类似,自身没有任何功能,存在只是为了告诉编译器:在特定上下文中使用实现了给定 trait 的类型是安全的。Unpin 告诉编译器:给定类型不需要遵守任何关于相应值能否被安全移动的保证。与 Send/Sync 一样,编译器能证明安全的地方都会自动实现 Unpin;也有反面写法 impl !Unpin for SomeType------这种类型每当其指针被放进 Pin 使用时,确实需要遵守上述保证才能安全。
关于二者关系,记两点:第一,Unpin 是「正常」情况,!Unpin 是特殊情况;第二,一个类型实现 Unpin 还是 !Unpin,只有在你对该类型使用被钉住的指针(如 Pin<&mut SomeType>)时才有关系。
说得更具体点,想想 String:一个长度加一堆 Unicode 字符。可以把一个 String 包进 Pin(图 17-8),但 String 会自动实现 Unpin------Rust 大多数类型都如此。
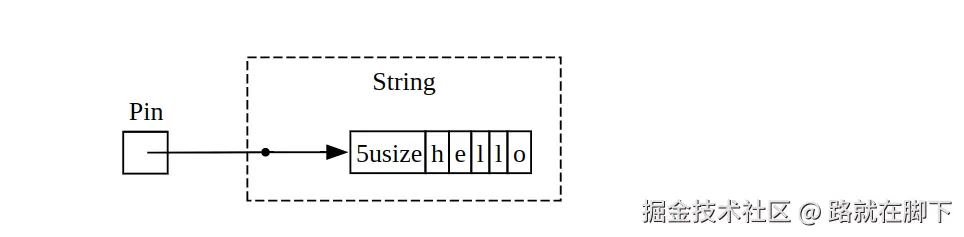
图 17-8:钉住一个 String;虚线表明该 String 实现了 Unpin trait,因此并没有被钉住
于是我们可以做一些「假如 String 实现的是 !Unpin 就会非法」的事,比如在内存中完全相同的位置用一个字符串替换另一个(图 17-9)。这不违反 Pin 的契约,因为 String 没有任何会让它移动起来不安全的内部引用------这恰恰是它实现 Unpin 而非 !Unpin 的原因。
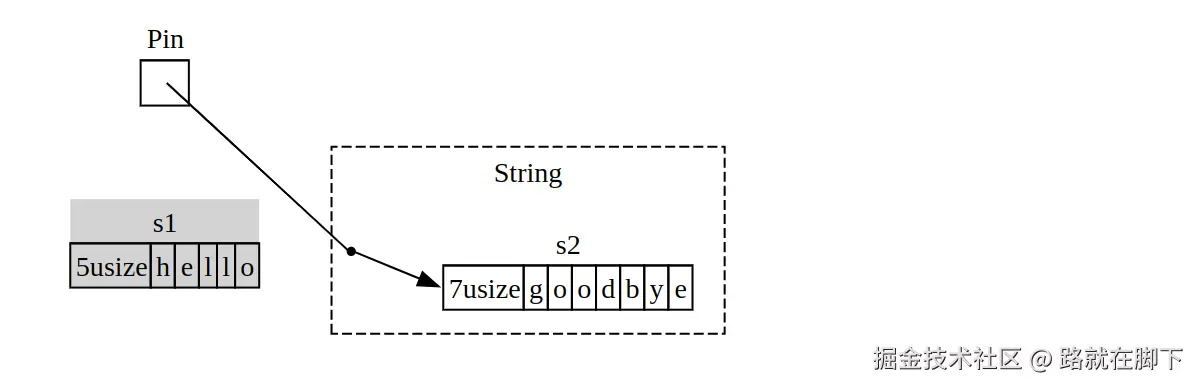
图 17-9:在内存中用一个完全不同的 String 替换原来的 String
**编译注:**为什么 C++20 不需要 Pin 这类东西?因为 C++ 把协程帧放进堆上分配的独立存储(编译器优化恰当时可以省掉分配),帧内引用天然稳定。Rust 反其道而行:future 就是普通的、可移动的值,能存进变量、结构体、
Vec------代价是必须在类型系统里表达「这个值从此不许再动」。两种取舍各有成本,Rust 方案的好处是把内存分配的决策权留给了使用者。
现在可以理解示例 17-23 那次 join_all 报的错了:async 块产生的 future 可能带内部引用,所以不会自动实现 Unpin;一旦钉住,得到的 Pin 类型就能放进 Vec,并确信 future 中的底层数据不会被移动。示例 17-24 是修法:在三个 future 各自定义处调用 pin! 宏,并调整 trait 对象的类型。
rust
use std::pin::{Pin, pin};

// --省略--

        let tx1_fut = pin!(async move {
            // --省略--
        });

        let rx_fut = pin!(async {
            // --省略--
        });

        let tx_fut = pin!(async move {
            // --省略--
        });

        let futures: Vec<Pin<&mut dyn Future<Output = ()>>> =
            vec![tx1_fut, rx_fut, tx_fut];
示例 17-24:钉住这些 future,使它们能被移进 vector
这个示例现在可以编译运行了,而且还能在运行时向 vector 添加或从中移除 future,再把它们全部 join 起来。
Pin 和 Unpin 主要对构建较底层的库、或构建运行时本身的人重要,对日常 Rust 代码不那么要紧------不过,下次在错误信息里见到这些 trait 时,你就更清楚该怎么修代码了。
提示:
Pin与Unpin的组合,让 Rust 能安全实现一整类因自引用性质而颇具挑战的复杂类型。如今需要Pin的类型最常出现在异步 Rust 里,偶尔也在其他场景出现。
Pin、Unpin 具体如何工作、必须遵守哪些规则,std::pin 的 API 文档讲得最全,是绝佳起点。想更细致地了解底层机制,可读《Asynchronous Programming in Rust》的第 2 章与第 4 章。
Stream trait
有了 Future、Pin、Unpin 的底子,把注意力转到 Stream trait 上。如本章前面所学,流类似于异步的迭代器;不过与 Iterator 和 Future 不同,截至成书之时 Stream 在标准库中还没有定义,但 futures crate 提供了整个生态广泛使用的通行定义。
先回顾 Iterator 和 Future,再看 Stream 如何把二者融合:Iterator 给「序列」概念,next 提供 Option<Self::Item>;Future 给「随时间推移而就绪」概念,poll 提供 Poll<Self::Output>。表示「随时间依次就绪的一系列项」,把两种特性合在一起:
rust
use std::pin::Pin;
use std::task::{Context, Poll};

trait Stream {
    type Item;

    fn poll_next(
        self: Pin<&mut Self>,
        cx: &mut Context<'_>
    ) -> Poll<Option<Self::Item>>;
}
Stream 定义了关联类型 Item 表示流所产生项的类型------这一点像 Iterator(项数零到多个),不像 Future(永远只有一个 Output,哪怕是单元类型 ())。它还定义了获取这些项的方法,叫 poll_next:像 Future::poll 那样轮询、像 Iterator::next 那样产生序列。返回类型把 Poll 与 Option 组合:外层是 Poll,因为它必须像 future 一样接受就绪检查;内层是 Option,因为它必须像迭代器一样示意后面还有没有更多。
与此非常相似的定义,将来很可能进入 Rust 标准库;在那之前,它已经是大多数运行时工具箱的一部分,可以放心依赖。
不过在「流」一节的示例里,我们用的既不是 poll_next 也不是 Stream,而是 next 和 StreamExt。当然可以基于 poll_next API 手写自己的流状态机(正如可以直接通过 poll 操作 future),但 await 舒服得多,而 StreamExt trait 提供了 next 方法让我们如愿:
rust
trait StreamExt: Stream {
    async fn next(&mut self) -> Option<Self::Item>
    where
        Self: Unpin;

    // 其他方法......
}
**提示:**本章前面实际使用的定义与此略有不同------为了兼容尚不支持 trait 中 async 函数的 Rust 版本,它长这样:
rust
fn next(&mut self) -> Next<'_, Self> where Self: Unpin;Next 类型是一个实现了 Future 的结构体,借助 Next<'_, Self> 为指向 self 的引用命名生命周期,从而使 await 能配合这个方法工作。
StreamExt 也是所有可用于流的实用方法的大本营。每个实现了 Stream 的类型都会自动实现 StreamExt,但两个 trait 分开定义,是为了让社区可以在不影响基础 trait 的情况下迭代便利 API。在 trpl 用的那版 StreamExt 中,该 trait 不仅定义 next 还提供默认实现(正确处理调用 Stream::poll_next 的各项细节)------所以即使你要编写自己的流式数据类型,也只需实现 Stream,使用者自动获得 StreamExt 及其全部方法。
底层细节就讲到这里。最后看 future(包括流)、任务与线程如何环环相扣、协同工作。
融会贯通:Future、任务与线程
第 16 章给了线程这一种并发方式,本章见识了另一种:async 配合 future 与流。什么时候选哪种?看情况------而且在很多场合,选择不是线程或 async,而是线程和 async。
许多操作系统提供基于线程的并发模型已有几十年,语言也随之支持线程,但线程不是免费的:在不少系统上每个线程占用的内存相当可观;而且只有操作系统和硬件都支持,线程才是可选项------一些嵌入式系统根本没有操作系统,自然也没有线程。async 提供另一套权衡,且最终与线程互补:并发操作不必各自占用线程,而是运行在任务(task)上------如同本章用 trpl::spawn_task 从一个同步函数中启动工作那样。任务与线程类似,但管理它的不是操作系统,而是库层面的代码:运行时。
创建线程与创建任务的 API 之所以相似,是有原因的:线程是一组同步操作的边界,并发发生在线程之间 ;任务是一组异步操作的边界,并发既可发生在任务之间 ,也可发生在任务内部(任务可以在体内的各个 future 之间切换);future 是 Rust 粒度最细的并发单元,每个 future 又可能表示一棵由其他 future 组成的树。整体层级如下:
text
操作系统
└── OS 线程(第 16 章:同步操作的边界,由 OS 调度)
    └── 运行时(执行器,多线程 + 工作窃取)
        ├── 任务 1(异步操作的边界)
        │   └── future 树(async 块、await 链......最细粒度的并发单元)
        ├── 任务 2
        │   └── future ......
        └── ......
运行时------具体说是其中的执行器------管理任务,任务管理 future:任务类似于由运行时而非操作系统管理的轻量级线程,并因此获得一些额外能力。但这不意味着异步任务总比线程好(反过来也不成立):以线程做并发在某些方面是更简单的编程模型,这既可能是优点也可能是缺点------线程多少有些「点火就不管」(fire and forget)的味道:没有与 future 对应的原生概念,只会一路运行到结束,除了操作系统本身,谁也不会打断它们。
事实上,线程与任务往往配合得很好,因为任务可以(至少在某些运行时中)在线程之间迁移。我们一直用的运行时------包括 spawn_blocking 和 spawn_task 函数------底层默认就是多线程的。许多运行时采用工作窃取(work stealing)技术,按各线程当前的繁忙程度透明地在线程间搬运任务以提升整体性能------这种做法恰恰同时需要线程和任务,因而也需要 future。
考虑该用哪种方式时,参考这些经验法则:
- 如果工作高度可并行(CPU 密集型),比如处理一批数据、每一部分都能单独处理------线程是更好的选择;
- 如果工作高度并发(I/O 密集型),比如处理来自一堆不同来源的消息,可能以不同的间隔或速率到来------async 是更好的选择。
既需要并行又需要并发?不必二选一,让各自扮演最擅长的角色。示例 17-25 是真实 Rust 代码中相当常见的一种混搭。
rust
use std::{thread, time::Duration};

fn main() {
    let (tx, mut rx) = trpl::channel();

    thread::spawn(move || {
        for i in 1..11 {
            tx.send(i).unwrap();
            thread::sleep(Duration::from_secs(1));
        }
    });

    trpl::block_on(async {
        while let Some(message) = rx.recv().await {
            println!("{message}");
        }
    });
}
示例 17-25:在线程中用阻塞代码发送消息,并在 async 块中 await 这些消息
先创建异步通道,再用 move 关键字创建一个取得发送端所有权的线程,线程里发送 1 到 10、每发一个睡 1 秒;最后把 async 块创建的 future 传给 trpl::block_on 运行(与整章做法一致),在那个 future 里 await 这些消息,与之前所有消息传递示例一样。
回到本章开头的场景:用专门的线程跑一组视频编码任务(视频编码是计算密集型的),同时用异步通道通知 UI 这些操作已完成------真实用例里,这类组合数不胜数。
小结与下一步
- 并发不等于并行:async 提供的是「暂停/恢复」式的并发,单核也能跑;底层是否并行由运行时决定
- Future 是惰性的:不 await 不执行,与迭代器同款设计;
async fn只是「返回实现Future的匿名类型」的语法糖 - Rust 不内置运行时:
block_on负责搭桥,同步与异步世界的交界由你自己选定 - 每个 await 点都是一次让出:没有 await 的长计算会饿死其他 future,需要
yield_now主动交还控制权 Pin/Unpin服务于自引用的 future 状态机------下次编译器让你pin!,你知道为什么- 选型口诀:CPU 密集用线程,I/O 密集用 async,两者可以也经常混用;第 21 章的最终项目会在更真实的场景里再综合演练
下一篇:第 18 章「面向对象语言特性」------Rust 没有类和继承,却装得下 OOP 的全部要义。