从一纸刚落地的新判例和一部施行三年的规章说起
一场刚判下来的官司:为了赶工用了 AI,一个月后丢了工作
就在上周(10 月 12 日),北京市朝阳区人民法院披露了一桩劳动争议案件:某保险公司法务吴女士,在领导推荐下把公司稽核数据表上传到第三方 AI 平台做 PPT,一个月后被公司以"严重违反规章制度、存在重大泄露风险"为由辞退。
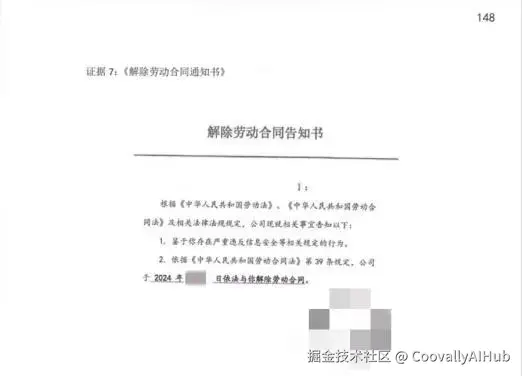
图片来源于:中国青年报
法院一审的判决是:公司违法解除,赔偿。
理由是三个"没有"------没有主观故意、没有明确禁令、没有实际损害。
判决刚落地,评论区已经吵翻。有人替企业叫屈:万一日后真泄露了呢?有人替员工喊冤:我明明是为了干活。
但真正该睡不着觉的,是那些还没建立 AI 使用规则 的企业。因为早在 2023 年,三星的三位半导体工程师就在 20 天内先后把源代码贴进了 ChatGPT,公司随即全面禁用生成式 AI 工具------没有人攻击他们,他们只是想省十分钟。
IBM 2026 年《数据泄露成本报告》给出了一个更扎心的数字:"影子 AI"(员工私用未经授权的 AI 工具)引发的事件占比已达56%,单起平均成本 499 万美元。
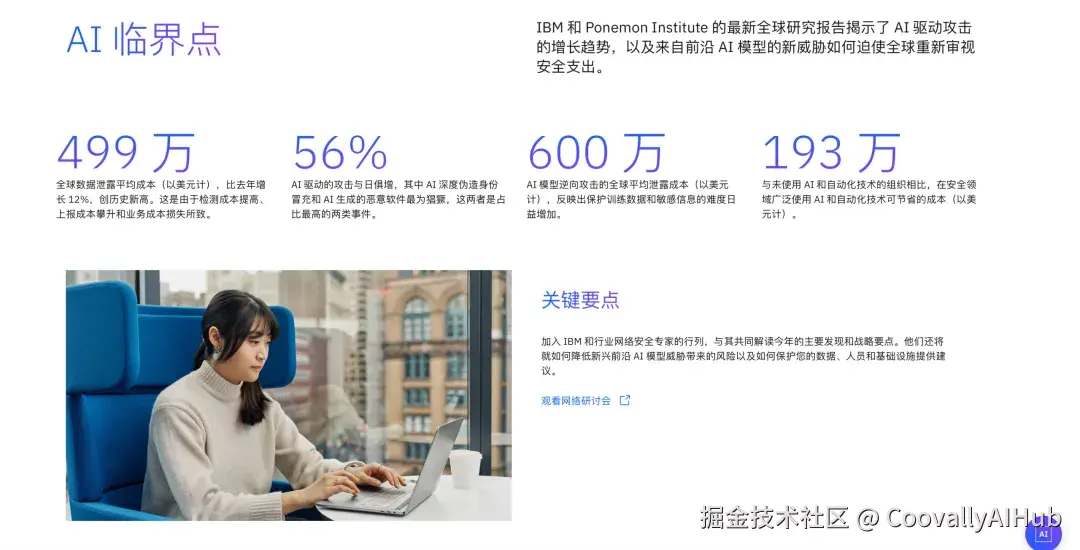
所以问题不是"员工该不该用 AI",而是------出了事,到底谁负责?
责任边界,规章早就写清了:两条条款,三句话
2023 年 8 月 15 日起施行的《生成式人工智能服务管理暂行办法》,把责任边界划得很明白。
第九条规定: "提供者应当依法承担网络信息内容生产者责任,履行网络信息安全义务。涉及个人信息的,依法承担个人信息处理者责任,履行个人信息保护义务。提供者应当与注册其服务的生成式人工智能服务使用者签订服务协议,明确双方权利义务。"
第十一条规定: "提供者对使用者的输入信息和使用记录应当依法履行保护义务,不得收集非必要个人信息,不得非法留存能够识别使用者身份的输入信息和使用记录,不得非法向他人提供使用者的输入信息和使用记录。"
翻译成企业听得懂的话,就是三件事:
① AI 服务商是第一责任人。 用户贴进对话框的资料,服务商必须保护,不能乱收、乱存、乱给别人。这意味着------如果一家 AI 工具说不清"你的数据去了哪",企业根本没有理由选它。
② 服务协议必须签、必须讲清楚。 没有《用户协议》或条款模糊的 AI 工具,本身就违反《办法》。
③ 员工不是法外之地,但企业也不能"一刀切甩锅"。 吴女士案已经说明:企业未明文禁止、未做培训、未划红线,就不能事后立规倒追员工。
四条底线:企业现在就该划清的红线
把《办法》和司法判例合起来看,企业在员工使用 AI 这件事上,有四条底线必须划清------
底线一:没有"涉密清单"的,赶紧补。 哪些数据可以贴进 AI、哪些绝对不行(核心机密、未公开数据、涉密文件、客户个人信息),必须白纸黑字写清楚。没有清单,出了事谁都说不清。
底线二:没有"AI 使用管理办法"的,抓紧立。 不禁止用 AI,但要规定用哪些 AI、在什么场景用、数据是否可留存在云端。朝阳法院判决已经说明,"事后立规"在法律上站不住脚。
底线三:选 AI 工具时,把"数据去向"问清楚。 这是《办法》第 11 条直接赋予企业的权利。如果一家工具回答不了"输入的数据存在哪、会不会用于训练、能不能随时删",直接出局。
底线四:对员工,要有培训、有留痕、有边界。 培训做了、操作记录留存了、红线划清了,员工再踩线,责任才真正归员工。这三样缺一样,企业就要自己兜底。
第 11 条里藏着一条"合规捷径":数据不出本机
把《办法》第 11 条拆开看,你会发现一条隐藏的逻辑: "不得非法留存能够识别使用者身份的输入信息和使用记录"
反过来说------如果一项 AI 工具根本不留存用户输入、不识别用户身份,它在合规层面天然占据了高地。
这也是为什么,越来越多的企业 IT 部门在选型时,会优先把"本机处理 / 数据不出域"这类特性写进采购标准。数据没离开过公司电脑,很多争议在源头就不成立。
以 CoCo 这类主打"授权范围内读取、本机处理、权限可关闭"的智能助手为例,它在产品设计上对应了三条企业关心的点:只读取授权范围、处理留本机、权限面板可查可关------这些能力本质上不是功能卖点,而是《办法》第 11 条在产品层的落地方式。具体边界以产品内权限面板展示为准,建议企业选型前做一次实测。
吴女士案没有输家也没有赢家,它只是把一个问题摆上了台面:
AI 办公已经是大势,挡是挡不住的。企业怕的不是"用 AI",而是"用 AI 导致失控"。
真正解法的成本,其实远低于一次数据泄露------
- 给员工一份涉密清单
- 给公司一份AI 使用办法
- 给采购一份数据去向核查表
这三份文件,加起来不超过 20 页 A4 纸,却能挡住 499 万美元级别的合规成本。
员工贴进对话框的每一个字,都值得被认真对待。
 Coco官网:coco.sinoaus.net