MOSS-Image 开源后爆火:5B 生图模型真正值得关注的,是可控排版
10 月 23 日晚,一款国产开源图像模型重新进入开发者视野:MOSS-Image 在海外社区的下载量快速上升,围绕 ComfyUI、量化、LoRA 和加速推理的适配也开始出现。这个传播节点是新的,但模型本身并非当天刚发布------官方仓库显示,代码与权重于 10 月 16 日公开,技术报告在 10 月 19 日上线,API 在 10 月 20 日开放。到本文写作时,GitHub 仓库约有 1600 个 Star;Hugging Face 的 ComfyUI 权重仓库累计下载已超过 160 万次。
这组数字说明社区关注度很高,却不能直接证明模型质量领先。MOSS-Image 真正值得开发者研究的,不是"又一个能生成漂亮图片的模型",而是它尝试把长文本渲染、显式布局控制和开放权重放进同一套工程链路。对于海报、电商图、内容封面和自动化营销素材,这三件事往往比单张样图是否惊艳更重要。
新变化是什么:社区扩散,而不是模型今天才发布
先把时间线说清楚。
- 10 月 16 日,OpenMOSS 团队发布 MOSS-Image-Base 与 MOSS-Image-SFT,并公开代码和模型权重;
- 同日,SGLang、vLLM-Omni 与 ComfyUI 出现首日适配;
- 10 月 19 日,技术报告提交至 arXiv;
- 10 月 20 日,官方 API 上线;
- 10 月 23 日,中文媒体集中报道其在海外社区的扩散,量化、低步数蒸馏、LoRA 训练及不同工作流开始增多。
因此,更准确的描述是:MOSS-Image 在开源一周后进入社区扩散期。把它写成"当天突发发布"会混淆模型发布时间与传播时间。
截至本文写作时,GitHub 官方仓库显示约 1625 个 Star,许可证标注为 Apache-2.0;MOSS-Image-Base与MOSS-Image-SFT两个官方模型页分别显示约 5600 和 7600 次下载,而用于 ComfyUI 的社区权重仓库已经超过 160 万次下载。不同仓库的统计口径不一致,不能简单相加,更不能把下载次数等同于独立用户数。
量子位的独立报道提到,社区已经开始制作 8 步、4 步加速版本、INT8 与 GGUF 量化、LoRA 和 ComfyUI 工作流,也有人用相同提示词将它与其他模型比较。这些自发适配比单一榜单更能说明一个开源项目是否开始形成生态,但它们仍属于社区反馈,不是严格的第三方基准。
它解决的不是"更会画",而是生成系统的可控性
MOSS-Image 技术报告将问题定义得很明确:开放权重的文生图模型在密集文字和复杂布局上仍然存在差距。团队因此组合了三个关键部件:一个 5B 参数的单流 DiT、双语长文本渲染能力,以及把用户请求转换为详细内容和布局规格的提示词增强模块。
这里最值得关注的是"布局规格"。传统文生图主要依赖自然语言,例如:
标题放在左上角,产品在右侧,底部加一行说明。
提示词越长,位置、文字、物体和视觉风格越容易互相干扰。MOSS-Image 增加了 JSON Layout 输入,可以把文字、物体和边界框拆成结构化字段,并用坐标描述位置。它不是设计软件那样的确定性排版引擎,但至少把"希望模型自己领会构图"变成了"向模型传递显式空间约束"。
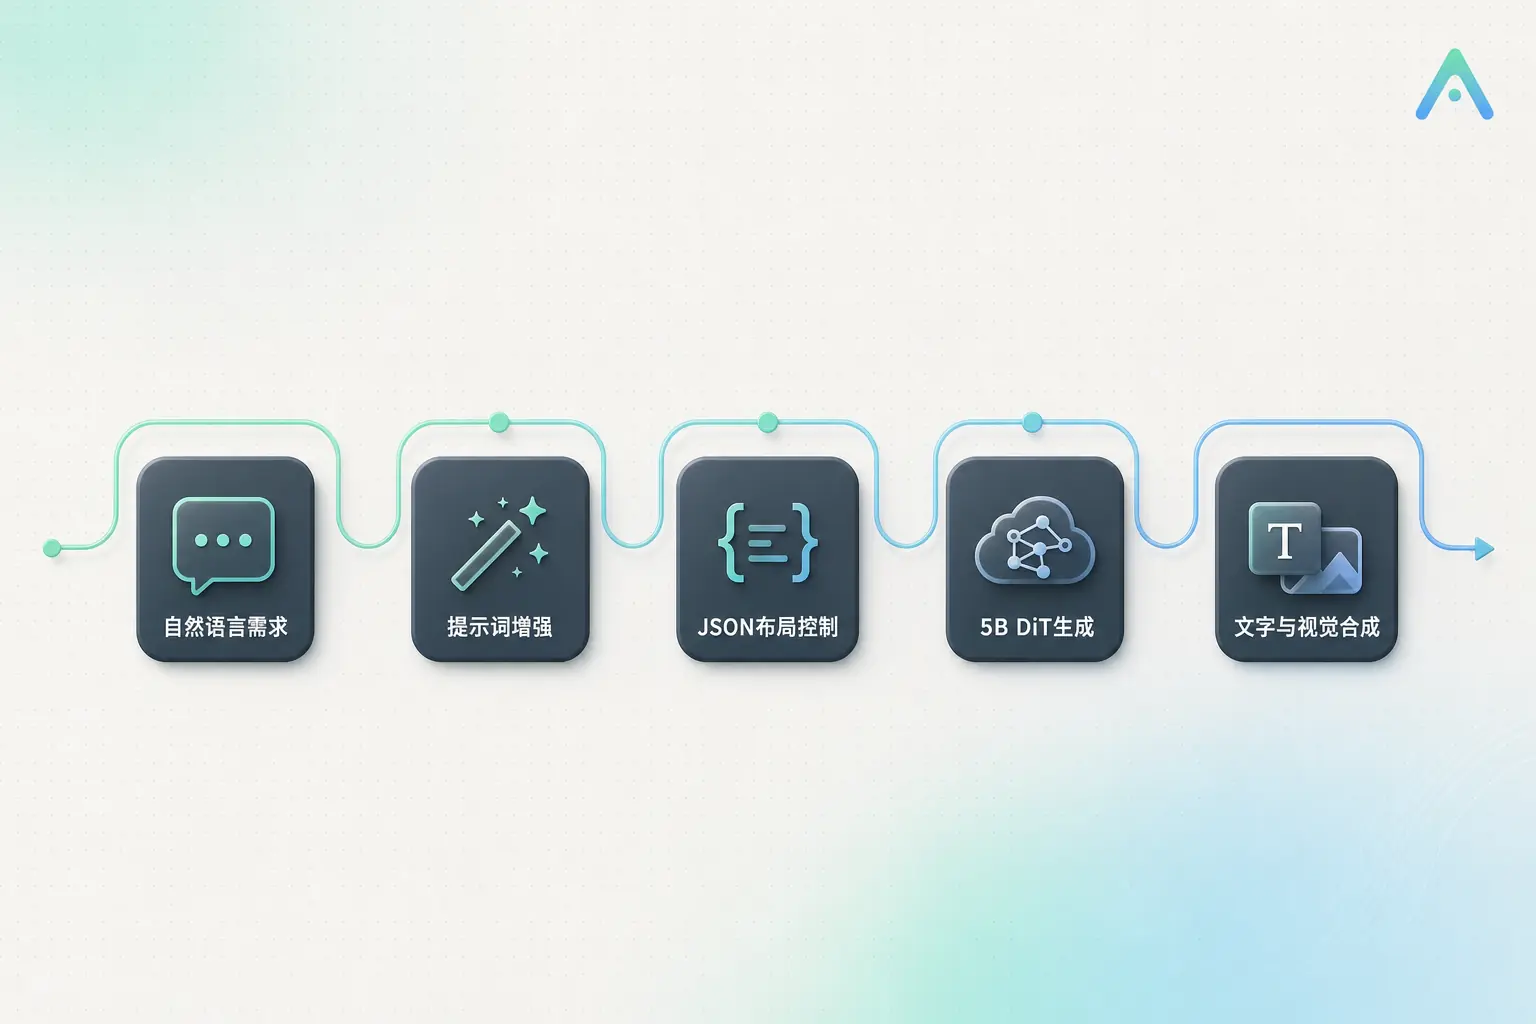
这条链路可以理解为:
- 用户给出自然语言需求;
- 提示词增强模块补全内容、风格与空间关系;
- JSON Layout 固定关键文字和物体的大致位置;
- 5B DiT 完成视觉生成;
- 生成结果进入检查、编辑或批量生产流程。
这对开发者的意义,是把图像生成从一次性"抽卡"往可编排组件推进。工作流可以保存布局模板、替换文案、批量生成多个尺寸,并在生成后做 OCR、拼写检测和品牌规范校验。模型仍然负责像素合成,但应用层开始拥有更明确的控制接口。
论文结果应该怎么看
官方报告称,MOSS-Image 在团队提出的 LongLongTextBench(LLTB)上取得 96.3% 的平均文本覆盖率,并在开放权重模型中达到最佳结果;在 RealLayoutArena(RLA)的端到端系统比较中排名第二,在使用统一增强提示词比较生成器时,其骨干模型排名第一。
这些结果有价值,但需要三个限定。
第一,覆盖率不等于逐字正确率。目标文字出现在图片中,不代表每一个汉字、标点、数字和换行都完全准确。真实海报还要求字体层级、对齐、可读性和品牌一致性,这些不是一个覆盖率指标能够完整表达的。
第二,LLTB 与 RLA 都由同一研究团队提出。论文公开了评测定义,有利于复现,但在更多独立团队完成交叉验证前,结论更适合表述为"官方评测显示",而不是"已经证明全面领先"。
第三,图像模型的平均分不能替代具体业务验收。电商价格、药品名称、合同条款、活动日期等文本一旦写错,后果远高于普通插画中的瑕疵。精确文案仍应由排版工具叠加,或至少经过 OCR 与人工复核。
换句话说,MOSS-Image 的贡献不是让后处理消失,而是提高了模型直接完成复杂构图的上限,让"生成草稿---机器检查---局部修改---人工确认"这条链路更可行。
开放权重之外,还有几个工程细节
官方仓库给出的默认推理配置是 Flow-matching Euler、50 步、CFG 3,并提供 Diffusers 与 ComfyUI 用法。仓库还列出了三种显存策略:模型常驻 GPU、组件级 CPU/GPU 切换,以及更省显存但速度更慢的顺序卸载。官方没有在 README 中承诺某一张消费级显卡即可稳定运行所有分辨率,因此部署前仍要基于目标尺寸、精度和并发量实测。
另一个有现实意义的点是微调。官方列出的社区训练工具已经支持 LoRA、完整微调、多 GPU、CPU offload 和多种低精度模式,其中第三方项目声称适配器训练最低可在 6GB 显存上进行。这里应注意:这是特定社区工具给出的能力说明,不等于官方对所有任务、分辨率和训练配置的统一保证。
许可证方面,GitHub 仓库和 Hugging Face 模型卡目前均标注 Apache-2.0。对企业来说,这比"可以免费下载"更重要,但上线前仍应分别审查代码、权重、依赖组件与训练数据声明,尤其是仓库提到使用了 Qwen 与 FLUX 相关组件,不能只看顶层仓库的一行许可证就完成合规判断。
对开发者和产品团队的实际影响
1. 海报与内容封面可以从"生成图片"升级为"生成模板"
如果产品需要每日生成不同标题、人物或商品的封面,最稳妥的做法不是保存一条超长提示词,而是把背景风格、标题区域、主体区域和品牌元素拆成结构化模板。MOSS-Image 的 JSON Layout 为这种做法提供了直接入口。
2. 文本能力越强,自动质检越重要
过去模型不擅长文字,团队通常会直接使用前端或设计工具叠字;当模型开始"看起来能写字",最危险的情况反而是细小错误不容易被察觉。建议在流水线中加入 OCR 回读、字符串比对、敏感数字检查和缩略图可读性检测。对不可错的文本,仍然优先采用确定性排版。
3. 5B 尺寸降低了实验门槛,但不等于低成本生产
参数量较小有利于本地部署、微调和社区适配,却不能直接推导出低延迟。50 步采样、目标分辨率、VAE、文本编码器、显存交换和并发策略都会影响吞吐。采购或自建前,至少要测首图延迟、稳定吞吐、峰值显存、失败重试率和单位合格图片成本。
4. 选择 Base 还是 SFT,取决于任务
SFT 版本更偏向开箱即用,官方示例强调它在文字分组和白板布局上的改善;Base 版本更适合需要训练自有风格或垂直能力的团队。内容团队可以先从 SFT 与 ComfyUI 工作流验证,平台团队则应保留 Base 版本的微调评估。
我的判断:它值得试,但别把下载量当成质量结论
MOSS-Image 目前最强的信号不是某张样图,而是发布后很快获得了推理框架、ComfyUI、量化与训练工具的适配。这说明它的尺寸、开放方式和能力组合击中了开发者需求。
但现阶段也不宜得出"国产开源生图模型全面超过闭源系统"的结论。官方基准需要更多独立复现,密集文字仍需逐字校验,本地推理成本也必须在真实硬件上测量。下载量高说明分发成功,不说明每次生成都达到生产标准。
对准备评估的团队,我建议按下面的顺序推进:
- 选取 30---50 个真实业务提示词,而不是只看官方样图;
- 分开评测中文、英文、数字、长段落和复杂布局;
- 对 Base、SFT 及现有商用 API 做盲测;
- 记录文字正确率、布局合格率、延迟、显存和人工返工时间;
- 把 JSON Layout、OCR 回读和确定性叠字组合成混合流水线;
- 完成模型权重、代码依赖、数据来源和输出内容的合规审查。
如果这套评估能通过,MOSS-Image 的价值就不只是"免费替代某个闭源模型",而是给团队一个可以控制、修改、部署和继续训练的图像生成底座。对真正要把生成式图像接进产品的人来说,这比一轮榜单排名更重要。
参考资料
- MOSS-Image 官方 GitHub 仓库
- MOSS-Image Technical Report(arXiv)
- MOSS-Image-Base 模型卡
- MOSS-Image-SFT 模型卡
- Comfy-Org / MOSS-Image
- 量子位:国产 5B 生图模型海外社区讨论
- Ace Data Cloud Platform
本文仅代表作者观点,仅供参考