不引 Ghostscript:我用纯 Go 给 PDF 做了一场「压缩手术」
先从一个具体场景说起。
内网办公的电脑上,一份材料要交:对面系统只收 5MB 以内的附件,手里这份十几页的扫描件 PDF 是 40MB------A4 纸按 300 DPI 扫,一页就是两三 MB,页数一多轻松翻十倍。
这时候能想到的路基本都不通。在线压缩网站,内网打不开;就算打得开,报销单、合同、证件的扫描件也不该往陌生服务器上传。程序员的答案通常是 Ghostscript,一条命令的事------但如果你做的是要分发给别人用的桌面工具,它就是个外部进程:macOS、Windows、银河麒麟每个平台打包一份,AGPL 许可要评估,装在内网机器上还有维护成本。对一个安装包必须自包含的工具来说,这条路比看起来贵得多。
「图片工坊」就是为这个场景做的离线批量图片工具(macOS / Windows / 银河麒麟三平台),0.2.0 加了 PDF 压缩:拖进去、点开始,输出一个更小的 PDF。交材料的场景同时定了两条底线:文字一字不动,图片不能糊到看不清。实现是纯 Go 的------生态里唯一的现成库 pdfcpu 恰好缺最关键的图像重压缩(2017 年挂到今天的 open feature request),所以分工是:pdfcpu 负责解析和回写,图像处理自己写。
工作台批量处理进行中(示例为图片批次)。PDF 不用选规则,拖进去直接压缩。项目已开源:github.com/Benny66/fil...,三平台安装包在 Release 页。
这篇文章讲三件事:业内压缩 PDF 的通用做法是什么;我们的实现具体怎么做;跟业内方案比,几处不同的设计换来了什么。
一、业内是怎么压缩 PDF 的
先看 PDF 的体积构成。扫描件和图文混排文档的大头都是内嵌图像流,其次是字体,真正的结构性冗余(重复对象、未压缩的 xref 表、没用到的对象)通常只占零头。所以有效的压缩手段就三件:
- 无损结构优化 :去重、对象流压缩、清理无用对象。qpdf 和 pdfcpu 的
optimize都是这个级别,收益稳定但有限,动不了图像流。 - 按显示尺寸降采样:这是最大的杠杆。扫描件常按 300--600 DPI 存储,屏幕阅读只需要 150。
- 图像重存:解出来、用更低的质量重新编码回去。
Ghostscript 把 2 和 3 打包成了三档预设:/screen = 72 DPI、/ebook = 150 DPI、/printer = 300 DPI,只对高于阈值的图降采样,同时按档位配一个 JPEG 重存质量。Acrobat 的「减少文件大小」和各家在线工具的「三档强度」,拆开看同样是「DPI 阈值 + 质量档」的预设组合。这套方案成熟、有效,问题只有一个:它跑在外部进程里,我引不进来。
二、我们的实现
整体管道
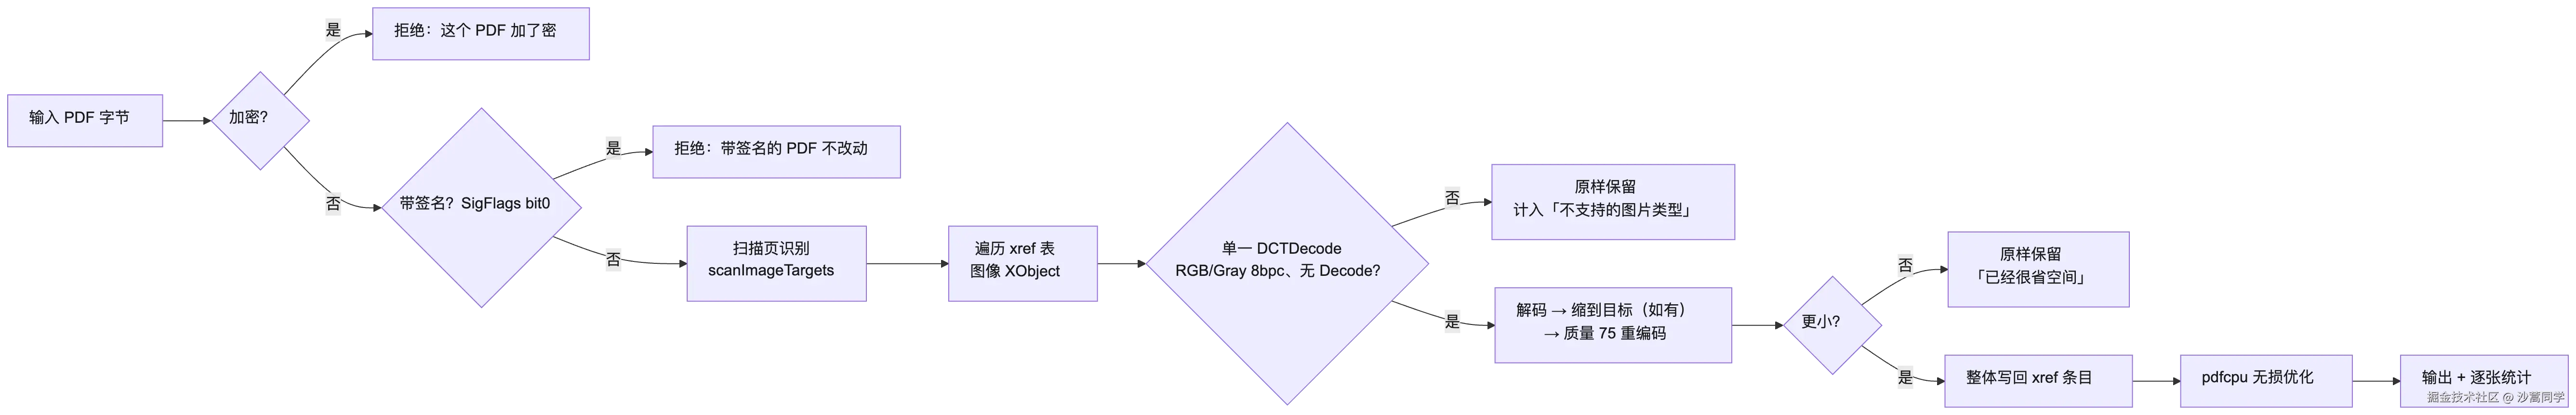
两个术语说明一下,后面会反复出现:xref 表 是 PDF 的对象目录,每个间接对象在这里有条目;XObject 是被文档引用的流对象,图像就存在其中的 Image XObject 里,滤镜名为 DCTDecode 的就是 JPEG 字节。
压缩分两步:先做图像层的重存和降采样(自己实现),再做无损结构优化(pdfcpu 的 OptimizeContext:去重内嵌资源、对象流/xref 流压缩、清理无用对象,内容字节级不变)。加密和带签名的文件在入口直接拒绝------前者不解密,后者改一个字节签名就失效。
内嵌 JPEG 重存
定位图像对象。 不解析页面内容流,直接遍历 xref 表,取出流字典后用 sd.Image() 判断是不是图像对象。这样一个好处是跨页共享的图像对象天然只处理一次。
安全子集判定。 只处理同时满足这几个条件的图:
go
// internal/imageproc/pdf.go
func recompressibleColorSpace(sd types.StreamDict) bool {
	cs, found := sd.Dict["ColorSpace"]
	if !found {
		return false
	}
	name, ok := cs.(types.Name)
	if !ok || (name != "DeviceRGB" && name != "DeviceGray") {
		return false // CMYK 转 RGB 会偏色;Indexed 是查色表语义,重编码后对不上
	}
	bpc, ok := sd.Dict["BitsPerComponent"].(types.Integer)
	if !ok || bpc.Value() != 8 {
		return false // 非 8bit 的 DCT 极罕见,标准库也解不了
	}
	_, hasDecode := sd.Dict["Decode"]
	return !hasDecode // Decode 是分量重映射,解码结果和字典声明不一致
}加上滤镜必须是单一 DCTDecode (HasSoleFilterNamed),这套谓词画出的圈子很小,但每条排除都有明确的技术原因,不是拍脑袋。圈子外的图(Flate 截图、传真码 JBIG2/CCITT、CMYK、索引色)保持原字节,计入「不支持的图片类型」。
重存与替换。 解码出来,用标准库按质量 75 重新编码,编码结果不比原来小就放弃:
go
// internal/imageproc/pdf.go
func recompressPDFImage(sd types.StreamDict, target *image.Point) (types.StreamDict, pdfImageResult) {
	if !sd.HasSoleFilterNamed(filterDCTDecode) || !recompressibleColorSpace(sd) {
		return types.StreamDict{}, pdfImageUnsupported
	}
	width, height := pdfImageDims(sd)
	if width <= 0 || height <= 0 || int64(width)*int64(height) > MaxPixels {
		return types.StreamDict{}, pdfImageUnsupported // 100 MP 上限
	}
	img, _, err := image.Decode(bytes.NewReader(sd.Raw))
	if err != nil {
		return types.StreamDict{}, pdfImageUnsupported
	}
	result := pdfImageReplaced
	if target != nil && (img.Bounds().Dx() != target.X || img.Bounds().Dy() != target.Y) {
		img = resizeImage(img, target.X, target.Y) // 扫描页降采样目标
		result = pdfImageReplacedDownsampled
	}
	var out bytes.Buffer
	if err := jpeg.Encode(&out, img, &jpeg.Options{Quality: pdfJPEGQuality}); err != nil {
		return types.StreamDict{}, pdfImageUnsupported
	}
	if out.Len() >= len(sd.Raw) {
		return types.StreamDict{}, pdfImageNotSmaller // 重存不更小:保持原样
	}
	// ......写回
}
质量档定死 75、不做多档:调研里 75 正是各家「Recommended」档的甜点值,多给档位只是把工程决策转嫁给用户。解码失败按「不支持」计入跳过而不是报错------个别图像异常不该毁掉整份文件。
写回。 这一步的细节比想象中多,每处漏了都会产出损坏或语义漂移的 PDF:替换编码字节和 StreamLength;缩放过的图要重申字典里的 Width/Height;色彩空间按实际编码通道数重申(灰度图重编码后仍是灰度);删掉 DecodeParms------那是原编码的解码参数,新的裸 JPEG 没有。SMask(透明蒙版)是独立对象,不在处理范围内,原样保留。
还有一个 pdfcpu 特有的坑值得单独记一笔:它的 StreamDict 是值类型,从 xref 条目取出来的是副本,改副本没有任何效果,必须整体写回:
go
for objNr, entry := range doc.XRefTable.Table {
	sd, ok := entry.Object.(types.StreamDict)
	if !ok || !sd.Image() {
		continue
	}
	stats.ImagesTotal++
	var target *image.Point
	if t, hit := scanTargets[objNr]; hit {
		target = &t
	}
	// ......重编码(上一段)
	entry.Object = recompressed // 值类型:必须整体写回条目
}
扫描页降采样
第一版只有重存、承诺「不缩小像素尺寸」,实际用下来发现这等于把业内最大的杠杆关在门外:扫描件按 300--600 DPI 存,屏幕阅读 150 就够,光靠质量重存动不了像素总量。0.2.0 修订了这个决策------满页扫描图默认压到 150 DPI,和 Ghostscript /ebook 同款。
难点在怎么判定「这一页是扫描页」。对任意插图降采样,得解析内容流里的变换矩阵算出图像的真实显示尺寸,复杂且容易误伤插图。我们的做法是绕开内容流,只用结构信号取一个安全子集:
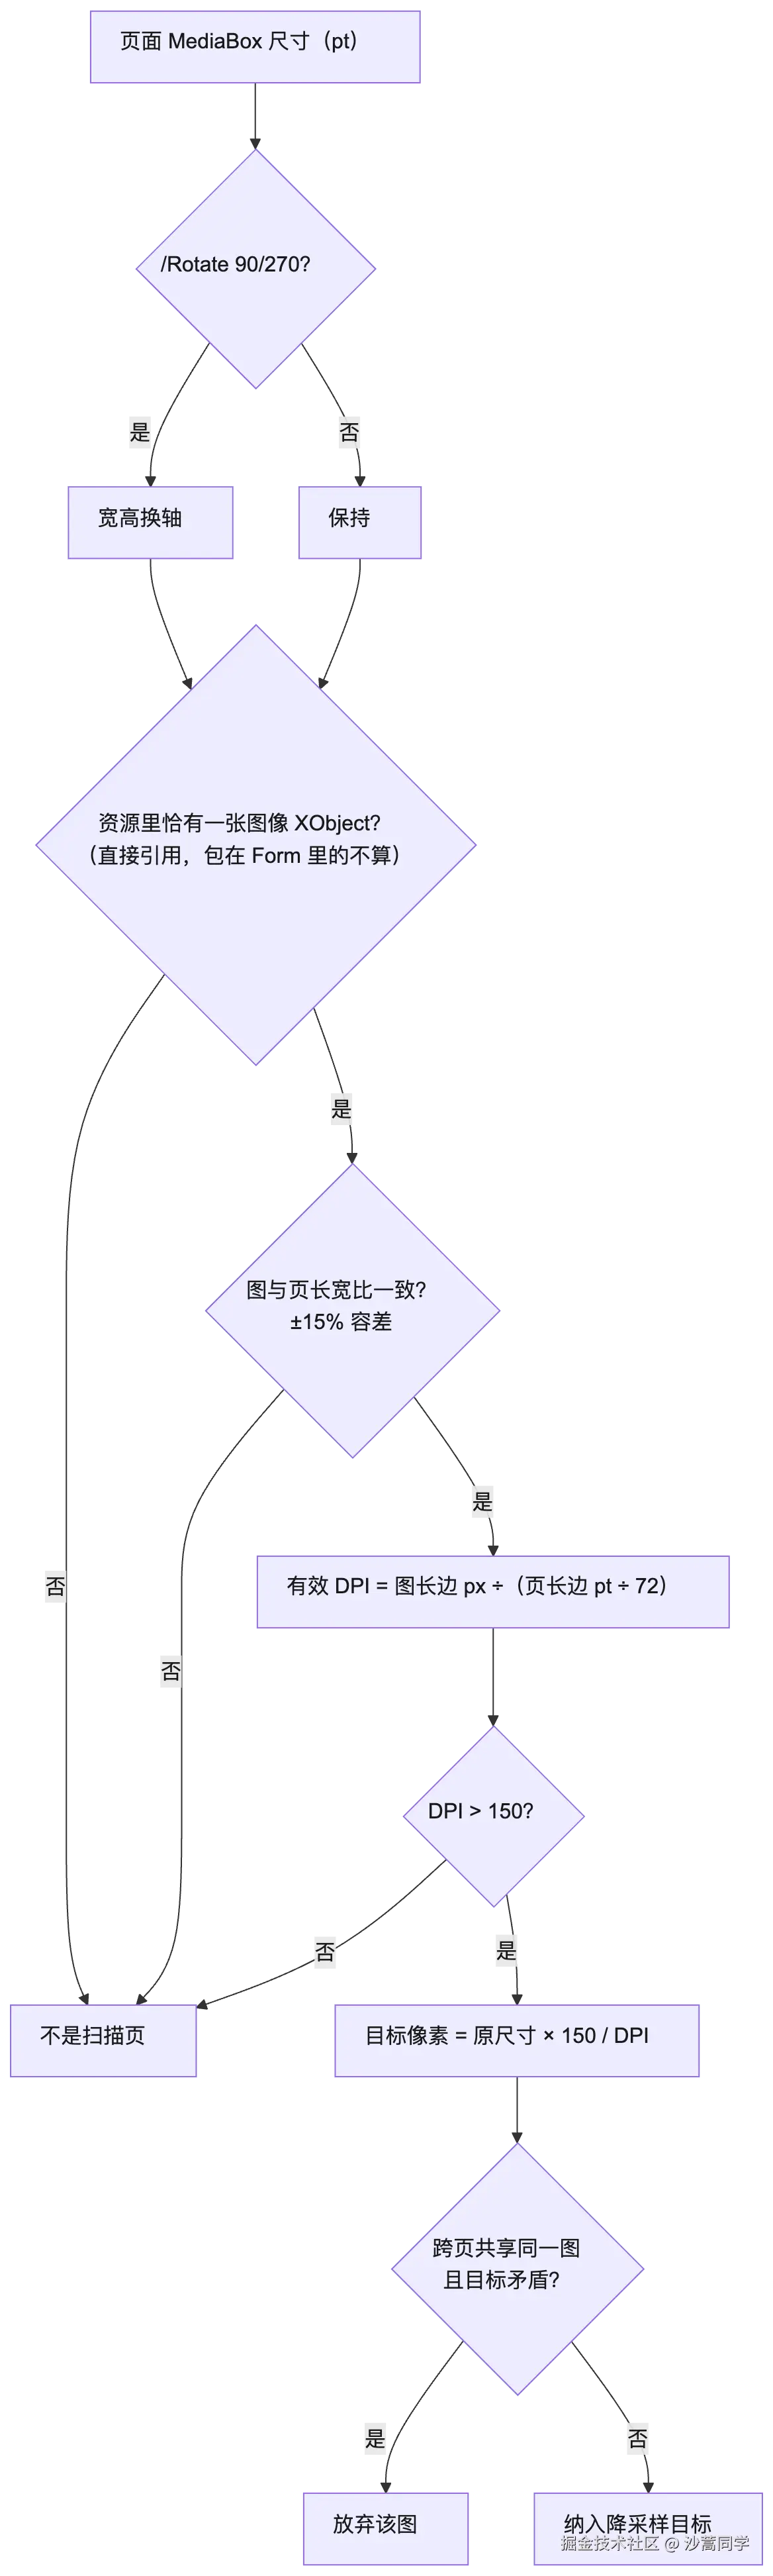
判定成立时,有效 DPI 可以从页面尺寸精确算出,完全不碰内容流------PDF 的页面单位是点,1 点 = 1/72 英寸:
go
// internal/imageproc/pdf.go,scanImageTargets
dpi := float64(imgLong) / (pageLong / 72.0)
if dpi <= pdfScanDPIFloor { // 150.0
	continue
}
scale := pdfScanDPIFloor / dpi
newLong := max(1, int(math.Round(float64(imgLong)*scale)))
newShort := max(1, int(math.Round(float64(imgShort)*scale)))几个边角的处理都遵循同一个原则:拿不准就不压。长宽比差过 15% 说明图没填满页面(旁边可能有文字),不压;同一张图被多页共享而各页算出的目标矛盾,放弃这张图;DPI 略超 150 时缩放取整可能恰好等于原尺寸,此时回落成普通重存,不当作异常跳过。
实现上还有一个 pdfcpu 的坑:ReadContext 之后 PageCount 可能为 0,直接逐页遍历会一次都不执行、静默返回空结果 ,必须先 EnsurePageCount() 把页树补齐。这类不报错、只是默默不生效的问题,靠读文档是发现不了的,是写测试夹具构造 300 DPI 扫描页时撞出来修掉的。
三、跟业内方案比,亮点在哪
1. 逐张判断,仅更小才替换。 预设方案是无条件套用:一张本来已经压得很好的图,被预设再压一遍,结果要么更糊、要么反而更大------这是各在线工具最常见的翻车点。我们逐张编码、逐张比较,不更小就放回原字节。这个判断也让「已经压好的文件再跑一遍」变成无害操作:第二次跑会全部命中「已经很省空间」,一个字节都不动。
2. DPI 是算出来的,不是估的。 从页面尺寸精确推导有效 DPI,不需要解析内容流;识别扫描页用结构信号(单图直引 + 长宽比匹配)取安全子集,宁可少压、绝不误伤排版插图。整个降采样没有魔法数字------150 对齐 Ghostscript /ebook,75 对齐各家 Recommended 档,±15% 容差覆盖扫描页常见的轻微裁边。
3. 每张图的结果如实计数。 输出统计是五个数:图像总数、重存数、压到屏幕清晰度数、不支持的类型数、已经很省空间数。不支持的就明说不支持(传真码、CMYK 这些纯 Go 没有对应编码器),而不是悄悄跳过。界面上用户看到的是「重新保存了 x 张图片,其中 y 张压到了屏幕清晰度,z 张保持原样」------每张图发生了什么,有交代。
4. 纯 Go,单二进制,三平台。 同一套代码出 macOS(Universal)、Windows、麒麟 amd64/arm64(信创交叉构建)的安装包,零外部依赖、零 CGO,没有许可问题。据我所知,开源里做「对象级 PDF 图像重压缩」的纯 Go 实现目前没有第二个。
5. 该不动的不动,该拒绝的拒绝。 文字和矢量内容字节级不变;加密的拒绝处理;带签名的拒绝处理(SigFlags bit0 判定,只含未签署签名表单字段的普通表单不算,照常处理)。
四、实测结果
| 项目 | 数字 |
|---|---|
| spike:2400×2400 DCT 图像,质量 75 重编码 | 整文件 -42.9% ,pdfcpu validate 通过,渲染像素对比平均差 0.41/765(765 为 RGB 三通道差值上限,肉眼不可辨) |
| 300 DPI 扫描夹具(1200px 图 + 288pt 方页) | 压到 600×600(4 英寸 × 150 DPI),测试读回输出验证像素 |
| 单文件 / 单图上限 | 512 MB / 100 MP |
测试矩阵:高噪声 JPEG(质量 100 与 75 之间体积差异巨大,断言确定性)显著变小;300 DPI 满页图降采样并读回验证;长宽比不符不降采样;Flate 图计入不支持;加密、损坏分别返回对应错误码;窄带回落普通重存。
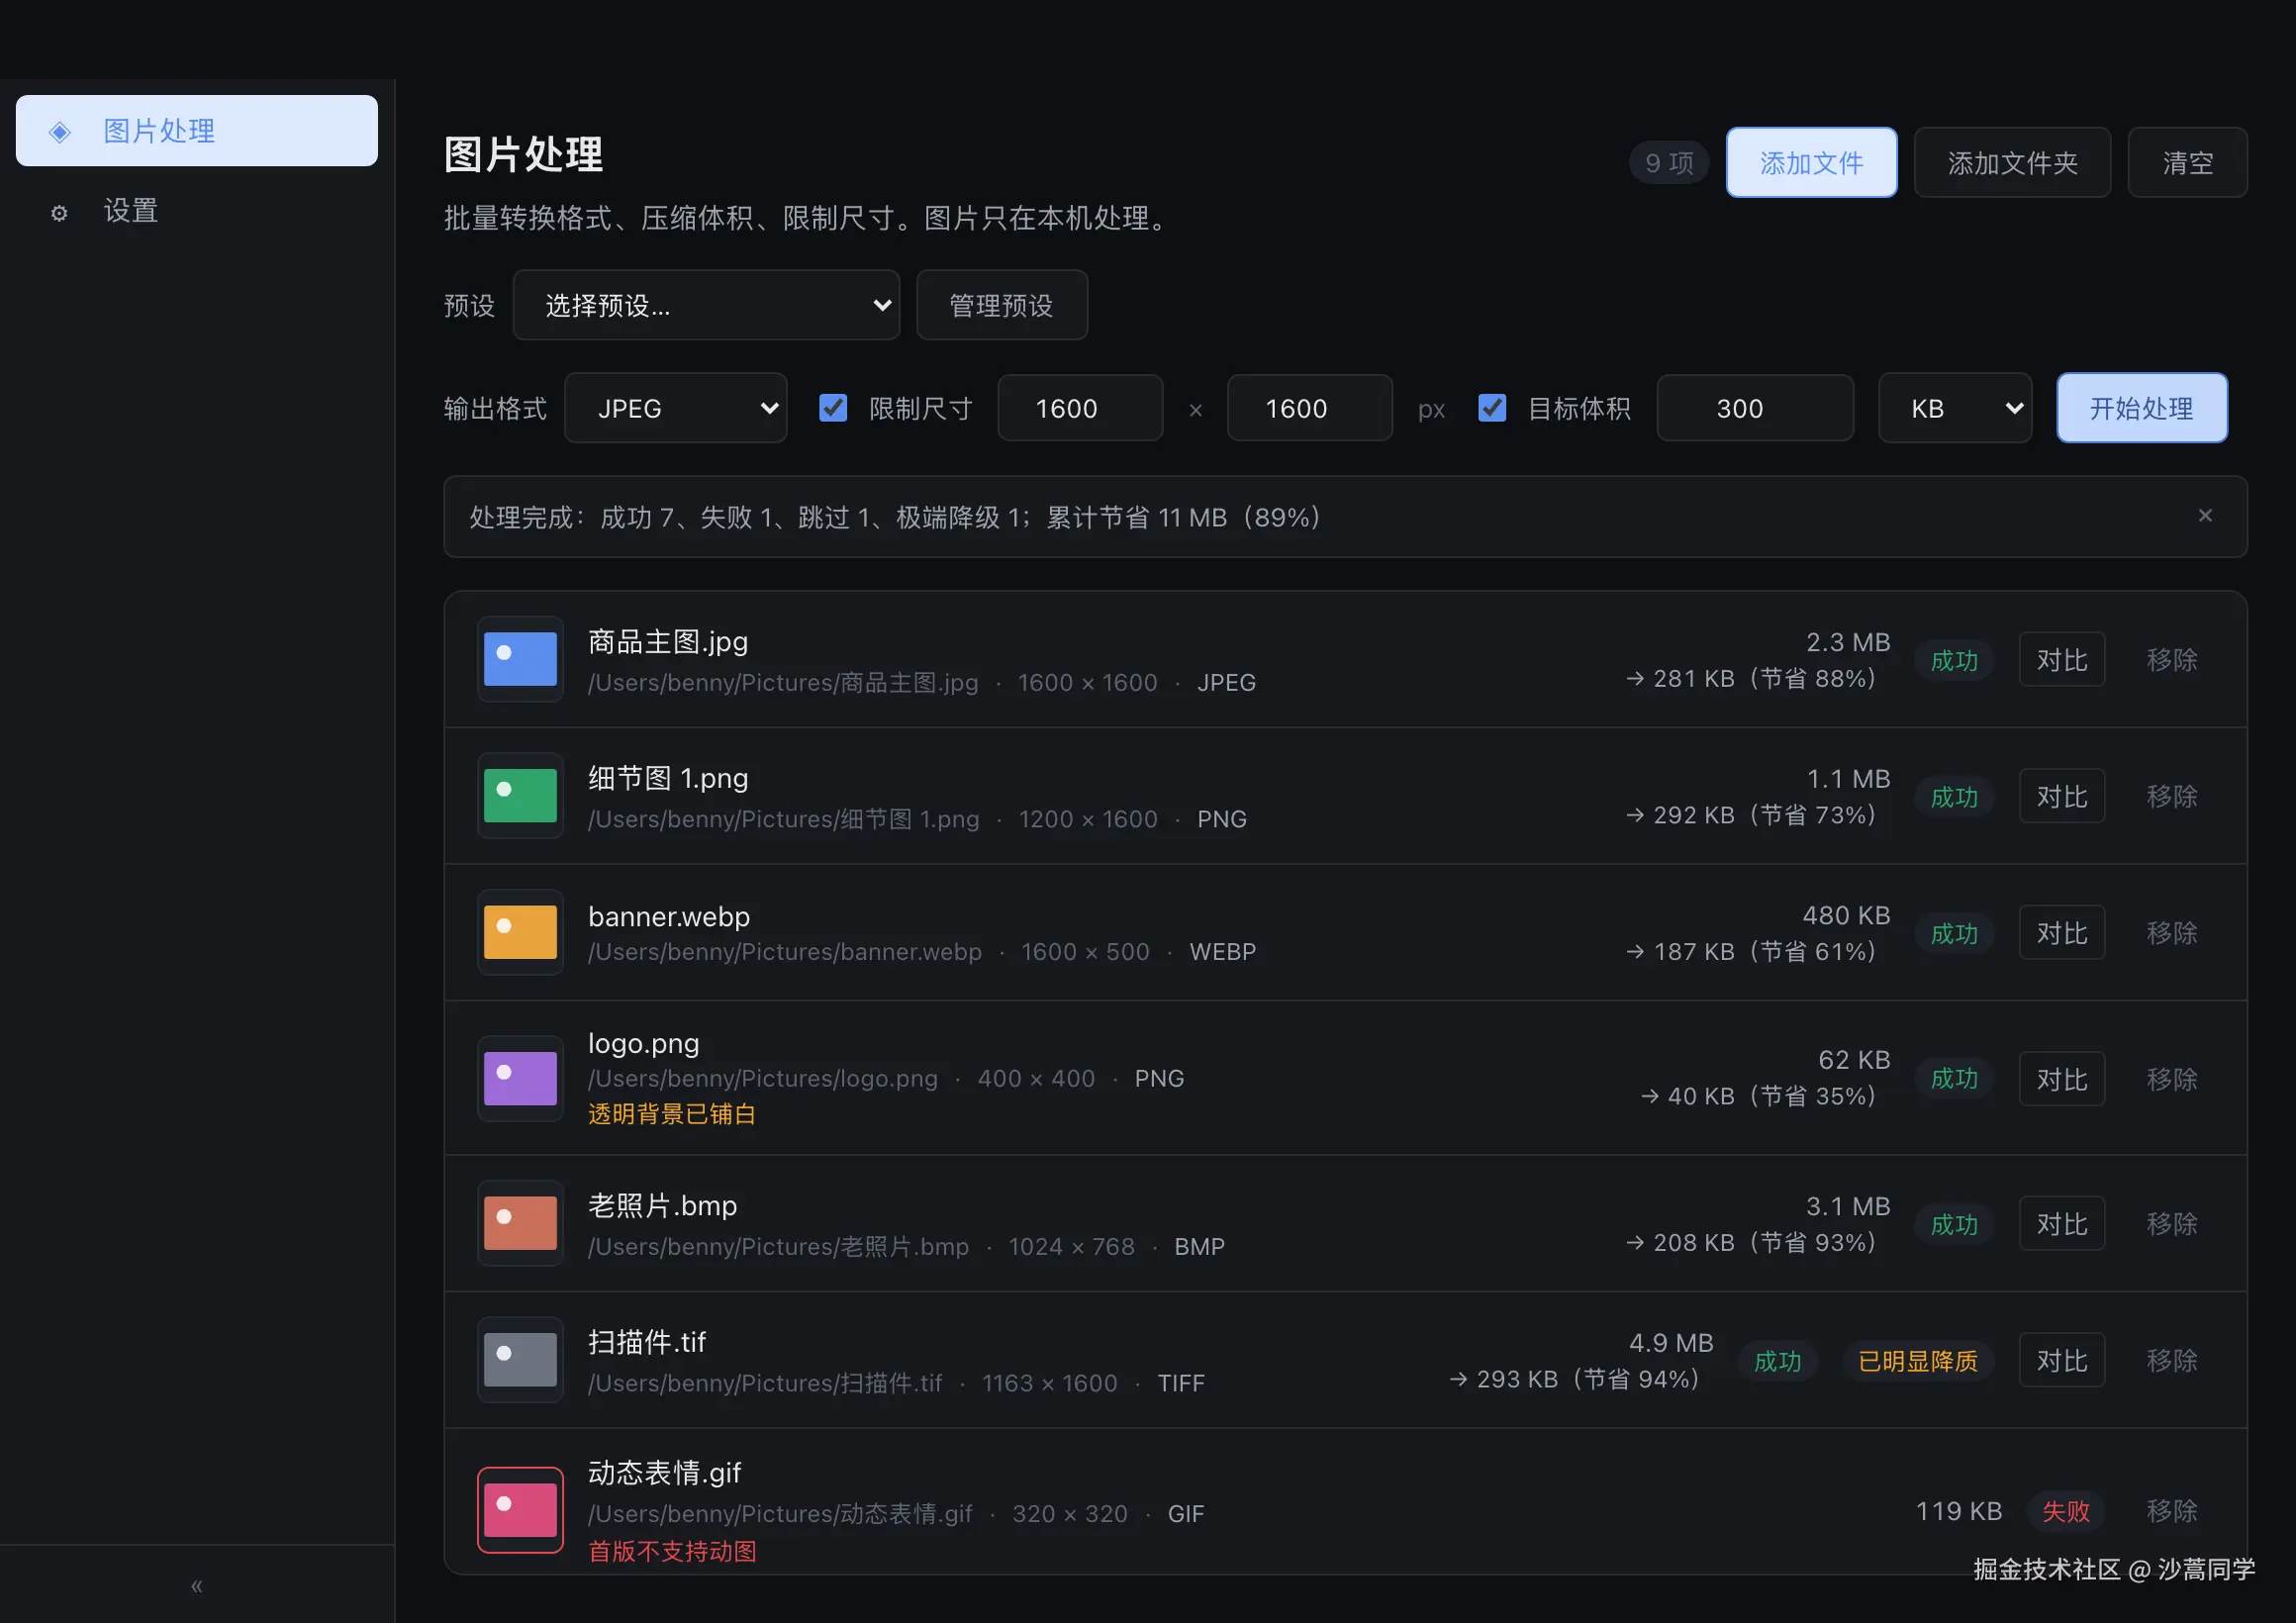
批次结束的汇总与逐项明细(示例为图片批次):每行给出原体积 → 输出体积与节省比例,汇总条给累计节省。PDF 批次同样逐项报告------「重新保存了 x 张图片,其中 y 张压到了屏幕清晰度,z 张保持原样」。
已知限制照实写在产品文档里:Flate/JBIG2/CCITT/JPX 编码与 CMYK/索引色的图保持原样并计数;内嵌字体不做子集化;150 DPI 是屏幕清晰度,打印可能不够。
完整实现在 Benny66/file-processor(internal/imageproc/pdf.go,363 行含注释),三平台安装包在 Release 页。如果对你有用,或者你在自己的场景里也动过「自己写 PDF 压缩」的念头,欢迎交流。