TL;DR:文档 OCR 微调有个隐藏的浪费:SFT 两轮之后模型已经基本能读对页面,剩下的错误就散落在少数位置上,可传统 SFT 还是对全页每个 token 一视同仁地算损失。OPPO 的 SP-DocReader 把训练对准「还没读对的地方」:拿上一轮模型自己生成的阅读和标准答案做最长公共子序列(LCS)对齐,只对错位 token 施加两种损失------相对打分的对比损失 + 直接纠错的保真损失。结果:Qwen3-VL-4B 上三轮自博弈 CER 直降 54%,零样本 DocVQA 反而涨了 3.67;更狠的是数据效率------30k 页标注干翻 SFT 的 120k 页。全程只训 0.5B 的 OCR 小分支,视觉编码器和语言主干纹丝不动。
先看一个训练文档 OCR 模型的日常场景。
你用两万页标注数据 SFT 了两轮,模型在验证集上的字符错误率(CER)从 5.22% 降到 2.40%。看起来不错------但那剩下的 2.40% 里,藏着的是小字号页码读串、形近字认错、公式符号张冠李戴这类「硬骨头」。你想继续压错误率,于是又加数据、加轮次,结果发现:损失的大头依然花在模型早就读对的那些 token 上。
这就是监督微调的均摊悖论:全序列损失不会告诉你哪些位置还不会。
OPPO 研究团队的这篇 SP-DocReader,给出的解法出奇地朴素:把模型自己的错误当成训练信号。
论文地址 :arXiv:2610.11148
整体框架:只训 0.5B 的「OCR 外挂」
先说架构。SP-DocReader 延续 DocVLM 的模块化思路:视觉编码器和语言主干(InternVL-3.5-4B 或 Qwen3-VL-4B)完全冻结,只训练一个 OCR 分支------DocFormerV2 式的 OCR 编码器 + 投影层 + 一组可学习查询,把外部 EasyOCR 识别出的文本和坐标框压缩成紧凑表示,注入冻结的 VLM。
可训参数只有 0.5B,对比 OCR-free 全参微调的 3.3B 和完整全参的 3.8B。推理开销约为纯主干方案的 +10%。
这个设计后面会看到回报:域内 CER 略逊于全参微调,但零样本全面占优,训练成本只有全参的 1/5。
核心方法:给模型配一个「错题本」
整个训练分两段。第一段是常规的 SFT-2(两轮监督微调)。第二段开始自博弈(self-play),每轮三步:
第一步,让「上一次的自己」读一遍。 上一轮的模型固定为对手(opponent),对每页生成一份完整阅读 ŷ------里面混着它独有的错误:把 "store" 读成 "stroe"、把 "kilograms" 读成 "kilogramhs"。
第二步,LCS 对齐,圈出错误。 对标准答案 y 和生成阅读 ŷ 在模型 token 序列上做最长公共子序列对齐------两边读对的部分自然对上,剩下的未匹配位置就是「错题」。整个过程看下面这张框架图:
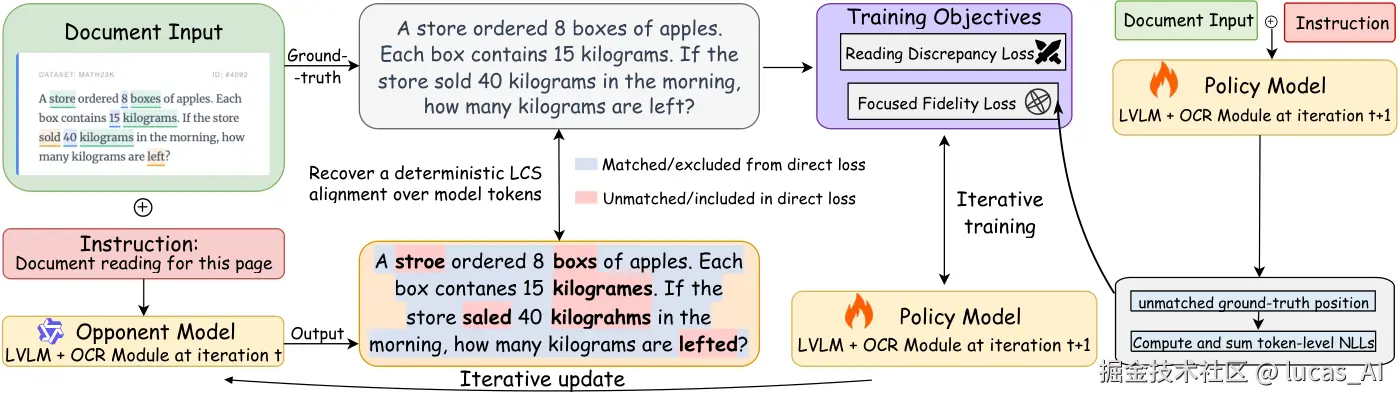
图里那个例子很直观:真值是 "A store ordered 8 boxes of apples...",对手读出 "A stroe ordered 8 boxes ... 15 kilograms ... saled 40 kilogramhs ... are lefted"------蓝色是读对的(排除出直接损失),红色的错处才进入训练。
这里有个容易被忽略但很讲究的细节:掩码只选损失位置,不截断序列。打分时错位 token 的条件前缀保持完整------匹配的 token 依然提供上下文。论文专门强调不把抽出来的残缺片段当新序列打分,避免了「在残缺文本上算概率」的语义错乱。
第三步,两种损失双管齐下。
- RDL(阅读差异损失):SPIN 式对比目标------在这些错位上,当前模型给标准答案的分数要比对手给自己错误阅读的分数高。这是「相对」信号:参考优势越小,拉扯越用力。
- FFL(聚焦保真损失):在标准答案的未匹配位置直接加负对数似然。这是「绝对」信号:纠正不依赖「压低错误阅读」,而是直接把对的抬起来。
为什么两个都要?消融给了干净答案:只留 FFL(去掉对比),Vary-600K CER 是 1.88;只留对比(去掉 FFL),1.57;双管齐下 1.11------而且五项指标全部最优。一个管方向,一个管力度,缺谁都使不上全劲。
每轮结束后刷新对手 :新对手、新阅读、新掩码。这一步不是仪式------对照实验显示,刷新分支训 2 个局部 epoch 的平均分(90.3)超过固定对手读物的 5 个 epoch(89.8)。道理很简单:旧错题刷完了,得出新错题才有新东西可学。
成绩单:域内 -54%,零样本涨 3.67 分
Qwen3-VL-4B 上的主要结果:
| 基准 | SFT-2 | SP-DR-3 | 变化 |
|---|---|---|---|
| Vary-600K CER(域内)↓ | 2.40 | 1.11 | −54% |
| DocBank CER(零样本)↓ | 10.95 | 9.05 | −1.90pp |
| IIT-CDIP CER(零样本)↓ | 16.71 | 14.42 | −2.29pp |
| DocVQA ANLS ↑ | 81.22 | 84.89 | +3.67 |
| InfographicVQA ANLS ↑ | 55.34 | 58.94 | +3.60 |
注意后四行全部是零样本------自博弈只在 Vary-600K 的英中双语页面上训,泛化到学术页(DocBank)和扫描件(IIT-CDIP)照样降错误率,连文档问答都跟着涨。InternVL-3.5-4B 上趋势一致(Vary CER 2.12→1.17)。附加的三个基准也全线上扬:OmniDocBench 编辑距离 0.347→0.291,OCRBench v2 +6.2,CC-OCR +5.6。
数据效率可能是对实践者最友好的一张图:30k 页标注 + 自博弈的五任务平均分 82.46,超过 120k 页 SFT 的 80.73。标注预算紧张时,这条曲线的含义不言自明。
分辨率鲁棒性是另一个惊喜:从 48 DPI 到 150 DPI,SP 版全面占优------48 DPI 极限低清下 CER 是 1.74 对 3.41。对那些「PDF 渲染分辨率上不去」的产品场景,这直接决定了能不能省视觉 token。
模块化 0.5B vs 全参 3.8B:域内小负,零样本全胜
架构消融是全文最有意思的对照。Qwen3-VL-4B 上三种玩法:
| 方案 | 可训参数 | Vary CER | DocBank CER | IIT-CDIP CER | DocVQA |
|---|---|---|---|---|---|
| OCR-free | 3.3B | 1.04 | 11.93 | 17.61 | 79.62 |
| 全参微调 | 3.8B | 0.98 | 11.28 | 16.87 | 80.41 |
| 模块化(本文) | 0.5B | 1.11 | 9.05 | 14.42 | 84.89 |
全参微调域内 CER 最低(0.98),但那更像对训练分布的过拟合------一到零样本就掉队,而且三轮自博弈后它的零样本均分不升反降(75.92→74.98)。模块化方案域内让出 0.13 个 CER 点,换来零样本三个指标全胜和 1/5 的训练成本。
这一幕是不是有点眼熟?域内刷榜的未必是好的部署选择------在垂直能力上加装小模块,反而保住了主干的泛化底座。
错题本里都有什么错?
定性案例最能说明「聚焦残差」到底在纠什么错。看论文给的两页对比:
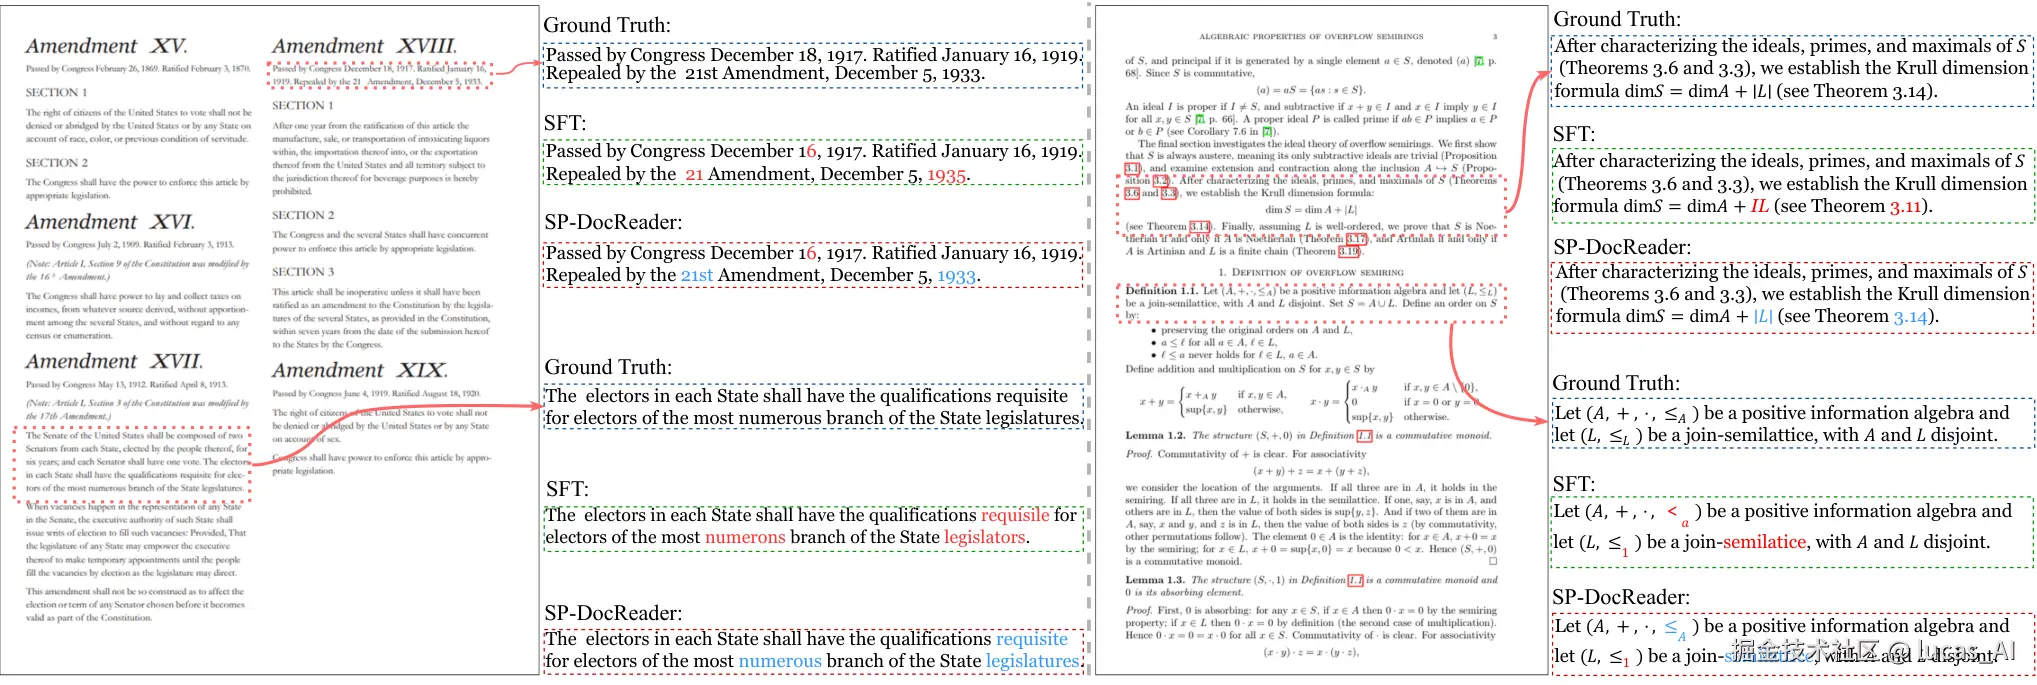
左边是美国宪法修正案影印页:SFT 把 "Passed by Congress December 18 , 1917" 读成 December 16 、把 "Repealed... 1933 " 读成 1935、把 "requisite" 拼成 "requsilie"、把 "State legislatures" 误成 "legislators"。SP-DocReader 版本全部修正。
右边是代数论文页:SFT 把维度公式 dim S = dim A + l 读成大写 L 、把 "see Theorem 3.14 " 读成 3.11、把 join-semilattice 拼错。公式符号和定理编号这类「差一个字符就谬以千里」的位置,恰恰是错题本最该覆盖的。
泼冷水时间
外部 OCR 是拐杖。 框架依赖 EasyOCR 提供文本和坐标框,OCR 分支学的是「如何把现成 OCR 结果压好喂给主干」。EasyOCR 读错的,这套框架无能为力;推理还有 +10% 开销。跟 GOT-OCR2.0、DeepSeek-OCR 这类端到端专精系统比,这是完全不同的技术路线,论文也没有同表对比它们的绝对成绩。
只管单页转录。 论文自己的 Limitations 写得清楚:不做多页阅读、不做结构化抽取,固定生成预算对超长页面不友好。
语种与家族覆盖窄。 只测英中双语训练 + 两个 4B backbone(都是 Qwen/InternVL 系),换语种换模型家族是否成立未知。
自博弈依赖 SFT 起点。 如果 SFT 后的错误分布有系统性盲区(比如整行漏读),LCS 对齐对这种「结构性错误」的覆盖是否充分,论文没有讨论。
理性看待
把这篇放进本系列最近几篇的脉络里看,会更有意思:
- pixels-to-structure 那篇说 OCR 专用小模型做结构化抽取 不行;本篇说模块化 OCR 分支做纯转录很强------任务边界再次显形,选型前先问自己要什么。
- HANS 答题卡那篇靠垂直数据全参微调拿精度;本篇证明「冻结主干+小分支+巧目标」是另一种更便宜的路。
- 训练方法层面,「SFT 之后的残差,用自博弈来收割」这个范式,本质上是把 SPIN/DPO 那套偏好优化从「整篇好坏」细化到了「token 级错位」------这个粒度迁移值得所有做生成任务微调的人参考。
一句话总结:当你的模型已经 97.6% 正确,别再全页撒网了,把错题圈出来逐个击破。
(本文是「智能文档」系列第 15 篇。相关阅读:小米 OCR-0:7B 视觉编码的知识瓶颈、PolyOCR:多语言 OCR 的专用路线。)