作者:来自 Elastic Ben-Amin York Jr.
用自然语言向一份包含大量表格的扫描版 PDF 提问,即可获得标明来源页码的答案,因为 jina-ocr-v1 会将每一页转换为结构化的 Markdown,再由 Elasticsearch 在摄取时将其转换为嵌入向量。
动手体验 Elasticsearch:深入探索 Elasticsearch 实验室代码仓库中的示例笔记本,开始免费云试用,或立即在你的本地计算机上试用 Elastic。
上传一份 56 页的扫描版植物指南,然后询问哪些树木能耐受浅层石灰岩土壤。不到五分钟,你就能获得答案,以及答案的来源页码和可供购买的适宜植物。其背后的检索增强生成( RAG )流水线包含两个托管组件。jina-ocr-v1 读取每一页扫描内容,返回保留完整表格的结构化 Markdown,而 Elasticsearch 的 semantic_text 字段则在摄取时对这些 Markdown 内容进行分块并生成嵌入向量。因此,你无需编写分块代码或运行嵌入任务。混合检索先融合关键词排名和语义排名,再由 Claude Haiku 4.5 生成有据可依的答案,整个流程都在同一个项目内通过 Elastic 推理服务( EIS )运行。
这一点很重要,因为组织所依赖的大部分知识从未进入数据库。它们存在于 PDF、扫描表单或传统搜索无法读取的文档照片中。传统的光学字符识别( OCR )流水线通过串联用于版面检测、文字识别、表格解析和阅读顺序识别的独立模型来提取这些知识,而每个模型都有各自的成本和故障模式。新一代视觉语言文档解析器只需运行一次模型,即可完成同样的工作。搭配支持向量检索的搜索引擎后,一份 PDF 或它的照片就能在几分钟内成为可查询、可引用的知识来源。
将文档解析与混合搜索和 检索增强生成 相结合,团队就能:
- 让关键词搜索和传统光学字符识别遗漏的表格、手写内容及复杂版面变得可搜索。
- 用自然语言针对文档提问,并获得有据可依、附带页码级引用的答案。
- 在一次查询中结合精确词项匹配(例如库存单位编码或植物学名)与语义匹配(含义和意图)。
- 将包含解析、嵌入向量生成和答案生成在内的整个流水线保留在同一个平台内,统一计费,并使用同一个安全边界。
 图 1:用户上传一份 56 页的扫描版植物指南,并用自然语言提问。随后,用户获得基于指南内容的答案,其中包含页码引用和符合要求的产品。
在本文中,我们将逐步介绍如何为一个销售得克萨斯州本土植物的电子商务网站添加文档解析功能。(我喜欢植物!)你上传指南,查看 jina-ocr-v1 逐页解析,将输出内容索引到以该文档命名的 Elasticsearch 索引中,再通过检索增强生成聊天机器人进行查询。该机器人会按页码 引用来源 ,并推荐商品目录中的产品。技术栈如下:
- **Jina 光学字符识别( jina-ocr-v1 ):**一种文档解析模型,只需进行一次多模态处理,就能读取页面图像并返回整洁、结构化的 Markdown。
- Elastic 推理服务:随 Elastic Cloud 无服务器服务提供的图形处理器加速推理服务。Elastic 推理服务通过预配置的
chat_completion端点托管 jina-ocr-v1,同时托管嵌入模型和对话式大语言模型(本项目使用 Claude Haiku 4.5 ),因此无需部署模型、配置图形处理器,也无需单独注册供应商账号。Elastic 推理服务按词元计量使用量,并作为无服务器服务的附加项计费。各模型的当前费率见 Elastic Cloud 定价表。 - **Elasticsearch:**使用 semantic_text 字段类型存储解析后的文档。该字段类型在摄取时通过推理端点对文本进行分块并生成嵌入向量,同时支持混合检索,通过倒数排名融合(RRF)融合词法排名和语义排名。
- **React、TypeScript 和 Vite,搭配 Express 后端:**在店面网站中新增文档上传页面,通过服务器发送事件实时推送解析进度,并添加悬浮聊天组件。Express 层将所有凭据保留在服务器端。
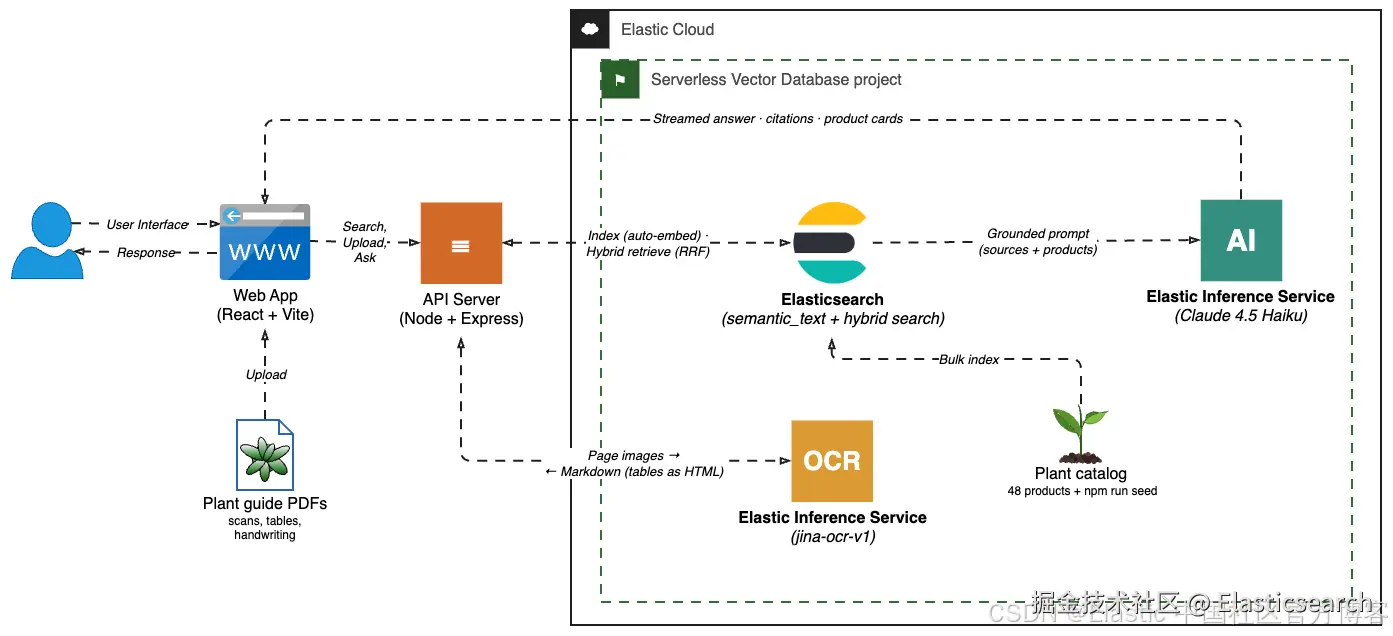 图 2:架构。问题沿顶部流程流转;文档上传沿底部流程进行,其中 jina-ocr-v1 先将页面转换为 Markdown,再进行索引。
jina-ocr-v1 与传统光学字符识别流水线有何不同?
jina-ocr-v1 是一个单一模型,也就是说,版面分析、文字识别、表格重建和阅读顺序识别都在一次处理中完成。传统光学字符识别流水线则通过串联用于版面检测、文字识别、表格解析和阅读顺序重建的独立模型来完成同样的工作。它的输出专为检索而设计:
- 输出结构化的 Markdown,保留阅读顺序,并将章节标题保留为 Markdown 标题。
- 以 HTML 格式输出表格,完整保留其中的数值,因此,无论是涵盖 50 个州的许可明细表,还是植物养护表,都能保留表格结构。
- 在原文位置转录手写内容。
- 移除重复的页面元素,包括页眉、页脚和印刷页码,避免干扰检索;页码改由摄取循环提供。
这种整洁的结构让下游的分块、嵌入向量生成和引用更加可靠。模型每次处理一张页面图像,可清晰辨识的图像分辨率最高约为 2048 × 2048 像素,因此需要由某一方负责逐页循环处理。
逐页循环在哪里运行:Jina 阅读器接口、聊天补全接口,还是 Elastic 推理服务
由谁运行这个循环,是架构设计中需要做出的决定。
| 方式 | 谁运行逐页循环 | 输入粒度 | 运行位置 |
|---|---|---|---|
Jina 阅读器接口( r.jina.ai ) |
Jina,在服务器端运行 | 每次调用处理一份 PDF | 在你的 Elastic 项目之外;使用独立的密钥并单独计费 |
| 直接调用聊天补全接口 | 你的应用程序 | 每次调用处理一页 | 在你的 Elastic 项目之外 |
Elastic 推理服务( .jina-ocr-v1-chat_completion ) |
你的应用程序 | 每次调用处理一张页面图像 | 在你的 Elastic 项目之内;使用一个密钥,统一计费 |
本文采用 Elastic 推理服务方案,即整个流程位于同一个平台边界内,而逐页循环只需在 server/documents.js 中编写几十行代码。
为什么扫描版植物指南是文档解析的一项严峻考验
演示语料只有具备挑战性,才有说服力。我们的测试文档是《本土及适生景观植物:得克萨斯州中部环保指南》,这是一份由奥斯汀市与得克萨斯州农业生命推广服务机构共同编写的教育出版物,旨在帮助公众节约用水并开展环保园艺。它也是该市绿色种植计划所采用的植物名录。这份指南包含 56 页扫描内容,恰好属于基础 PDF 文本提取容易出错的内容类型。几乎每一页都是密集的多列表格,其中充斥着缩写(例如," VL "表示需水量极低," B/E "表示黑土草原和爱德华兹高原)、表示野生动物价值和抗鹿啃食能力的勾选标记、斜体植物学名,以及穿插在数据中的照片说明。能够重建这些表格并完整保留其中数值的解析器,也能处理你的发票。
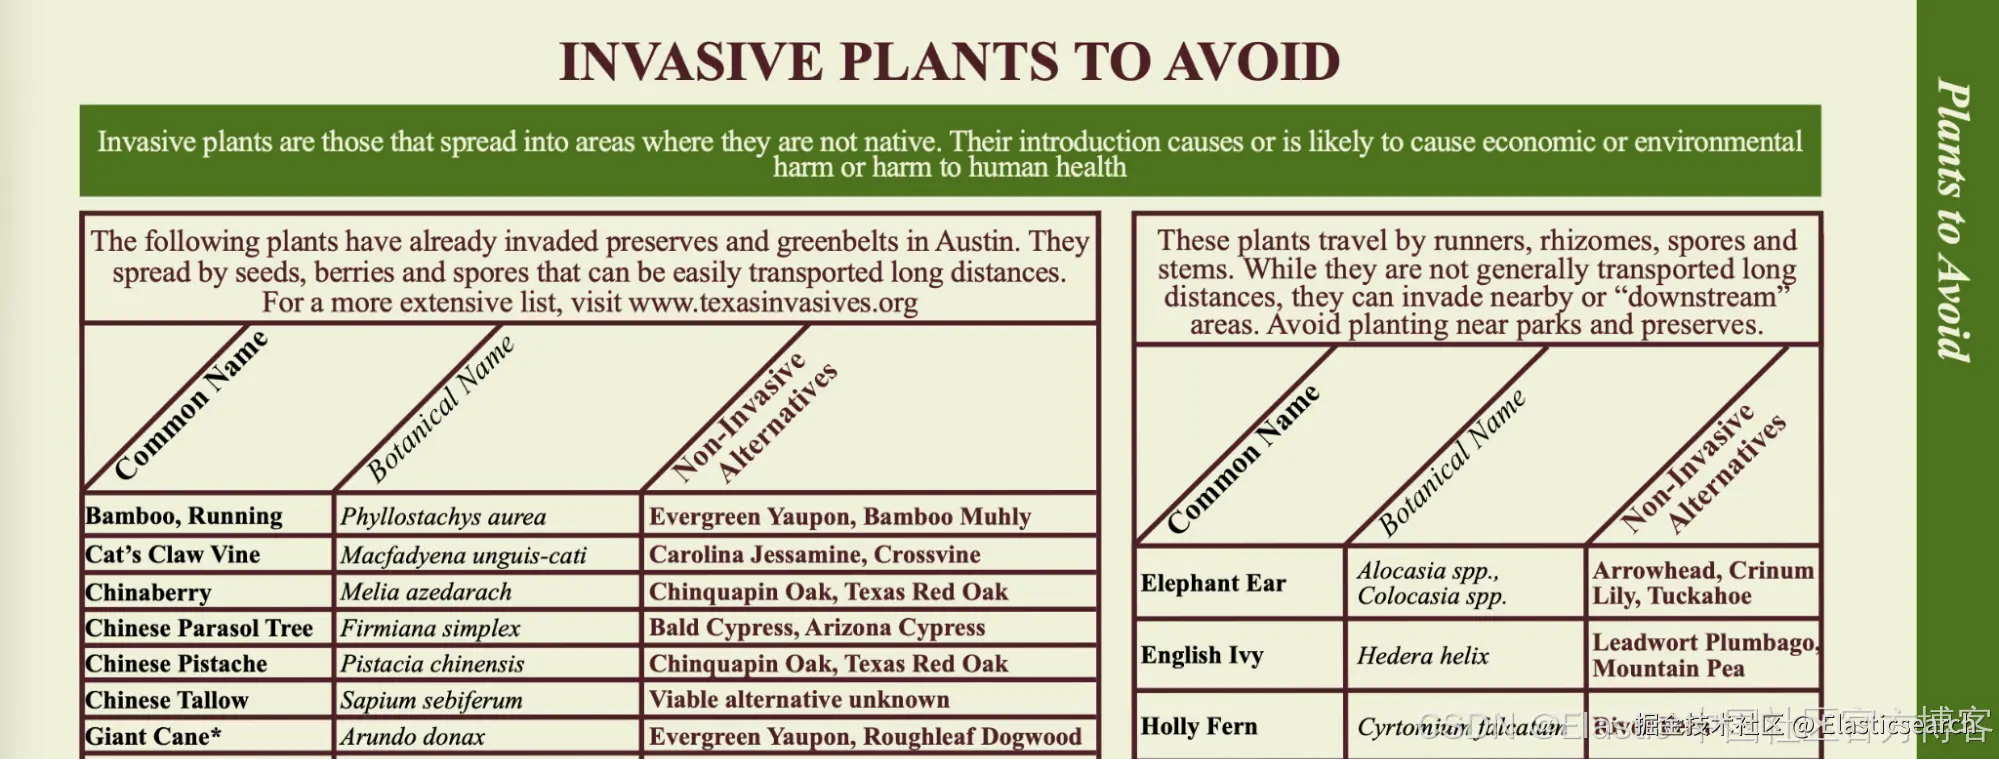 图 3:由 jina-ocr-v1 重建的指南第 50 页"应避免种植的入侵植物"表格,其中列出了推荐的本土替代植物。
植物主题也为文档智能提供了应用场景。宿主应用是一个销售得克萨斯州本土植物的店面网站,其 Elasticsearch 商品目录已预先填充数据:包含 48 种植物,使用 semantic_text 字段存储描述,并提供全文搜索与混合搜索的切换功能。添加文档智能后,购物者就能上传一份地区种植指南,然后询问:*哪些树木能耐受浅层石灰岩土壤?*他们将获得基于指南内容的答案,其中包含页码引用和符合要求的产品列表。
前提条件:Elastic Cloud、接口密钥和扫描文档
- 一个 Elastic Cloud 账号(免费试用账号也可以)。创建一个 Elastic Cloud 无服务器项目。向量数据库项目类型适合这种大量使用嵌入向量的工作负载。
- 在项目中,确认 Elastic 推理服务的模型列表包含 Jina 光学字符识别第一版(
.jina-ocr-v1-chat_completion)和 Claude Haiku 4.5(.anthropic-claude-4.5-haiku-chat_completion)。两者均已预配置,无需部署。 - 一个具有索引读写权限和推理权限的 Elasticsearch 接口密钥,以及你的项目端点地址。
- Node.js 20 或更高版本、npm 和 git。
- 一份测试文档,例如上文链接的*《本土及适生景观植物》*指南,或你自己的任何包含大量表格的扫描文档。
搭建扫描版 PDF 的检索增强生成流水线
**步骤 1:**克隆代码仓库并安装依赖。
bash
`

1.  git clone https://github.com/elastic/elastic-labs.git
2.  cd elastic-labs/supporting-blog-content/jina-ocr-v1-hybrid-rag-elasticsearch
3.  npm install

`AI代码解释
**步骤 2:**配置凭据。复制模板,并填入你的项目配置值。.env 文件已被 git 忽略,因此密钥不会进入代码仓库。光学字符识别端点已预配置,嵌入模型采用项目默认模型,因此聊天模型是本项目中唯一需要选择的模型,而且已经为你选好了。
bash
`cp .env.example .env`AI代码解释
ini
`

1.  ELASTICSEARCH_URL=https://<your-project>.es.<region>.elastic.cloud:443
2.  ELASTICSEARCH_API_KEY=<your-api-key>
3.  LLM_INFERENCE_ID=.anthropic-claude-4.5-haiku-chat_completion

`AI代码解释
**步骤 3:**填充商品目录。初始化脚本会创建商品目录索引( long_description 是一个文本字段,其内容会同步到 semantic_text 字段,因此商品混合搜索可以立即使用),并批量加载 48 种植物。首次运行大约需要一分钟,因为 Elasticsearch 会在摄取时为每条描述生成嵌入向量。
arduino
`npm run seed`AI代码解释**步骤 4:**在两个终端中分别启动后端和前端,先启动后端。
在第一个终端中,启动 Express 接口服务。它监听 3001 端口(由 .env 中的 PORT 设置),并运行光学字符识别流水线和聊天功能。
arduino
`npm run server`AI代码解释在第二个终端中,启动 React 应用的 Vite 开发服务器。它会将 /api 调用代理到后端。
arduino
`npm run dev`AI代码解释Vite 会输出服务地址,通常为 http://localhost:5173。(如果 5173 端口已被占用,它会选择下一个可用端口。)打开该地址;不要直接访问 3001 端口,因为该端口仅提供接口服务。
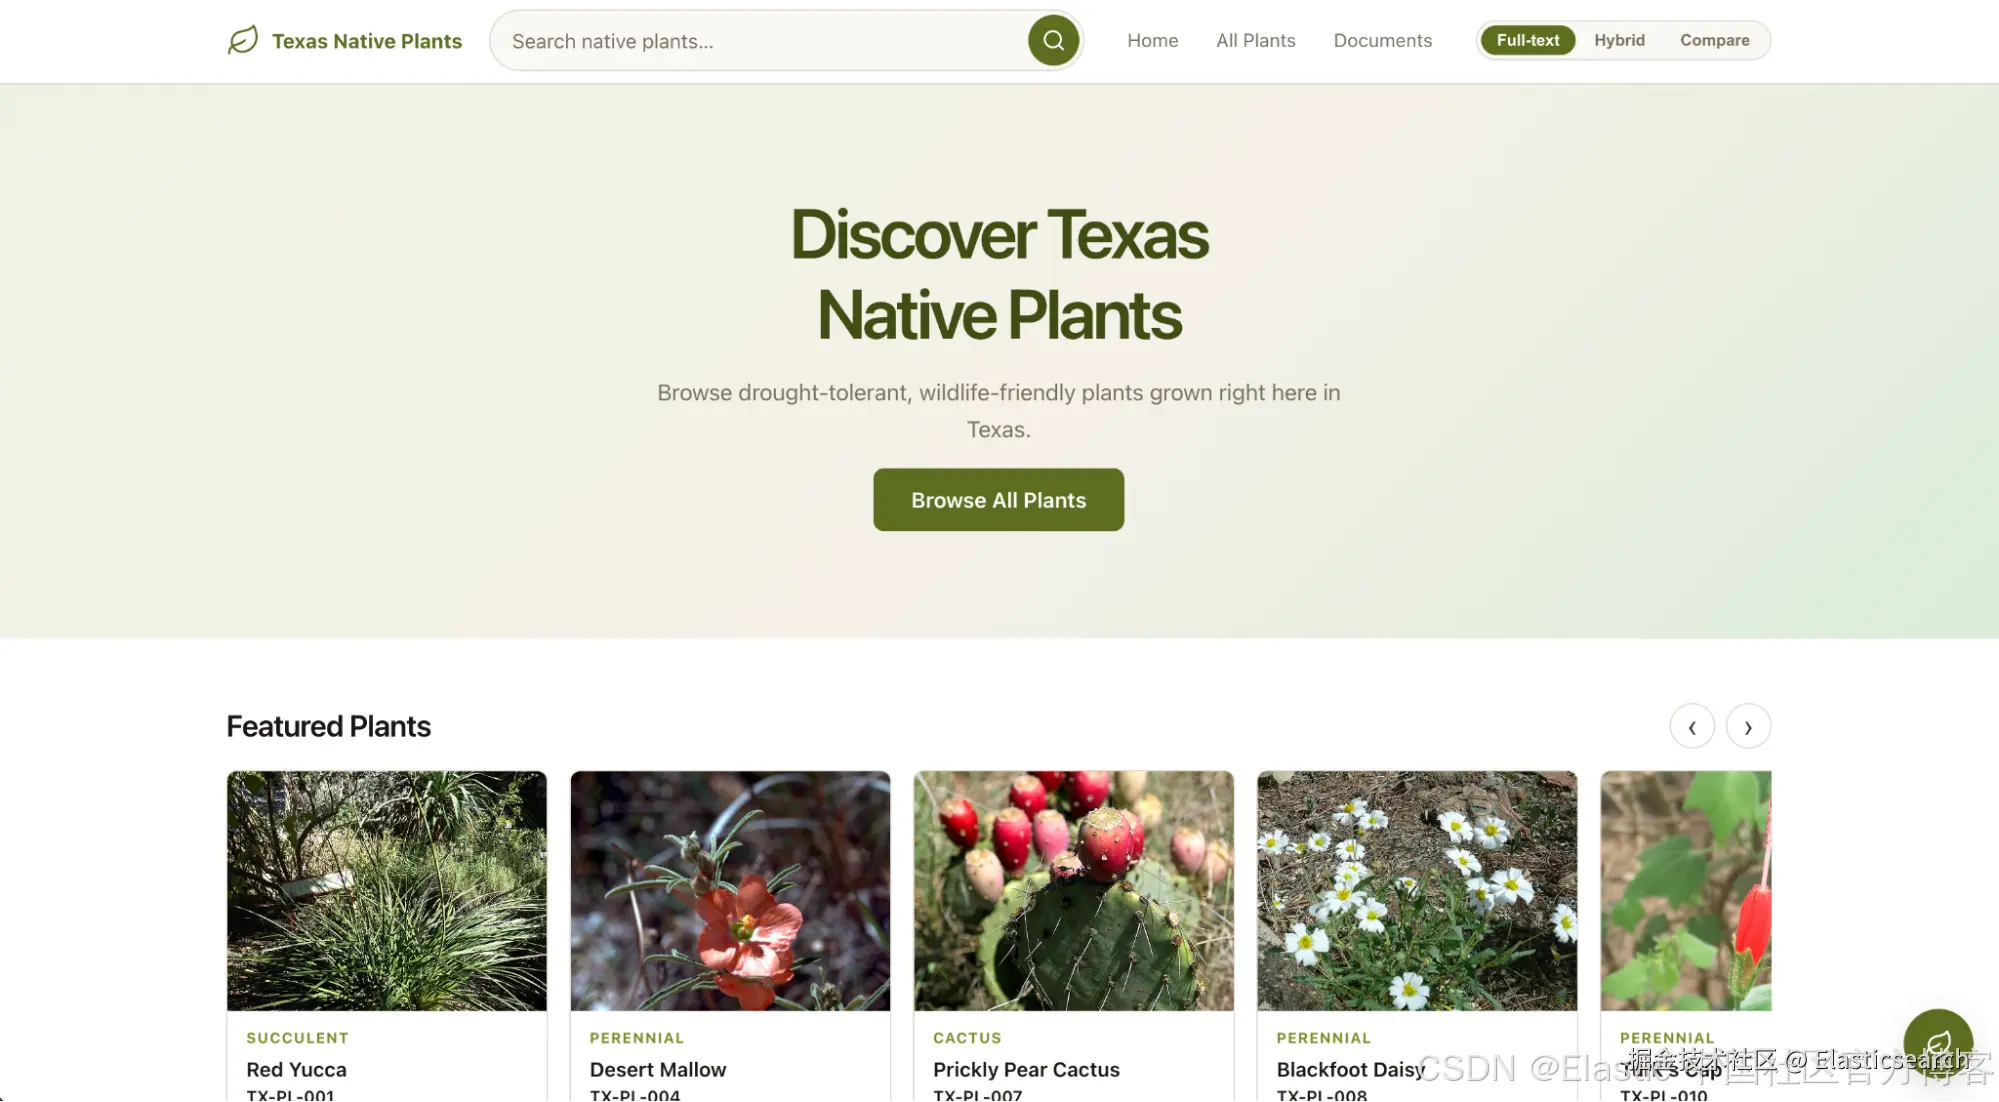
光学字符识别流水线如何将扫描页面转换为 Markdown
解析过程会在文档页面上直观呈现。用户拖入一份 PDF 或一张照片后,Express 服务器便会运行一个包含四个阶段的流水线,同时通过服务器发送事件将每一步的进展实时传回浏览器。
阶段 1:将 PDF 页面渲染为图像
PDF 会在内存中渲染为分辨率约为 1224 × 1584 像素的 PNG 页面图像,低于模型可清晰辨识的 2048 像素上限。拍摄的文档照片则直接作为单页进入下一阶段。
阶段 2:转录每一页并重建表格
每张页面图像都以 base64 数据地址的形式发送到 Elastic 推理服务端点,与调用任何聊天模型的视觉功能完全相同。每次并行处理四页,并在重新组装时保留原始顺序:
markdown
``
1. const resp = await fetch(
2. `${ES_URL}/_inference/chat_completion/.jina-ocr-v1-chat_completion/_stream`,
3. {
4. method: 'POST',
5. headers: { Authorization: `ApiKey ${ES_API_KEY}` },
6. body: JSON.stringify({
7. messages: [{
8. role: 'user',
9. content: [
10. { type: 'image_url',
11. image_url: { url: `data:image/png;base64,${png}` } },
12. { type: 'text',
13. text: '将此页转录为整洁的 Markdown,保留阅读顺序。将表格表示为 HTML 表格。' }
14. ]
15. }]
16. })
17. }
18. );
``AI代码解释每完成一页,浏览器就会记录其处理结果,例如"第 12 页:2,572 个 Markdown 字符"。只要任意一页生成了第一个 HTML 表格,服务器就会立即将其发送给浏览器,用户界面随即以完整样式渲染该表格。看着一张密集的扫描版植物表格重新呈现为结构化的 HTML 表格,其中每个需水量代码和高度范围都完整保留,是整个演示中最有说服力的时刻。
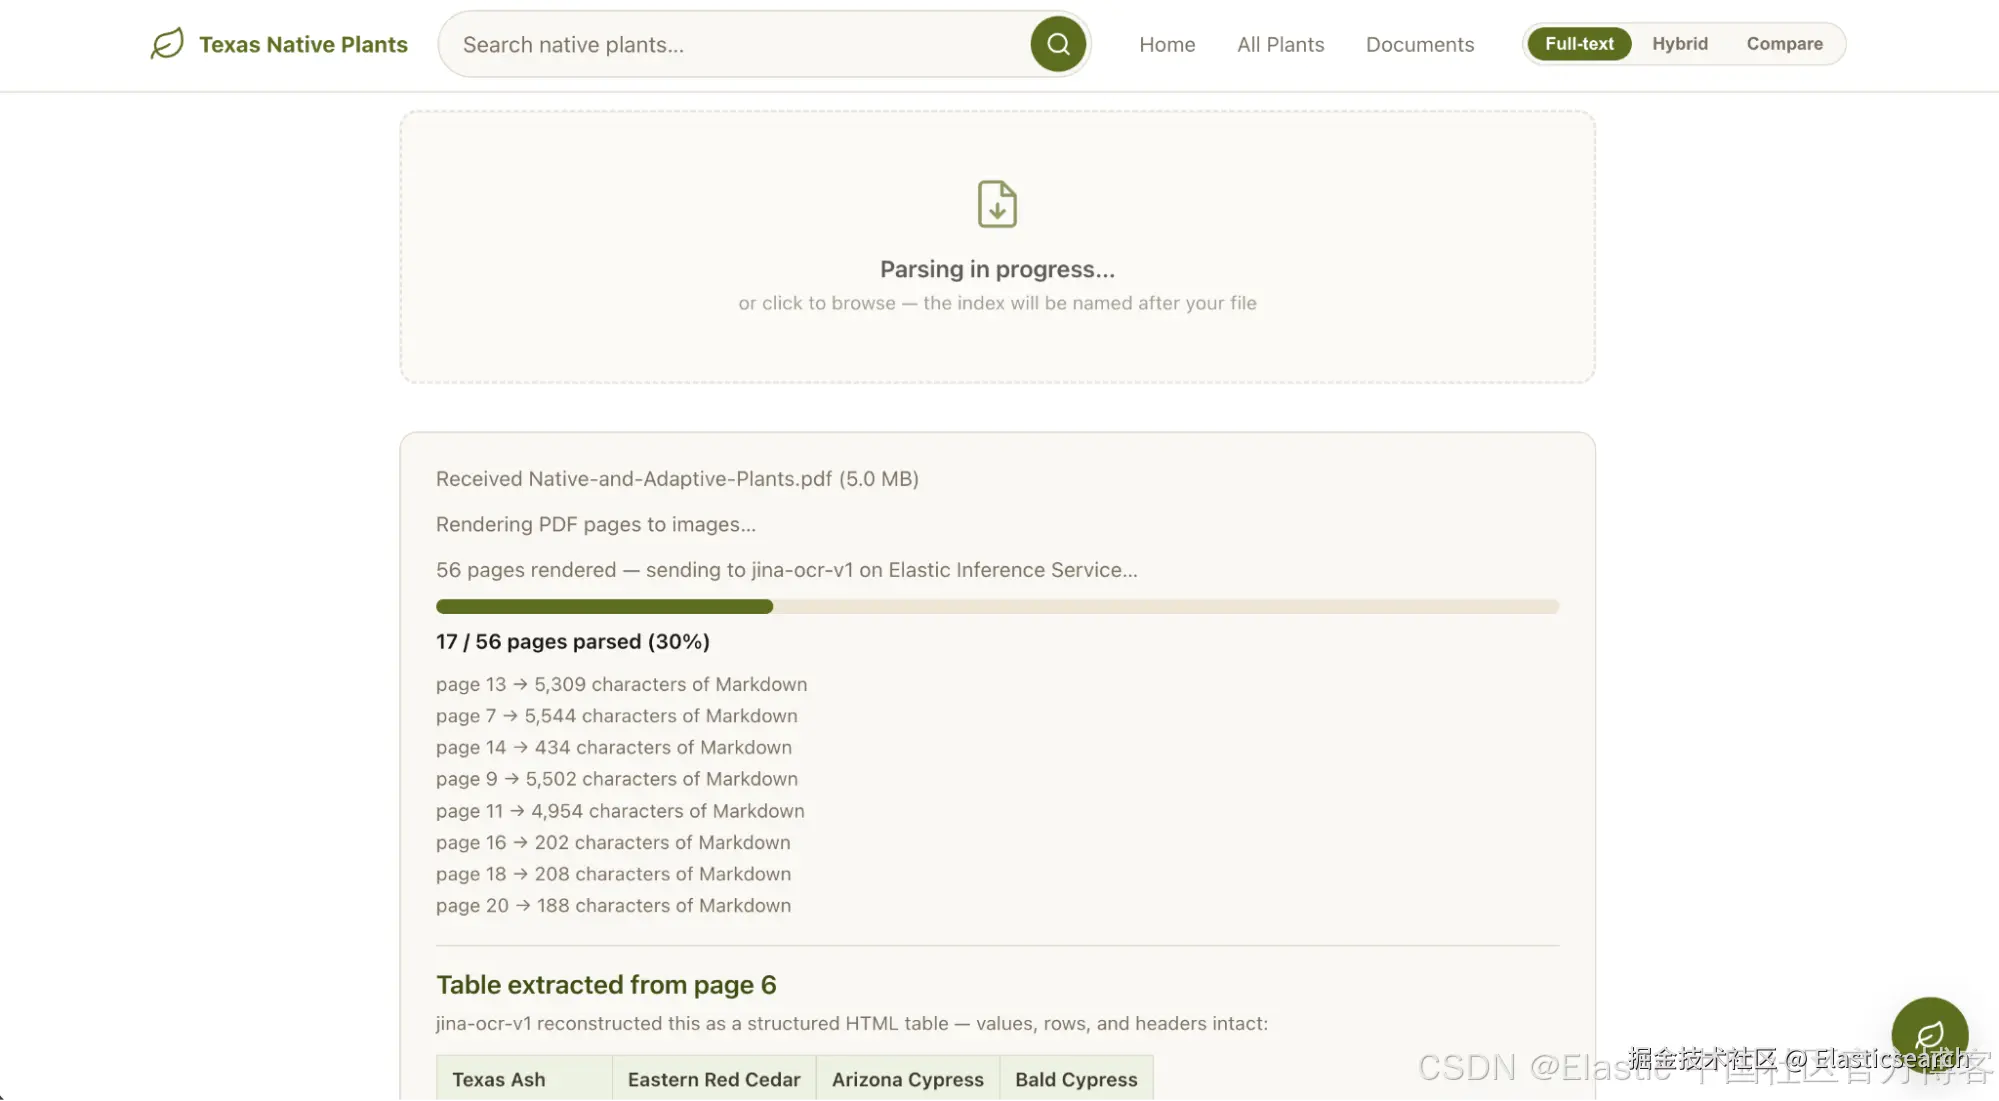
阶段 3:使用 semantic_text 为文档建立索引并生成嵌入向量
每次上传都会创建一个以文件名命名的独立索引:Native-and-Adaptive-Plants.pdf 会变为 native-and-adaptive-plants。(索引名称取自文件名,因此会与你上传的文件对应。)content 字段按词法文本建立索引,并通过 copy_to 将 内容同步 到一个 semantic_text 字段中。Elasticsearch 会在摄取时通过项目的默认推理端点对 Markdown 进行分块并生成嵌入向量。因此,你无需编写分块代码、构建嵌入流水线,也无需管理向量。
bash
`
1. PUT native-and-adaptive-plants
2. {
3. "mappings": {
4. "properties": {
5. "content": { "type": "text", "copy_to": "content_semantic" },
6. "content_semantic": { "type": "semantic_text" },
7. "title": { "type": "keyword" },
8. "page_count": { "type": "integer" }
9. }
10. }
11. }
`AI代码解释阶段 4:在 Elastic 中检查新索引
文档索引完成后,用户界面会提示解析已完成,并让你检查 Elastic 索引。打开项目,就能看到以该文档命名的索引,其中的内容已完成分块并生成嵌入向量。一个小型注册表索引( doc-registry )会跟踪每份已解析的文档,以便聊天功能列出这些文档。
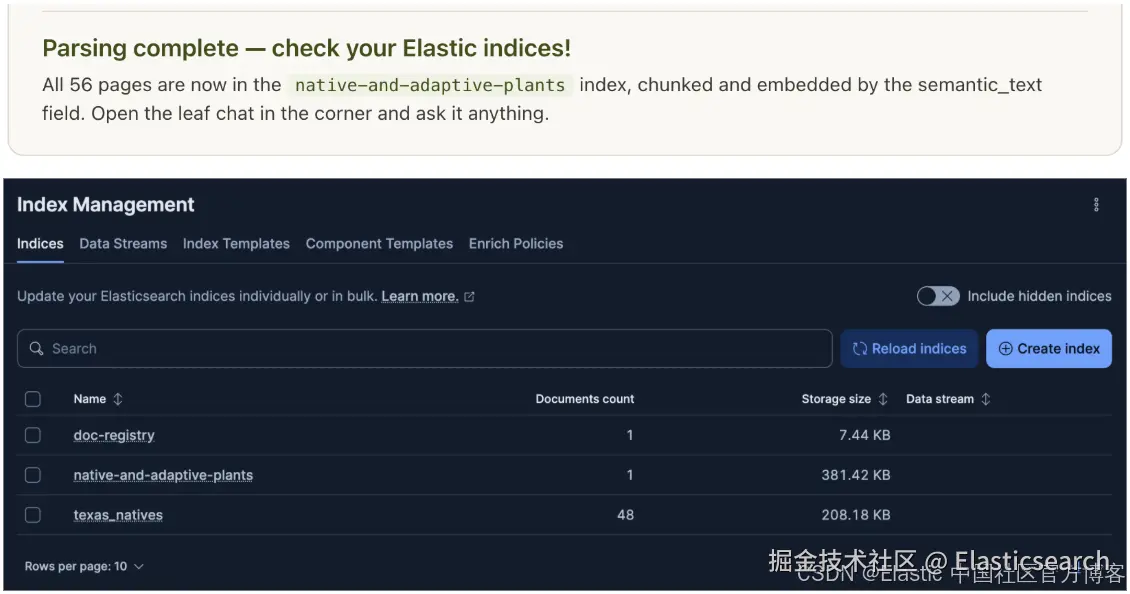 图 6:完成提示横幅显示新索引的名称,Elastic 控制台中也能看到同一个索引。
提问:混合检索与有据可依的生成
每个页面角落的叶形聊天按钮都能打开植物顾问。默认情况下,它会基于"全部内容"(上传的指南和商品目录)回答问题。用户可以将范围缩小到单份文档或仅限商品目录,而默认模式最能体现零售场景的价值。服务器分三步作答:
1. 混合检索:词法搜索与语义搜索如何结合
两次混合搜索并行运行,一次搜索文档索引,另一次搜索商品目录。每次搜索都使用倒数排名融合检索器,融合针对同一文本的两种排名:词法匹配(捕获精确词项,例如"大果栎"的学名" Quercus macrocarpa "、需水量代码" VL "或价格)和语义查询(即使没有任何句子包含"适合岩石较多的碱性土壤的树木"这些词,也能理解并匹配其含义)。在这组语料中,混合搜索总能找出关键词匹配遗漏的植物;店面网站的对比视图会针对任意查询,准确展示这些植物。
css
`

1.  "retriever": {
2.    "rrf": {
3.      "retrievers": [
4.        { "standard": { "query": { "match":    { "content": question } } } },
5.        { "standard": { "query": { "semantic": { "field": "content_semantic",
6.                                                 "query": question } } } }
7.      ]
8.    }
9.  }

`AI代码解释
2. 来源提取与页码引用
这些工作由高亮器完成。语义高亮器返回最匹配的嵌入文本块,普通高亮器返回词法匹配片段。页码则从摄取循环嵌入的页面标记中提取。每个来源都会标注指南名称和页码。
3. 生成:使用 Claude Haiku 4.5 生成有据可依的答案
来源、匹配的目录商品和问题会一并发送给 Elastic 推理服务上的 Claude Haiku 4.5,并附带严格的依据约束:仅根据来源作答,按名称和页码引用来源,仅推荐商品目录中存在的产品,如果来源中没有答案,就明确说明。模型还会返回一个隐藏行,列出所推荐商品的库存单位编码,服务器会将这一行从输出流中移除;界面只展示这些商品,因此,当商店无法满足某个问题所表达的需求时,就会如实作答,不显示任何商品卡片。答案以流式方式显示在聊天窗口中,附带可展开的来源面板,下方还有默认折叠的"查看推荐"区域。
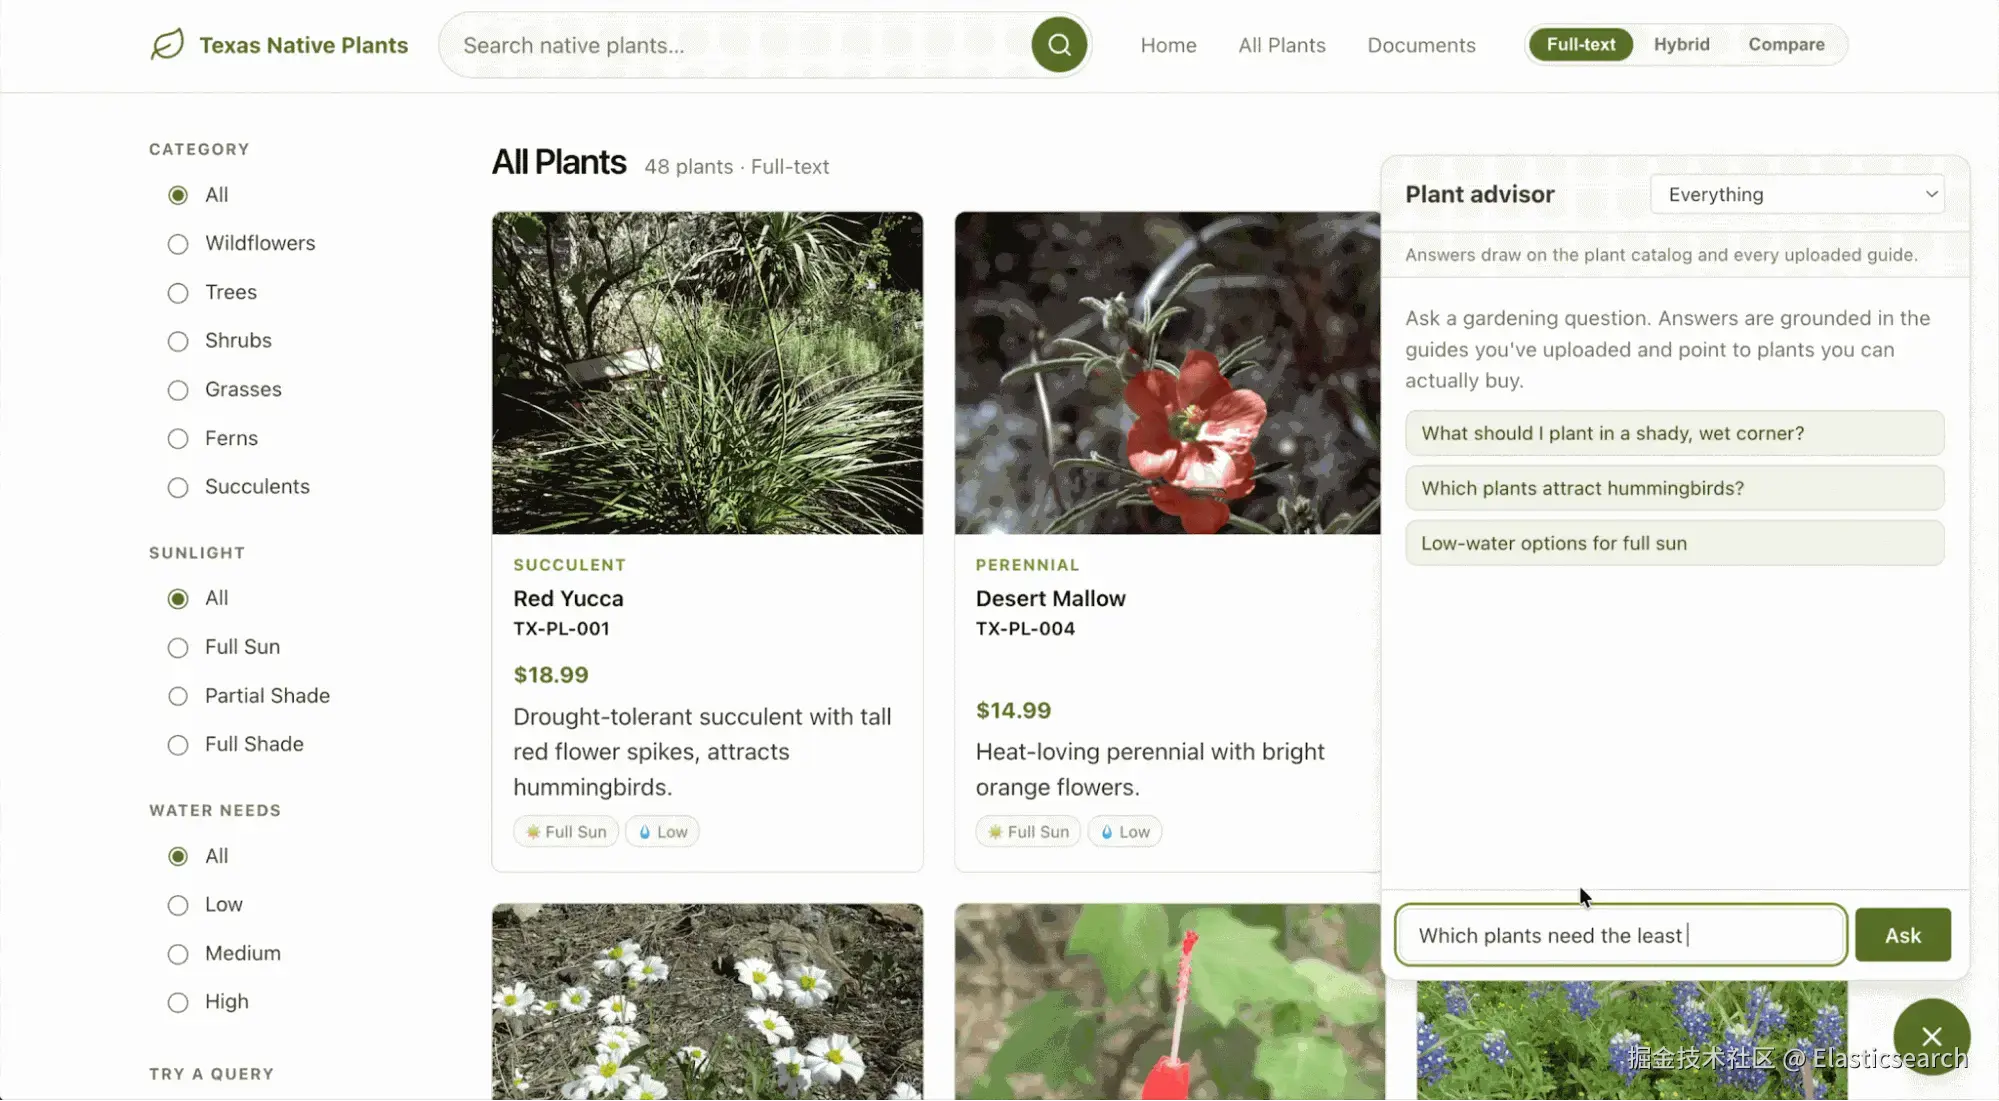 图 7:植物顾问回答"哪些植物的需水量最少?",以流式方式显示答案,并提供标注页码的来源。推荐商品折叠显示在下方。
可针对已建立索引的文档尝试的查询
- 哪些树木能耐受浅层石灰岩土壤?(语义检索发挥主要作用。)
- 指南如何介绍大果栎?(词法检索精确匹配植物学名 Quercus macrocarpa。)
- 我应该避免种植哪些入侵植物?推荐的替代植物有哪些?(答案位于 jina-ocr-v1 重建的表格中。)
- 需水量代码 VL 和 M 分别是什么意思?(这会检验对指南图例页中图例表格的检索效果。)
从扫描版 PDF 到带引用的答案
一年前,要搭建这条流水线,需要分别部署版面分析模型、光学字符识别引擎、表格解析器、分块服务、嵌入任务和 向量数据库 。如今,两个托管组件就能完成从扫描页面到带引用答案的整个流程:jina-ocr-v1 一次处理即可将像素转换为结构化的 Markdown,而 Elasticsearch 的 semantic_text 字段则在摄取时将这些 Markdown 内容转换为支持混合搜索的知识。
这份植物指南代表了你那些最难处理的文档。换成理赔表单、实验室报告、设备手册或供应商目录,然后上传、解析、为每份文档建立索引,再提问。开始免费试用 Elastic Cloud,让这条流水线处理你团队抱怨最多的那份 PDF。
原文:www.elastic.co/search-labs...> 本文由 简悦 SimpRead 转码, 原文地址 blog.csdn.net
作者:来自 Elastic Ben-Amin York Jr.
用自然语言向一份包含大量表格的扫描版 PDF 提问,即可获得标明来源页码的答案,因为 jina-ocr-v1 会将每一页转换为结构化的 Markdown,再由 Elasticsearch 在摄取时将其转换为嵌入向量。
动手体验 Elasticsearch:深入探索 Elasticsearch 实验室代码仓库中的示例笔记本,开始免费云试用,或立即在你的本地计算机上试用 Elastic。
上传一份 56 页的扫描版植物指南,然后询问哪些树木能耐受浅层石灰岩土壤。不到五分钟,你就能获得答案,以及答案的来源页码和可供购买的适宜植物。其背后的检索增强生成( RAG )流水线包含两个托管组件。jina-ocr-v1 读取每一页扫描内容,返回保留完整表格的结构化 Markdown,而 Elasticsearch 的 semantic_text 字段则在摄取时对这些 Markdown 内容进行分块并生成嵌入向量。因此,你无需编写分块代码或运行嵌入任务。混合检索先融合关键词排名和语义排名,再由 Claude Haiku 4.5 生成有据可依的答案,整个流程都在同一个项目内通过 Elastic 推理服务( EIS )运行。
这一点很重要,因为组织所依赖的大部分知识从未进入数据库。它们存在于 PDF、扫描表单或传统搜索无法读取的文档照片中。传统的光学字符识别( OCR )流水线通过串联用于版面检测、文字识别、表格解析和阅读顺序识别的独立模型来提取这些知识,而每个模型都有各自的成本和故障模式。新一代视觉语言文档解析器只需运行一次模型,即可完成同样的工作。搭配支持向量检索的搜索引擎后,一份 PDF 或它的照片就能在几分钟内成为可查询、可引用的知识来源。
将文档解析与混合搜索和 检索增强生成 相结合,团队就能:
- 让关键词搜索和传统光学字符识别遗漏的表格、手写内容及复杂版面变得可搜索。
- 用自然语言针对文档提问,并获得有据可依、附带页码级引用的答案。
- 在一次查询中结合精确词项匹配(例如库存单位编码或植物学名)与语义匹配(含义和意图)。
- 将包含解析、嵌入向量生成和答案生成在内的整个流水线保留在同一个平台内,统一计费,并使用同一个安全边界。
图 1:用户上传一份 56 页的扫描版植物指南,并用自然语言提问。随后,用户获得基于指南内容的答案,其中包含页码引用和符合要求的产品。
在本文中,我们将逐步介绍如何为一个销售得克萨斯州本土植物的电子商务网站添加文档解析功能。(我喜欢植物!)你上传指南,查看 jina-ocr-v1 逐页解析,将输出内容索引到以该文档命名的 Elasticsearch 索引中,再通过检索增强生成聊天机器人进行查询。该机器人会按页码 引用来源 ,并推荐商品目录中的产品。技术栈如下:
- **Jina 光学字符识别( jina-ocr-v1 ):**一种文档解析模型,只需进行一次多模态处理,就能读取页面图像并返回整洁、结构化的 Markdown。
- Elastic 推理服务:随 Elastic Cloud 无服务器服务提供的图形处理器加速推理服务。Elastic 推理服务通过预配置的
chat_completion端点托管 jina-ocr-v1,同时托管嵌入模型和对话式大语言模型(本项目使用 Claude Haiku 4.5 ),因此无需部署模型、配置图形处理器,也无需单独注册供应商账号。Elastic 推理服务按词元计量使用量,并作为无服务器服务的附加项计费。各模型的当前费率见 Elastic Cloud 定价表。 - **Elasticsearch:**使用 semantic_text 字段类型存储解析后的文档。该字段类型在摄取时通过推理端点对文本进行分块并生成嵌入向量,同时支持混合检索,通过倒数排名融合(RRF)融合词法排名和语义排名。
- **React、TypeScript 和 Vite,搭配 Express 后端:**在店面网站中新增文档上传页面,通过服务器发送事件实时推送解析进度,并添加悬浮聊天组件。Express 层将所有凭据保留在服务器端。
图 2:架构。问题沿顶部流程流转;文档上传沿底部流程进行,其中 jina-ocr-v1 先将页面转换为 Markdown,再进行索引。
jina-ocr-v1 与传统光学字符识别流水线有何不同?
jina-ocr-v1 是一个单一模型,也就是说,版面分析、文字识别、表格重建和阅读顺序识别都在一次处理中完成。传统光学字符识别流水线则通过串联用于版面检测、文字识别、表格解析和阅读顺序重建的独立模型来完成同样的工作。它的输出专为检索而设计:
- 输出结构化的 Markdown,保留阅读顺序,并将章节标题保留为 Markdown 标题。
- 以 HTML 格式输出表格,完整保留其中的数值,因此,无论是涵盖 50 个州的许可明细表,还是植物养护表,都能保留表格结构。
- 在原文位置转录手写内容。
- 移除重复的页面元素,包括页眉、页脚和印刷页码,避免干扰检索;页码改由摄取循环提供。
这种整洁的结构让下游的分块、嵌入向量生成和引用更加可靠。模型每次处理一张页面图像,可清晰辨识的图像分辨率最高约为 2048 × 2048 像素,因此需要由某一方负责逐页循环处理。
逐页循环在哪里运行:Jina 阅读器接口、聊天补全接口,还是 Elastic 推理服务
由谁运行这个循环,是架构设计中需要做出的决定。
| 方式 | 谁运行逐页循环 | 输入粒度 | 运行位置 |
|---|---|---|---|
Jina 阅读器接口( r.jina.ai ) |
Jina,在服务器端运行 | 每次调用处理一份 PDF | 在你的 Elastic 项目之外;使用独立的密钥并单独计费 |
| 直接调用聊天补全接口 | 你的应用程序 | 每次调用处理一页 | 在你的 Elastic 项目之外 |
Elastic 推理服务( .jina-ocr-v1-chat_completion ) |
你的应用程序 | 每次调用处理一张页面图像 | 在你的 Elastic 项目之内;使用一个密钥,统一计费 |
本文采用 Elastic 推理服务方案,即整个流程位于同一个平台边界内,而逐页循环只需在 server/documents.js 中编写几十行代码。
为什么扫描版植物指南是文档解析的一项严峻考验
演示语料只有具备挑战性,才有说服力。我们的测试文档是《本土及适生景观植物:得克萨斯州中部环保指南》,这是一份由奥斯汀市与得克萨斯州农业生命推广服务机构共同编写的教育出版物,旨在帮助公众节约用水并开展环保园艺。它也是该市绿色种植计划所采用的植物名录。这份指南包含 56 页扫描内容,恰好属于基础 PDF 文本提取容易出错的内容类型。几乎每一页都是密集的多列表格,其中充斥着缩写(例如," VL "表示需水量极低," B/E "表示黑土草原和爱德华兹高原)、表示野生动物价值和抗鹿啃食能力的勾选标记、斜体植物学名,以及穿插在数据中的照片说明。能够重建这些表格并完整保留其中数值的解析器,也能处理你的发票。
图 3:由 jina-ocr-v1 重建的指南第 50 页"应避免种植的入侵植物"表格,其中列出了推荐的本土替代植物。
植物主题也为文档智能提供了应用场景。宿主应用是一个销售得克萨斯州本土植物的店面网站,其 Elasticsearch 商品目录已预先填充数据:包含 48 种植物,使用 semantic_text 字段存储描述,并提供全文搜索与混合搜索的切换功能。添加文档智能后,购物者就能上传一份地区种植指南,然后询问:*哪些树木能耐受浅层石灰岩土壤?*他们将获得基于指南内容的答案,其中包含页码引用和符合要求的产品列表。
前提条件:Elastic Cloud、接口密钥和扫描文档
- 一个 Elastic Cloud 账号(免费试用账号也可以)。创建一个 Elastic Cloud 无服务器项目。向量数据库项目类型适合这种大量使用嵌入向量的工作负载。
- 在项目中,确认 Elastic 推理服务的模型列表包含 Jina 光学字符识别第一版(
.jina-ocr-v1-chat_completion)和 Claude Haiku 4.5(.anthropic-claude-4.5-haiku-chat_completion)。两者均已预配置,无需部署。 - 一个具有索引读写权限和推理权限的 Elasticsearch 接口密钥,以及你的项目端点地址。
- Node.js 20 或更高版本、npm 和 git。
- 一份测试文档,例如上文链接的*《本土及适生景观植物》*指南,或你自己的任何包含大量表格的扫描文档。
搭建扫描版 PDF 的检索增强生成流水线
**步骤 1:**克隆代码仓库并安装依赖。
bash
`

1.  git clone https://github.com/elastic/elastic-labs.git
2.  cd elastic-labs/supporting-blog-content/jina-ocr-v1-hybrid-rag-elasticsearch
3.  npm install

`AI代码解释
**步骤 2:**配置凭据。复制模板,并填入你的项目配置值。.env 文件已被 git 忽略,因此密钥不会进入代码仓库。光学字符识别端点已预配置,嵌入模型采用项目默认模型,因此聊天模型是本项目中唯一需要选择的模型,而且已经为你选好了。
bash
`cp .env.example .env`AI代码解释
ini
`

1.  ELASTICSEARCH_URL=https://<your-project>.es.<region>.elastic.cloud:443
2.  ELASTICSEARCH_API_KEY=<your-api-key>
3.  LLM_INFERENCE_ID=.anthropic-claude-4.5-haiku-chat_completion

`AI代码解释
**步骤 3:**填充商品目录。初始化脚本会创建商品目录索引( long_description 是一个文本字段,其内容会同步到 semantic_text 字段,因此商品混合搜索可以立即使用),并批量加载 48 种植物。首次运行大约需要一分钟,因为 Elasticsearch 会在摄取时为每条描述生成嵌入向量。
arduino
`npm run seed`AI代码解释**步骤 4:**在两个终端中分别启动后端和前端,先启动后端。
在第一个终端中,启动 Express 接口服务。它监听 3001 端口(由 .env 中的 PORT 设置),并运行光学字符识别流水线和聊天功能。
arduino
`npm run server`AI代码解释在第二个终端中,启动 React 应用的 Vite 开发服务器。它会将 /api 调用代理到后端。
arduino
`npm run dev`AI代码解释Vite 会输出服务地址,通常为 http://localhost:5173。(如果 5173 端口已被占用,它会选择下一个可用端口。)打开该地址;不要直接访问 3001 端口,因为该端口仅提供接口服务。
光学字符识别流水线如何将扫描页面转换为 Markdown
解析过程会在文档页面上直观呈现。用户拖入一份 PDF 或一张照片后,Express 服务器便会运行一个包含四个阶段的流水线,同时通过服务器发送事件将每一步的进展实时传回浏览器。
阶段 1:将 PDF 页面渲染为图像
PDF 会在内存中渲染为分辨率约为 1224 × 1584 像素的 PNG 页面图像,低于模型可清晰辨识的 2048 像素上限。拍摄的文档照片则直接作为单页进入下一阶段。
阶段 2:转录每一页并重建表格
每张页面图像都以 base64 数据地址的形式发送到 Elastic 推理服务端点,与调用任何聊天模型的视觉功能完全相同。每次并行处理四页,并在重新组装时保留原始顺序:
markdown
``
1. const resp = await fetch(
2. `${ES_URL}/_inference/chat_completion/.jina-ocr-v1-chat_completion/_stream`,
3. {
4. method: 'POST',
5. headers: { Authorization: `ApiKey ${ES_API_KEY}` },
6. body: JSON.stringify({
7. messages: [{
8. role: 'user',
9. content: [
10. { type: 'image_url',
11. image_url: { url: `data:image/png;base64,${png}` } },
12. { type: 'text',
13. text: '将此页转录为整洁的 Markdown,保留阅读顺序。将表格表示为 HTML 表格。' }
14. ]
15. }]
16. })
17. }
18. );
``AI代码解释每完成一页,浏览器就会记录其处理结果,例如"第 12 页:2,572 个 Markdown 字符"。只要任意一页生成了第一个 HTML 表格,服务器就会立即将其发送给浏览器,用户界面随即以完整样式渲染该表格。看着一张密集的扫描版植物表格重新呈现为结构化的 HTML 表格,其中每个需水量代码和高度范围都完整保留,是整个演示中最有说服力的时刻。
阶段 3:使用 semantic_text 为文档建立索引并生成嵌入向量
每次上传都会创建一个以文件名命名的独立索引:Native-and-Adaptive-Plants.pdf 会变为 native-and-adaptive-plants。(索引名称取自文件名,因此会与你上传的文件对应。)content 字段按词法文本建立索引,并通过 copy_to 将 内容同步 到一个 semantic_text 字段中。Elasticsearch 会在摄取时通过项目的默认推理端点对 Markdown 进行分块并生成嵌入向量。因此,你无需编写分块代码、构建嵌入流水线,也无需管理向量。
bash
`
1. PUT native-and-adaptive-plants
2. {
3. "mappings": {
4. "properties": {
5. "content": { "type": "text", "copy_to": "content_semantic" },
6. "content_semantic": { "type": "semantic_text" },
7. "title": { "type": "keyword" },
8. "page_count": { "type": "integer" }
9. }
10. }
11. }
`AI代码解释阶段 4:在 Elastic 中检查新索引
文档索引完成后,用户界面会提示解析已完成,并让你检查 Elastic 索引。打开项目,就能看到以该文档命名的索引,其中的内容已完成分块并生成嵌入向量。一个小型注册表索引( doc-registry )会跟踪每份已解析的文档,以便聊天功能列出这些文档。
图 6:完成提示横幅显示新索引的名称,Elastic 控制台中也能看到同一个索引。
提问:混合检索与有据可依的生成
每个页面角落的叶形聊天按钮都能打开植物顾问。默认情况下,它会基于"全部内容"(上传的指南和商品目录)回答问题。用户可以将范围缩小到单份文档或仅限商品目录,而默认模式最能体现零售场景的价值。服务器分三步作答:
1. 混合检索:词法搜索与语义搜索如何结合
两次混合搜索并行运行,一次搜索文档索引,另一次搜索商品目录。每次搜索都使用倒数排名融合检索器,融合针对同一文本的两种排名:词法匹配(捕获精确词项,例如"大果栎"的学名" Quercus macrocarpa "、需水量代码" VL "或价格)和语义查询(即使没有任何句子包含"适合岩石较多的碱性土壤的树木"这些词,也能理解并匹配其含义)。在这组语料中,混合搜索总能找出关键词匹配遗漏的植物;店面网站的对比视图会针对任意查询,准确展示这些植物。
css
`

1.  "retriever": {
2.    "rrf": {
3.      "retrievers": [
4.        { "standard": { "query": { "match":    { "content": question } } } },
5.        { "standard": { "query": { "semantic": { "field": "content_semantic",
6.                                                 "query": question } } } }
7.      ]
8.    }
9.  }

`AI代码解释
2. 来源提取与页码引用
这些工作由高亮器完成。语义高亮器返回最匹配的嵌入文本块,普通高亮器返回词法匹配片段。页码则从摄取循环嵌入的页面标记中提取。每个来源都会标注指南名称和页码。
3. 生成:使用 Claude Haiku 4.5 生成有据可依的答案
来源、匹配的目录商品和问题会一并发送给 Elastic 推理服务上的 Claude Haiku 4.5,并附带严格的依据约束:仅根据来源作答,按名称和页码引用来源,仅推荐商品目录中存在的产品,如果来源中没有答案,就明确说明。模型还会返回一个隐藏行,列出所推荐商品的库存单位编码,服务器会将这一行从输出流中移除;界面只展示这些商品,因此,当商店无法满足某个问题所表达的需求时,就会如实作答,不显示任何商品卡片。答案以流式方式显示在聊天窗口中,附带可展开的来源面板,下方还有默认折叠的"查看推荐"区域。
图 7:植物顾问回答"哪些植物的需水量最少?",以流式方式显示答案,并提供标注页码的来源。推荐商品折叠显示在下方。
可针对已建立索引的文档尝试的查询
- 哪些树木能耐受浅层石灰岩土壤?(语义检索发挥主要作用。)
- 指南如何介绍大果栎?(词法检索精确匹配植物学名 Quercus macrocarpa。)
- 我应该避免种植哪些入侵植物?推荐的替代植物有哪些?(答案位于 jina-ocr-v1 重建的表格中。)
- 需水量代码 VL 和 M 分别是什么意思?(这会检验对指南图例页中图例表格的检索效果。)
从扫描版 PDF 到带引用的答案
一年前,要搭建这条流水线,需要分别部署版面分析模型、光学字符识别引擎、表格解析器、分块服务、嵌入任务和 向量数据库 。如今,两个托管组件就能完成从扫描页面到带引用答案的整个流程:jina-ocr-v1 一次处理即可将像素转换为结构化的 Markdown,而 Elasticsearch 的 semantic_text 字段则在摄取时将这些 Markdown 内容转换为支持混合搜索的知识。
这份植物指南代表了你那些最难处理的文档。换成理赔表单、实验室报告、设备手册或供应商目录,然后上传、解析、为每份文档建立索引,再提问。开始免费试用 Elastic Cloud,让这条流水线处理你团队抱怨最多的那份 PDF。