19 · KV 复用迁移到 GPU(上):per-state 镜像与同类静默分叉
一句话 :GPU 侧的 KV 缓存一直没有 CPU 那套调度能力(分页、前缀复用、disk-KV、L3 驻留),只有一份扁平镜像;迁移的第一步是把它改成 per-state 槽位池 ,并堵掉「多 state 共用镜像」「内存前缀复用不写镜像」两处同类静默分叉。 前置 :建议先读 第 18 篇(把 attention/decode 数值做到位级的前提)。 环境 :x86-64 + NVIDIA RTX 5090(CUDA 后端)· Qwen3-30B-A3B q4local · 开关
VLLM_CUDA_ATTN=1/VLLM_CUDA_DECODE=1。
状态:✅ 已落地并复验(opt-in 档不回归,=0 档与迁移前逐字节一致)。
一、问题与结论
- 原设计在多 state 下必错 :device KV 镜像原为全后端单份 ,且
vcuda_dev_kv_init会 free-all 后重建 ------ 第二个 state 一 init 就把第一个 state 的镜像指针释放掉;多个 state 的行还会互相覆盖。 - 前缀复用是第二处 :
st_qwen_copy_kv_prefix只复制 CPU 侧 KV 数组、不碰镜像 ,却把dst->cache_len[l]直接前移到prefix_len。于是镜像的前缀行是未初始化垃圾,后续 decode/attention 会静默读它。 - 地雷已复现(硬数据) :
VLLM_STREAM_COPYTEST=1 VLLM_CUDA_ATTN=1 --cuda→A_NLL=6.631492386 B_NLL=18.756641629 diff=-1.213e+01 FAIL(纯 CPU 基线diff=0.000e+00 PASS)。B 侧 NLL 飞到 18.75,是典型的「读到垃圾」。 - 修法不是加开关,是改归属 :镜像从「单份」改成 per-state 槽位池 (
vc_kv_slot_t kv[8]),kv_init只分配/释放本槽位 ;引擎侧STQwenInferenceState持槽位号,惰性 acquire、free 时归还。 - 把「拒绝」升级为「同步」 :新增
vcuda_dev_kv_copy_prefix(device-to-device 逐层拷[0,prefix)的 K/V/ks/vs),在st_qwen_copy_kv_prefix末尾补齐镜像。判别量diff从-4.205e-03变为0.000e+00,且[CUDA-KV-GUARD]告警消失 ------ 证明被复用侧的 state 确实从「CPU 回退」切到了「同步后的镜像」,且与全量路径逐位一致。 - 无回归(逐字节硬证) :L2 两档 dump(纯 CPU /
DECODE+INFER+FORCE_CPU+L2EXACT,2120 key)改造前后 SHA256 完全相同 (A15A5FB9.../24B104A6...)。
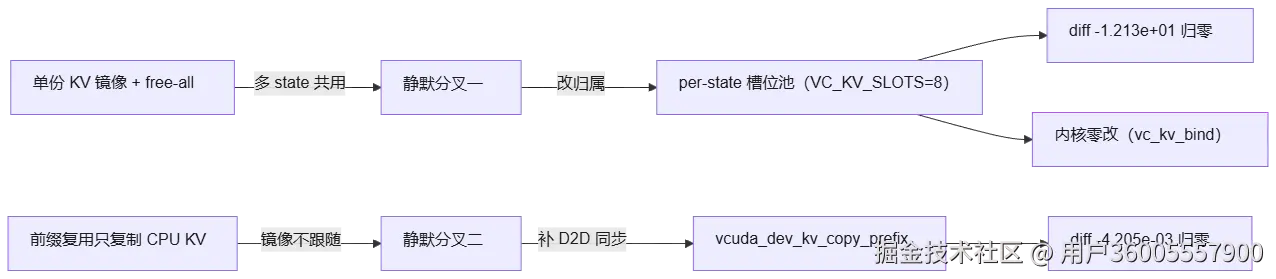
图 1 :本篇两处「同类静默分叉」的成因与修法。上支:device KV 镜像原为全后端单份、
kv_initfree-all 后重建,多 state 共用时会互相释放/覆盖行(复现A_NLL=6.63 / B_NLL=18.76 / diff=-1.213e+01 FAIL);修法是把归属改成 per-state 槽位池 (VC_KV_SLOTS=8),并用vc_kv_bind的指针视图把改动挡在 API 层------三个 attention 内核与vc_decode_body一行未改。下支:st_qwen_copy_kv_prefix只复制 CPU KV、不碰镜像,导致镜像前缀读垃圾;修法是补vcuda_dev_kv_copy_prefix(逐层 D2D 拷[0,prefix)的 K/V/ks/vs),diff由-4.205e-03变为0.000e+00。两处都坚持「不允许静默读垃圾」。
二、背景:CPU 有、GPU 没有的调度能力
CPU 侧 KV 缓存早已具备(设计见 docs/KV缓存v2-惰性分配与分层驻留方案.md):
| 能力 | CPU 侧实现 | GPU 侧(迁移前) |
|---|---|---|
| 分页 | kv_bs 块 + 块指针数组 |
❌ 扁平 [nl][max_seq][kv_dim] |
| 内存前缀复用 | st_qwen_copy_kv_prefix(逐块 memcpy + scale) |
❌ 镜像不跟随 |
| disk-KV 快照 | st_kv_disk_save/load(q8+scale) |
❌ 镜像不跟随 |
| L3 分层驻留 | Q4 驱逐 + 按需回填 | ❌ 无等价物 |
GPU 侧的镜像只有一个用途:让 attention 内核不必逐块跳转 地流式读 KV(vc_dev_t 注释:mirrored as flat [nl][max_seq][kv_dim] int8 + [nl][max_seq][nkv] f32 scales)。它是「派生物」,必须以 CPU 的 q8+scale 行为唯一真值。迁移的全部难点都在这个不变式上。
三、核心机制
3.1 地雷一:单份镜像 + free-all
原实现里 vc_dev_t 只有一个扁平镜像字段,vcuda_dev_kv_init 进来先 vc_kv_free(s) 无条件释放 那份镜像再 cudaMalloc。引擎侧靠 st->cuda_kv_ready 做「每 state 只 init 一次」,但对共享的同一份 device 缓冲 来说这个 per-state 标志是错位的:state A 先 append → init 出镜像 P;state B 首次 append → 也走 !cuda_kv_ready 分支 → kv_init 把 P 释放、另建 P'。A 之后读的仍是旧指针语义下的 P',内容还是 B 写的。
复现(现成 harness 正好是三 state 结构:COPYTEST 建 istA/istT/istB,A 走「全量 prefill」,B 走「st_qwen_copy_kv_prefix(T→B) + 续 prefill」,最后比较两条路的 forced-NLL):
ini
# 基线(纯 CPU,CUDA 全关)
[STREAM] COPYTEST A_NLL=6.635696930 (n=20)  B_NLL=6.635696930 (n=20)  diff=0.000e+00 PASS

# 地雷(VLLM_CUDA_ATTN=1 --cuda)
[STREAM] COPYTEST A_NLL=6.631492386 (n=20)  B_NLL=18.756641629 (n=20)  diff=-1.213e+01 FAIL
B_NLL 从 6.64 飞到 18.76 ------ 语言模型 NLL 的正常区间是 5--7,18.76 只可能来自「注意力读到了语义无关的向量」。地雷确凿。
3.2 落地一:镜像改成 per-state 槽位池(device 侧)
仓库里的槽位定义与 vc_dev_t 挂载(src/npu/cuda/vllm_cuda_kernels.cu):
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu */
/* Per-state KV mirror slot(镜像按 state 归属,不再单份 free-all)。 */
#define VC_KV_SLOTS 8
typedef struct {
    int      used;      /* 1 = 该槽位已被 acquire */
    int      nl, max_seq, kv_dim, nkv;
    int8_t  *d_k;       /* [nl][max_seq][kv_dim] int8 K */
    int8_t  *d_v;       /* [nl][max_seq][kv_dim] int8 V */
    float   *d_ks;      /* [nl][max_seq][nkv]  f32 K scale */
    float   *d_vs;      /* [nl][max_seq][nkv]  f32 V scale */
} vc_kv_slot_t;

/* vc_dev_t 内 */
vc_kv_slot_t kv[VC_KV_SLOTS];
int     kv_act;   /* bound slot index, -1 = none */
int8_t *d_k, *d_v; float *d_ks, *d_vs;   /* 指向当前绑定槽位的「视图」 */
kv_init 只动本槽位(彻底去掉 free-all):
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu,vcuda_dev_kv_init() */
/* Allocate the GPU K/V mirror for ONE slot. Other slots are untouched:
 * this is the per-state ownership that replaces the old free-all. */
VCUDA_API int vcuda_dev_kv_init(void *dev, int slot, int nl, int max_seq,
                                int kv_dim, int nkv) {
    vc_dev_t *s = (vc_dev_t *)dev;
    if (!s || !s->ok) return -1;
    if (slot < 0 || slot >= VC_KV_SLOTS) return -1;
    vc_kv_slot_t *k = &s->kv[slot];
    if (!k->used) return -1;   /* must be acquired first (kv_slot_alloc) */
    const size_t kv_elems = (size_t)nl * max_seq * kv_dim;
    const size_t sc_elems = (size_t)nl * max_seq * nkv;
    if (cudaMalloc((void **)&k->d_k,  kv_elems) != cudaSuccess || ... ) { /* 释放半成品 */ }
    k->nl = nl; k->max_seq = max_seq; k->kv_dim = kv_dim; k->nkv = nkv;
    return vc_kv_bind(s, slot);
}
三个关键设计:
kv_init(dev, slot, ...)只动本槽位,彻底去掉 free-all。vc_kv_bind(slot)把槽位「绑定」成扁平指针视图 (s->d_k = k->d_k; ...)。这样三个 attention 内核与vc_decode_body的s->d_k + base*kv_dim这类行寻址一行都不用改------改动被限制在 API 边界,热点路径零风险。
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu,vc_kv_bind() */
static int vc_kv_bind(vc_dev_t *s, int slot) {
    if (slot < 0 || slot >= VC_KV_SLOTS) return -1;
    vc_kv_slot_t *k = &s->kv[slot];
    if (!k->used) return -1;
    if (s->kv_act != slot && s->graph_ready) {   /* 切槽位使已捕获的 CUDA Graph 失效 */
        cudaGraphExecDestroy(s->gexec); s->gexec = NULL;
        cudaGraphDestroy(s->graph);     s->graph = NULL;
        s->graph_ready = 0;
    }
    s->kv_act = slot;
    s->kv_nl = k->nl; s->kv_max_seq = k->max_seq;
    s->kv_dim = k->kv_dim; s->kv_nkv = k->nkv;
    s->d_k = k->d_k; s->d_v = k->d_v; s->d_ks = k->d_ks; s->d_vs = k->d_vs;
    return 0;
}- 切槽位会让已捕获的 CUDA Graph 失效 (图里固化的是镜像基址),
vc_kv_bind检测到kv_act变化就销毁gexec/graph,下次重捕获。
槽位生命周期由两个 API 管:vcuda_dev_kv_slot_alloc(dev)(→ slot 或 -1 池满)、vcuda_dev_kv_slot_free(dev, slot)(释放本槽位,含图失效)。append / attn_q8 / decode_run / spec_probe / spec_verify 全部加 slot 参数并在入口 vc_kv_bind。
3.3 引擎侧:槽位惰性 acquire
STQwenInferenceState 用槽号持有,st_cuda_kv_slot(st) 惰性 acquire,st_qwen_inference_free 归还。仓库里的惰性分配(src/model/vllm_safetensors.c):
c
/* 文件名:src/model/vllm_safetensors.c */
/* Resolve (lazily acquiring) this state's device KV-mirror slot. Returns a slot
 * index >= 0, or -1 when no mirror is available (pool full / no backend). */
static int st_cuda_kv_slot(STQwenInferenceState *st) {
    if (st->cuda_kv_slot >= 0) return st->cuda_kv_slot;
    if (st->cuda_kv_slot == -2) return -1;   /* 已判定池满:不再重试、不再刷屏 */
    vllm_cuda_t *c = st_cuda_of(st);
    if (!c || !vllm_cuda_available(c)) return -1;
    st->cuda_kv_slot = vllm_cuda_kv_slot_alloc(c);
    if (st->cuda_kv_slot < 0) {   /* pool exhausted: say so once, don't degrade silently */
        fprintf(stderr,
                "[CUDA-KV-SLOT] device KV mirror pool exhausted (VC_KV_SLOTS) -> "
                "this state falls back to CPU attention/decode\n");
        st->cuda_kv_slot = -2;
        return -1;
    }
    return st->cuda_kv_slot;
}草稿模型走独立设备 g_draft_cuda,因此天然各自成池(不受主模型槽位占用影响)。
槽位容量 :VC_KV_SLOTS 初值 4,实测 COPYTEST 自身就要 4 个(stream state + istA/istT/istB),正好顶格 → 抬到 8 留余量。池满时打印一次告警 并让该 state 回退 CPU(槽位记 -2,避免每层每 token 重试刷屏)。
内存代价:镜像单槽 =
nl·max_seq·(2·kv_dim + 8·nkv)。对本机 30B-A3B(48 层 / kv_dim=512 / max_seq=8192)= 415,236,096 B ≈ 396 MiB (测算见 第 21 篇)。只有真正 append 的 state 才分配,故实际开销正比于并发。
四、地雷二:前缀复用不碰镜像
4.1 问题
st_qwen_copy_kv_prefix 逐块把 CPU 数组 memcpy 好、把 dst->cache_len[l] 设成 prefix_len,但 device 镜像一行都没写 。此后 dst 一 append 就从 pos = prefix_len 开始写,镜像的 [0, prefix_len) 永远是未初始化内容。
4.2 第一步:拒绝,而不是静默
同步不成时,让该 state 整体回退 CPU,并打印一次性 [CUDA-KV-GUARD] 告警。复验(ATTN=1 ATTN_BITEXACT=1):
ini
[CUDA-KV-GUARD] prefix copy of 74 tokens leaves the device KV mirror unsynced
                -> CUDA mirror disabled for this state (CPU fallback)
[STREAM] COPYTEST A_NLL=6.635696930  B_NLL=6.635696930  diff=0.000e+00 PASS
-1.213e+01 → 0。但这是靠「把 B 踢回 CPU」换来的 :diff 虽然为 0,B 实际没在用镜像。
4.3 第二步:真正的 device 侧同步
新增逐层 D2D 拷贝 API(src/npu/cuda/vllm_cuda_kernels.cu):
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu */
/* Copy the mirror rows [0, prefix_len) of EVERY layer from `src_slot` to
 * `dst_slot` (device-to-device). This is the device half of a host KV-prefix
 * reuse (st_qwen_copy_kv_prefix): the host rows were memcpy'd block by block,
 * so the device mirror has to follow or the subsequent decode/attention reads
 * stale/never-written rows. */
VCUDA_API int vcuda_dev_kv_copy_prefix(void *dev, int src_slot, int dst_slot,
                                       int prefix_len) {
    ...
    if (sk->nl != dk->nl || sk->max_seq != dk->max_seq ||
        sk->kv_dim != dk->kv_dim || sk->nkv != dk->nkv) return -1;
    for (int l = 0; l < sk->nl; l++) {
        const size_t koff = (size_t)l * (size_t)sk->max_seq * (size_t)sk->kv_dim;
        cudaMemcpyAsync(dk->d_k + koff, sk->d_k + koff, kbytes, cudaMemcpyDeviceToDevice);
        cudaMemcpyAsync(dk->d_v + koff, sk->d_v + koff, kbytes, cudaMemcpyDeviceToDevice);
        cudaMemcpyAsync(dk->d_ks + soff, sk->d_ks + soff, sbytes, cudaMemcpyDeviceToDevice);
        cudaMemcpyAsync(dk->d_vs + soff, sk->d_vs + soff, sbytes, cudaMemcpyDeviceToDevice);
    }
    ...
}
接线点在 st_qwen_copy_kv_prefix 末尾(src/model/vllm_safetensors.c):
c
/* 文件名:src/model/vllm_safetensors.c,st_qwen_copy_kv_prefix() 末尾 */
/* 同步成功 → 放开镜像(dst 继续走 CUDA,与全量 prefill 位级一致);
 * 同步失败 → 标记该 state「镜像不可用」整体回退 CPU。
 * 两种情况都不允许静默读到垃圾。 */
if (st_cuda_of(dst) && vllm_cuda_available(st_cuda_of(dst))) {
    if (st_cuda_kv_sync_prefix(dst, src, prefix_len) == 0) {
        dst->cuda_kv_nosync = 0;
        fprintf(stderr, "[CUDA-KV-SYNC] device KV mirror prefix synced "
                        "(%d tokens, slot %d <- %d)\n",
                prefix_len, dst->cuda_kv_slot, src->cuda_kv_slot);
    } else {
        fprintf(stderr, "[CUDA-KV-GUARD] prefix copy of %d tokens cannot sync the "
                        "device KV mirror -> CUDA mirror disabled for this state "
                        "(CPU fallback)\n", prefix_len);
        dst->cuda_kv_nosync = 1;
    }
}
成功则清 cuda_kv_nosync;失败(跨设备 / 任一侧无镜像 / 几何不符 / 拷贝失败)则保留上一步的 guard 回退。两种情况都不允许静默读垃圾。
一个反直觉的结论 :serve 的
ist_reset复用分支不需要接线 。它复用同一个 state 的同一份镜像 ,cache_len回绕到keep_lcp时镜像的[0,keep_lcp)行本就有效,续 prefill 从keep_lcp接着写即可。需要同步的是「跨 state / 跨设备」的复用 ,而 serve 不走st_qwen_copy_kv_prefix。(此点由读码 + 路径核对确认,见 第 20 篇 的同类教训。)
4.4 判别量:为什么 diff 能证明「B 真的在用镜像」
同一条命令(VLLM_STREAM_COPYTEST=1 VLLM_CUDA_ATTN=1 --cuda,实测):
| P0(guard 回退) | P1(真同步) | |
|---|---|---|
| 日志 | [CUDA-KV-GUARD] |
[CUDA-KV-SYNC] synced (74 tokens, slot 3 <- 2) |
A_NLL |
6.631492386(CUDA 快内核) | 6.631492386(CUDA 快内核) |
B_NLL |
6.635696930(CPU) | 6.631492386(CUDA 快内核) |
diff |
-4.205e-03 | 0.000e+00 |
A 走的是 CUDA 的默认(非位级)attention 内核,与 CPU 有 greedy 级口径差;B 在 P0 走 CPU 所以拿的是「CPU 精确值」,两者相差 -4.205e-03。P1 后 B 也走同一个 CUDA 内核读同一份数据 ,于是 A == B 逐位相同。diff 从 -4.205e-03 变 0 本身就是「B 已切到镜像」的证据 ------ 若同步写错偏移或槽位,B 会像迁移前那样大幅偏离(≈-1.2e+01)。
4.5 L2 复用对拍(判据的逐字节版)
把探针从「GPU vs CPU」换成「复用 vs 全量 」(VLLM_L2_DUMP,key = t<pos>_l<L>_{nrm,kraw,knorm,qrope,k,v,ks,vs,attn,ores,x} + t<pos>_{final_normed,logits},实测):
| 量 | 值 |
|---|---|
| A 段 / B 段 key 数 | 10070 / 10070(11 类逐层量 × 912 + logits/normed × 19) |
| A 段 vs B 段同 key 哈希 | 0 不等 |
| 整份 dump vs P0 基线(B 在 CPU 时) | 逐字节相同 |
最后一行是最强的一句:「复用 + 同步后的镜像」的输出,与「B 被迫走 CPU」的输出逐字节相同 ------ 即镜像同步路径 == CPU 路径 == 全量 prefill。
五、边界与已知限制
| 项 | 结果 |
|---|---|
=0(CUDA 全关)COPYTEST |
diff=0.000e+00 PASS,值同迁移前(6.635696930) |
| L2 纯 CPU dump | l2_ref SHA256 A15A5FB9... 逐字节不变 |
| L2 全 GPU decode dump | l2_gpu SHA256 24B104A6... 逐字节不变 |
| L2 不一致集合 | 仍 2054 个,首个仍 t32_l0_x;层 0 注意力路径十探针保持一致 |
- 本篇只覆盖两处同类分叉(多 state 共用镜像、内存前缀复用);disk-KV 恢复与 L3 见 第 20 篇。
- 镜像单槽 ≈ 396 MiB、池上限 8 槽均为本机 30B-A3B 口径,换模型/换卡需重算。
- 复用同步是 D2D 拷贝,成本随
prefix_len × nl增长;长前缀场景未单独量收益。
CPU 对照(迁移前基线)
- CPU 参考 :
kestrel-llm/src/model/vllm_safetensors.c:st_qwen_copy_kv_prefix------ CPU 内存 KV 前缀复用(迁移前的前缀复用语义)。 - 迁移要点 :单份 device KV 镜像 → per-state 槽位池(
VC_KV_SLOTS);vc_kv_bind用指针视图把槽位机制挡在 API 层(内核零改);切槽位使已捕获 graph 失效;前缀复用补 D2D 镜像同步([CUDA-KV-SYNC])。 - 真机验证 :未独立复现:需 30B-A3B +
VLLM_STREAM_COPYTEST三 state(istA/istT/istB)与 L2 复用对拍。
六、小结
- 「派生物」必须显式跟随真值。镜像相对 CPU KV 是派生数据;任何修改 CPU KV 的调度动作(前缀复用、disk-KV 恢复、L3 回填)都必须显式同步它,否则就是静默分叉。
- per-state 的
ready标志救不了共享缓冲 。st->cuda_kv_ready看似「每 state 一次初始化」,但当缓冲是全局单份时,这个标志只保证「每个 state 各 init 了一次」,结果是把别人的数据砸了。要么 per-state 归属,要么根本别用 ready 标志自我安慰。 - 改造要限制在 API 边界 。
vc_kv_bind用「指针视图」把槽位机制挡在 API 层,三个 attention 内核与vc_decode_body一行未改 ------ 这是本篇能快速、低风险落地的主因。 diff也能当证据,只要口径差异是已知的 。P1 的判别量不是「结果对不对」而是「diff是否归零」:因为 A/B 走同一内核读同一数据时必须逐位相同。先用已知口径差造出一把尺子,再拿尺子量新路径 ------ 比单纯看「输出合理」强得多。- 先复现、再动手 。三处同类隐患都是先跑出
FAIL(-1.2e+01 / -4.2e-03 / 见 第 20 篇 的 DKVTEST FAIL),再写代码。没有可证伪的复现,就无法判断修法是否真的生效。
相关篇目:第 18 篇、第 20 篇、第 21 篇 源码与配套资源:本仓库 gitee.com/pei-xiaogua...; CPU 推理源码 gitee.com/pei-xiaogua...