凌晨两点刷推送看到月之暗面发新模型,先算了一笔账:输入 13 块、输出 68 块每百万 Token,比 K3 直接腰斩,Highspeed 版速度翻三倍再翻倍价------这定价...
凌晨两点的定价:砍半不是优惠,是抢开发者预算
K3 今年 7 月发布时约 21 元 / 108 元每百万 Token。三个多月过去,K3.1 Pro 没有重新预训练,而是在同一套 2.8T MoE 基座上加码后训练,官方称跨数百个下游领域做了大规模联合强化学习。参数没变,价格直接砍到 13 / 68。
月底账单薄了
为什么敢这么定。MoE 架构是关键变量。2.8T 总参数听着吓人,每个 Token 实际只激活 104B 专家,推理成本落在百亿级稠密模型的量级。对月之暗面来说边际算力成本远低于 2.8T 稠密推理,定价空间就撑开了。对照 GPT-6 Astra 输出 50 美元 / 百万 Token(约 360 元),K3.1 Pro 的 68 元只有对方五分之一。你买的旗舰款,瞬间变成平替套餐。
13 元 / 68 元 / Highspeed 三倍速,三档怎么摆
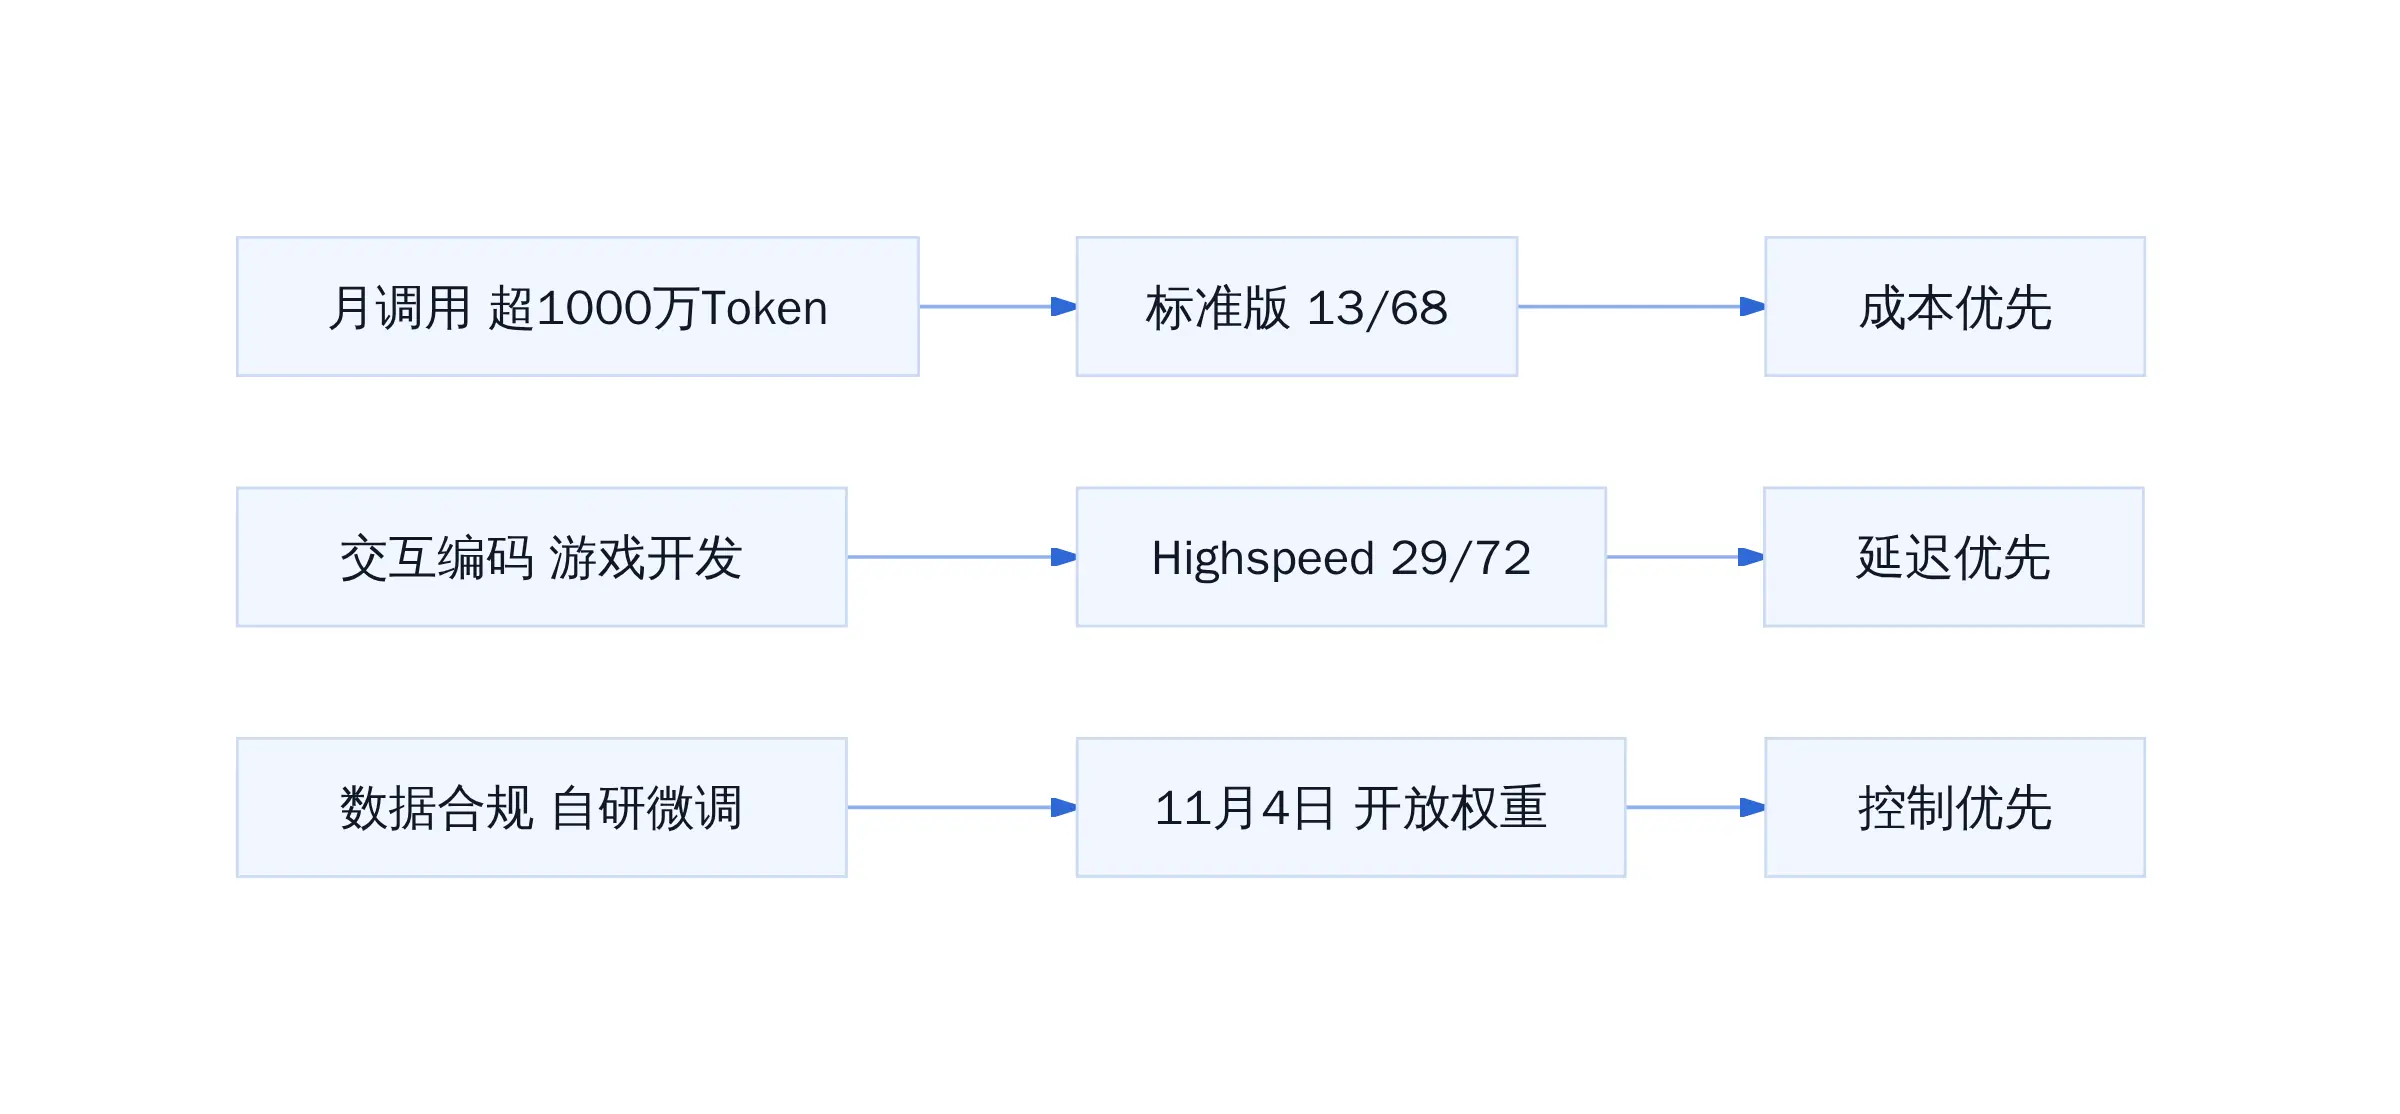
标准版 13 / 68 元走量。跑金融文档分析、百万 Token 级代码仓库扫描、批量 Agent 任务,延迟不敏感,月调用过千万 Token 时单条成本可压到几分钱。Highspeed 版输入 4 美元、输出 10 美元(约 29 / 72 元),吞吐拉满 2 到 3 倍,价格翻倍。这一档给交互式编码:Godot 里边写边跑、Unity 实时预览,反馈环从 8 秒缩到 3 秒,团队迭代节奏完全不同。
K3.1 Pro 三档选择路径
判断标准就一条,你的瓶颈是钱还是时间。跑批选标准版,做交互选 Highspeed,数据不出域等 11 月 4 日。
完整权重 11 月 4 日前开放,自部署的门槛还剩多少
2.8T 参数 FP16 落盘要 5.6TB 显存,INT8 量化压到 2.8TB。最低硬件大致 8 张 H100 80GB 合计 640GB 跑 INT8,或者 4 张卡加 4-bit 量化往极限压。MoE 的好处是计算量只跟 104B 活跃参数挂钩,瓶颈在内存带宽而非 FLOPS,推理延迟不会随总参数线性膨胀。
实话说,对绝大多数产品团队 API 就是答案。自部署真正有意义的场景卡在三条线上:金融与政企的数据合规硬要求、日调用破亿 Token 后边际成本趋近零、以及你打算在基座上做领域微调而不只是推理。11 月 4 日前把 MoE 路由表和专家分配配置文件过一遍,硬件采购周期别卡在发布节点上。
四个基准数:65.7、92.7、64.4、幻觉降 65%
月之暗面给 K3.1 Pro 配了四组对外数字,每组对应一条能力线。终端编程 65.7,CAD 工具辅助 92.7,金融文档 64.4,幻觉率从 23.4% 压到 8.3%。四个数放在一起看,后训练算力砸在哪条线上,那条线就往上顶了一截。值得注意的是,K3.1 Pro 跟 K3 总参数同为 2.8 万亿、激活 1040 亿,架构没变,涨的全是联合强化学习的量。
Terminal-Bench 4.0 差 Opus 0.7 个百分点意味着什么
Terminal-Bench 4.0 不考「写一段函数」,考的是模型在真实终端环境里完成受限任务:登录、跑脚本、排查报错、提交结果。K3.1 Pro 得 65.7%,GPT-6 Astra 58.2%,Claude Opus 5.5 66.4%。内部 Kimi Code Bench 3.0 Long-horizon 里,K3.1 Pro 拿到 61.2%,比 K3 的 55.95% 涨了 5 个点以上。
0.7 个百分点,在这个量级的评测里已经接近噪声区间。但跟 GPT-6 Astra 拉开的 7.5 个点不是噪声,是越过去了。Artificial Analysis 的 Intelligence Index 上,K3.1 Pro 排第四,比 K3 的第四十四名往上一跳就是十一分,直接顶到 Pareto 前沿。
四轮实测里,Godot 2.5D 肉鸽那关,DeepSeek 1017 和 Opus 5.5 都做出了接近成品的效果,有音乐、能选人放技能。K3.1 Pro 完成度更像 demo,没有音乐。细节赢了,物理直觉还没追上来。那条马跑得好看,但步态还是滑的。
四轮 Godot 跑完,demo 和成品之间还差一层
BenchCAD 92.7%:Blender / CAD 脚本已能端到端出图
92.7% 是 BenchCAD 工具辅助得分。对照组:Opus 5.5 拿 96.2%,GPT-6 Astra 拿 95.9%。三点五的差距,落在「能用」和「好用」之间,但没拉开代差。
实际工作流的变化是:模型现在能直接编写并运行 Blender Python 脚本完成参数化建模,也能驱动 CAD 软件出图。官方列出的场景覆盖 Unity、Unreal Engine、Godot 三大引擎,加上 Blender 和 CAD 两条 3D 管线。从「写一段建模代码」到「端到端交付可渲染的 3D 场景」,中间省掉了手动导资源、逐帧调参数的环节。对独立游戏团队和工业设计师来说,缩短的是从概念图到可交互原型的时间。
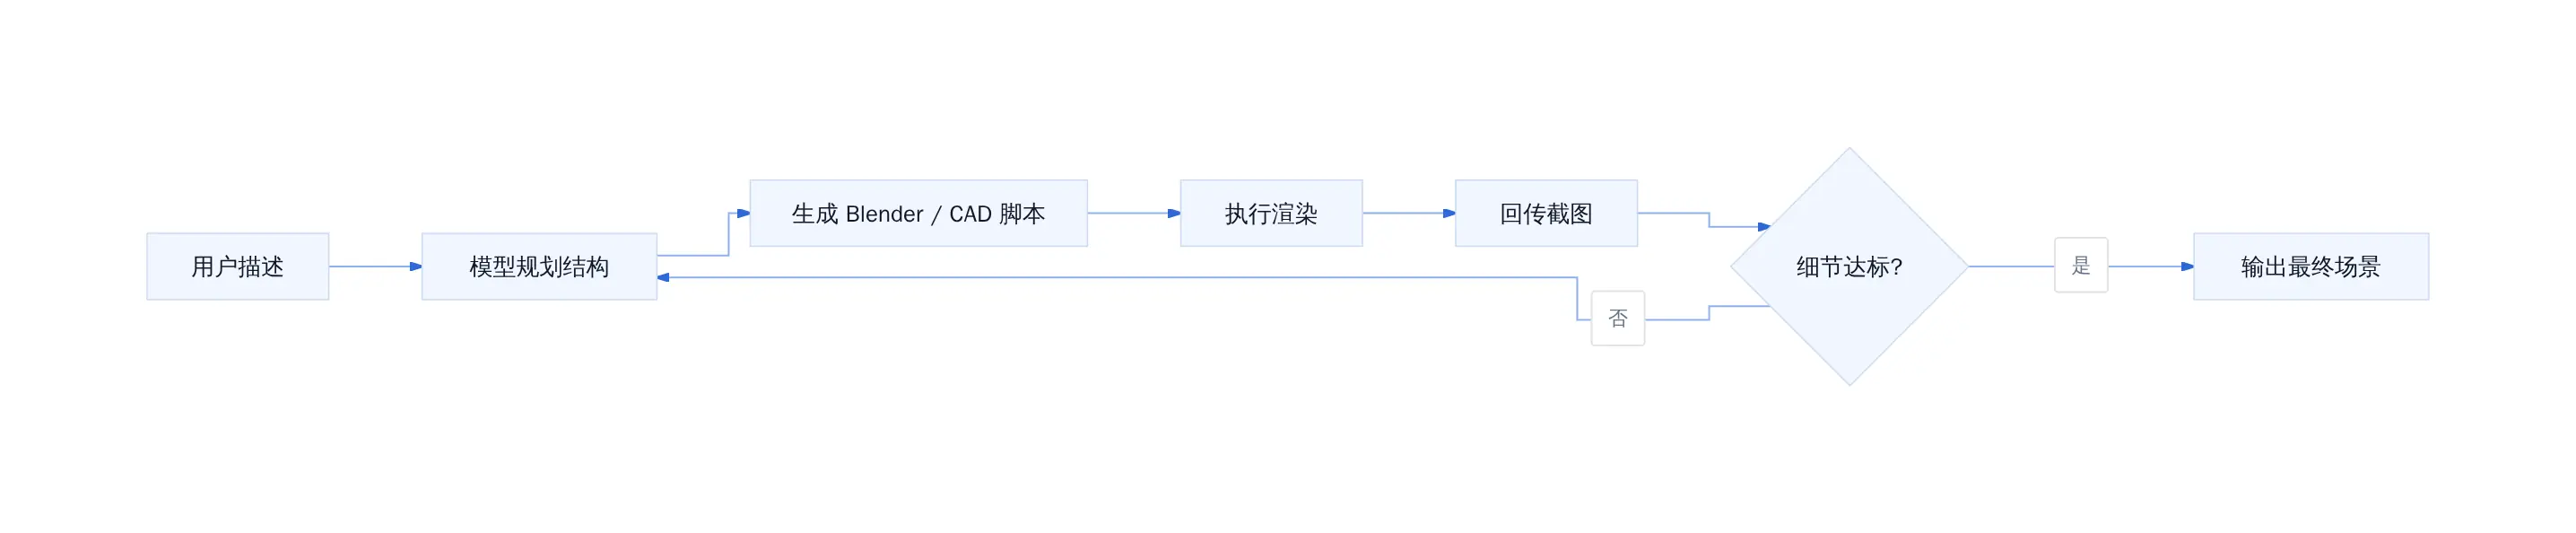
K3.1 Pro 3D 创作闭环
动画动效那轮,K3.1 Pro 的 3D 细节优于 DeepSeek 1017,但多分镜视频里 Opus 5.5 会主动调真实图片素材,观感最专业。K3.1 Pro 好于 DeepSeek,个别段落偏简单。能力够了,审美决策还差半拍。
OfficeQA Pro v2 拿「当前最优」,金融文档分析过线了
OfficeQA Pro v2 考的是真实金融文档的端到端分析:读研报、拆财务模型、跨表公式、诊断错误。K3.1 Pro 得 64.4 分,官方标注「当前最优」。同套外部基准 SpreadsheetBench 2 里,它操作电子表格建财务模型的成绩也越过了 GPT-6 Astra 和 Opus 5.5。
幻觉是另一个维度。Kimi Hallu Bench 内部压力测试中,K3 硬幻觉率 23.4%,K3.1 Pro 压到 8.3%,降幅 65%。金融场景里,23.4% 意味着每四次回答有一次是编的,8.3% 把风险压到了可审计区间。这是你敢不敢让模型自主出结论的分界线。更狠的是,做金融投研的团队一年在人工复核上烧掉的钱,可能比换模型的订阅费还多。
幻觉从 23% 压到 8%,研报终于敢交出去
四轮实测:游戏、动画、网页、3D 各卡在哪
测试设置很直接,同一组提示词,Opus 5.5 走 Claude 中档推理,DeepSeek 1017 和 Kimi K3.1 Pro 都拉满推理档位。四道题分别是 Godot 2.5D 三国肉鸽第一关、奔跑马匹动画加 2006---2026 中国经济变迁分镜、一个创意网页交互、一组 3D 场景生成。
Godot 三国肉鸽:完成度是 demo,缺音乐缺收尾
提示词只给了基本要求,让模型自己找开源美术资源。DeepSeek 和 Opus 5.5 都做出了接近可玩成品的效果,有背景音乐、能选人放技能、有结算画面。K3.1 Pro 的输出更像 demo,核心战斗逻辑跑通,但没有音乐,没有角色死亡后的重开流程,关卡结束只有黑屏。
差距不在单行代码,在把整条体验串起来的工程直觉上。拿到 K3.1 Pro 的产出,下一步大概率是手动补音效、补过场,而不是直接打包发布给玩家。
奔跑的马与 2006---2026 分镜:细节赢了,物理直觉没追上
细节赢了,物理直觉还没追上来。那条马跑得好看,但步态还是滑的。
K3.1 Pro 的马匹细节(鬃毛飘动、胸肌起伏)优于 DeepSeek,但四足交替节奏对不上真实步态,后脚着地时机偏早,整段看起来像快进。Opus 5.5 的运动曲线最接近参考视频,重心从后脚弹到前脚的弧线是真实的。多分镜视频里,Opus 5.5 会主动拉真实历史图片素材做背景,观感最专业;K3.1 Pro 好于 DeepSeek,但 2010 年前后那几段画面偏静态,缺少时间流动感,更像幻灯片而非视频。
创意网页交互:月相刻度加诗句 vs 鼠标光圈,审美分高下
同一题让三个模型做创意网页交互。DeepSeek 只给了鼠标跟随光圈效果,中规中矩。Opus 5.5 做了一组月相刻度交互,滚轮推动月球盈亏,旁边配一首短诗,视觉节奏最舒服。K3.1 Pro 交互复杂度接近 Opus,月相切换的动画帧数也够,但视觉气质偏功能完成而非设计完成,元素排布密而少留白,看着像后台仪表盘。
在让页面好看这件事上,Opus 5.5 的品味仍领先半拍。K3.1 Pro 的优势在交互结构和状态机设计,不在美术收尾。
3D 场景生成:构图排版进步,长程调试仍是短板
3D 是 K3.1 Pro 这一代提升最明显的方向。构图排版对比 K3 有肉眼可见改善,Blender 和 CAD 脚本能端到端出图,BenchCAD 92.7% 的分数也印证了这一点。问题出在长程调试:场景元素超过十几个、需要反复调光照角度和碰撞体积时,模型出现改了光源位置结果阴影全乱的循环,得人工介入打断重新指定约束。
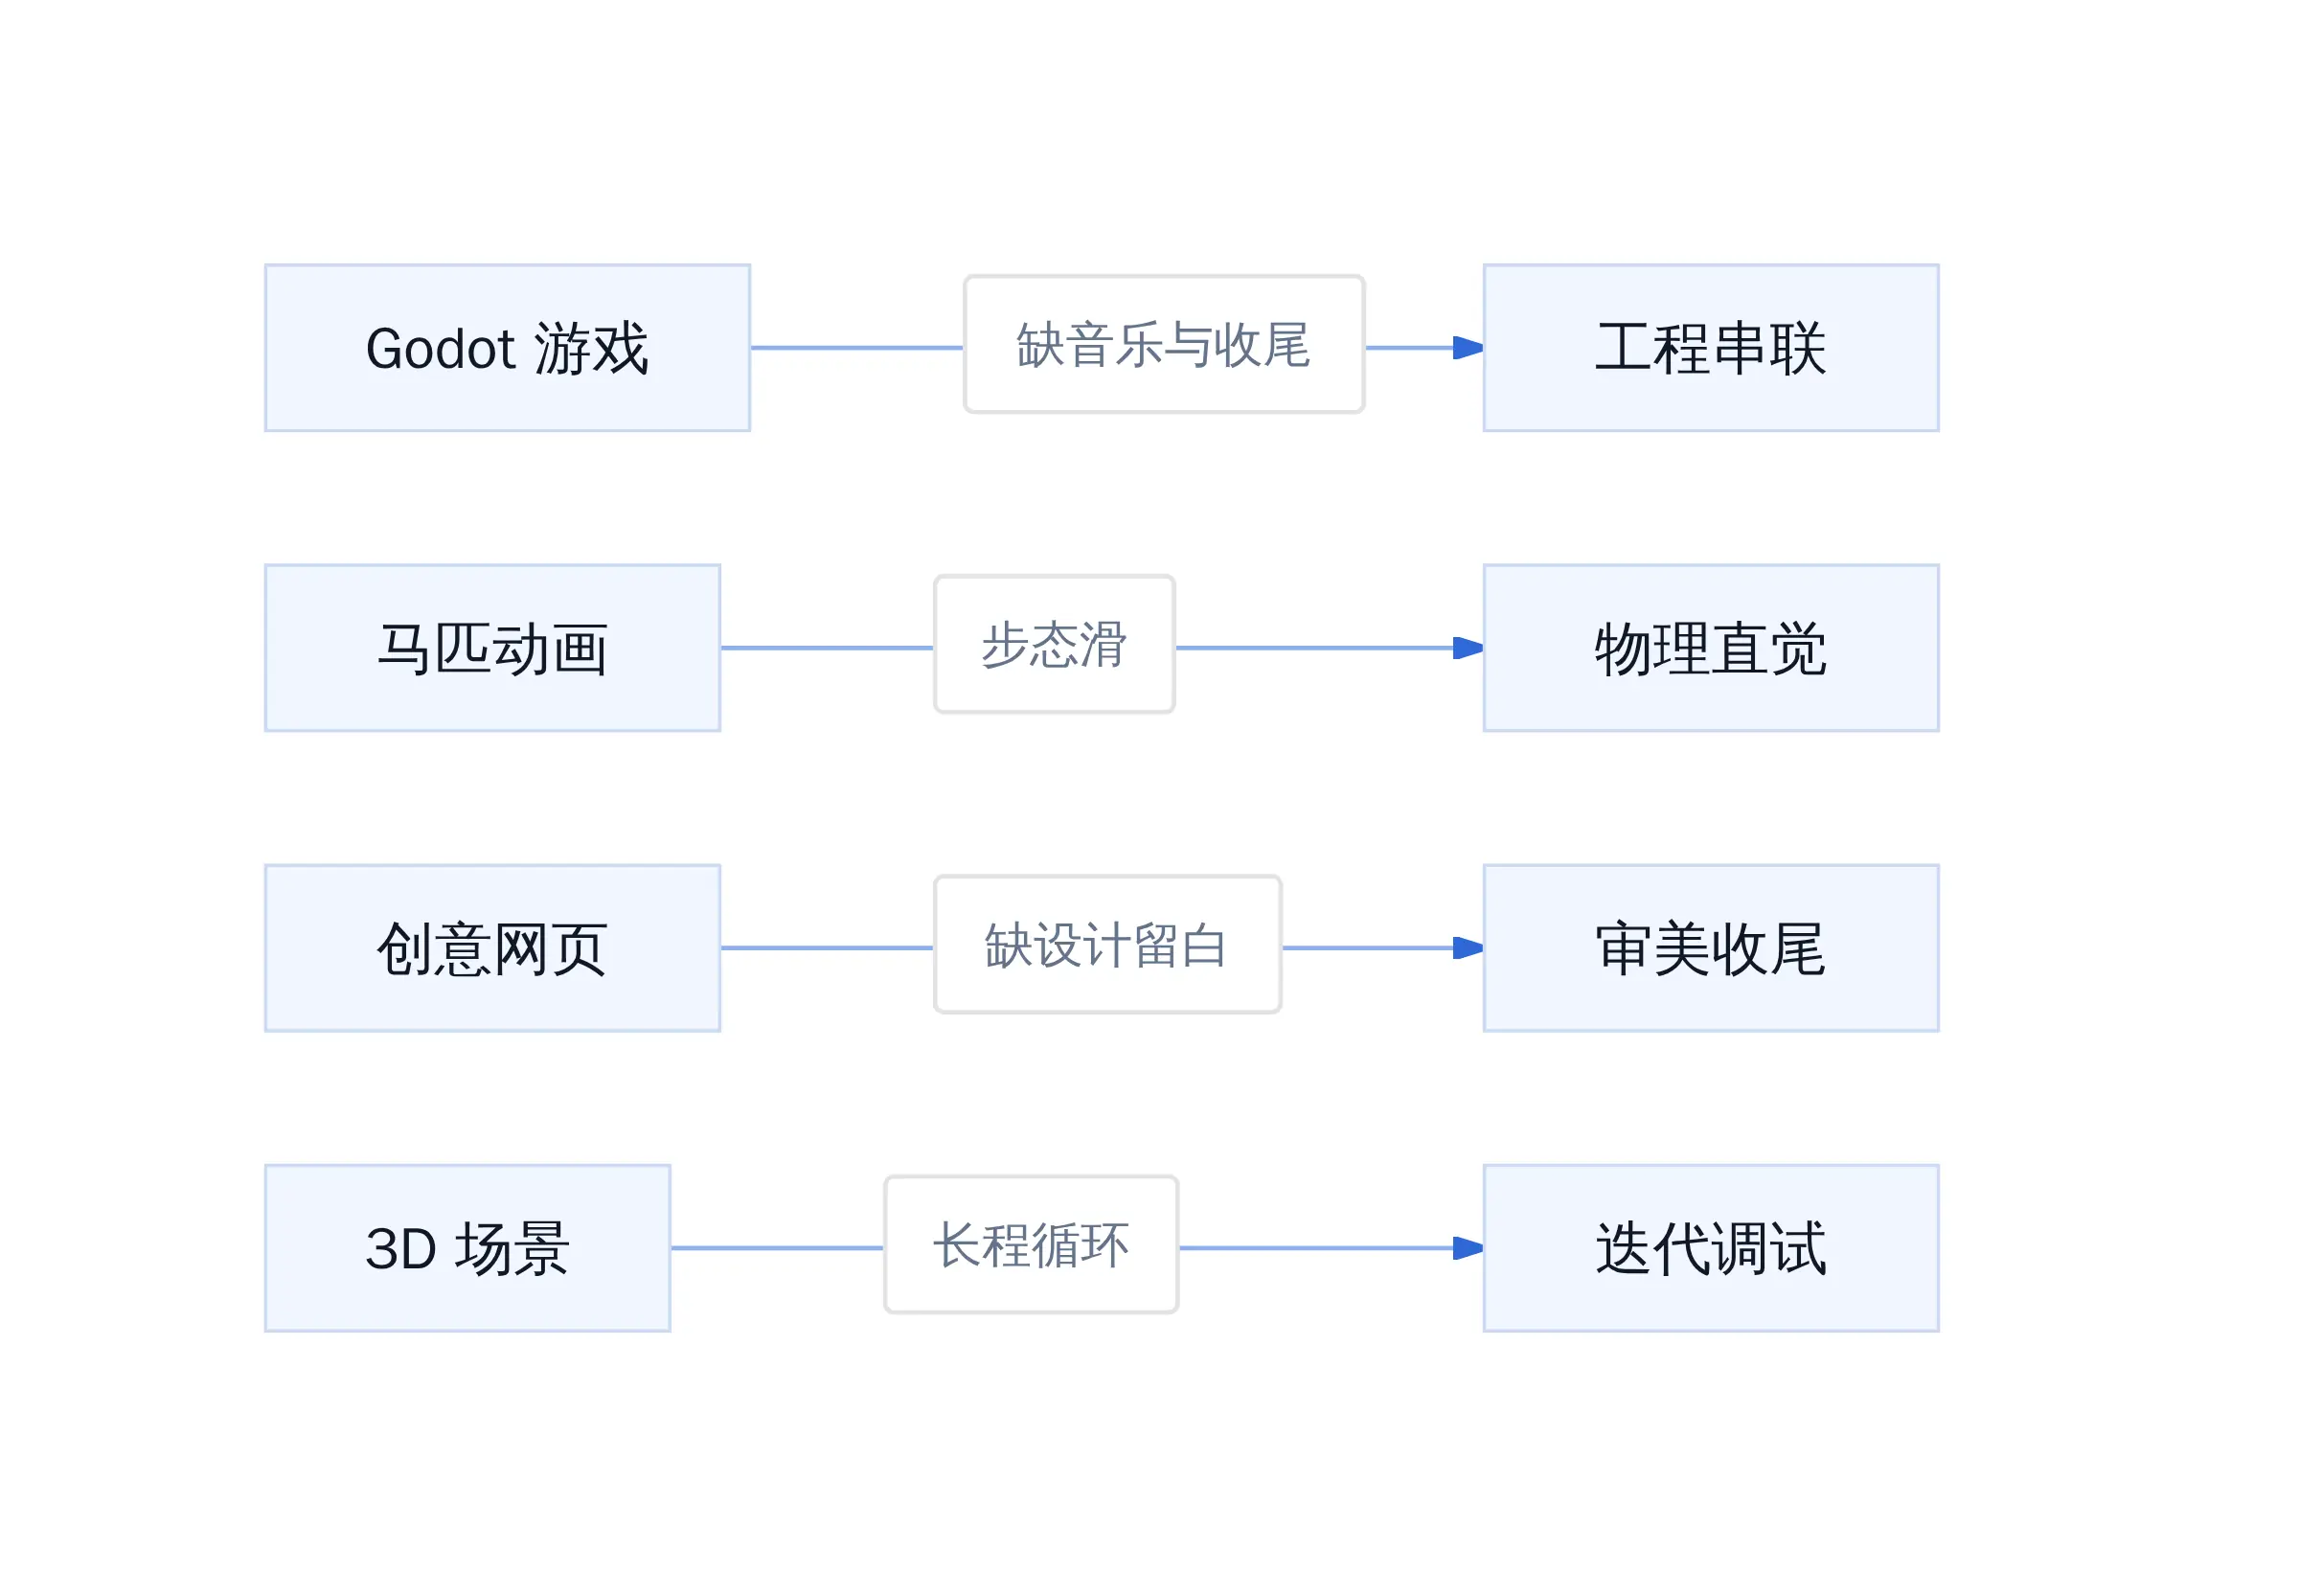
四轮实测短板分布
单步能力够了,多步纠错还在磨。这和前面 Terminal-Bench 那 0.7 个百分点的差距指向同一个瓶颈。
2.8 万亿 MoE 为什么敢卖这么便宜
每次推理只激活 1040 亿,实际算力成本远低于稠密模型
2.8 万亿这个数字容易让人下意识算一遍 GPU 集群电费,然后得出「不可能这么便宜」的结论。问题出在把总参数当成了每次推理的算力开销。K3.1 Pro 走的是 MoE 稀疏架构,每个 token 经过门控路由后只点亮约 1040 亿参数做前向计算,剩下 2.7 万亿权重躺在显存里待命。实际推理 FLOPs 接近一个 100B 稠密模型,而不是 2.8T。月之暗面敢把 API 输入压到 13 元、输出 68 元,核心原因就是这张表上的分子没变、分母却从稠密全量换成了稀疏激活。
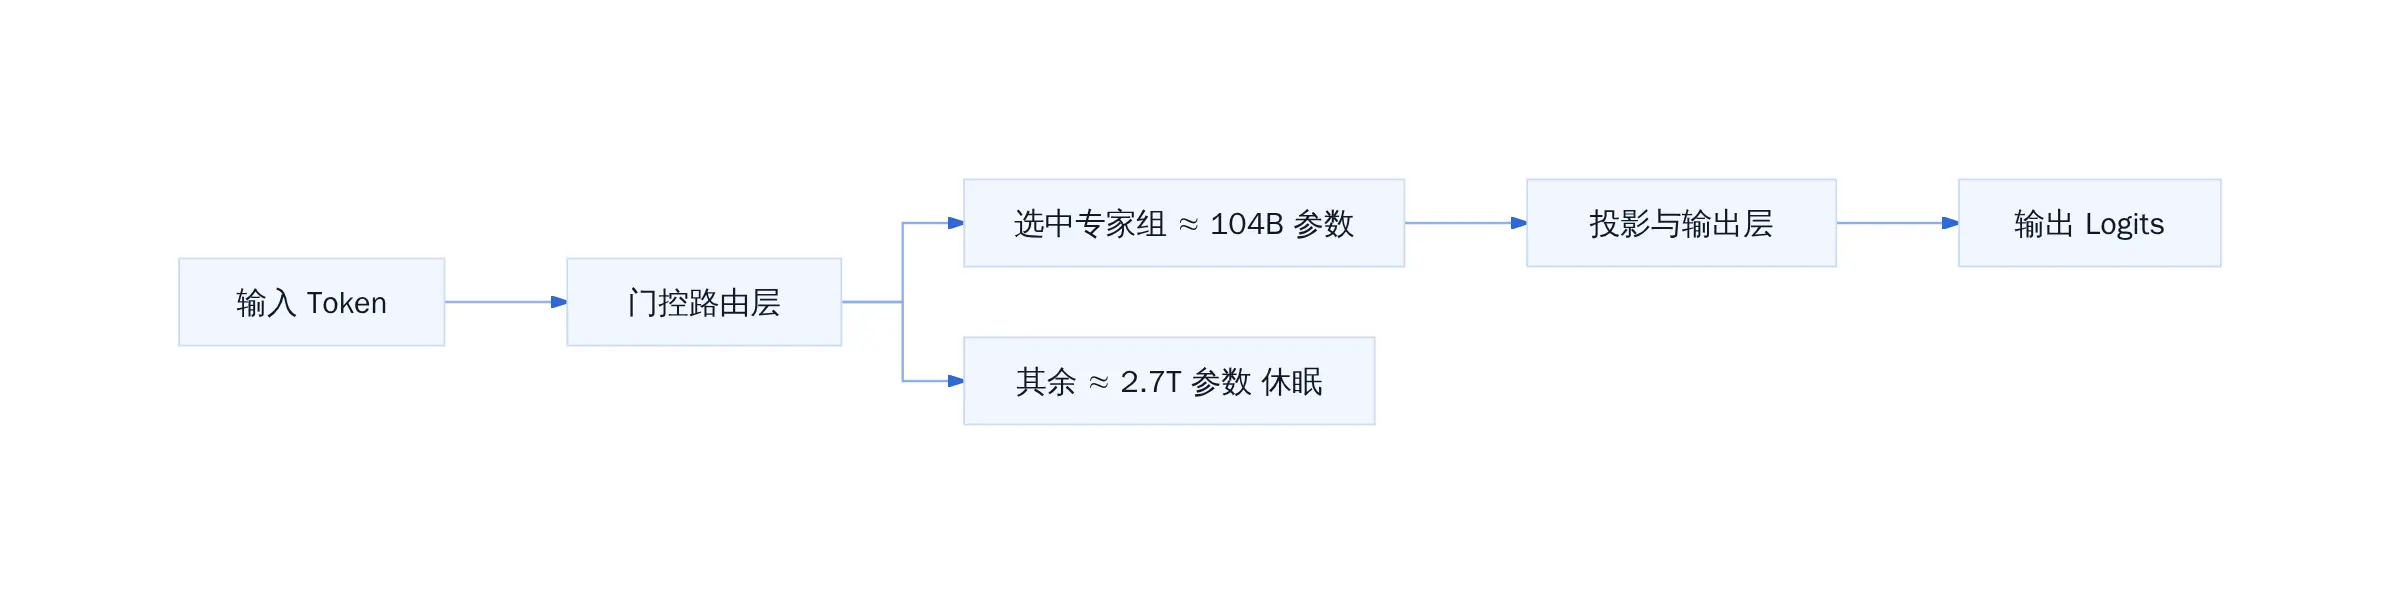
K3.1 Pro 单次 Token 推理路径
对比一下就能感受差距:同规模稠密模型跑一次 100 万 Token 上下文,每步都要搬运 2.8T 权重做矩阵乘;K3.1 Pro 每步只搬 104B,内存带宽压力直接砍到三十七分之一。这就是「仓库很大、每次只取一小箱」的成本结构。
K3 到 K3.1 Pro 只动了后训练,预训练没重新跑
月之暗面在技术报告里写得很直白:K3.1 Pro 是 K3 的后训练版本,基座权重没动,增量算力全部砸在后训练阶段。具体做法是大规模联合强化学习,覆盖几百个下游领域,同时优化了 RL 框架、长上下文推理、沙箱基础设施和 rollout 调度。Artificial Analysis 的 Intelligence Index 上,K3 得 44 分,K3.1 Pro 拉到 55 分,涨了 11 点。内部幻觉压力测试 Kimi Hallu Bench 的硬幻觉率从 23.4% 压到 8.3%,降幅 65%。
这条路线的取舍很清楚:不重跑预训练意味着省掉数万美元级 GPU 时长的冷启动,代价是能力上限被 7 月那版 2.8T 基座锁死。只要基座知识覆盖足够,后训练 RL 能把推理链、工具调用、长程规划这些「软能力」再挤出一截。目前看,Terminal-Bench 4.0 从 55.95% 跳到 65.7%,金融 OfficeQA Pro v2 拿到 64.4 的「当前最优」,说明后训练收益还没有到天花板,但下一次再想涨 10 个点,大概率得动预训练或架构了。
自部署门槛与适用边界
完整权重承诺 11 月 4 日前放出。有卡的话,104B 激活参数意味着一张 80GB 的 H100 装不下全部 2.8T 权重,但推理时只需把选中的专家组热加载进显存,实际并发部署对单卡显存的压力和跑 100B 稠密模型差不多。真正卡人的是存储:完整权重落盘需要至少 5.6 TB 显存或磁盘空间(FP16 口径)。没有这块资源的团队,走 API 是更现实的路径。
选型的判断条件可以压缩成一句:如果你的工作负载以长上下文编程、3D 脚本生成、金融文档分析为主,且月调用量在 50 万百万 Token 以上,K3.1 Pro 标准版比 Opus 5.5 省下的差价够再养一个标注团队;如果追求极低延迟的高并发 Agent 编排,Highspeed 版两倍价换来的 2--3 倍出字速度在 SLA 敏感场景里回本更快。超出这两个条件,比如纯短文本分类或轻量问答,用 K3.1 Pro 就是拿旗舰刀切葱。
参考文献
- 月之暗面官方技术博客(K3.1 Pro 发布):platform.kimi.com/docs/guide/...
- 数字生命卡兹克实测长文:upgrade.xiaoheiwan.com/aihot/gwhdq...
- 新浪财经报道:m.sohu.com/a/109203341...
- 腾讯新闻·晓静技术分析:news.qq.com/rain/a/2026...
- 东方财富/中新社报道:wap.eastmoney.com/a/202610243...
- Artificial Analysis 发布推文:x.com/ArtificialA...
- Local AI Zone 架构深度解析:local-ai-zone.github.io/blog/kimi-k...
- Eigent.ai 基准对比:www.eigent.ai/blog/kimi-k...
延伸入口
- 原文归档:tobemagic.github.io/ai-magician...
- 公众号:计算机魔术师