数据集成产品这个东西,从外面看都长得差不多:数据从 A 库进,从 B 库出,中间画个箭头,完事。选型的时候各家 PPT 也都差不多,低侵入、高可用、秒级延迟,词儿都一样。
但真把它拆开看,零件和零件之间的差别大得很。这几天我把 KFS(Kingbase FlySync,金仓做的异构数据同步软件)的官方资料按技术链路捋了一遍,从它怎么抓日志,到中间怎么搬,到两边数据怎么对账。值得记的不少,写下来。
一、骨架:三段式,老老实实分三截
KFS 的结构图我在官网看过一版总览:左边一列源端------交易型数据库、分布式数仓、消息队列、NoSQL,右边一列目标端------同样一堆,中间是日志解析、过滤、转换,底下标着支持的的各种网络环境,防火墙、正反向隔离设备、单向光闸都算在内。
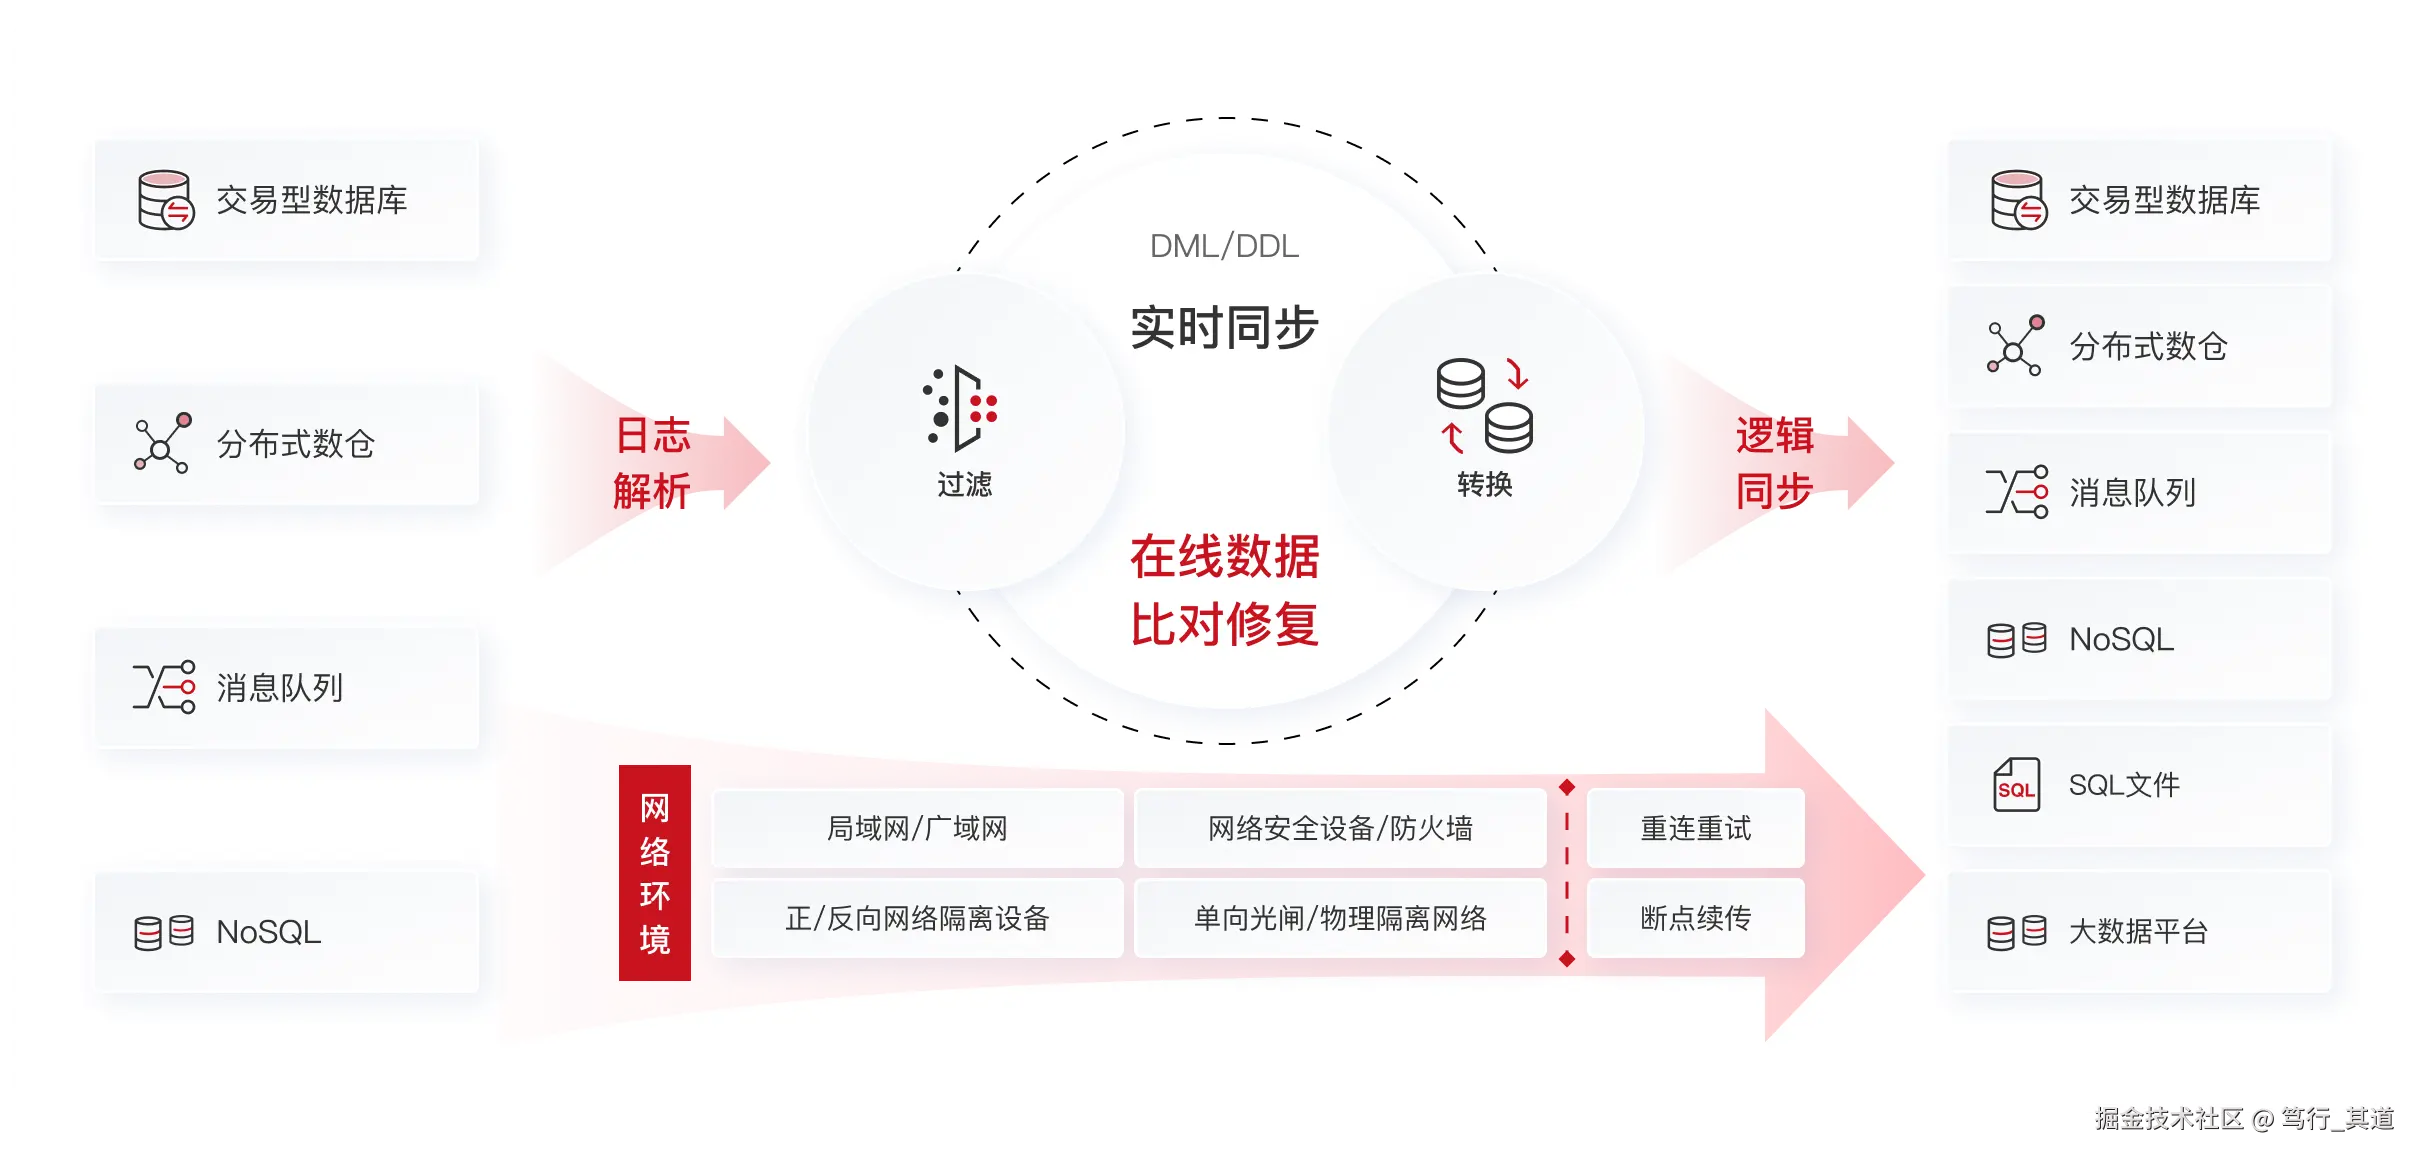
图 1:KFS 官网产品原理图(来源:kingbase.com.cn),左侧各类数据源经日志解析、过滤、实时同步与转换,逻辑同步到右侧目标端;下方列出支持的隔离网络环境与断点续传能力
拆到组件层,整条链路是标准的三段式:采集模块守在源端读日志,中间一个统一格式文件做接力,加载模块在目标端把变更落库。三段各自独立,各自记进度,互相不绑死。
这个分法不新鲜,但分得干净。后面能看到,它的几个关键能力------断点续传、低侵入、多拓扑------全是从这个分段里长出来的。
二、神经:KUFL 文件,全链路最值得看的设计
三段式里最有意思的是中间那段。KFS 发明了个格式叫 KUFL(Kingbase Unified Format Log),把从不同数据库里抽出来的操作信息,统一成一种格式存进去。
它的用法有点反直觉:采集模块读到数据后,读一次就把它挪到外部的 KUFL 文件里,之后一路到目标端加载完成为止,中间不再回源端碰第二次。
为什么这么设计?答案在故障场景里。源系统或者目标系统断掉的时候,KUFL 文件里躺着截至中断那一刻的最新数据。恢复之后,加载模块从最新的 KUFL 文件接着读,断在哪儿续哪儿,不用重头再来。
我第一次看到这段的时候想,这不就是个消息队列吗?细想又不太一样。消息队列管的是"不丢",KUFL 多管了一层"格式"------Oracle 的日志、MySQL 的 binlog、各种 NoSQL 的操作流,进来全部摊平成同一种统一表示,加载端拿到的东西是归一过的。异构同步的复杂度有一大半在格式差异上,KFS 把这个复杂度摁在中间层消化掉了。
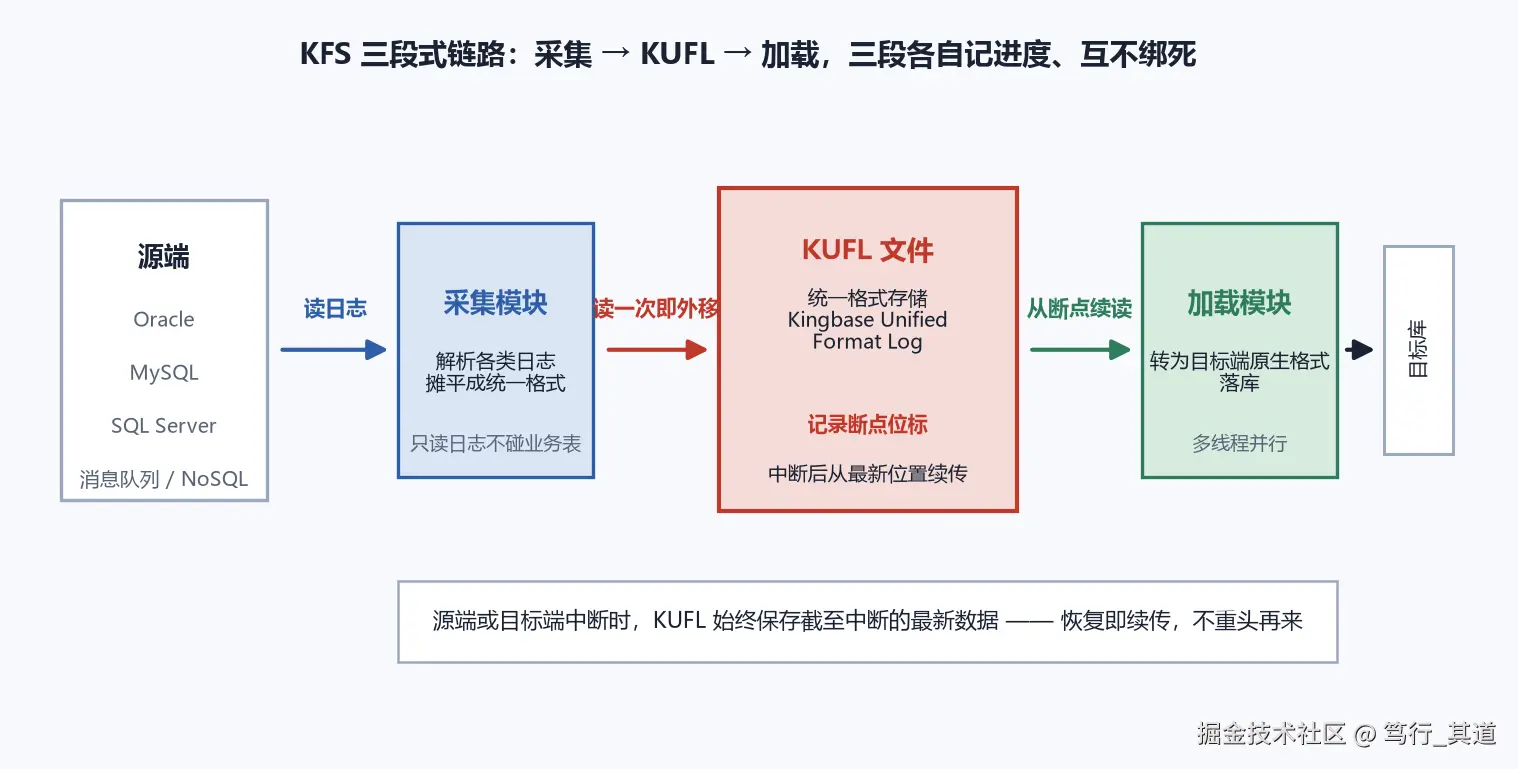
图 2:KFS 三段式链路与 KUFL 文件:读一次即外移,中断后从断点位标续传
三、肌肉:不碰业务库,性能从哪来
做数据同步有两条路。老派做法在业务库装触发器、建中间表,业务每写一笔就多一笔额外开销------侵入性大,业务方见一次烦一次。另一条路是解析数据库自己的日志,业务库只多了一个读日志的进程。
KFS 走的是后一条,官方管这叫低侵入。落到数字上,FAQ 里给过一个参考:每天 50GB 的同步量级,对生产库的资源侵入极小。无主键表能同步,DDL、DCL 能复制,大对象(BLOB、CLOB 这些)也在支持列表里,多线程并行加载。这几条对老系统很关键------恰恰是那种十几年前建的系统,最容易有一堆没主键的老表。
性能这块,胶片里有组实测数据我一直记着。标准 TPCC 场景、基础 100 仓:
- KFS 每天 600GB 出头
- OGG(Oracle 家的 GoldenGate)每天 460GB 出头
600 仓的场景是 570 对 450。彩页里概括成一句话:局域网 TPCC 模型数据同步性能高于业界同类产品 30%。
拆开看环节:Oracle 源端日志解析速率 118MB/s,KES 源端解析 101MB/s,目标端加载 240MB/s 以上,数据同步延时 40 毫秒。解析和加载的速度差是刻意留的余量------加载永远快于解析,管道里不会积水。
广域网是另一套打法。传输层做了压缩,压缩比 4 倍,官方的直接结论是:2M 带宽就能做实时容灾。这个数字对跨地域的场景很实用------省下的专线钱比软件钱多得多。
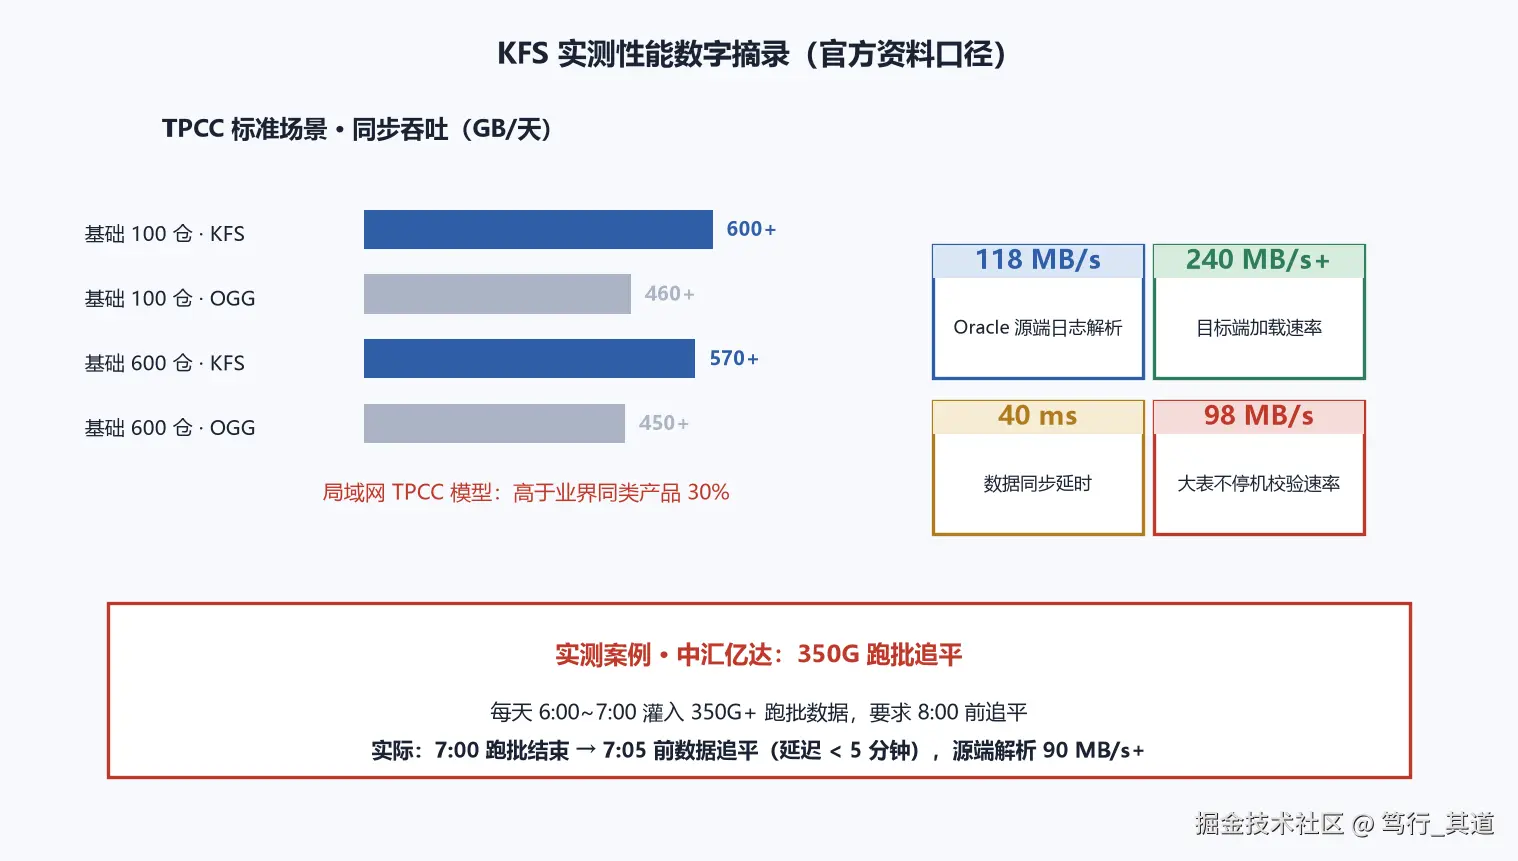
图 3:KFS 实测性能数字摘录(TPCC 对比、解析/加载速率、同步延时)
四、对账:同步过去的数据,凭什么信
数据同步产品最怕的不是慢,是错------两边看着都成功了,一比账对不上。KFS 在这条上花的心思不比同步本身少。
它的一致性校验是全周期的:全量校验对存量,增量校验对新增,两边可以并行跑。关键卖点是不停机------校验的时候业务照常跑,大表连着大对象一起校,速率能到 98MB/s,100GB 的数据量平均校验时间在分钟级。发现差异还能自动修复,不用人工捞数据。
校验走的数据通道就是 KUFL 本身(校验程序从 KUFL 拿指定数据),所以增量校验的开销不会额外压到业务库上。这个复用设计我觉得挺聪明。
有个真实案例把校验的价值讲得很透。中汇亿达的项目,每天早上 6 点到 7 点有一小时跑批,要灌进去超过 350G 的数据,业务要求 7 点跑批结束、8 点之前数据必须追平。实际结果是 7 点跑批完成,7 点 05 分之前数据追平,同步延迟压在 5 分钟内,源端解析速率 90MB/s 以上。350G 的改动量,五分钟对平,这活儿靠人工是别想了。
五、长法:一台产品怎么长成一堆部署形态
同步需求千奇百怪,KFS 靠同一套三段式拼出好几种拓扑。
一对一,最基础的数据搬迁和容灾。级联同步,A 到 B、B 再到 C,适合总部分发到省、省再发到市的层级结构。数据汇聚,多个源端往一个目标端灌,做汇总库或者数仓前置。双向同步,两端各搭一套 KFS、互为目标,这是最难的一种------两个库同时改同一条数据怎么办?
KFS 的答案是自动冲突处理:对双向同步、数据汇聚场景里的冲突数据做无人工介入的自动处置。多源异构环境里所有数据源都支持 DML 加 DDL 同步,DDL 变更过来的时候同步程序不用停,连续作业。
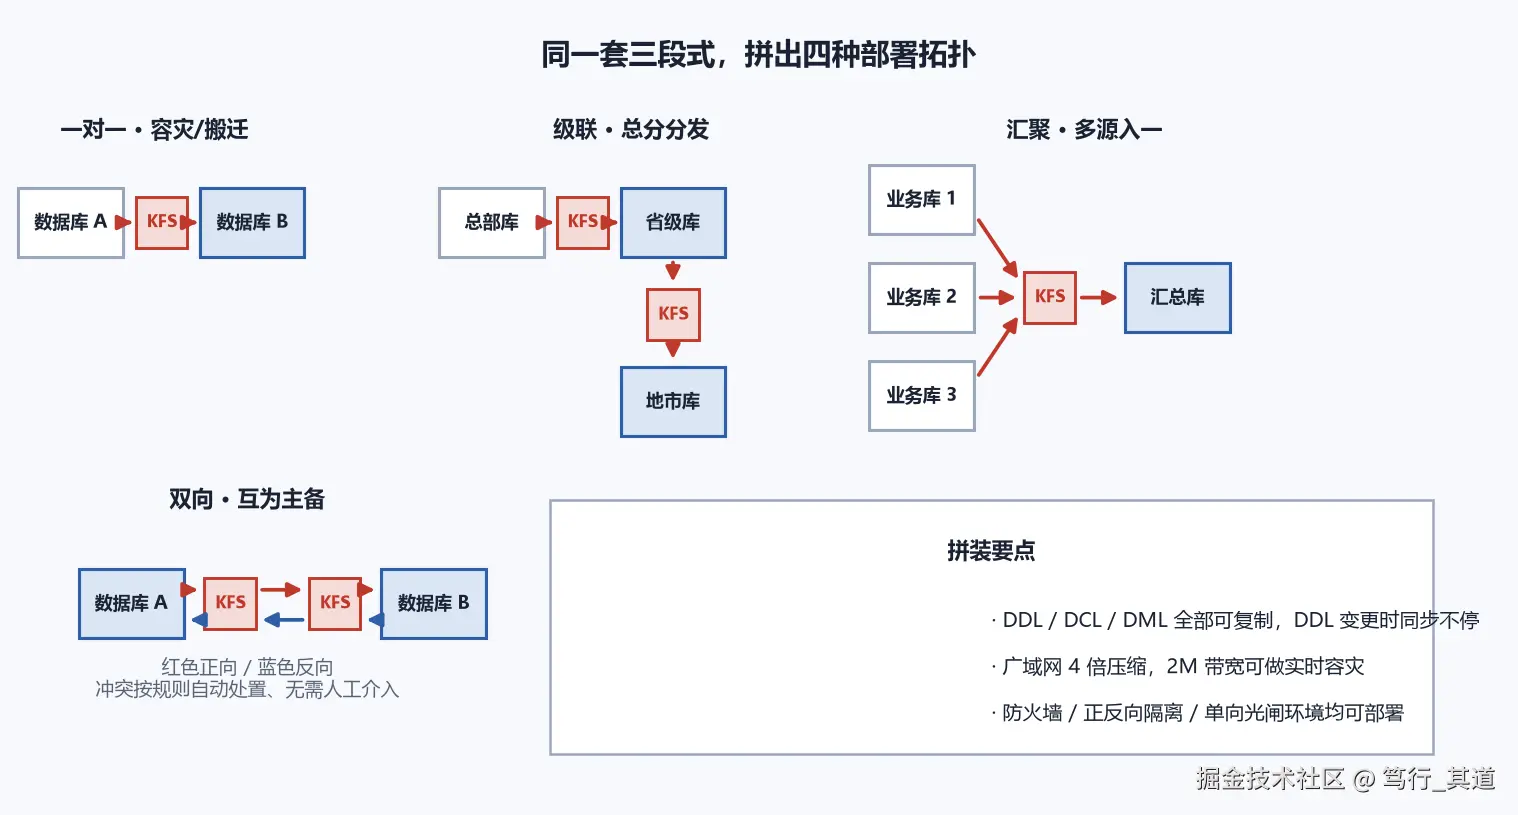
图 4:KFS 四种典型部署拓扑:一对一、级联、汇聚、双向
六、也别光听好的
几个值得写在采购风险栏里的点。
双向同步的自动冲突处理听着省心,但冲突策略是产品按规则定的,什么算"对"最终是业务说了算,上线前得把自己的业务规则想清楚,别指望产品替你做业务决定。复杂的数据清洗、多表关联加工这类活,KFS 的定位是搬运用,重转换的场景官方另有 KFS Ultra,选型时得把边界问清楚。
无主键表虽然能同步,但这类表天生难定位单行,同步和校验的效率天然不如有主键的表,老系统迁移前能补主键还是先补。另外广域网 2M 带宽容灾的前提是开了压缩、链路质量达标,网络丢包严重的环境得先测,别直接拿彩页数字当承诺。
还有一条经验之谈:校验再快也只是兜底。同步链路的告警、延迟监控得配好,等校验发现不对,问题已经发生一会儿了。