一、问题、结论与阅读地图
让 Agent 修一个失败的测试,几乎每个框架都能跑通:读文件、定位报错、改代码、再跑测试。功能清单也很快趋同------工具、权限、记忆、上下文压缩,名字都差不多。
差别藏在边界上。Claude Code 发布到 npm 的包没有删除 source map,完整 TypeScript 源码被还原,包含约 1,900 个源文件、51 万行代码^1^;整理这份源码的 claude-code-analysis 仓库记录的口径是 1,902 个源文件、513,237 行^2^,对 src/ 下 .ts 与 .tsx 重新统计得到 1,884 个文件、512,664 行,量级一致。这个体量远超「把上面那条链路串起来」所需,多出来的部分不在功能,而在边界上的取舍:什么时候算一轮结束,工具失败怎么表达,并发凭什么放行,上下文满了先牺牲什么。
这些取舍没有标准答案,Claude Code 的选择可以压成一句:
模型负责提议,运行时负责裁决。
模型提出工具调用、计划、总结;harness------包在模型外面的运行时------决定这次调用能不能执行、以什么并发度执行、结果怎么裁剪、失败怎么归因、何时该停。本文的七个判断,是这条主线在源码里的七种落法。
阅读地图按一次运行的生命周期排列,对应第二至第八节,每节回答一个运行期问题:
- 循环何时停。 退出条件是流里出现过的事实,不是模型的自我报告。
- 一次调用怎么被约束。 契约分三层:模型可读、运行时能验、失败能解释。
- 多个调用能不能并行。 安全性由工具自己声明,调度器不推断。
- 凭什么允许执行。 默认拒绝的管线,外加一层限制进程能碰到什么的沙箱。
- 上下文满了先删什么。 按代价分层压缩,先做便宜的。
- 跨会话记住什么。 记忆是文件,召回交给模型判断。
- 这些机制怎么不拖慢彼此。 缓存与事件流是硬约束。
第九节把七节里的能力汇总成索引,第十节给出对自建 harness 的启示,第十一节交代这份分析的证据边界。
证据口径:全文结论来自对泄露源码的静态阅读,没有运行 Claude Code 做行为实测。文中出现的数字是源码里的常量或阈值,不等于线上实际行为------它们会被环境变量、GrowthBook 开关和模型能力覆盖。这个区别在第十一节还会再交代一次。
二、判断一:循环的退出条件必须是观测到的事实
一次 Agent 运行最先要回答的问题是「什么时候算完」。模型说「已经修好了」,这一轮到底结束没有?Claude Code 的主循环写成一个 while (true),但它的续轮条件不是模型返回的 stop_reason。
源码在这里留了一条很直白的注释:
ts
// Note: stop_reason === 'tool_use' is unreliable -- it's not always set correctly.
// Set during streaming whenever a tool_use block arrives --- the sole
// loop-exit signal. If false after streaming, we're done (modulo stop-hook retry).
const toolUseBlocks: ToolUseBlock[] = []
let needsFollowUp = false
主循环把「流里是否真的出现过 tool_use block」作为唯一的续轮信号;收到就置 needsFollowUp = true,流结束仍为 false 才进入收尾。模型说自己要调用工具不算数,得看消息里有没有可执行块。
退出路径也不是一句「完成」,而是一组有名字的原因:
| 退出原因 | 触发条件 |
|---|---|
completed |
没有待执行的工具调用,收尾流程走完 |
max_turns |
下一轮序号超过 maxTurns |
blocking_limit |
上下文到达硬阻塞线且未压缩成功 |
aborted_streaming / aborted_tools |
用户在流式阶段或工具阶段中断 |
stop_hook_prevented / hook_stopped |
Stop hook 或工具 Hook 阻止继续 |
model_error / prompt_too_long |
模型错误或提示词超长 |
这套命名的价值在于:调用方拿到的不只是一段文本,而是「为什么停」。完成、被预算掐断、被用户中断、被 Hook 拦下、模型出错,是几种不同的运行结果,后续的恢复、计费、重试策略都依赖这个区分。
围绕退出,还有三处设计要配套:
-
工具可以在模型出完之前开始跑。 流式模式下,每收到一个含
tool_use的 assistant 消息就交给StreamingToolExecutor.addTool,已完成的结果非阻塞地取回。这层优化受isConcurrencySafe约束,细节留到第四节。它把工具 IO 藏进模型生成时间里,代价是中断、顺序和错误处理都变复杂。 -
Stop hook 只在真正准备结束时执行,而且跳过 API 错误。 源码注释解释了原因:模型根本没产生有效回复时若还让 hook 评估,会形成
error → hook blocking → retry → error的死循环。这个分支防的是一条能自我放大的失败链。 -
错误恢复有明确上限。
max_output_tokens先尝试把上限从 8k 提到 64k,再最多注入 3 次续写提示;连续 3 次 529 则切换 fallback 模型,并清空已经产出的 assistant 与 tool 块重试。
所有恢复路径都以「多跑一轮」的形式回到同一个循环,而不是在调用栈里层层嵌套重试;从续轮信号到恢复路径,循环的每次继续或停止都落在可观测的消息与计数上,而不是模型的自述。
三、判断二:工具是一份三段式契约
循环决定「继续还是停」,接下来决定「这一动能不能做」。以 Edit 改一个文件为例:模型得知道参数怎么填,harness 得在写入前拦住明显错误的编辑,写入失败后还得让模型看懂错在哪。Claude Code 的工具因此不是「一个函数加一段描述」,而是一份分三层兑现的契约:
-
模型可读。
Tool类型里,inputSchema是 Zod schema,inputJSONSchema给 MCP 工具直接传 JSON Schema;description()可以按输入动态生成;prompt()决定工具在系统提示里的呈现。模型看到的是 schema 和描述,不是实现。 -
运行时能验。 执行前有两道校验:先
inputSchema.safeParse,再调工具自己的validateInput。源码对第一道有一句不太客气的注释:「surprisingly, the model is not great at generating valid input」。第二道处理语义约束,例如 Bash 拦截会卡住的sleep,FileEdit 拒绝新旧字符串相同、目标目录被拒或文件过大的编辑。MCP 工具例外,客户端只做passthrough,真实 schema 原样交给 API。 -
失败能解释。 工具失败不靠抛一个裸异常给上层,而是统一变成带
is_error: true的tool_result,内容包在<tool_use_error>标签里。未知工具是Error: No such tool available,schema 失败是InputValidationError,权限拒绝、validateInput失败、运行时异常走同一形状。异常文本超过 10,000 字符时保留头尾各 5,000 字符,中间标注截断量。
这套分层直接决定了模型能不能自我修复。错误信息里有工具名、失败阶段和具体原因,模型下一轮才有东西可改;如果只回一句「工具执行失败」,它只能盲猜。契约主干之外,还有三组细节,先看它们对应的字段:
| 字段 | 作用 |
|---|---|
isConcurrencySafe / isReadOnly |
声明这次调用能否并发、是否只读;默认都是 false |
interruptBehavior |
用户中途发消息时,工具该取消还是继续跑 |
maxResultSizeChars |
单个结果超过多少字符转存到磁盘 |
mapToolResultToToolResultBlockParam |
模型侧结果序列化,与 UI 渲染分开 |
buildTool 给未声明的工具填默认值时,isConcurrencySafe 和 isReadOnly 都取 false,注释写明「fail-closed where it matters」。但 checkPermissions 的默认值是 allow,因为它把判断交给中央权限管线,而不是在工具内部重复实现。默认值不是一律保守,而是把保守放在「猜错会出事」的字段上。
结果容量也按工具区分:默认单个结果 50,000 字符,Bash 自己限 30,000,Read 设为 Infinity,因为把 Read 的结果转存成文件会形成「Read → 文件 → 再 Read」的循环。超限内容不是直接丢弃,而是写到会话目录的 tool-results/ 下,模型收到一个带 <persisted-output> 标签的预览和文件路径。单条用户消息内还有 200,000 字符的总预算,超出时按大小依次转存,且决定会被冻结以保持 prompt cache 稳定。
UI 和模型走两条渲染路径:模型拿到 mapToolResultToToolResultBlockParam 的输出,UI 直接读原始 tool.data。Bash 的注释写得很清楚:「The UI never sees this --- it uses data.stdout」。同一次结果,给人看和给模型看是两种表达,混在一起通常两头都不讨好。
工具之外还有三种扩展口,各自面向不同作者。Skill 是目录下的 SKILL.md,frontmatter 带 name、description、when_to_use、allowed-tools、model 等字段,列表只注入约 1% 上下文,调用时才加载全文;Plugin 按目录约定打包 commands、agents、hooks,并通过清单声明 skills 与 MCP server;MCP 把远端 tools/list 的结果 1:1 转成内部 Tool,默认命名为 mcp__<server>__<tool>,JSON Schema 原样透传。加上工具本身,四个入口各有作者:Tool 给模型用,Skill 复用提示词,Plugin 负责分发,MCP 接生态------它们不是互相替代,而是四种不同的生命周期。
四、判断三:并发与隔离写在声明里,不靠调度器猜
工具能跑了,下一个问题是能不能一起跑。模型在一轮里同时发出 Read、Grep 和一条 Bash 命令,harness 要不要让它们一起跑?Claude Code 没有让调度器去推断副作用,而是要求每个工具自己声明 isConcurrencySafe,默认 false。
声明之后,并发控制在四个地方落地:
- 非流式按批次跑。 连续的安全调用切成一批并发执行,上限默认 10(可用
CLAUDE_CODE_MAX_TOOL_USE_CONCURRENCY覆盖);不安全调用严格串行。声明函数抛异常时按不安全处理------解析 shell 命令失败并不等于命令安全。 - 并发副作用排队重放。 并发工具的
contextModifier不会立刻生效,而是排队到整批结束后按序重放。否则两个并发工具同时改上下文,结果取决于完成顺序,无法复现。 - 流式按安全边界放行。 只有当「当前没有工具在跑」或「自己和所有在跑的工具都安全」时才启动;遇到不安全的排队工具就停住队列,保证输出顺序与模型给出顺序一致。
- 中断按层级冒泡。 每个工具拿一个子 AbortController,
sibling_error只杀兄弟工具,用户中断则向上冒泡到 query 控制器。中止原因区分user_interrupted、sibling_error、streaming_fallback,工具可以按自己的interruptBehavior决定取消还是跑完。
四处合起来,并发的批次、副作用和中断都有确定规则,不依赖完成顺序,也不靠调度器猜测。
隔离不只发生在并发层,也发生在执行环境层:
- 子 Agent。 有独立的上下文与 AbortController,
createSubagentContext复制读文件状态、换掉控制器,非交互 Agent 还会关掉权限弹窗。 - 任务类型。 定义里列了 7 种:
local_bash、local_agent、remote_agent、in_process_teammate、local_workflow、monitor_mcp、dream。它们共享同一套状态机与终止状态,但执行位置和生命周期不同。 - 队友通信。 用文件邮箱,消息作为
<task-notification>回到主会话,而不是共享上下文。同进程队友通过leaderPermissionBridge把权限弹窗交给 leader 渲染,且队友统一以default模式运行,不能继承 leader 的 bypass 权限。 - 队友生成。 队友不能再生成队友,避免协作图无限展开。
- Worktree。 把「隔离分支」变成工具动作:进入时创建独立副本,退出时让用户选择保留或删除。
这里的设计判断是:并发安全是工具作者的责任,不是调度器的推理结果;隔离要同时覆盖上下文、文件系统、权限和生命周期,少一层都可能让「并行」变成「互相污染」。
五、判断四:安全是一条默认拒绝的管线
工具能并发执行之后,最难的问题变成「凭什么允许它执行」。模型要删掉构建目录、要往项目外写文件,harness 是每次都问用户,还是自己判断?Claude Code 的权限不是布尔开关,而是一条从规则到分类器再到沙箱的管线。
先看权限模式。对外暴露的是 5 档,auto 在 feature gate 后追加:
| 模式 | 行为 |
|---|---|
default |
规则能定的按规则走,定不了的问用户 |
acceptEdits |
工作目录内的文件编辑放行,Bash 的常见写命令也放行 |
plan |
进入规划态,记录进入前的模式;退出时恢复并请求批准 |
dontAsk |
把管线末尾的 ask 一律改写成 deny |
bypassPermissions |
跳过大部分检查,但 deny 规则、内容级 ask 规则和安全检查仍然生效 |
auto |
用 LLM 分类器替代人工确认(feature gate 后) |
管线的顺序大致是:deny 规则 → 工具自己的 checkPermissions → 安全检查 → 当前模式 → allow 规则 → 询问用户。几个细节体现了「默认拒绝」:
- 安全检查(
.git/、.claude/、.vscode/、shell 配置等)是 bypass 免疫的,即使用户开了bypassPermissions也要弹窗。 auto模式的分类器不可用时,默认 fail-closed 直接拒绝(tengu_iron_gate_closed默认 true);会话记录过大时退回人工确认,无界面运行直接中止。- 拒绝会被计数:连续 3 次或累计 20 次后,系统退回人工确认,而不是继续让分类器硬扛。一个容易误解的点是:连续拒绝不会升级权限模式,它只会把自动判定降级为人工判定;模式切换仍由用户或远端开关决定。
三处细节说明,默认拒绝不是一句口号,而是分别在检查、故障和计数上兑现。
危险命令识别也不是单一黑名单。Bash 侧同时有硬编码的危险模式、对 shell AST 的语义检查和专门的 Zsh 危险内建命令表,auto 模式再叠加 LLM 分类器。多层并存的原因是:正则挡不住变量拼接和管道,AST 挡不住业务语义,分类器挡不住不可用的网络。
以上手段都在判断「这条命令想做什么」。还有一条路是绕开意图,直接限制进程能碰到什么。
5.1 沙箱:把权限问题换一个问法
沙箱在 Claude Code 里默认关闭(sandbox.enabled 为 false)。开启后,它不维护独立的规则表,只回答一个问题:这个进程能碰到什么。 判断意图永远有漏,限制进程能碰到什么只需要配置一次,然后由内核执行。
这个定位要站得住,得回答四个问题:规则从哪来(5.1.1)、边界画在哪(5.1.2)、运行期怎么对齐(5.1.3)、平台为何改变结论(5.1.4)。
5.1.1 规则只有一份,流向是双向的
权限规则和沙箱配置不是两套并行维护的清单,而是同一条规则的两次投影,方向正好相反。
流出:权限规则生成沙箱配置。 convertToSandboxRuntimeConfig 把 Edit(...) 规则变成写白名单/黑名单,Read(...) 变成读黑名单,WebFetch(domain:...) 变成 allowedDomains。工作目录、Claude 临时目录、--add-dir 追加目录和 worktree 主仓自动进白名单;各类 settings 文件、managed drop-in 目录和 .claude/skills 强制进黑名单。settings 文件被拦是因为它决定沙箱本身的配置,允许改等于允许模型给自己解绑;skills 被单独补进来,是因为它和 commands/agents 同权------自动发现、自动加载、拥有完整能力。
之所以派生而不是各写一份,是因为边界只画在 spawn 点(见 5.1.2):改一个文件,走 Edit 是引擎直接写,走 Bash 是沙箱内写,两条路径的控制点不同。两边各自维护,同一条规则就会给出两个结论。denyWrite 里的 settings.json 也因此只对 shell 路径有意义;文件工具那条路上,它由权限层的安全检查拦截。
流回:沙箱的状态参与权限判定。 有三个落点:
- 自动批准。 开启
autoAllowBashIfSandboxed(默认 true)后,被沙箱接管的 Bash 调用直接放行,但 deny 规则仍在最前面,ask 规则会先拆子命令再逐条判断。这就是沙箱真正的产出:它让「自动批准」变得可以接受,因为进程能碰到的范围已经被内核限制住。 - 路径校验。 写操作在权限层会检查目标是否落在沙箱写白名单里,避免
echo > /tmp/claude/x这类已受沙箱保护的操作再弹一次窗。 - 绕行出口。 模型可以传
dangerouslyDisableSandbox: true,但这不是后门:allowUnsandboxedCommands为 false 时该参数被完全忽略,为 true 时命令走正常权限管线重新征求同意。excludedCommands同理,源码注释明说它不是安全边界,能绕过它不算漏洞,因为真正的控制点是权限提示。
两个方向合起来是一个闭环:配置从权限来,自动批准的依据从沙箱来,路径校验复用同一份白名单,所有绕行又都回到权限提示。任何一端单独维护,用户看到的允许和内核执行的允许就会分叉。
5.1.2 边界只画在 spawn 点
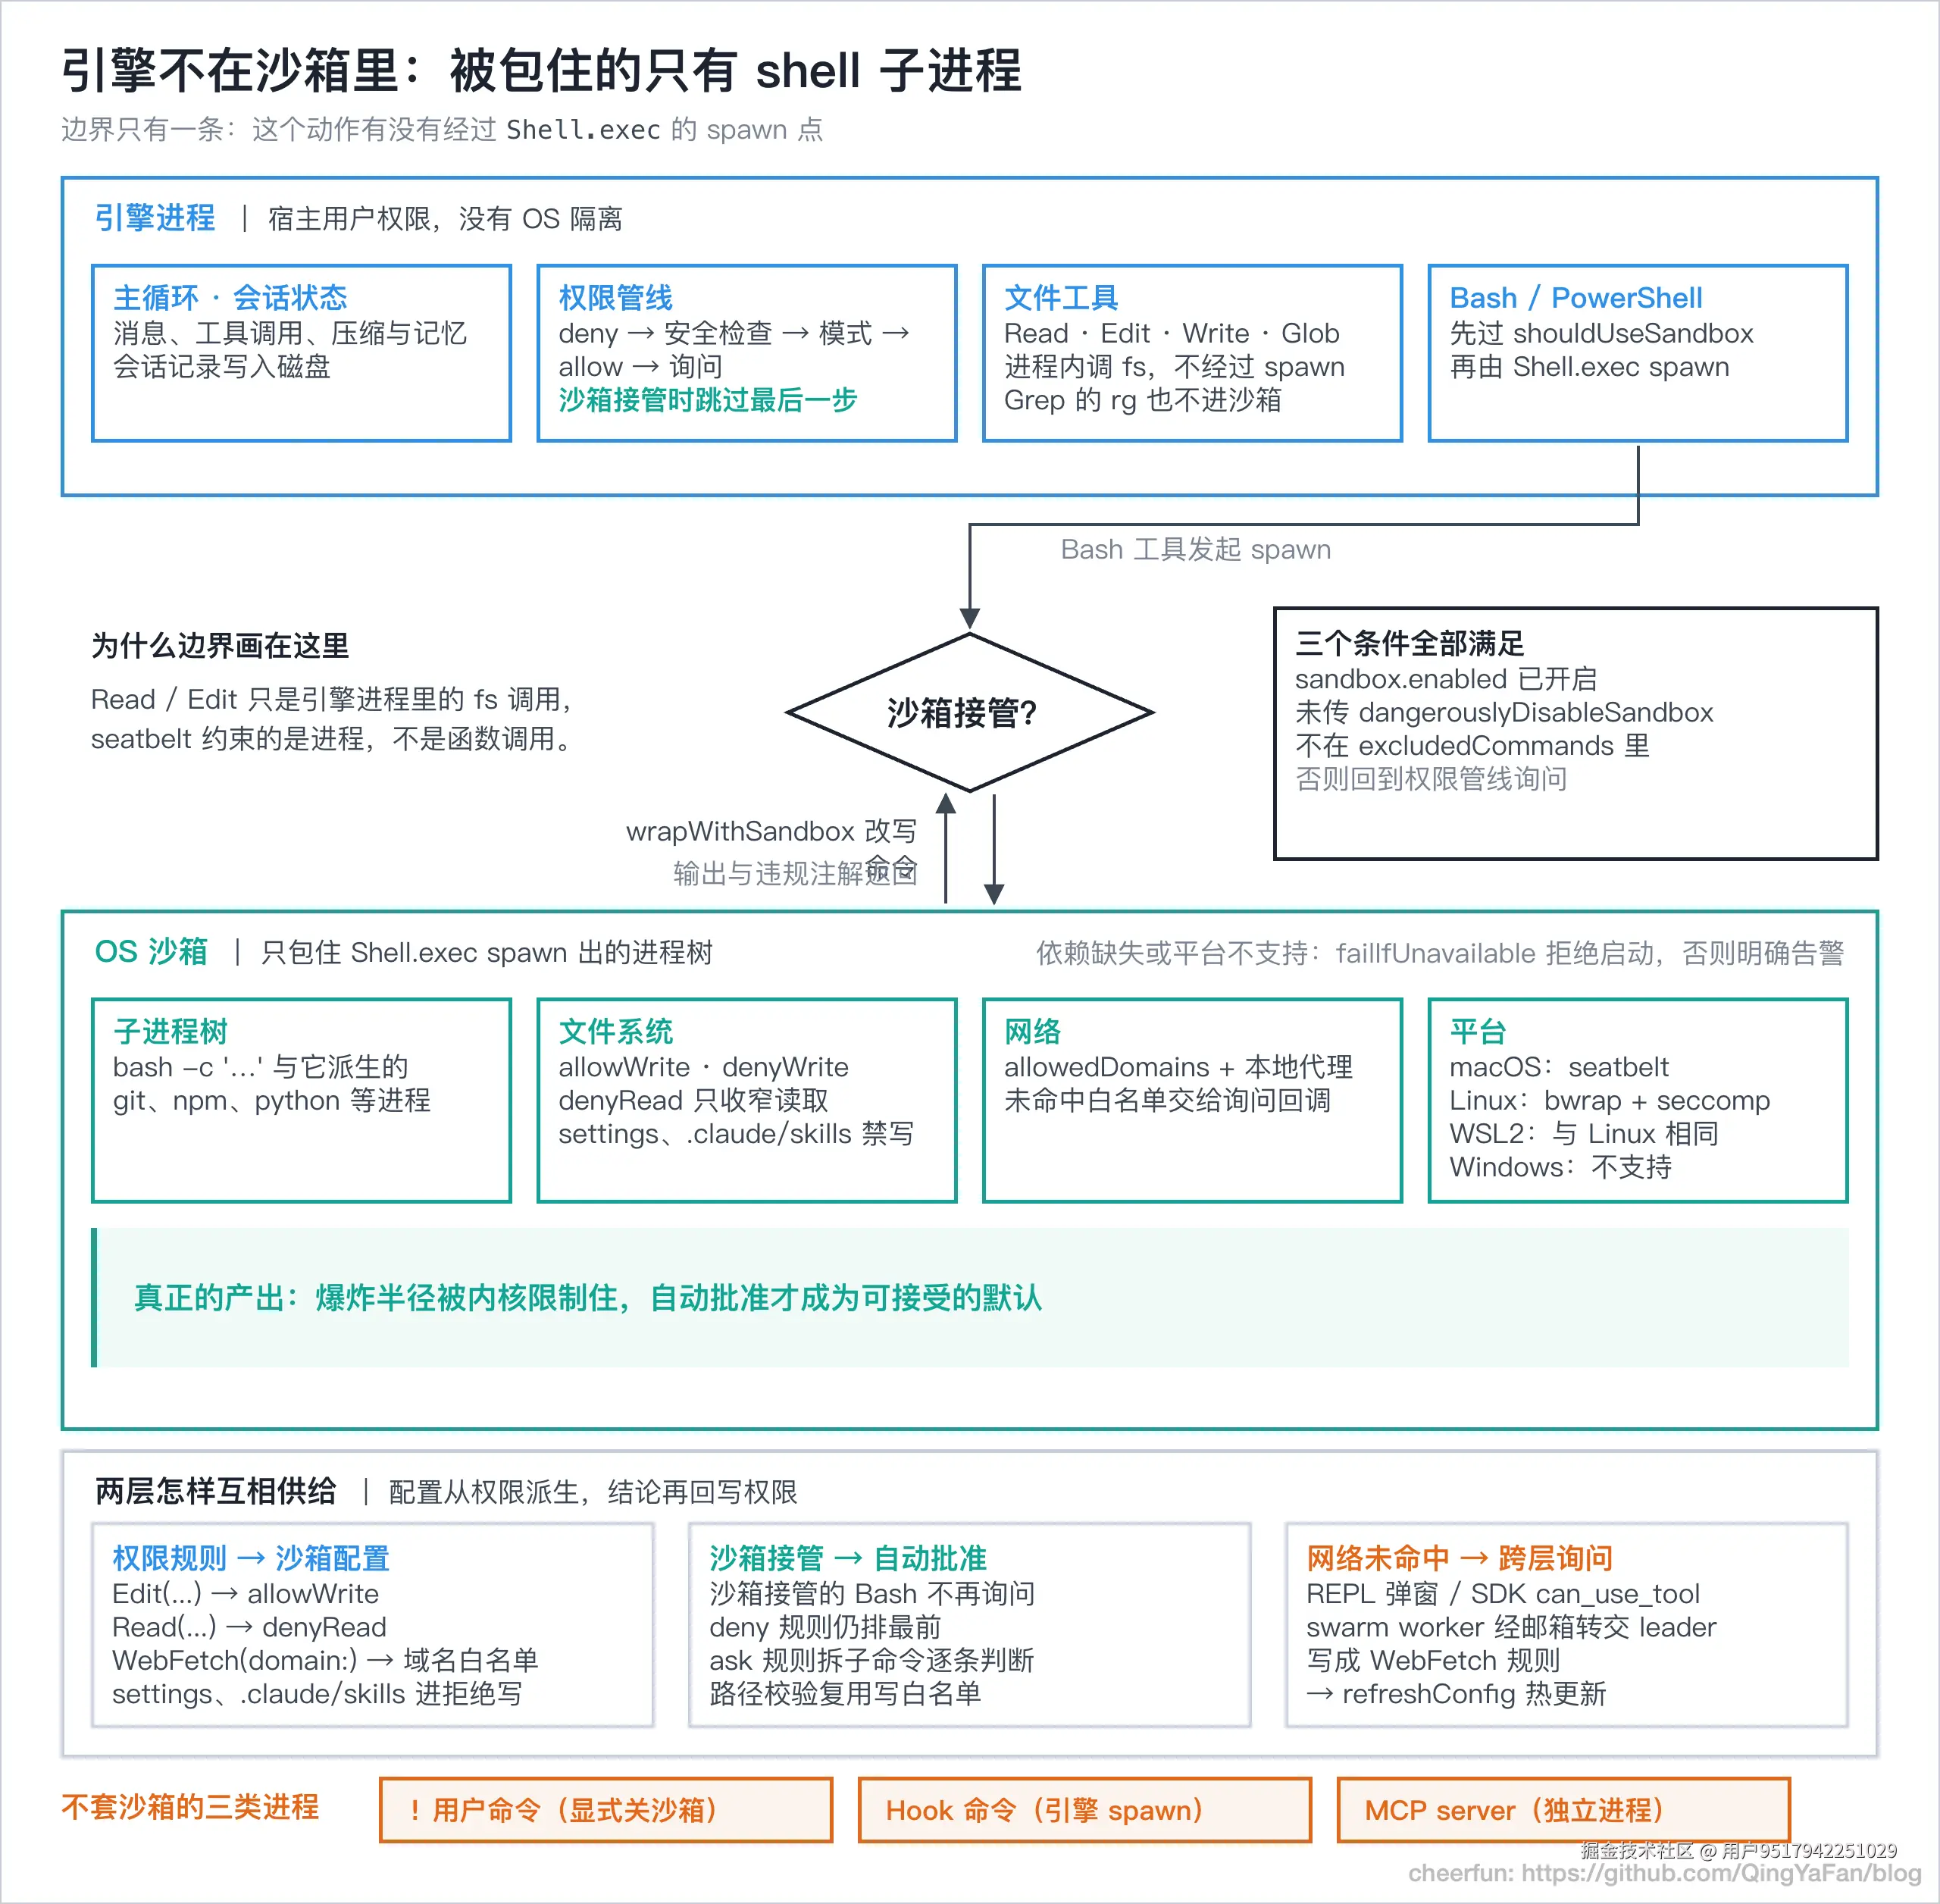
沙箱不是套在引擎外面的壳,而是挂在 spawn 点上的笼子:引擎进程以宿主用户权限运行,所有工具调用都经过权限管线;只有经 Shell.exec spawn 出去的 shell 子进程及其子孙,才落进 macOS 的 seatbelt 或 Linux 的 bubblewrap(bwrap)。
| 动作 | 在哪跑 | 沙箱是否生效 |
|---|---|---|
| 主循环、权限判定、上下文压缩、记忆读写 | 引擎进程,宿主用户权限 | 否 |
| Read / Edit / Write / Glob / Grep | 进程内直接调 fs;Grep 由引擎自己 spawn rg |
否,只受权限管线约束 |
| Bash / PowerShell 的每次命令 | wrapWithSandbox 改写后 spawn 的子进程及其子孙 |
是 |
用户敲的 ! 命令 |
显式传 dangerouslyDisableSandbox: true |
否 |
| Hook 命令、MCP server | 引擎自己的 spawn | 否 |
后两类不套沙箱不是漏洞:! 是用户自己敲的,Hook 与 MCP server 是用户自己配置的受信组件,各自按信任边界处理。
为什么边界画在这里:OS 沙箱约束的是进程 ,不是函数调用。Read/Edit 只是引擎进程里的几次 fs 调用,seatbelt 对它们无从下手;要把引擎也关进去,就得给配置读取、会话写入、API 调用逐一开洞。模型能自由拼出来的东西只有一样------shell 命令,所以沙箱只包这一层,其余能力靠结构化输入加权限判定。
这条边界和两层的互相供给可以放在一张图里看:上半部分是引擎,文件工具在进程内直接读写,只有 Bash 命令走到 Shell.exec 的接管判断;被判定接管的命令才进入下半部分的 OS 沙箱。底部三条说明两层怎样互相供给:配置派生、自动批准与网络放行。
5.1.3 运行期有三处必须咬合
边界只回答「谁在笼子里」,不保证另外三件事:两层的结论始终一致、模型知道笼子在哪、沙箱不留残渣。任一处断开,闭环就漏。
- 两层的判断始终一致。 settings 变更通过订阅推给
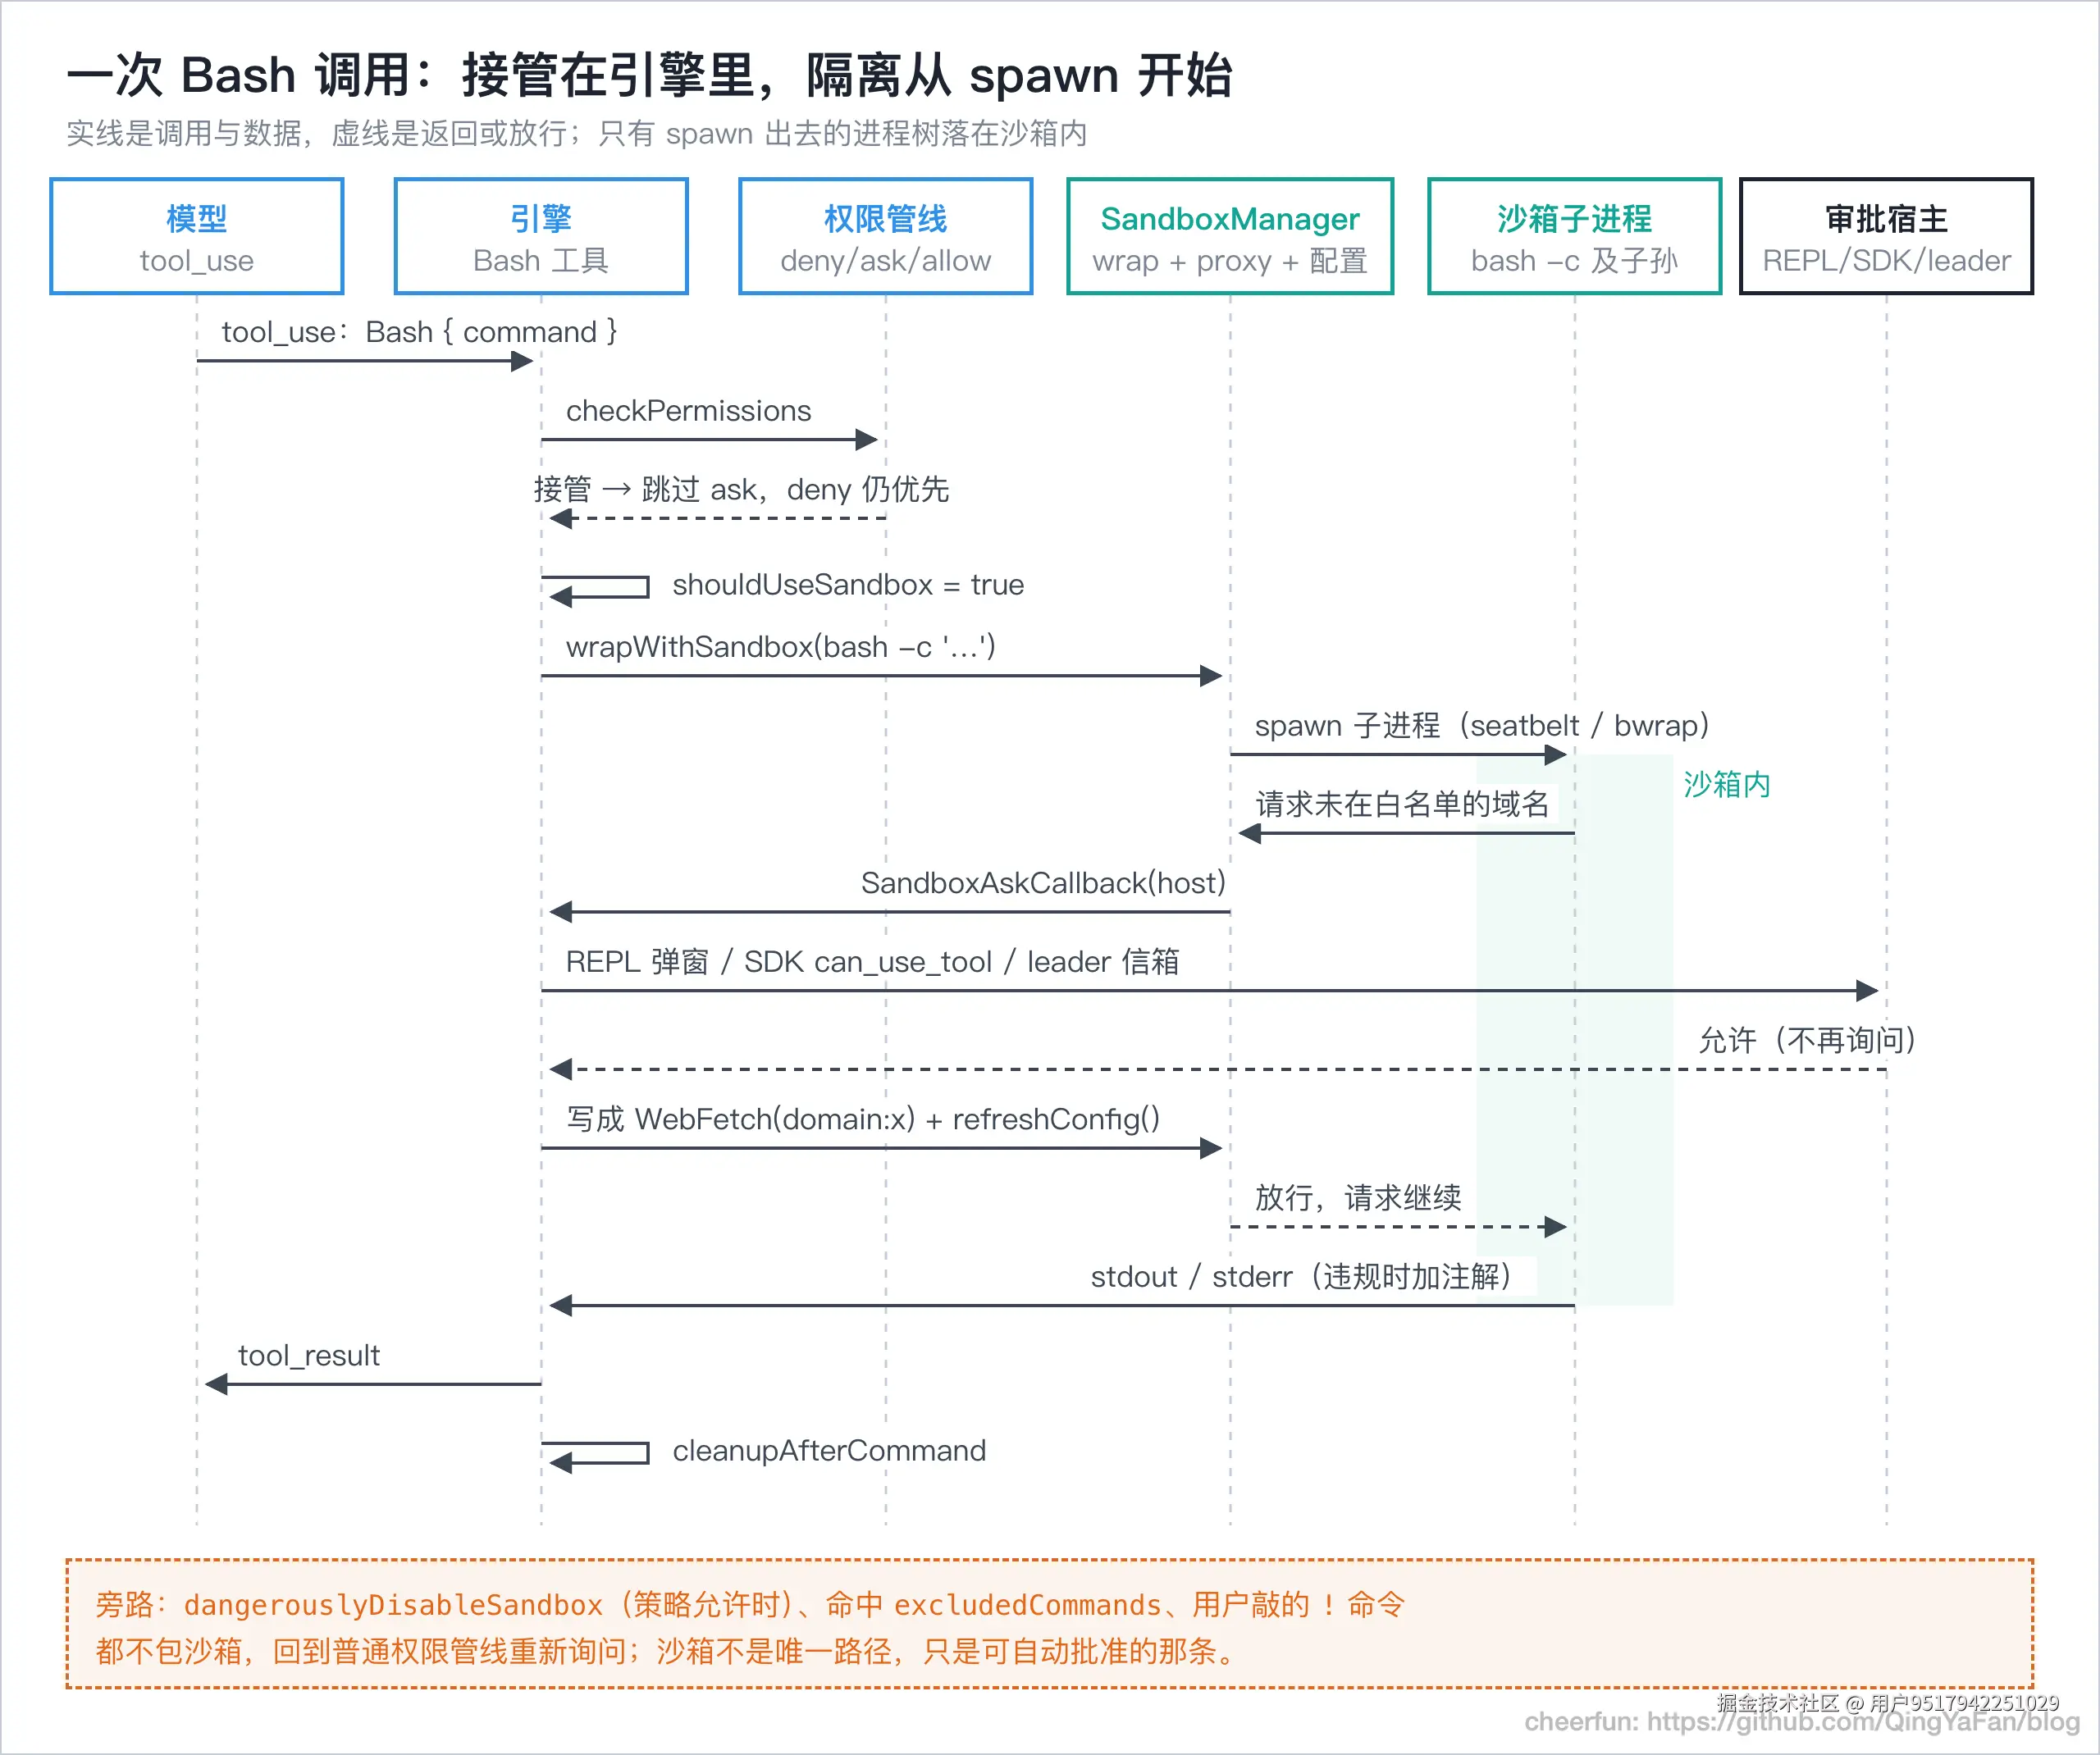
BaseSandboxManager.updateConfig,权限更新后同步调一次refreshConfig(),避免「用户刚点允许、沙箱还没读到新域名」的窗口;初始化 Promise 也在第一个await前赋值,让并发调用看不到未初始化状态。网络未命中时的审批是同一份要求跨层出现:SandboxAskCallback在 REPL 弹窗、SDK 或无界面运行转成can_use_tool、多 Agent 协作时转交 leader,用户选「不再询问」就写成WebFetch(domain:x)allow 规则并立即刷新配置。allowManagedDomainsOnly在回调外面再包一层,直接返回 false,用户点了也无效。 - 模型知道边界在哪。 沙箱生效时,Bash 的系统提示会注入当前文件系统与网络限制,并写明什么样的报错才算沙箱导致、重试要用
dangerouslyDisableSandbox: true。真被拦下时,annotateStderrWithSandboxFailures把违规说明追加进命令输出,用<sandbox_violations>包裹:模型看得到,UI 显示前再剥掉。约束在事前说明、失败在事后解释,模型才不会把沙箱拦截当成普通报错去盲目重试。 - 生命周期两端都要收干净。 启动时,显式开启沙箱但平台不支持、依赖缺失或不在
enabledPlatforms里,getSandboxUnavailableReason给出具体原因;failIfUnavailable为 true 直接拒绝启动,否则打印警告后继续。源码注释把这处修复的动机写成 security footgun:用户配了allowedDomains却一项都没生效,还以为自己在受保护。收尾时,Linux 上 bwrap 为拒绝写入不存在的路径,会在宿主上留下 0 字节挂载点;cleanupAfterCommand在命令结束的同一个微任务里清掉这些幽灵文件,并删除可能被植入的 bare-repo 文件(HEAD、objects等),避免后续未沙箱化的 git 调用中招。
把这三处咬合放进一次调用里:
5.1.4 同一份规则落到不同平台,语义并不相同
上面这条时序在三个平台上并不等价,失效方式分三种:
- 通配路径失效。 Linux 的 bwrap 不支持 glob,权限规则里的通配路径会失效,
getLinuxGlobPatternWarnings把这批规则单独挑出来提示。 - 按路径的 socket 放行失效。 按路径放行 Unix socket 只在 macOS 有效,Linux 的 seccomp 只能按类型过滤。
- 整层不存在。 Windows 原生不支持沙箱,PowerShell 工具在 Windows 上直接跳过沙箱判断。
沙箱不替权限做决定,它改变的是做决定的代价:同样一句「允许」,在笼子里执行和在宿主上执行,风险不是一个量级。权限管线回答「准不准」,沙箱回答「准了之后能走多远」------前者是决策,后者是决策生效时的物理边界。
六、判断五:上下文是预算,压缩按代价分层
权限决定「能不能做」,上下文决定「还能不能想」。一个任务跑到第 80 轮,历史消息已经把窗口填满,先删哪一段?Claude Code 没有等上下文爆掉再处理,而是在每次 API 调用前跑一条分层降级链:
- 历史裁剪(feature gate):按片段裁掉旧历史,先释放最容易释放的空间;
- 微压缩:清理旧工具结果;时间型策略在距上一条 assistant 超过 60 分钟时触发,缓存型策略走 cache editing;
- 上下文折叠(feature gate):把旧消息投影成更短的视图,同时保留可回放的归档;
- 自动压缩:前几步都不够时,才调用模型做整体摘要。
这条链的顺序就是成本顺序:裁剪是本地操作,微压缩多数不调模型,折叠是读时投影,整体摘要最贵。先做便宜的,能省掉最贵的那一步。
阈值也留了明确余量。有效窗口 = 模型上下文窗口 − 摘要预留(最多 20,000 token);自动压缩线再减 13,000 token 缓冲;警告线和错误线各留 20,000。摘要本身用 forked agent 执行,复用主会话的 cacheSafeParams,失败才退回直接调模型。连续失败 3 次会熔断,源码注释记录了这个改动的背景:曾有 1,279 个会话在一个会话内连续失败 50 次以上,全球每天浪费约 25 万次 API 调用。
压缩策略不止一种,各自处理不同粒度:
| 策略 | 触发 | 是否调模型 |
|---|---|---|
| 时间型微压缩 | 距上条 assistant 超过 60 分钟 | 否 |
| 缓存型微压缩 | cache editing 达到阈值 | 否,走服务端 |
| API 原生上下文管理 | 服务端策略,默认 180k 触发、保留 40k | 服务端处理 |
| 会话记忆压缩 | 已有 session memory 时优先复用 | 否,直接读 summary.md |
| 自动压缩 | 超过阈值且前几步无效 | 是,forked agent 摘要 |
会话记忆本身也有独立的写入节奏:上下文达到 10,000 token 后初始化,之后每新增 5,000 token 且累计 3 次工具调用才更新一次。每节约 2,000 token、全文上限 12,000 token,避免摘要自己变成新的上下文负担。
除了消息压缩,还有三处预算控制:
- 工具结果与消息级预算(见判断二)。
- Skill 列表只占上下文窗口的 1%,8,000 字符兜底,每条描述最多 250 字符。
- 可延迟加载的工具 schema 交给
ToolSearch按需发现。
这些预算的共同点是:先规定「最多给多少」,再决定「给什么」,而不是让内容自然膨胀后再截断。
七、判断六:记忆是文件,召回是模型决策
上下文预算管的是这一次会话能想多久,会话一结束就清零。记忆要解决清零之后的事:下周再打开同一个项目,Agent 该记得「提交信息用中文」这类从代码里看不出来的偏好,而不是再问一遍。
但记忆最常见的失败不是「记不住」,是「记得太多」:存进去的尽是随时能重新算出来的东西,召回时自然全是噪声。Claude Code 的应对是在两端各设一道门槛:写入端先定「不存什么」,召回端先按时间缩小候选、再让一个小模型挑几条。下面三块分别回答存什么(7.1)、怎么挑(7.2)、什么时候做(7.3)。
7.1 写入:先定不存什么
写入有两条路,一条人写、一条 Agent 写:
- 人写的项目指令。 走
CLAUDE.md的四层加载:managed → user → project → local,从当前目录向上遍历到根目录,越靠近当前目录优先级越高。支持@path引用,只处理叶子文本、深度上限 5、带循环检测。单文件建议上限 40,000 字符,但源码只用它列出超大文件,没有据此截断。 - Agent 自己写的自动记忆。 走
memdir:~/.claude/projects/<slug>/memory/下每个主题一个 markdown 文件,frontmatter 固定三项name、description、type;类型是封闭的四种:user、feedback、project、reference。目录入口MEMORY.md没有 frontmatter,一行一个文件,上限 200 行或 25KB。
两条路的格式都不复杂,真正决定质量的是「不存什么」:源码里有一段固定提示,明确排除可从代码推导的架构与路径、git 历史、调试配方、CLAUDE.md 已有的内容、临时任务状态;即使用户要求保存活动列表,也要先追问「其中哪一点是反直觉的」。判据可以压成一句:下次要用时,这条信息能不能轻易重新推出来。
7.2 召回:程序定触发,模型定挑选
写下的文件不会自己跑进上下文。召回分两段,但不靠关键词命中:
- 时间筛。 先扫描记忆目录,按 mtime 倒序取最近 200 个文件的 frontmatter,拼成一份清单。
- 模型选。 再让一个 Sonnet 侧查询从清单里最多选 5 个。近期已经用过的工具,其参考文档会被排除,避免模型正在用某个工具时又被塞一份该工具的说明书。
所以「关键词匹配 + 时间衰减」的说法并不准确:时间只用来缩小候选集,相关性判断由一个小模型完成;description 写得好不好,直接决定这条记忆能不能被选中,frontmatter 要求它「具体到能判断相关性」也是为此。
分工还要再划清一层:整条链上只有「挑哪几条」交给模型。触发是写死的,每个回合入口自动跑一次,不需要主模型同意;模型自己翻记忆目录(Read、Grep)只是兜底,提示词只规定「用户明确要求时必须查」。检索也没有做成一个工具交给模型调用,默认路线是先把可能用得上的几条递过去。
7.3 时序:读写与主回合并行
读写都要花时间。Claude Code 不让它们串在用户等待的路径上,而是各借一段本来就在等的时间:
- 读取提前发起。
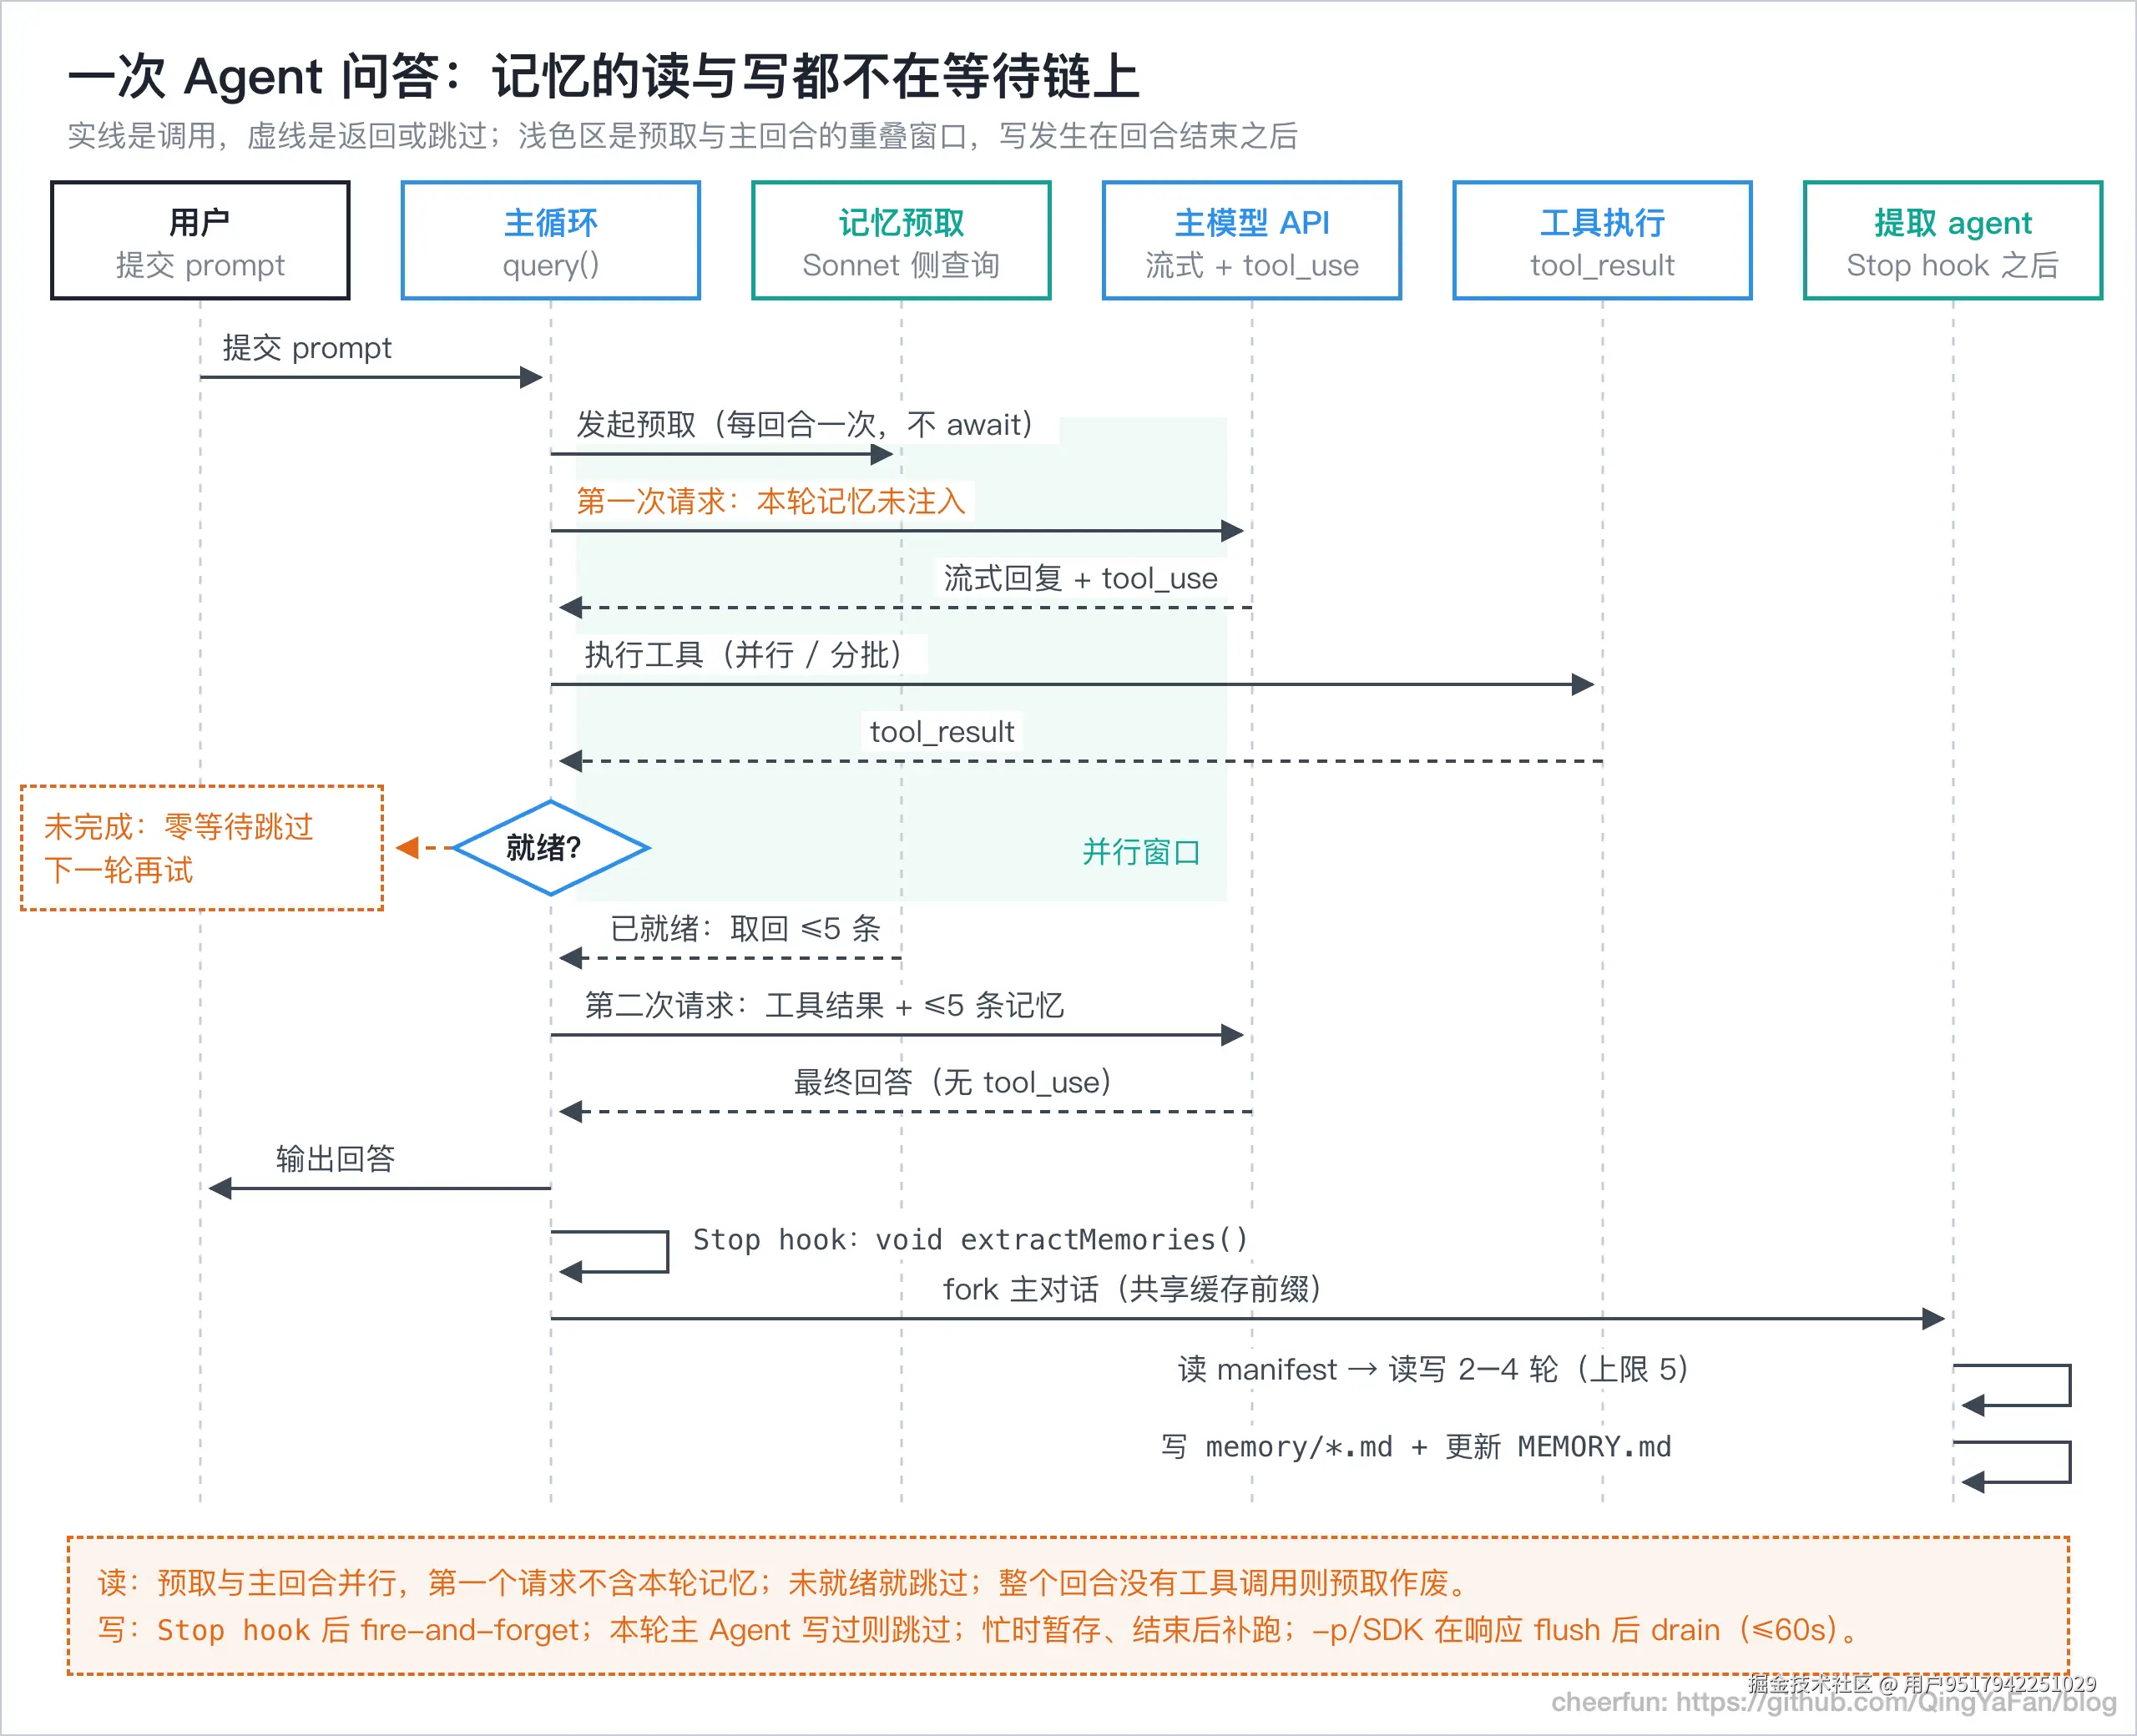
startRelevantMemoryPrefetch在每轮开始时发起侧查询,与模型流式生成并行;用户按 Esc 会通过子 AbortController 一并取消。选中的记忆作为relevant_memories附件注入,最多 5 条,并带上「这条记忆可能已过时」的年龄提示。 - 写入放到收尾。 由一个 forked agent 在 Stop hook 阶段完成,最多 5 轮;主 Agent 本轮已经写过记忆就跳过,避免重复。
这套做法的代价同样明确:第一个请求拿不到本轮记忆;整轮没有工具调用,预取就没有消费窗口,直接作废;预取没跑完时不等待,跳过、下一轮再试。换来的是读写都塞进模型本来就要等待的窗口,也不在主循环之外另开一条同步链路。
把读写放回一次问答的时序里:
八、判断七:缓存与事件流是运行时的硬约束
前面六节都在管「做什么」,这一节管「做得值不值」。Claude Code 把 prompt cache 当成一等约束,很多看起来奇怪的代码都是为它让路,六处很明显:
- 工具顺序。 工具池按名字排序,但内建工具必须保持连续前缀。注释解释:服务端的全局缓存断点落在最后一个内建工具之后,扁平排序会让 MCP 工具插进内建工具之间,导致后续所有缓存键失效。
- 观测副本。
backfillObservableInput只改观测副本,绝不改发往 API 的原始输入,注释直接写明「preserves prompt cache」。 - 系统提示。 按 section 记忆化,直到
/clear或/compact才失效。 - 压缩摘要。 复用主会话的
cacheSafeParams,fork 子 Agent 共享父级缓存前缀。 - 转存决定。 工具结果的转存决定会被冻结,避免每轮重新计算导致缓存失效。
- Sleep 提示。 连
Sleep工具的提示里都写着:每次唤醒是一次 API 调用,prompt cache 在 5 分钟无活动后过期,要按这个节奏安排等待。
这些细节放在一起,说明 harness 的性能指标不只是「延迟」,还包括「缓存命中率」。一次无意的输入变动可能让 5--7 万 token 的前缀缓存全部重算,成本比多跑一次工具高得多。
另一条硬约束是事件流。HOOK_EVENTS 定义了 27 个事件,覆盖工具前后、会话起止、压缩前后、权限请求与拒绝、任务创建与完成、配置变更、工作区变更、文件变更等。可配置的执行器有四种:command、prompt、http、agent。
Hook 不是旁路日志,它能反向影响循环:命令输出按 JSON 解析后可以给出权限决定、修改入参、追加 additionalContext;退出码 2 变成阻塞错误;聚合结果可以 preventContinuation 或把错误拼回上下文再跑一轮。HTTP hook 有 URL 白名单和 SSRF 防护,且 SessionStart、Setup 这类事件不允许走 HTTP。
加上 GrowthBook 的 feature flag 与埋点,压缩策略、工具开关、分类器行为都能灰度。这套 harness 自己也在被 A/B 测试,而不是发布后就冻结。
九、能力索引
能力清单的价值不在数量,而在归属。下面这张索引把七节里的能力落回判断,每一项都能回答「属于哪条判断」,而不是「一共有多少个」。
| 能力 | 归属判断 |
|---|---|
| 主循环与退出原因 | 判断一 |
| 流式工具执行 | 判断一、判断三 |
| 工具契约与默认值 | 判断二 |
| 输入校验与错误信封 | 判断二 |
| 结果转存与消息预算 | 判断二、判断五 |
| 并发分批与中断层级 | 判断三 |
| 子 Agent 与队友 | 判断三 |
| 权限模式与管线 | 判断四 |
| 危险命令识别 | 判断四 |
| OS 沙箱与权限互供 | 判断四 |
| 上下文压缩链 | 判断五 |
| CLAUDE.md 与自动记忆 | 判断六 |
| Skills / Plugins / MCP | 判断二、判断五、判断七 |
| 27 类 Hook 与四种执行器 | 判断七 |
| Session / Worktree / Plan | 判断三、判断四、判断六 |
工具目录下共有 42 个子目录(其中 shared、testing 是公共目录,不是工具本身),注册表 getAllBaseTools() 再按平台、环境变量和 feature flag 裁剪;getTools() 还会剔除被 deny 规则整体封禁的工具、隐藏 REPL 专用原语、执行工具自己的 isEnabled()。所以「内置工具有多少个」没有稳定答案,能确定的是装载机制:先全量声明,再按策略裁剪,而不是按需拼装。
十、对自建 Harness 的启示
如果正在做一个垂直 Agent,Claude Code 最值得借鉴的不是功能列表,而是下面六条做法:
- 先定义
stop_reason,再写循环。 把完成、超轮次、无进展、被取消、失败做成封闭枚举,调用方才能区分「做完了」和「被掐断了」;否则上层只能靠文本猜。 - 工具契约至少写三层。 模型可读的 schema 与描述、运行时能验的语义校验、失败能解释的错误信封。少任何一层,模型都难以自我修复。
- 并发安全默认 false。 让工具作者显式声明,而不是让调度器推断;声明函数抛异常时按不安全处理。上下文修改要排队重放,不能依赖完成顺序。
- 权限默认拒绝,失败也拒绝。 分类器不可用、会话过大、依赖缺失,都应该有明确且可见的降级路径;静默放行比报错危险得多。如果加了沙箱,就让它和权限规则共用一份配置,并允许沙箱接管的调用自动放行------两层各配一遍,迟早对不上。
- 上下文按代价分层。 先裁剪、再微压缩、再折叠、最后才摘要;给摘要预留空间,给连续失败设熔断,别让压缩自己变成故障源。
- 记忆先写「不存什么」。 存储格式和检索算法都不是第一优先级;先保证不把可推导、易过时的信息写进去,再谈召回。
这六条都不是「多写一个模块」,而是在已有模块之间加约束。Harness engineering 的主要工作量,恰恰落在这类约束上。
十一、边界
这份分析有几处边界需要说明:
- 静态阅读。 全部结论来自源码阅读,没有运行 Claude Code 做行为实测。文中的阈值、上限、事件数量是代码里的值;线上的实际行为还受模型、服务端策略、GrowthBook 配置和环境变量影响。
- 缺失模块。 源码树里有几处 feature-gated 模块在调用点出现、但文件本身缺失:历史裁剪、上下文折叠、reactive compact 在当前快照里都找不到对应实现文件。文中只描述了调用顺序与开关位置,没有推断其内部算法。
- 外部包。 沙箱的落地实现有一半在
@anthropic-ai/sandbox-runtime里,快照中只有适配层。本文关于 seatbelt 与 bubblewrap 的描述来自适配层的依赖检查、平台判断和源码注释,没有核对该包如何生成沙箱 profile,也没有验证网络代理的拦截细节。 - 内部工具。
USER_TYPE === 'ant'分支下的工具(如ConfigTool、TungstenTool、REPL 原语)不属于外部版本的行为,本文未把它们计入能力判断。 - 时间点。 这是泄露快照的一个时点,Claude Code 迭代很快,函数名、阈值和顺序都可能变化。
- 未覆盖范围。 文章没有覆盖 TUI 渲染、遥测隐私边界、OAuth 与远程会话协议,这些属于产品与平台层,不是本文讨论的 harness 控制面。
Footnotes
-
Chaofan Shou,关于 Claude Code npm 包残留 source map 的推文,2026-03-31 --- x.com/Fried_rice/... ↩
-
claude-code-analysis,Claude Code 泄露源码的静态分析文档集 --- github.com/liuup/claud... ↩