卡尔曼滤波自学教程 10:无迹卡尔曼滤波(UKF)

系列导航 :上一篇:扩展卡尔曼滤波(EKF) | 下一篇:综合实战一:IMU 姿态估计

本篇目标:读完本篇,你将能够

  • 用"香蕉形分布"的例子说明线性化在什么情况下失效;
  • 写出 sigma 点和权重的公式,理解 α、β、κ、λ 各自的作用;
  • 证明 sigma 点精确保持均值和协方差,并说明无迹变换对非线性函数精确到二阶;
  • 推导并实现完整的 UKF,在雷达跟踪场景上与 EKF 做公平对比。

前置知识:第 02 篇(协方差与多元高斯)、第 06 篇(最优增益的推导)、第 09 篇(EKF 与雷达例子)。

上一篇的 EKF 用切线代替曲线:在估计点求雅可比,然后套用线性卡尔曼滤波。这种做法有两个代价:一是要手推雅可比,二是当不确定性范围内函数弯曲得厉害时,切线会严重失真。

无迹卡尔曼滤波(Unscented Kalman Filter,UKF)换了一个角度看问题。Julier 和 Uhlmann 在 1990 年代提出的核心观点大意是:近似一个概率分布,比近似一个任意的非线性函数更容易。 与其把函数线性化,不如从分布里挑出少量有代表性的点,让它们原封不动地穿过非线性函数,再根据这些点在另一侧的位置重新统计出均值和协方差。这个过程叫无迹变换 (Unscented Transform,UT),挑出来的点叫 sigma 点。

一、线性化在什么时候失效

1. 香蕉形分布

雷达测到的是距离 rr r 和方位角 θ\theta θ。把它换算成直角坐标是一个典型的非线性变换:
x y =g(r, θ)= rcos⁡θ rsin⁡θ \begin{bmatrix} x \\ y \end{bmatrix} = g(r,\ \theta) = \begin{bmatrix} r\cos\theta \\ r\sin\theta \end{bmatrix} xy=g(r, θ)=rcosθrsinθ

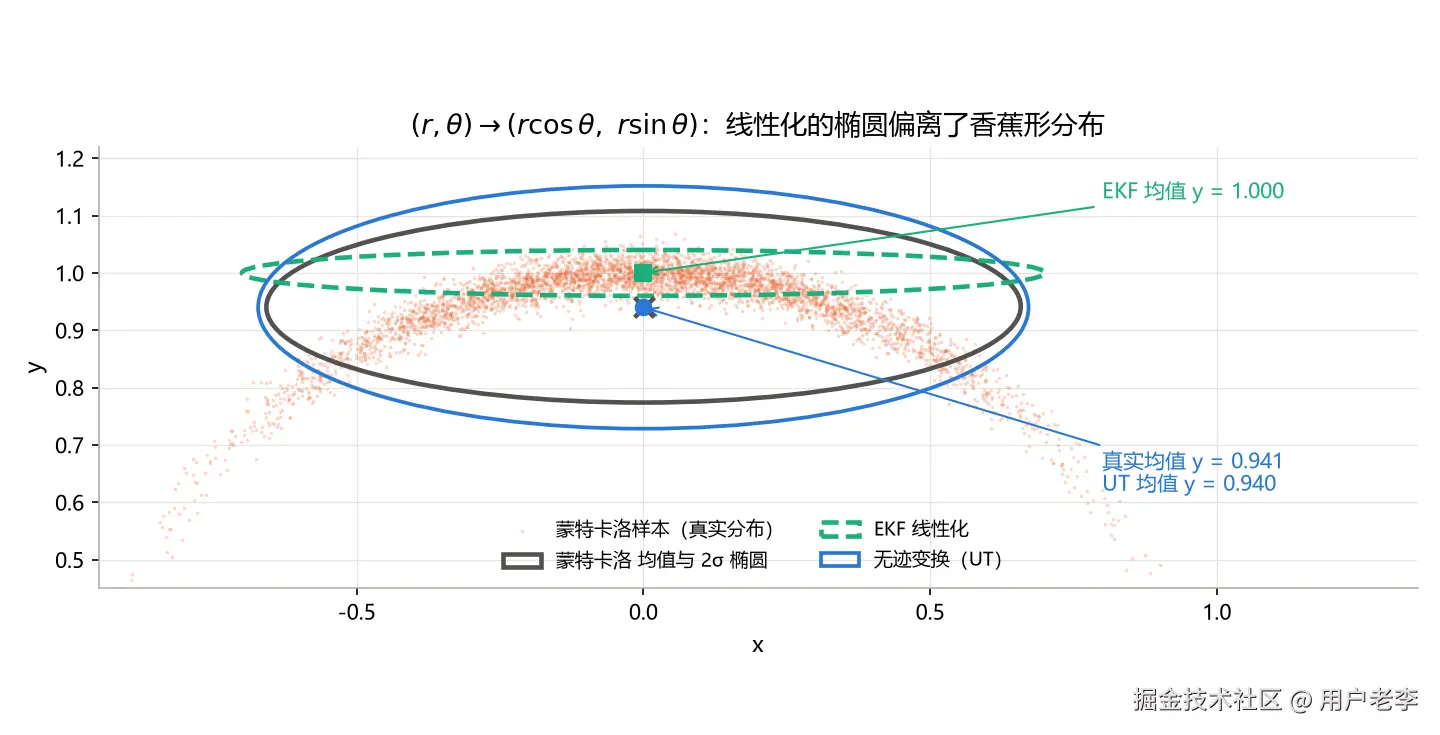
设 r∼N(1, 0.022)r \sim \mathcal{N}(1,\ 0.02^2) r∼N(1, 0.022), θ∼N(π/2, 0.352)\theta \sim \mathcal{N}(\pi/2,\ 0.35^2) θ∼N(π/2, 0.352),两者独立。也就是说,测距很准(2%),但测角很粗(标准差约 20°)。从这个分布里抽 20 万个样本,逐个换算到直角坐标,得到的点云呈弯弯的"香蕉形"(图 1 中的橙色点):所有点到原点的距离都接近 1,沿着半径为 1 的圆弧散开。

2. 精确的均值

先算出真实均值,作为后面比较的基准。对 θ∼N(μθ,σθ2) \theta \sim \mathcal{N}(\mu_\theta, \sigma_\theta^2) θ∼N(μθ,σθ2),利用高斯分布的特征函数 Eeiθ=e iμθ−σθ2/2 Ee\^{\\mathrm{i}\\theta} = e^{\mathrm{i}\mu_\theta - \sigma_\theta^2/2} Eeiθ=eiμθ−σθ2/2,分别取实部和虚部:
Ecos⁡θ=cos⁡μθ e −σθ2/2 ,Esin⁡θ=sin⁡μθ e −σθ2/2 E\\cos\\theta = \cos\mu_\theta\, e^{-\sigma_\theta^2/2}, \qquad E\\sin\\theta = \sin\mu_\theta\, e^{-\sigma_\theta^2/2} Ecosθ=cosμθe−σθ2/2,Esinθ=sinμθe−σθ2/2

由于 rr r 与 θ\theta θ 独立, Ersin⁡θ=Er Esin⁡θEr\\sin\\theta = Er\,E\\sin\\theta Ersinθ=ErEsinθ,所以
Ex=1⋅cos⁡π2 e−0.352/2=0,Ey=1⋅sin⁡π2 e−0.352/2=e−0.06125≈0.9406Ex = 1 \cdot \cos\frac{\pi}{2}\, e^{-0.35^2/2} = 0, \qquad Ey = 1 \cdot \sin\frac{\pi}{2}\, e^{-0.35^2/2} = e^{-0.06125} \approx 0.9406 Ex=1⋅cos2πe−0.352/2=0,Ey=1⋅sin2πe−0.352/2=e−0.06125≈0.9406

蒙特卡洛的结果是 (0.0004, 0.9409)(0.0004,\ 0.9409) (0.0004, 0.9409),与解析值一致。

3. EKF 线性化的结果

在均值点 (r,θ)=(1,π/2)(r, \theta) = (1, \pi/2) (r,θ)=(1,π/2) 处求雅可比:
J= cos⁡θ −rsin⁡θ sin⁡θ rcos⁡θ (1, π/2) = 0 −1 1 0 \mathbf{J} = \begin{bmatrix} \cos\theta & -r\sin\theta \\ \sin\theta & r\cos\theta \end{bmatrix}_{(1,\ \pi/2)} = \begin{bmatrix} 0 & -1 \\ 1 & 0 \end{bmatrix} J=cosθsinθ−rsinθrcosθ(1, π/2)=01−10

线性化给出的均值是 g(1,π/2)=(0, 1)g(1, \pi/2) = (0,\ 1) g(1,π/2)=(0, 1),协方差是
JPJ⊤= 0 −1 1 0 0.022 0 0 0.352 0 1 −1 0 = 0.1225 0 0 0.0004 \mathbf{J}\mathbf{P}\mathbf{J}^\top = \begin{bmatrix} 0 & -1 \\ 1 & 0 \end{bmatrix} \begin{bmatrix} 0.02^2 & 0 \\ 0 & 0.35^2 \end{bmatrix} \begin{bmatrix} 0 & 1 \\ -1 & 0 \end{bmatrix} = \begin{bmatrix} 0.1225 & 0 \\ 0 & 0.0004 \end{bmatrix} JPJ⊤=01−100.022000.3520−110=0.1225000.0004

三种方法的结果放在一起(后两行"无迹变换"将在第三节解释):

方法 均值 yy y Var⁡(x)\operatorname{Var}(x) Var(x) Var⁡(y)\operatorname{Var}(y) Var(y)
蒙特卡洛(20 万个样本) 0.9409 0.1082 0.0070
EKF 线性化 1.0000 0.1225 0.0004
无迹变换(5 个点) 0.9400 0.1128 0.0112

图 1:橙色是蒙特卡洛样本,灰色椭圆是由样本算出的均值和 2σ 椭圆(真值),绿色虚线是 EKF 线性化的结果,蓝色是无迹变换的结果。

EKF 的问题非常明显:

  • 均值偏高。 线性化的均值 y=1y = 1 y=1,真实值约 0.9410.941 0.941,偏差 0.0590.059 0.059。
  • yy y 方向的方差被严重低估。 线性化认为 yy y 方向的标准差只有 0.020.02 0.02(只来自测距误差),而真实值约 0.0840.084 0.084。圆弧向下弯曲带来的 yy y 方向散布,切线完全看不到。
  • 两者叠加,EKF 是"自信地错了"。 它的均值偏差 0.0590.059 0.059 大约是它自己给出的标准差 0.020.02 0.02 的 3 倍。在滤波器里,这意味着协方差过小、增益过小,新的测量被忽视,严重时会导致滤波发散。

根源在于:这里的角度不确定性(20°)很大,在这个范围内 sin⁡θ\sin\theta sinθ 已经明显弯曲,切线近似不再成立。而无迹变换只用了 5 个点,就把均值几乎精确地算了出来,协方差也稳妥得多(略偏大,比低估安全)。

二、无迹变换的思路

无迹变换分三步:

  1. 选点。 从分布 N(μ, P)\mathcal{N}(\boldsymbol{\mu},\ \mathbf{P}) N(μ, P) 中按确定的规则挑选 2n+12n+1 2n+1 个点 χi \boldsymbol{\chi}_i χi( nn n 是状态维数),并给每个点配上权重,使得这组带权重的点恰好 具有均值 μ\boldsymbol{\mu} μ 和协方差 P\mathbf{P} P。
  2. 变换。 把每个点代入非线性函数: γi=g(χi) \boldsymbol{\gamma}_i = g(\boldsymbol{\chi}_i) γi=g(χi)。不做任何近似。
  3. 统计。 用同样的权重计算变换后点的加权均值和加权协方差,作为输出分布的近似。

它与蒙特卡洛的区别在于:点不是随机抽的,而是精心构造的,所以只需要 2n+12n+1 2n+1 个点(雷达例子中 n=4n = 4 n=4,只要 9 个点),而不是成千上万个。它与 EKF 的区别在于:不需要求导数,函数本身被精确地计算,近似发生在"用有限个点代表分布"这一步。

三、sigma 点与权重

1. 公式

本篇采用最常用的 van der Merwe 缩放 sigma 点。设状态维数为 nn n,先定义
λ=α2(n+κ)−n\lambda = \alpha^2(n + \kappa) - n λ=α2(n+κ)−n

再求矩阵平方根 L\mathbf{L} L,使 LL⊤=(n+λ)P\mathbf{L}\mathbf{L}^\top = (n + \lambda)\mathbf{P} LL⊤=(n+λ)P,记它的第 ii i 列为 li \mathbf{l}_i li。 2n+12n+1 2n+1 个 sigma 点为
  χ0=μ,χi=μ+li, χi+n =μ−li,i=1,...,n   \boxed{\; \boldsymbol{\chi}_0 = \boldsymbol{\mu}, \qquad \boldsymbol{\chi}_i = \boldsymbol{\mu} + \mathbf{l}i, \qquad \boldsymbol{\chi}{i+n} = \boldsymbol{\mu} - \mathbf{l}_i, \qquad i = 1, \dots, n \;} χ0=μ,χi=μ+li,χi+n=μ−li,i=1,...,n

即中心一个点,再沿 L\mathbf{L} L 的每一列方向对称地各放两个点。权重分两套, W(m)W^{(m)} W(m) 用于算均值, W(c)W^{(c)} W(c) 用于算协方差:
   W0(m) = λn+λ , W0(c) = λn+λ +(1−α2+β), Wi(m) = Wi(c) = 12(n+λ) , i=1,...,2n    \boxed{\; \begin{aligned} W_0^{(m)} &= \frac{\lambda}{n + \lambda}, & W_0^{(c)} &= \frac{\lambda}{n + \lambda} + (1 - \alpha^2 + \beta), \\ W_i^{(m)} &= W_i^{(c)} = \frac{1}{2(n + \lambda)}, & & i = 1, \dots, 2n \end{aligned} \;} W0(m)Wi(m)=n+λλ,=Wi(c)=2(n+λ)1,W0(c)=n+λλ+(1−α2+β),i=1,...,2n

两套权重只在中心点上不同。矩阵平方根通常用 Cholesky 分解计算(np.linalg.cholesky),它要求 P\mathbf{P} P 对称正定。

2. 参数的含义

参数 作用 常见取值
α\alpha α 控制 sigma 点离中心多远。点到中心的"距离"正比于 n+λ =α n+κ \sqrt{n + \lambda} = \alpha\sqrt{n + \kappa} n+λ =αn+κ 10−3≤α≤110^{-3} \le \alpha \le 1 10−3≤α≤1
κ\kappa κ 第二个缩放参数,和 α\alpha α 一起决定 λ\lambda λ 00 0 或 3−n3 - n 3−n
λ\lambda λ 由前两者算出,决定点的分布范围和中心点的权重 λ=α2(n+κ)−n\lambda = \alpha^2(n+\kappa) - n λ=α2(n+κ)−n
β\beta β 只出现在 W0(c) W_0^{(c)} W0(c) 中,用来补偿分布的高阶矩(四阶项),把"先验分布是高斯"的信息加进来 高斯分布取 β=2\beta = 2 β=2

α\alpha α 很小时,所有点挤在中心附近,只"看到"函数的局部,此时 λ≈−n\lambda \approx -n λ≈−n,中心点会得到很大的负权重。 α=1\alpha = 1 α=1、 κ=0\kappa = 0 κ=0 时 λ=0\lambda = 0 λ=0,点分布在 ±n \pm\sqrt{n} ±n 个标准差处,所有权重都非负,数值上最稳妥。本篇统一使用 α=1\alpha = 1 α=1、 β=2\beta = 2 β=2、 κ=0\kappa = 0 κ=0,此时
λ=0, W0(m) =0, W0(c) =2, Wi(m) = Wi(c) = 12n \lambda = 0, \qquad W_0^{(m)} = 0, \qquad W_0^{(c)} = 2, \qquad W_i^{(m)} = W_i^{(c)} = \frac{1}{2n} λ=0,W0(m)=0,W0(c)=2,Wi(m)=Wi(c)=2n1

中心点不参与均值的计算,但在协方差里有权重 2。

3. 例子:香蕉形分布的 5 个 sigma 点

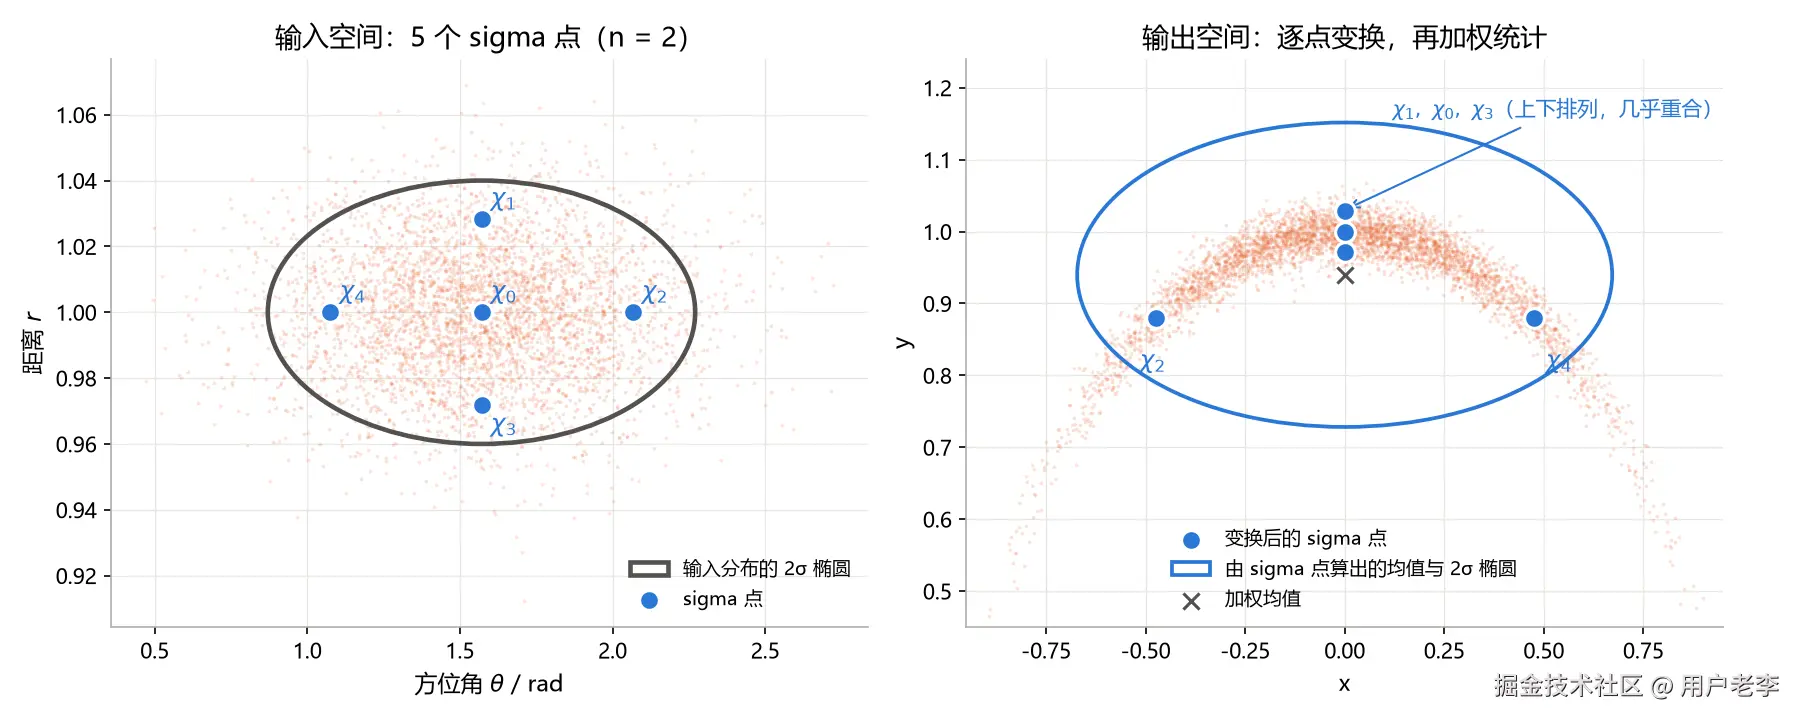
输入是 (r,θ)(r, \theta) (r,θ), n=2n = 2 n=2, μ=(1, π/2)\boldsymbol{\mu} = (1,\ \pi/2) μ=(1, π/2), P=diag⁡(0.022, 0.352)\mathbf{P} = \operatorname{diag}(0.02^2,\ 0.35^2) P=diag(0.022, 0.352)。 P\mathbf{P} P 是对角阵,所以 L=2diag⁡(0.02, 0.35)=diag⁡(0.0283, 0.4950) \mathbf{L} = \sqrt{2}\operatorname{diag}(0.02,\ 0.35) = \operatorname{diag}(0.0283,\ 0.4950) L=2 diag(0.02, 0.35)=diag(0.0283, 0.4950)。5 个点及其变换结果:

点 (r, θ)(r,\ \theta) (r, θ) (x, y)=(rcos⁡θ, rsin⁡θ)(x,\ y) = (r\cos\theta,\ r\sin\theta) (x, y)=(rcosθ, rsinθ) W(m)W^{(m)} W(m) W(c)W^{(c)} W(c)
χ0 \boldsymbol{\chi}_0 χ0 (1, 1.5708)(1,\ 1.5708) (1, 1.5708) (0, 1)(0,\ 1) (0, 1) 0 2
χ1 \boldsymbol{\chi}_1 χ1 (1.0283, 1.5708)(1.0283,\ 1.5708) (1.0283, 1.5708) (0, 1.0283)(0,\ 1.0283) (0, 1.0283) 0.25 0.25
χ2 \boldsymbol{\chi}_2 χ2 (1, 2.0658)(1,\ 2.0658) (1, 2.0658) (−0.475, 0.88)(-0.475,\ 0.88) (−0.475, 0.88) 0.25 0.25
χ3 \boldsymbol{\chi}_3 χ3 (0.9717, 1.5708)(0.9717,\ 1.5708) (0.9717, 1.5708) (0, 0.9717)(0,\ 0.9717) (0, 0.9717) 0.25 0.25
χ4 \boldsymbol{\chi}_4 χ4 (1, 1.0758)(1,\ 1.0758) (1, 1.0758) (0.475, 0.88)(0.475,\ 0.88) (0.475, 0.88) 0.25 0.25

加权均值的 yy y 分量为
0.25×(1.0283+0.88+0.9717+0.88)=0.25×3.76=0.940.25 \times (1.0283 + 0.88 + 0.9717 + 0.88) = 0.25 \times 3.76 = 0.94 0.25×(1.0283+0.88+0.9717+0.88)=0.25×3.76=0.94

与真实值 0.94060.9406 0.9406 几乎相同。关键在于 χ2 \boldsymbol{\chi}_2 χ2 和 χ4 \boldsymbol{\chi}_4 χ4:它们沿着圆弧落到了 y=0.88y = 0.88 y=0.88,把"弯曲"这个信息带进了统计结果,而切线做不到这一点。

图 2:左图是输入空间 (θ,r)(\theta, r) (θ,r) 中的 5 个 sigma 点和输入分布的 2σ 椭圆;右图是它们变换到直角坐标后的位置,以及由这 5 个点加权算出的均值(×)和 2σ 椭圆。

四、证明:sigma 点精确保持均值和协方差

记 c=n+λc = n + \lambda c=n+λ,则 Wi= 12c W_i = \dfrac{1}{2c} Wi=2c1( i≥1i \ge 1 i≥1), W0(m) = λc W_0^{(m)} = \dfrac{\lambda}{c} W0(m)=cλ。

1. 均值权重之和为 1

∑i=02n Wi(m) =λc+2n⋅ 12c = λ+nc =1 \sum_{i=0}^{2n} W_i^{(m)} = \frac{\lambda}{c} + 2n \cdot \frac{1}{2c} = \frac{\lambda + n}{c} = 1 i=0∑2nWi(m)=cλ+2n⋅2c1=cλ+n=1

2. 加权均值等于 μ\boldsymbol{\mu} μ

把成对的点放在一起:
∑i=02n Wi(m) χi = W0(m) μ+ ∑i=1n 12c (μ+li)+(μ−li) = W0(m) μ+ ∑i=1n 1cμ= (λc+nc) μ=μ \begin{aligned} \sum_{i=0}^{2n} W_i^{(m)}\boldsymbol{\chi}i &= W_0^{(m)}\boldsymbol{\mu} + \sum{i=1}^{n} \frac{1}{2c}\Bigl(\\boldsymbol{\\mu} + \\mathbf{l}_i) + (\\boldsymbol{\\mu} - \\mathbf{l}_i)\\Bigr \\ &= W_0^{(m)}\boldsymbol{\mu} + \sum_{i=1}^{n}\frac{1}{c}\boldsymbol{\mu} = \left(\frac{\lambda}{c} + \frac{n}{c}\right)\boldsymbol{\mu} = \boldsymbol{\mu} \end{aligned} i=0∑2nWi(m)χi=W0(m)μ+i=1∑n2c1(μ+li)+(μ−li)=W0(m)μ+i=1∑nc1μ=(cλ+cn)μ=μ

±li \pm\mathbf{l}_i ±li 两两抵消,这就是对称放点的好处。

3. 加权协方差等于 P\mathbf{P} P

中心点满足 χ0−μ=0 \boldsymbol{\chi}0 - \boldsymbol{\mu} = \mathbf{0} χ0−μ=0,无论 W0(c) W_0^{(c)} W0(c) 取多少都不贡献。其余点满足 χi−μ=li \boldsymbol{\chi}{i} - \boldsymbol{\mu} = \mathbf{l}i χi−μ=li、 χi+n −μ=−li \boldsymbol{\chi}{i+n} - \boldsymbol{\mu} = -\mathbf{l}i χi+n−μ=−li,所以
∑i=02n Wi(c) (χi−μ)(χi−μ)⊤ = ∑i=1n 12c lili⊤+(−li)(−li)⊤=1c ∑i=1n lili⊤ \begin{aligned} \sum
{i=0}^{2n} W_i^{(c)}(\boldsymbol{\chi}i - \boldsymbol{\mu})(\boldsymbol{\chi}i - \boldsymbol{\mu})^\top &= \sum{i=1}^{n}\frac{1}{2c}\Bigl\\mathbf{l}_i\\mathbf{l}_i\^\\top + (-\\mathbf{l}_i)(-\\mathbf{l}_i)\^\\top\\Bigr = \frac{1}{c}\sum{i=1}^{n}\mathbf{l}_i\mathbf{l}_i^\top \end{aligned} i=0∑2nWi(c)(χi−μ)(χi−μ)⊤=i=1∑n2c1lili⊤+(−li)(−li)⊤=c1i=1∑nlili⊤

而 ∑i=1n lili⊤ \displaystyle\sum_{i=1}^{n}\mathbf{l}_i\mathbf{l}_i^\top i=1∑nlili⊤ 正是 LL⊤\mathbf{L}\mathbf{L}^\top LL⊤ 按列展开的写法(矩阵乘法的"外积形式": LL⊤=∑ilili⊤ \mathbf{L}\mathbf{L}^\top = \sum_i \mathbf{l}_i\mathbf{l}i^\top LL⊤=∑ilili⊤),等于 c Pc\,\mathbf{P} cP。因此
   ∑i=02n Wi(c) (χi−μ)(χi−μ)⊤=1c⋅c P=P   \boxed{\;\sum
{i=0}^{2n} W_i^{(c)}(\boldsymbol{\chi}_i - \boldsymbol{\mu})(\boldsymbol{\chi}_i - \boldsymbol{\mu})^\top = \frac{1}{c}\cdot c\,\mathbf{P} = \mathbf{P}\;} i=0∑2nWi(c)(χi−μ)(χi−μ)⊤=c1⋅cP=P

推论: 当 gg g 是线性(仿射)函数 g(x)=Ax+bg(\mathbf{x}) = \mathbf{A}\mathbf{x} + \mathbf{b} g(x)=Ax+b 时,变换后的点 Aχi+b \mathbf{A}\boldsymbol{\chi}_i + \mathbf{b} Aχi+b 的加权均值是 Aμ+b\mathbf{A}\boldsymbol{\mu} + \mathbf{b} Aμ+b,加权协方差是 APA⊤\mathbf{A}\mathbf{P}\mathbf{A}^\top APA⊤(直接代入上面两式即得),与精确结果完全相同。所以对线性系统,UKF 与卡尔曼滤波给出完全一样的结果。

五、无迹变换对非线性函数的精度

1. 均值精确到二阶

设 x=μ+δ\mathbf{x} = \boldsymbol{\mu} + \boldsymbol{\delta} x=μ+δ, δ∼N(0,P)\boldsymbol{\delta} \sim \mathcal{N}(\mathbf{0}, \mathbf{P}) δ∼N(0,P)。考虑输出的某一个分量 gj g_j gj(为简洁省略下标 jj j),把它在 μ\boldsymbol{\mu} μ 处做泰勒展开(第 09 篇第三节):
g(μ+δ)=g(μ)+∇g⊤δ+12δ⊤Gδ+T3(δ)+T4(δ)+⋯g(\boldsymbol{\mu} + \boldsymbol{\delta}) = g(\boldsymbol{\mu}) + \nabla g^\top\boldsymbol{\delta} + \frac{1}{2}\boldsymbol{\delta}^\top\mathbf{G}\boldsymbol{\delta} + T_3(\boldsymbol{\delta}) + T_4(\boldsymbol{\delta}) + \cdots g(μ+δ)=g(μ)+∇g⊤δ+21δ⊤Gδ+T3(δ)+T4(δ)+⋯

其中 G=∇2g(μ)\mathbf{G} = \nabla^2 g(\boldsymbol{\mu}) G=∇2g(μ) 是黑塞矩阵, Tk(δ) T_k(\boldsymbol{\delta}) Tk(δ) 表示关于 δ\boldsymbol{\delta} δ 的 kk k 次齐次项,满足 Tk(−δ)=(−1)kTk(δ) T_k(-\boldsymbol{\delta}) = (-1)^k T_k(\boldsymbol{\delta}) Tk(−δ)=(−1)kTk(δ)。

真实均值。 高斯分布关于均值对称,所有奇数阶项的期望为零。再用 Eδ⊤Gδ=Etr⁡(Gδδ⊤)=tr⁡(GP)E\\boldsymbol{\\delta}\^\\top\\mathbf{G}\\boldsymbol{\\delta} = E\\operatorname{tr}(\\mathbf{G}\\boldsymbol{\\delta}\\boldsymbol{\\delta}\^\\top) = \operatorname{tr}(\mathbf{G}\mathbf{P}) Eδ⊤Gδ=Etr(Gδδ⊤)=tr(GP):
Eg(x)=g(μ)+12tr⁡(GP)+ET4(δ)+⋯Eg(\\mathbf{x}) = g(\boldsymbol{\mu}) + \frac{1}{2}\operatorname{tr}(\mathbf{G}\mathbf{P}) + ET_4(\\boldsymbol{\\delta}) + \cdots Eg(x)=g(μ)+21tr(GP)+ET4(δ)+⋯

EKF 的均值 只有第一项 g(μ)g(\boldsymbol{\mu}) g(μ),在二阶项上就已经出错了,误差为 12tr⁡(GP) \frac{1}{2}\operatorname{tr}(\mathbf{G}\mathbf{P}) 21tr(GP)。第 09 篇一维例子 g(x)=x2g(x) = x^2 g(x)=x2 中, G=2\mathbf{G} = 2 G=2,误差 =12⋅2⋅σ2=σ2=0.16 = \frac{1}{2} \cdot 2 \cdot \sigma^2 = \sigma^2 = 0.16 =21⋅2⋅σ2=σ2=0.16,与当时算出的结果一致。

无迹变换的均值。 对每一对点 μ±li \boldsymbol{\mu} \pm \mathbf{l}_i μ±li,奇数阶项正负抵消:
g(μ+li)+g(μ−li)=2g(μ)+li⊤Gli+2T4(li)+⋯ g(\boldsymbol{\mu} + \mathbf{l}_i) + g(\boldsymbol{\mu} - \mathbf{l}_i) = 2g(\boldsymbol{\mu}) + \mathbf{l}_i^\top\mathbf{G}\mathbf{l}_i + 2T_4(\mathbf{l}_i) + \cdots g(μ+li)+g(μ−li)=2g(μ)+li⊤Gli+2T4(li)+⋯

于是
∑i=02n Wi(m) g(χi) = W0(m) g(μ)+ 12c ∑i=1n 2g(μ)+li⊤Gli+2T4(li)+⋯  = ( W0(m) +nc) ⏟ = 1 g(μ)+ 12c ∑i=1n li⊤Gli+1c ∑i=1n T4(li)+⋯ \begin{aligned} \sum_{i=0}^{2n} W_i^{(m)} g(\boldsymbol{\chi}i) &= W_0^{(m)} g(\boldsymbol{\mu}) + \frac{1}{2c}\sum{i=1}^{n}\Bigl2g(\\boldsymbol{\\mu}) + \\mathbf{l}_i\^\\top\\mathbf{G}\\mathbf{l}_i + 2T_4(\\mathbf{l}_i) + \\cdots\\Bigr \\ &= \underbrace{\left(W_0^{(m)} + \frac{n}{c}\right)}{=\,1} g(\boldsymbol{\mu}) + \frac{1}{2c}\sum{i=1}^{n}\mathbf{l}_i^\top\mathbf{G}\mathbf{l}i + \frac{1}{c}\sum{i=1}^{n}T_4(\mathbf{l}_i) + \cdots \end{aligned} i=0∑2nWi(m)g(χi)=W0(m)g(μ)+2c1i=1∑n2g(μ)+li⊤Gli+2T4(li)+⋯==1 (W0(m)+cn)g(μ)+2c1i=1∑nli⊤Gli+c1i=1∑nT4(li)+⋯

中间一项利用 li⊤Gli=tr⁡(Glili⊤) \mathbf{l}_i^\top\mathbf{G}\mathbf{l}_i = \operatorname{tr}(\mathbf{G}\mathbf{l}_i\mathbf{l}i^\top) li⊤Gli=tr(Glili⊤):
12c ∑i=1n tr⁡(Glili⊤)= 12c tr⁡(G ∑i=1n lili⊤)= 12c tr⁡(G⋅c P)=12tr⁡(GP) \frac{1}{2c}\sum
{i=1}^{n}\operatorname{tr}(\mathbf{G}\mathbf{l}_i\mathbf{l}i^\top) = \frac{1}{2c}\operatorname{tr}\Bigl(\mathbf{G}\sum{i=1}^{n}\mathbf{l}_i\mathbf{l}_i^\top\Bigr) = \frac{1}{2c}\operatorname{tr}(\mathbf{G}\cdot c\,\mathbf{P}) = \frac{1}{2}\operatorname{tr}(\mathbf{G}\mathbf{P}) 2c1i=1∑ntr(Glili⊤)=2c1tr(Gi=1∑nlili⊤)=2c1tr(G⋅cP)=21tr(GP)

所以
  ∑i Wi(m) g(χi)=g(μ)+12tr⁡(GP)+ 1c ∑i=1n T4(li)+⋯ ⏟ 四阶及以上    \boxed{\;\sum_{i} W_i^{(m)} g(\boldsymbol{\chi}i) = g(\boldsymbol{\mu}) + \frac{1}{2}\operatorname{tr}(\mathbf{G}\mathbf{P}) + \underbrace{\frac{1}{c}\sum{i=1}^{n}T_4(\mathbf{l}i) + \cdots}{\text{四阶及以上}}\;} i∑Wi(m)g(χi)=g(μ)+21tr(GP)+四阶及以上 c1i=1∑nT4(li)+⋯

与真实均值相比,前两阶完全相同,误差从四阶项才开始 。这就是"无迹变换精确到二阶"的含义。特别地,如果 gg g 是二次函数(三阶及以上导数为零),无迹变换给出的均值是精确的,与参数取值无关。

2. 协方差的主项精确

记真实均值为 yˉ \bar{\mathbf{y}} yˉ。由上一小节, yˉ−g(μ)=12tr⁡(GP)+⋯ \bar{\mathbf{y}} - g(\boldsymbol{\mu}) = \frac{1}{2}\operatorname{tr}(\mathbf{G}\mathbf{P}) + \cdots yˉ−g(μ)=21tr(GP)+⋯ 是二阶小量。对向量函数 gg g,记雅可比为 J\mathbf{J} J,每个 sigma 点与均值之差为
g(μ±li)−yˉ=±Jli+(二阶项)+⋯ g(\boldsymbol{\mu} \pm \mathbf{l}_i) - \bar{\mathbf{y}} = \pm\mathbf{J}\mathbf{l}_i + (\text{二阶项}) + \cdots g(μ±li)−yˉ=±Jli+(二阶项)+⋯

代入加权协方差。一阶项乘一阶项给出
∑i=1n 12c (Jli)(Jli)⊤+(−Jli)(−Jli)⊤=1cJ(∑ilili⊤)J⊤=JPJ⊤ \sum_{i=1}^{n}\frac{1}{2c}\Bigl(\\mathbf{J}\\mathbf{l}_i)(\\mathbf{J}\\mathbf{l}_i)\^\\top + (-\\mathbf{J}\\mathbf{l}_i)(-\\mathbf{J}\\mathbf{l}_i)\^\\top\\Bigr = \frac{1}{c}\mathbf{J}\Bigl(\sum_{i}\mathbf{l}_i\mathbf{l}_i^\top\Bigr)\mathbf{J}^\top = \mathbf{J}\mathbf{P}\mathbf{J}^\top i=1∑n2c1(Jli)(Jli)⊤+(−Jli)(−Jli)⊤=c1J(i∑lili⊤)J⊤=JPJ⊤

一阶项乘二阶项的交叉项在 +li +\mathbf{l}_i +li 和 −li -\mathbf{l}_i −li 之间符号相反、互相抵消;中心点的贡献 W0(c) (g(μ)−yˉ)(⋅)⊤ W_0^{(c)}\bigl(g(\boldsymbol{\mu}) - \bar{\mathbf{y}}\bigr)\bigl(\cdot\bigr)^\top W0(c)(g(μ)−yˉ)(⋅)⊤ 是二阶量的平方,属于四阶项。所以:

  • 协方差的主项 JPJ⊤\mathbf{J}\mathbf{P}\mathbf{J}^\top JPJ⊤ 被精确得到(这也是 EKF 唯一能得到的那一项);
  • 剩下的误差都在四阶项里,而 β\beta β 正是通过 W0(c) W_0^{(c)} W0(c) 来调节四阶项的。

与 EKF 相比,UKF 的协方差包含了一部分高阶修正;更重要的是,它的均值准确到二阶,协方差是围绕更准的均值计算的。

3. 一个完整的例子: g(x)=x2g(x) = x^2 g(x)=x2 与 β = 2 的来历

还是第 09 篇的一维例子: x∼N(μ,σ2)x \sim \mathcal{N}(\mu, \sigma^2) x∼N(μ,σ2), g(x)=x2g(x) = x^2 g(x)=x2,精确结果为 Ey=μ2+σ2Ey = \mu^2 + \sigma^2 Ey=μ2+σ2, Var⁡y=4μ2σ2+2σ4\operatorname{Var}y = 4\mu^2\sigma^2 + 2\sigma^4 Vary=4μ2σ2+2σ4。

n=1n = 1 n=1 时,记 c=1+λc = 1 + \lambda c=1+λ, s=c σ s = \sqrt{c}\,\sigma s=c σ。三个 sigma 点为 μ\mu μ、 μ±s\mu \pm s μ±s,权重 W0(m) =λ/c W_0^{(m)} = \lambda/c W0(m)=λ/c, W1=W2= 12c W_1 = W_2 = \dfrac{1}{2c} W1=W2=2c1, W0(c) =λ/c+γ W_0^{(c)} = \lambda/c + \gamma W0(c)=λ/c+γ,其中记 γ=1−α2+β\gamma = 1 - \alpha^2 + \beta γ=1−α2+β。

均值(由上一小节的结论,二次函数一定精确,这里验证一遍):
λcμ2+ 12c (μ+s)2+(μ−s)2=λcμ2+1c(μ2+s2)=μ2+s2c=μ2+σ2✓ \frac{\lambda}{c}\mu^2 + \frac{1}{2c}\Bigl(\\mu + s)\^2 + (\\mu - s)\^2\\Bigr = \frac{\lambda}{c}\mu^2 + \frac{1}{c}(\mu^2 + s^2) = \mu^2 + \frac{s^2}{c} = \mu^2 + \sigma^2 \quad \checkmark cλμ2+2c1(μ+s)2+(μ−s)2=cλμ2+c1(μ2+s2)=μ2+cs2=μ2+σ2✓

方差。 记 yˉ=μ2+σ2 \bar{y} = \mu^2 + \sigma^2 yˉ=μ2+σ2。三个点的偏差为
μ2−yˉ=−σ2,(μ±s)2−yˉ=±2μs+(s2−σ2) \mu^2 - \bar{y} = -\sigma^2, \qquad (\mu \pm s)^2 - \bar{y} = \pm 2\mu s + (s^2 - \sigma^2) μ2−yˉ=−σ2,(μ±s)2−yˉ=±2μs+(s2−σ2)

所以
Var⁡UT = W0(c) σ4+ 12c (2μs+(s2−σ2))2+(−2μs+(s2−σ2))2 = W0(c) σ4+ 12c 8μ2s2+2(s2−σ2)2 \begin{aligned} \operatorname{Var}_{\text{UT}} &= W_0^{(c)}\sigma^4 + \frac{1}{2c}\Bigl\\bigl(2\\mu s + (s\^2 - \\sigma\^2)\\bigr)\^2 + \\bigl(-2\\mu s + (s\^2 - \\sigma\^2)\\bigr)\^2\\Bigr \\ &= W_0^{(c)}\sigma^4 + \frac{1}{2c}\Bigl8\\mu\^2 s\^2 + 2(s\^2 - \\sigma\^2)\^2\\Bigr \end{aligned} VarUT=W0(c)σ4+2c1(2μs+(s2−σ2))2+(−2μs+(s2−σ2))2=W0(c)σ4+2c18μ2s2+2(s2−σ2)2

代入 s2=cσ2s^2 = c\sigma^2 s2=cσ2:第一部分 8μ2cσ22c =4μ2σ2 \dfrac{8\mu^2 c\sigma^2}{2c} = 4\mu^2\sigma^2 2c8μ2cσ2=4μ2σ2;第二部分 (cσ2−σ2)2c = (c−1)2c σ4 \dfrac{(c\sigma^2 - \sigma^2)^2}{c} = \dfrac{(c-1)^2}{c}\sigma^4 c(cσ2−σ2)2=c(c−1)2σ4;再加上 W0(c) σ4= ( c−1c +γ) σ4 W_0^{(c)}\sigma^4 = \left(\dfrac{c-1}{c} + \gamma\right)\sigma^4 W0(c)σ4=(cc−1+γ)σ4(因为 λ=c−1\lambda = c - 1 λ=c−1)。合并 σ4\sigma^4 σ4 的系数:
c−1c +γ+ (c−1)2c = (c−1)(1+c−1)c +γ=(c−1)+γ \frac{c-1}{c} + \gamma + \frac{(c-1)^2}{c} = \frac{(c-1)(1 + c - 1)}{c} + \gamma = (c - 1) + \gamma cc−1+γ+c(c−1)2=c(c−1)(1+c−1)+γ=(c−1)+γ

于是
Var⁡UT =4μ2σ2+(c−1+γ) σ4 \operatorname{Var}_{\text{UT}} = 4\mu^2\sigma^2 + (c - 1 + \gamma)\,\sigma^4 VarUT=4μ2σ2+(c−1+γ)σ4

要与精确值 4μ2σ2+2σ44\mu^2\sigma^2 + 2\sigma^4 4μ2σ2+2σ4 相等,需要 c−1+γ=2c - 1 + \gamma = 2 c−1+γ=2。代入 c=α2(1+κ)c = \alpha^2(1 + \kappa) c=α2(1+κ) 和 γ=1−α2+β\gamma = 1 - \alpha^2 + \beta γ=1−α2+β:
α2(1+κ)−1+1−α2+β=2  ⟹     β=2−α2κ   \alpha^2(1 + \kappa) - 1 + 1 - \alpha^2 + \beta = 2 \;\Longrightarrow\; \boxed{\;\beta = 2 - \alpha^2\kappa\;} α2(1+κ)−1+1−α2+β=2⟹β=2−α2κ

这给出了 β 的直观来历:当 κ=0\kappa = 0 κ=0 时,无论 α\alpha α 取多少, β=2\beta = 2 β=2 都能让这个例子的方差精确。 高斯分布的四阶矩 Eδ4=3σ4E\\delta\^4 = 3\sigma^4 Eδ4=3σ4,β = 2 正是在补偿这一项。用代码验证( μ=1\mu = 1 μ=1, σ=0.4\sigma = 0.4 σ=0.4,精确值:均值 1.16,方差 0.6912):

α\alpha α β\beta β κ\kappa κ sigma 点 W(m)W^{(m)} W(m) 均值 方差
1 2 0 1, 1.4, 0.6 0, 0.5, 0.5 1.1600 0.6912
1 0 2 1, 1.6928, 0.3072 0.667, 0.167, 0.167 1.1600 0.6912
1 2 2 1, 1.6928, 0.3072 0.667, 0.167, 0.167 1.1600 0.7424
0.1 2 0 1, 1.04, 0.96 −99, 50, 50 1.1600 0.6912

前两行和最后一行满足 β=2−α2κ\beta = 2 - \alpha^2\kappa β=2−α2κ,方差精确;第三行不满足(应取 β=0\beta = 0 β=0),方差偏大。最后一行 α=0.1\alpha = 0.1 α=0.1 时中心点的均值权重是 −99-99 −99,结果依然精确,但大的负权重在多维、非二次函数时容易让协方差失去正定性,这也是本篇选用 α=1\alpha = 1 α=1 的原因。

六、UKF 算法

1. 更新公式的来源:线性最小均方误差估计

UKF 的更新步不再有 H\mathbf{H} H 矩阵,需要换一种写法。先证明一个一般结论。

定理。 设随机向量 x\mathbf{x} x、 z\mathbf{z} z 的均值分别为 xˉ \bar{\mathbf{x}} xˉ、 zˉ \bar{\mathbf{z}} zˉ,协方差和互协方差为
Pxx =E(x−xˉ)(x−xˉ)⊤, Pzz =E(z−zˉ)(z−zˉ)⊤, Pxz =E(x−xˉ)(z−zˉ)⊤ \mathbf{P}{xx} = E(\\mathbf{x} - \\bar{\\mathbf{x}})(\\mathbf{x} - \\bar{\\mathbf{x}})\^\\top,\quad \mathbf{P}{zz} = E(\\mathbf{z} - \\bar{\\mathbf{z}})(\\mathbf{z} - \\bar{\\mathbf{z}})\^\\top,\quad \mathbf{P}_{xz} = E(\\mathbf{x} - \\bar{\\mathbf{x}})(\\mathbf{z} - \\bar{\\mathbf{z}})\^\\top Pxx=E(x−xˉ)(x−xˉ)⊤,Pzz=E(z−zˉ)(z−zˉ)⊤,Pxz=E(x−xˉ)(z−zˉ)⊤

在所有形如 x^=a+Bz \hat{\mathbf{x}} = \mathbf{a} + \mathbf{B}\mathbf{z} x^=a+Bz 的线性估计中,使误差协方差最小的是
x^=xˉ+ Pxz Pzz−1 (z−zˉ),P= Pxx − Pxz Pzz−1 Pxz⊤ \hat{\mathbf{x}} = \bar{\mathbf{x}} + \mathbf{P}{xz}\mathbf{P}{zz}^{-1}(\mathbf{z} - \bar{\mathbf{z}}), \qquad \mathbf{P} = \mathbf{P}{xx} - \mathbf{P}{xz}\mathbf{P}{zz}^{-1}\mathbf{P}{xz}^\top x^=xˉ+PxzPzz−1(z−zˉ),P=Pxx−PxzPzz−1Pxz⊤

证明。 先要求无偏: Ex−x\^=xˉ−a−Bzˉ=0 E\\mathbf{x} - \\hat{\\mathbf{x}} = \bar{\mathbf{x}} - \mathbf{a} - \mathbf{B}\bar{\mathbf{z}} = \mathbf{0} Ex−x\^=xˉ−a−Bzˉ=0,得 a=xˉ−Bzˉ \mathbf{a} = \bar{\mathbf{x}} - \mathbf{B}\bar{\mathbf{z}} a=xˉ−Bzˉ。于是误差为
e=x−x^=(x−xˉ)−B(z−zˉ) \mathbf{e} = \mathbf{x} - \hat{\mathbf{x}} = (\mathbf{x} - \bar{\mathbf{x}}) - \mathbf{B}(\mathbf{z} - \bar{\mathbf{z}}) e=x−x^=(x−xˉ)−B(z−zˉ)

其协方差为
Eee⊤= Pxx −B Pxz⊤ − Pxz B⊤+B Pzz B⊤E\\mathbf{e}\\mathbf{e}\^\\top = \mathbf{P}{xx} - \mathbf{B}\mathbf{P}{xz}^\top - \mathbf{P}{xz}\mathbf{B}^\top + \mathbf{B}\mathbf{P}{zz}\mathbf{B}^\top Eee⊤=Pxx−BPxz⊤−PxzB⊤+BPzzB⊤

对 B\mathbf{B} B "配方"。记 B∗= Pxz Pzz−1 \mathbf{B}^* = \mathbf{P}{xz}\mathbf{P}{zz}^{-1} B∗=PxzPzz−1,可以直接展开验证
(B−B∗) Pzz (B−B∗)⊤=B Pzz B⊤−B Pxz⊤ − Pxz B⊤+ Pxz Pzz−1 Pxz⊤ (\mathbf{B} - \mathbf{B}^*)\mathbf{P}{zz}(\mathbf{B} - \mathbf{B}^*)^\top = \mathbf{B}\mathbf{P}{zz}\mathbf{B}^\top - \mathbf{B}\mathbf{P}{xz}^\top - \mathbf{P}{xz}\mathbf{B}^\top + \mathbf{P}{xz}\mathbf{P}{zz}^{-1}\mathbf{P}_{xz}^\top (B−B∗)Pzz(B−B∗)⊤=BPzzB⊤−BPxz⊤−PxzB⊤+PxzPzz−1Pxz⊤

(展开时用到 Pzz \mathbf{P}{zz} Pzz 对称, B∗ Pzz = Pxz \mathbf{B}^*\mathbf{P}{zz} = \mathbf{P}{xz} B∗Pzz=Pxz, B∗ Pzz B∗⊤= Pxz Pzz−1 Pxz⊤ \mathbf{B}^*\mathbf{P}{zz}\mathbf{B}^{*\top} = \mathbf{P}{xz}\mathbf{P}{zz}^{-1}\mathbf{P}{xz}^\top B∗PzzB∗⊤=PxzPzz−1Pxz⊤。)对比两式得
Eee⊤= (B−B∗) Pzz (B−B∗)⊤⏟ 半正定 + Pxx − Pxz Pzz−1 Pxz⊤ E\\mathbf{e}\\mathbf{e}\^\\top = \underbrace{(\mathbf{B} - \mathbf{B}^*)\mathbf{P}
{zz}(\mathbf{B} - \mathbf{B}^*)^\top}{\text{半正定}} + \mathbf{P}{xx} - \mathbf{P}{xz}\mathbf{P}{zz}^{-1}\mathbf{P}_{xz}^\top Eee⊤=半正定 (B−B∗)Pzz(B−B∗)⊤+Pxx−PxzPzz−1Pxz⊤

第一项是半正定矩阵,当且仅当 B=B∗\mathbf{B} = \mathbf{B}^* B=B∗ 时为零;第二部分与 B\mathbf{B} B 无关。所以 B=B∗\mathbf{B} = \mathbf{B}^* B=B∗ 时误差协方差在矩阵意义下最小(任何方向上的误差方差都最小,当然迹也最小)。 ■\blacksquare ■

用到滤波上。 在第 kk k 步, x\mathbf{x} x 的"先验均值"是 x^k∣k−1 \hat{\mathbf{x}}{k\mid k-1} x^k∣k−1, Pxx = Pk∣k−1 \mathbf{P}{xx} = \mathbf{P}_{k\mid k-1} Pxx=Pk∣k−1, zˉ \bar{\mathbf{z}} zˉ 是预测测量 z^k \hat{\mathbf{z}}k z^k, Pzz \mathbf{P}{zz} Pzz 就是新息协方差 Sk \mathbf{S}k Sk。定理直接给出
Kk= Pxz Sk−1 , x^k∣k = x^k∣k−1 +Kk(zk− z^k ), Pk∣k = Pk∣k−1 −KkSkKk⊤ \mathbf{K}k = \mathbf{P}{xz}\mathbf{S}k^{-1}, \qquad \hat{\mathbf{x}}{k\mid k} = \hat{\mathbf{x}}
{k\mid k-1} + \mathbf{K}_k(\mathbf{z}k - \hat{\mathbf{z}}k), \qquad \mathbf{P}{k\mid k} = \mathbf{P}{k\mid k-1} - \mathbf{K}_k\mathbf{S}_k\mathbf{K}_k^\top Kk=PxzSk−1,x^k∣k=x^k∣k−1+Kk(zk−z^k),Pk∣k=Pk∣k−1−KkSkKk⊤

最后一式用了 KkSkKk⊤= Pxz Sk−1 Sk Sk−1 Pxz⊤ = Pxz Sk−1 Pxz⊤ \mathbf{K}_k\mathbf{S}_k\mathbf{K}k^\top = \mathbf{P}{xz}\mathbf{S}_k^{-1}\mathbf{S}k\mathbf{S}k^{-1}\mathbf{P}{xz}^\top = \mathbf{P}{xz}\mathbf{S}k^{-1}\mathbf{P}{xz}^\top KkSkKk⊤=PxzSk−1SkSk−1Pxz⊤=PxzSk−1Pxz⊤。

检验:线性情况下退化为卡尔曼滤波。 若 z=Hx+v\mathbf{z} = \mathbf{H}\mathbf{x} + \mathbf{v} z=Hx+v,则 z^=H x^k∣k−1 \hat{\mathbf{z}} = \mathbf{H}\hat{\mathbf{x}}{k\mid k-1} z^=Hx^k∣k−1,且
Pxz =E(x− x\^k∣k−1 )(H(x− x\^k∣k−1 )+v)⊤= Pk∣k−1 H⊤,Sk=H Pk∣k−1 H⊤+R \mathbf{P}
{xz} = E\bigl(\\mathbf{x} - \\hat{\\mathbf{x}}_{k\\mid k-1})\\bigl(\\mathbf{H}(\\mathbf{x} - \\hat{\\mathbf{x}}_{k\\mid k-1}) + \\mathbf{v}\\bigr)\^\\top\\bigr = \mathbf{P}_{k\mid k-1}\mathbf{H}^\top, \qquad \mathbf{S}k = \mathbf{H}\mathbf{P}{k\mid k-1}\mathbf{H}^\top + \mathbf{R} Pxz=E(x−x\^k∣k−1)(H(x−x\^k∣k−1)+v)⊤=Pk∣k−1H⊤,Sk=HPk∣k−1H⊤+R

于是 Kk= Pk∣k−1 H⊤ Sk−1 \mathbf{K}k = \mathbf{P}{k\mid k-1}\mathbf{H}^\top\mathbf{S}_k^{-1} Kk=Pk∣k−1H⊤Sk−1,与第 05 篇完全一致;并且 KkSkKk⊤= Pk∣k−1 H⊤Kk⊤=(KkH Pk∣k−1 )⊤=KkH Pk∣k−1 \mathbf{K}_k\mathbf{S}_k\mathbf{K}k^\top = \mathbf{P}{k\mid k-1}\mathbf{H}^\top\mathbf{K}k^\top = (\mathbf{K}k\mathbf{H}\mathbf{P}{k\mid k-1})^\top = \mathbf{K}k\mathbf{H}\mathbf{P}{k\mid k-1} KkSkKk⊤=Pk∣k−1H⊤Kk⊤=(KkHPk∣k−1)⊤=KkHPk∣k−1(对称矩阵),所以 Pk∣k =(I−KkH) Pk∣k−1 \mathbf{P}{k\mid k} = (\mathbf{I} - \mathbf{K}k\mathbf{H})\mathbf{P}{k\mid k-1} Pk∣k=(I−KkH)Pk∣k−1,也与第 05 篇一致。

UKF 的思路由此就清楚了:更新公式本身是精确的线性最小均方误差公式,UKF 只是用无迹变换去近似其中的 z^ \hat{\mathbf{z}} z^、 S\mathbf{S} S、 Pxz \mathbf{P}_{xz} Pxz;EKF 则是用线性化去近似它们。

2. 完整算法

给定 x^0∣0 \hat{\mathbf{x}}{0\mid 0} x^0∣0、 P0∣0 \mathbf{P}{0\mid 0} P0∣0,对 k=1,2,...k = 1, 2, \dots k=1,2,... 循环(噪声为加性):

预测

  1. 由 x^k−1∣k−1 \hat{\mathbf{x}}{k-1\mid k-1} x^k−1∣k−1、 Pk−1∣k−1 \mathbf{P}{k-1\mid k-1} Pk−1∣k−1 生成 sigma 点 χi \boldsymbol{\chi}_i χi 和权重 Wi(m) W_i^{(m)} Wi(m)、 Wi(c) W_i^{(c)} Wi(c)。
  2. 逐点通过运动模型: χi−=f(χi, uk) \boldsymbol{\chi}_i^- = f(\boldsymbol{\chi}_i,\ \mathbf{u}_k) χi−=f(χi, uk)。
  3. 预测均值和协方差:

x^k∣k−1 = ∑i=02n Wi(m) χi−, Pk∣k−1 = ∑i=02n Wi(c) (χi−− x^k∣k−1 )(χi−− x^k∣k−1 )⊤+Q \hat{\mathbf{x}}{k\mid k-1} = \sum{i=0}^{2n} W_i^{(m)}\boldsymbol{\chi}i^-, \qquad \mathbf{P}{k\mid k-1} = \sum_{i=0}^{2n} W_i^{(c)}(\boldsymbol{\chi}i^- - \hat{\mathbf{x}}{k\mid k-1})(\boldsymbol{\chi}i^- - \hat{\mathbf{x}}{k\mid k-1})^\top + \mathbf{Q} x^k∣k−1=i=0∑2nWi(m)χi−,Pk∣k−1=i=0∑2nWi(c)(χi−−x^k∣k−1)(χi−−x^k∣k−1)⊤+Q

更新

  1. 由 x^k∣k−1 \hat{\mathbf{x}}{k\mid k-1} x^k∣k−1、 Pk∣k−1 \mathbf{P}{k\mid k-1} Pk∣k−1 重新 生成 sigma 点 χi \boldsymbol{\chi}_i χi(因为加上 Q\mathbf{Q} Q 后分布变了)。
  2. 逐点通过观测函数: ζi=h(χi) \boldsymbol{\zeta}_i = h(\boldsymbol{\chi}_i) ζi=h(χi)。
  3. 预测测量、新息协方差、互协方差:

z^k =∑i Wi(m) ζi Sk =∑i Wi(c) (ζi− z^k )(ζi− z^k )⊤+R Pxz =∑i Wi(c) (χi− x^k∣k−1 )(ζi− z^k )⊤ \begin{aligned} \hat{\mathbf{z}}k &= \sum{i} W_i^{(m)}\boldsymbol{\zeta}_i \\ \mathbf{S}k &= \sum{i} W_i^{(c)}(\boldsymbol{\zeta}_i - \hat{\mathbf{z}}_k)(\boldsymbol{\zeta}i - \hat{\mathbf{z}}k)^\top + \mathbf{R} \\ \mathbf{P}{xz} &= \sum{i} W_i^{(c)}(\boldsymbol{\chi}i - \hat{\mathbf{x}}{k\mid k-1})(\boldsymbol{\zeta}_i - \hat{\mathbf{z}}_k)^\top \end{aligned} z^kSkPxz=i∑Wi(m)ζi=i∑Wi(c)(ζi−z^k)(ζi−z^k)⊤+R=i∑Wi(c)(χi−x^k∣k−1)(ζi−z^k)⊤

  1. 增益与更新:

Kk= Pxz Sk−1 , x^k∣k = x^k∣k−1 +Kk(zk− z^k ), Pk∣k = Pk∣k−1 −KkSkKk⊤ \mathbf{K}k = \mathbf{P}{xz}\mathbf{S}k^{-1}, \qquad \hat{\mathbf{x}}{k\mid k} = \hat{\mathbf{x}}_{k\mid k-1} + \mathbf{K}_k(\mathbf{z}k - \hat{\mathbf{z}}k), \qquad \mathbf{P}{k\mid k} = \mathbf{P}{k\mid k-1} - \mathbf{K}_k\mathbf{S}_k\mathbf{K}_k^\top Kk=PxzSk−1,x^k∣k=x^k∣k−1+Kk(zk−z^k),Pk∣k=Pk∣k−1−KkSkKk⊤

几点说明:

  • 整个算法没有任何导数 , ff f 和 hh h 可以是黑盒函数,甚至可以不可导。
  • 每步要计算 2(2n+1)2(2n+1) 2(2n+1) 次函数值(预测、更新各 2n+12n+1 2n+1 次)和两次 Cholesky 分解。雷达例子中 n=4n = 4 n=4,每步 9 个 sigma 点。
  • 本例运动模型是线性的,由第四节的推论,UKF 的预测步与 KF 完全相同;两种滤波器的差别全部来自更新步。

3. 角度量的处理

雷达观测中有角度,第 09 篇讲过要做 ±π 归一化。UKF 里需要注意的地方更多:

  • 预测测量的均值 :不能直接对角度加权平均。假如两个 sigma 点的角度分别是 3.13.1 3.1 和 −3.1-3.1 −3.1,它们其实几乎指向同一方向,算术平均却得到 00 0,方向完全相反。正确的做法是对单位向量加权平均,再求角度:

θ^=atan2⁡(∑i Wi(m) sin⁡ ζi,θ , ∑i Wi(m) cos⁡ ζi,θ ) \hat{\theta} = \operatorname{atan2}\Bigl(\sum_i W_i^{(m)}\sin\zeta_{i,\theta},\ \sum_i W_i^{(m)}\cos\zeta_{i,\theta}\Bigr) θ^=atan2(i∑Wi(m)sinζi,θ, i∑Wi(m)cosζi,θ)

  • 所有角度差 : ζi− z^k \boldsymbol{\zeta}_i - \hat{\mathbf{z}}_k ζi−z^k 和新息 zk− z^k \mathbf{z}_k - \hat{\mathbf{z}}_k zk−z^k 的角度分量都要归一化到 [−π,π)[-\pi, \pi) [−π,π)。

七、雷达场景:EKF 与 UKF 的公平对比

1. 实验设置

雷达场景与第 09 篇完全相同(真实初值、运动模型、 Q\mathbf{Q} Q、60 步)。为了得到可靠的结论,每种设置都做 200 次蒙特卡洛:每次用不同的随机种子(1000~1199)生成新的真实轨迹和测量,两种滤波器处理同一组数据,比较平均的位置 RMSE。设置了三种场景:

  • 场景 A :与第 09 篇相同, σθ=0.03 \sigma_\theta = 0.03 σθ=0.03 rad,滤波初值 −38,0,28,0⊤-38, 0, 28, 0^\top −38,0,28,0⊤, P0∣0 =diag⁡(10,4,10,4) \mathbf{P}_{0\mid 0} = \operatorname{diag}(10, 4, 10, 4) P0∣0=diag(10,4,10,4)。
  • 场景 B :测角噪声加大到 σθ=0.3 \sigma_\theta = 0.3 σθ=0.3 rad(约 17°),其余同 A。
  • 场景 C :初值偏差加大, x^0∣0 =−20, 0, 50, 0⊤ \hat{\mathbf{x}}{0\mid 0} = -20,\\ 0,\\ 50,\\ 0^\top x^0∣0=−20, 0, 50, 0⊤(与真实位置相差约 28 m),相应地 P0∣0 =diag⁡(400,4,400,4) \mathbf{P}{0\mid 0} = \operatorname{diag}(400, 4, 400, 4) P0∣0=diag(400,4,400,4);测量噪声同 A。

2. 结果

场景 EKF 全程 RMSE UKF 全程 RMSE EKF 前 10 步 UKF 前 10 步 UKF 更好的次数
A:与第 09 篇相同 0.958 m 0.957 m 1.239 m 1.236 m 122/200
B:测角噪声 0.3 rad 4.156 m 4.017 m 4.370 m 4.147 m 106/200
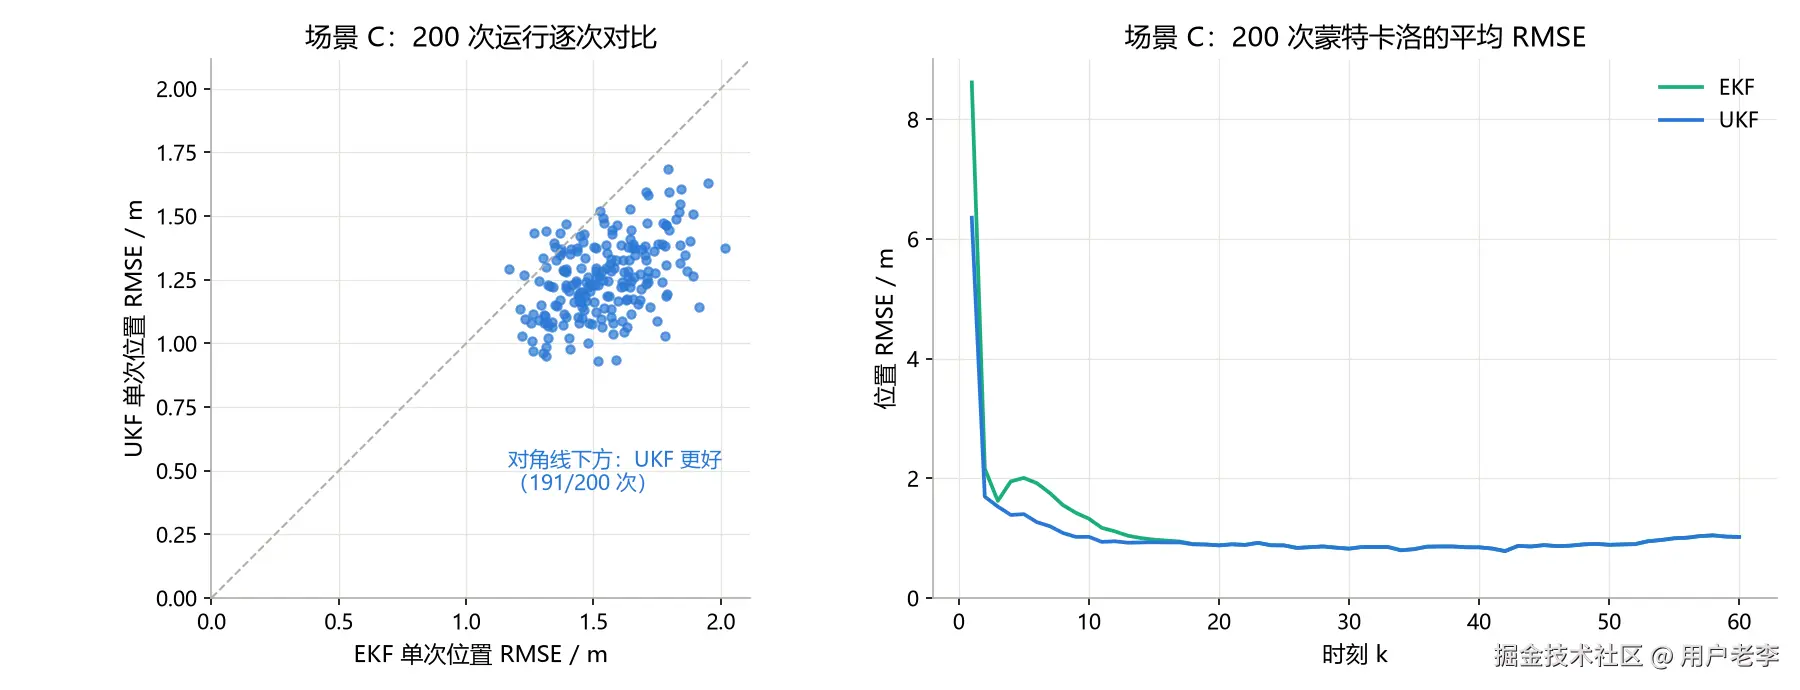
C:初值偏差 28 m 1.539 m 1.257 m 3.171 m 2.337 m 191/200

图 3:左图每个点是一次运行,横坐标是 EKF 的 RMSE,纵坐标是 UKF 的 RMSE,落在对角线下方表示 UKF 更好;右图是 200 次运行在每个时刻的平均位置误差。

3. 怎样理解这些结果

  • 场景 A:两者几乎没有差别。 不确定性很小(几米),在这么小的范围内,雷达观测函数几乎是平的,切线近似足够好。这时 EKF 更简单、更快,没有理由换成 UKF。
  • 场景 B:UKF 平均略好,但并非每次都好。 200 次里 UKF 只赢了 106 次,接近一半;平均 RMSE 的差距主要来自少数几次 EKF 表现较差的运行(逐次差值的中位数只有 0.039 m,差距最大的 10 次运行贡献了约 63% 的平均差距)。测角噪声大会让更新步的非线性变强,但当滤波器收敛后,状态的不确定性本身并不大,线性化依然大致可用。
  • 场景 C:UKF 明显更好。 200 次中 191 次 UKF 胜出,前 10 步的 RMSE 从 3.171 m 降到 2.337 m。原因是:初始阶段 P\mathbf{P} P 很大(位置标准差 20 m,而目标离雷达只有约 50 m),在这么大的范围内方位角和距离都明显非线性;EKF 只在一个本身就偏了 28 m 的点上求雅可比,得到的切线与真实情况差别很大;UKF 的 sigma 点铺满了整个不确定范围,"看到"了函数的弯曲。从图 3 右图可以看到,差别集中在前 15 步左右,两种滤波器收敛后的误差几乎重合。

还要提醒一点:单次运行说明不了问题。 例如在场景 C 中用种子 42 运行一次(附录代码的第一个输出),EKF 的 RMSE 是 1.181 m,UKF 是 1.244 m,EKF 反而略好;但 200 次统计中 UKF 胜出 191 次。比较滤波器一定要用足够多次的蒙特卡洛。

经验上可以这样选:非线性弱、不确定性小,用 EKF;非线性强、初值不确定、雅可比难推或不存在,用 UKF。 两者的计算量在状态维数不高时差不多,UKF 省去了推导和调试雅可比的工夫,在工程上常常更省心。

八、实践中的注意事项

  1. 保持 P\mathbf{P} P 对称正定。 Cholesky 分解要求 P\mathbf{P} P 正定,数值误差积累可能让它失效。常见做法是每步后对称化 P = (P + P.T) / 2,必要时加一个很小的对角项;更稳健的是"平方根 UKF",直接递推 P\mathbf{P} P 的 Cholesky 因子。
  2. 参数选择。 本篇用的 α=1\alpha = 1 α=1、 β=2\beta = 2 β=2、 κ=0\kappa = 0 κ=0 所有权重非负,数值上稳定。文献中也常见 α=10−3\alpha = 10^{-3} α=10−3 这样很小的值,它让 sigma 点更局部,但中心点权重会变成很大的负数,需要更小心地处理正定性。
  3. 非加性噪声。 如果噪声不是加在 ff f、 hh h 外面(例如噪声作用在控制量上),要把噪声并入状态做"增广",在增广后的高维空间里取 sigma 点。
  4. 角度、四元数等非欧氏量。 求均值和差值时要用对应空间的运算(上面的 atan2 平均、角度归一化;姿态估计中还有四元数平均),不能直接相加相减。
  5. 它仍然是高斯近似。 UKF 只是把均值和协方差算得更准,仍然假设分布可以用一个高斯描述。如果真实分布是多峰的(例如机器人不知道自己在两条相同走廊中的哪一条),UKF 和 EKF 都无能为力,需要第 13 篇介绍的粒子滤波。

小结

项目 EKF UKF
处理非线性的方法 在估计点做一阶泰勒展开 用 2n+12n+1 2n+1 个 sigma 点直接通过非线性函数
需要雅可比 是 否
均值精度 一阶(缺 12tr⁡(GP) \frac{1}{2}\operatorname{tr}(\mathbf{G}\mathbf{P}) 21tr(GP)) 二阶,误差从四阶项开始
协方差 只有 JPJ⊤\mathbf{J}\mathbf{P}\mathbf{J}^\top JPJ⊤ 主项 JPJ⊤\mathbf{J}\mathbf{P}\mathbf{J}^\top JPJ⊤ 精确,含部分高阶修正
更新公式 K=PHk⊤S−1 \mathbf{K} = \mathbf{P}\mathbf{H}_k^\top\mathbf{S}^{-1} K=PHk⊤S−1 K= Pxz S−1 \mathbf{K} = \mathbf{P}_{xz}\mathbf{S}^{-1} K=PxzS−1(线性 MMSE 公式)
线性系统 等价于 KF 等价于 KF
本篇雷达实验 不确定性小时与 UKF 相当 初值偏差大时明显更好(191/200)

无迹变换的三个关键公式:
λ=α2(n+κ)−n,χ0=μ,χi, χi+n =μ± (n+λ)P i,Kk= Pxz Sk−1 \lambda = \alpha^2(n + \kappa) - n, \qquad \boldsymbol{\chi}{0} = \boldsymbol{\mu},\quad \boldsymbol{\chi}{i},\ \boldsymbol{\chi}_{i+n} = \boldsymbol{\mu} \pm \Bigl\\sqrt{(n + \\lambda)\\mathbf{P}}\\Bigr_i, \qquad \mathbf{K}k = \mathbf{P}{xz}\mathbf{S}_k^{-1} λ=α2(n+κ)−n,χ0=μ,χi, χi+n=μ±(n+λ)P i,Kk=PxzSk−1

练习题

  1. 概念题。 无迹变换用 2n+12n+1 2n+1 个点,蒙特卡洛通常要成千上万个点。为什么无迹变换用这么少的点就能把均值算准到二阶?它付出的代价是什么?
  2. 计算题。 设 x∼N(0, 1)x \sim \mathcal{N}(0,\ 1) x∼N(0, 1), g(x)=x2g(x) = x^2 g(x)=x2。分别用 EKF 的线性化和无迹变换( α=1\alpha = 1 α=1、 β=2\beta = 2 β=2、 κ=0\kappa = 0 κ=0)计算 y=g(x)y = g(x) y=g(x) 的均值和方差,并与精确值比较。
  3. 证明题。 取 n=1n = 1 n=1、 α=1\alpha = 1 α=1、 κ=2\kappa = 2 κ=2(即 κ=3−n\kappa = 3 - n κ=3−n)。证明此时 sigma 点(带均值权重)的四阶中心矩等于 3σ43\sigma^4 3σ4,与高斯分布相同。
  4. 计算题。 雷达例子中状态维数 n=4n = 4 n=4,取 α=1\alpha = 1 α=1、 β=2\beta = 2 β=2、 κ=0\kappa = 0 κ=0。写出 sigma 点的个数和全部权重。如果改用 α=1\alpha = 1 α=1、 κ=3−n\kappa = 3 - n κ=3−n, λ\lambda λ 和中心点权重变为多少?
  5. 编程题。 随机生成一个 3×33 \times 3 3×3 的正定矩阵 P\mathbf{P} P 和均值 μ\boldsymbol{\mu} μ,用 sigma_points 生成 sigma 点,数值验证它们的加权均值等于 μ\boldsymbol{\mu} μ、加权协方差等于 P\mathbf{P} P。

参考答案

1. 第五节的证明说明,只要点关于均值对称、并且精确匹配均值和协方差,奇数阶项就会成对抵消,二阶项会给出 12tr⁡(GP) \frac{1}{2}\operatorname{tr}(\mathbf{G}\mathbf{P}) 21tr(GP),所以均值自动精确到二阶。这些性质只依赖分布的前两阶矩,不需要很多点去"描绘"整个分布。代价是:它只匹配了均值和协方差(以及通过参数部分匹配四阶矩),无法表示多峰、强偏斜等复杂分布;高阶项的误差也无法消除。蒙特卡洛的点数越多越接近真实分布,可以表示任意形状,但计算量大得多。

2. 精确值: Ex2=σ2=1Ex\^2 = \sigma^2 = 1 Ex2=σ2=1, Var⁡x2=2σ4=2\operatorname{Var}x\^2 = 2\sigma^4 = 2 Varx2=2σ4=2。 EKF 线性化:在 x=0x = 0 x=0 处 g(0)=0g(0) = 0 g(0)=0、 g′(0)=0g'(0) = 0 g′(0)=0,得到均值 00 0、方差 00 0,完全错误:切线是一条水平线,滤波器会认为 yy y 毫无不确定性。 无迹变换: n=1n = 1 n=1, λ=0\lambda = 0 λ=0,sigma 点为 0,1,−10, 1, -1 0,1,−1,权重 W(m)=(0, 0.5, 0.5)W^{(m)} = (0,\ 0.5,\ 0.5) W(m)=(0, 0.5, 0.5), W(c)=(2, 0.5, 0.5)W^{(c)} = (2,\ 0.5,\ 0.5) W(c)=(2, 0.5, 0.5)。均值 =0.5×1+0.5×1=1= 0.5 \times 1 + 0.5 \times 1 = 1 =0.5×1+0.5×1=1;方差 =2×(0−1)2+0.5×(1−1)2+0.5×(1−1)2=2= 2 \times (0 - 1)^2 + 0.5 \times (1 - 1)^2 + 0.5 \times (1 - 1)^2 = 2 =2×(0−1)2+0.5×(1−1)2+0.5×(1−1)2=2。两者都精确,与第五节第 3 小节 β=2−α2κ=2\beta = 2 - \alpha^2\kappa = 2 β=2−α2κ=2 的结论一致。

3. c=n+λ=α2(n+κ)=3c = n + \lambda = \alpha^2(n + \kappa) = 3 c=n+λ=α2(n+κ)=3,sigma 点为 μ\mu μ、 μ±3σ \mu \pm \sqrt{3}\sigma μ±3 σ,权重 W1=W2= 12c =16 W_1 = W_2 = \frac{1}{2c} = \frac{1}{6} W1=W2=2c1=61。四阶中心矩为
W0⋅0+16(3σ)4+16(−3σ)4=26⋅9σ4=3σ4 W_0 \cdot 0 + \frac{1}{6}(\sqrt{3}\sigma)^4 + \frac{1}{6}(-\sqrt{3}\sigma)^4 = \frac{2}{6} \cdot 9\sigma^4 = 3\sigma^4 W0⋅0+61(3 σ)4+61(−3 σ)4=62⋅9σ4=3σ4

与高斯分布的 Eδ4=3σ4E\\delta\^4 = 3\sigma^4 Eδ4=3σ4 相同。这就是 Julier 建议 κ=3−n\kappa = 3 - n κ=3−n 的原因;此时由 β=2−α2κ\beta = 2 - \alpha^2\kappa β=2−α2κ 应取 β=0\beta = 0 β=0( α=1\alpha = 1 α=1)。

4. 2n+1=92n + 1 = 9 2n+1=9 个点。 λ=1⋅(4+0)−4=0\lambda = 1 \cdot (4 + 0) - 4 = 0 λ=1⋅(4+0)−4=0, W0(m) =0 W_0^{(m)} = 0 W0(m)=0, W0(c) =0+(1−1+2)=2 W_0^{(c)} = 0 + (1 - 1 + 2) = 2 W0(c)=0+(1−1+2)=2,其余 8 个点 Wi(m) = Wi(c) =18 W_i^{(m)} = W_i^{(c)} = \frac{1}{8} Wi(m)=Wi(c)=81。 若 κ=3−4=−1\kappa = 3 - 4 = -1 κ=3−4=−1: λ=1⋅(4−1)−4=−1\lambda = 1 \cdot (4 - 1) - 4 = -1 λ=1⋅(4−1)−4=−1, n+λ=3n + \lambda = 3 n+λ=3, W0(m) =−13 W_0^{(m)} = -\frac{1}{3} W0(m)=−31, W0(c) =−13+β W_0^{(c)} = -\frac{1}{3} + \beta W0(c)=−31+β,其余 Wi=16 W_i = \frac{1}{6} Wi=61。中心点的均值权重变成了负数。

5. 参考代码(sigma_points 来自附录):

python 复制代码
rng = np.random.default_rng(0)
A = rng.normal(size=(3, 3))
P = A @ A.T + 0.1 * np.eye(3)        # 构造一个正定矩阵
mu = rng.normal(size=3)
X, Wm, Wc = sigma_points(mu, P)
m = Wm @ X
C = (Wc[:, None] * (X - mu)).T @ (X - mu)
print(np.allclose(m, mu), np.allclose(C, P))   # 输出 True True

参考资料

  • Dan Simon,《Optimal State Estimation: Kalman, H∞, and Nonlinear Approaches》,第 14 章(无迹卡尔曼滤波)。
  • Sebastian Thrun、Wolfram Burgard、Dieter Fox,《Probabilistic Robotics》,第 3 章(高斯滤波器,其中包括 UKF)。
  • Roger Labbe,《Kalman and Bayesian Filters in Python》,无迹卡尔曼滤波一章。
  • S. J. Julier、J. K. Uhlmann,"A New Extension of the Kalman Filter to Nonlinear Systems",1997(无迹变换的提出)。
  • E. A. Wan、R. van der Merwe,"The Unscented Kalman Filter for Nonlinear Estimation",2000(缩放 sigma 点与 α、β、κ 参数)。

附录:完整代码

下面的程序在第 09 篇的雷达场景(场景 C:初值偏差约 28 m)上实现 UKF,并与 EKF 对比:先用种子 42 运行一次并画出轨迹,再做 200 次蒙特卡洛,打印平均 RMSE 和 UKF 胜出的次数(结果对应正文表格的场景 C 一行)。只依赖 numpy 和 matplotlib,运行 python example.py 即可,蒙特卡洛部分需要几十秒。

python 复制代码
"""卡尔曼滤波自学教程 10:无迹卡尔曼滤波(UKF)------ 附录代码

在第 09 篇的雷达跟踪场景上实现 UKF,并与 EKF 对比。
场景 C:滤波器初值偏差约 28 m,初始协方差放大到 400。
程序先做一次单独运行并画图,再做 200 次蒙特卡洛统计平均 RMSE。
运行:python example.py(蒙特卡洛部分需要几十秒)
"""
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False

# ---------------- 1. 模型参数(与第 09 篇相同) ----------------
dt = 1.0
F = np.kron(np.eye(2), np.array([[1.0, dt],
                                 [0.0, 1.0]]))   # 状态 [px, vx, py, vy]
q = 0.01
Q = np.kron(np.eye(2), q * np.array([[dt**4 / 4, dt**3 / 2],
                                     [dt**3 / 2, dt**2]]))
sigma_r, sigma_th = 1.0, 0.03
R = np.diag([sigma_r**2, sigma_th**2])
N = 60
x_true0 = np.array([-40.0, 0.3, 30.0, -1.0])
x_hat0 = np.array([-20.0, 0.0, 50.0, 0.0])        # 场景 C:初值偏差约 28 m
P0 = np.diag([400.0, 4.0, 400.0, 4.0])           # 初始协方差相应放大

# UKF 参数
ALPHA, BETA, KAPPA = 1.0, 2.0, 0.0


def wrap(angle):
    """把角度归一化到 [-π, π)。"""
    return (angle + np.pi) % (2 * np.pi) - np.pi


def h(x):
    """观测函数:状态 → (距离, 方位角)。"""
    return np.array([np.hypot(x[0], x[2]), np.arctan2(x[2], x[0])])


def jacobian_h(x):
    """观测函数的雅可比(只有 EKF 需要)。"""
    px, py = x[0], x[2]
    r2 = px**2 + py**2
    r = np.sqrt(r2)
    return np.array([[px / r, 0.0, py / r, 0.0],
                     [-py / r2, 0.0, px / r2, 0.0]])


# ---------------- 2. 无迹变换的 sigma 点和权重 ----------------
def sigma_points(x, P, alpha=ALPHA, beta=BETA, kappa=KAPPA):
    """Merwe 缩放 sigma 点:返回 (2n+1)×n 的点阵和两组权重。"""
    n = len(x)
    lam = alpha**2 * (n + kappa) - n
    L = np.linalg.cholesky((n + lam) * P)        # 矩阵平方根:L @ L.T = (n+λ)P
    points = [x]
    for i in range(n):
        points.append(x + L[:, i])
    for i in range(n):
        points.append(x - L[:, i])
    Wm = np.full(2 * n + 1, 1.0 / (2 * (n + lam)))
    Wc = Wm.copy()
    Wm[0] = lam / (n + lam)
    Wc[0] = lam / (n + lam) + (1 - alpha**2 + beta)
    return np.array(points), Wm, Wc


# ---------------- 3. 生成真实轨迹和测量 ----------------
def simulate(rng):
    x = x_true0.copy()
    truth, zs = [], []
    for _ in range(N):
        x = F @ x + rng.multivariate_normal(np.zeros(4), Q)
        z = h(x) + np.array([rng.normal(0.0, sigma_r), rng.normal(0.0, sigma_th)])
        z[1] = wrap(z[1])
        truth.append(x.copy())
        zs.append(z)
    return np.array(truth), np.array(zs)


# ---------------- 4. 两种滤波器 ----------------
def ekf(zs):
    x, P = x_hat0.copy(), P0.copy()
    out = []
    for z in zs:
        x, P = F @ x, F @ P @ F.T + Q
        Hj = jacobian_h(x)
        y = z - h(x)
        y[1] = wrap(y[1])
        K = P @ Hj.T @ np.linalg.inv(Hj @ P @ Hj.T + R)
        x = x + K @ y
        P = (np.eye(4) - K @ Hj) @ P
        out.append(x.copy())
    return np.array(out)


def ukf(zs):
    x, P = x_hat0.copy(), P0.copy()
    out = []
    for z in zs:
        # ---- 预测:sigma 点逐个通过运动模型 ----
        X, Wm, Wc = sigma_points(x, P)
        X_pred = X @ F.T                          # 每一行是 f(χ_i)
        x = Wm @ X_pred
        dX = X_pred - x
        P = (Wc[:, None] * dX).T @ dX + Q

        # ---- 更新:用预测分布重新取 sigma 点,逐个通过观测函数 ----
        X, Wm, Wc = sigma_points(x, P)
        Z = np.array([h(chi) for chi in X])
        # 预测测量的均值:距离直接加权平均,角度用正弦、余弦加权后求 atan2
        z_hat = np.array([Wm @ Z[:, 0],
                          np.arctan2(Wm @ np.sin(Z[:, 1]), Wm @ np.cos(Z[:, 1]))])
        dZ = Z - z_hat
        dZ[:, 1] = wrap(dZ[:, 1])                 # 角度差必须归一化
        dX = X - x
        S = (Wc[:, None] * dZ).T @ dZ + R          # 新息协方差
        Pxz = (Wc[:, None] * dX).T @ dZ            # 状态与测量的互协方差
        K = Pxz @ np.linalg.inv(S)
        y = z - z_hat
        y[1] = wrap(y[1])
        x = x + K @ y
        P = P - K @ S @ K.T
        out.append(x.copy())
    return np.array(out)


def pos_err(est, truth):
    return np.hypot(est[:, 0] - truth[:, 0], est[:, 2] - truth[:, 2])


# ---------------- 5. 单次运行 ----------------
truth, zs = simulate(np.random.default_rng(42))
est_ekf, est_ukf = ekf(zs), ukf(zs)
print("单次运行(种子 42)位置 RMSE:EKF "
      f"{np.sqrt(np.mean(pos_err(est_ekf, truth)**2)):.3f} m,"
      f"UKF {np.sqrt(np.mean(pos_err(est_ukf, truth)**2)):.3f} m")

# ---------------- 6. 蒙特卡洛:200 次 ----------------
rmse_ekf, rmse_ukf = [], []
for s in range(200):
    tr, z = simulate(np.random.default_rng(1000 + s))
    rmse_ekf.append(np.sqrt(np.mean(pos_err(ekf(z), tr)**2)))
    rmse_ukf.append(np.sqrt(np.mean(pos_err(ukf(z), tr)**2)))
rmse_ekf, rmse_ukf = np.array(rmse_ekf), np.array(rmse_ukf)
print(f"200 次蒙特卡洛平均位置 RMSE:EKF {rmse_ekf.mean():.3f} m,UKF {rmse_ukf.mean():.3f} m")
print(f"UKF 比 EKF 更好的次数:{np.sum(rmse_ukf < rmse_ekf)}/200")

# ---------------- 7. 画图 ----------------
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))
ax1.plot(truth[:, 0], truth[:, 2], "--", color="gray", label="真实轨迹")
ax1.plot(est_ekf[:, 0], est_ekf[:, 2], color="tab:green", label="EKF")
ax1.plot(est_ukf[:, 0], est_ukf[:, 2], color="tab:blue", label="UKF")
ax1.scatter([x_hat0[0]], [x_hat0[2]], marker="x", color="black", label="滤波初值")
ax1.scatter([0], [0], marker="^", color="purple", label="雷达")
ax1.set_aspect("equal")
ax1.set_xlabel("px / m")
ax1.set_ylabel("py / m")
ax1.legend()

ax2.scatter(rmse_ekf, rmse_ukf, s=12)
lim = max(rmse_ekf.max(), rmse_ukf.max()) * 1.05
ax2.plot([0, lim], [0, lim], "--", color="gray")
ax2.set_xlabel("EKF 单次 RMSE / m")
ax2.set_ylabel("UKF 单次 RMSE / m")
ax2.set_title("对角线下方的点:UKF 更好")
plt.tight_layout()
plt.show()
相关推荐
深圳市益普科技有限公司2 小时前
半导体良率管理YMS:良率与设备参数的相关性,先拉哪几组数据
人工智能·python·算法
程序员清风4 小时前
算法题中的边界条件、测试与调试
开发语言·算法·kotlin
炘爚4 小时前
数据结构算法总结
数据结构·python·算法
Dageno_AI4 小时前
ChatGPT 不再引用 Reddit 之后,还值得在 Reddit 上做 AI 可见度吗?
算法
hetao17338374 小时前
2026-10-25 hetao1733837 的刷题记录
c++·算法
Jsundoku5 小时前
第七章 机器学习 -- 其他经典算法
人工智能·算法·机器学习
进击的丸子5 小时前
基于 ArcFace SDK 的跨平台人脸特征值下发、同步以及存储方案
后端·算法·代码规范
见叶之秋5 小时前
【C++】红与黑的边界:红黑树从插入到自检
数据结构·c++·算法·面试
一条闲鱼_mytube6 小时前
分布式 ID 生成方案:雪花算法与号段模式
分布式·算法·wpf