作者:来自 Elastic Kevin Lacabane
选错了这 100 条样本,你得到的就可能是 log.level: error、一条每次请求都会触发的规则,或者一条什么也检测不到的规则,而日志采样决定了最终会出现哪种结果。
在你的数据所在之处构建和观测 人工智能 agent。从 Elastic agent 构建器开始。你也可以立即开始免费云试用,或在你的本地计算机上试用 Elastic。
重大事件功能通过读取某个日志源中约 100 份文档,为其编写检测规则,而读取哪 100 份文档,决定了这些规则能够发现什么。整个过程依次完成两项工作:先构建一份有证据支撑的日志源描述,再根据这份描述生成查询。组成这份描述的单元称为知识指标。通过日志采样,我们从本系列使用的 OpenTelemetry 演示日志源中提取了 27 个知识指标,涵盖 13 个服务、它们之间的 8 条依赖关系、4 种技术、编排器以及数据模式。本文介绍如何选出这 100 份文档。如果采用均匀抽样,它们描述的就只会是最繁忙的服务在每次请求时记录的内容。
本系列的第二部分将根据本文发现的事实生成查询。第三部分将把它们转化为重大事件。
为什么 大语言模型 为陌生日志源生成的检测规则会失效
你有一个新的日志源,其中包含数百万份文档。你并未编写生成这些文档的服务,却需要为它制定检测规则。手动编写规则意味着先阅读日志,而这种方式无法应对大规模数据。
让语言模型直接处理原始日志,是一种显而易见的捷径。但我们尝试后,得到的却是类似 log.level: error 这样的通用规则。对于日志量大的数据源,这条规则会不断触发。而在本系列用作示例的日志源中,它在整个故障期间都没有返回任何结果。该日志源采用 OpenTelemetry 格式,因此严重级别存储在 severity_text 中,而 log.level 之所以能够解析,只是因为 Elasticsearch 将它保留为该字段的别名。使用任一名称得到的结果都一样:只有两个服务设置了严重级别,而且始终为信息级别。 提示词 中能容纳的少量文档,无法让模型判断自己面对的是哪种情况。
重大事件功能将单个提示词混在一起的两项工作分开。首先,我们构建一份范围明确、有证据支撑的描述,说明日志源中包含哪些内容。然后,根据这份描述生成检测查询。我们将组成这份描述的单元称为知识指标。这样的拆分让过程更可控:提取和生成可以分别评估,因此,错误的查询可以追溯到某项事实的缺失或误用,而知识指标表则提供了一个审核环节,让你无需编写查询就能纠正系统的理解。代价是,提取阶段遗漏的内容,生成阶段无法补回。
本系列将依次介绍这条流水线:日志源、特征知识指标、查询知识指标、规则、事件、重大事件。本文是第一部分,介绍特征知识指标,以及指导我们提取这些指标的原则:模型只知道它所看到的内容。代码决定了模型读取哪些文档,以及读取时能看到哪些先验知识。本文涉及的覆盖范围和身份识别这两个问题,最终都归结为模型看到了什么。
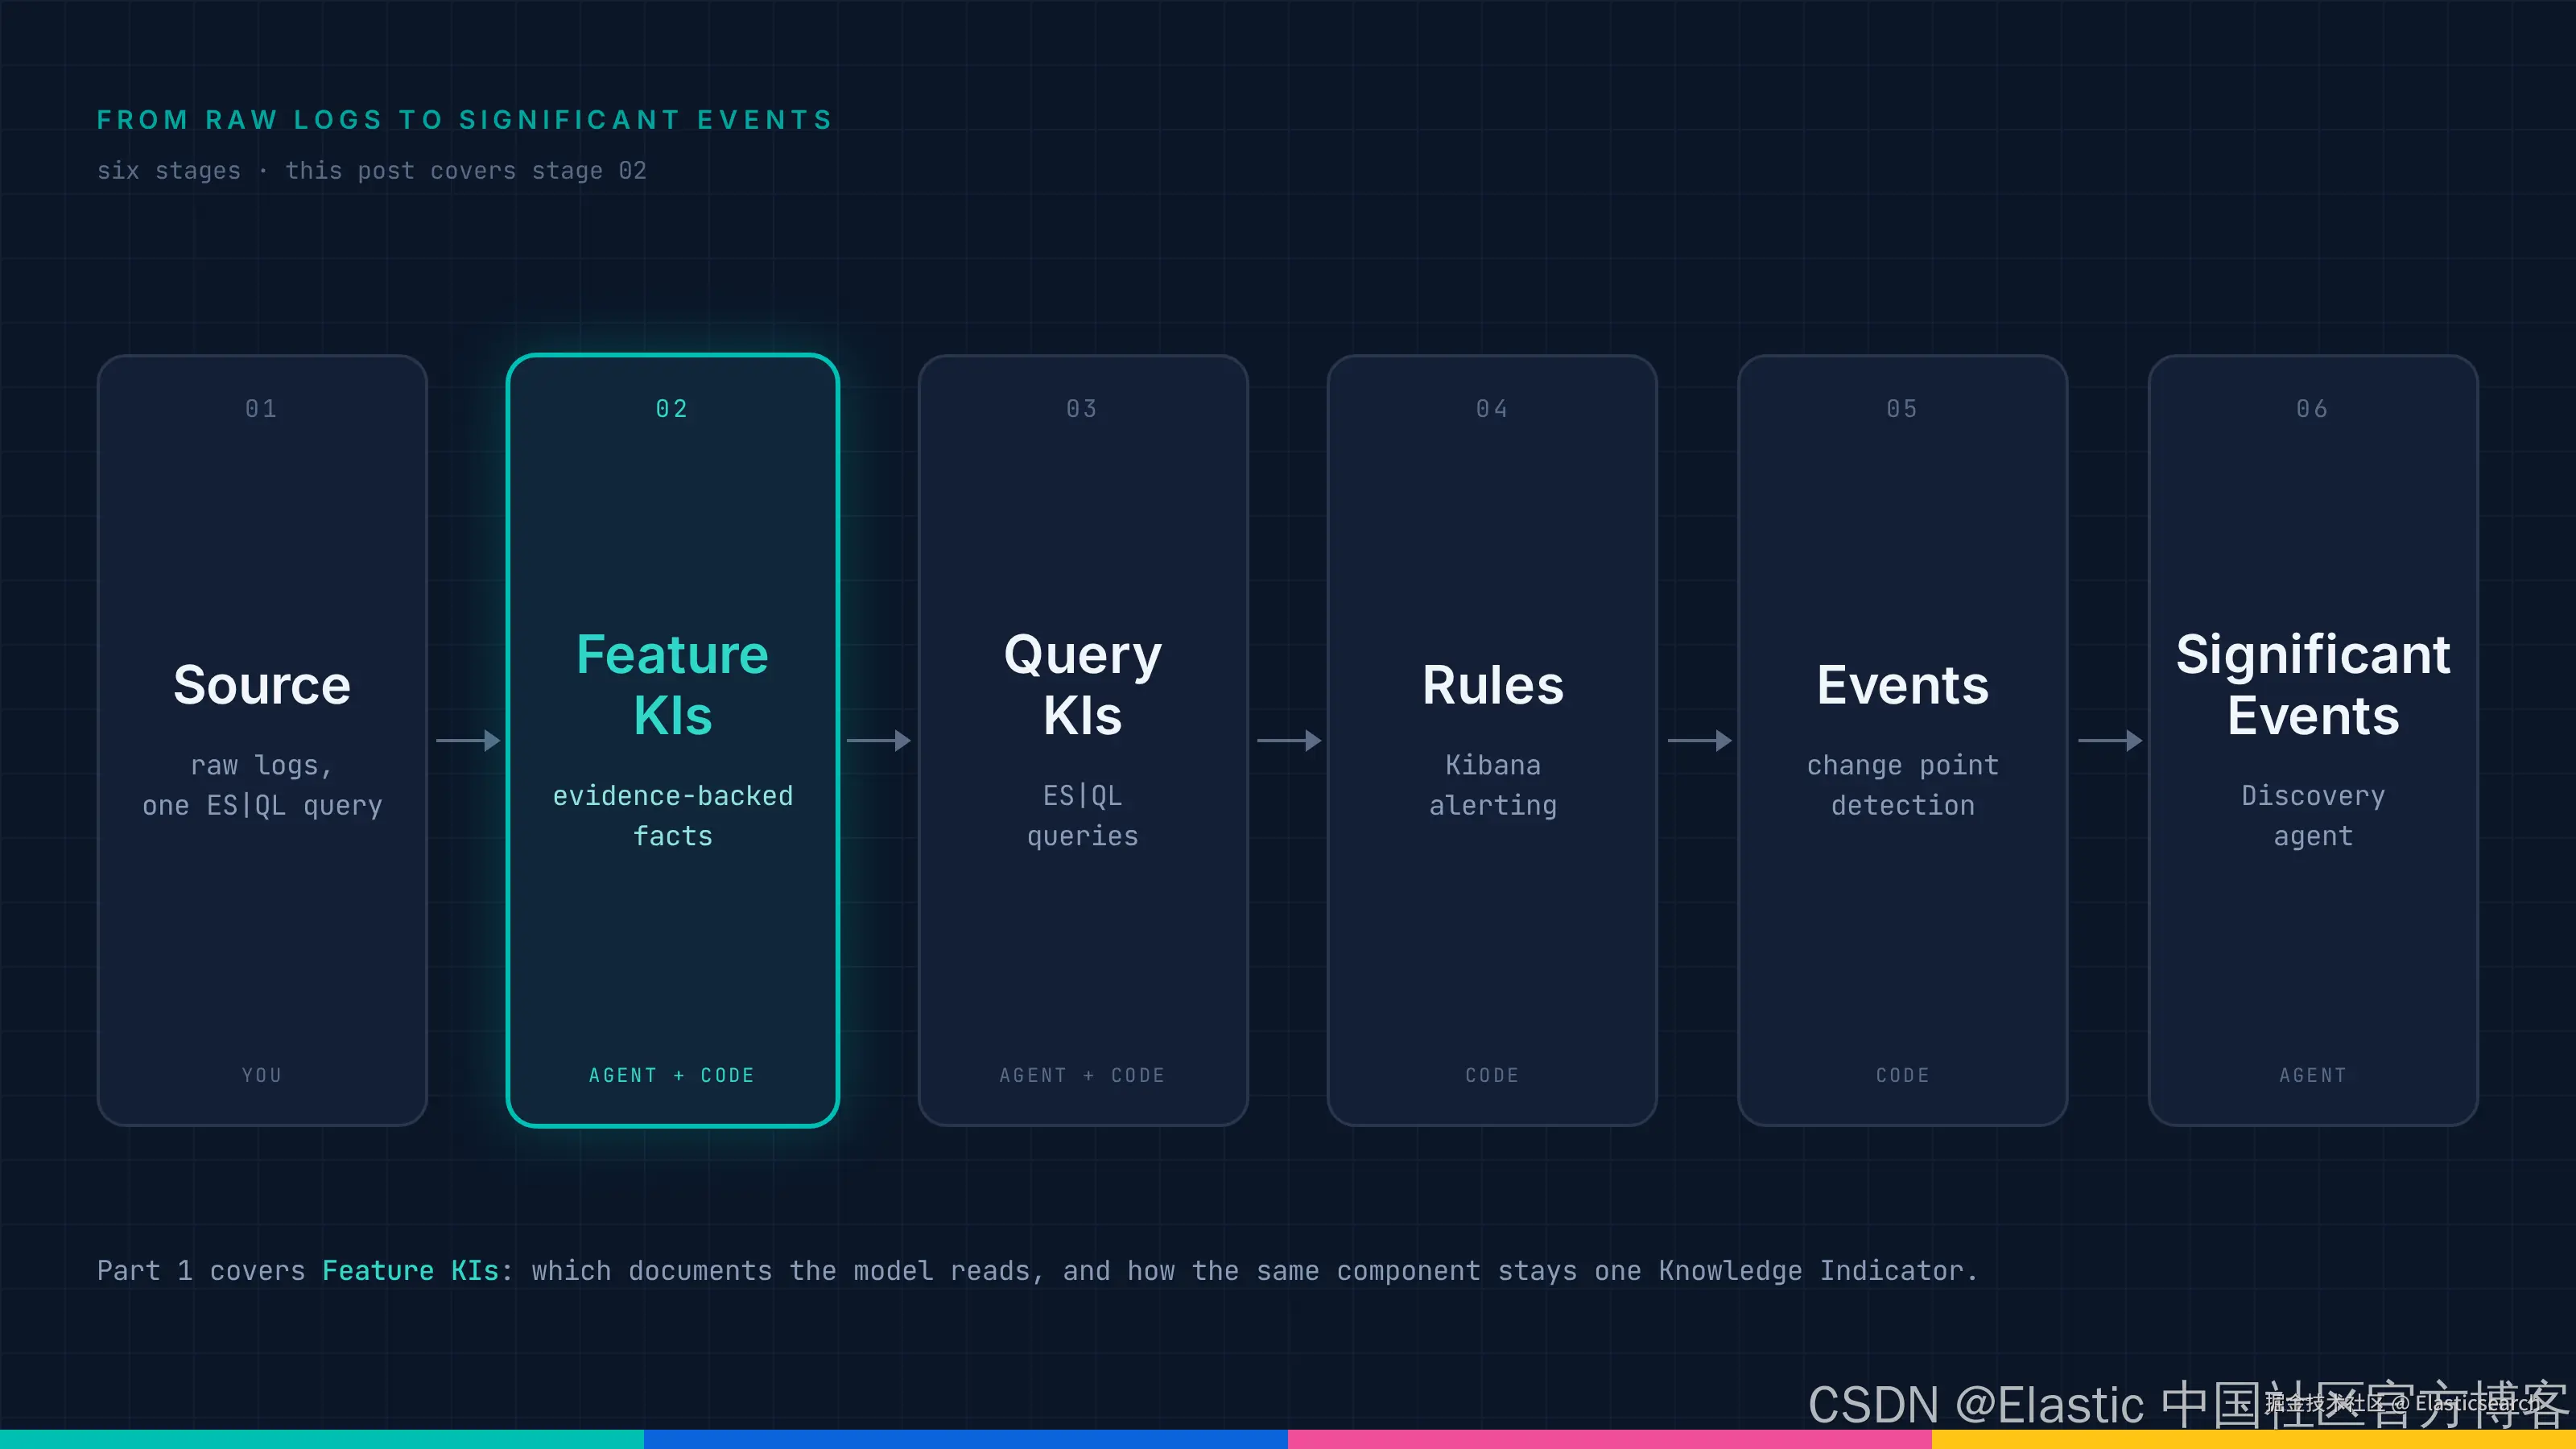 本系列的流水线。本文介绍高亮显示的阶段;第二部分和第三部分将依次介绍后续阶段。
日志源是一组由 Elasticsearch 查询语言( ES|QL )查询定义的日志文档,通过 FROM 指定索引模式,并可选择使用 WHERE 缩小范围,然后在 Elastic 夜班系统的"日志源"页面注册。贯穿本文的示例是在 Kubernetes 上运行的 OpenTelemetry 演示应用,其容器日志写入 logs.otel。在采集过程中,我们将结账服务连接支付服务的端口改成了错误端口,并将负载生成器的用户数增加到原来的三倍。从那时起,每笔订单都会在支付环节失败,而流量仍在持续攀升。
知识指标会记录日志源的哪些信息
先来看一份文档,它是在某个服务无法访问其依赖项时采样得到的。内容已节选,后面还有堆栈跟踪。
less
`
1. {
2. "@timestamp": "2026-10-16T13:37:42.885Z",
3. "resource": {
4. "attributes": {
5. "app": "frontend",
6. "k8s.namespace.name": "otel-demo",
7. "k8s.deployment.name": "frontend",
8. "container.image.tag": "1.12.0-frontend"
9. },
10. "schema_url": "https://opentelemetry.io/schemas/1.40.0"
11. },
12. "body": {
13. "text": "Error: 13 INTERNAL: failed to charge card: could not charge the card: rpc error: code = Unavailable desc = connection error: desc = \"transport: Error while dialing: dial tcp 10.104.231.249:9999: i/o timeout\"\n at callErrorFromStatus (/app/node_modules/@grpc/grpc-js/build/src/call.js:31:19)\n at Object.onReceiveStatus (/app/node_modules/@grpc/grpc-js/build/src/client.js:193:76)\n ..."
14. }
15. }
`AI代码解释以下是提取模型根据这份文档及类似文档生成的实体知识指标,已省略运行元数据和文档引用。
python
`
1. {
2. "id": "frontend",
3. "type": "entity",
4. "subtype": "service",
5. "title": "Frontend Service",
6. "description": "Frontend service in the otel-demo namespace serves the user-facing application and makes backend gRPC calls during checkout flows. The sample directly identifies the frontend deployment and shows a failing backend RPC from frontend code.",
7. "properties": { "name": "frontend", "namespace": "otel-demo" },
8. "confidence": 92,
9. "evidence": [
10. "app=frontend",
11. "k8s.deployment.,
12. "Error: 13 INTERNAL: failed to charge card: could not charge the card: rpc error: code = Unavailable desc = connection error",
13. "at /app/.next/server/pages/api/checkout.js:1:1041"
14. ],
15. "filter": { "field": "k8s.deployment.name", "eq": "frontend" }
16. }
`AI代码解释evidence 引用支撑该判断的日志内容,因此你可以核查判断,而不必直接相信它。filter 用于选取该服务的文档,既限定生成查询的范围,也会引导采样,后文将介绍这一点。confidence 的取值范围为 0 到 100,用于衡量证据的直接程度:由资源属性明确命名的服务得分较高,根据请求模式推断出的组件得分较低,而依赖关系的置信度不会高于它所连接的任一组件。
模型会提取五种类型。
| 类型 | 记录的内容 | 此日志源中的示例 |
|---|---|---|
实体( entity ) |
服务、数据库、队列或缓存 | frontend,发起失败的 gRPC 调用的服务 |
依赖关系( dependency ) |
两个实体之间的连接 | checkout-payment-grpc,结账服务通过 gRPC 调用支付服务 |
技术( technology ) |
语言、框架和库 | grpc-js,堆栈跟踪中的 @grpc/grpc-js 客户端 |
基础设施( infrastructure ) |
云服务提供商、编排器和操作系统 | Kubernetes,根据 k8s.* 资源属性识别 |
数据模式( schema ) |
日志源是否遵循 Elastic 通用模式、OpenTelemetry 语义约定或自定义模式 | otel-schema,通过匹配 OpenTelemetry 语义约定识别 |
根据上述文档及类似文档,该日志源的知识指标还包括以下内容,每项证据均缩减为一行:
bash
`
1. [
2. { "id": "checkout-payment-grpc", "type": "dependency", "subtype": "service_dependency",
3. "properties": { "source": "checkout", "target": "payment", "protocol": "grpc" },
4. "confidence": 56, "evidence": ["paymentSvcAddr:payment:9999"] },
5. { "id": "grpc-js", "type": "technology", "subtype": "framework",
6. "properties": { "library": "@grpc/grpc-js" },
7. "confidence": 92, "evidence": ["位于 ServiceClientImpl.makeUnaryRequest (/app/node_modules/@grpc/grpc-js/build/src/client.js:161:32)"] },
8. { "id": "otel-schema", "type": "schema", "subtype": "otel",
9. "properties": { "schema_family": "otel" },
10. "confidence": 85, "evidence": ["存在 resource.attributes.k8s.deployment.name"] }
11. ]
`AI代码解释第二部分将直接使用这些知识指标:实体的筛选条件限定查询范围,依赖关系说明哪里可能出故障,技术说明故障会呈现什么特征,数据模式则说明应该查看哪个字段。
计算生成的知识指标:字段清单、日志模式和日志样本
并非所有知识指标都来自模型。计算生成的知识指标通过针对日志源执行 ES|QL 查询获得,包括附带值分布的字段清单( dataset_analysis )、分类后的消息模式及其计数和每类的一个样本( log_patterns ),以及一组原始日志样本( log_samples )。这些指标是将真实日志文本传递给第二部分查询生成器的途径。查询生成器接收的是日志源的描述,而不是任意一批原始文档。
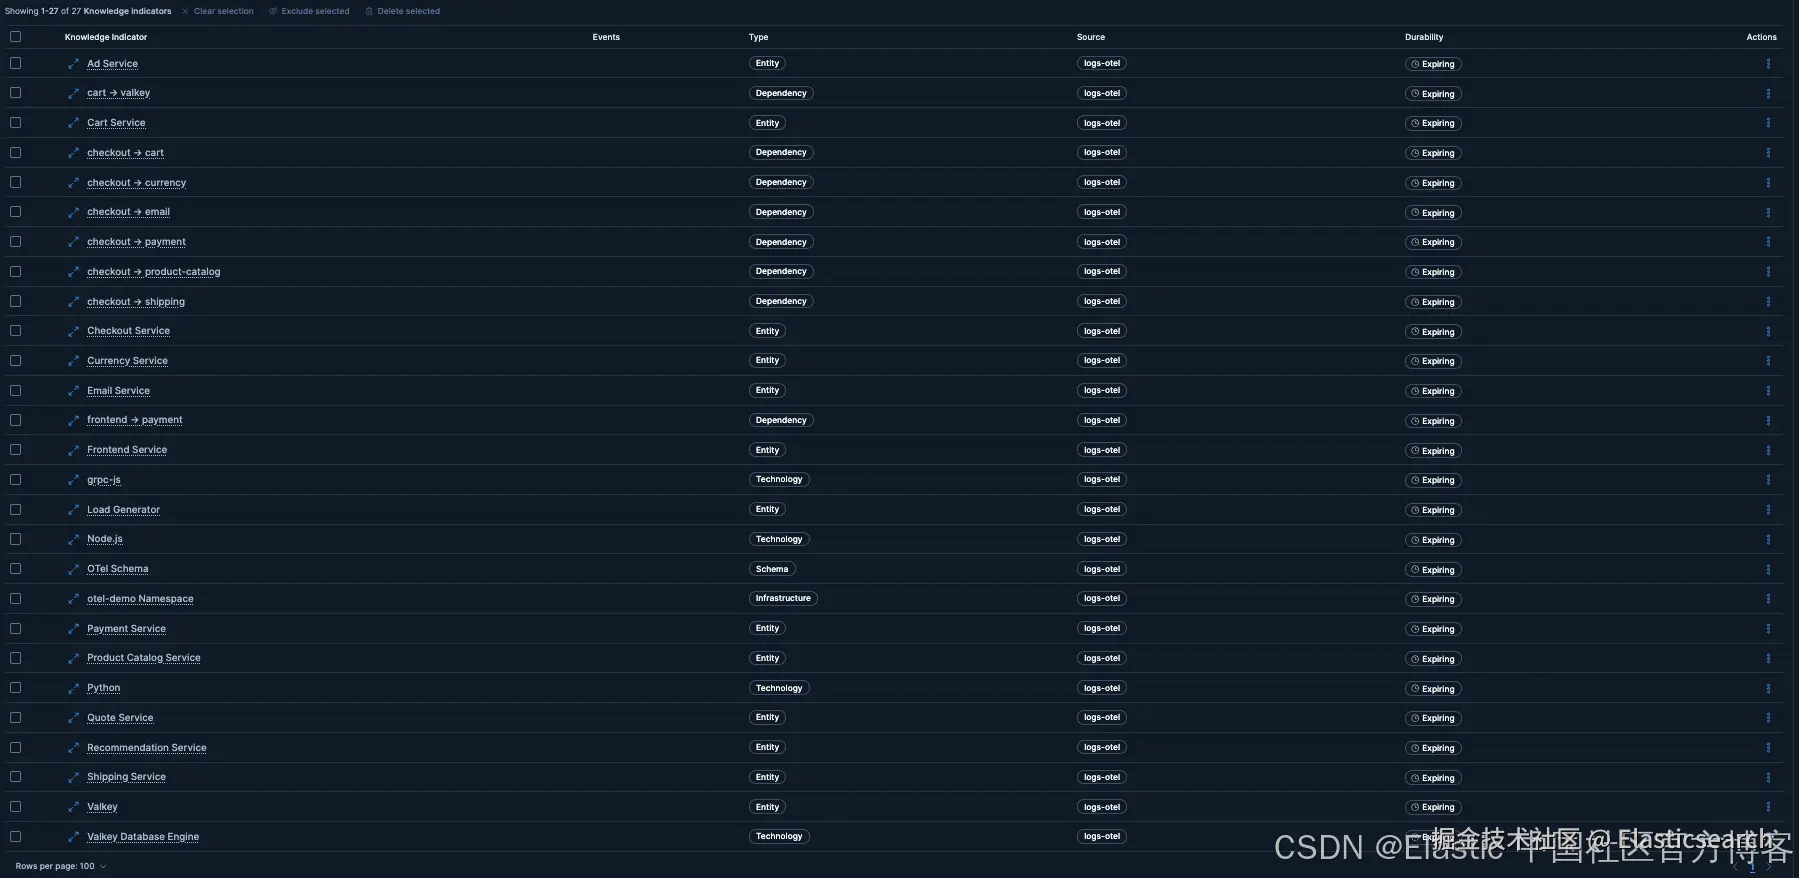 从示例日志源中提取的 27 个特征知识指标:13 个实体、它们之间的 8 条依赖关系、4 种技术、Kubernetes 基础设施和数据模式。每个指标都有有效期,只有提取过程持续观测到它,才会继续保留。
日志采样如何选择模型读取的文档
提取循环:五批,每批 20 份文档
接入日志源时,先运行提取,再生成查询,而提取是一个循环过程。每次迭代都会采样一批文档,将其连同日志源的已知信息交给一个 agent,由它返回新增和更新的特征。代码会将这些特征与已存储的知识指标进行核对,持久化保存变更,并决定是否再次迭代。默认情况下,每次运行最多处理五批,每批 20 份文档,总计 100 份;如果连续两批都未增加新信息,就会提前停止。单批文档的规模并不大于前面那种会失败的单次提示词所包含的规模;它必须与所有已知信息一起放入模型的上下文中。真正带来区别的是循环:每批采样都会朝着前几批未能解释的内容推进,结果则累积在知识指标存储中,而不是同一个 上下文窗口 里。
提取步骤由一个 agent 构建器 agent 执行;Kibana 工作流负责控制循环,让每次运行都能在工作流界面中查看。agent 推理分析一批文档说明了什么;代码则决定它能看到哪些文档,以及它给出的内容是否与某项已知信息相匹配。采样和身份识别是确保正确性的关键,因此我们将它们保留在可衡量的代码逻辑中。
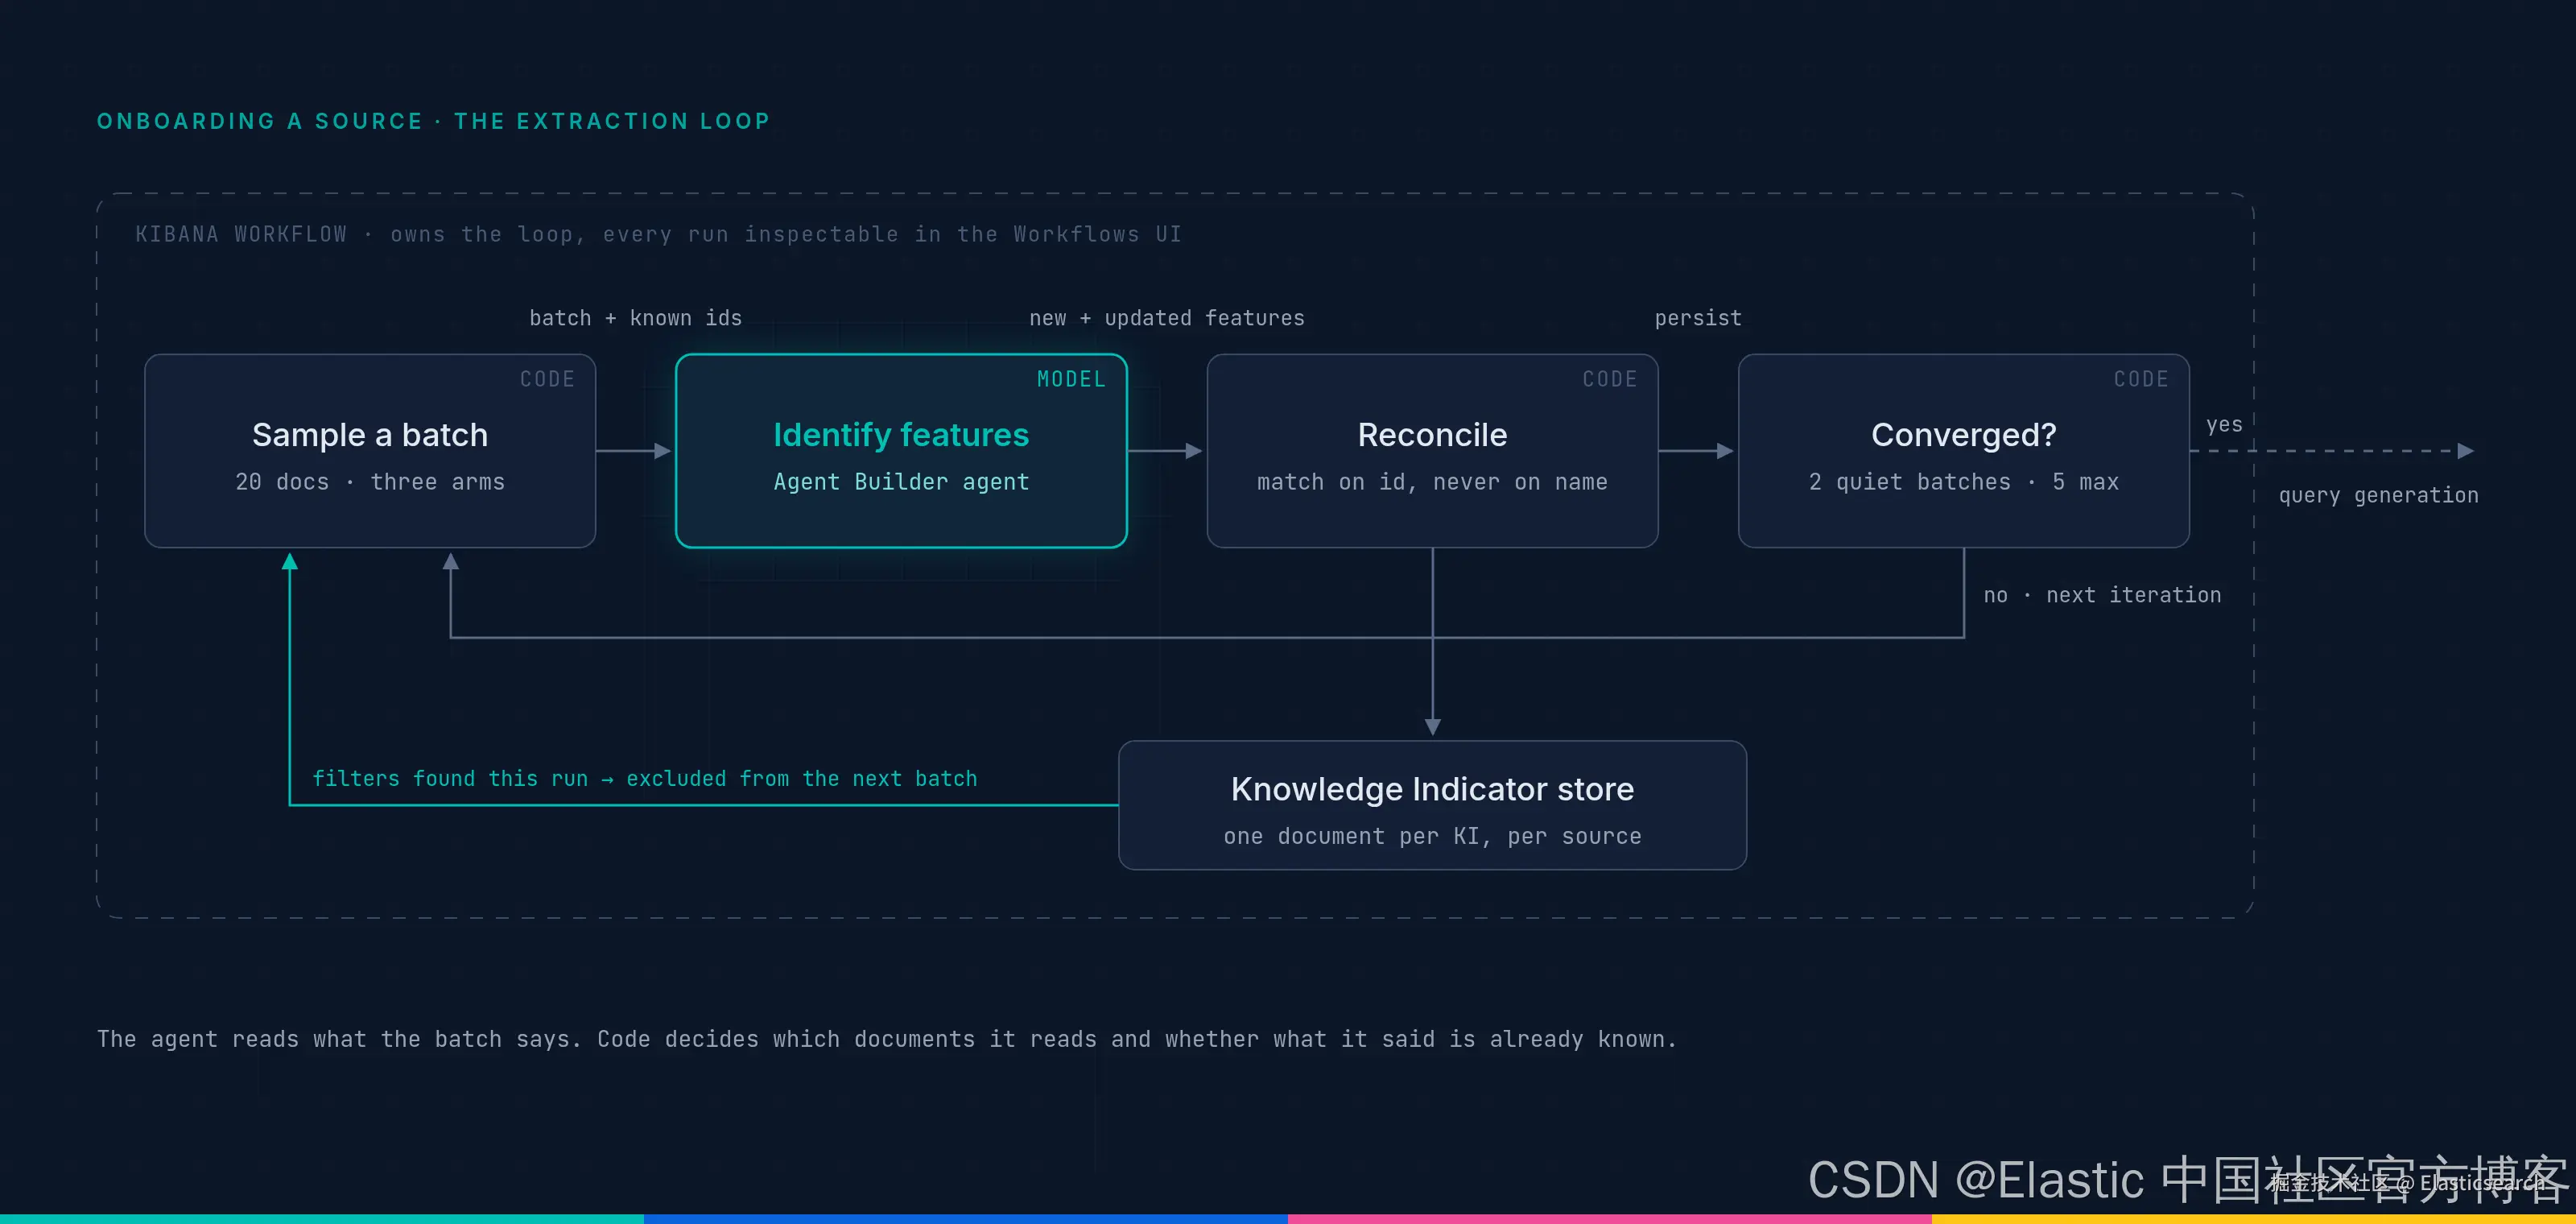
一次接入运行。只有高亮显示的步骤由模型执行;循环、采样和匹配均由代码完成。反馈路径让循环逐步收敛。
为什么均匀随机采样会遗漏检测所需的信息
面对数百万份文档,只采样几批。如果采用均匀抽样,这些样本反映的就是日志源的频率分布,而其中占主导地位的是最繁忙的服务在每次请求时记录的内容。日志较少的服务、罕见的依赖关系,以及仅在部署或故障期间出现的组件,恰恰是检测所需的信息,但均匀采样无法充分覆盖它们。因此,每批样本都会通过三种采样方式抽取,再合并。
| 采样方式 | 占每批样本的比例 | 抽样方法 | 作用 |
|---|---|---|---|
| 按实体筛选 | 40% | 排除本次运行中迄今发现的所有 filter 所匹配的文档,从无法被任何已知实体解释的文档中抽样 |
让循环收敛:系统已经能够解释的文档不再被采样 |
| 多样性采样 | 40% | 对消息字段运行 CATEGORIZE,从每种模式中选取一个代表样本 | 覆盖不同的消息形态,而不是按消息数量分配样本 |
| 随机采样 | 20% | 在整个日志源中均匀抽样 | 补充样本,也是唯一反映日志源真实频率分布的采样方式 |
!\[\](https://i-blog.csdnimg.cn/direct/fe96a9b17c7346b396cbc025ecbdc9d6.png) 单批样本的组成方式。按实体筛选的采样方式会排除本次运行中迄今发现的所有筛选条件所匹配的文档,因此每批样本都从尚未得到解释的剩余文档中抽取;多样性采样则会在不同迭代之间轮换频率区间。
基准测试:三路日志采样与均匀随机采样的对比
最终确定这一设计的基准测试,对比了三路采样器与均匀随机采样。
| 混合采样(三路) | 随机采样 | |
|---|---|---|
| 每次运行提取的特征数,取 5 次平均值 | 26.0 | 17.6 |
| 每次运行覆盖的日志类别数,共 60 类 | 每次均覆盖全部 60 类 | 21 至 24 类 |
| 5 次运行中仅由该策略发现的特征数 | 34 | 5 |
| 评判模型的偏好 | 5 次全部胜出 | 0 次胜出 |
方法说明:将四种 OpenTelemetry 演示场景重放到同一个日志源中;混合采样和随机采样各运行五次;使用 GPT-5.4 mini 提取特征,由 Gemini 3.1 Flash-Lite 根据架构完整性进行评判。本实验中的多样性采样采用的是早于当前分层采样器的版本,因此它表明混合采样在该实验设置下优于随机采样,并非对当前生产环境所用采样器的精确基准测试。
日志类别这一行揭示了其中的机制:混合采样每次运行都能看到所有消息形态,而随机采样最多只能看到约三分之一。评判模型反复强调的差异是依赖关系。在唯一一次双方都提取出 20 个特征的运行中,混合采样明确识别出了四条服务间依赖关系,而随机采样只给出了笼统的"下游 gRPC 依赖"。数量相同,获得的知识却不同。
针对罕见日志模式的分层采样
采样器一直在改进。在一个高流量的内部日志源中,提取时间窗口内约有 600 万份文档,其中一种表示请求正常完成的模式就占了约 92%。几种每次发布都会触发的生命周期消息,各自仅出现了 56 至 64 次,而服务负责人确认这些消息很重要。对于任何按频率抽样的采样器而言,这些出现概率约为十万分之一的模式都难以被发现。如果"多样性"采样只从最常见的类别中选取代表样本,也会继承同样的偏差,因为它只覆盖了分布头部的多样性。这一发现促成了当前的分层采样器。它分两轮进行分类:先处理占日志流 1% 以上的模式,再排除这些模式,对剩余内容进行分类,从而让罕见模式也能被统计,而不是因取整而被忽略。随后,它会从各频率区间中选取一种模式,并在不同迭代之间轮换,确保长尾模式也能被读取。
如何避免重复提取同一个服务
启用持续接入后,接入流程会按计划再次运行,根据新样本重新描述相同的服务。如果不加约束,模型就会重新命名这些组件:checkout 变成 checkout-service,frontend 变成 frontend-v2.3.1,每次改名都会产生一个新的知识指标,让生成器基于重复信息开展工作。
我们通过两种机制处理这一问题:从设计上确保同一组件对应同一标识符,并捕获漏网的重复项。模型会写入一个短标识符 id;存储标识符则是根据日志源和转为小写的短标识符生成的通用唯一标识符,因此,同一日志源中的相同短标识符始终对应同一份文档。版本号、构建哈希值和镜像标签都不应出现在标识符中。模型会看到一份受上下文窗口大小限制的精简清单,其中列出该日志源当前有效的标识符,并被要求在遇到同一组件时复用完全一致的标识符,其他情况则使用相似性搜索工具核查。
结果返回后,代码会分三个层级,将每个返回的特征与已知特征进行匹配,绝不依据名称相似度:
- **短标识符完全一致。**模型写入的短标识符与已存储的短标识符匹配。
- 类型相同,且去除类似版本号的后缀后匹配。
frontend-v2.3.1会归并到frontend。 - **类型、子类型和属性相同。**这就是文档中所述的用作去重键的指纹。
匹配成功就合并到已存储的知识指标中,未匹配则创建新的知识指标。
知识指标如何过期,以及你可以手动调整哪些设置
知识指标描述的是一个不断变化的系统,因此,只增不减的清单终将失准。系统提取的知识指标_会过期_:每个指标都会在最后一次被观测到的 30 天后失效。这段宽限期是必要的,因为单次运行可能遗漏仍然存在的组件。你创建或标记为_永久保留_的知识指标永不过期,只有你能将其移除。排除某个知识指标后,它就不会再参与后续运行。
在哪里审核和排除知识指标
在 Elastic 夜班系统中,从"日志源"页面接入日志源会触发一次运行。"知识"下的"知识指标"选项卡会列出所有知识指标及其来源,你可以在这里排除或恢复知识指标,并在永久保留和到期失效之间切换。针对已启用日志源的持续接入是一项独立设置,默认关闭;详见文档。
日志采样仍然无法解决什么
还有三个问题尚未解决:
- **数十亿文档规模下的罕见模式覆盖。**没有哪种采样器能解决这一问题。一条在十亿份文档中仅出现一次的消息,需要采用不同的机制。
- **跨日志源的身份识别。**目前,同一服务出现在两个日志源中时,会对应两个知识指标,这是有意为之,我们尚未探索将其合并。
- **成本控制。**根据尚待发现的信息量决定运行多少提取工作,这一机制仍在完善。
我们正在进行基准测试的 agent 驱动替代方案
更大规模的实验是一个由 agent 驱动的发现循环:agent 配备工具,可以自行抽取样本、查询已知信息并直接写入知识指标。我们在相同数据集上,将它与本文介绍的循环进行基准比较。这会将采样和身份识别的保障从代码转移到 agent 的判断上,而它必须通过相同的衡量标准证明自身价值,才能被采用。
第二部分将介绍什么
第二部分将接着使用上文提取的知识指标,展示生成器因掌握这些信息而生成的查询:通过筛选条件将范围限定到发起调用的服务,识别发生故障的依赖关系,在该数据模式所使用的字段中匹配故障,并以来源为依据,在来源失效时一并停用。第二部分只根据第一部分发现的 内容生成 查询,而第一部分只能发现采样所覆盖的内容。
常见问题
Elastic 重大事件功能中的知识指标是什么?
知识指标是已存储且有证据支撑的日志源事实,可以是服务、服务间的依赖关系、技术、基础设施组件或数据模式。特征知识指标从采样文档中提取;查询知识指标则是根据这些特征生成的 ES|QL 查询。
启用重大事件功能后,会自动开始提取吗?
不会。只有在 Elastic 夜班系统的"日志源"页面接入日志源时,才会运行提取。针对已启用日志源的持续接入是一项独立设置,默认关闭。
我可以自行排除或保留知识指标吗?
你可以在 "知识" 下的 "知识指标" 选项卡中排除某个知识指标,使其不再被重新生成;也可以将其标记为永久保留,使其不会自行过期。