传统思路是"给 AI 看整个世界,让它自己搞清楚怎么玩"。jev-ultrafast 换了个方向:先把世界翻译成 AI 能快速理解的结构化数据,再让 AI 做它最擅长的事------选一个。
一、序言
这几天技术圈的朋友,估计很多都被两极分化的讨论刷屏了。
一边是社交平台上的高度评价。有人将其用于企业收件箱自动化分拣,把 300 封包含商务采购、线上故障与日常通知的邮件实时路由给 15 个业务部门,耗时 9.9 秒,API 成本仅约 3 美分。相较于传统大语言模型逐字生成的自回归推理,并发吞吐提升了数十倍。
另一边,工程实测也迅速暴露出明显的短板。有人将其接入浏览器端到端自动化测试,在需要长程状态回溯的任务集中仅取得了 1/20 的完成度。也有开发者反馈,在复杂中文语境与长上下文输入下,模型的判断准确率存在明显的抖动。
同一个工具,在不同的工程应用场景中呈现出截然相反的落地表现。它就是 TypeSafe AI 刚在 2026 年 9 月 15 日正式放出来的模型,名字叫 Jev。
二、System One 模型
在认知科学里,人类的大脑有两套思维系统。
认知科学的经典隐喻。 慢思考对应 System 2,快思考对应 System 1。
- 慢思考(System 2) 负责深思熟虑、逻辑推演、微积分计算、写万字长文。它的特点是算力消耗大,速度慢,每走一步都要在心里自言自语。现在的各大推理大模型(比如 o3、Claude 3.7 Thinking),其实都在朝着 System 2 狂奔。
- 快思考(System 1) 属于本能反射。走在路上迎面飞来一颗石子,你不需要在脑子里列个抛物线方程推算受力,身体在几十毫秒内就会自动偏头躲开。看到一张熟人的脸,你不需要调取他的身份证号逐位比对,一瞬间就能认出来。
而 Jev,就是要当软件系统里的那道「神经反射弧」。
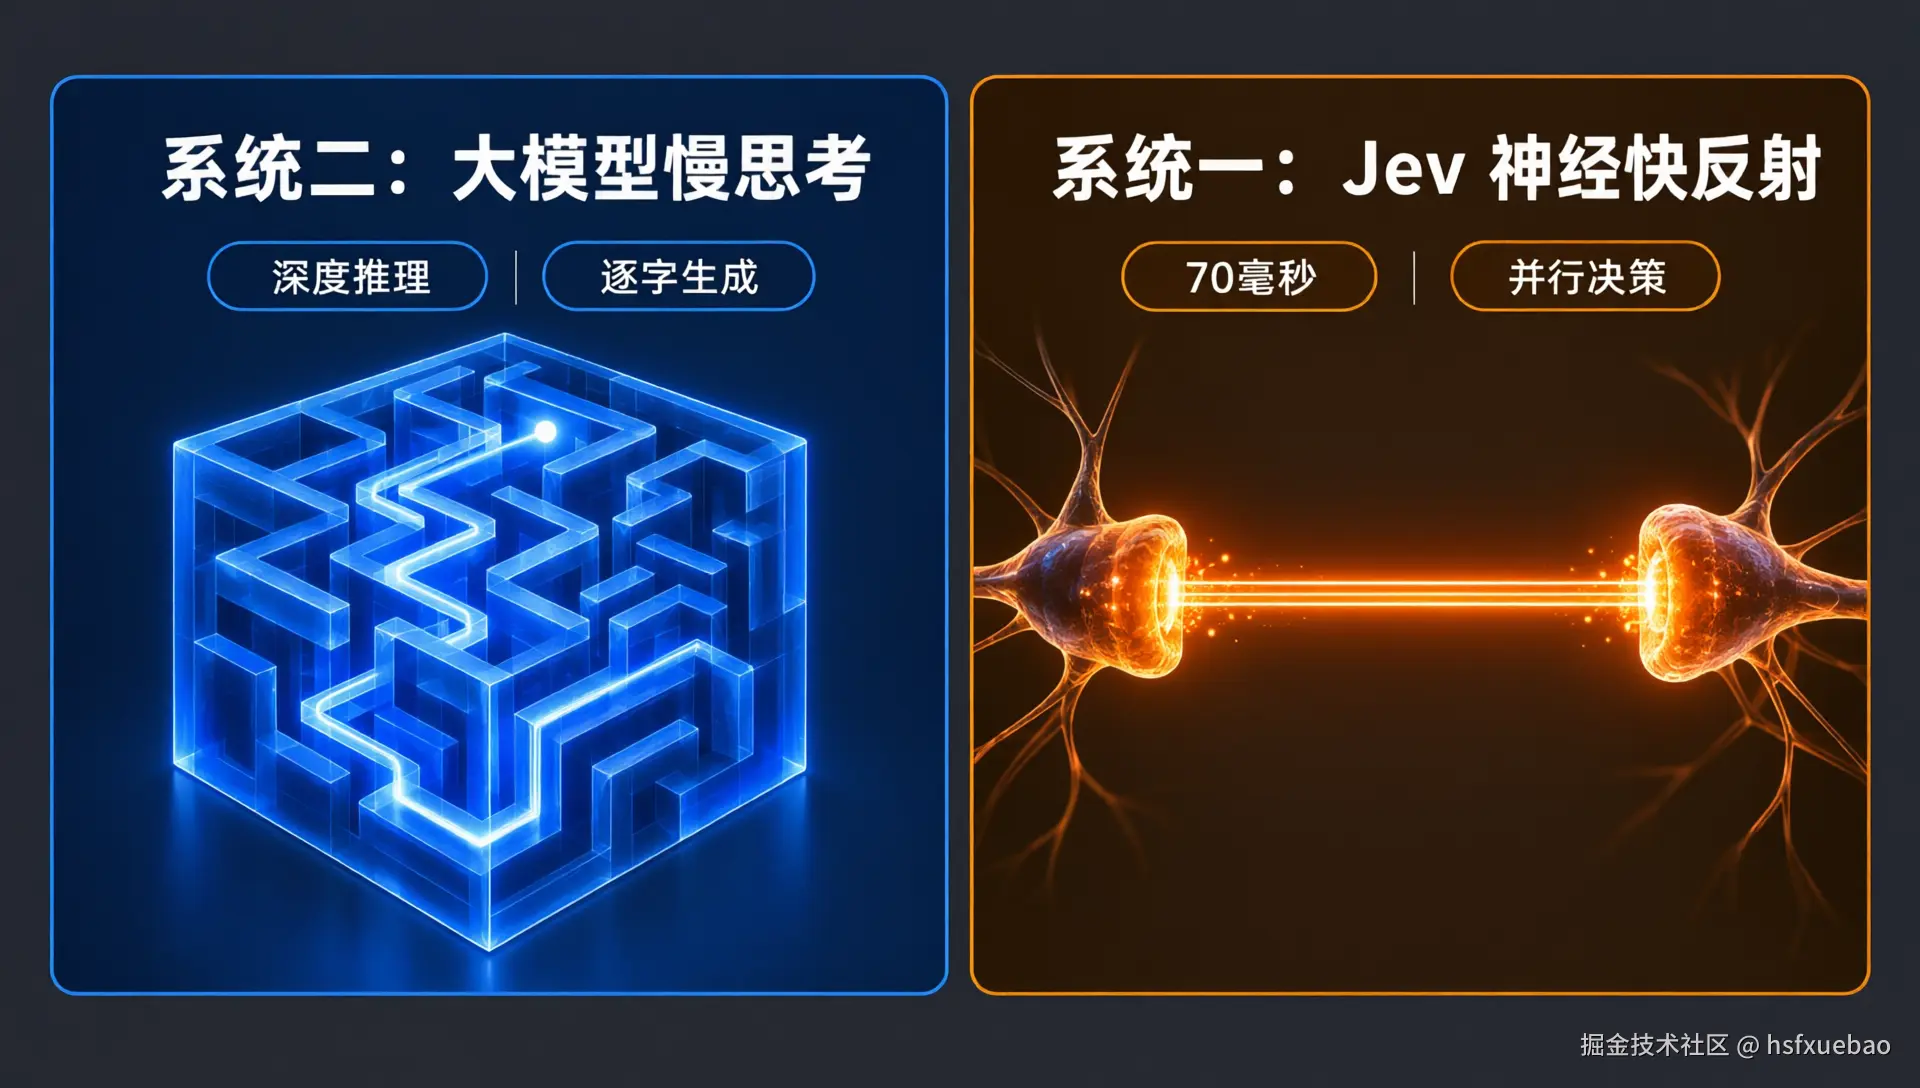
System 1 神经快反射与 System 2 慢思考大模型架构对比
三、三个 AI 原语:Choice / Score / Noul
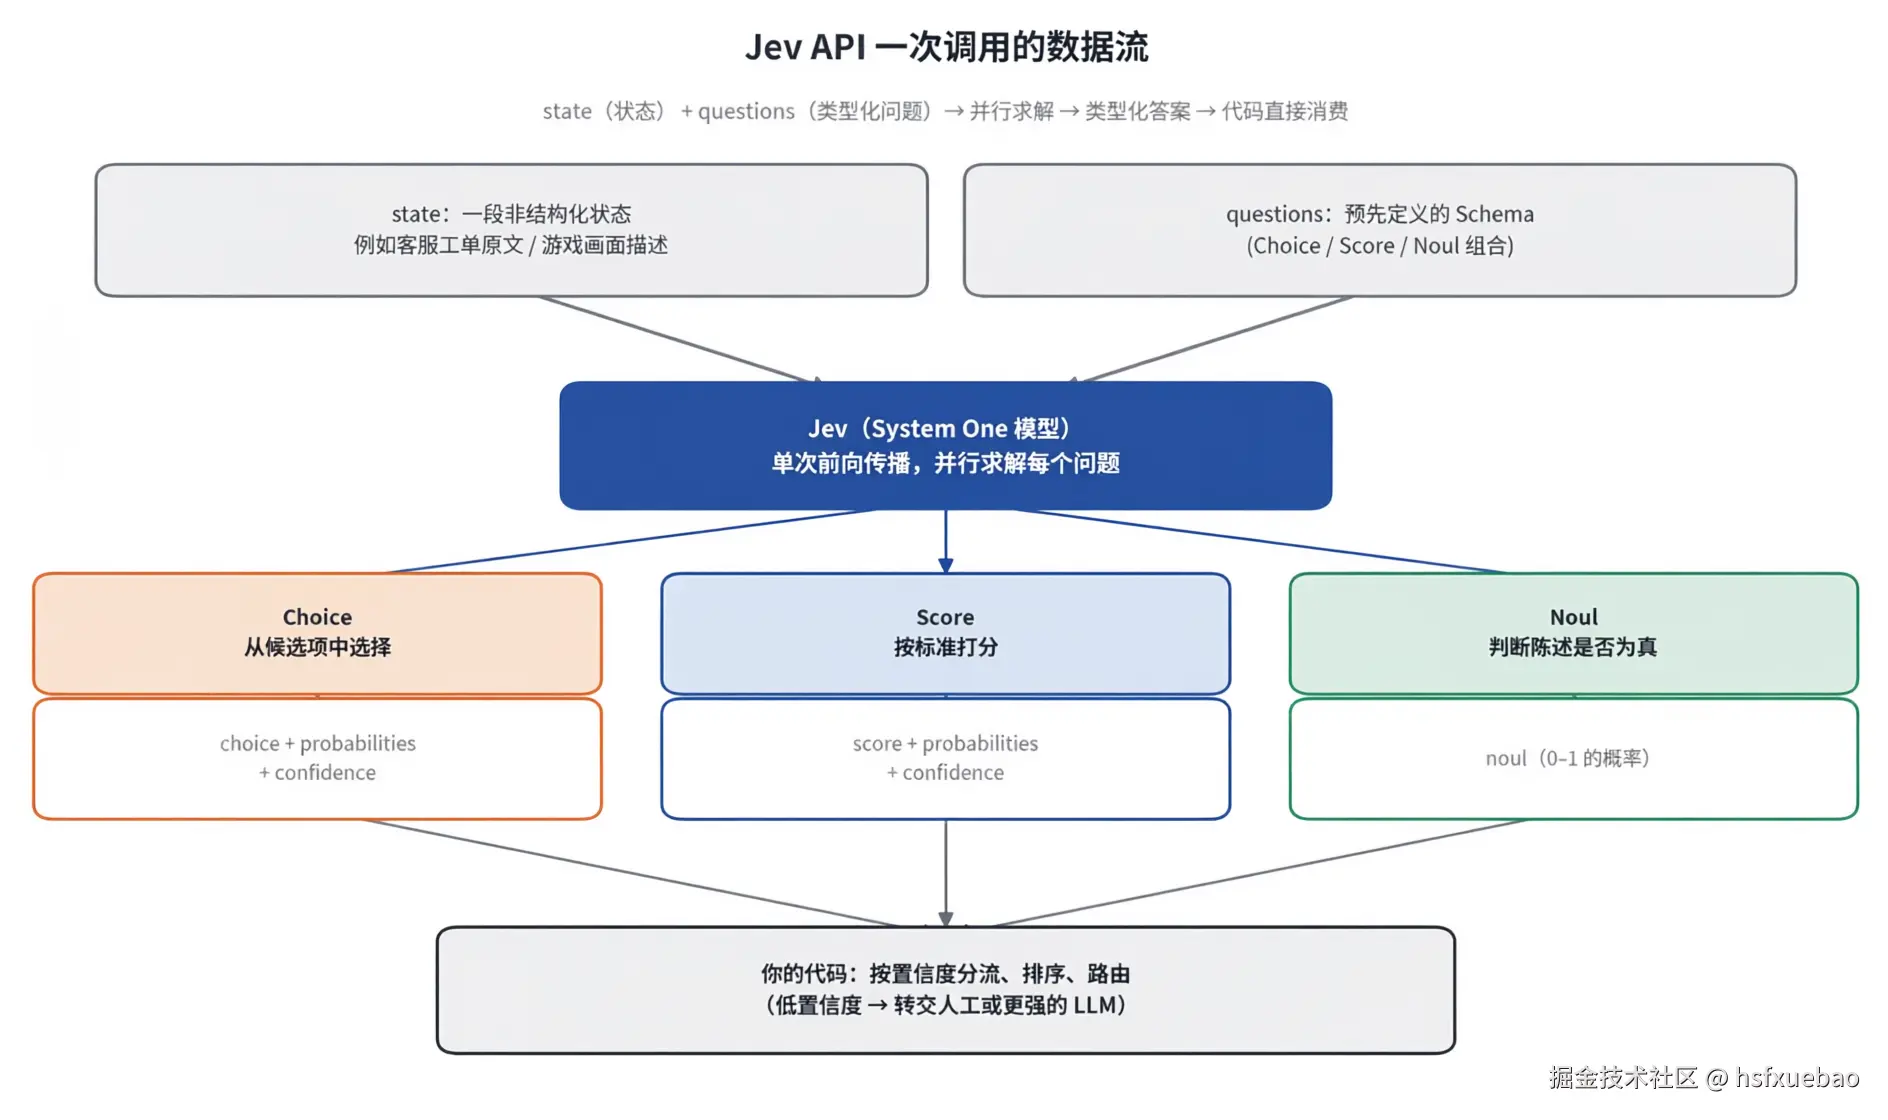
Jev 的调用方式和传统的对话式 Prompt 完全不同。你不是"跟它聊天",而是给它一段 state (可以理解成程序运行到某一刻的上下文快照,比如一条客服工单原文),再配上一组类型化的 questions,Jev 会针对每个问题并行给出结构化答案。
TypeSafe 把这套问题类型称为三个"AI 原语":
| 原语 | 角色 | 输出形态 | 核心特点 | 返回内容 |
|---|---|---|---|---|
| Choice | 离散分类器 | 从预先指定的选项池(上限 255 个)挑选一项,附带全概率分布与置信度 | 闭集分类,锁定输出边界 | 选中项 + 各选项概率分布 + 置信度 |
| Score | 标尺刻度仪 | 在固定整数区间(比如 0 到 4 档)给出评级,附带档位概率 | 离散分级打分,仅输出数值刻度 | 分值 + 概率分布 + 置信度 |
| Noul | 布尔概率计 | 0 到 1 之间的概率浮点数,比如 0.82 | 单点真假判断,直接返回后验概率 | 0 到 1 之间的概率值 |
3.1 选择(Choice)
从无序固定集合里选一项 :工单部门、商品类目、代码语言。适合 switch,不适合「有多重少」。选项最多 255 个;清单可能盖不全时加 other / none of the above。
请求字段:type: "choice";instructions 是问题;criteria 是「选项名 → 描述」的 map。选项名和描述都会进模型,描述要能把选项切开。
csharp
from typesafe_sdk import Choice, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
        questions={
            "department": Choice(
                instructions="Which team should handle this?",
                criteria={
                    "returns": "Exchanges, wrong or damaged items",
                    "shipping": "Delivery status, delays, lost packages",
                    "billing": "Charges, invoices, payment problems",
                },
            ),
        },
    )
    print(response.answers["department"].choice)
json
{
  "model": "jev-1.13.0",
  "usage": {
    "input_tokens": 357,
    "output_tokens": 38
  },
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": {
        "billing": 0.0,
        "returns": 1.0,
        "shipping": 0.0
      }
    }
  }
}答案三个字段:choice 是概率最高的选项;probabilities 在全部选项上求和为 1;confidence 在 0--1,由分布尖不尖算出来------概率全堆在一个选项则接近 1,摊在多个选项则变低。鞋码错误、只提换货时,returns 可为 1.0、confidence 1.0;同时抱怨尺码和重复扣款时,returns 与 billing 会分概率,confidence 下降。
实践:一次请求问齐代码可能用到的 Choice(含投机题)。深层类目用多层 Choice + 概率 beam search,而不是一次 greedy 走到底。代码读 choice 做主路径,读 probabilities 做抄送(例如 billing 份额 > 0.25 就抄送账单组),低 confidence 则先问用户再执行。
官方说明见 Choice。
3.2 分数(Score)
把内容评到你写好的有序档位上 :缺陷严重度、挫败感、经验深浅。档位是 criteria 数组,从低到高,至少 2 档、最多 10 档。编号就是数组下标,从 0 开始。模型只看到每档的文字描述,看不到数字、也看不到「比上一档更严重」这种相对说法。
ini
from typesafe_sdk import Score, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state="The export button crashes the settings page in Safari. It works in Chrome, but a few of our customers only use Safari.",
        questions={
            "bug_severity": Score(
                instructions="How severe is the reported issue?",  // "这个上报的问题严重程度如何?"
                criteria=[
                    "Cosmetic; no impact to functionality", // "外观问题;不影响实际功能",
                    "Broken or degraded feature, but workaround exists", // "功能损坏或降级,但存在变通方案",
                    "Blocking issue; no workaround exists", // "阻塞性问题;不存在变通方案",
                ],
            ),
        },
    )
    print(response.answers["bug_severity"].score)
makefile
{
  "model": "jev-1.13.0",
  "usage": {
    "input_tokens": 341,
    "output_tokens": 20
  },
  "answers": {
    "bug_severity": {
      "type": "score",
      "score": 1.42,
      "confidence": 0.37,
      "legend": {
        "0": "Cosmetic; no impact to functionality",
        "1": "Broken or degraded feature, but workaround exists",
        "2": "Blocking issue; no workaround exists"
      },
      "probabilities": {
        "0": 0.0,
        "1": 0.58,
        "2": 0.42
      }
    }
  }
}
bug_severity.score: 1.42返回答案:probabilities 按档位编号分布(求和为 1);score 是档位编号的概率加权均值 ,可以落在两档之间,例如 0×0 + 1×0.57 + 2×0.43 = 1.43;legend 把编号映回描述;confidence 同样看分布尖不尖。1.43 表示卡在「有 workaround」和「完全 blocking」之间------多数人能改用 Chrome,只用不了 Safari 的用户没有 workaround。
写档位要写可匹配的情境 ,不要写「中等严重」。只用 ["0","1","2"] 时,模型没有可对齐的语义,会把概率摊开、confidence 变差。一题只测一个维度;「守时且聪明且资深」应拆成三题。需要单独处置的极端(辱骂/威胁)应单独成档,否则会和「很生气」挤在最高分附近。
同一 score 可能对应完全不同的分布:1.0 可以是 100% 落在第 1 档,也可以是 0 档和 2 档各一半。排序或四舍五入到最近档之前,要一起看 probabilities 和 confidence。多题合成优先级时,先用 score / (档位数 - 1) 归一化再加权,权重留在代码里改。
官方说明见 Score。
3.3 努尔(Noul)
Noul 问是否,返回「为真」的概率,0 为否、1 为是。适合退款申请、是否含 PII、简历是否提到分布式。Noul 没有 单独的 confidence:只有 yes/no 两个结果,一个 noul 就描述完整分布。接近 0.5 表示模型认为是否差不多。
请求:type: "noul";instructions 用疑问句或陈述句均可;可选 criteria 用 true / false 说明什么算是、什么算否。
ini
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state="I have asked three times now. Can I please just talk to a real person?",
        questions={
            "is_human_escalation": Noul(
                instructions="Is the customer asking for a human agent?",
            ),
            "is_repeat_contact": Noul(
                instructions="Has the customer contacted support about this before?", // "客户之前是否就此事联系过客服?"
                criteria=NoulCriteria(
                    true="Mentions a prior attempt, ticket, or that they have asked before", //"提到了之前的尝试、工单,或者说过他们之前已经问过",
                    false="No sign of any previous contact", // "没有任何之前联系过的迹象",
                ),
            ),
        },
    )
makefile
{
  "model": "jev-1.13.0",
  "usage": {
    "input_tokens": 344,
    "output_tokens": 43
  },
  "answers": {
    "is_human_escalation": {
      "type": "noul",
      "noul": 0.99
    },
    "is_repeat_contact": {
      "type": "noul",
      "noul": 0.94
    }
  }
}
is_human_escalation.noul: 0.99
is_repeat_contact.noul: 0.94
读法:靠近 1 是强是,靠近 0 是强否。阈值放在代码里------误报代价高(呼叫值班、打款)就提高阈值;漏报代价高(安全问题)就降低;中间带给人审。不要把 Noul 当成程度尺:「Python 强不强」的 0.5 不是「中等水平」,只是是否「强」的把握对半。要测程度用 Score,把档位写成无经验 / 偶尔脚本 / 工作常用 / 深度专家。
一题一个条件。「又生气又要退款」应拆成两个 Noul,再在代码里 and。问句方向要让高分表示「是」,避免「是否不含 PII」这种取反。边界含混时补 true/false 描述。
官方说明见 Noul。
四、底层原理拆解
很多人觉得,这不就是一个参数量很小的轻量蒸馏模型吗?
还真不是。如果仅仅是把 LLM 做小,它依然逃不掉自回归的时序诅咒。Jev 能跑出 70ms 到 500ms 的端到端响应,底层在这三个硬核技术支柱上。
4.1 并行采样(Parallel Sampler)摆脱时序自回归
传统大语言模型的计算依赖自回归解码机制。
每预测一个 Token,都必须将已生成的上下文连同输入重新参与注意力计算,完成一次完整的前向传播。若生成 100 个 Token,就需要执行 100 次串行前向循环,时间开销随着输出长度线性叠加。
而 Jev 不生成自然语言文本。在请求到达时,输出字段的定义与类别空间就已经完全确定。
即使一次请求包含分类、打分与布尔判断等多个离散问题,Jev 底层的硬件感知采样器能够在单次前向传播(Forward Pass)中,将所有目标变量的后验概率矩阵并行计算完成。
所有字段的概率分布一次性产出,无需逐步等待前序字段生成。因此在单次请求中组合多个判断条件时,其计算耗时相对稳定,不会随字段数量呈倍数线性膨胀。
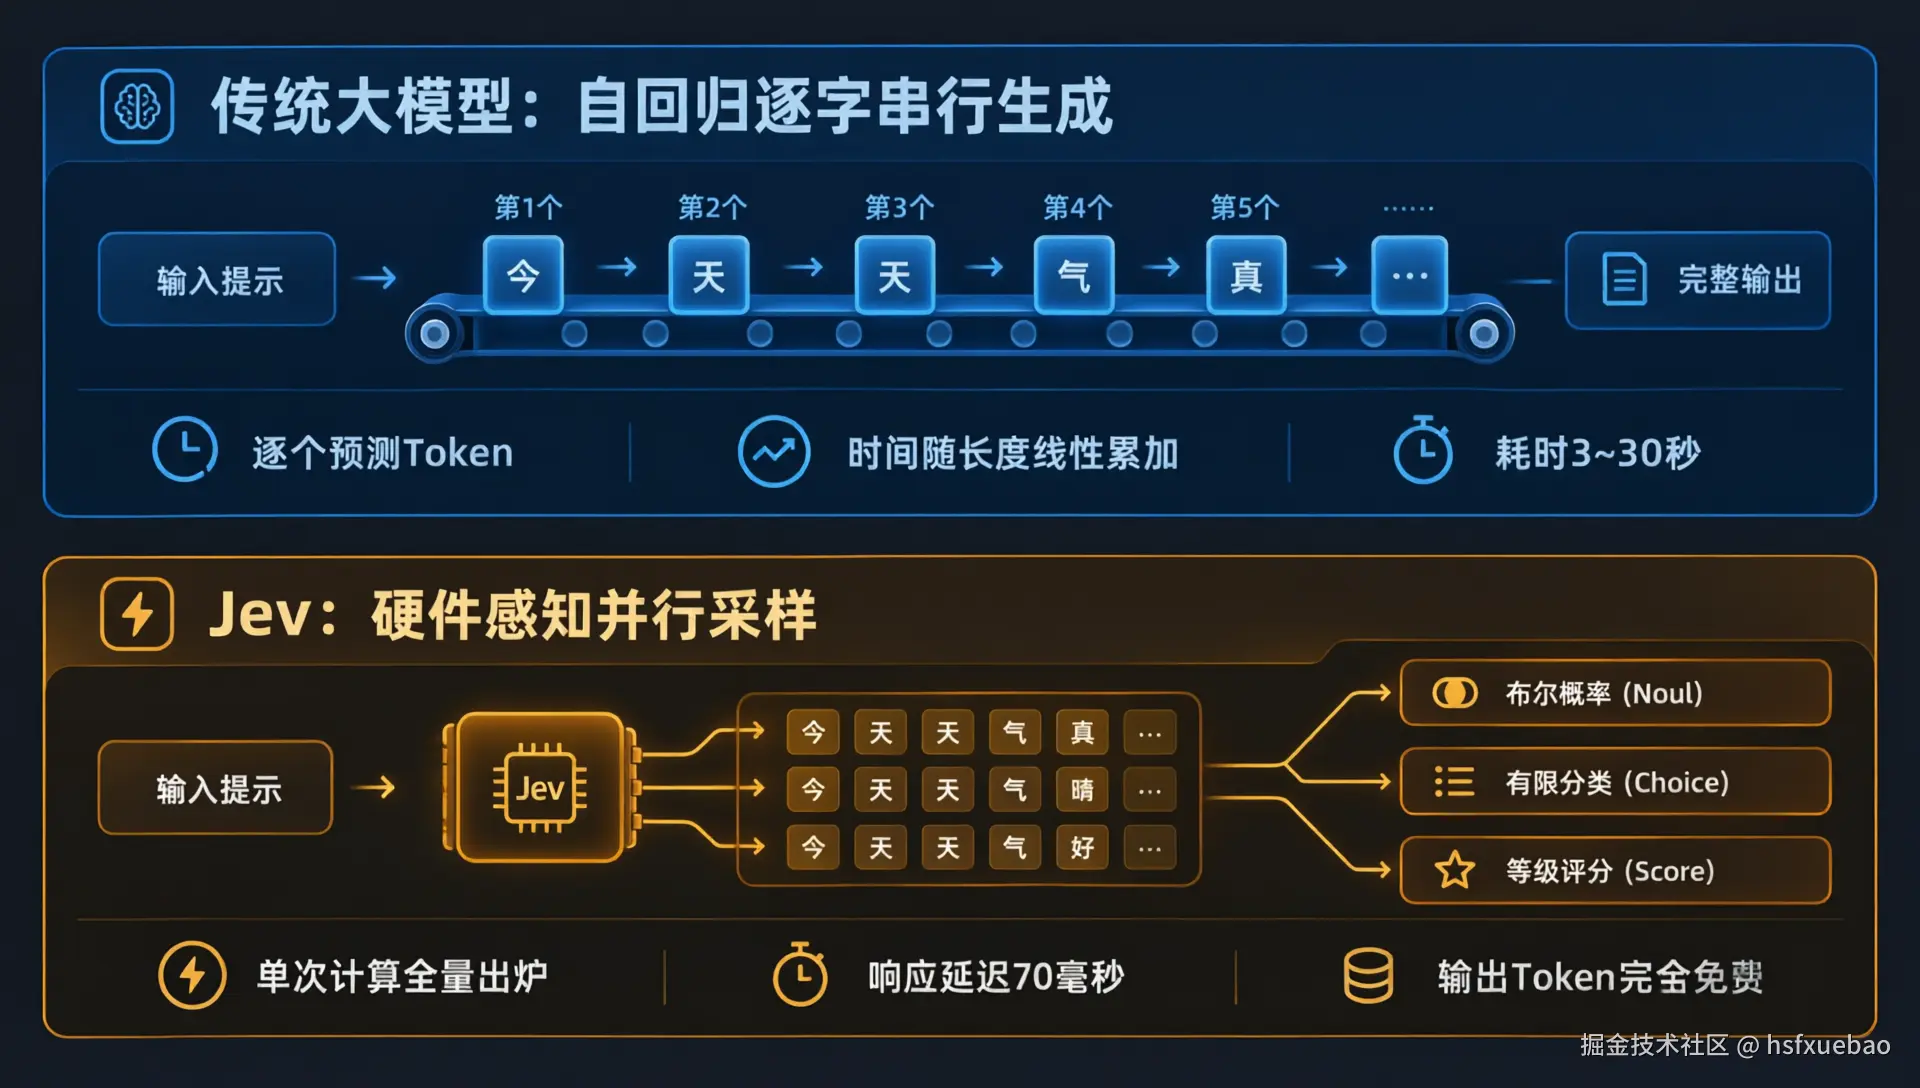
LLM 自回归逐字生成机制与 Jev 并行决策对比
4.2 RLCD 算法,强化置信度校准
当前大语言模型的主流训练方式通常为 RLHF(人类反馈强化学习)或 RLVR(可验证奖励强化学习)。
RLHF 面向人类主观偏好进行对齐,在实践中容易促使模型倾向于生成篇幅冗长、用词委婉的文本。 RLVR 则依赖明确的判题反馈(如代码测试用例或数学答案),但在缺乏自动化编译器的复杂业务流中很难直接构建验证闭环。 Jev 采用了一套名为 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习) 的训练范式。
这套算法不以生成对话体验为导向,其核心目标高度聚焦于认知诚实(Epistemic Honesty)与置信度校准。
置信度校准的工程价值 在工业级自动化流程中,最具破坏性的风险在于模型在给出错误判断时依然伴随着极高的置信度。如果一个模型在 5% 的边界样本上发生误判,却无法通过置信度指标暴露不确定性,下游业务流水线就很难设计安全拦截策略。 RLCD 的训练目标是拉近模型输出置信度与经验准确率的统计一致性。当模型给出 0.95 的置信度时,其后验经验准确率接近 95%,而当置信度跌落至 0.4 附近时,工程系统便能基于清晰的阈值触发兜底逻辑或转入人工审核。
| 训练方法 | 优化目标 |
|---|---|
| RLHF(人类反馈强化学习) | 让回复更符合人类评审员的偏好 |
| RLVR(可验证奖励强化学习) | 让输出能被程序自动验证为正确 |
| RLCD(校准决策强化学习) | 让概率判断诚实、可校准------模型说「九成把握」时,真实命中率也该接近九成 |
4.3 结构性有界输出,杜绝格式解析异常
在官方技术白皮书中,TypeSafe 指出 Jev 的类型错误(Type Error)发生率为 0% 。
这并非源于外层的工程容错测试,而是因为在模型输出层的体系结构上,它根本不走自回归字符生成链路,因此在机制层面消除了产生 JSON 格式解析错误的可能。
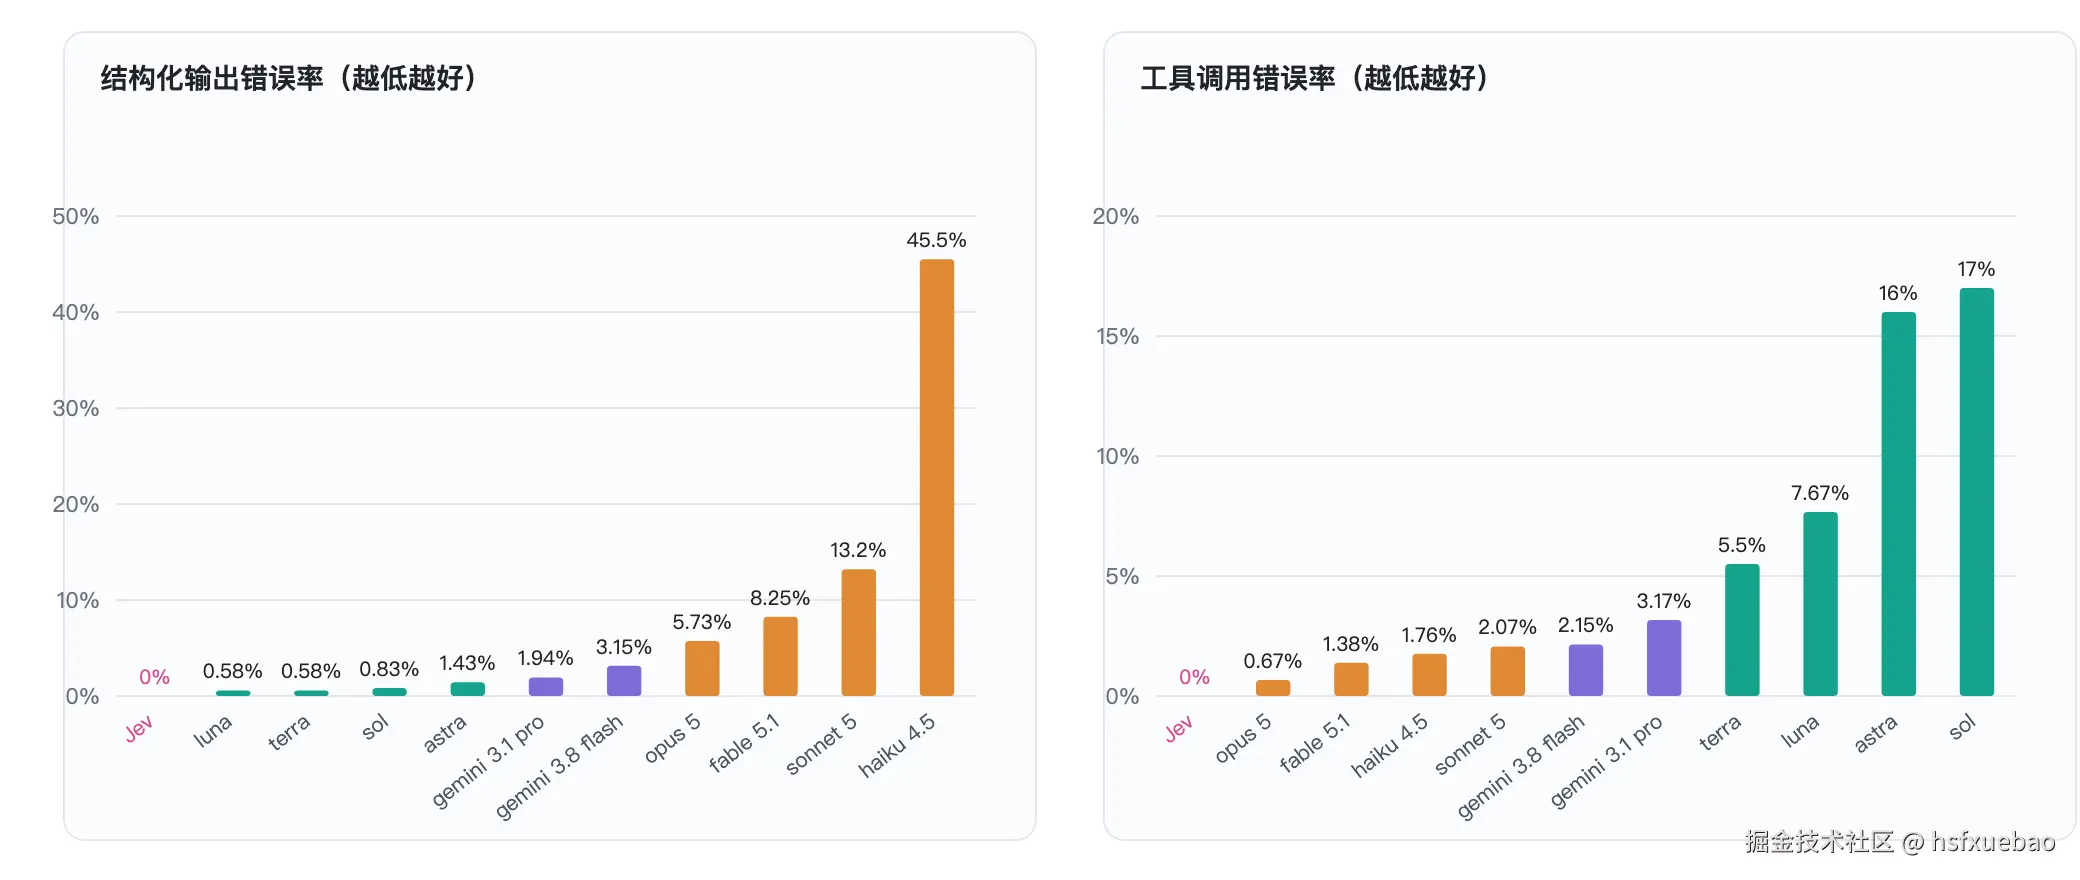
TypeSafe 官方结构化输出与工具调用错误率基准评测(来自官方博客发布数据)
官方给出的实测对比非常直观。在结构化输出错误率(Structured output error rate)上,哪怕是当前顶级的商业模型,依然会在极小概率下输出格式损坏的文本,轻量模型如 Haiku 4.5 甚至高达 45.5%,而 Jev 因为直接在受限概率单纯形上采样,数学上不可能出现类型损坏。在工具调用错误率上,Jev 同样保持了 0% 的记录。
传统方案是让大语言模型生成 JSON 格式的字符串,再由运行时代码尝试解析。而 Jev 是直接在预先约束的概率空间内计算分布 。输入一段非结构化上下文,输出的是离散索引与标量 浮点数。模型输出在受限集合内封闭,不会返回候选列表之外的非法项,也不会出现标点缺失或格式错位,因为它在输出端根本不产生字符流。
4.4 与 LLM 对比
了解了并行采样架构与 RLCD 训练范式的底层逻辑后,我们可以通过一张全维度横向对比表,完整呈现主流大模型与 Jev/System One 的核心差异与适用边界:
| 维度 | 主流大模型 | Jev / System One |
|---|---|---|
| 训练目标 | RLHF / RLVR | RLCD(校准决策) |
| 输出形态 | 字符串,需解析校验 | 类型安全的结构化值 |
| 采样方式 | 逐 token 串行生成 | 单次并行打分 |
| 典型延迟 | 3 秒到 329 秒 | 70 毫秒到 500 毫秒 |
| 输入定价 | 每百万 token 0.2 到 10 美元 | 每百万 token 0.042 美元 |
| 输出定价 | 通常是输入的 5 倍左右 | 免费 |
| 擅长场景 | 对话、写代码、需要人工把关的智能体 | 分类、路由、打分、验证、高频小判断 |
五、性能与成本:数字有多夸张
TypeSafe 官方定价相当激进:输入 token 每百万 0.042 美元(约合每十亿 token 42 美元),输出 token 免费,官方给出的理由是"便宜到不值得计费"。作为对比,主流前沿模型的输入价格普遍在 0.2 到 10 美元 / 百万 token 之间,输出价格往往还要再贵上好几倍。
更有说服力的,是 TypeSafe 自建的四项生产级工作流评测(覆盖安全事件响应、Agent 轨迹可观测性、发票处理、客服场景四类任务),参考答案取自 GPT-6 Astra 与 Fable 5.1 两个模型预测的平均值:
TypeSafe 官方 Pareto 准确率与成本前沿对比
Jev 的准确率和 GPT-5.6 Terra 基本打平,比头部的 GPT-5.6 Sol、Claude Opus 5 低几个百分点,但成本只有 Terra 的约 1/76,延迟是其 1/25。TypeSafe 官网首页给出的汇总数字是"最高 193.6 倍更快、444.6 倍更省",这类量级的加速主要体现在这类结构复杂、多步骤的生产工作流场景上。换句话说:Jev 用可以接受的准确率损失,换来了一到两个数量级的成本和延迟优势。
结构化输出的可靠性差距则更悬殊。由于 Jev 的输出被 Schema 严格约束,理论上不可能产生格式错误或幻觉------这不是经验统计,而是数学上的必然。作为对比,TypeSafe 报告的结构化输出错误率中,Claude Haiku 4.5 达到 45.5%;工具调用错误率最高的 GPT-5.6 Sol 也有 17.0%。这类错误在一次性的聊天场景里可能只是小麻烦,一旦被塞进有延迟保证、层层依赖的自动化管线里,就可能是致命问题。
六、真实应用场景
从其架构特性来看,Jev 的设计定位并非面向开放域对话,而是在现代 AI 架构中承担前置的「决策路由与分流节点」。
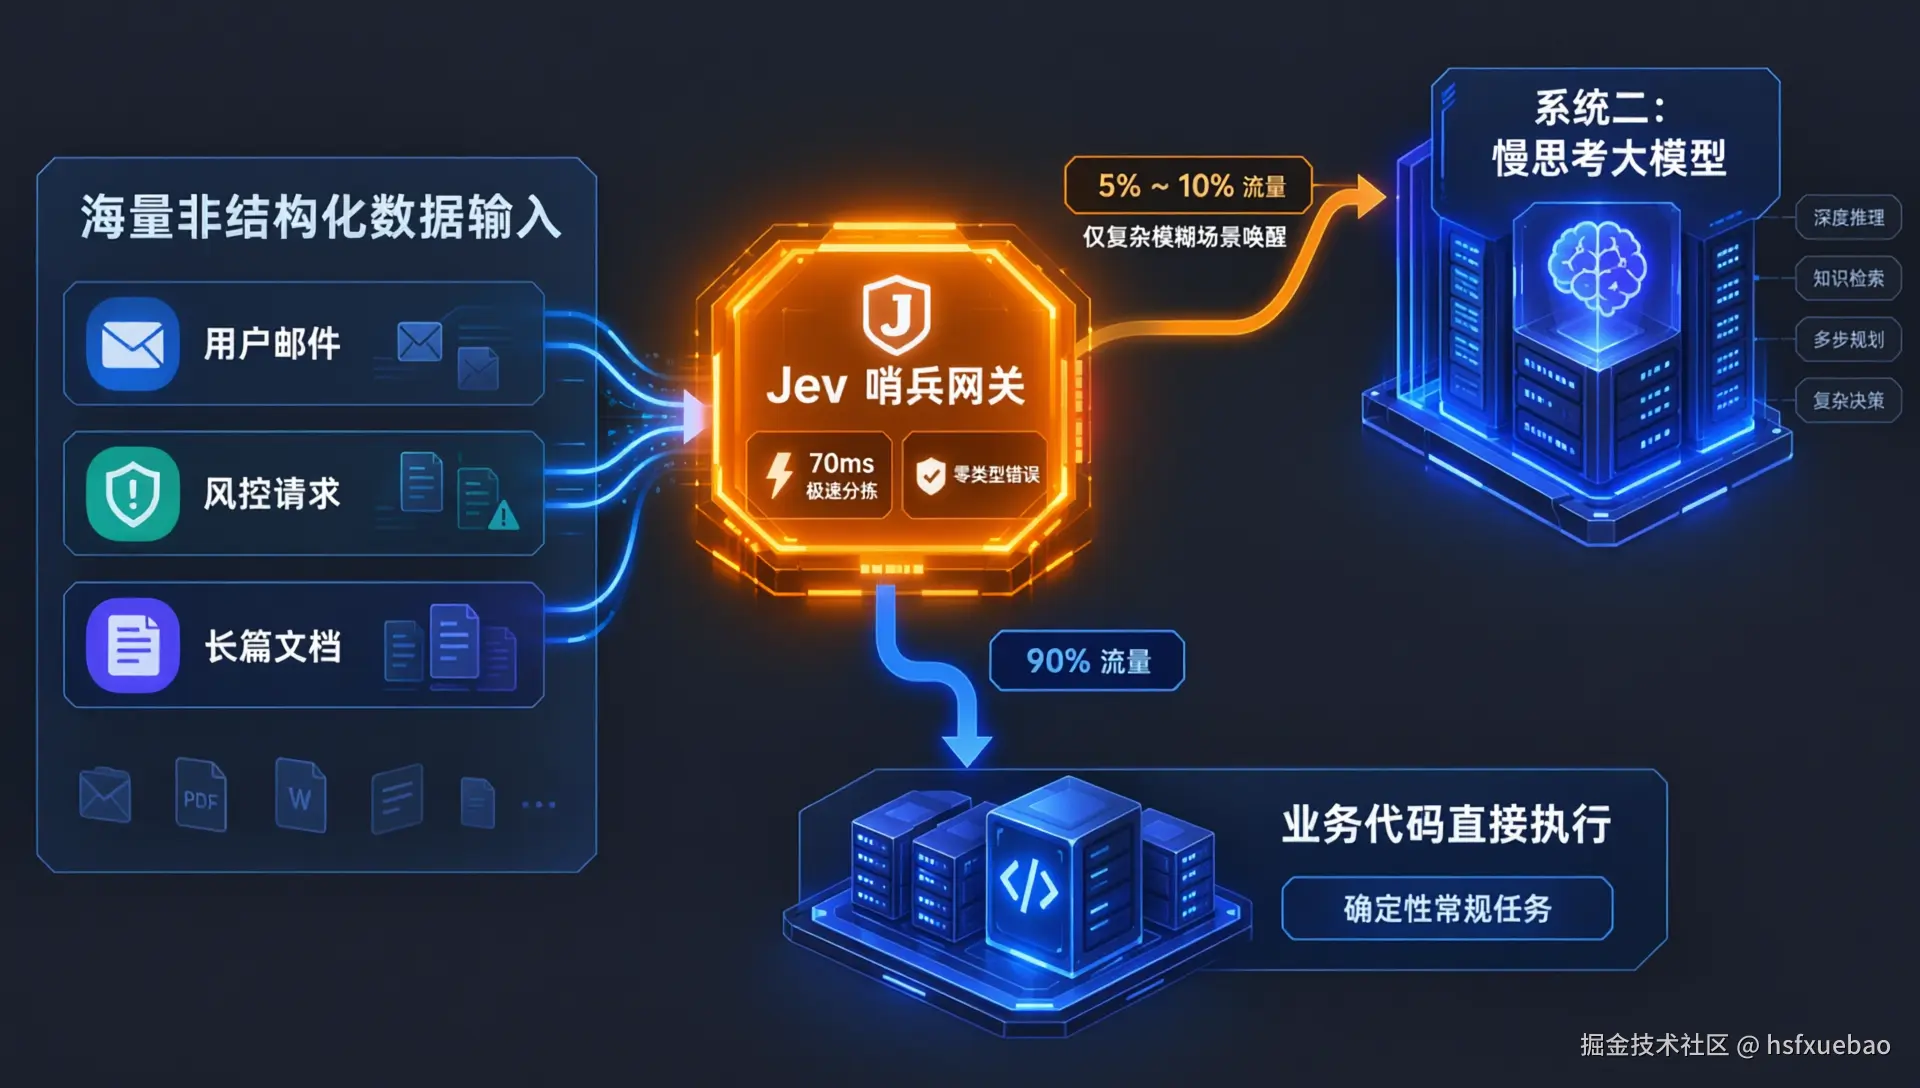
实际生产中的混合 AI 流水线架构
目前社区探索出来的几种典型用法,非常有代表性。
6.1 业务流水线的高速分流阀(Smart Routing)
在中大型业务系统中,往往存在大量维护成本高昂的硬编码规则与复杂正则表达式。例如客服工单分配、风控初筛与多模型网关。过去若全量接入生成式大模型,单次调用存在数秒延迟且高并发下成本可观,若完全依赖硬编码规则,面对语义表述灵活的输入则极易出现漏判。
Jev 恰好适用于这一中间层。
面对批量工单邮件或用户反馈,可先由 Jev 进行第一道前向判别。对于意图清晰明确的常规请求,系统可在几十毫秒内直接路由至指定处理逻辑,无需调用大语言模型。仅当 Jev 评估的置信度低于安全阈值、或分值处于临界模糊区间时,系统才将任务升级至更重的大模型进行二次复核。
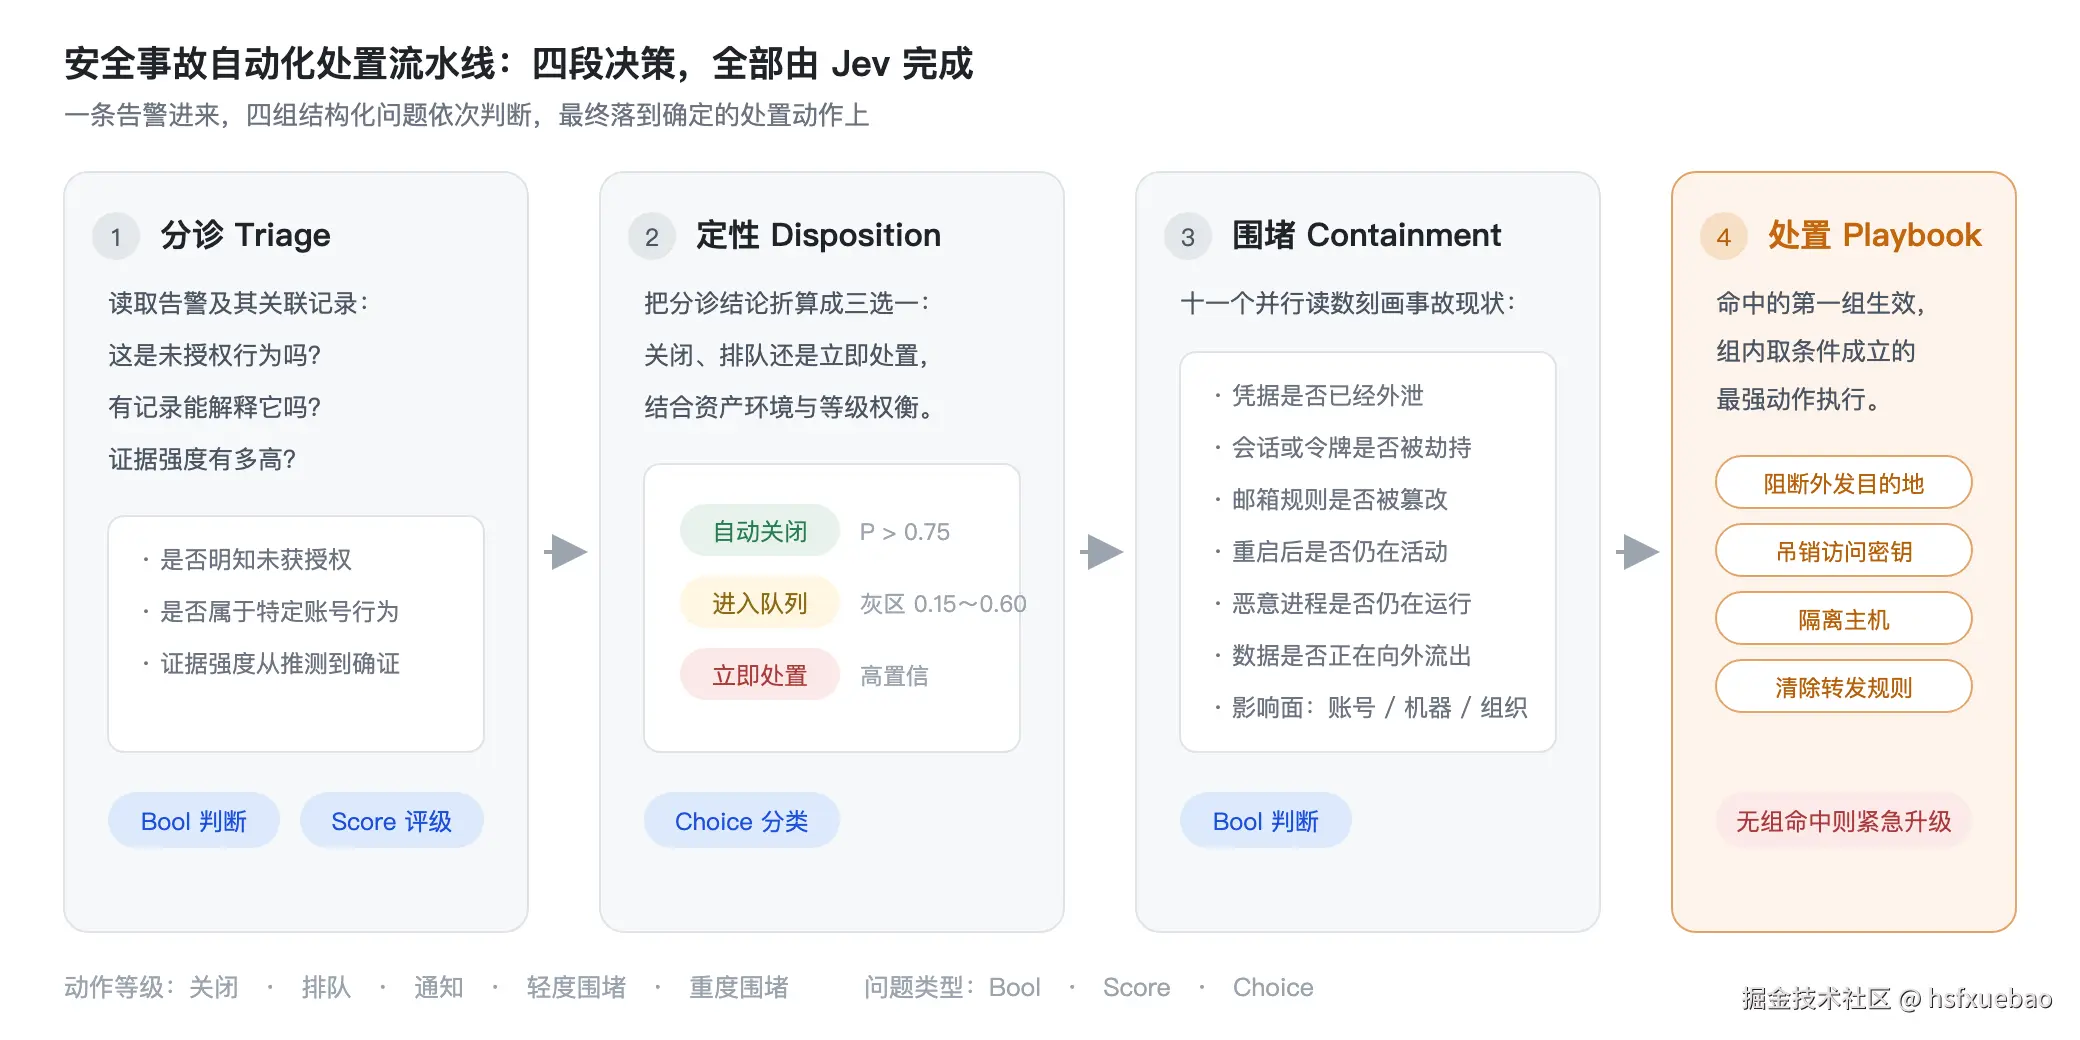
TypeSafe 官方生产级安全事故自动化处置流水线
TypeSafe 官方公布的这套企业安全响应流水线非常有参考价值。从第一步的初始审阅(Triage,让 Jev 判断告警是否异常),到第二步由代码做分支路由(Disposition),再到第三步深度遏制(Containment,让 Jev 并行评估 11 个安全状态维度),最后第四步执行确定性动作(Playbook,封禁目标、撤销会话或重置权限)。整个链条完全由布尔、打分与选择原语驱动确定性业务分支,无需经过自然语言的文本生成与二次抽取。
6.2 开发者 Agent 的上下文脱水机(Context Compaction)
现在写代码的 Agent 工具越来越多,但几乎所有重度用户都会遇到一个痛点,上下文膨胀。Agent 在复杂工程执行中,常常为了检索特定定义而读取大段文档与日志,导致主模型上下文迅速膨胀。这不仅推高了后续多轮交互的计费成本,也容易因注意力稀释而遗漏关键约束。
开源社区里的 fast-jev-compaction(针对 Claude Code 的插件),采用的就是这种思路。
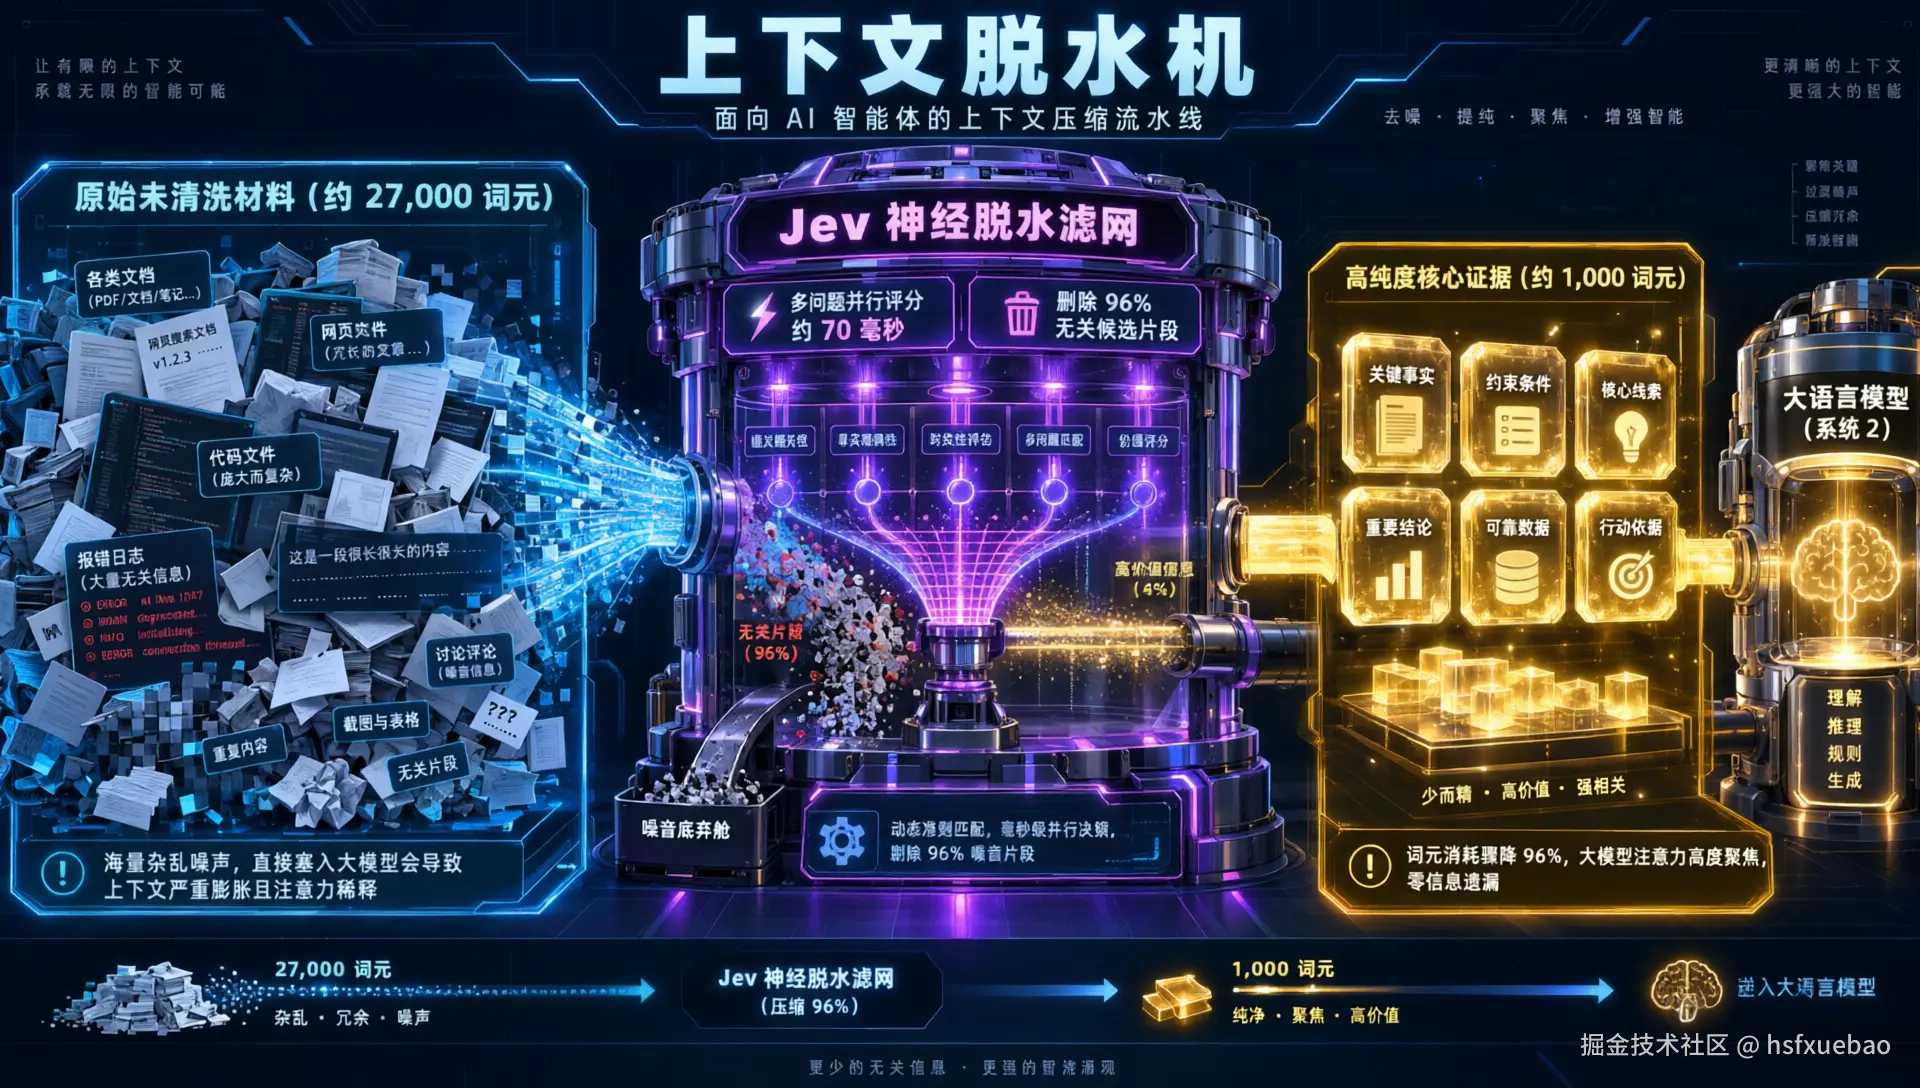
开发者 Agent 的上下文脱水:Jev 作为后置过滤器
在主模型阅读长篇资料之前,让 Jev 充当后置过滤器 。把几十段候选文本切片,以毫秒级的并发让 Jev 快速判断「这段材料是否包含回答问题所必需的事实或限制条件」。把明显无关的干扰项摘除,只将核心证据送入主模型的视野。
七、真实工程落地,Jev 面临的三个核心局限
如果仅看官方基准与理想评测,容易高估其在复杂场景中的适用性。但在真实的生产落地中,Jev 存在几个明确的技术边界与工程限制。厘清这些局限,才能避免在架构选型时做出不切实际的假设。
7.1 局限一:中文语境与长上下文泛化不足
在 TypeSafe 的官方技术文档中明确指出,模型目前对 CJK(中日韩字符)的处理准确率显著低于英文。
社区开发者的测试与我们的工程验证均反映了这一现象。在处理简短的英文输入时,Jev 的分类与打分表现相对稳定,但在面对包含语境转折、行业术语或复杂修辞的中文长文本时,其判断容易出现较大波动。
在本地桌面项目的测试工程中,甚至需要加入前置检测机制,在未显式开启实验开关时,对中文内容绕过 Jev 分流以规避风险。在官方推出针对中文的本土化微调版本之前,不建议直接将其部署在关键的中文业务主干链路中。
7.2 局限二:缺乏多步推理与状态回溯机制
Browser Use 的创始人 @gregpr07 做过一个端到端实机评测。他尝试用 Jev 替代具备长程推理能力的大模型去执行多步骤网页操作。测试集包含 20 个需要探索状态空间、多轮点击、表单输入以及失败路径回溯的任务。
测试结果展现出明显的性能断层,Jev 最终仅完成了 1 项任务(1/20) ,而具备多步推理与验证能力的轻量模型 Luna 则成功完成了 17 项(17/20) 。这反映了纯判别式架构与序列决策任务之间的错配。浏览器交互并非孤立的单步选择,系统需要维护跨步骤的历史状态,理解表单验证失败的原因,并基于观察动态调整后续策略。
Jev 仅具备单步状态的模式映射,不具备显式思维链(CoT)与状态记忆。面对未清洗的复杂 DOM 树、异步弹窗与意外跳转,它无法维护历史上下文与回溯假设,一旦执行环境偏离预设路径,容易在局部错误状态中反复重试。
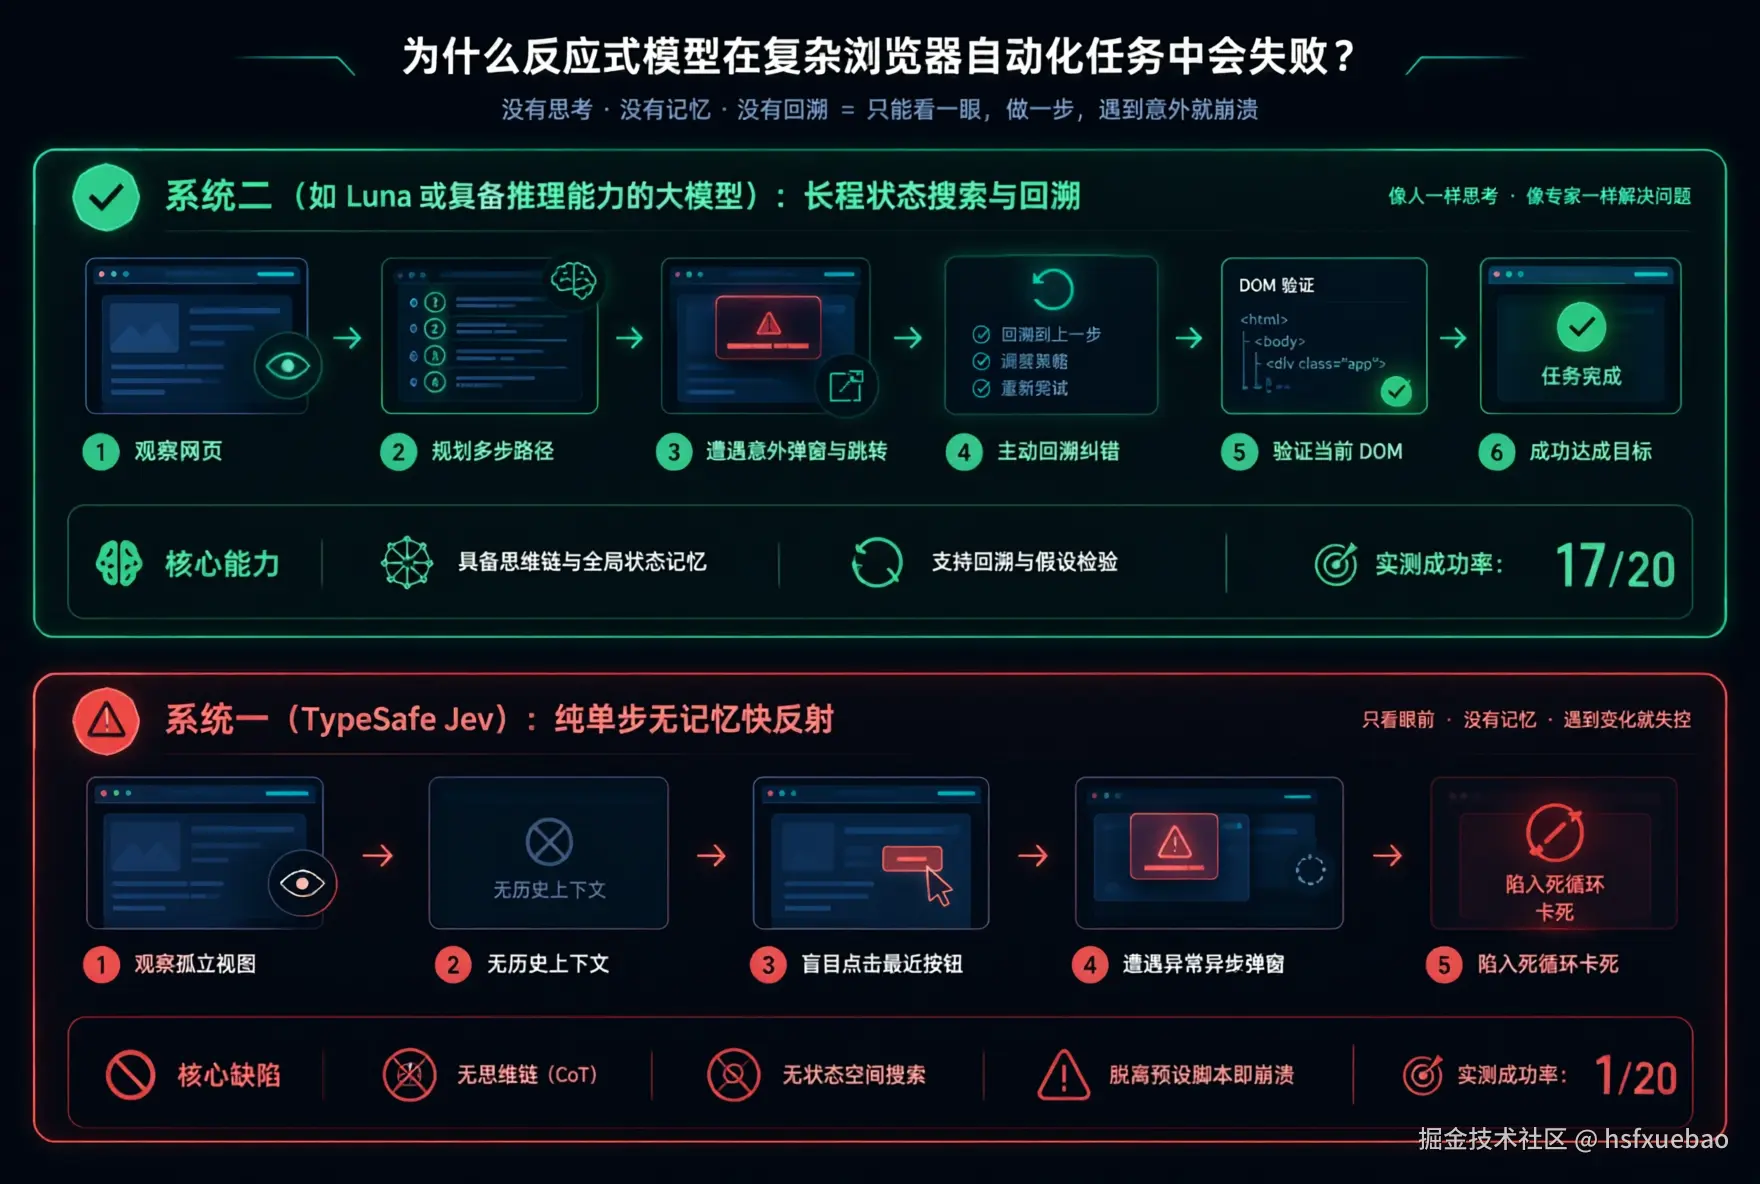
浏览器长程自动化任务中具备状态回溯的系统二与盲目单步反射的系统一对比剖析
从图解中可以看清两者的鸿沟。系统二遇到异常弹窗,能结合历史上下文主动回溯并纠错,最终顺利达成目标,而没有思维链的 Jev 面对意外,只能凭单步直觉盲目点击最近按钮,彻底卡死在死循环里。
7.3 局限三:「类型安全」并不等同于「业务判断正确」
在工程落地中,容易将「输出类型安全」等同于「业务判断正确」。Jev 能够在机制上保证输出格式严格匹配定义好的 Schema,消除 JSON 解析异常或空指针错误。
防范高置信度的业务误判。 它可能输出严格符合 Schema、置信度高达 0.99 的预测值,但在业务逻辑层面上却给出了完全错误的分类结论。
TypeSafe 团队也在社区交流中指出,在边界模糊的真实样本中,模型同样存在高置信度误判的情况。把一封严肃的投诉邮件错误归入日常咨询,虽然在程序运行层面没有任何语法错误,但在业务链路中却会造成关键告警的遗漏。因此,在任何核心业务路径中引入 Jev,都必须针对置信度分值建立阈值分流,保留人工复核或大模型兜底的逻辑分支。
八、总结
梳理至此,Jev 的真实定位已经非常明确。它并非取代通用大模型的新物种,而是分层架构中专注于高频判别的专用组件。
在过去两年的生成式浪潮中,工程选型普遍存在一种路径依赖,倾向于将通用自回归大模型应用于各类任务。无论是复杂长程推理,还是一个简单的布尔判断或收件箱标签归类,均调用数百亿乃至千亿参数的模型在云端逐字生成。这造成了显著的算力冗余,也无形中推高了自动化链路的端到端时延。
Jev 的出现,标志着工程系统正在走向更加清晰的分层架构:
- 深度推理模型(System 2) 位于后方,负责长程规划、多步推演与高质量自由内容生成。
- 快速判别模型(System 1) 部署在前沿,负责毫秒级完成过滤、意图路由与状态判别。
明晰其技术边界,建立严谨的分支校验与兜底机制,不苛求其承担长程复杂推理,在适合的高频判别与低延迟路由场景中部署它,才能真正发挥专用判别式架构的工程效能。
九、开源对照:Jev / kev / laya
社区里已经出现几套 System One 取向的实现。官方 Jev 走托管 API,kev 与 laya 是可本地跑的开源复刻,对照如下。
| 模型 | 地址 | 形态 | 骨干 | 训练 | 延迟 | 最大基数 | 语言 | 许可证 |
|---|---|---|---|---|---|---|---|---|
| jev | TypeSafe Consolegithub.com/typesafe-ai | 托管 API | 未公开(推测稀疏 MoE ~10B active) | RLCD | 70--500ms | 255 | 英文为主 | 商业 |
| kev | github.com/jaredpalmer... | 本地开源 | Qwen3.5 + LoRA + pointer head | RLCD 风格 + decision-v7 | H100 上几十 ms | 255 | 英文为主 | Apache-2.0 |
| laya | github.com/NandhaKisho... | 本地开源 | ModernBERT / mmBERT | RLCD | 33ms / 每问题 7.2ms (T4) | 取决于 checkpoint | 100+ 语言(Router) | Apache-2.0 |