写在文章开头
软件工程是用计算机语言表达需求的过程。良好的软件设计,在代码落地之前就已奠定基调。
用 proposal.md 写清需求和验收标准后,下一步就是架构设计。读者可能会问:目标清楚了,范围明确了,验收标准也能量化了,AI 还不能直接照着这份文档开工吗?
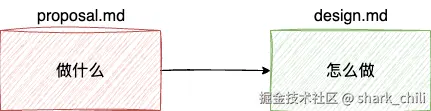
proposal.md 从业务角度告诉 AI "做什么",却没有说明"怎么做"。就像盖房子,它规定了要盖什么房子、几层楼、几个房间,却没有说明用什么材料、每层多高、房间如何布局。
以系统认证模块的优化为例,需求可以写得很具体:
- 输入账号和密码登录,登录成功后获得工作台访问权限,可以编写文章、分析流量、制作自媒体工作流。
- 用户持续操作网站时,会话不过期。
- 用户超过 30 分钟没有任何操作,则注销会话。
- 网站支持记住密码,勾选后可以在较长时间内直接登录。
这些要求说明了功能应该表现成什么样,却没有回答以下技术问题:
- 是否需要独立的认证模块?
- 前后端如何通信,交互的数据结构是什么?
- 登录认证采用哪种技术,为什么?
- 会话定期续约采用
Redisson看门狗,还是其他机制? - 如何处理频繁撞库等安全问题?
- 会话续约失败怎么办,是否考虑通过数据库降级?
proposal.md 定义"做什么",design.md 定义"怎么做"。需求写得再细,技术实现仍有选择空间。极端情况下,AI 可能把整个登录模块塞进一个类里,把复杂逻辑一路铺开,再把认证代码散落到各个接口方法中,或混入其他切面,忽略原有的系统架构。
SharkChili · 禅与计算机程序设计的艺术
开源贡献
- mini-redis :教学级 Redis 精简实现 · github.com/shark-ctrl/...
关注公众号,回复 【加群】 获得笔者联系方式加入技术交流群
从 proposal.md 到 design.md 的关键跨越
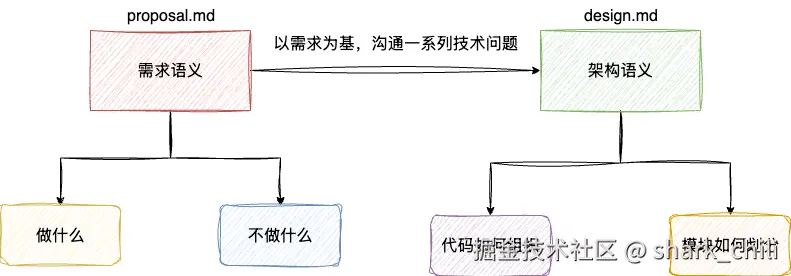
从 proposal.md 到 design.md,是 SDD 开发中信息密度高、思维跨度大的一步:把业务需求转成技术方案。
proposal.md 划定需求边界,告诉 AI 做什么、不做什么;design.md 则回答代码如何组织、模块如何协作。两份文档都面向人和 AI,但承担的任务不同。只有逐一澄清这些技术问题,才能确定代码的结构。
缺少 design.md 时,AI 就会依据训练数据中的常见做法组织代码,给实现带来更多不确定性。就像前面的例子:功能虽然跑通了,代码却耦合在一个文件里。后续排查问题、迭代功能都难以下手,每次修改还可能牵动大范围的业务回归。
先设计系统架构,再落地编码
为什么架构设计如此重要
康威定律指出:组织设计出的系统,其结构会反映组织内部的沟通结构。
例如:一个涉及 5 个模块的系统,可能由 5 个团队分别负责开发。团队之间如何沟通,会影响模块之间如何协作。这也是人类工程师必须参与架构设计的原因:
AI 不知道代码之外的团队情况,需要我们主动定义这些约束,把它们作为上下文提供给 AI。
《人月神话》强调:概念完整性是系统设计中最重要的考量。
单个模块的实现不够完善,可以逐步迭代;只要整体概念一致,系统就有继续改进的基础。反过来,即使各个模块各自精良,整体交互却杂乱无章,一条业务链路处处需要特殊适配,架构仍然存在问题。
以响应格式为例。如果各模块都按下面的数据结构返回结果,调用方就能按统一的约定处理响应:
java
@Data
public class Result<T> {
    private boolean success;

    private T data;

    private int errorCode;

    private String errorMsg;

}
如果一个模块返回 Result,另一个模块却只返回布尔值,调用方就需要分别适配。统一响应格式,正是概念一致性在接口交互中的一种体现。design.md 的作用,就是在 AI 编码之前,让它明确各模块在系统中的位置和职责。
从实际场景定义架构
回到登录模块,我们可以把需求拆成三部分:
- 校验用户输入。
- 对工作台操作进行鉴权。
- 定期续约会话,退出时清理令牌。
数据采集、组织、发送这类按流程逐步处理的业务,可以用管道型架构来表达。这里的登录模块,则更适合按职责分层:
- 表现层/接入层:校验输入。
- 业务逻辑层/安全层:对工作台操作进行鉴权。
- 会话管理层/基础设施层:续约会话、清理令牌。
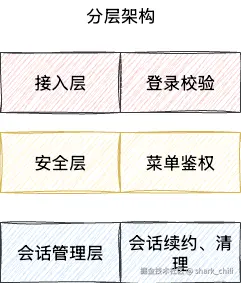
这个选择来自业务本身。三部分各有职责,处理逻辑也不同;沿着数据流梳理这些职责,便能得到相应的分层。
优秀的架构并非凭空创造,而是从问题的内在结构中"显现"出来的。
我们没有先挑一个架构,再把业务塞进去,而是从数据流和职责中抽象出适合的结构。
是否还需要进一步拆成微服务?proposal.md 已经说明,系统仅供笔者个人使用。在这个体量下,微服务只会增加复杂性。因此,架构选择以满足需求、刚好够用为准。
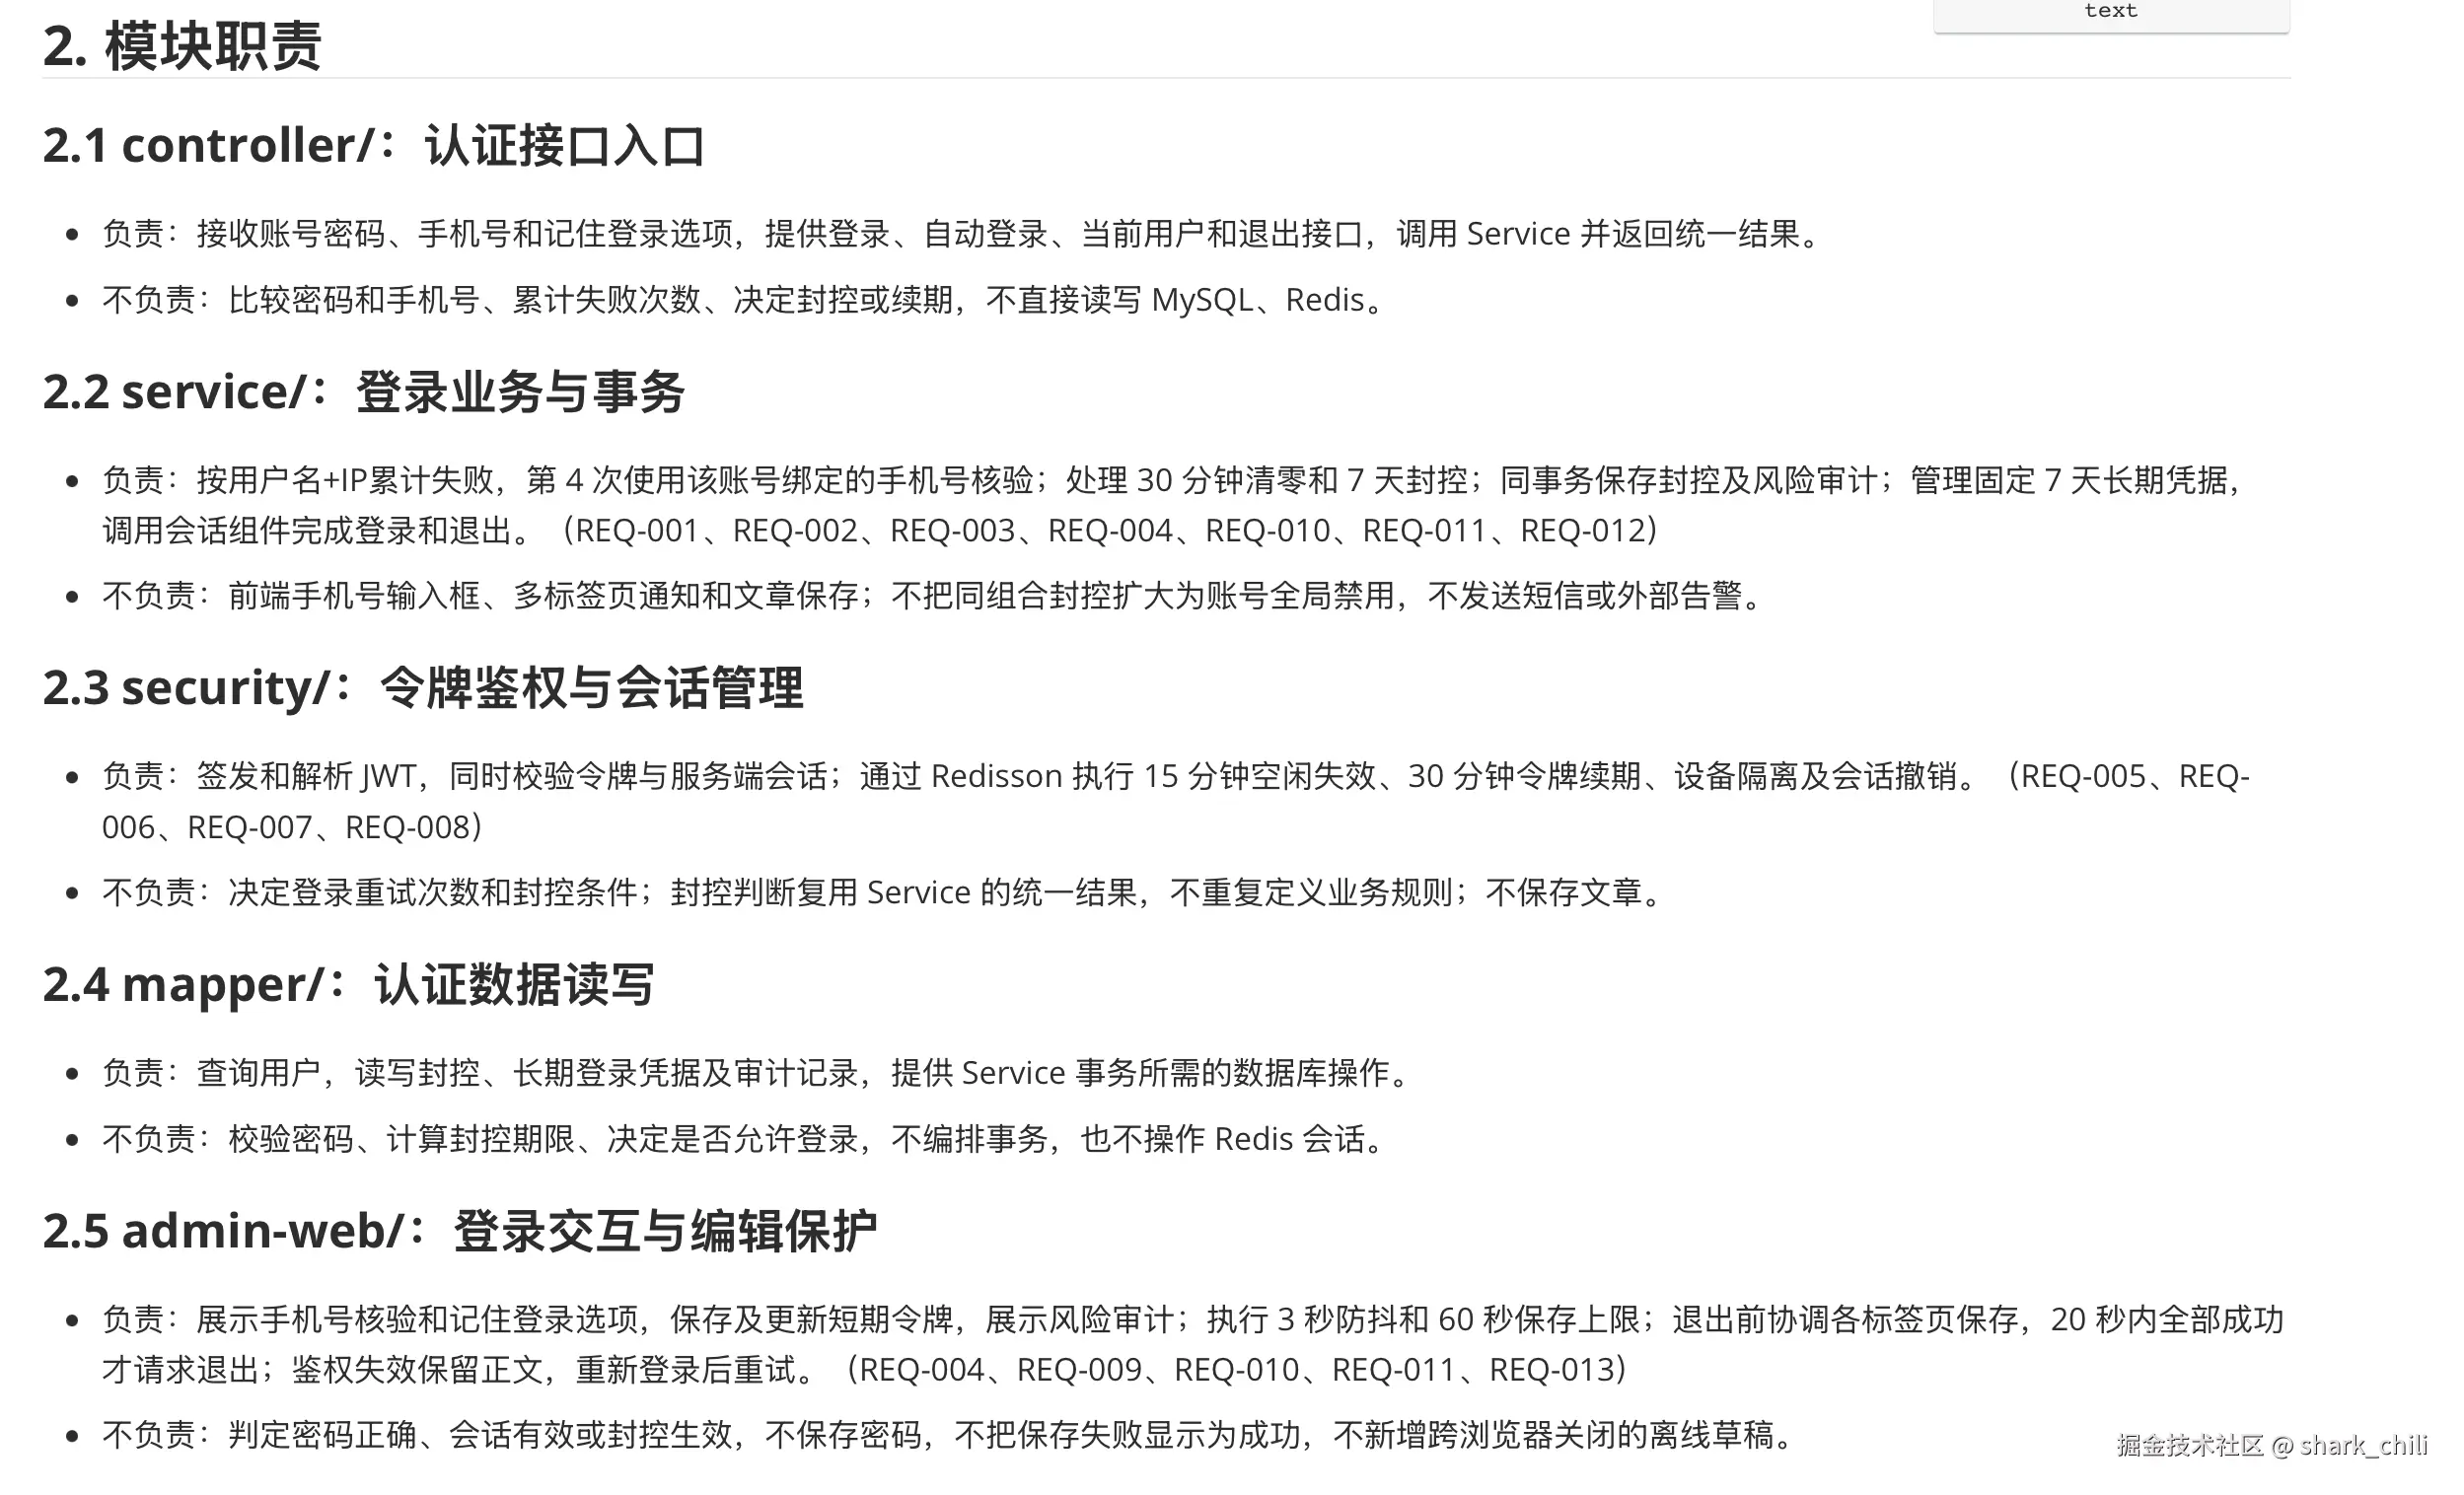
模块定义
确定整体架构后,还要写清每个模块负责什么、不负责什么。这一步经常被低估:架构图画出来了,职责边界却仍然模糊。
登录功能服务于笔者的个人工作台,因此认证、鉴权应独立到专门的模块中;菜单鉴权则通过独立切面处理,避免与业务逻辑耦合。这对应《架构整洁之道》中的单一职责原则:每个模块只有一个引发变更的理由。职责清楚,才能缩小各模块迭代时的影响面。
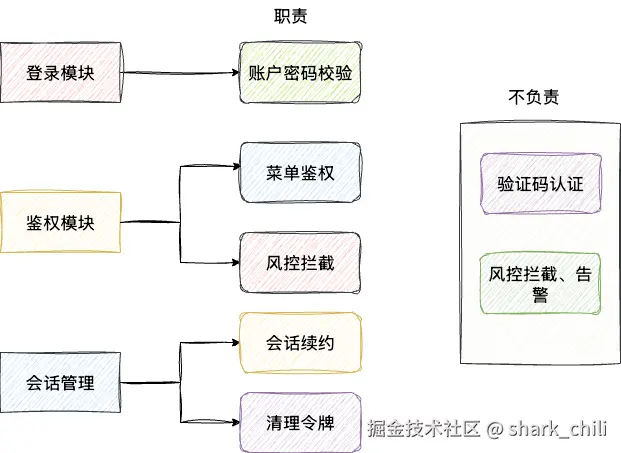
划定模块时,尤其要说清"不负责什么"。缺少边界,AI 可能直接修改现有方法来适配新业务,而没有按开闭原则封装、扩展。一次次把相关功能并入现有模块,职责就会逐渐模糊。
所以,模块划分的重点不仅是"拆",更是"界"。这也是关注点与职责分离的体现:既说明模块该做什么,也说明哪些事不该顺手放进来,避免这些"举手之劳"打乱系统架构。
ADR:记录决策,也记录理由
为什么需要记录决策
项目在设计和演进时,总要面对技术选择:
- 通信选 HTTP 还是 RPC?
- 数据库选 MySQL 还是 Doris?
- 消息队列选 Redis 还是 RocketMQ?
以笔者的经验,团队做这些选择时往往偏保守:"一直用 Redis,消息队列也继续用 Redis。"等到业务痛点推动团队考虑 RocketMQ 时,大家却可能因为不知道当初为什么选 Redis,不敢轻易调整。
这就是决策蒸发:方案留下来了,理由却丢了。
因此,可以借助 AI,把难以改变的关键决策写成架构决策记录(ADR)。决策越难改变,支撑它的理由就越值得记录。
ADR 的做法很简单:针对每个关键技术决策,用一份简短文档写清背景、考虑过的选项、最终选择及其理由。
ADR 格式
一份 ADR 应保持简练,同时包含以下 5 个要素:
- 标题:一句话概括决策。
- 背景:面临什么问题,为什么需要决策?
- 选项:考虑过哪些方案,各有什么优缺点?
- 决策:最终选择什么?
- 理由:为什么这样选,关键取舍是什么?
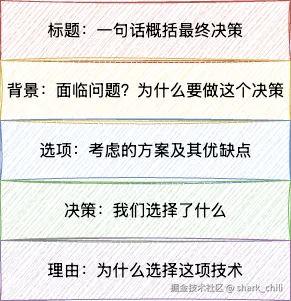
ADR 用来说明决策的前因后果,帮助后续维护者判断如何迭代,无需写成厚重文档。如果一份 ADR 超过一页纸,就值得检查:是否陷入了不必要的细节?
ADR 使用示例
以笔者个人平台的登录方案为例,下面这份 ADR 先用标题给出选择,再依次说明背景、备选方案、最终决策和取舍理由:
bash
# ADR-001:管理端采用 JJWT 与 Spring MVC 拦截器实现轻量认证

## 背景

个人工作台由 Vue 管理端和 Spring Boot REST API 组成,目前只有一名管理员,需要完成登录、识别当前用户并保护 `/api/admin/**` 接口。系统暂时没有多用户、角色权限、单点登录、第三方登录和多因素认证需求。

管理端入口会暴露在公网。"仅一人使用"只能说明认证模型简单,不能说明没有攻击风险,因此本决策仍需考虑令牌泄露、暴力登录和失效控制。

## 选项

| 方案 | 优点 | 缺点 |
|---|---|---|
| Spring Security 完整认证链路,可配合 JWT 或 Session | 安全能力标准化,扩展角色权限、会话控制和第三方认证更方便 | 当前需求下配置和概念较多,现有登录链路需要迁移 |
| Spring MVC 拦截器 + JJWT | JJWT 负责标准令牌签发与验签,项目只维护登录流程和接口拦截;无服务端会话,改动小 | 令牌撤销、登录限流和权限扩展需要自行补充,安全边界由项目维护 |
| 服务端 Session + HttpOnly Cookie | 可主动销毁会话,令牌不暴露给前端 JavaScript | 需要管理 Session 和 CSRF 防护,并改造现有 Bearer Token 调用方式 |

## 决策

采用 Spring MVC 拦截器 + JJWT:登录成功后签发有过期时间的 JWT,前端通过 `Authorization: Bearer <token>` 访问受保护接口,后端拦截器统一验签并写入当前用户上下文。密码继续使用 BCrypt 校验,不自行实现密码算法或 JWT 密码学逻辑。

## 理由

当前只有单管理员和"已登录/未登录"两种状态,完整 Spring Security 的权限模型暂时不能带来相称收益。JJWT 避免自行实现令牌标准和签名算法,MVC 拦截器又能沿用现有 Controller、Service 和前端请求链路,整体依赖少、代码范围小,适合个人持续维护。

出现多用户或角色权限、需要立即撤销会话、接入 SSO/MFA、发生令牌安全事件,或需要统一管理更多安全策略时,应重新评估并优先迁移到 Spring Security 或服务端 Session 方案。
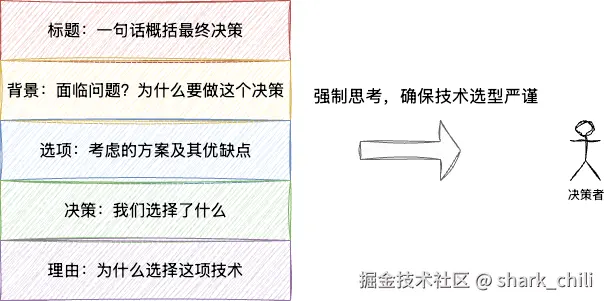
写 ADR 不只是留痕,也是在检验自己的思考:为什么选择这项技术,是否认真比较过其他方案?如果一个决策出错后,修复成本会成倍增加,就应该把它记入 ADR,并纳入 Git 版本管理。
接口契约:模块间的握手协议
为什么要先定义接口
架构划定模块边界,ADR 记录技术选择,接下来还要回答:模块之间如何通信?
接口契约约定双方如何交互:我提供什么数据,你返回什么结果,内部如何实现则不必向调用方展开。AI 生成代码时,明确的输入输出约定也能减少实现偏差,因此这些契约需要写进 design.md。
数据载体
先定义数据类型,写清模块之间传递的数据结构,以及各字段的含义。这里约束的是数据语义,不必过度绑定代码内部的组织方式,可以让 AI 按规范和设计实现:
bash
## LoginRequest(登录请求)

| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
| `username` | string | 是 | 管理员登录名,不能为空 |
| `password` | string | 是 | 本次登录使用的明文密码,只允许进入认证服务 |

## UserAccount(用户账户)

| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
| `userId` | integer | 是 | 用户唯一标识 |
| `username` | string | 是 | 唯一登录名 |
| `passwordHash` | string | 是 | BCrypt 密码摘要,仅用于服务端校验 |
| `nickname` | string | 否 | 管理端展示名称 |
| `avatar` | string | 否 | 管理端展示头像地址 |
| `createdAt` | datetime | 是 | 账户创建时间 |

## TokenClaims(令牌声明)

| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
| `subject` | string | 是 | 用户唯一标识的字符串形式 |
| `username` | string | 是 | 签发令牌时的登录名 |
| `issuedAt` | datetime | 是 | 令牌签发时间 |
| `expiresAt` | datetime | 是 | 令牌过期时间 |

## LoginResult(登录结果)

仅在用户名和密码校验成功后返回。

| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
| `token` | string | 是 | 已签名的 JWT,后续通过 `Authorization: Bearer <token>` 携带 |
| `userId` | integer | 是 | 当前用户唯一标识 |
| `username` | string | 是 | 当前用户登录名 |
| `nickname` | string | 否 | 当前用户展示名称 |
| `avatar` | string | 否 | 当前用户展示头像地址 |
有些场景还需要说明不同数据之间的对应关系。例如,同一个用户既能用账号名登录,也能用手机号登录,就可以用一份配置,让 AI 看清账号名、手机号和昵称属于同一账户:
bash
# 同一组配置表示账号名、手机号和昵称属于同一个用户。
# 用户输入账号名或手机号登录后,系统都能找到 user_id 为 1 的账户。
# 以下均为示例数据。
accounts:
  - user_id: 1
    username: "demo-admin"
    phone: "13800000000"
    nickname: "博主"
模块接口定义
数据模型确定后,再定义各模块对外暴露哪些函数、接收哪些参数、返回什么结果:
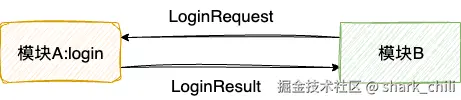
在 design.md 中,应给出对接者需要的信息,隐藏与对接无关的内部细节,主要有三个原因:
- 信息隐藏:说明协议、入参、出参及其语义,让调用方按契约对接,无需理解内部封装。
- 降低噪音:开发者和 AI 都需要阅读大量文档、代码,简洁的接口说明能减少理解负担。
- 安全:避免对外暴露过多内部实现信息。
非功能性约束:那些看不见的需求
为什么非功能性约束很重要
看一栋建筑,外行可能先关注外观和布局;建筑师还要考虑消防通道、抗震等级、防水和隔热。这些不显眼的设计,同样影响建筑的使用寿命。
软件系统也是如此。proposal.md 中的验收标准,通常先描述用户能直接感知的功能:
- 输入正确的账号和密码后,可以登录。
- 持续操作页面时,不会被强制退出。
- 勾选记住密码后,7 天内不用重复登录。
但系统要投入生产,还需要考虑非功能性需求(Non-functional Requirements,NFR)。
以笔者的经验,完整的业务流程在提测时较容易覆盖,非功能性问题却容易遗漏,直到生产运行才暴露出来。需要关注的方面包括:
- 性能:处理得快不快、扛不扛得住,例如响应时间、并发量、内存占用和批量任务耗时。
- 安全:数据和权限是否可能被滥用,例如身份认证、数据访问、密码加密、敏感信息泄露和 SQL 注入。
- 容错:某个环节失败后,能否控制影响面,例如超时重试、单个数据源失败时的隔离,以及重复请求的幂等处理。
- 可维护性:上线后能否快速发现、定位和处理问题,例如日志、监控、告警、健康检查、配置管理和故障回滚。
如何说明非功能性约束
在本次设计中,容错部分重点考虑优雅降级:某个环节故障时,尽量控制影响,避免整个系统停摆。
以鉴权模块为例,需要进一步说明两类处理:
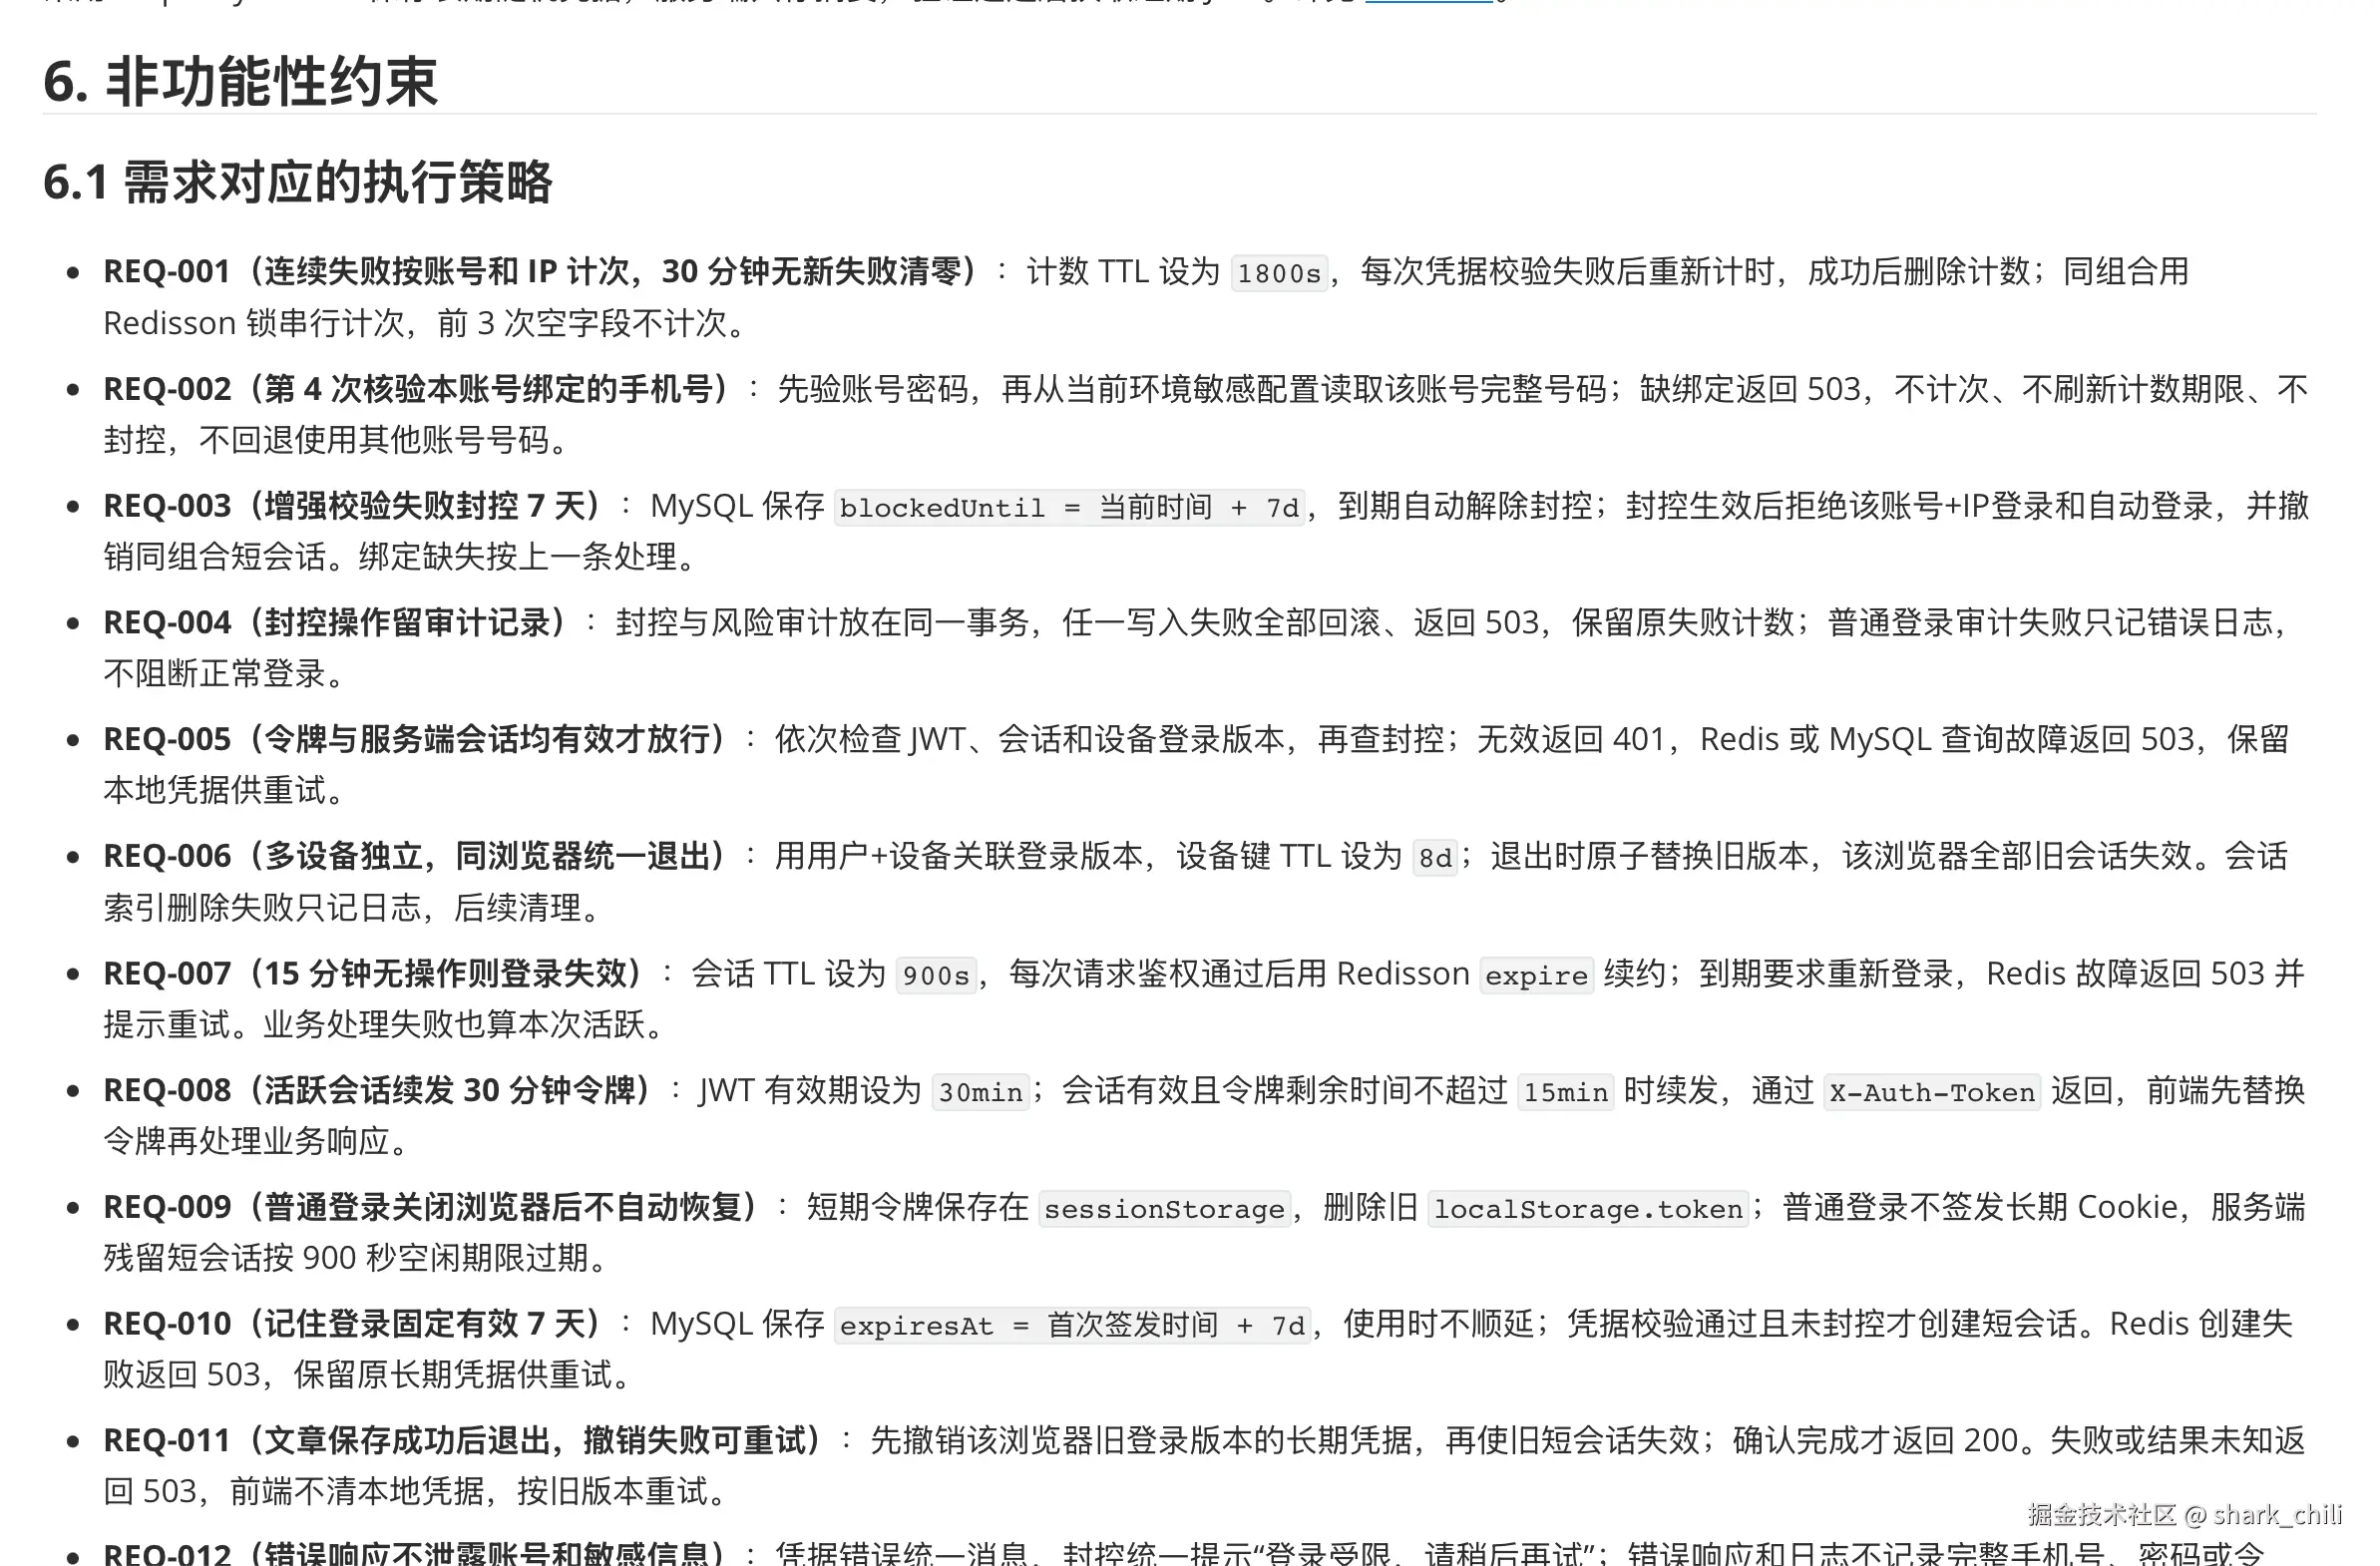
- 会话续约依赖的 Redis 宕机时,先在有限时间内重试,再通过数据库降级,维持个人工作台的操作。
- 外部用户频繁尝试登录时,限制重试次数,并要求手机认证;若未在指定时间内完成认证,则封禁当前 IP、发送告警,禁止其登录。
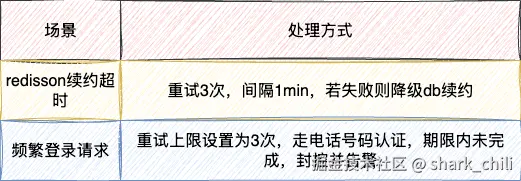
proposal.md 可以用两条要求说明预期结果:
- 用户持续操作时,会话不会因超时被强制退出。
- 登录尝试超过 3 次后,需要手机认证;认证失败则封禁用户 IP。
design.md 则要继续写清技术方案。例如,通过 Redisson 每隔 1 分钟重试续约,重试超过 3 次后,降级为数据库定期续约。
这仍然是"做什么"与"怎么做"的分工:proposal.md 定义约束,design.md 说明如何落实。
实践:使用 Codex 生成架构设计
工作流搭建
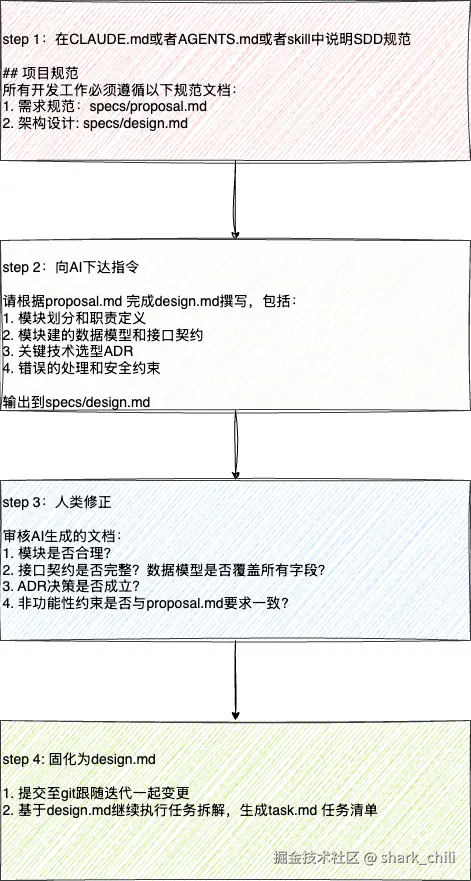
到这里,design.md 的主要内容已经明确,但并不需要全部手写。我们可以把 proposal.md 作为输入约束,借助 Claude Code/Codex 辅助设计。
笔者会先在 CLAUDE.md 或 skill 中说明项目采用 SDD 流程:先用 proposal.md 定义需求,再编写 design.md。具体分为四步:
- 让 AI 阅读 proposal.md,提出模块划分、职责定义、数据模型、接口契约和非功能性约束的设计方案。
- 人类工程师审核、决策并订正方案。
- AI 生成 design.md,提交到 Git,随功能迭代维护。
- 基于 design.md 拆解任务,具体方法留到后续文章展开。
生成 design.md 的注意事项
第一,关键决策仍由人主导。可以让 AI 分析技术方案、指出思考盲点,但最终的选型和取舍,需要人类架构师判断。design.md 可能在开发中修改,甚至被推翻,但设计过程会迫使我们认真思考系统结构、模块边界和技术取舍。这些思考本身就有价值。
第二,确保 design.md 与 proposal.md 一致。proposal.md 定义需求和约束,design.md 必须在这些边界内给出方案。例如:
- proposal.md 规定本次不采用验证码登录,design.md 就不应引入 EasyCaptcha 等组件。
- proposal.md 规定登录尝试上限为 3 次,design.md 就应采用相同的上限。
- proposal.md 规定超过 3 次后进行手机认证,且认证方式是输入配置的号码段进行比对,design.md 就应按此设计,而不是改成短信验证码;认证成功后再允许重试。
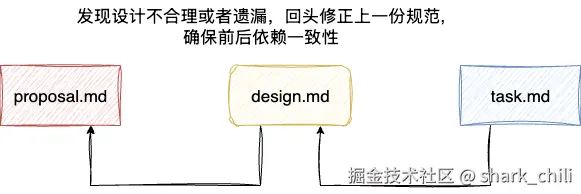
第三,设计变了,文档也要跟着变。后续拆解任务时,如果发现遗漏或不合理之处,应回头修改 design.md,并通过 Git 记录变更。
design.md 示例
以本次登录模块的设计为例,文档按以下顺序展开:
- 用标题说明本次架构设计对应的需求。
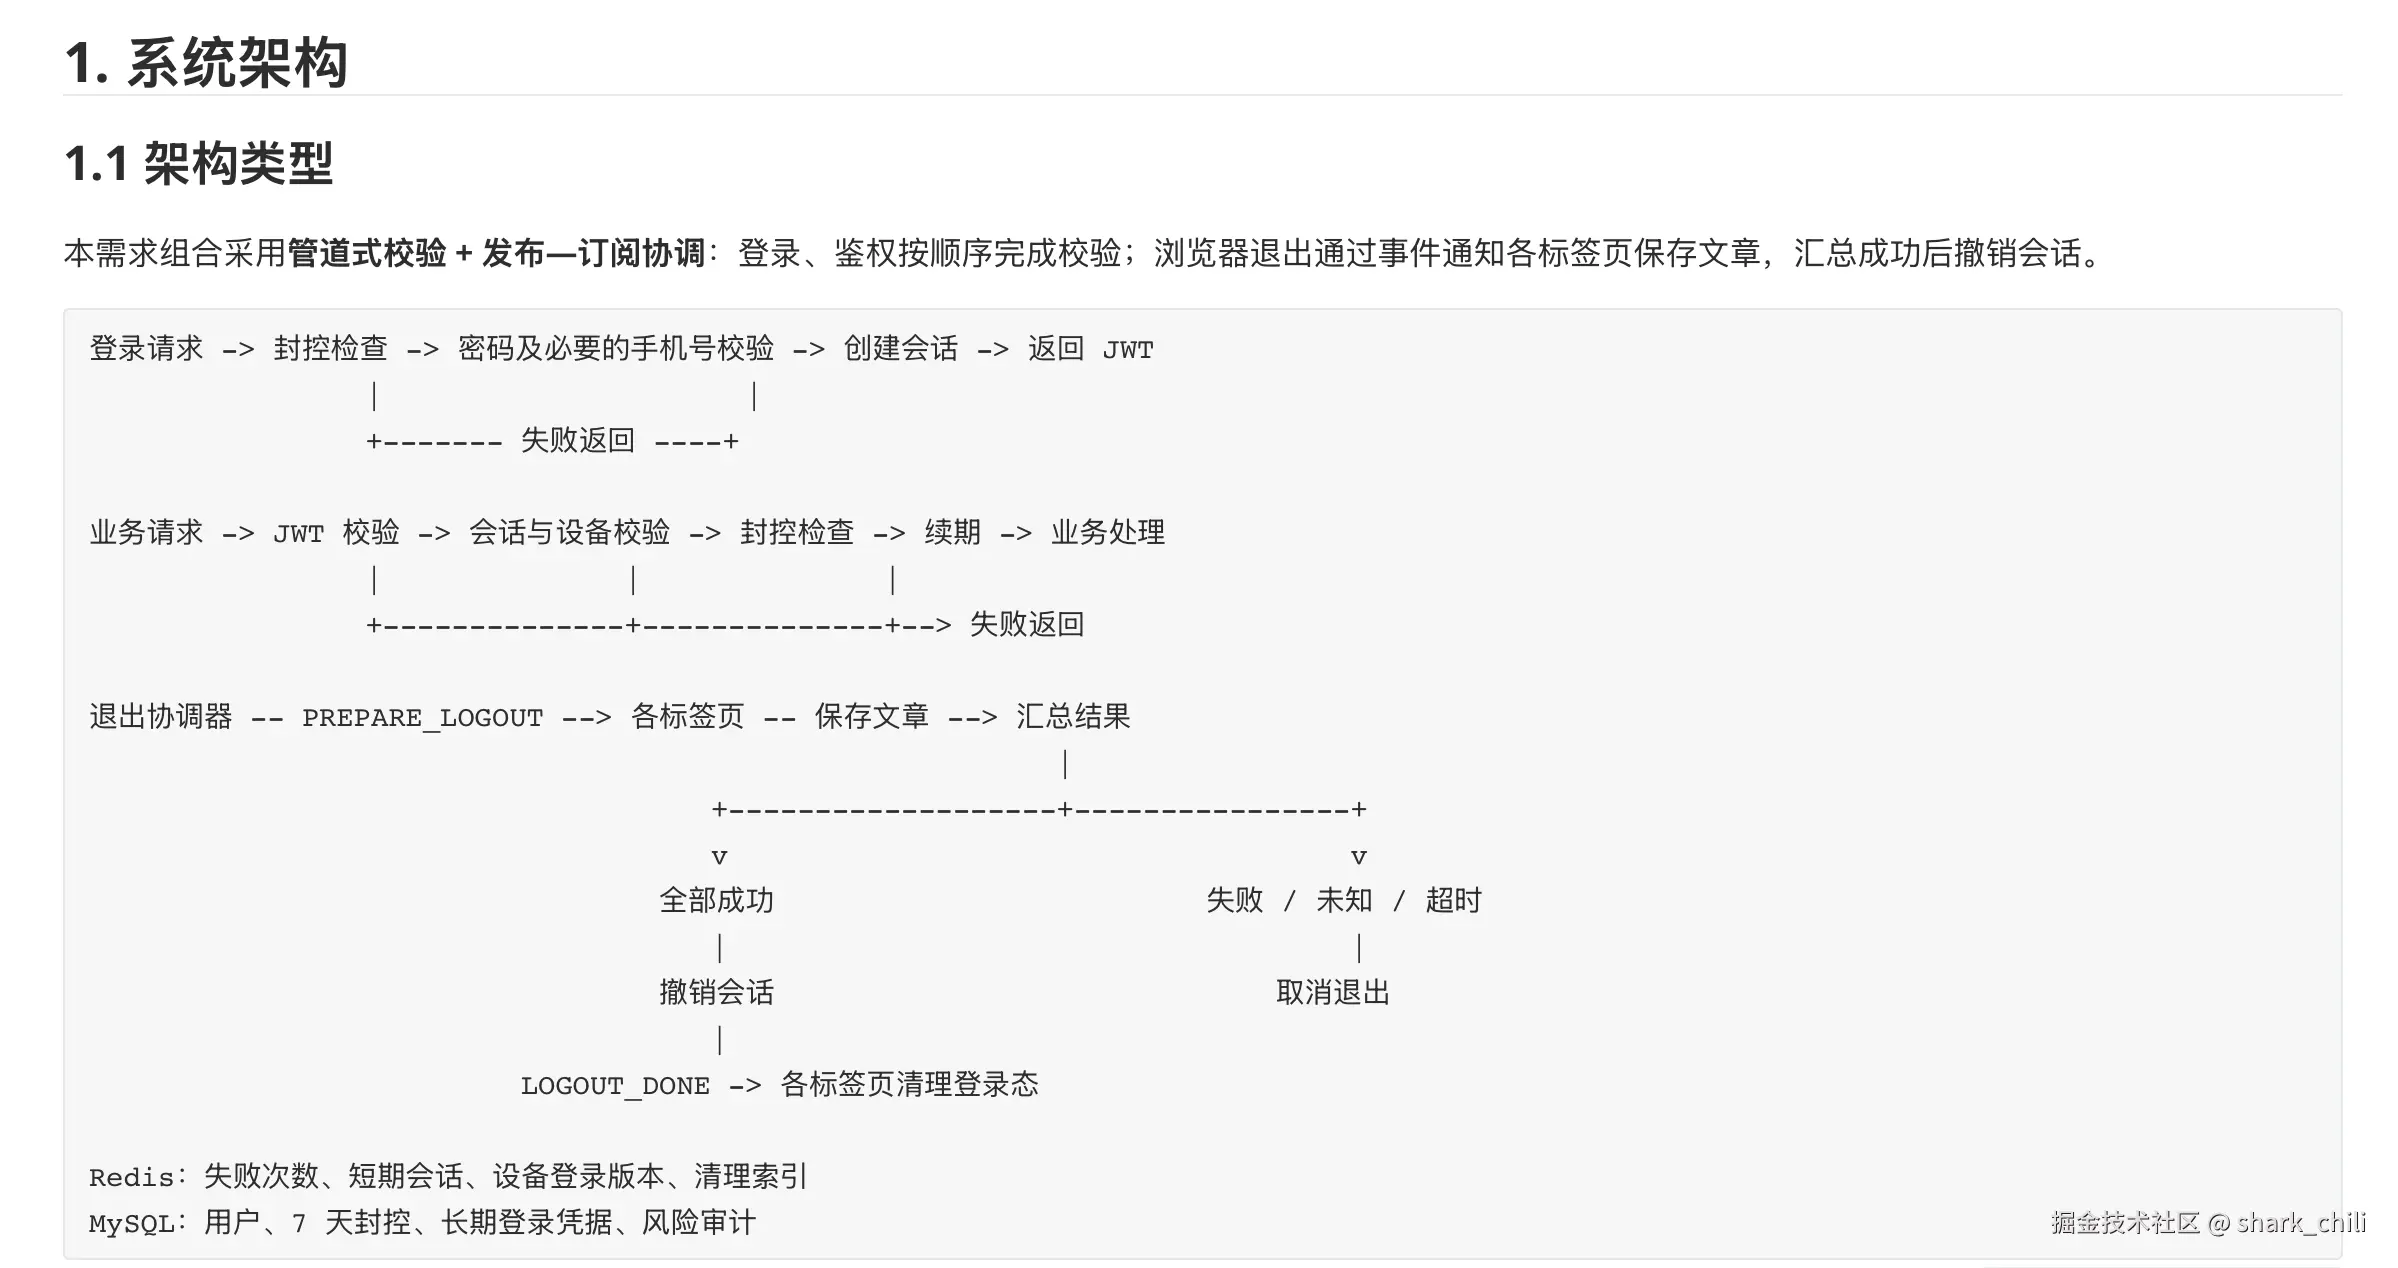
- 用 ASCII 图展示系统架构和数据流向。
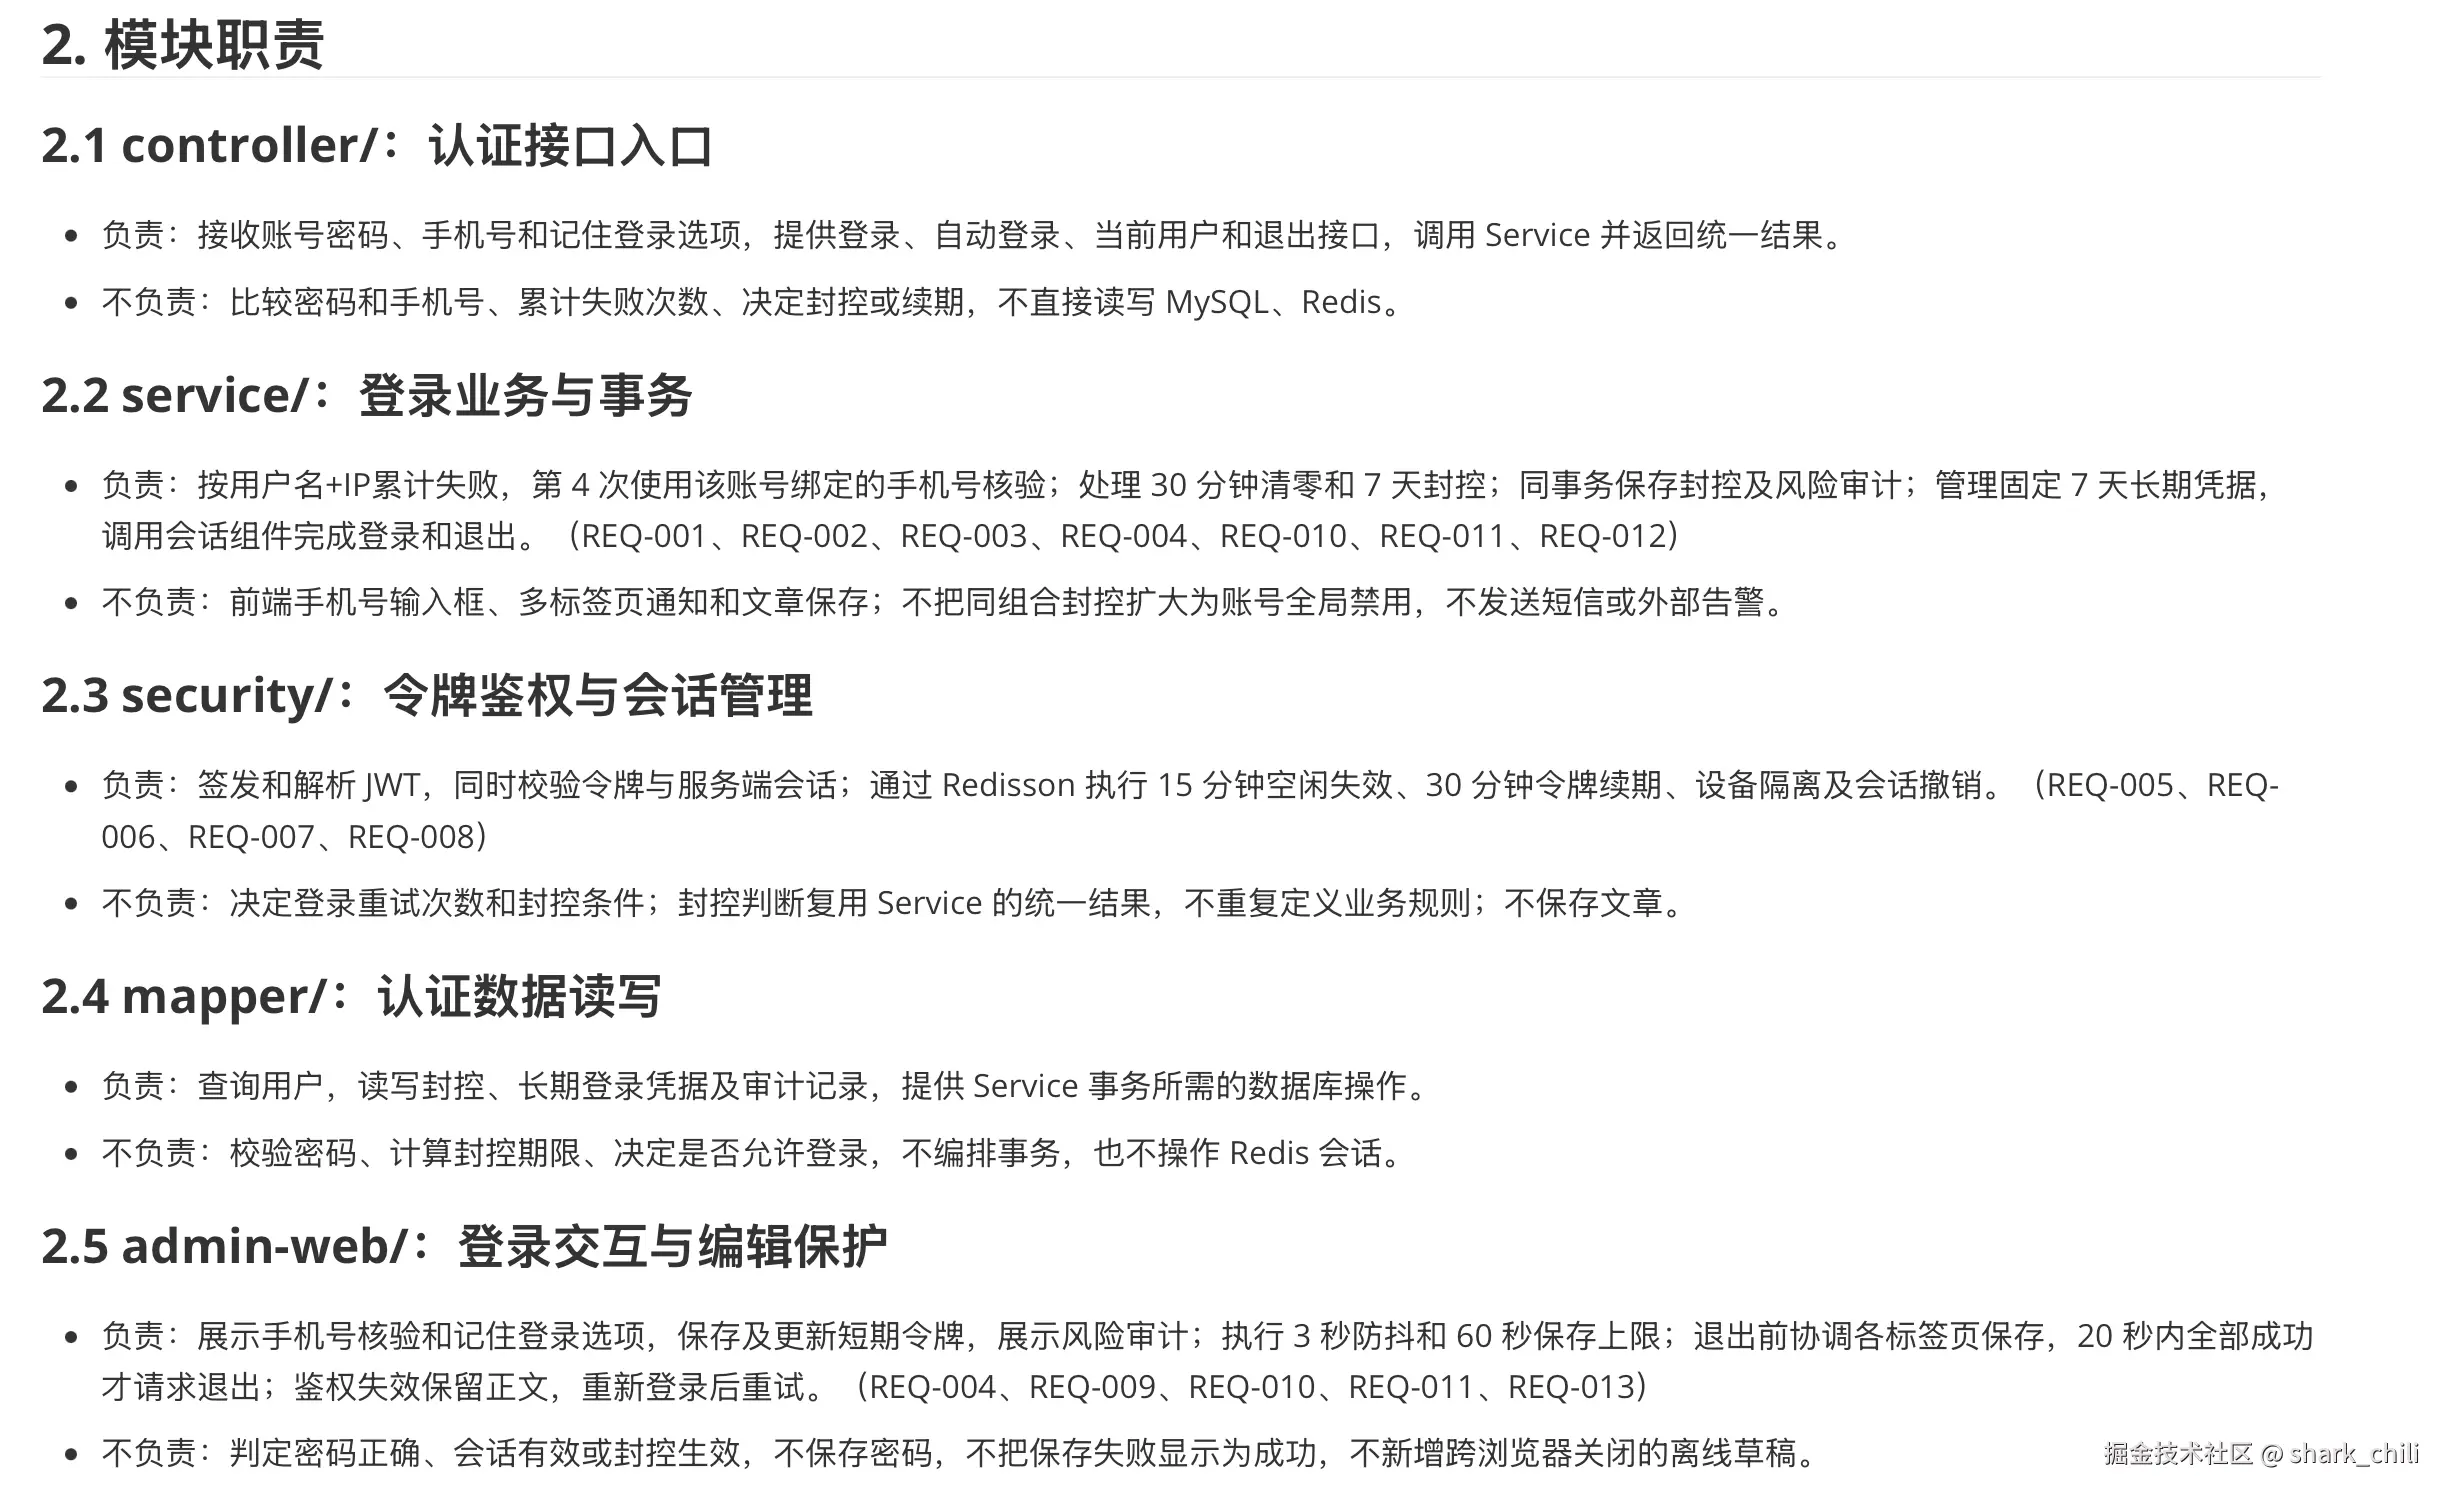
- 按 Java 分包说明模块及其职责,写清该做什么、不做什么,以及新增和修改的范围。
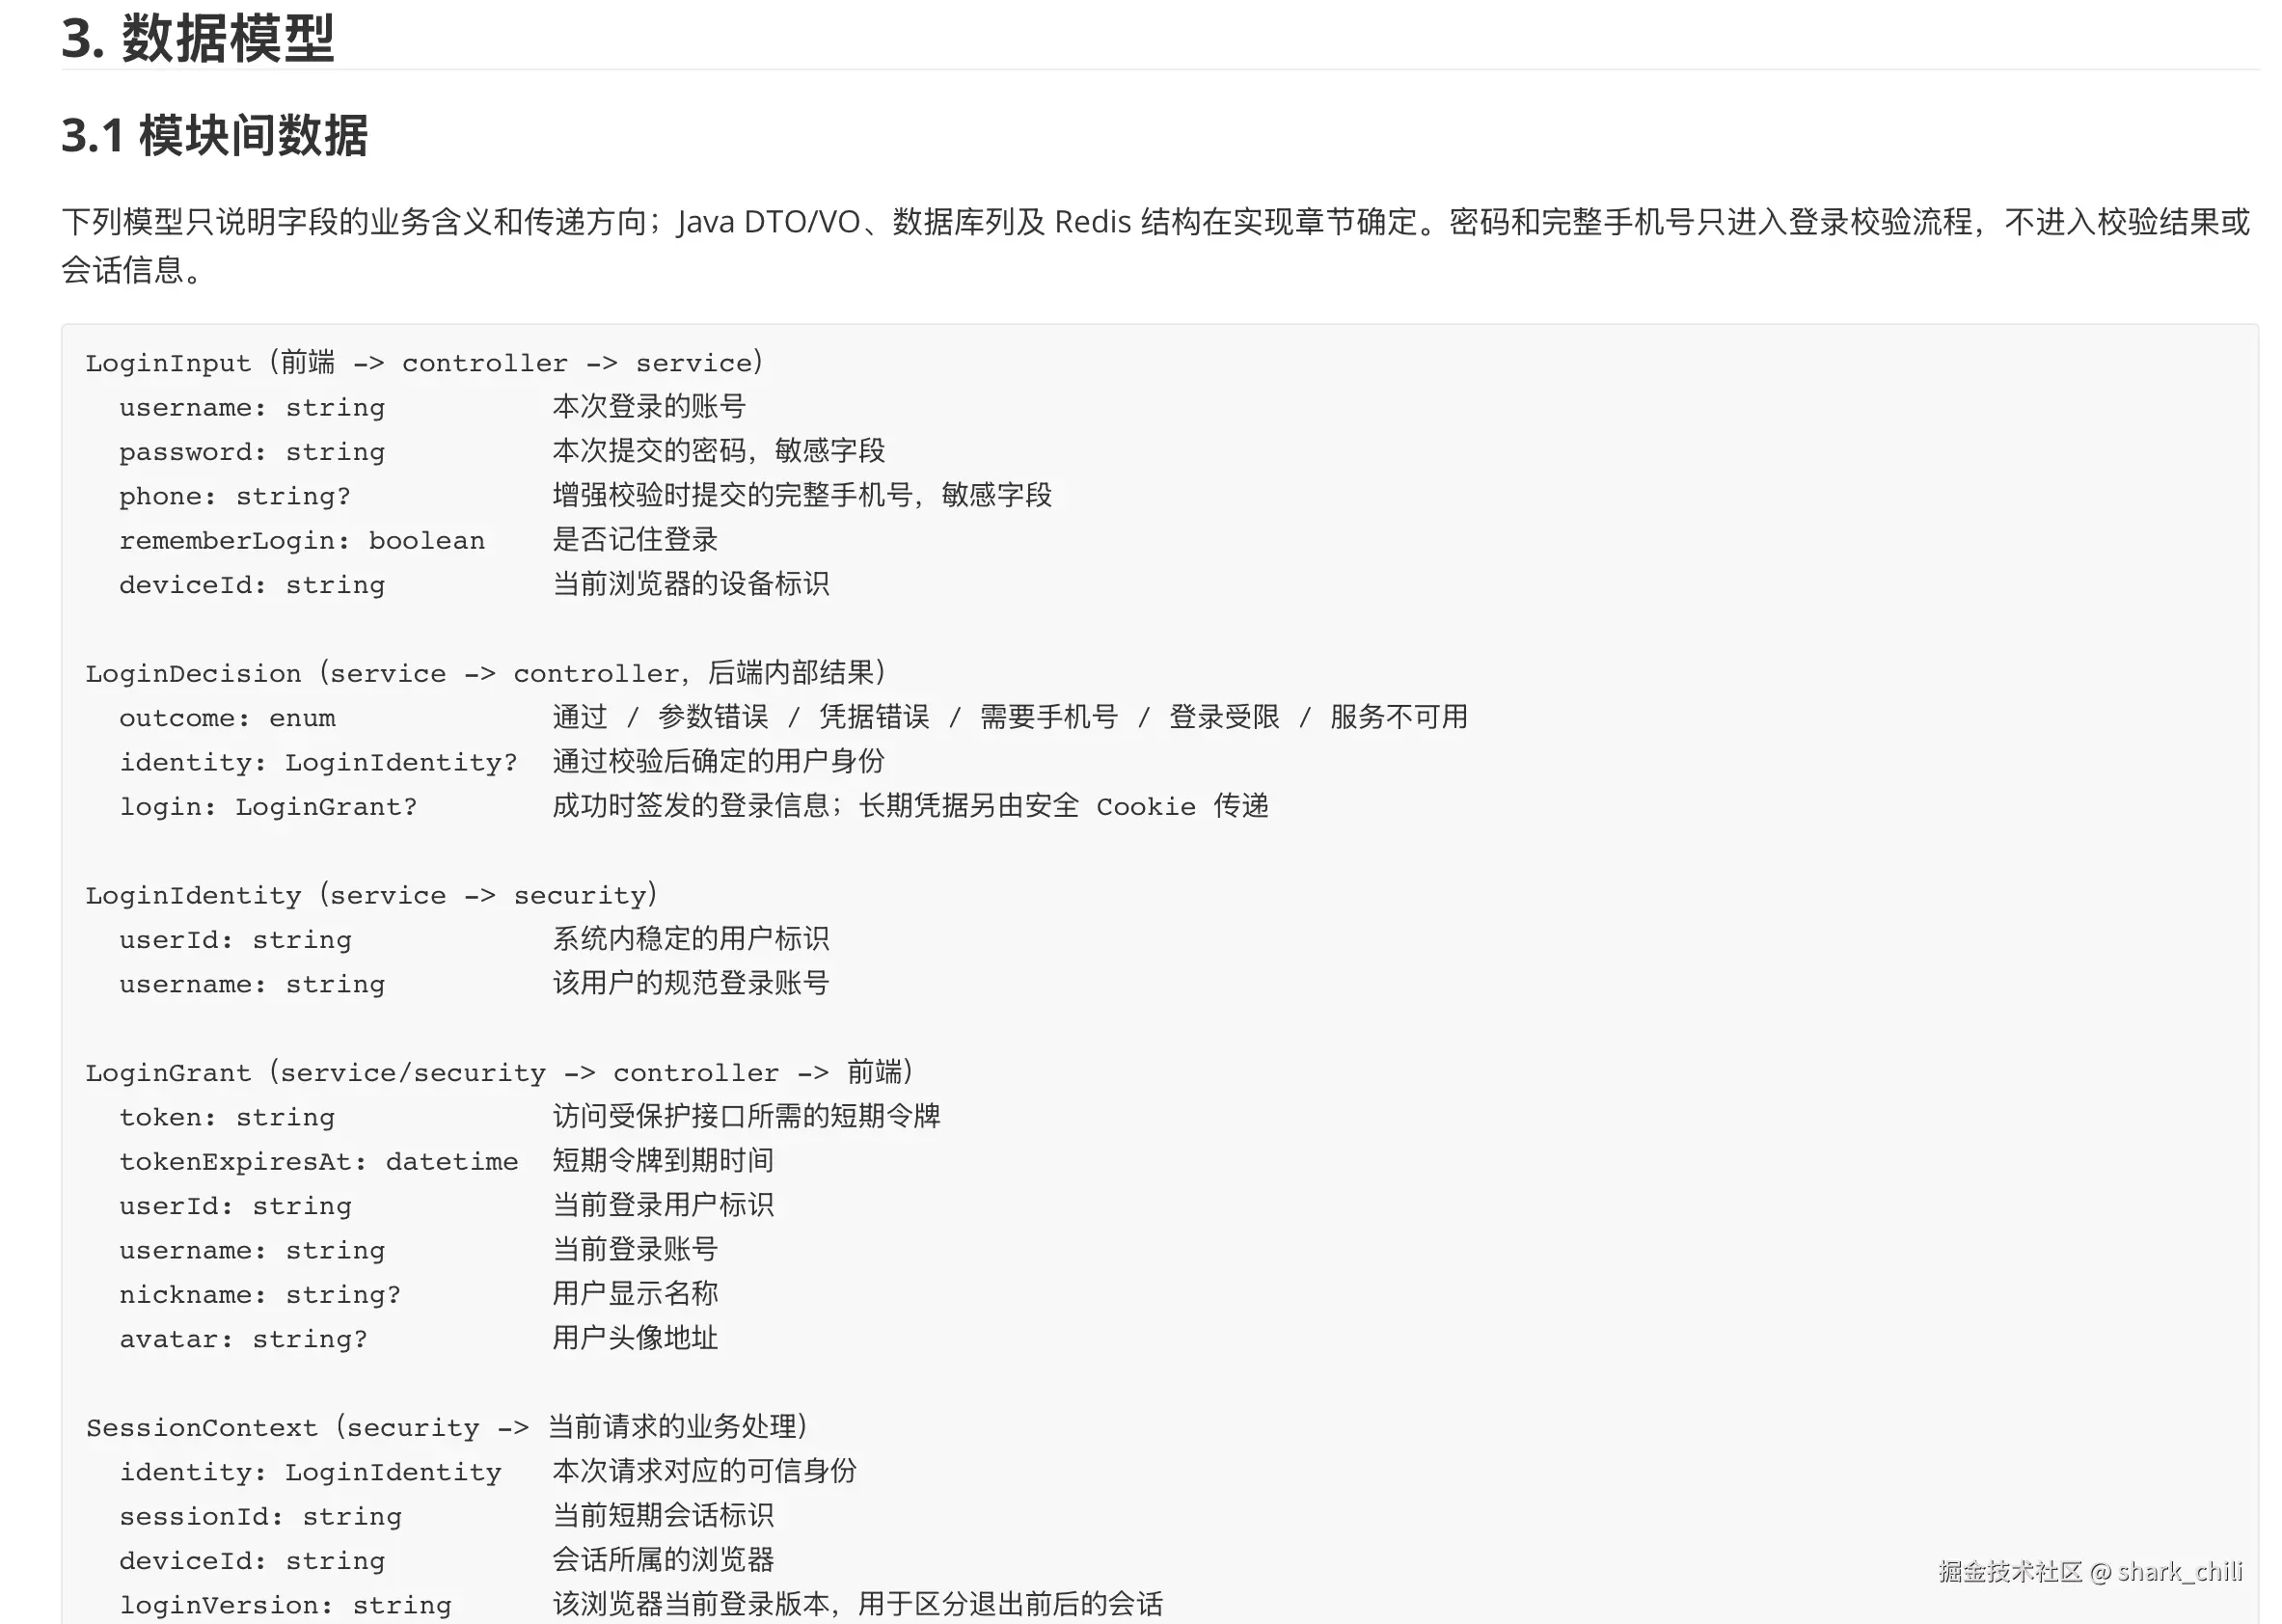
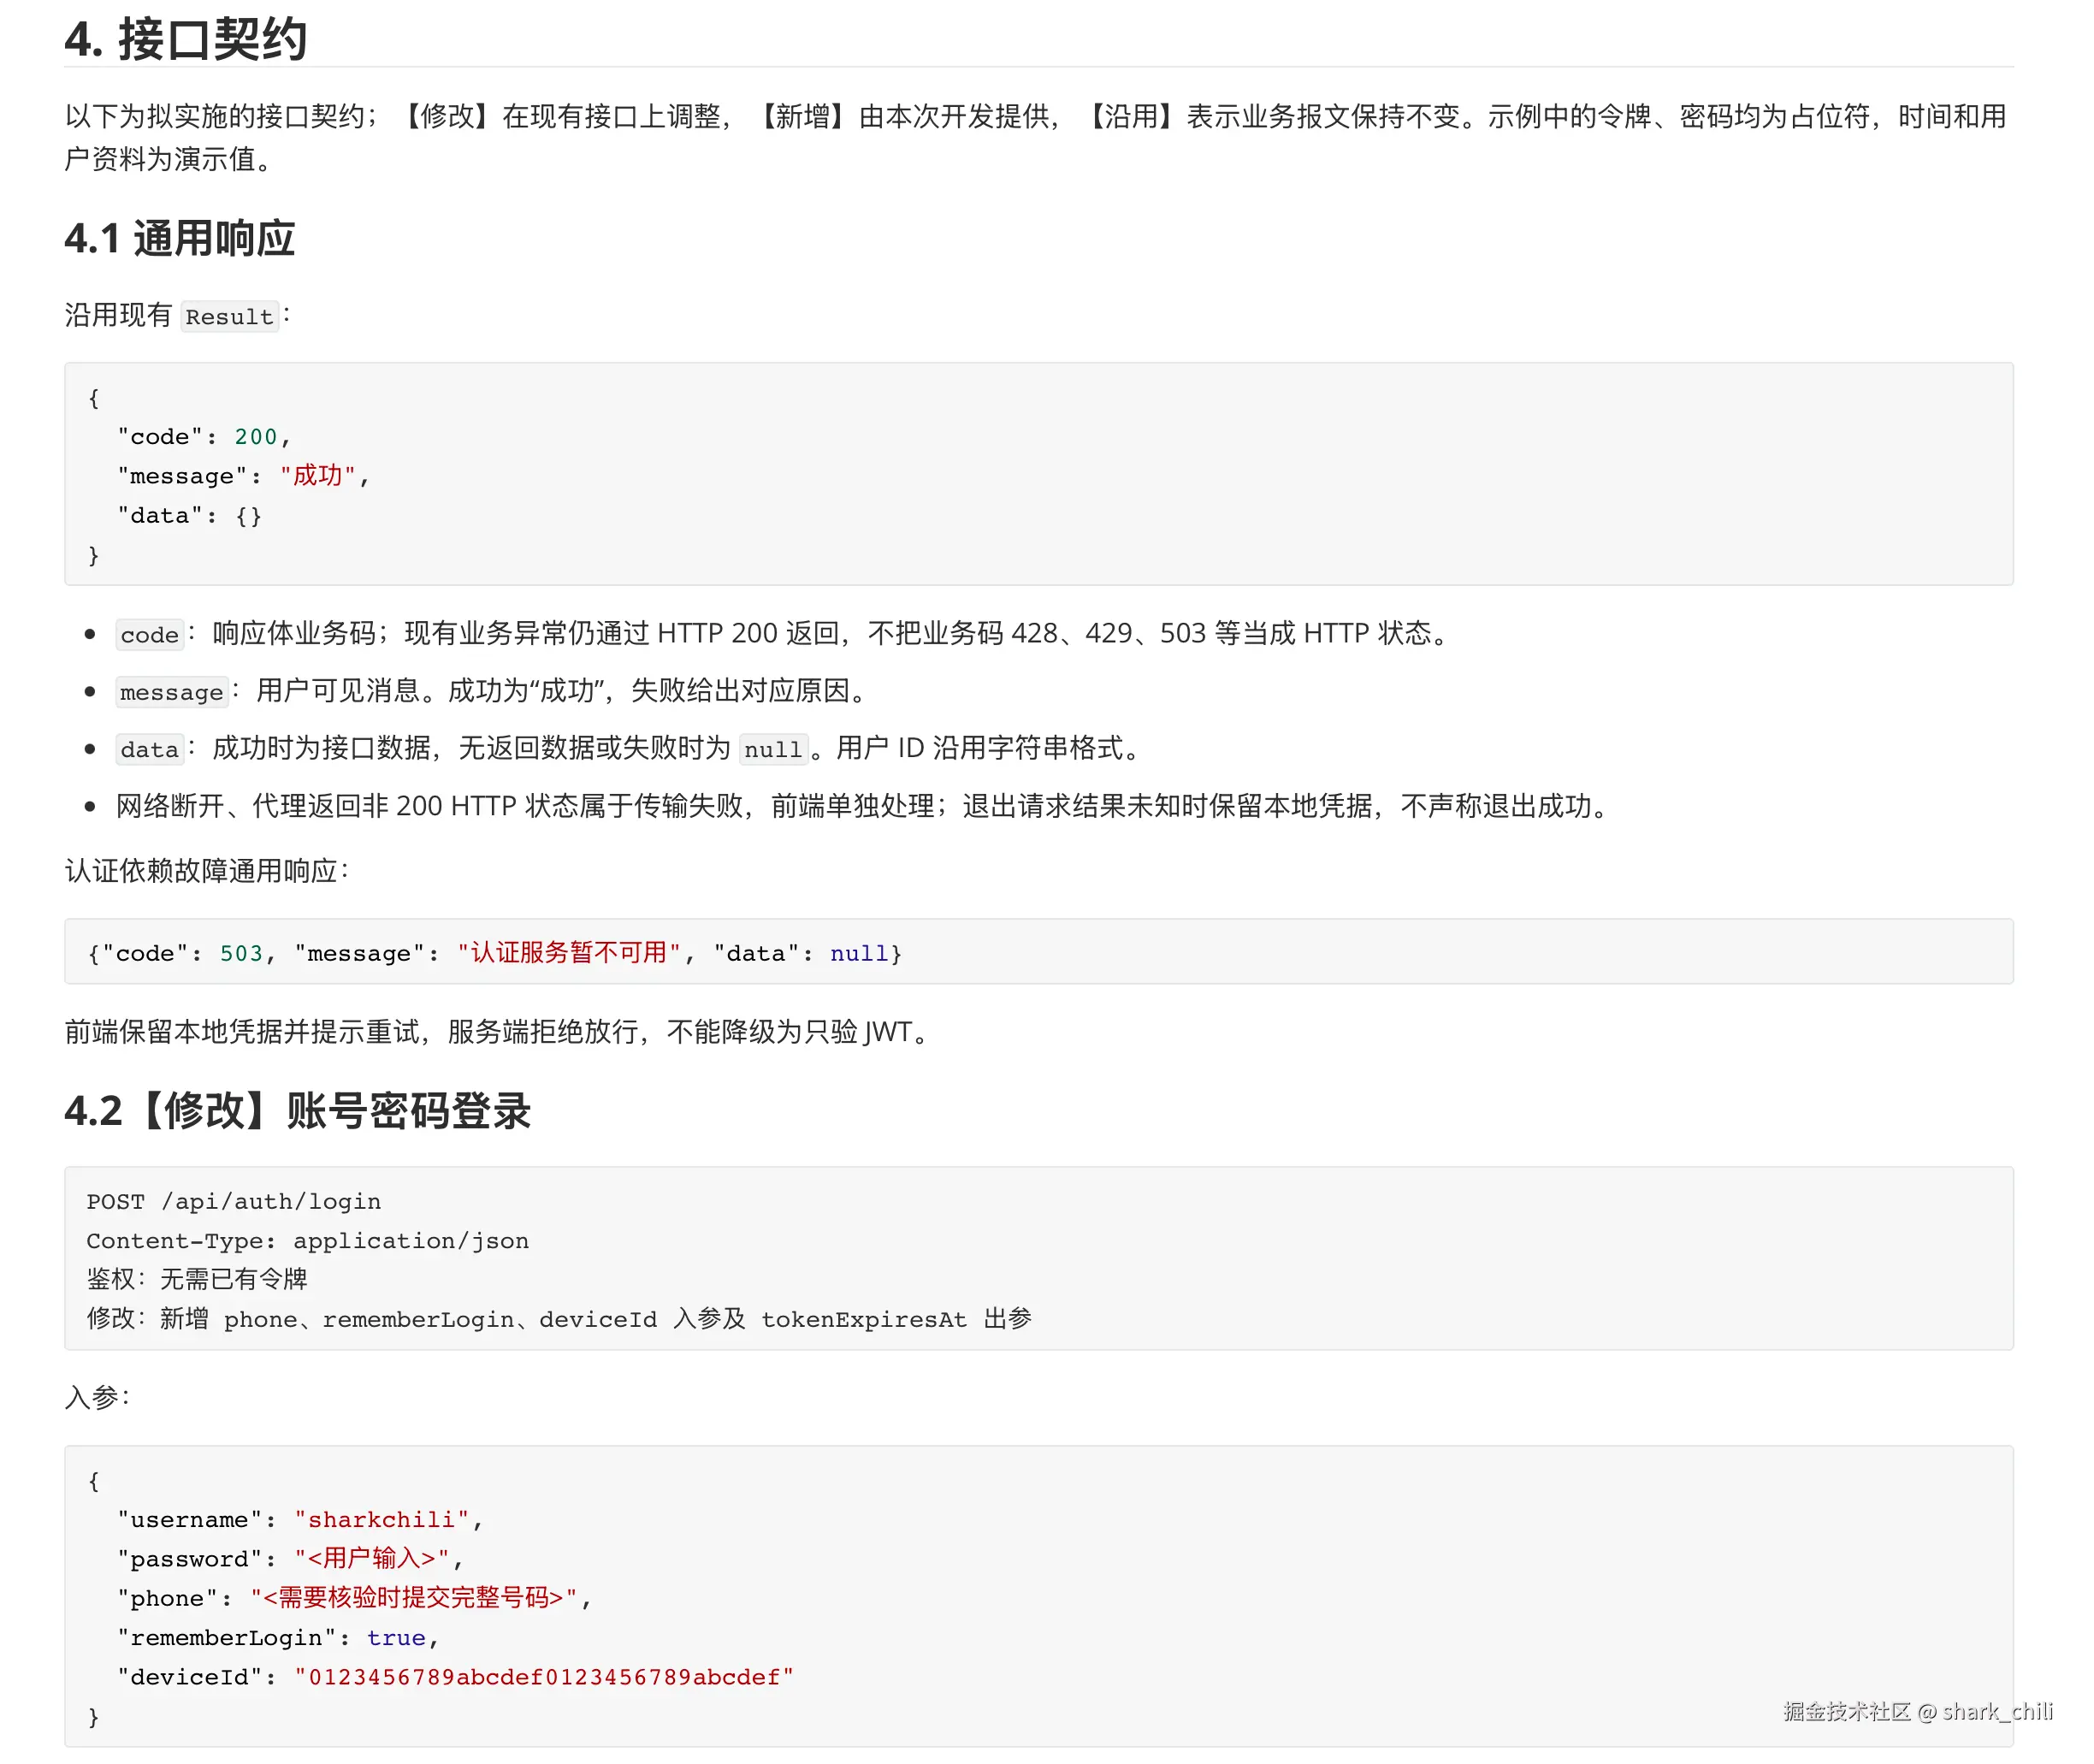
- 定义数据类型和接口契约,约定输入输出格式。
- 引用具体的 ADR 文件,说明关键技术决策。
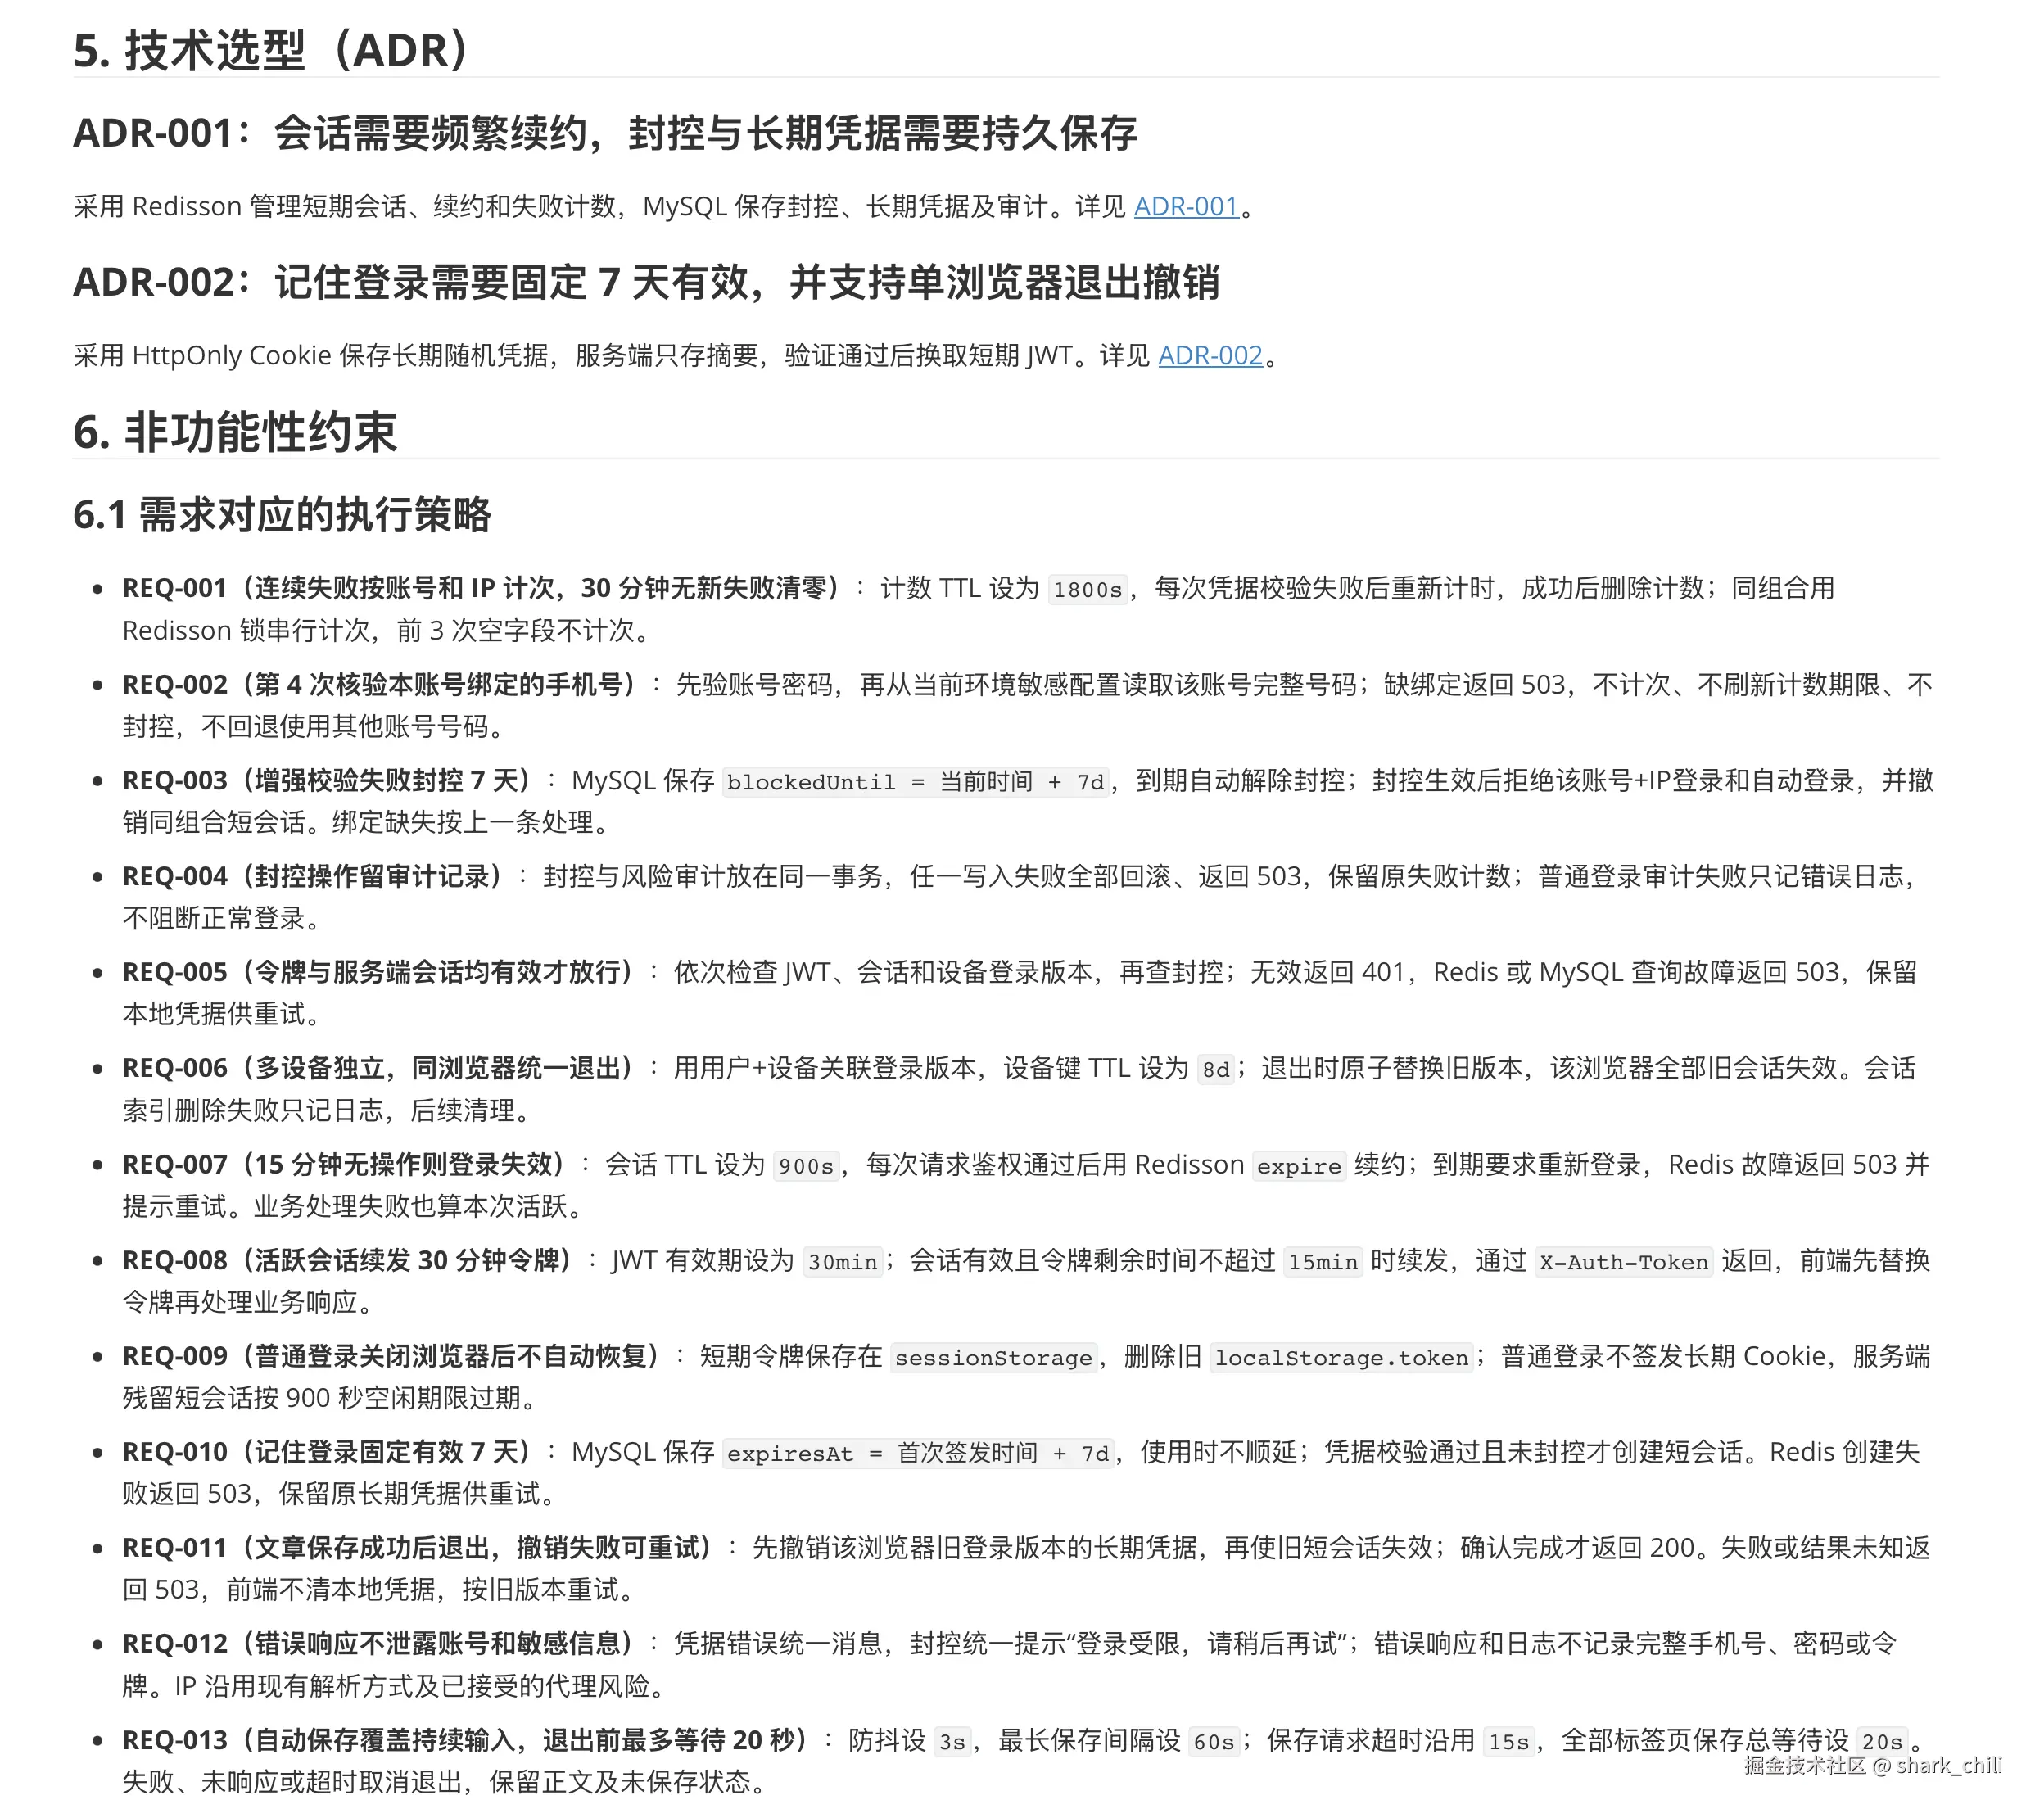
- 对照 proposal.md,说明非功能性约束的具体落实策略。
小结
本文讨论了 SDD 工作流的第二个阶段:从定义"做什么"的 proposal.md,走向说明"怎么做"的 design.md。
架构设计不只是画图。收到需求后、开始编码前,需要先回答四个问题:
- 模块如何划分?
- 采用什么技术,为什么?
- 模块之间如何通信?
- 非功能性需求如何落实?
这些回答,构成了 design.md 的四个主要部分:
- 系统架构:按单一职责和关注点分离原则,划分模块、定义职责、说明数据流向。
- 技术选型(ADR):记录关键决策的选项、理由和取舍,供维护者回溯,也作为 AI 实现时的技术约束。
- 数据模型与接口契约:约定数据和交互规则,让模块能够准确协作。
- 非功能性约束:说明错误处理、安全性、可维护性等方面的具体设计。
AI 时代,我们更需要主动做出架构决策。否则,AI 会替我们选择;如果这些选择没有记录,后续就难以审查和回溯,风险也会随系统长期演进而积累。
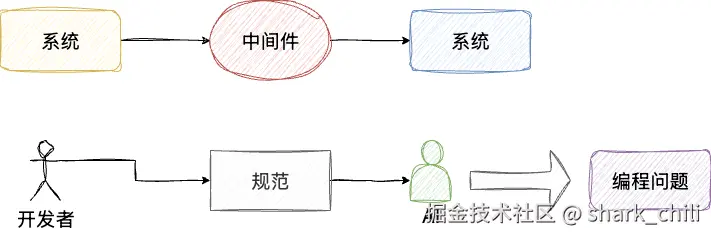
借用软件工程中"增加一层间接层"的说法,我想用下面这句话概括本文的思路:
所有 AI 辅助编程的问题,都可以通过增加一层规范解决。
SharkChili · 禅与计算机程序设计的艺术
开源贡献
- mini-redis :教学级 Redis 精简实现 · github.com/shark-ctrl/...
关注公众号,回复 【加群】 获得笔者联系方式加入技术交流群
参考
《SDD实战:规范驱动开发之道》