YOLO从零到论文:模型改进与科研实战全攻略
YOLO基础篇 · A01
作者:迪菲赫尔曼
开始第一课:先认识 YOLO
这一篇,我们正式开始新专栏的学习。
我知道,有些同学已经接触过 YOLO,可能也跑过几次训练;但也有同学是第一次接触,老师给了一个方向,自己连代码应该放在哪里都还没弄清楚。
所以,咱们从头来。第一篇先不安装软件,也不着急复制一段训练代码。我们先把一个问题讲明白:给 YOLO 一张图片,我们究竟想让它做什么?
这个问题弄清楚,后面收集什么数据、怎么标注、选择哪种模型,才有依据。
至于卷积、网络结构、损失函数,我们后面都会讲,而且会和实际操作穿插起来。今天先建立一个能看懂结果的认识,不需要提前学高等数学。
1. 先看图:人能看懂,电脑需要学
配套资料里有一张街景图片:
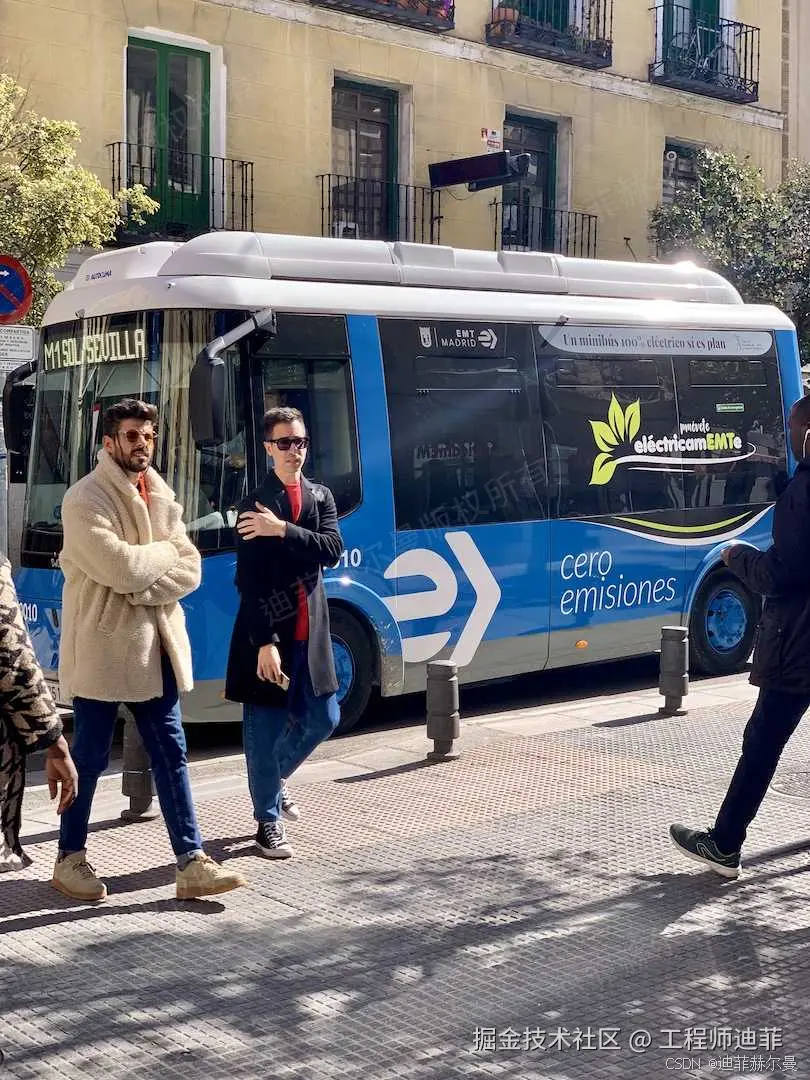
你看这张图,应该很快就能说出:这里有一辆公交车,旁边有行人。
但如果再问得具体一点:
- 图片里哪些地方是人?
- 每个人分别在哪里?
- 公交车的范围有多大?
我们的回答就不只是"这是一张街景图"了,还要指出具体位置。
目标检测,就是让模型尝试回答"有什么、在哪里"这两个问题。
这里的"目标",指的是我们想识别的对象。它可以是人、汽车,也可以是你研究中的果实、害虫、零件、缺陷。
不过,想识别什么,并不是在文章里把名字改一下就能做到。后面我们需要准备对应的数据,让模型有机会学到这些对象的特征。
1.1 图片到了电脑里是什么?
我们看的是一张完整照片,电脑读取后处理的则是数字。
先想象把照片放大很多倍,会看到一个个小格子,每个小格子对应一个像素。彩色图片可以用红、绿、蓝三个通道的数值描述颜色。
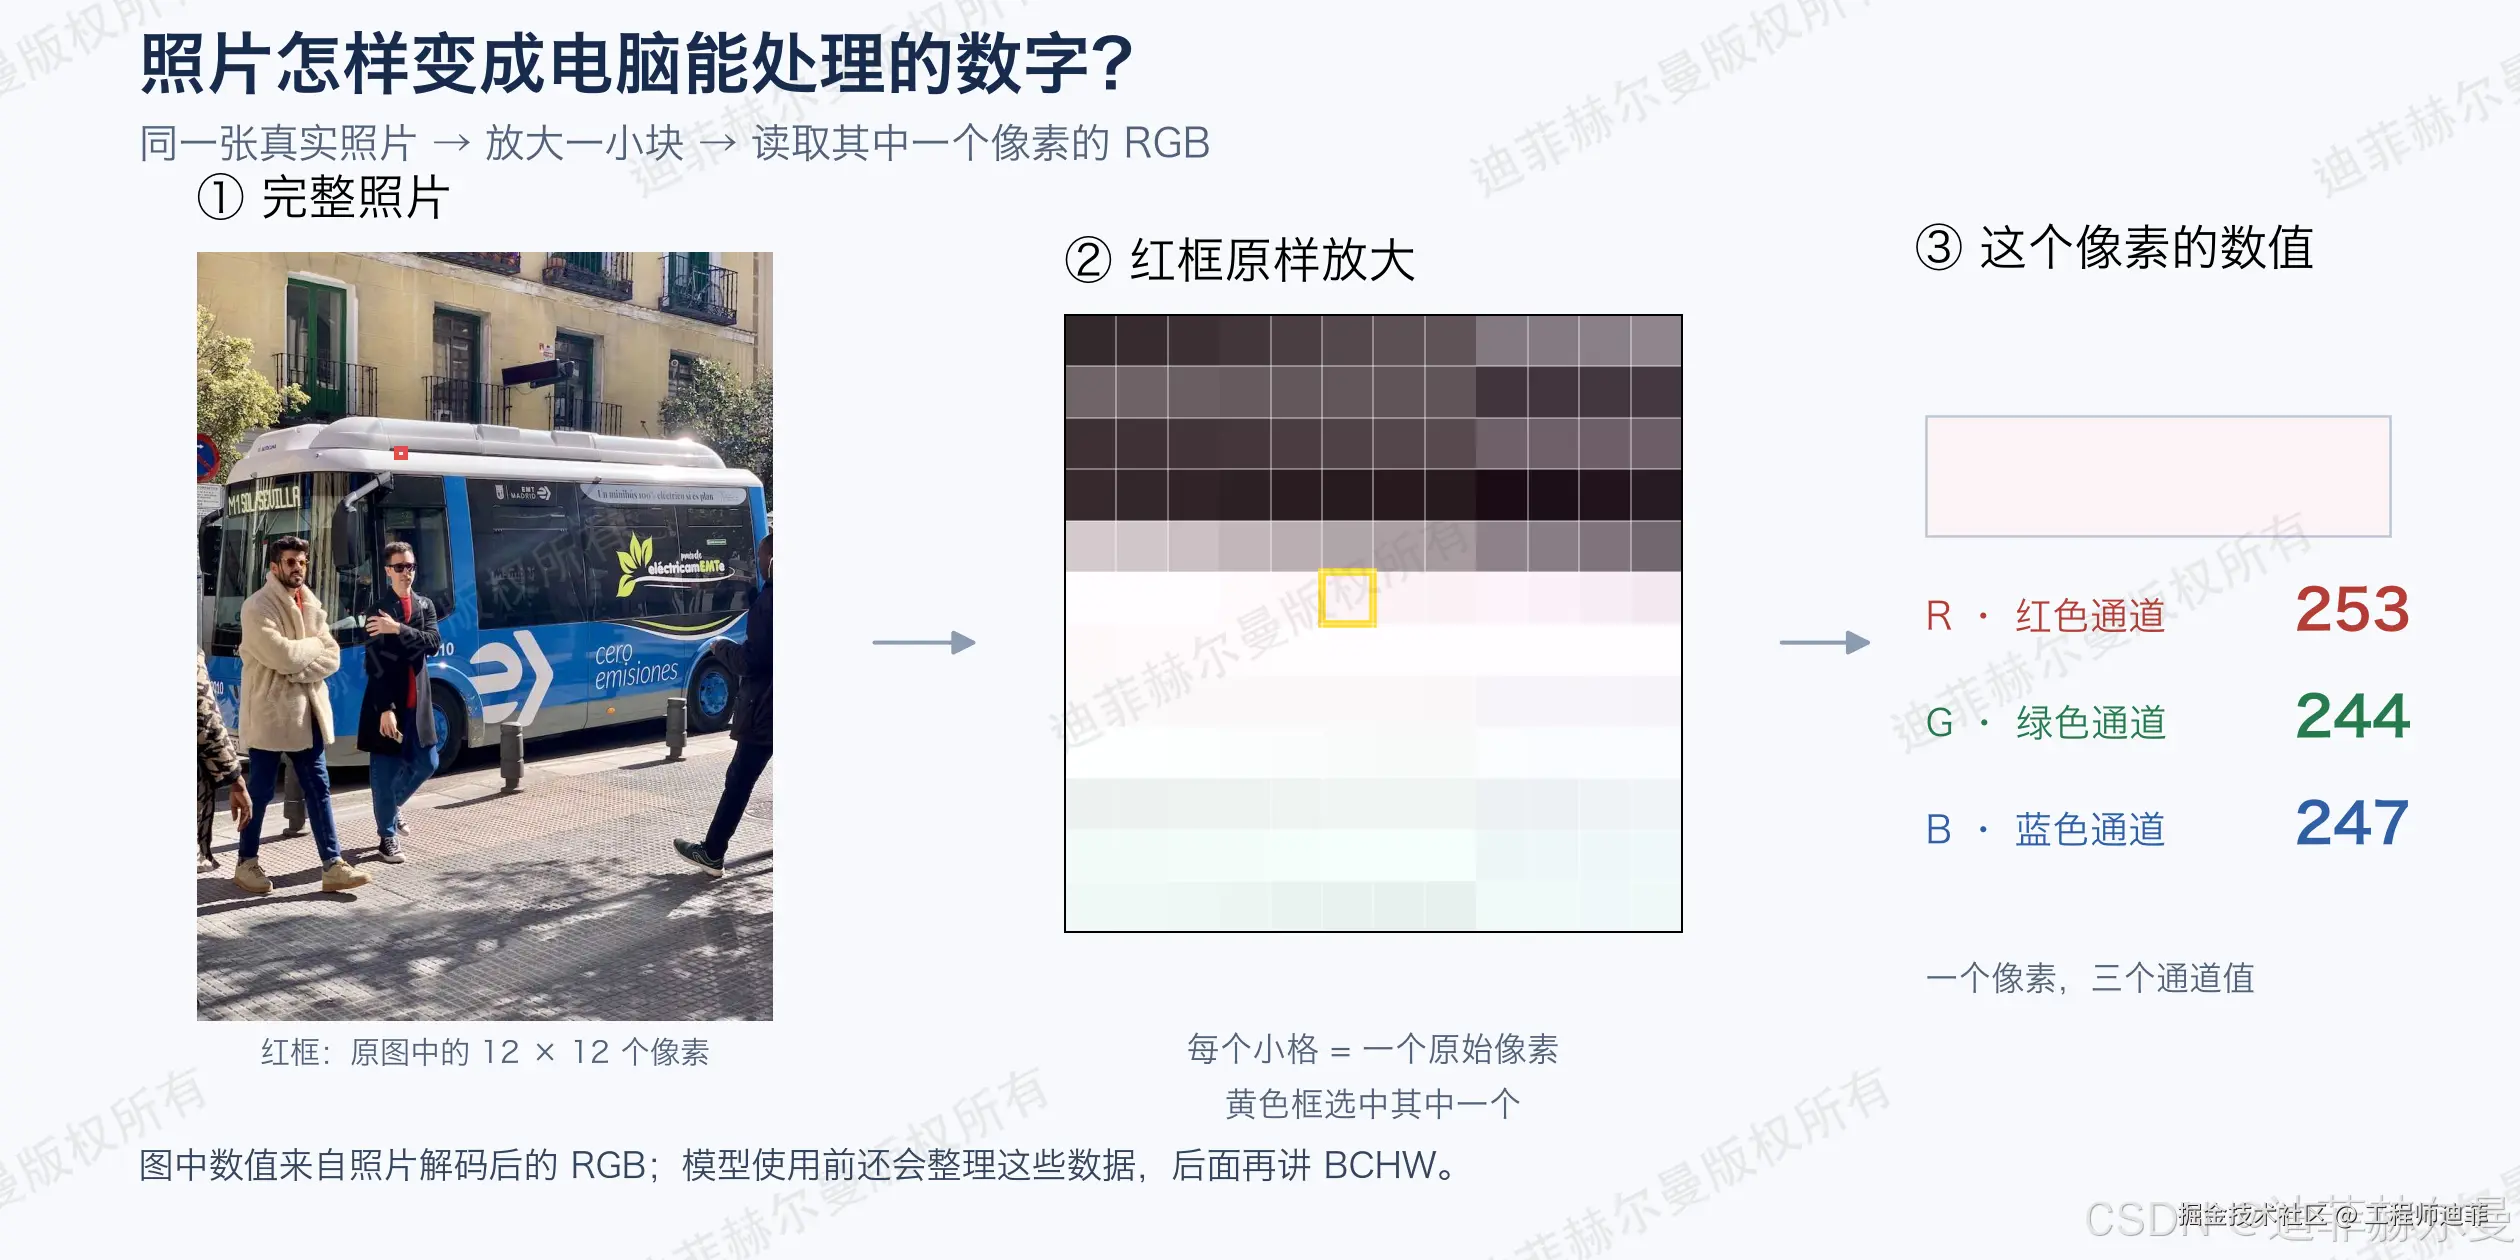
看这张图:左边红框圈出照片里很小的一块,中间把这一块放大,每个小格仍然对应原来的一个像素。黄色框选中的像素,读取后是 R=253、G=244、B=247;这三个值共同描述它的颜色,不是三种目标类别。图中的格子只是为了让你看清原有像素,放大没有给照片增加新细节。
图片和数值来自本教程的真实照片。这里先理解"颜色可以用数字表示",不用记住这三个数,也不用跟着计算。
现在不用记存储格式,也不用计算这些数字。先理解一件事:模型接收的是经过读取、整理的图像数据,并没有一个和人一样的"看图窗口"。
后面讲张量时,我们会把这件事接到 B、C、H、W 上。今天先记住,图片能转成数字,模型才能对它进行计算。
1.2 模型是不是去网上搜了一张相似图片?
我们这套课程里使用的 YOLO,做预测时主要根据模型参数对输入图片进行计算。它不需要每次拿到一张图,就去网上搜索同款图片。
可以先把过程想成:
text
输入图片
   ↓
整理成模型能够处理的数据
   ↓
模型进行计算
   ↓
整理预测结果
   ↓
画框、显示类别,或者显示其他任务的结果
这张流程图是概念说明。具体怎么整理数据、输出怎么解读,后面会对着代码展开。
2. 检测结果里的框、文字和数字,各表示什么?
先看一张已有的检测结果:
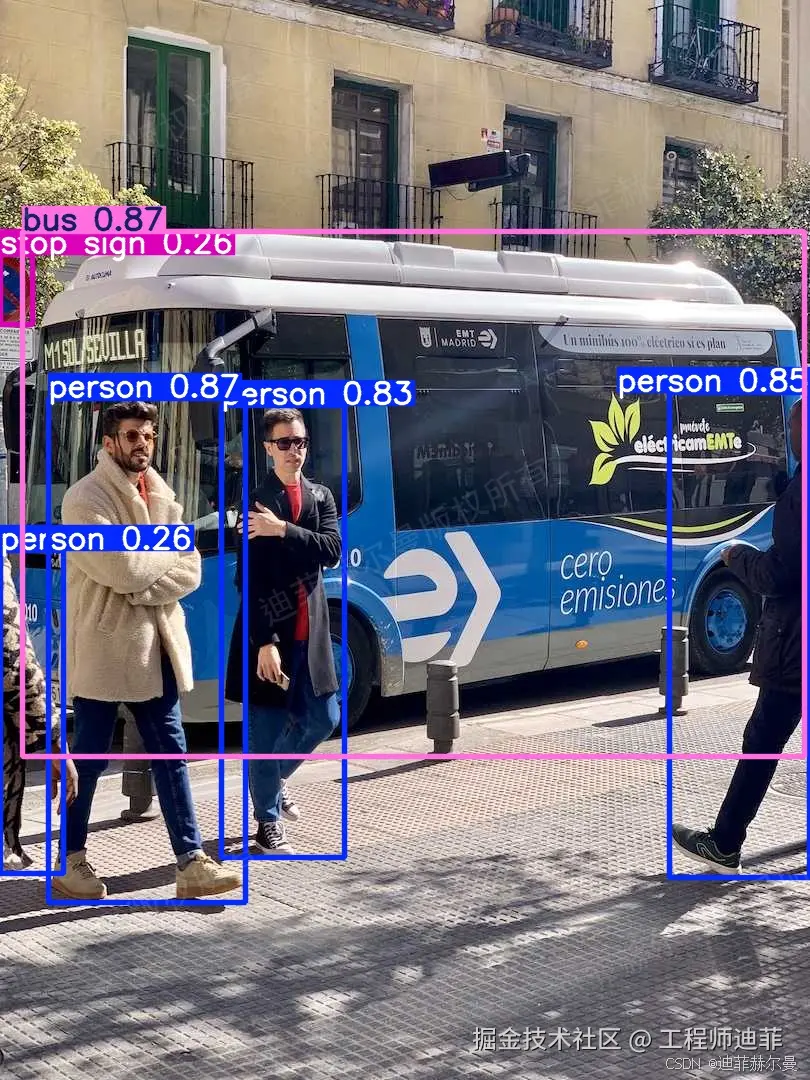
这是用于认识输出形式的已有示例,不是本篇刚运行的新模型结果;图中预测也可能出现错误。
先看公交车,再看行人。它们周围出现了矩形框,框旁边还有文字和数字。
咱们把它拆成三部分。
2.1 框:模型认为目标大致在哪里
矩形框叫作边界框,也常写成 bounding box。
它用一个矩形表示目标的位置和范围。
注意看公交车的框:框里面除了车,也可能包含一些背景。因为公交车的轮廓并不是一个完美的矩形,矩形框只是用比较简单的形式把它包围起来。
所以,检测框并不等于把公交车的每一个像素都抠出来。这一点,等会儿和分割对比就清楚了。
框也不要求永远画得正好。模型有可能画大、画小、漏掉目标,或者把背景当成目标。我们后面学习评价指标,就是要有办法衡量这些问题。
2.2 类别:模型把这个目标判断成什么
person 表示人,bus 表示公交车。
我们称这些名称为类别。
先区分"一个类别"和"一个目标":同一张图里可能有三个人,他们属于同一个 person 类别,但可以是三个不同的目标,各有自己的框。
再举一个贴近课题的例子。假设你做苹果检测,类别只有 apple 一个,图片里有五个苹果。即使类别只有一种,模型仍然可能需要输出五个苹果的位置。
因此,类别数量和图片里的目标数量,是两回事。
2.3 数字:这一次预测的置信度
假设某个预测旁边写着:
text
person 0.87这行文字的意思是:模型把这一个候选目标判断为 person,并给了它一个 0.87 的置信度分数。
有的界面会把分数显示成百分数。但不要顺手把它说成"模型准确率 87%",也不要认为它就是经过严格校准的正确概率。
它描述的是这一次预测的分数;评价整个模型,需要在一批有正确答案的数据上计算指标。
比如,模型对十张图片中的一个框很有信心,不代表另外九张都预测正确。反过来,一个看起来分数很高的框,也可能认错。
后面第一次预测时,我们会调整显示结果的置信度阈值,观察框的数量如何变化。现在先别急着调参数,把"单个预测分数"和"整个模型的评价指标"分开就可以了。
3. 框的位置怎么变成数字?
我们用手指一下屏幕,说"车在这里",人可以理解。程序要记录位置,就需要具体的数值。
为了好理解,咱们单独设一个例子:
text
图片宽:640 像素
图片高:480 像素

某个目标的框:
左上角 (100, 80)
右下角 (300, 280)
这些数字是讲解用的假设值,不是上面街景图的实际测量结果。
通常按左上角为原点来理解,横向往右是 x 增大,纵向往下是 y 增大。
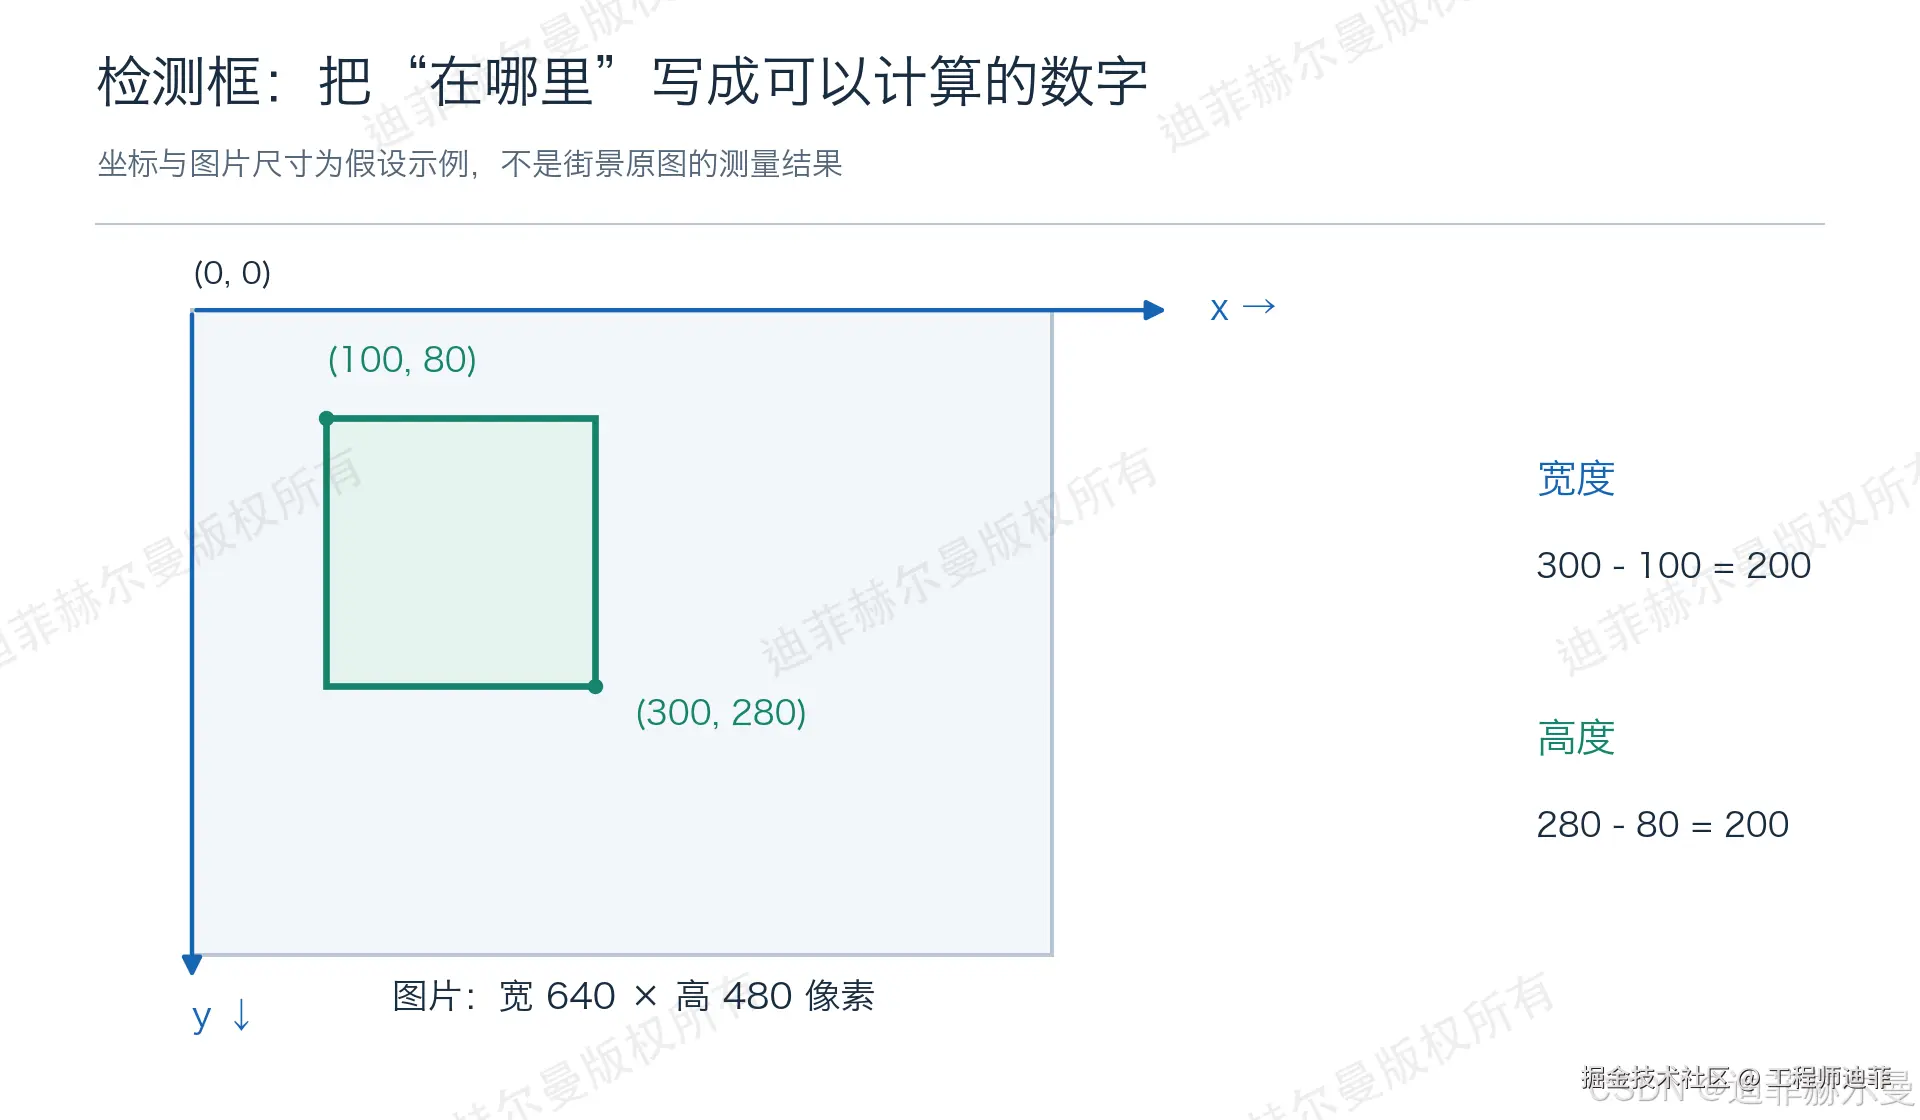
先找到两个角点,再做坐标差;这不是街景图的实测坐标。
那么,这个框的宽度是多少?
text
300 - 100 = 200高度是多少?
text
280 - 80 = 200这就把"一个位置范围"表达成了可以计算的数字。
以后会看到不止一种框的表示方法,比如两个角点,或者中心点加宽高。有的数值还会按图片尺寸归一化。我们学标注格式时再转换,现在不要求记全部写法。
今天只要能解释:检测结果既要有类别,也要有位置;位置不是一句文字,而是可以存储、比较和计算的数值。
4. 同样处理图片,检测、实例分割和分类有什么区别?
新专栏会围绕检测、实例分割、分类做例子。先把它们的目标分清,后面就知道自己该走哪条路线。
4.1 目标检测:找出对象,并给出框
还是刚才的公交车例子。
如果我们希望找到每辆车、每个人,并知道大致位置,就可以考虑目标检测。
text
输入:一张街景图
输出:若干个目标,每个目标有类别、框和分数
注意,"若干个"也可能是零个。没有检测结果,不一定是程序没有运行,也可能是没有符合条件的预测。到第一次运行时,我们会具体排查。
4.2 实例分割:进一步给出每个对象的区域
看下面的结果:
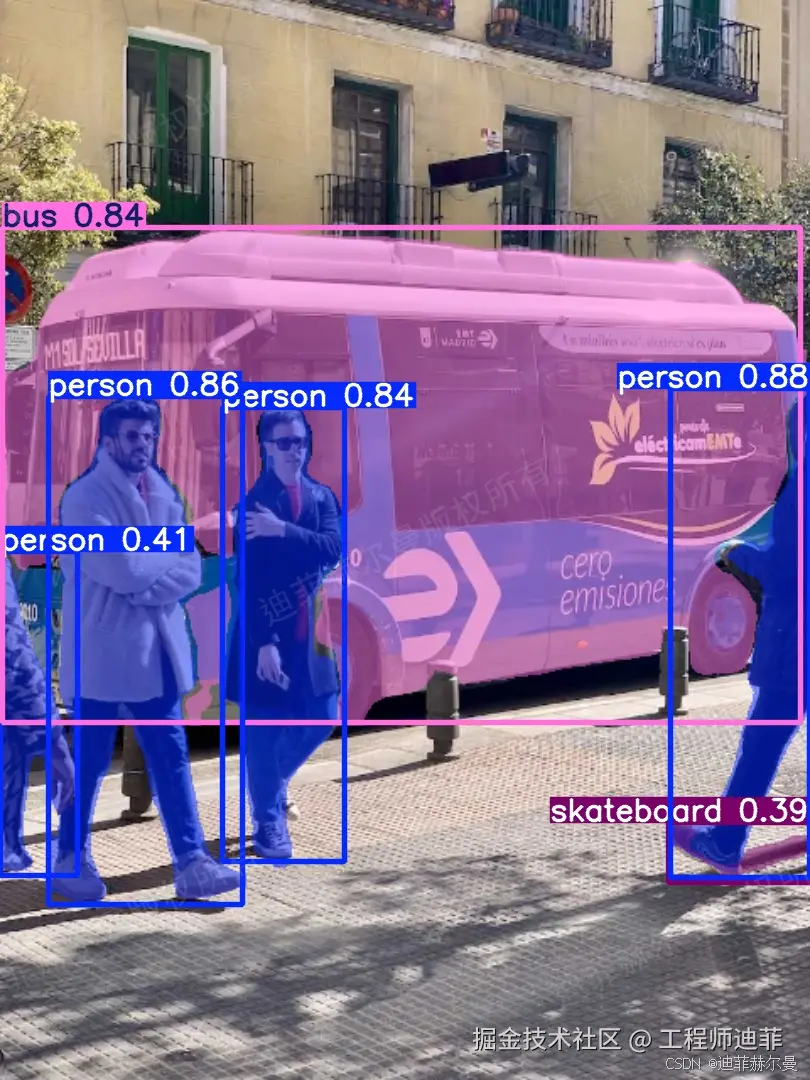
同样用于认识输出形式。不同颜色帮助我们区分预测对象,不能仅凭颜色判断类别或预测是否正确。
和刚才只看矩形框相比,现在还能看到贴着对象形状的彩色区域。
这个区域叫作掩码,英文是 mask。你可以先把它理解成:模型指出了哪些像素属于这个对象。
"实例"强调一个一个具体对象。比如两个人站在一起,实例分割要尽量把他们分别表示出来,而不只是给出一整块"有人"的区域。
它也可能出错,边缘不齐、漏分、错分都需要评价。不要把分割理解成"天然比检测准确",两者要完成的工作不同。
比如你研究叶片,如果只需要知道叶片在哪里,检测框可能就能服务当前目标;如果还需要分析叶片形状或区域,分割才提供了更细的区域信息。具体选哪种,还要看数据、标注成本和研究问题。
这里说的是实例分割。语义分割也会给像素分配类别,但通常不区分同类别里的不同个体,后续拓展篇再讲。
4.3 图像分类:判断整张输入图更像哪一类
再看分类示例:
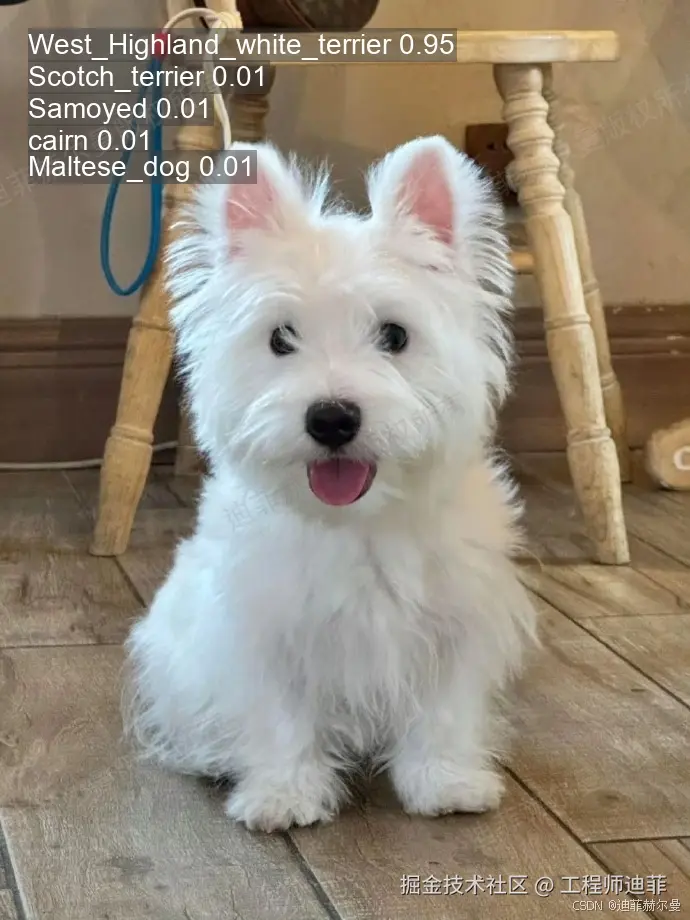
这个例子回答的是"这张输入图属于什么类别",没有为图里的每一只狗分别画框。
text
输入:一张图片
输出:类别及相应分数
假设你的任务是判断一张已经裁剪好的零件图片是"合格"还是"不合格",可以先考虑分类。
但如果一张照片里有十个零件,要分别找到其中哪几个不合格,整图分类就不能直接提供每个零件的位置。你需要重新分析任务,可能要检测,也可能要组合多步处理。
课题名称里有"识别"两个字,并不能直接决定用哪种任务。先看你最终需要的输出。
4.4 放在一起比较
| 你希望模型回答的问题 | 先考虑的任务 | 你要看的主要结果 |
|---|---|---|
| 有哪些对象,分别在哪里? | 目标检测 | 类别和边界框 |
| 每个对象具体占了哪些像素? | 实例分割 | 类别、对象掩码等 |
| 整张输入图属于哪一类? | 图像分类 | 类别及分数 |
Ultralytics 还支持其他任务;任务边界可以参考官方任务说明。我们先把这三种学扎实,再扩展。
5. 模型是怎么学会的?先分清训练和预测
举个例子:我们希望模型识别月饼。
你只把一张月饼照片交给电脑,并说一句"以后都帮我识别",电脑并不会因此自动学会你的任务。
在常见的监督学习流程里,我们需要提供一批图片,以及对应的标注。
标注就是为训练提供的参考答案。不同任务的答案形式不同:
| 任务 | 一张图片的标注,直观上提供什么 |
|---|---|
| 检测 | 哪些位置有月饼,每个框是什么类别 |
| 实例分割 | 每个月饼对应的区域,以及类别 |
| 分类 | 这张输入图属于哪一类 |
同一张原图可以用于不同任务,但标注不会自动互相等价。检测框里没有完整的像素轮廓,不能直接当作精细分割的真实答案。
5.1 训练:利用数据调整模型参数
训练过程中,模型先给出预测,然后根据预测与标注之间的差异计算损失,再通过优化过程调整参数。这个过程会重复很多次。
先把损失理解为训练使用的一种衡量差异的数值,不要先把它当成最终论文指标。
具体有哪些损失、不同任务怎么计算,我们会在能跑通训练之后,用实际输出和代码来讲。今天先知道训练不是"把图片存进一个文件夹",它还发生了参数的学习与更新。
5.2 预测:使用已有参数处理输入
有了训练好的模型,再给它一张图片,让它输出结果,这个过程叫预测,也经常叫推理。
text
训练:图片 + 标注 → 学习与调整参数 → 得到模型权重
预测:图片 + 已有模型权重 → 得到预测结果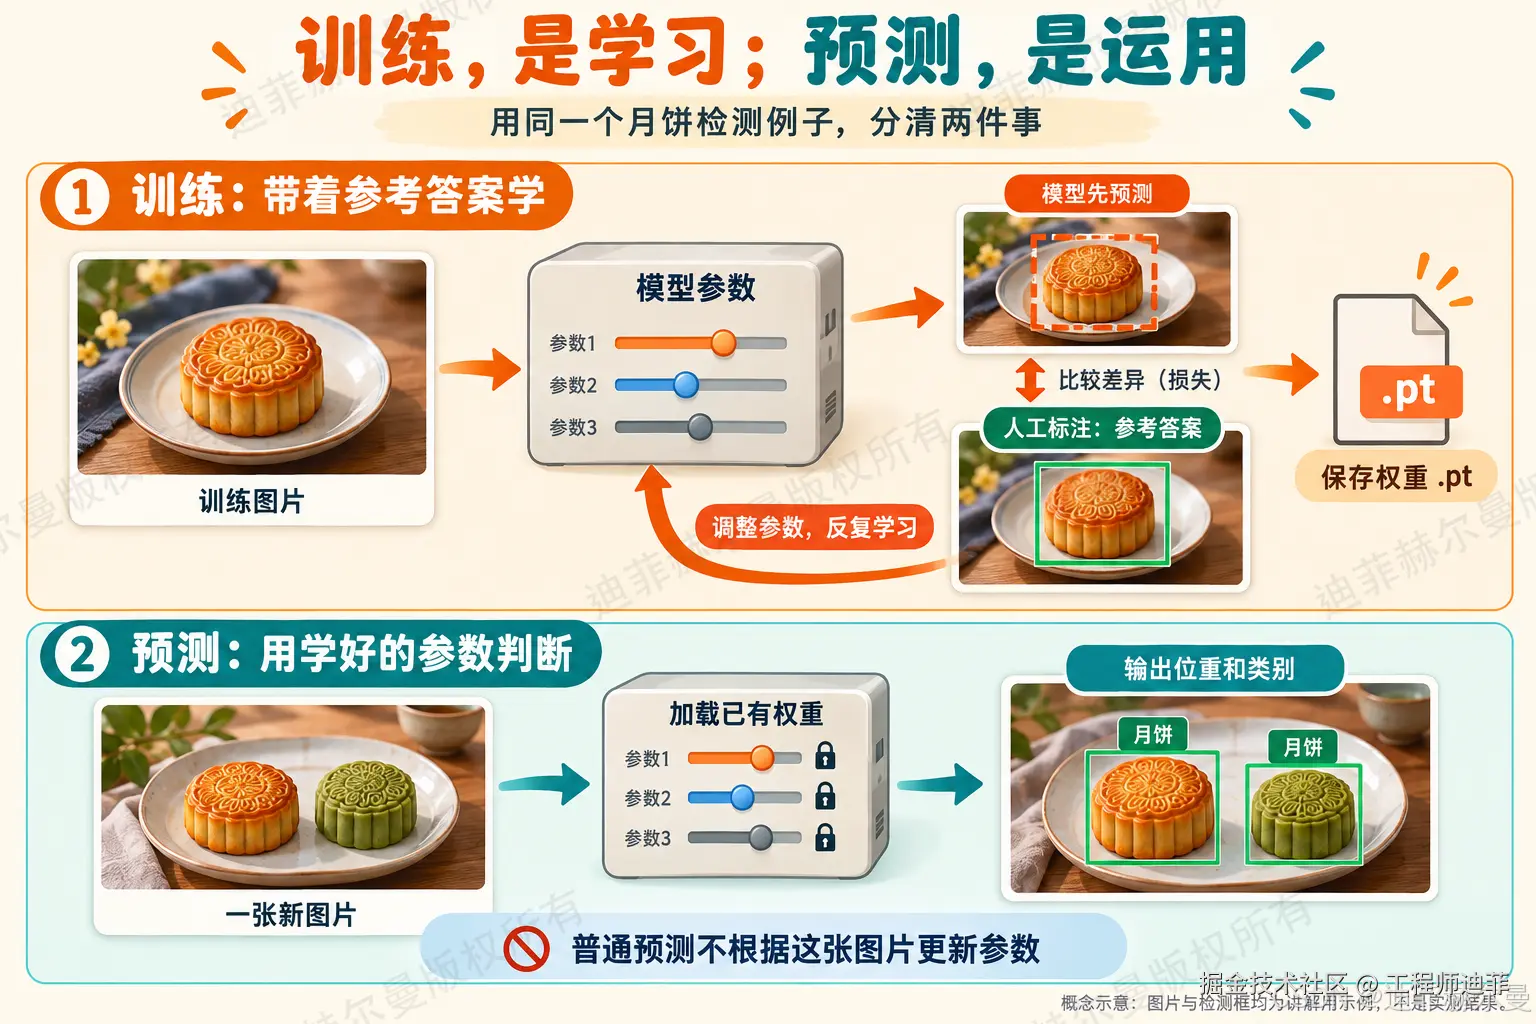
先看上半部分:模型先试着框月饼,再和人工标注的参考答案比较,根据差异调整参数,反复学习后保存权重。下半部分则是加载已有权重,对新图片输出结果,普通预测不根据这张图片更新参数。
这是概念示意图,月饼、检测框和参数旋钮都是讲解用的画面,不是训练实测结果;旋钮只是在表示"参数可以被调整",模型并不是一台真的旋钮机器。
后面我们会先用官方已经训练好的权重做预测,再训练自己的数据。
这样安排是为了先把输入、命令、输出文件这些操作走通。第一张结果图跑出来以后,你就知道整个程序在做什么了。
5.3 权重是什么?为什么会有 .pt 文件?
可以先把权重理解成模型学习得到的一组参数。后面的 .pt 模型文件会用于保存和加载相关模型信息。
但是,有了文件不等于它能识别任何对象。某个模型如果没有针对你的类别、数据分布学习过,就不能因为你把文件改名成"月饼模型.pt",便获得月饼识别能力。
后面还会学习预训练、迁移学习、验证集和测试集。这里先把最基本的关系接起来:图片是输入,标注服务于学习和评价,权重保存学习得到的模型信息,预测结果则是运行后的输出。
6. YOLO 和 Ultralytics,为什么经常一起出现?
YOLO 这个名字来自 You Only Look Once ,可以对照最初的 YOLO 论文理解这个名称的由来。在这里先把它看作目标检测方法及其后续发展的一个系列。
名字里的"Once"不要理解成"训练只看一次图片",也不是说模型内部只有一步计算。训练仍然可能反复遍历数据,模型内部也有许多层。
Ultralytics 则提供了我们课程将使用的 Python 软件包、模型实现和训练、验证、预测等工具。
你以后看到:
text
安装 ultralytics
加载某个 YOLO 权重
调用训练或预测接口
这几件事分别涉及软件、模型和运行过程,不是三个互不相干的项目。
不同 YOLO 版本的结构和训练细节会变化。所以,新专栏会在实战开始时写清楚实际使用的代码版本与权重,后面的修改也围绕固定基线展开。不会让大家拿着一套版本的教程,去猜另一套源码里的对应位置。
6.1 YOLO 是怎么一路发展过来的?先认识这张地图
你以后查资料,会看到 YOLOv3、YOLOv5、YOLOv8、YOLO11、YOLO26,也会看到 YOLOv6、YOLOv7、YOLOv9、YOLOv10、YOLOv12、YOLOv13。
第一次接触,很容易以为它们和手机系统一样,都是同一家公司按顺序更新出来的:学最新的,就把前面的全部覆盖了。
这里先纠正一个认识:YOLO 的发展有多支团队参与。版本名里的数字,不能单独用来判断作者、代码是否兼容,或者哪个模型一定更适合你的课题。
下面这张图只选取代表节点,让你先有一个整体印象。年份按早期论文公开或项目发布所在年份标记,不把所有会议发表年份、后续代码大版本都挤进来。
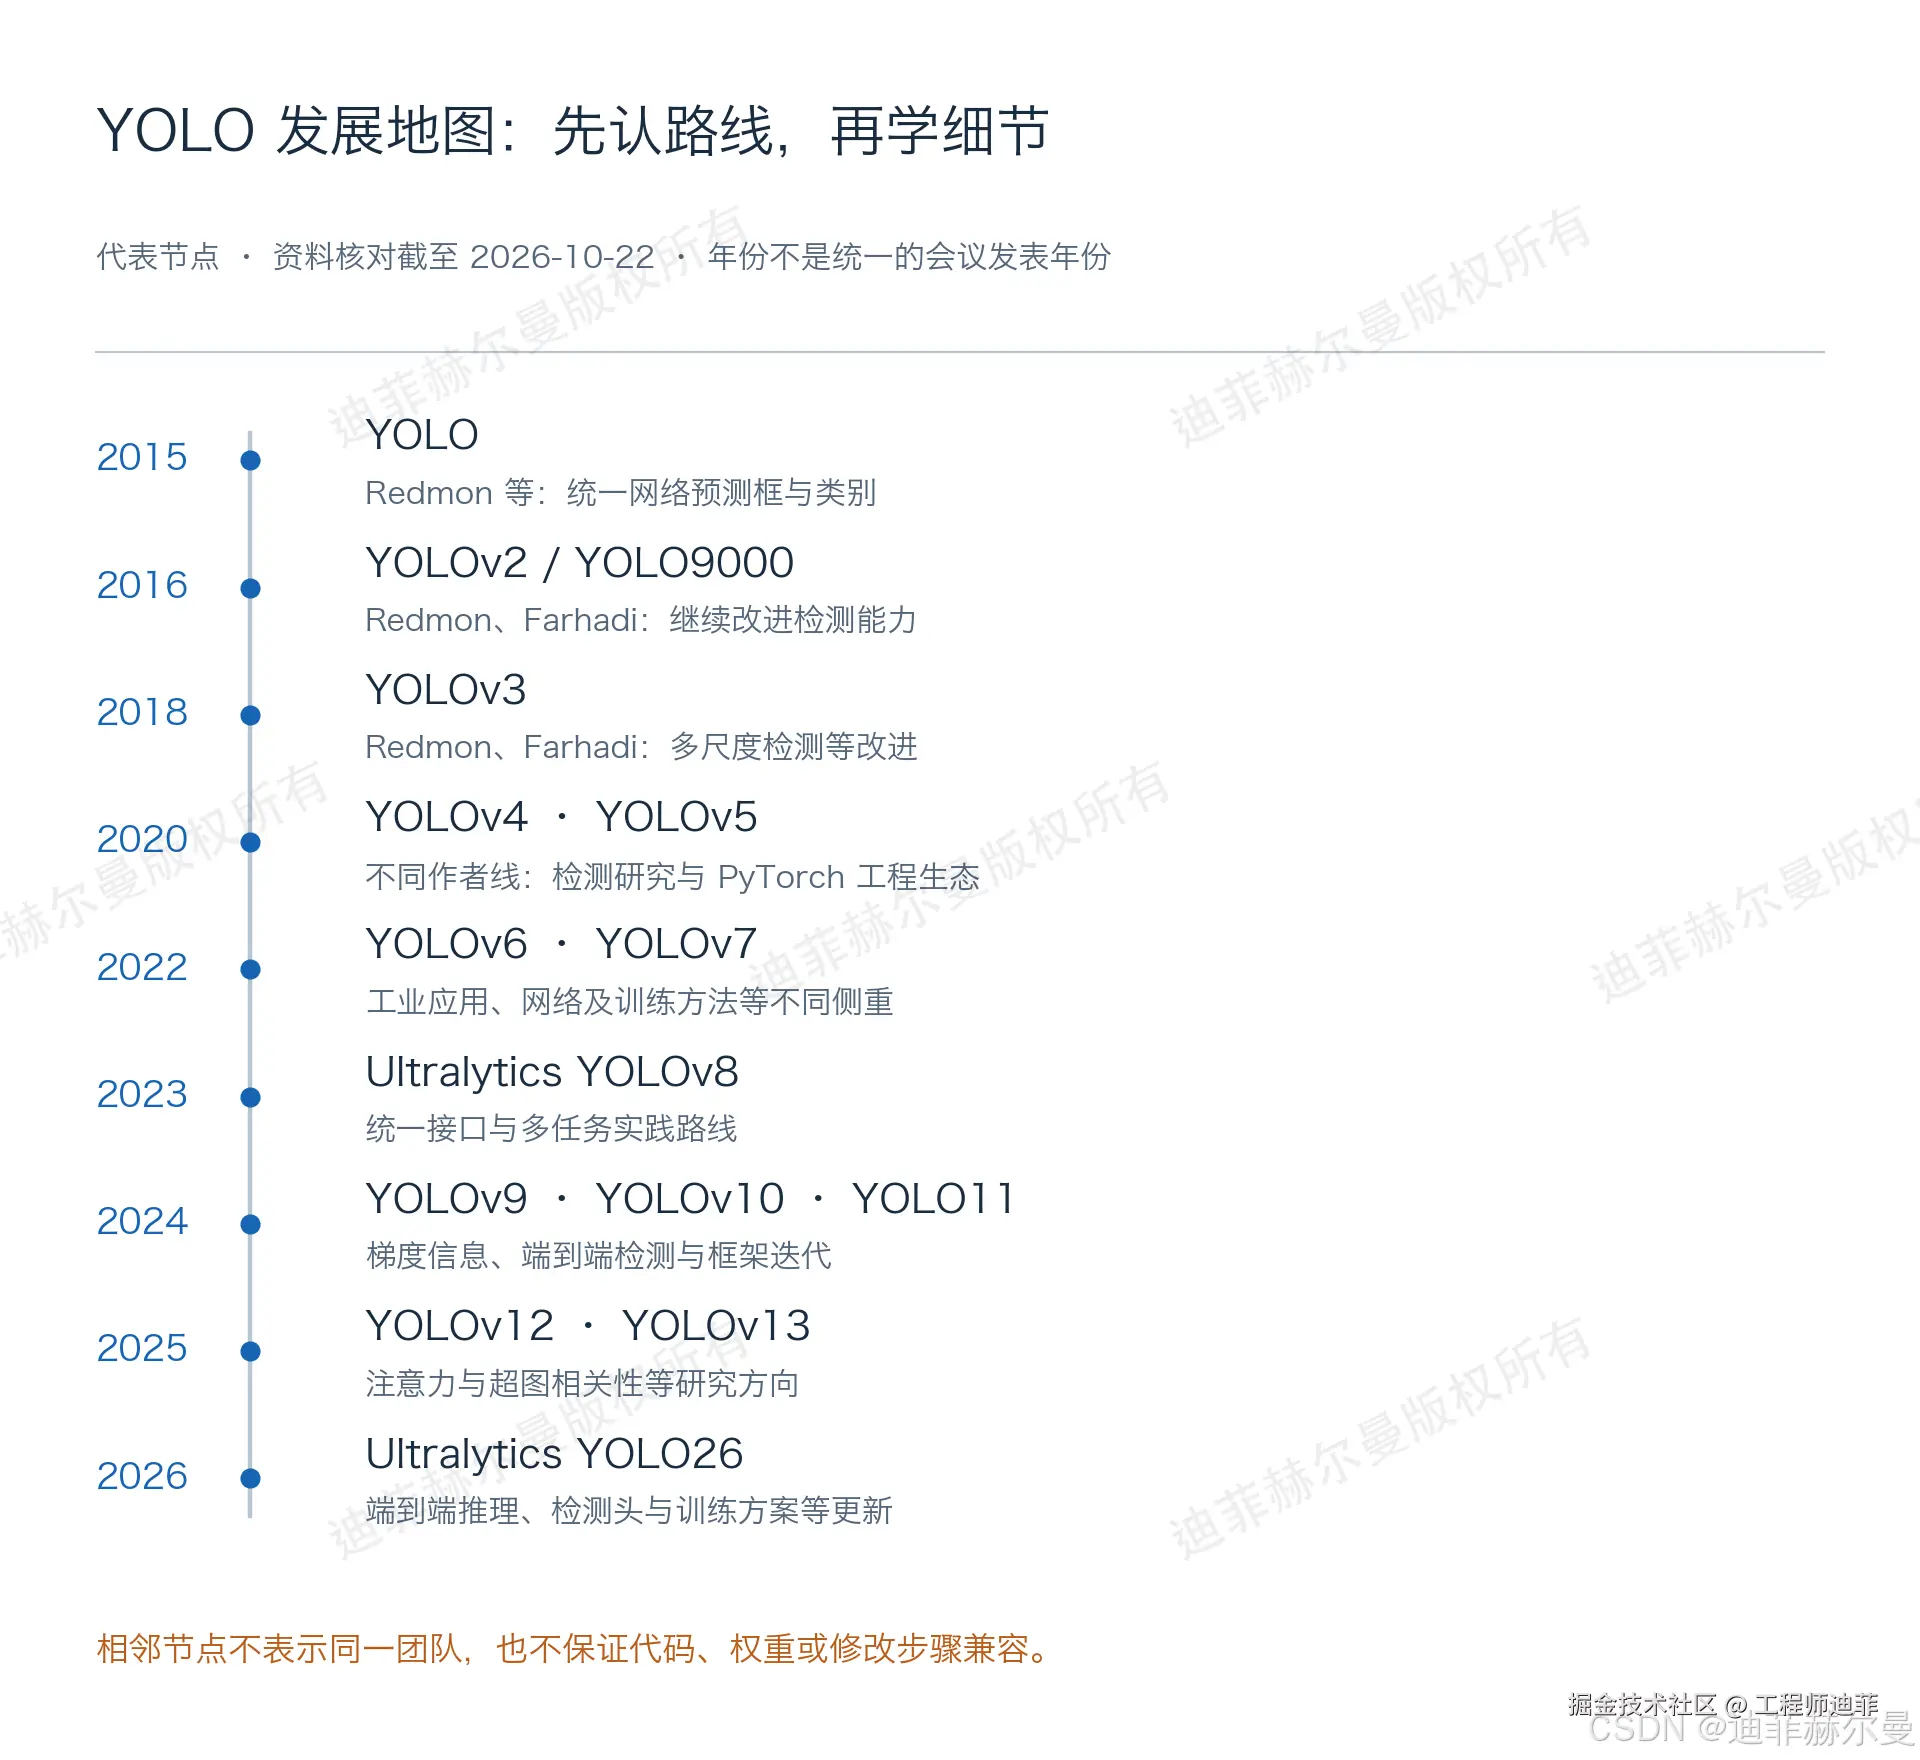
这是一张历史认知图,不是精度排行榜,也不表示图中相邻项目都有直接的代码继承关系。资料核对截至 2026 年 10 月 22 日。
6.2 第一阶段:YOLO 把什么事情做得不一样?
回到 2015 年公开的最初论文。作者 Joseph Redmon 等人把目标检测表述为:直接从整张图片预测目标框和类别相关输出,通过一个统一网络完成主要计算。
你现在可以联系前面的街景图来理解:我们希望把"公交车是什么"和"公交车在哪里"一起变成模型的预测结果,同时重视运行速度。
它的意义不只是名字里那个"看一次",而是提供了一种兼顾整体检测流程与速度的思路。这里不要求你比较所有早期检测方法,更不要把"看一次"理解成只有一层网络。
随后,Redmon 和 Ali Farhadi 又公开了 YOLOv2、YOLOv3。它们持续改进检测能力;你后面学习到的锚框、多尺度预测等概念,可以放回这一段历史里理解。
现在不懂"锚框"也没关系,先把它当成后面要学习的一种框预测设计。我们不会在这里先塞一整套陌生公式。
这一阶段的原始资料,分别是 YOLO 论文、YOLO9000/YOLOv2 论文、YOLOv3 技术报告。它们公开于 2015、2016、2018 年;不要把首次公开年份与会议发表年份混为一谈。
6.3 第二阶段:有更多团队参与,路线开始丰富
到了 2020 年,YOLOv4 和 Ultralytics YOLOv5 都成为重要节点,但它们并不是同一份项目换了两个名字。
YOLOv4 的作者是 Alexey Bochkovskiy、Chien-Yao Wang 和 Hong-Yuan Mark Liao,论文研究了网络、训练方法等多种因素如何组合。你可以先理解成:检测效果的提升,不只来自"加一个新模块",训练策略和整体设计同样重要。见 YOLOv4 原论文。
Ultralytics 的 YOLOv5 则对应另一套广泛使用的 PyTorch 工程项目。对跟着教程做实验的人来说,训练、预测、验证、导出等工具组织得怎么样,直接影响上手和复现实验的过程。原项目见 ultralytics/yolov5,2020 年的发布信息可查官方模型说明。
注意:原 YOLOv5 仓库与后来 ultralytics 包中的 YOLOv5u,也不能仅凭名字相似就当成完全兼容。跟教程时,仓库、代码版本、权重都需要对应。
再往后,美团团队的 YOLOv6 重视工业应用,YOLOv7 的研究则关注网络设计和训练方法等问题。两者都在 2022 年出现,但并不是因为编号相邻,就能把一个项目里的修改步骤原封不动搬到另一个项目。可以分别查 YOLOv6 项目、YOLOv6 报告和 YOLOv7 论文。
"基于哪个项目做的",是科研实验里需要交代的信息,不能只写一个 YOLO 名字就结束。
6.4 第三阶段:多任务工具与新研究方向一起发展
2023 年,Ultralytics 发布 YOLOv8。我们的旧教程主要围绕这一阶段的代码展开。它不仅是模型名称,也和统一的 Python 调用方式、命令行及多任务工作流程联系在一起,见官方 YOLOv8 说明。
2024 年,又出现了不同方向的代表工作:
| 项目 | 主要团队或作者线索 | 现在先记住的研究侧重 |
|---|---|---|
| YOLOv9 | Chien-Yao Wang、I-Hau Yeh、Hong-Yuan Mark Liao | 研究训练中的梯度信息,并提出 PGI、GELAN |
| YOLOv10 | Ao Wang 等作者,THU-MIG 项目 | 研究不依赖传统 NMS 后处理的端到端检测,以及效率设计 |
| Ultralytics YOLO11 | Ultralytics | 继续迭代模型及其多任务使用流程 |
PGI、GELAN、NMS 这些缩写目前只作为路标,不要求背全称,更不要求现在推导。比如 NMS,你先知道它与整理、筛选预测框有关;到后处理原理篇,我们再拿重叠框实际演示。
对应资料:YOLOv9 原论文、YOLOv10 原论文、YOLO11 官方说明。
2025 年,YOLOv12 研究以注意力为中心的实时检测设计;YOLOv13 则研究超图增强的相关性建模等方向。它们各有论文作者和项目。即使某份代码基于 Ultralytics 改造,也不代表它就是由 Ultralytics 发布的下一代官方模型。分别见 YOLOv12 原论文、YOLOv13 原论文与作者项目。
2026 年,Ultralytics 又发布了 YOLO26。官方资料强调端到端推理、检测头和训练方案等方面的更新。这些术语背后的代码细节,我们会在后面的实战与源码篇展开,见 YOLO26 官方说明。
截至本篇资料核对时,YOLO26 是 Ultralytics 已发布的新一代模型,YOLO27 仍列为尚未发布的预告。不能把等待名单或预告页面,当成已经可复现的正式基线。发布状态以官方模型总览为准。
这里没有把每个分支、每篇使用 YOLO 名称的论文都收进来。我们的目的,是让你知道这片领域有原始研究、不同团队的模型工作,以及具体工程框架这些不同层次。
6.5 看完历史,新手选模型时到底看什么?
不要从"哪个数字最大"开始,先把下面三件事写清楚:
- 做什么任务。 要的是框、每个对象的区域,还是整图类别?某个模型的检测代码,并不意味着自动具备你要的全部任务。
- 用哪份代码。 是论文作者仓库、Ultralytics 官方仓库,还是别人改造的版本?不同实现要分别核对。
- 怎么比较。 数据划分、训练配置、输入尺寸和设备条件是否一致?不能拿不同条件下的截图分数,直接断言一个版本永远更好。
这套专栏以 Ultralytics 当前代码为实践主线。到正式安装和训练时,我们会固定代码版本、模型配置、权重与运行环境,再围绕它们做修改;历史版本用来帮助理解和对照。
你不需要从 YOLOv1 一直训练到 YOLO26,才有资格进入后面的课。先建立一张地图,之后学到多尺度特征、损失函数或后处理,再把这些知识放回地图里。这样读论文和源码,会比只记一串版本号更有方向。
7. 接下来怎么学?先让每一步都有落点
现在不要求你立刻读懂模型源码。
接下来四篇,我们依次完成:
text
认识文件、文件夹和路径
   ↓
用 VS Code 打开目录,创建并保存代码
   ↓
认识终端,知道命令在哪输入、当前在哪里
   ↓
读懂最小 Python 代码,知道自己改了什么
再往后准备 Python 环境、安装软件、核对运行位置,真正执行第一份程序,再做第一次 YOLO 预测。
操作不是学完一次就结束。后面遇到数据集和配置文件,我们还会回到路径;遇到训练命令,我们还会检查环境;看模型结构时,再把张量、卷积和网络层接进来。
前几篇不需要先买显卡,也不需要先租服务器。先用手里的电脑完成文件操作和代码阅读。到了训练阶段,再根据任务和实验规模选择设备。
最终我们要学的不只是"复制一份能运行的代码",还要能解释改了哪里、为什么改、结果如何验证。论文实验同样要靠实际问题、合理设计和证据来支撑,不能靠堆模块保证结果。
8. 读完这一篇,先对自己的方向有个认识
这一篇是认识 YOLO 的原理导读,不需要安装、运行,也没有必须完成的操作作业。读到这里,先对任务、训练预测和发展路线有一个印象就可以。
如果你已经有课题,可以顺手记下下面三件事;暂时没有,也可以直接继续阅读。第三篇建立学习记录时,再一起填写。
8.1 我想处理什么图片?
例如:
text
我想处理果园里的苹果图片。还没有自己的课题,可以写:
text
先使用课程提供的街景图片,认识行人和公交车。8.2 我希望得到什么结果?
不要只写"识别苹果",试着具体一点:
text
我希望找到每个苹果,并画出它的位置框。这更接近检测。
如果写的是"把每个苹果的像素区域分开",则更接近实例分割;如果写的是"判断裁剪好的单个苹果图片属于哪个品种",则更接近分类。
暂时分不清,可以先把需要的结果画出来。后面再根据这个结果讨论任务。
几个值得带走的认识
同一个类别可以有多个具体目标,每个目标都可以有自己的检测框。框旁边的置信度是单个预测的分数,不等于整个模型的准确率。
检测、实例分割、分类,主要区别在于要回答的问题和输出形式。选择任务时,先想清楚自己需要得到什么结果。
训练利用数据调整参数,预测使用已有参数处理输入。YOLO 后续发展有不同团队参与,编号不能代替对作者、代码来源和实验条件的核对。
不需要背完所有年份和缩写。以后遇到具体网络、损失和代码,再回头看这张地图,会逐渐把认识接起来。
下一篇开始动手,咱们在电脑里建立自己的学习目录。🍀
下一篇:基础篇 02|文件、文件夹和路径