做机器人、或者说做具身智能的这两年,最难受的不是模型跑不通,是跑通了也不知道它到底学没学到东西。
官方演示里机械臂稳稳抓起积木,论文里成功率写着 94%,然后你发现那个场景是作者自己挑的,指令是作者自己写的那句,连相机角度都只有一个。你想自己验一遍,代码在 GitHub 上,权重在 Hugging Face 上------然后卡在第一步:这东西到底怎么跑?
这篇不讲原理。我把这个项目的官方成绩在本机复现了一遍,顺手算了几个官方没写的数。
一、这是什么东西
AMP Tadpole ,一家叫 Adaptive Machine Patterns 的英国小公司做的,650 万参数的视觉-语言-动作(VLA)模型:机械臂有 6 个关节,看三路固定相机(顶视 / 侧视 / 等轴),听一句「把那个青柠色的星星捡起来」这样的指令,然后去抓。
它配套了一个基准叫 AMP Toy Robotics Benchmark,还有一套能在浏览器里直接跑的演示。
最让我停了一下的是作者自己写的一段话------他说这个项目的数据集生成器,最开始是手写的,「看看我还能不能算三维三角函数(不能)」,后来交给本地跑的 Qwen3.8 27B,最后用 Claude Opus 5.5 收尾。模型卡的 Credits 里还多了一个 OpenAI ChatGPT。
也就是说:这个模型的代码,本身就是 AI 写的。
我看到这句的时候第一反应是「那它的成绩可信吗」。所以才有这篇。
二、官方到底给了几个数(先把原始数据摊开)
这是这篇最需要先讲清楚的,因为官方在不同地方给了三个不同的成功率,直接看很容易懵:
| 口径 | 数值 | 出处 |
|---|---|---|
| 作者原帖口述 | 「约 95%」 | Open Robotics Discourse 原帖(抓取与搬运,不含未见场景) |
| 模型卡标准测试 | 93.7%(898 条指令) | HF 模型卡,基准 v0.2.0 |
| 基准升到 v0.3.0 后,同一组权重 | 94.2% | GitHub README |
| 200 个从未参与选模的场景 | 93.1%(608 条) | HF 模型卡 |
teacher 基线(脚本控制器,天花板)也有同样的版本差:99.4%(v0.2.0)/ 100.0%(v0.3.0)。
这三个数不矛盾,是基准版本变了:模型卡跑的是 0.2.0 基准,README 跑的是 0.3.0 基准,同一组权重在不同基准上量出来就是不一样。后面我会说我们本机跑出来是 94.0%,正好卡在 93.7% 和 94.2% 中间------那不是巧合,那是我们在 0.3.0 基准上跑的。
三、我们怎么在本机跑的
先说环境,因为这里有个意外的好消息:
- Windows / Python 3.12.4 / torch 2.14.1+cpu
- 用
python -m venv --system-site-packages .venv建独立环境,依赖零下载------numpy、pillow、torch、safetensors 全局已有 - 仓库 115 KB,模型包 51.9 MB(权重 26.0 + onnx 28.2 + 词表 149 KB)
- 装完只多了一个
amp-toy-robotics包,pip uninstall就能完全清除
更关键的一点:这个基准不需要下载任何数据集。 训练场景是拿整数种子现场生成的,所以同一个种子在任何机器上生成的场景、物体、指令逐位相同。这意味着复现这件事不需要「申请数据权限」「等作者上传」,也不存在「我拿到的数据和作者不是同一份」这种扯皮。
teacher 基线 300 个场景,我们本机从 22:16 跑到 22:45,29 分钟(官方说约 40 分钟,CPU 上跑)。
四、三组数字
第一组,teacher 基线 100.0% ,和官方 0.3.0 基准的那个数对得上。这条本身不稀奇,但它证明我们的评测环境跟官方是对齐的------不然后面所有数字都没意义。
第二组,Tadpole 完整评测 94.0%(898 条指令)。
| 子任务 | pick | move | midpoint | open | close | home | 全部 |
|---|---|---|---|---|---|---|---|
| 成功率 | 94% | 94% | 76% | 100% | 100% | 100% | 94.0% |
对比官方模型卡(0.2.0 基准):93% / 94% / 75% / 100% / 100% / 100% / 93.7%。
我们的 94.0% 落在官方两个口径(93.7% / 94.2%)之间,而且落在 0.3.0 基准那一侧------这就把「95% 是怎么来的」这个疑问关掉了:那个 95% 是口述的近似值,标准测试口径是 93.7%,换了新基准是 94.2%,没有哪个是编的。
第三组,也是我最看重的一组:5 项 grounding test,逐位相同。
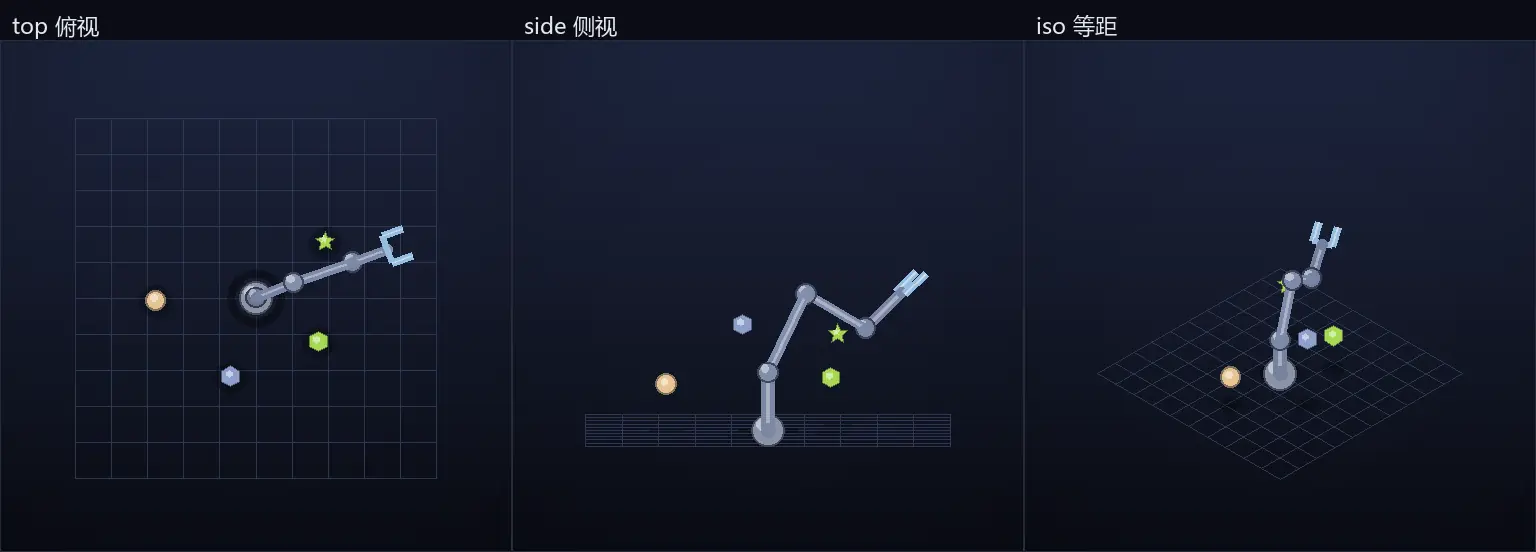
这五项是作者专门设计的防作弊测试。因为大型 VLA 经常根本不看你给的画面、不看你给的指令,就靠猜。
| 测试 | 改了什么 | 官方 | 我们 |
|---|---|---|---|
| named object | 不变,看它是否奔向被点名的物体 | 0.98 | 0.98 |
| other objects | 同上,但看它是否奔向没被点名的物体 | 0.31 | 0.31 |
| image swap | 两个物体互换位置,只有像素变 | 1.00 | 1.00 |
| instruction swap | 换指令,只有词变 | 1.00 | 1.00 |
| blank instruction | 指令留空 | 0.95 | 0.95 |
这五个数怎么读 :image swap = 1.00 说明它真的在看像素(位置变了它的行为就跟着变);blank instruction = 0.95 说明空指令会让它停手而不是瞎动;other objects = 0.31 说明它对「没被点名的物体」有明显的抑制倾向,不是无差别乱抓。
这五项逐位一模一样,意味着我们的评测环境和官方用的是同一套------不是「跑了个寂寞」,也不是「环境太糙导致分数虚高」。
另外两个辅助指标也对上了:步数比 teacher 1.12× (官方 1.13×),路径比直线 1.96×(官方 1.96×,逐位相同)。
五、我们自己算出了官方没写的那部分
README 里有一句话:
The word table was cut to the 32 tokens the instructions use. This changes no output, and takes the model from 19.2M to 6.5M parameters.
「19.2M → 6.5M」这个说法我没找到对应的脚本,于是自己把权重逐项统计了一遍:
| 模块 | 参数量 | 占比 |
|---|---|---|
| transformer 主体(6 层 / 宽 256 / 8 头) | 4,738,560 | 72.8% |
| 共享卷积(三路相机共用) | 1,669,440 | 25.7% |
| 位置 / 视角 / query 参量 | 76,544 | 1.2% |
| 词嵌入 + 词位置嵌入 | 20,480 | 0.3% |
| 动作输出头 | 2,311 | 0.0% |
| 合计 | 6,507,335 | 100% |
统计本身没什么难的,难的是把「19.2M」这个数的来历还原出来:
python
weights = load_file(str(PKG / "weights.safetensors"))
total = sum(v.numel() for v in weights.values())

groups = {}
for k, v in sorted(weights.items()):
    g = ("cnn" if k.startswith("cnn") else
         "word" if k.startswith("word") else
         "fuse" if k.startswith("fuse") else
         "head" if k.startswith("head") else "other")
    groups[g] = groups.get(g, 0) + v.numel()

# 词表裁剪的账:SmolVLM2 分词器 49152 → 指令实际用到的 32
used_vocab = len(json.loads((PKG / "instructions.json").read_text())["vocab"])
old_emb, new_emb = 49_152 * 256, used_vocab * 256
saved = old_emb - new_emb
untrimmed = total - new_emb + old_emb # 反推未裁剪的体量- 原词表 = SmolVLM2-500M-Video-Instruct 分词器的 49,152 个 token(
tokenizer_config.json里vocab_size: 49152) - 裁剪后只保留指令真正用到的 32 个(规范指令共 1,644 条)
- 词嵌入:49,152×256 = 12,582,912 → 32×256 = 8,192 ,省下 12,574,720
- 未裁剪总参数 = 6,507,335 − 8,192 + 12,582,912 = 19,082,055 = 19.08M
判定:6.5M 这个数和实测对得上(实测 6,507,335 = 6.51M);官方说的 19.2M,实际是 19.08M,是往大了取整的说法。
但真正让我停下来的是这件事的反面:
这次「瘦身」省下的 1,257 万参数,全部来自词表 ------占原模型的 65.9%。可裁完之后,词嵌入总共只剩 2 万参数,占整个模型的 0.3%,可以忽略不计。
也就是说,决定这个模型体量的是 transformer 主体和 CNN,跟词表一点关系都没有了。 「小模型」这件事在词嵌入这个维度上已经做完了,剩下的空间在视觉编码和主干网络------这跟大多数人的直觉是反的。
顺带把它的结构常量也读出来了,这几个数字解释了「650 万参数」到底是怎么用的:
ini
GRID = 16            # 每路相机 16×16 = 256 个 token
CHUNK = 8            # 一次输出 8 步动作
STATE_DIM = 7        # 6 个关节角 + 夹爪开合
TOKEN_LEN = 48       # 指令槽位
STATE_FEATURES = 31  # 状态经 sin/cos 展开
token 总数 = 3×16×16(图像)+ 48(指令)+ 1(状态)+ 8(动作)= 825。
一次前向,825 个 token 进去,8 步动作出来,没有采样、没有自回归。 这也是为什么它能在纯 CPU 上 29 分钟跑完 300 个场景------每步的成本比扩散策略或者自回归 VLA 便宜得多。模型小不是侥幸,是结构上就这么设计的。
六、浏览器里跑的那个,跟本地跑的是同一个模型吗
官方演示是个 Hugging Face Space,浏览器里用 Pyodide 跑 Python,不用装环境、不用 GPU、不用 API key,第一次访问会下载约 61 MB。
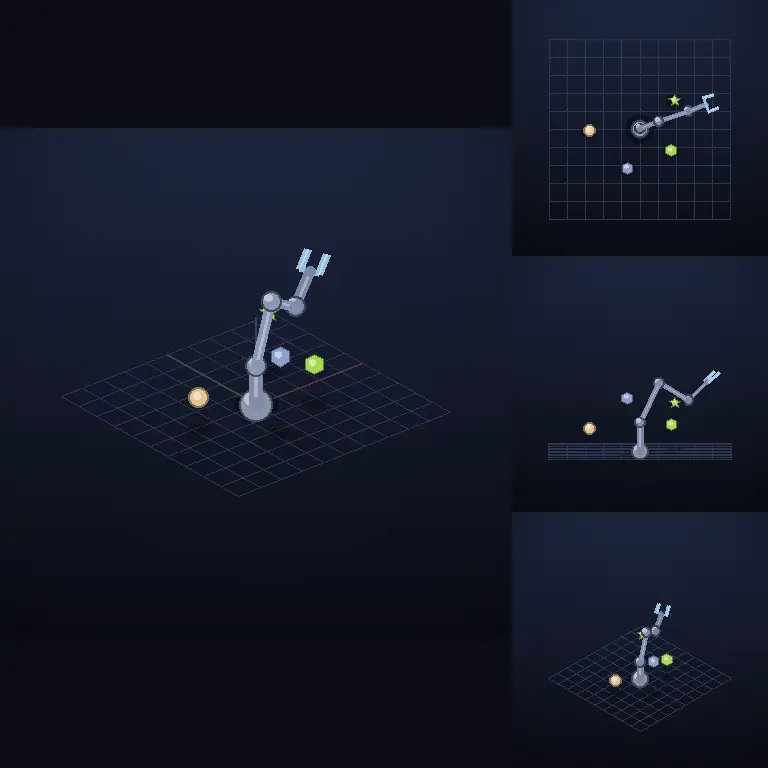
那它跑的是 ONNX 导出版,跟我们本地跑的 PyTorch 版,是同一个模型吗?我用同一个观测(场景 9000007,指令「Pick up the lime star」)走了两条推理路径对比:
| 指标 | 值 |
|---|---|
| 最大绝对差 | 2.384e-07 |
| 余弦相似度 | 1.000000000 |
浮点误差在 1e-7 量级------是同一个模型。
然后我又自己写了个驱动脚本,把官方导出的 amp-tadpole.onnx 当后端,接进基准的闭环里自己驱动机械臂:
| 项 | 值 |
|---|---|
| 指令 | Pick up the lime star |
| 总步数 | 34 |
| ONNX 调用次数 | 5 次(每次输出 8 步动作),总共 1.5 秒 |
| 单次推理 | 平均 299 ms(含三路 512×512 图像渲染) |
| 是否抓住 | 是,抓住了 lime star |
| 是否触步数上限 | 否 |
注:抓取判定由 benchmark 的物理逻辑给出(指尖与物体距离 ≤ 容差且在闭合瞬间),不是我目测。
这条是我最想给读者看的东西 :不是「模型声称能抓」,是我把它的浏览器后端拆下来自己接进闭环,它真的把那个青柠色的星星抓起来了。
七、浏览器里到底能干什么
顺手把那个 Space 逐个点了一遍,功能比想象中多:
- 四个视角(Free 3D / Top / Side / Iso),可拖拽旋转
- 点选式指令输入 :积木式拼装,
INSTRUCTIONS(pick up / move to / open the gripper / close the gripper / return home)+OBJECTS(lime square / coral triangle / teal star...)+ 连接词 - 语音输入(Listen)和朗读(Read)
- Model Viewer :把模型的每一层画成建筑的一层------底部是相机画面,中间是主干的每一层,顶上是机械臂下一步动作,用一次真实运行点亮。这个可视化我觉得比论文里的架构图好懂
- New scene 会随机一个模型训练时从没见过的新场景
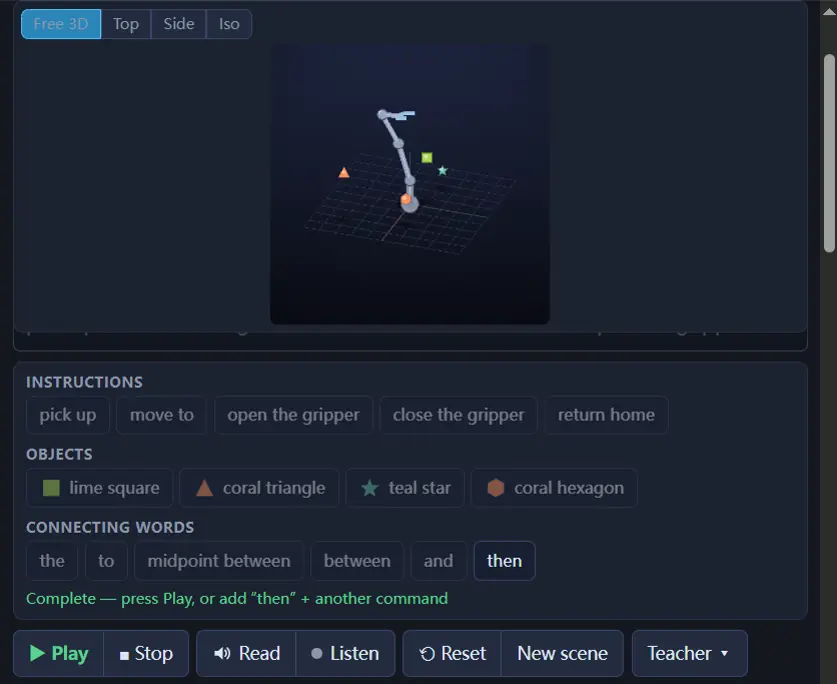
⚠️ 有一个付费 Pro 版,官方页面明列。免费版只有 Demo 面板;加载自己的 PyTorch 模型、从 HF 拉 LeRobot 模型、两次运行并排对比、保存图片视频轨迹、在无限 benchmark 数据上训练微调,这些都在 Pro 里。
八、边界(这些必须一起说)
这个模型的能力边界,模型卡自己写得很清楚,我照搬:
- 只认固定句式。自由文本会先被基准改写成规范句式,模型本身不处理自然语言变体
- 只见过这一个模拟世界 :一台机械臂、三路固定相机、8 种颜色、5 种形状,没见过真实相机
- 「midpoint」(移到两物体中点)是最弱项,75% 。原因是两物体中间是空地,画面里没有可瞄准的目标,而它只占 10% 的训练指令,训练结束时误差还在下降
- 所有结果来自一次训练,没有换随机种子复现
- 官方自己的免责段,我觉得该原样留着:teacher 是确定性的、无限的、相机是固定的------这就是为什么 650 万参数能在这里表现好。这不是对更大 VLA 在人类演示基准上的反面证据。
还有一条商用上必须注意的:
| 对象 | 协议 | 能商用吗 |
|---|---|---|
| 数据生成器 + 基准代码 | Apache-2.0 | ✅ 可以 |
| AMP Tadpole 模型权重 | CC BY-NC 4.0 | ❌ 不行,商用要单独联系作者 |
文章里所有配图都是我们本机用 Apache-2.0 的基准代码渲染生成的,不是转载官方截图。渲染结果不含权重。
九、所以这说明了什么
它证明的:在「一台机械臂 + 固定相机 + 固定句式」这种高度受控的环境里,650 万参数能到 94%,而且这个 94% 经得起 5 项防作弊测试的检验(图像一换它就跟着换、指令一空它就停手)。
它没证明的:650 万参数能干活。VLA 这条路真正难的是泛化到没见过的场景、真实的相机、真实的指令分布------而这个模型恰好在训练结束时误差还在下降的那一类任务上最弱。
作者自己给了一句我觉得挺诚实的话:These numbers are a line in the sand, not a ceiling.(是给后来者立的一根线,等着被超越。)
我唯一想补的一句是 :这根线是用 AI 写的代码立起来的。一个 6.5M 参数的模型,配一套 AI 写的 1,644 条规范指令和训练场景生成器,能被独立复现到逐位一致------这件事本身可能比 94% 这个数字更有意思。
如果你也想跑一遍:代码在 GitHub 的 Adaptive-Machine-Patterns/amp-toy-robotics(Apache-2.0,开源 ),权重在 Hugging Face 的 Adaptive-Machine-Patterns/amp-tadpole(CC BY-NC,不可商用 ),浏览器演示是 Adaptive-Machine-Patterns/amp-embodied-ai-workbench-demo。不需要申请数据权限,不需要 GPU,一个整数种子就能开始。
资料检索与信息核对由 AI 辅助完成,判断与取舍由我负责。