当模型开始理解物理世界,当 Agent 开始进入真实生产,数据平台需要提供哪些新的能力?在 2026 云栖大会上,阿里云智能集团计算平台事业部 EMR 负责人李钰以《EMR:Agentic Lake 全模态数据处理与极速分析》为题,分享了相关实践与思考。
去年 EMR 的判断是:开放让计算与存储连接起来,高效使规模化使用成为可能,智能让产品的专业能力更容易被使用。这些判断依然成立,但过去一年出现了两个值得关注的变化:Agent 从单轮、多轮对话进入真实生产;模型的应用则从数字场景拓展到物理世界,开始学习空间、时间与动作之间的关系。
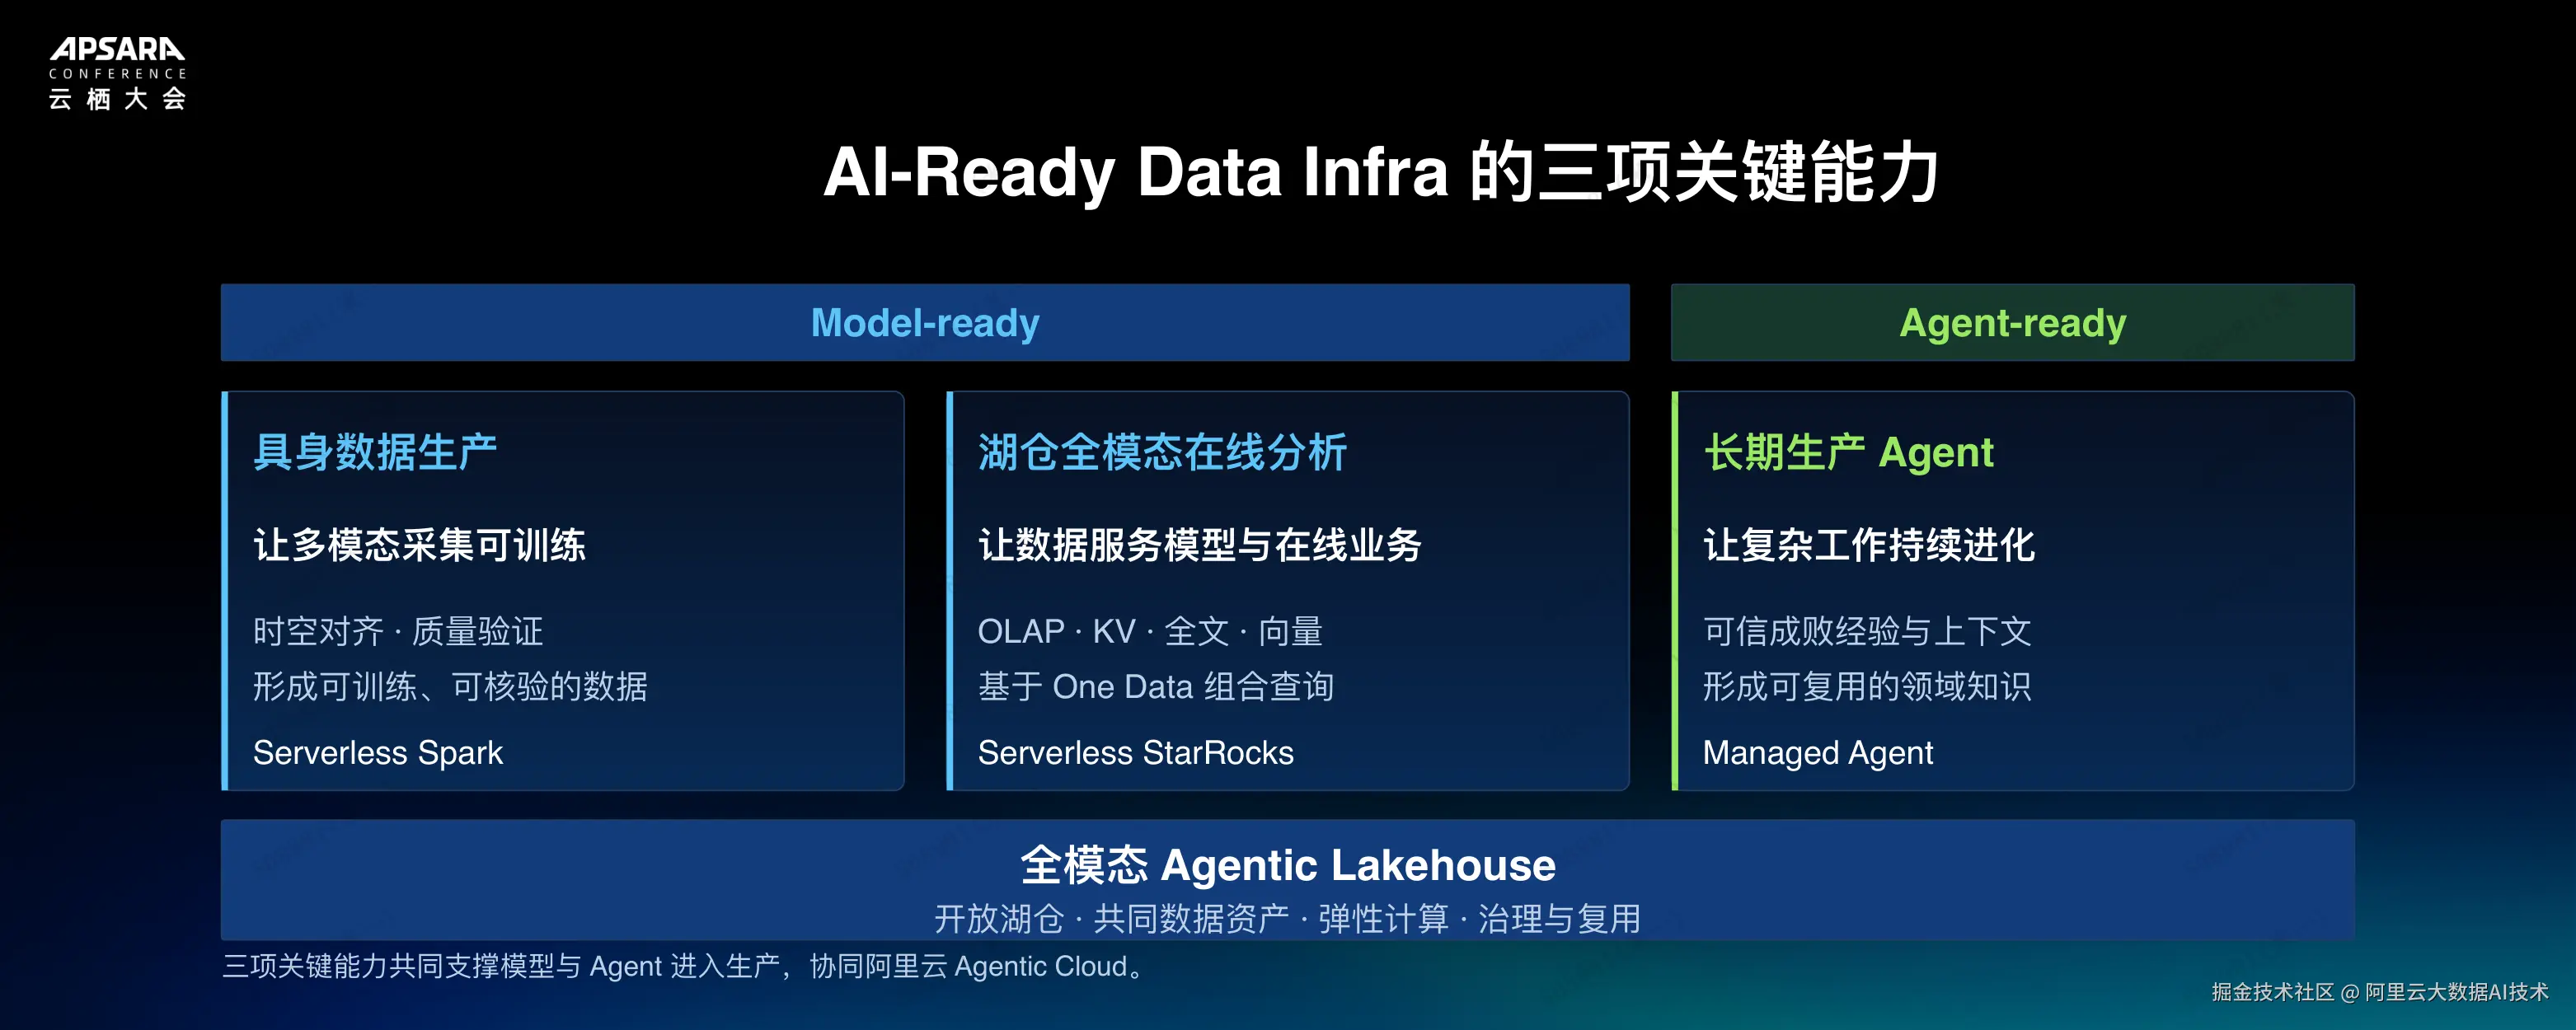
李钰提到,面向这些新场景,AI-Ready Data Infra 需要具备三项关键能力:在数据生产上,让视频、点云、动作和传感信号在时间、空间与质量上保持一致,能够还原真实动作;在数据服务上,除传统在线服务外,还要通过标量、向量、全文等组合查询支持模型迭代与样本圈选;在长期生产中,让可信的成功与失败经验经过治理转化为知识,成为 Agent 下一轮工作的基础。EMR 的年度升级正是围绕这三项能力展开。
Serverless Spark:让多模态采集成为可训练资产
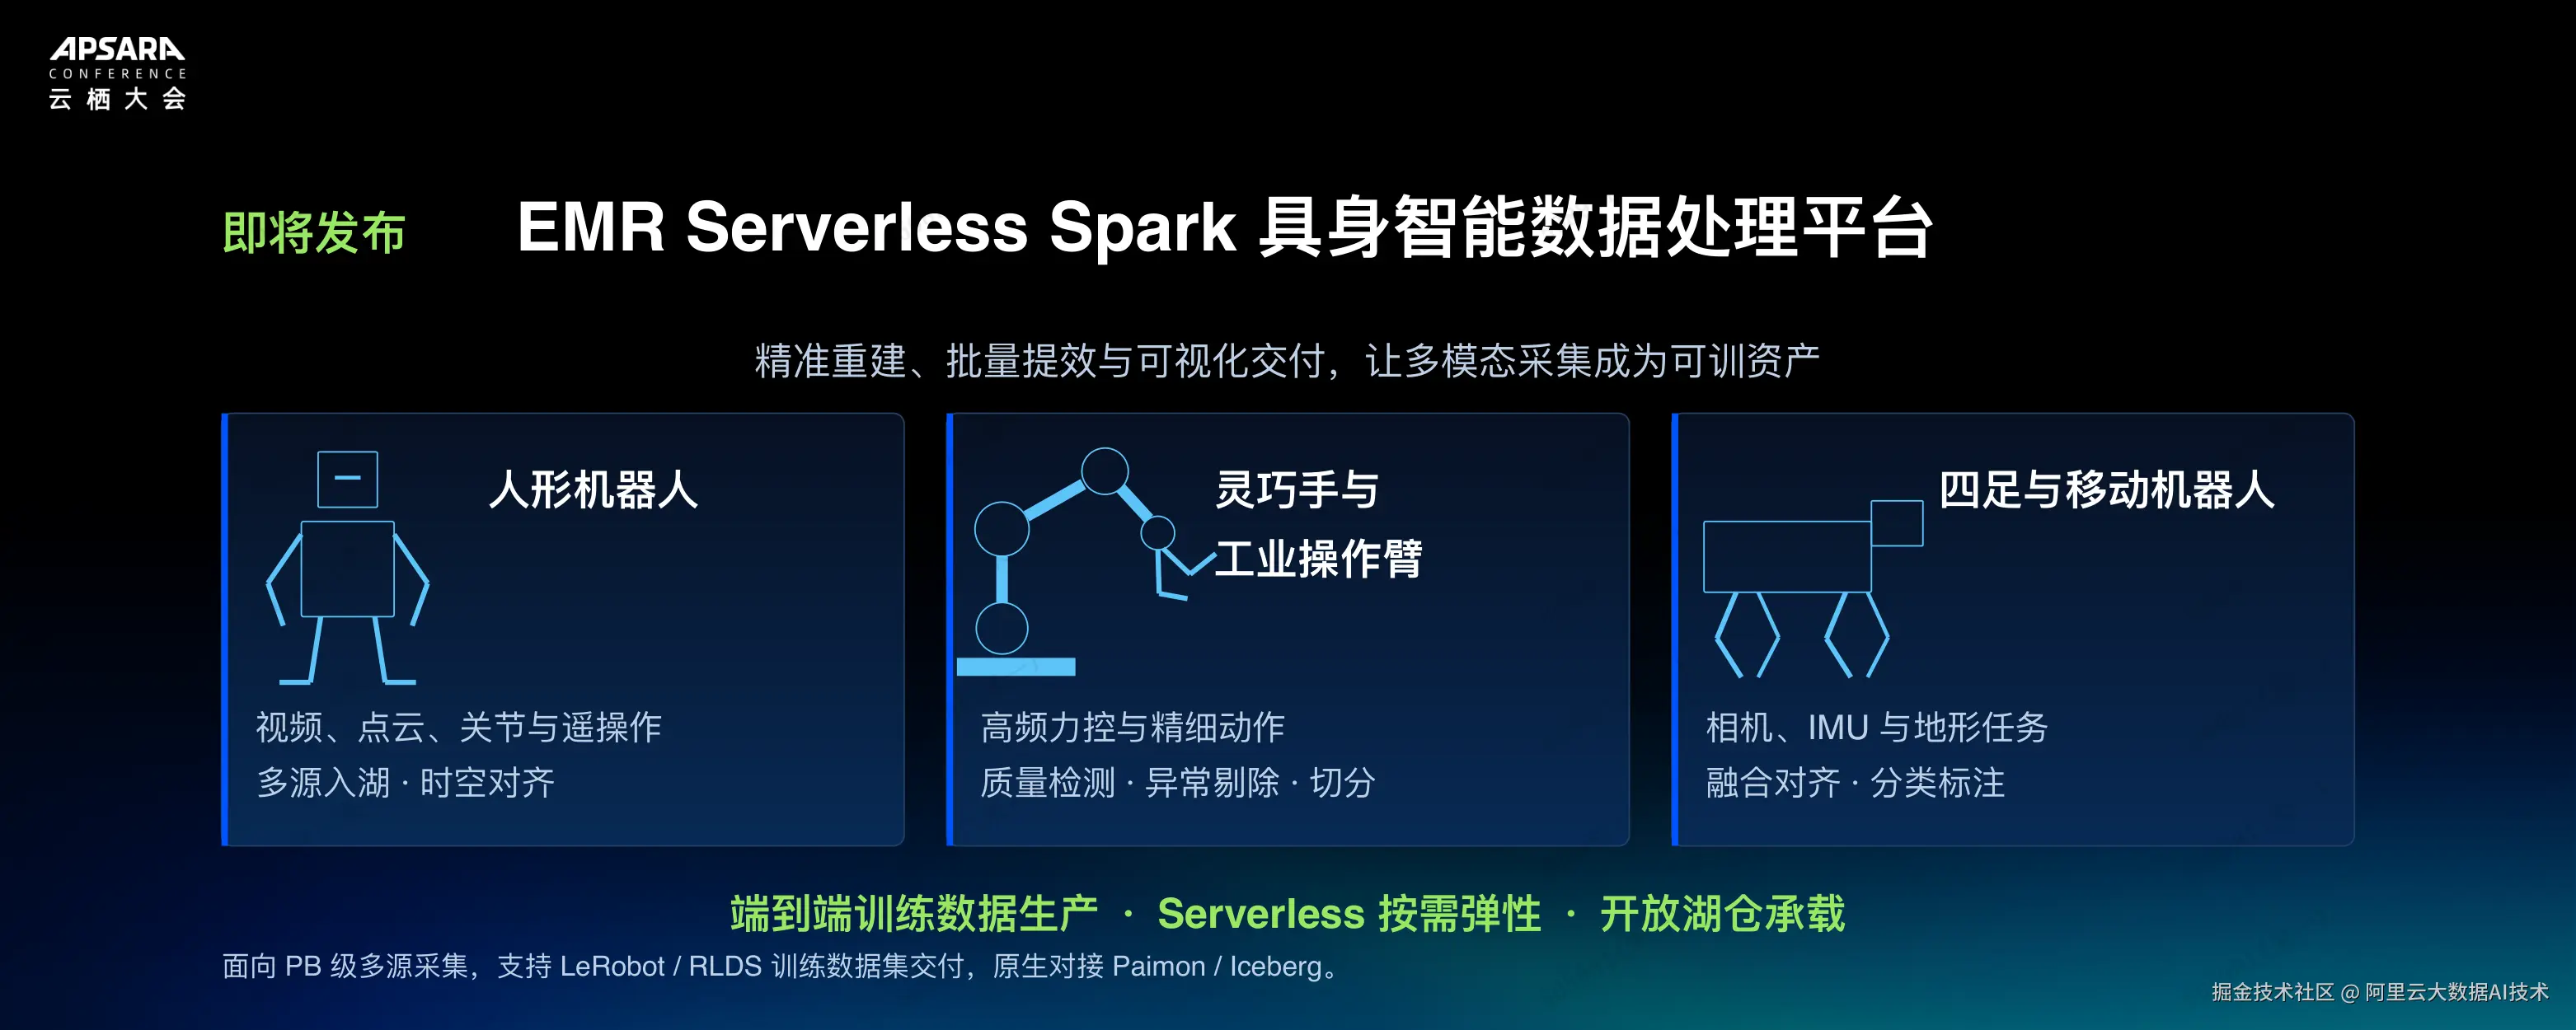
具身智能对数据生产提出了不同于传统分析的要求。人形机器人需要对齐视频、点云和关节轨迹;工业操作臂需要从高频力控信号中识别有效动作;四足机器人则需要融合相机、IMU 与地形信息。这些场景共同要求数据在时间、空间和质量上保持一致,能够还原真实动作。
EMR 宣布即将发布 Serverless Spark 具身智能数据处理平台,将精准重建、批量处理与可视化交付结合起来,以 Serverless 按需弹性承接端到端训练数据生产。平台面向 PB 级多源采集,支持 LeRobot / RLDS 数据集交付,原生对接 Paimon / Iceberg。
可信重建与质量验证贯穿交付
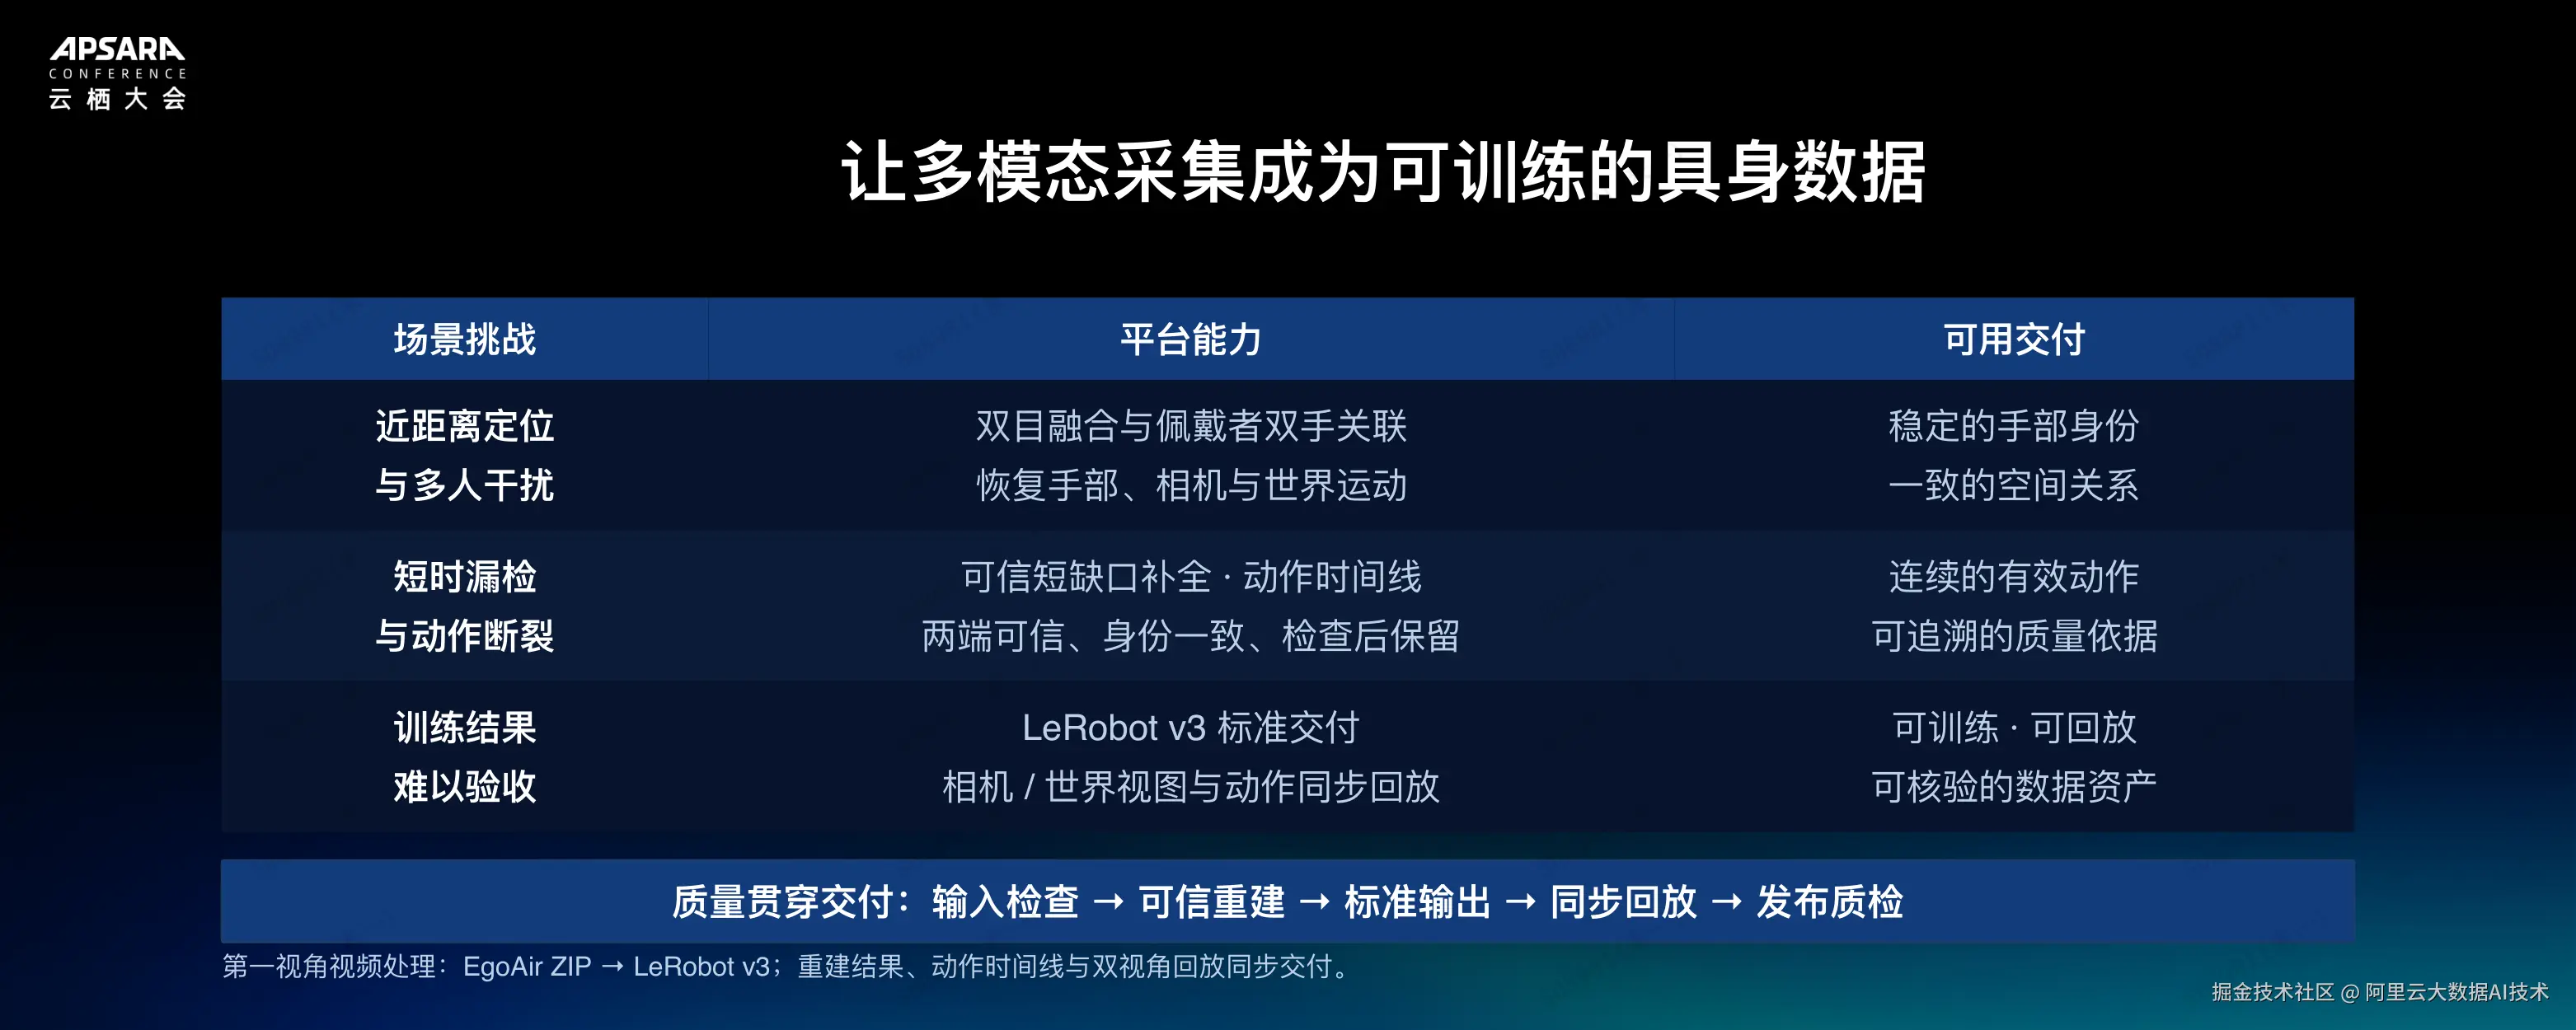
以头戴式设备采集的第一视角视频为例,看见动作并不等于准确还原动作。近距离定位误差会影响手与物体的接触关系,多人干扰可能导致操作手身份切换,遮挡和运动模糊则可能造成轨迹断裂。
平台通过双目融合、佩戴者双手关联与时序关系,恢复手部、相机与世界运动。对于轨迹缺口,仅在两端可信、身份一致且通过检查时进行短缺口补全;长缺口或身份切换不强行补全,避免将缺乏依据的推断带入训练集。
交付环节支持将 EgoAir ZIP 数据处理为 LeRobot v3 标准数据,同步提供重建结果、动作时间线和相机 / 世界双视角回放。输入检查、可信重建、标准输出、同步回放与发布质检贯穿全流程,让数据既可训练,也可回放、可核验。
精度与效率协同提升
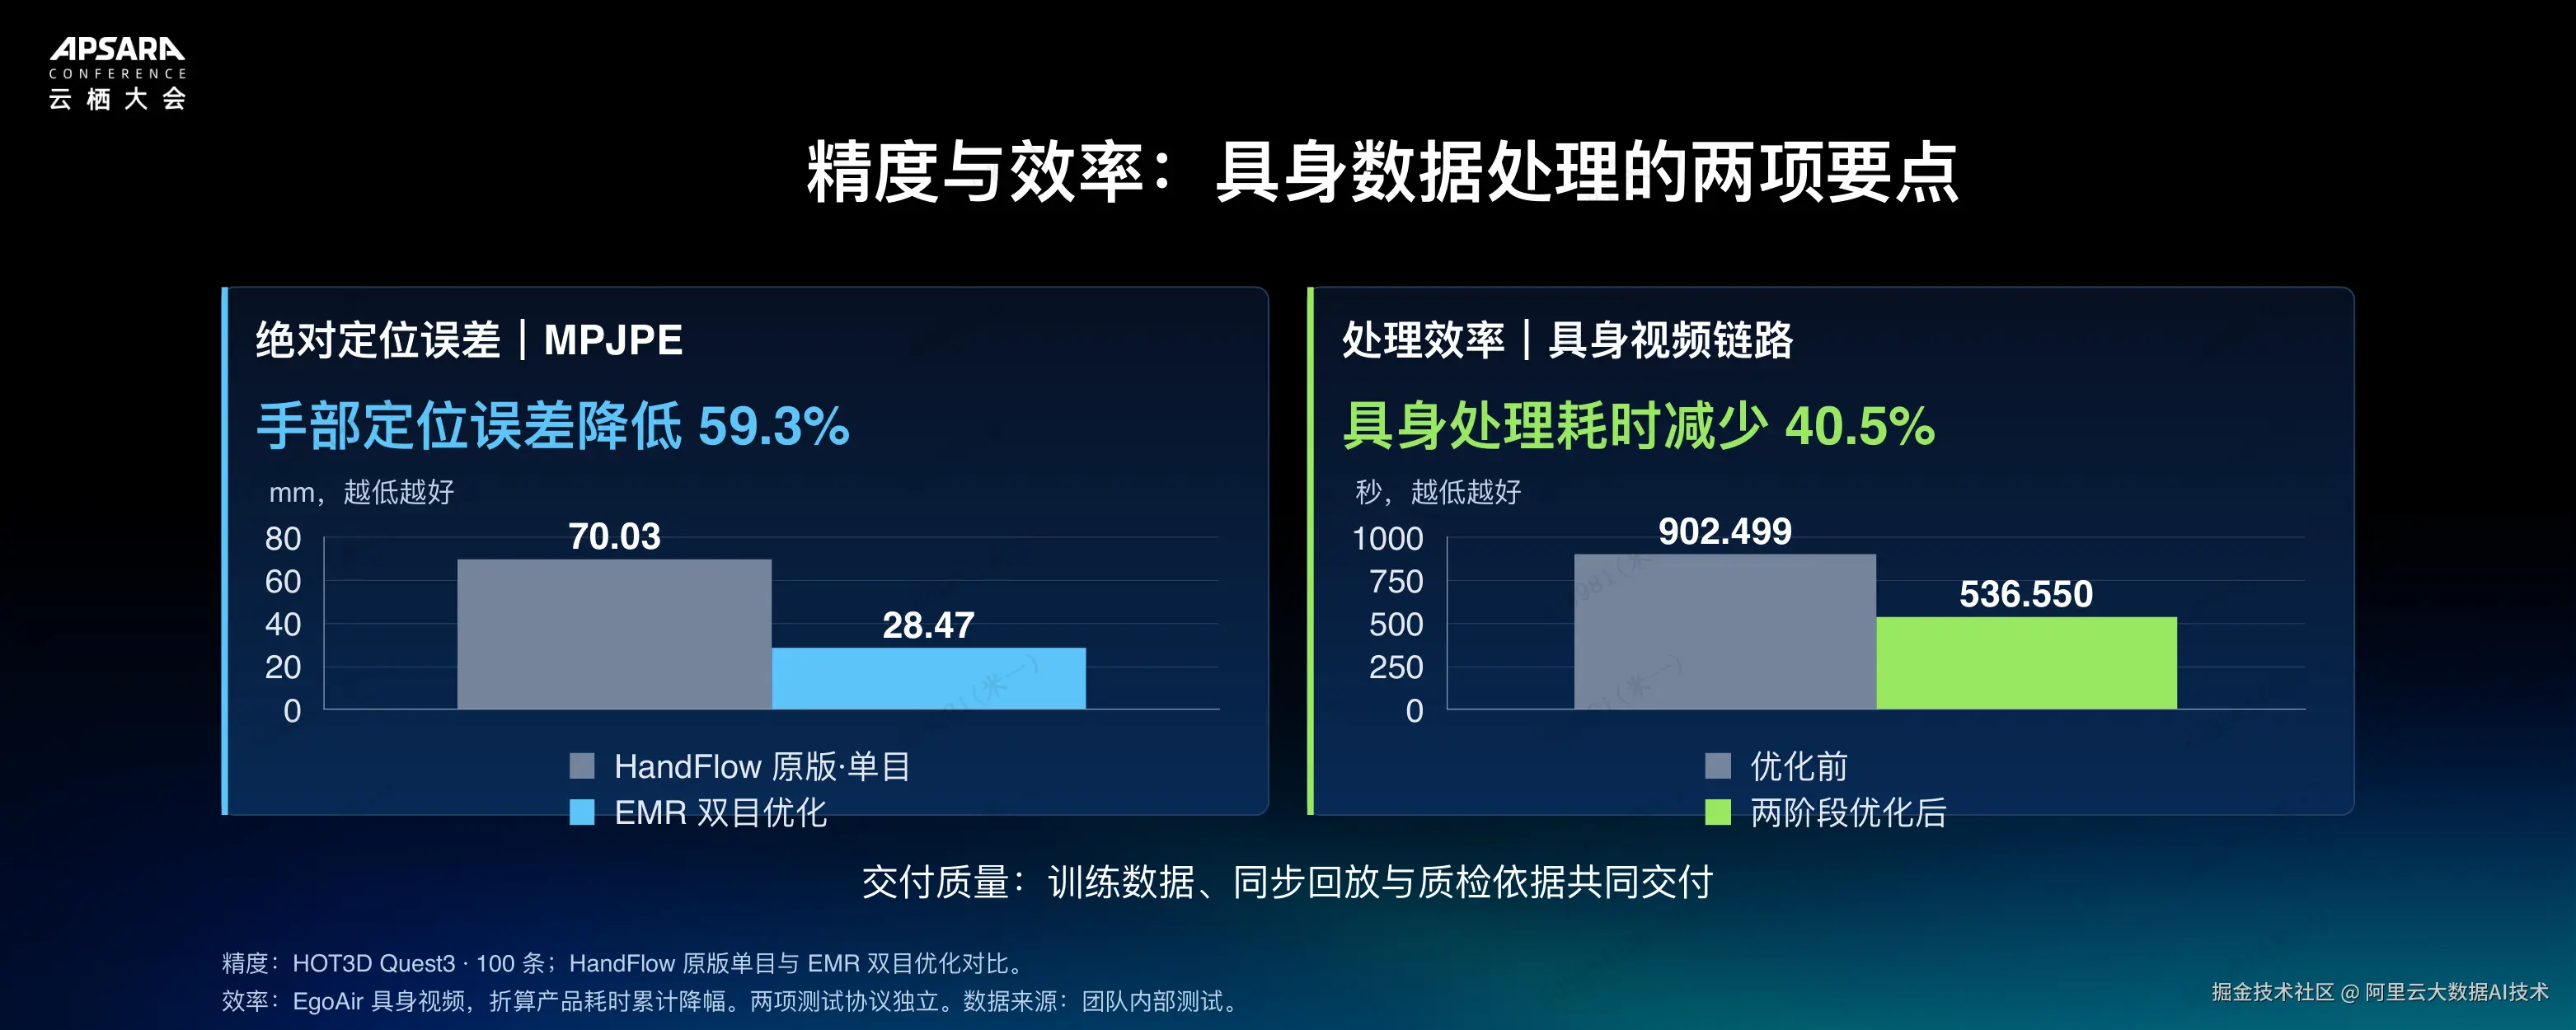
根据团队内部测试,在 HOT3D Quest3 的 100 条数据上,EMR 双目优化相较 HandFlow 原版单目方案,将手部定位误差指标 MPJPE 从 70.03 mm 降至 28.47 mm,误差降低 59.3%。在独立的 EgoAir 具身视频测试中,两阶段优化后,折算产品处理耗时从 902.499 秒降至 536.550 秒,累计减少 40.5%。
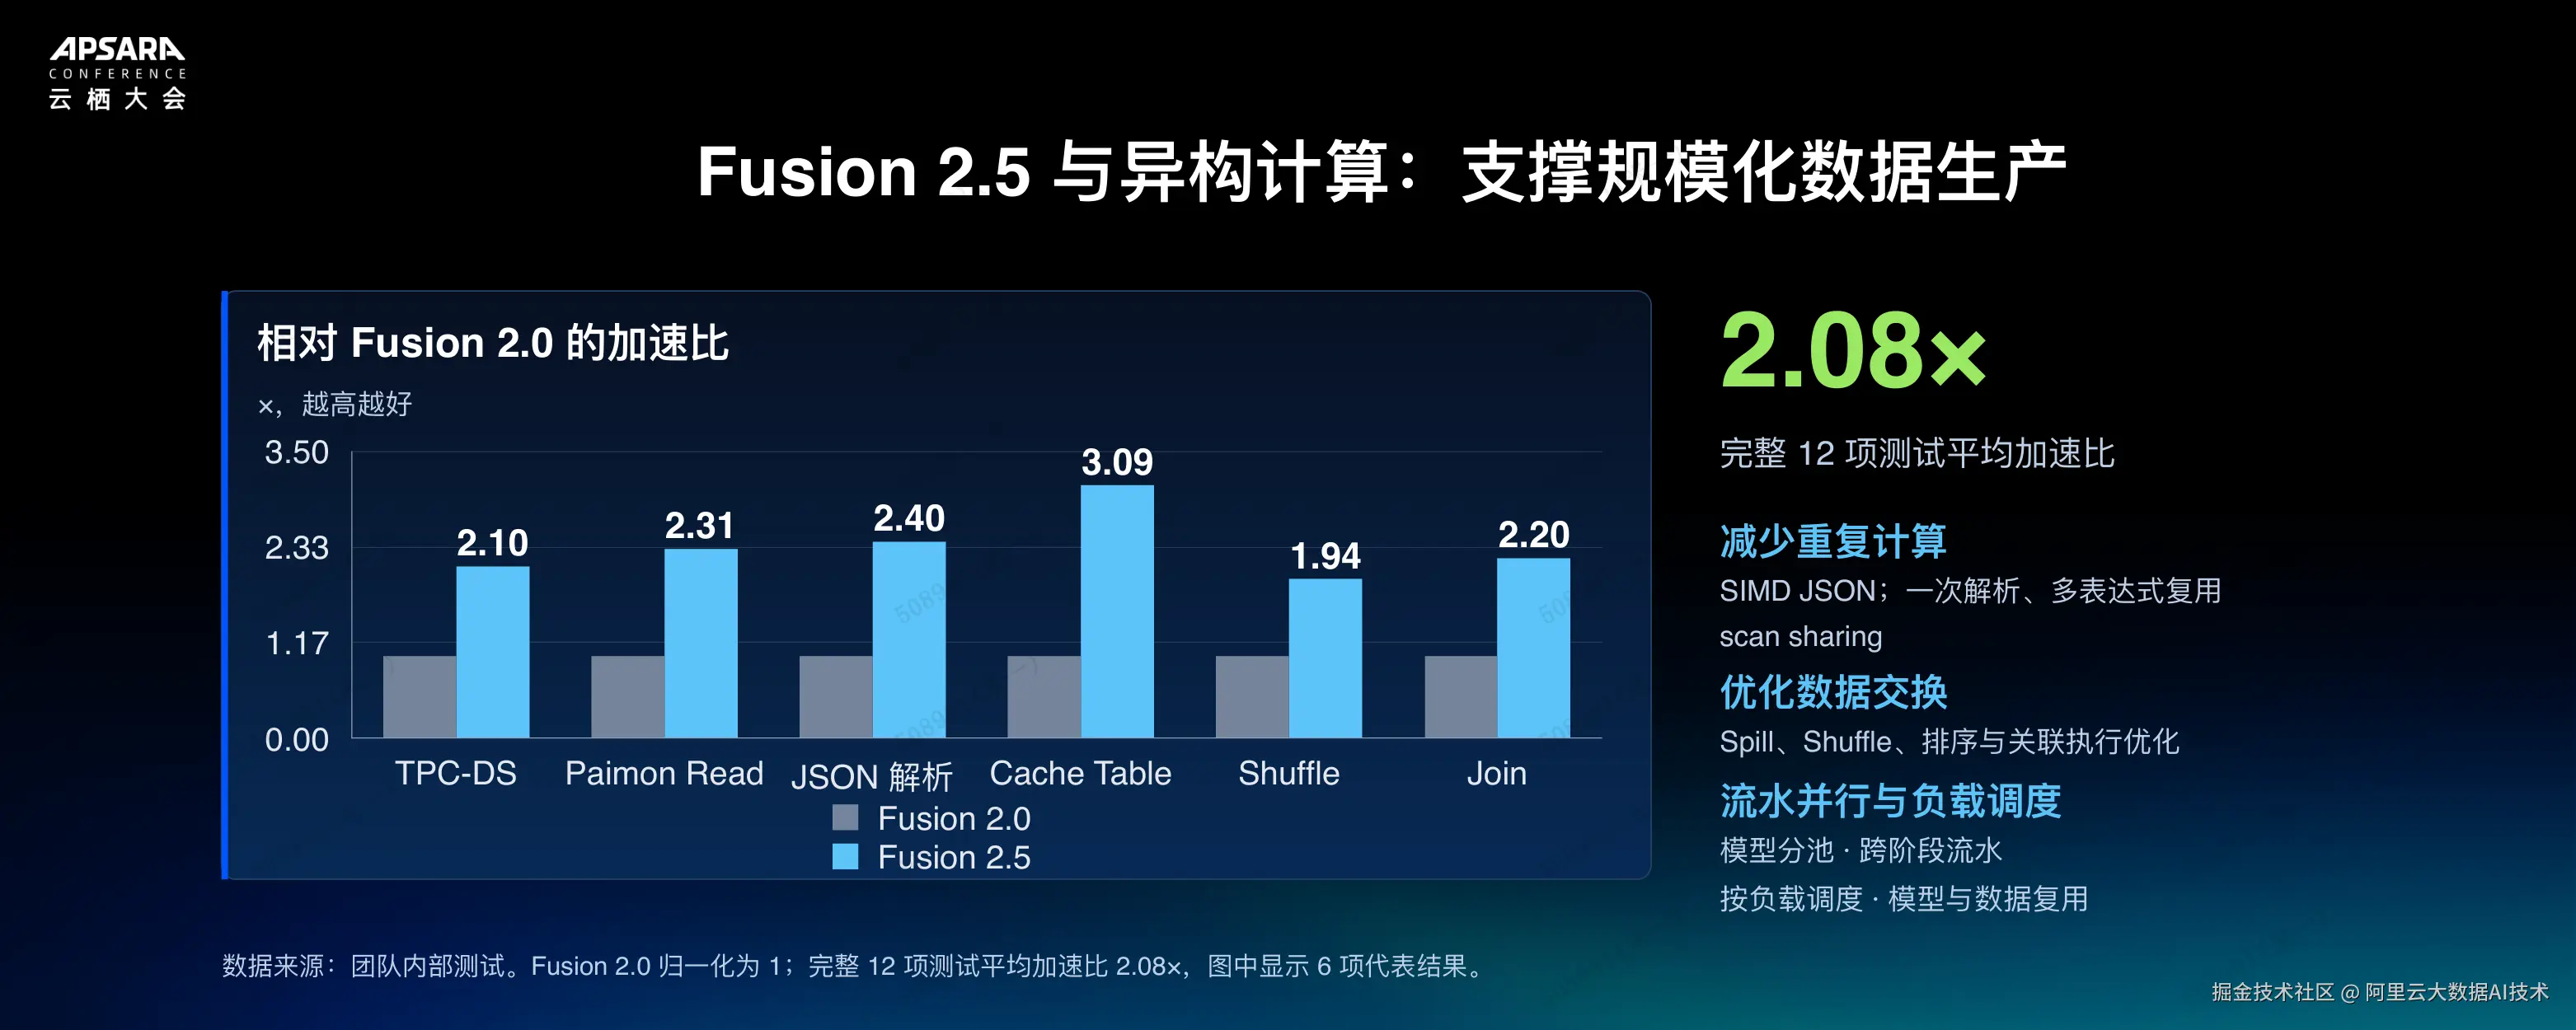
规模化生产还需要通用引擎与异构计算支撑。Fusion 2.5 通过 SIMD JSON、多表达式复用和 scan sharing 减少重复计算,优化 Spill、Shuffle、排序与关联执行,并结合模型分池、跨阶段流水和按负载调度提升资源效率。团队完整 12 项内部测试的平均加速比为 2.08×,其中 Cache Table 代表场景达到 3.09×,比较基线为去年云栖大会发布的 Fusion 2.0 版本。
Serverless StarRocks:在同一份湖仓资产上统一分析与检索
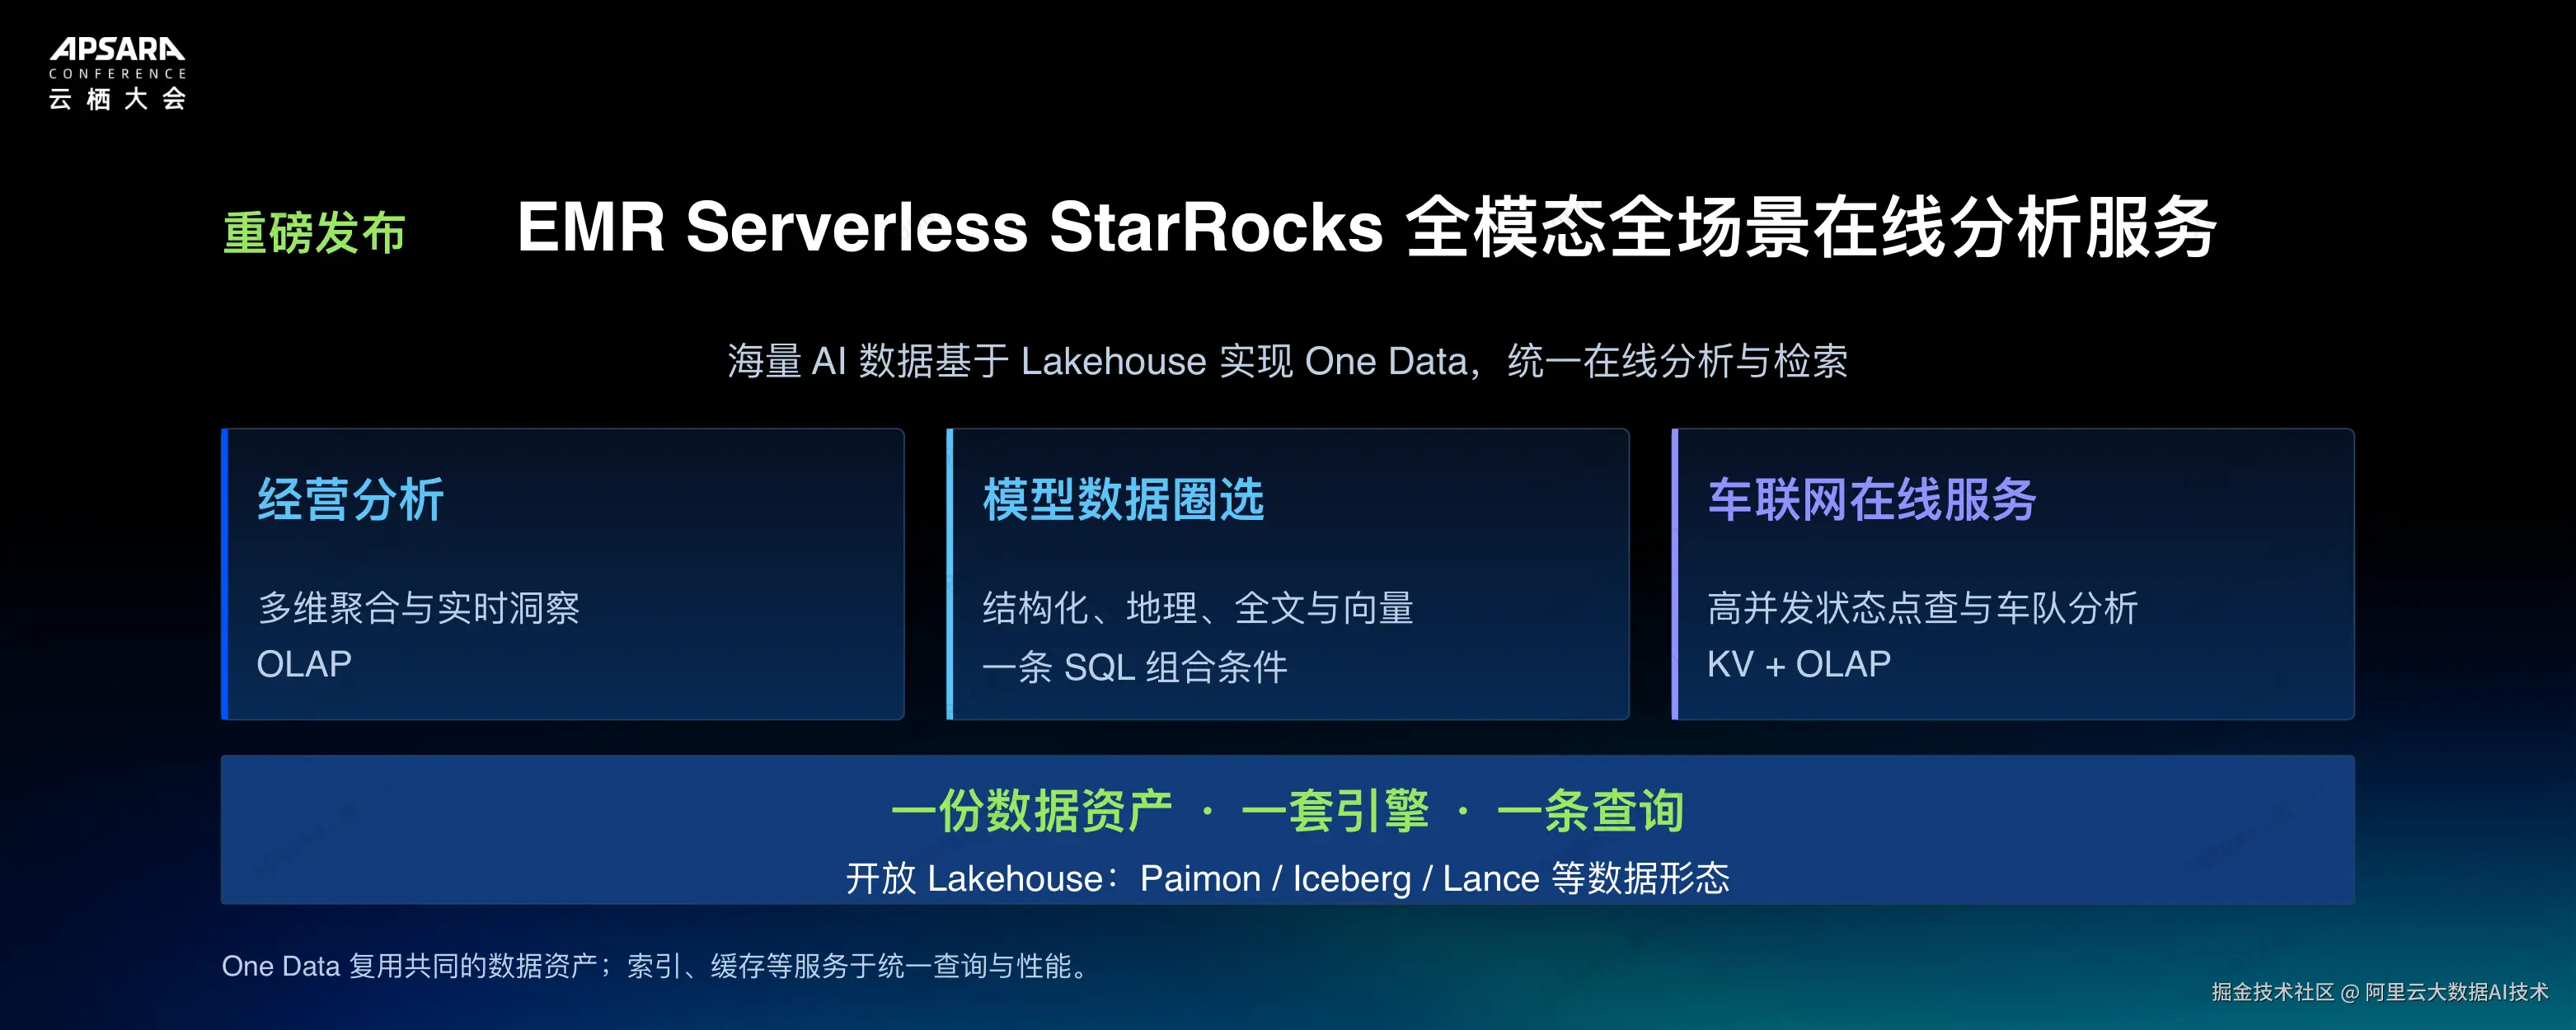
经营分析需要多维聚合,在线服务需要高频点查,模型数据圈选则需要结构化、地理、全文与向量条件组合。若每类需求分别依赖数据副本和查询引擎,应用层就需要承担跨系统关联、结果拼接与一致性校验,训练目标变化时容易引入重复加工。
本次大会重磅发布 EMR Serverless StarRocks 全模态全场景在线分析服务,面向 Paimon / Iceberg / Lance 等开放 Lakehouse 数据形态,基于 One Data 复用共同数据资产,由一套引擎组合完成在线分析与检索,索引和缓存服务于统一查询与性能。
一条 SQL 承接复杂圈选意图
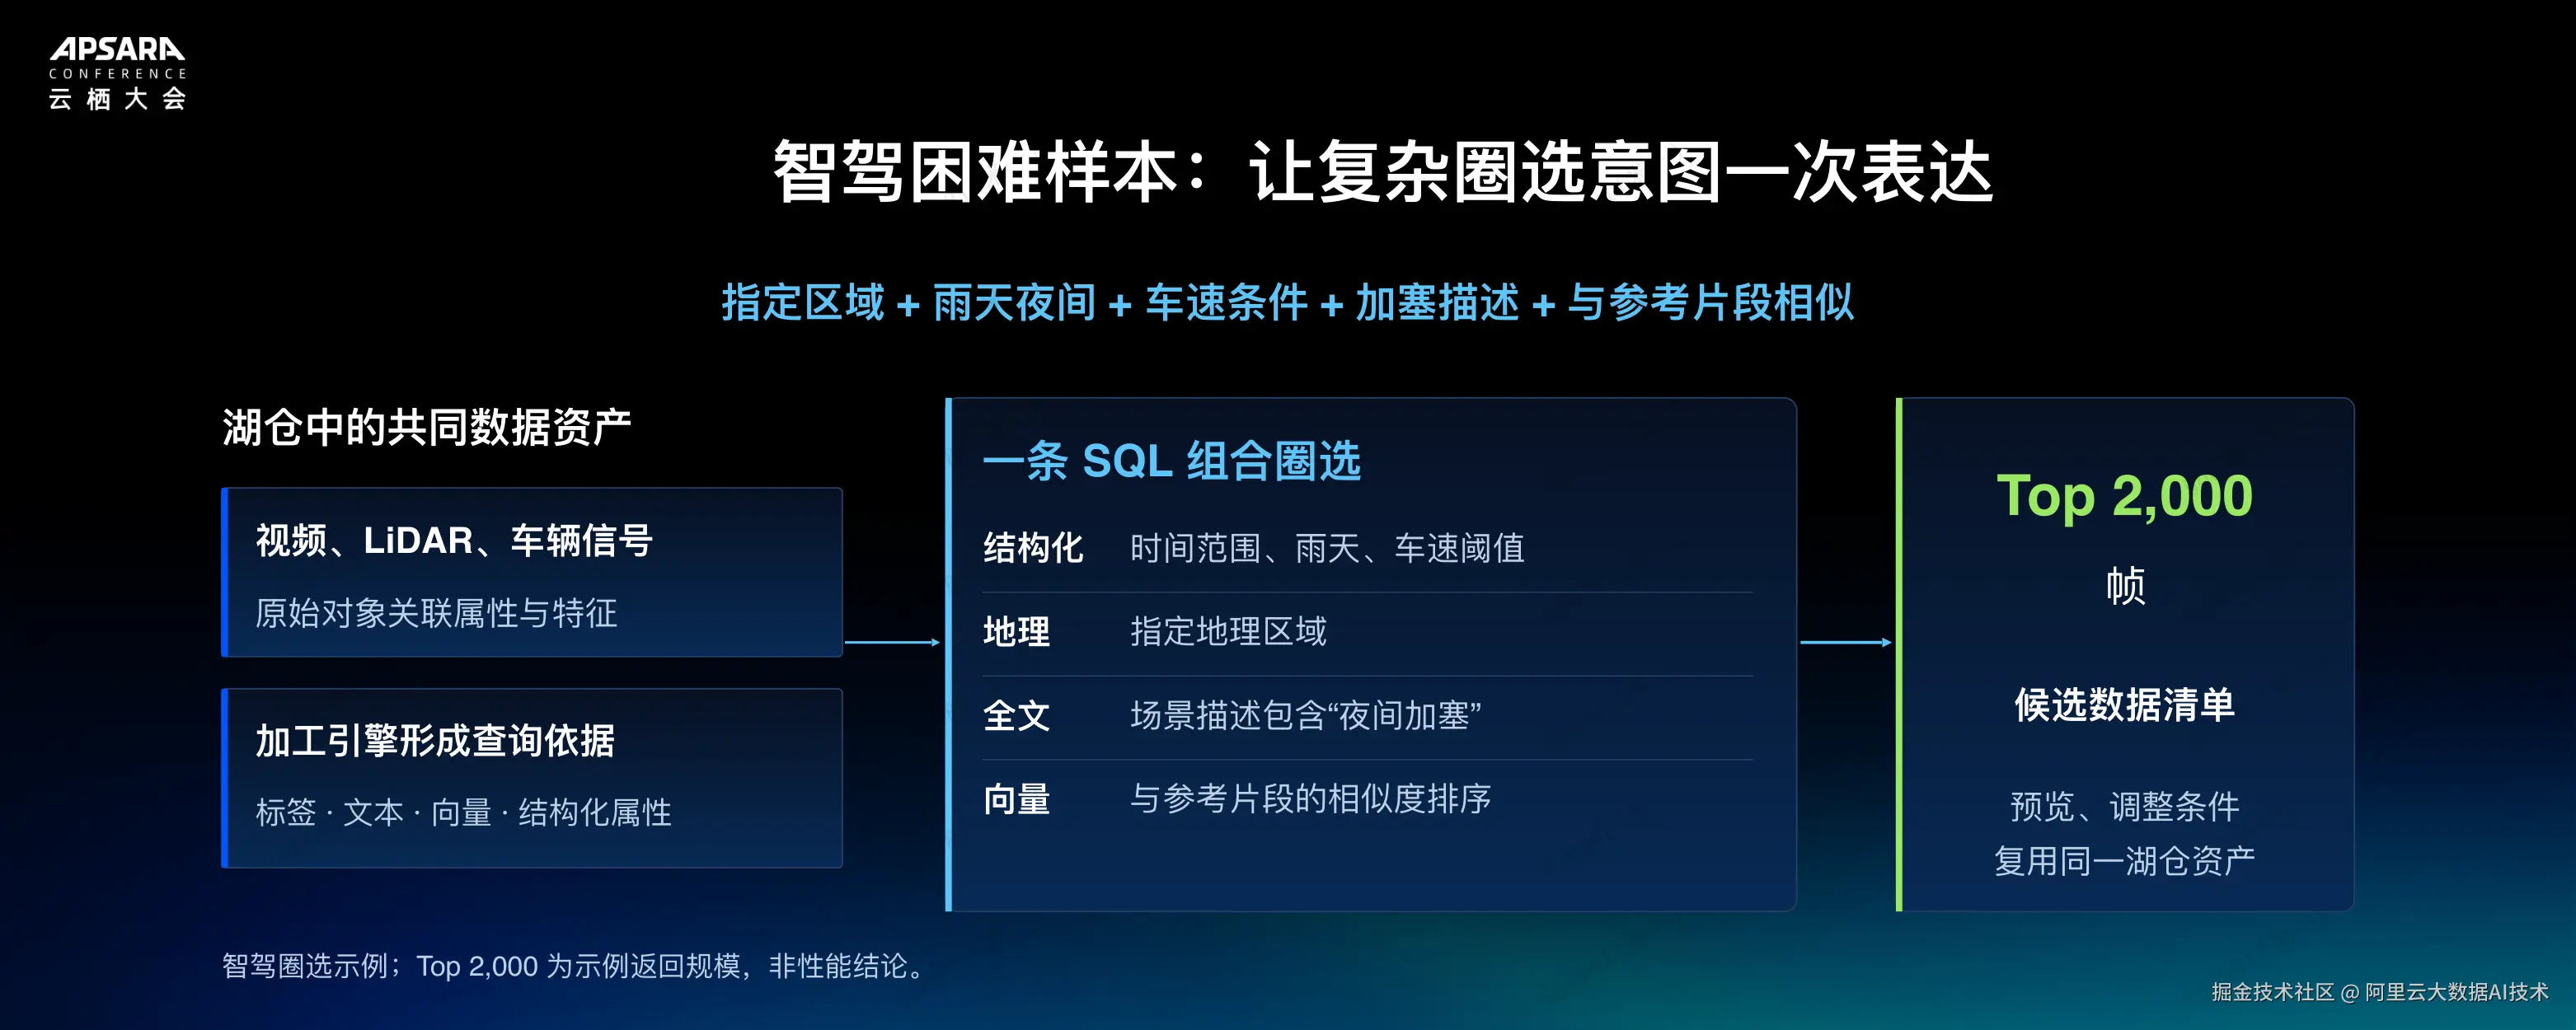
智能驾驶团队可能需要寻找指定区域内、雨天夜间、满足车速条件、出现车辆加塞,且与参考片段相似的样本。这一需求同时涉及结构化过滤、地理条件、全文匹配和向量排序。
加工引擎从视频、LiDAR 和车辆信号中形成标签、文本、向量与属性后,StarRocks 用一条 SQL 组合条件,完成过滤、召回和排序。团队可以先预览候选样本,再调整条件,持续收敛到目标数据。需求变化由查询承接,减少应用层反复拆分查询、跨引擎拼接结果的复杂性。
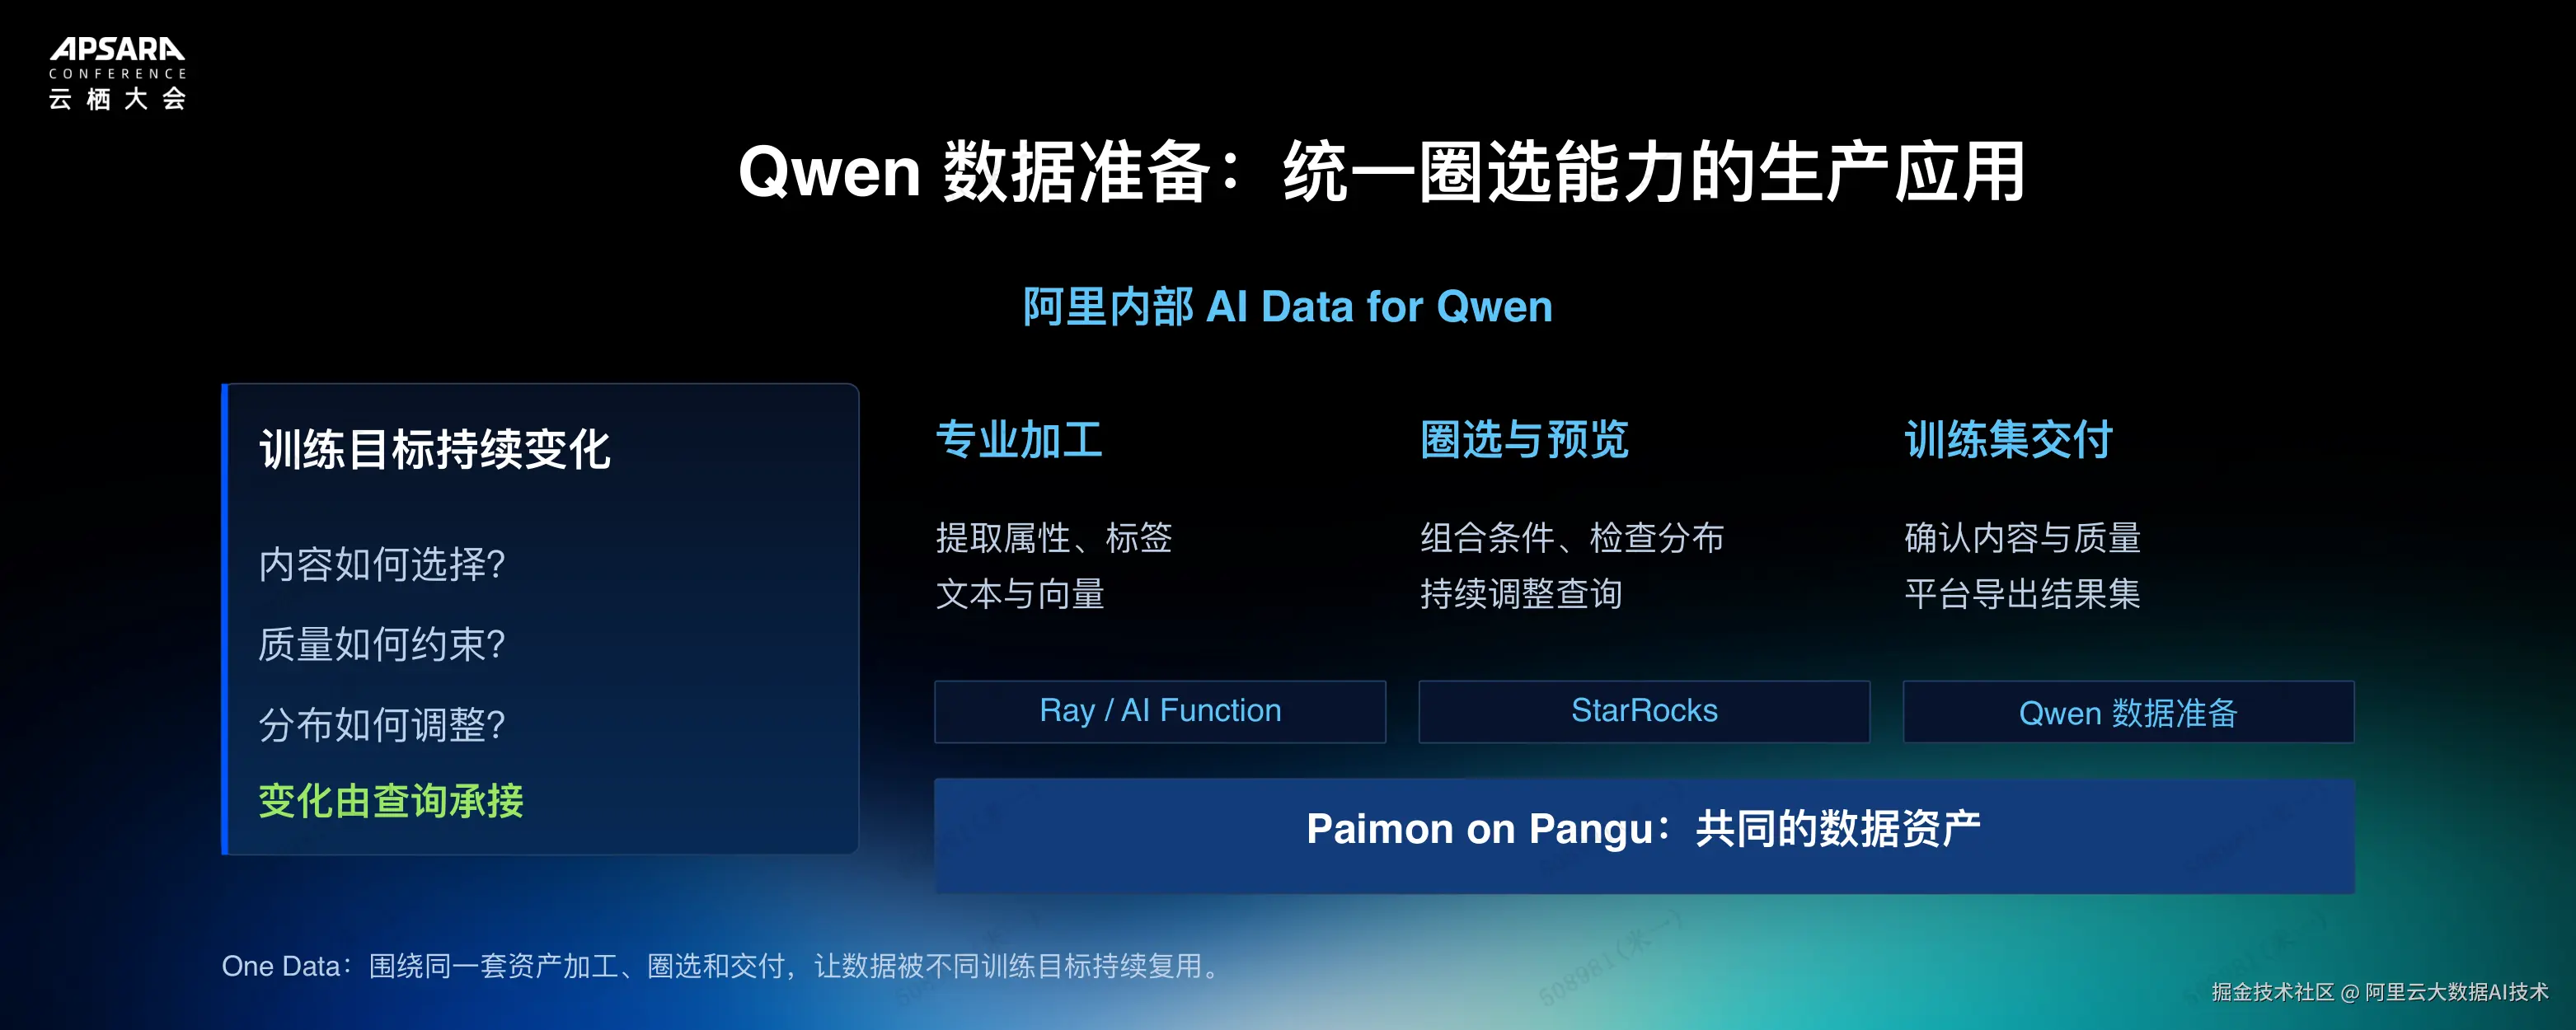
统一圈选也已用于阿里内部 AI Data for Qwen 的数据准备。Paimon on Pangu 承载共同资产,Ray / AI Function 等能力提取属性、标签、文本与向量,StarRocks 承接圈选、预览和分布检查,确认内容与质量后由平台导出训练集。加工、圈选和交付围绕同一套资产展开,使数据随训练目标变化持续复用。
四类湖仓负载的性能优化
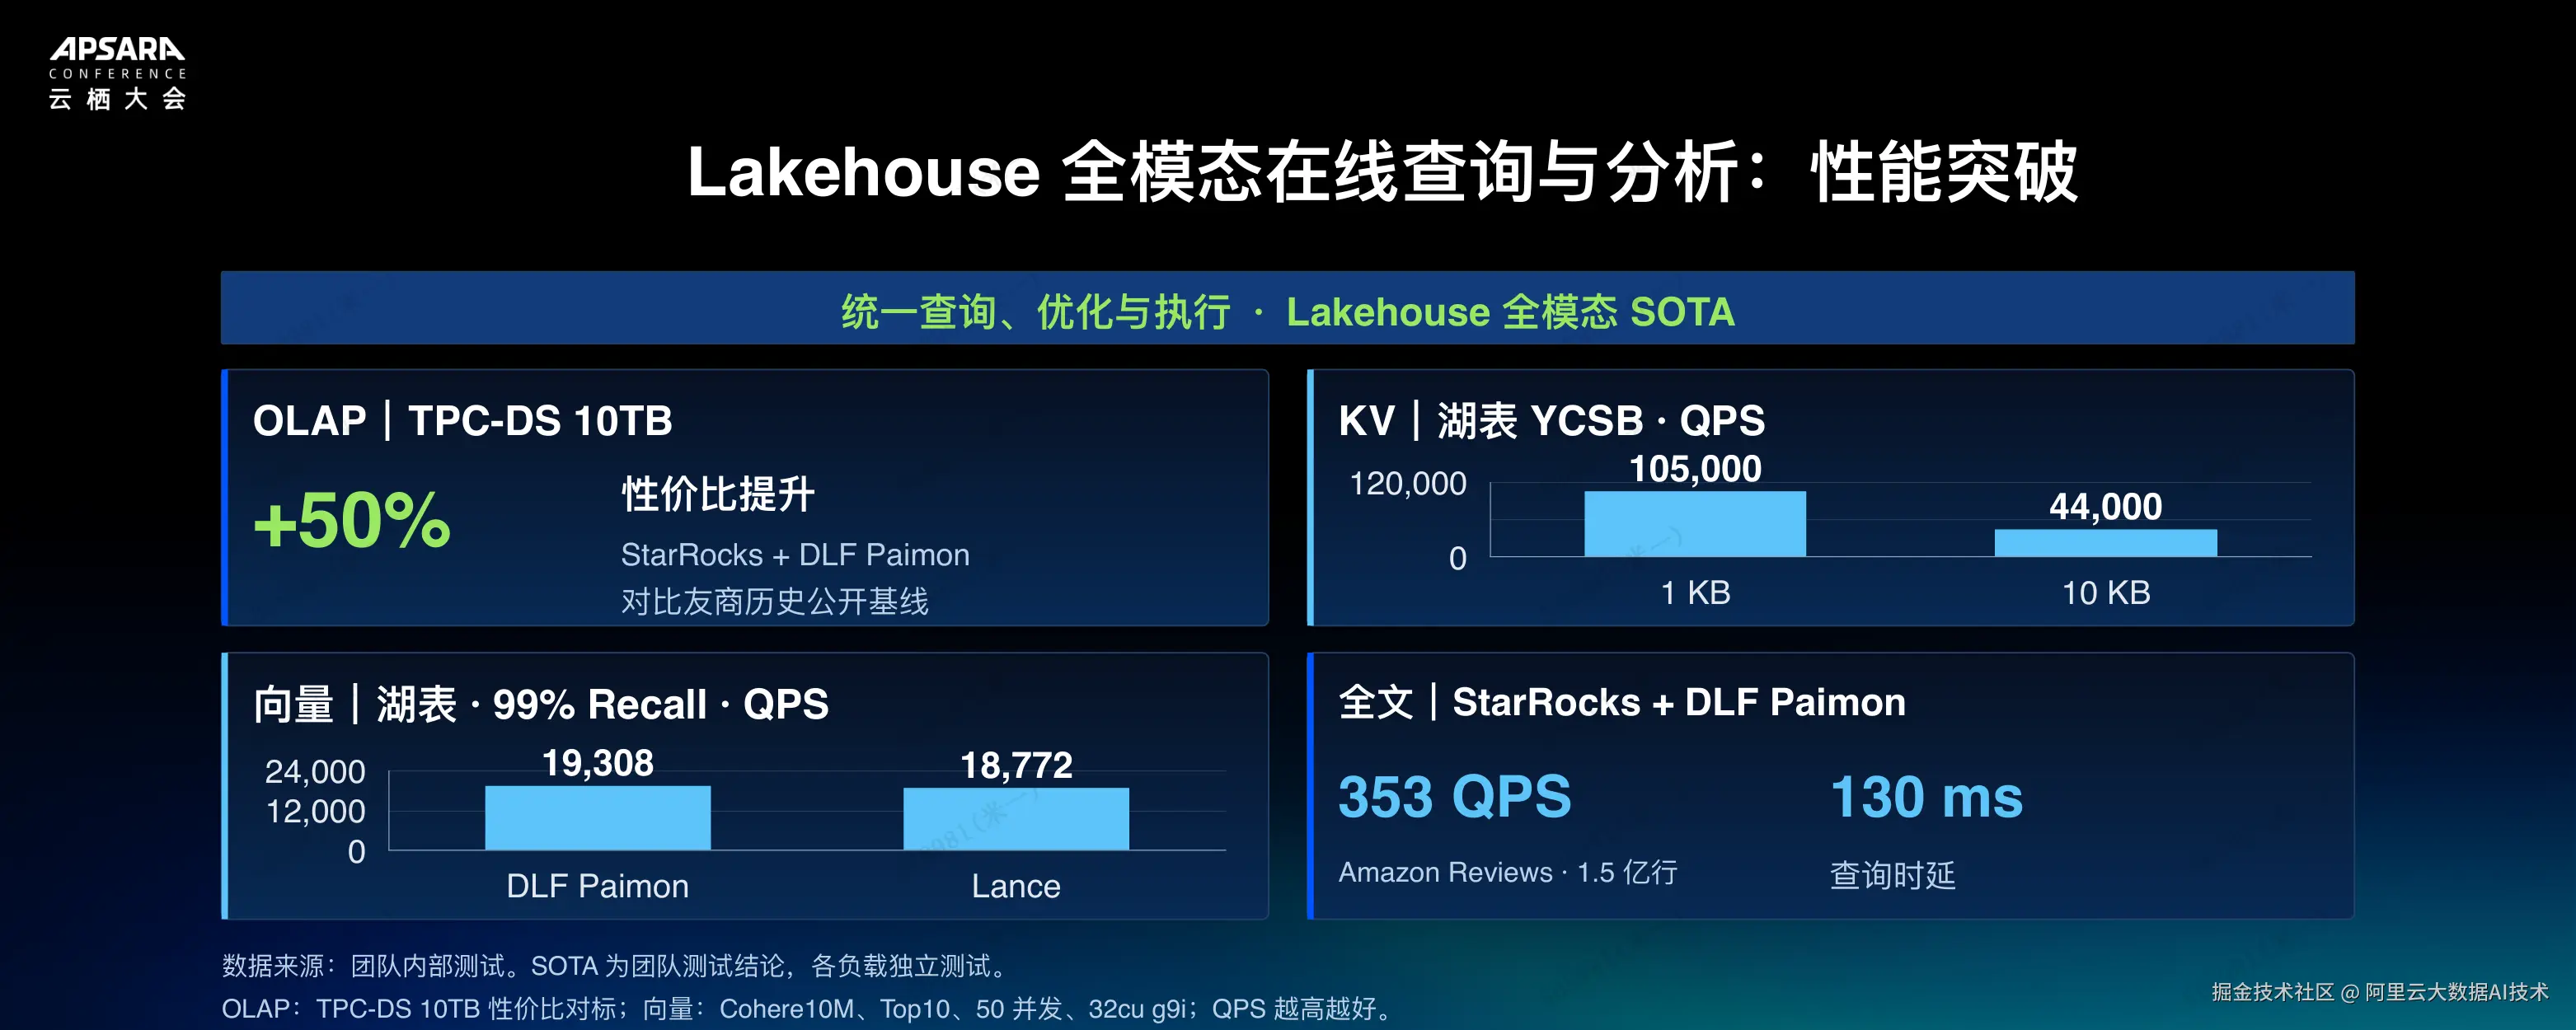
EMR 围绕元数据解析、数据合并、索引访问和统一查询执行进行优化。大会披露的内部测试中,TPC-DS 10 TB 场景下,StarRocks + DLF Paimon 相较此前公开基线,性价比提升 50%;YCSB 点查场景下,1 KB 和 10 KB 数据大小下的性能分别达到 105,000 和 44,000 QPS。
向量测试在 VectorDBBench Cohere 10M、Top 10、50 并发、保持 99% 召回率的场景下,面向 DLF Paimon 和 Lance 湖表数据的查询性能分别达到 19,308 和 18,772 QPS。全文测试在 Amazon Reviews 1.5 亿行数据上达到 353 QPS,查询时延为 130 ms。各负载独立测试,不代表同时运行时的混合吞吐。
Managed Agent:让长期生产工作积累可信经验
具身数据生产与全模态分析主要解决 Model-ready,长期生产 Agent 则提出 Agent-ready 的要求。生产现场的数据分布、负载和软件版本持续变化,过去有效的方法需要重验。完成一次任务,不等于能够长期胜任复杂工作。
大会正式发布 EMR Agent 与 Managed Agent 平台,将长期生产 Agent 的共性能力提供给开发者。平台管控覆盖开发部署、资源管理、运行运维,以及权限、必要审批、沙箱、可观测和审计;引擎内核负责组合数据与工具、随新证据推进任务,并保留可信过程信息。
以作业诊断为例,Agent 需要关联日志、指标和配置形成方案,再结合真实结果检验方法及适用范围。失败任务尤其需要保留上下文、查询数据、方案、决策和人工更正,经验证与治理后形成领域知识,支持后续工作。持续进化的基础不是简单保存对话,而是积累有依据、可复用的专业经验。
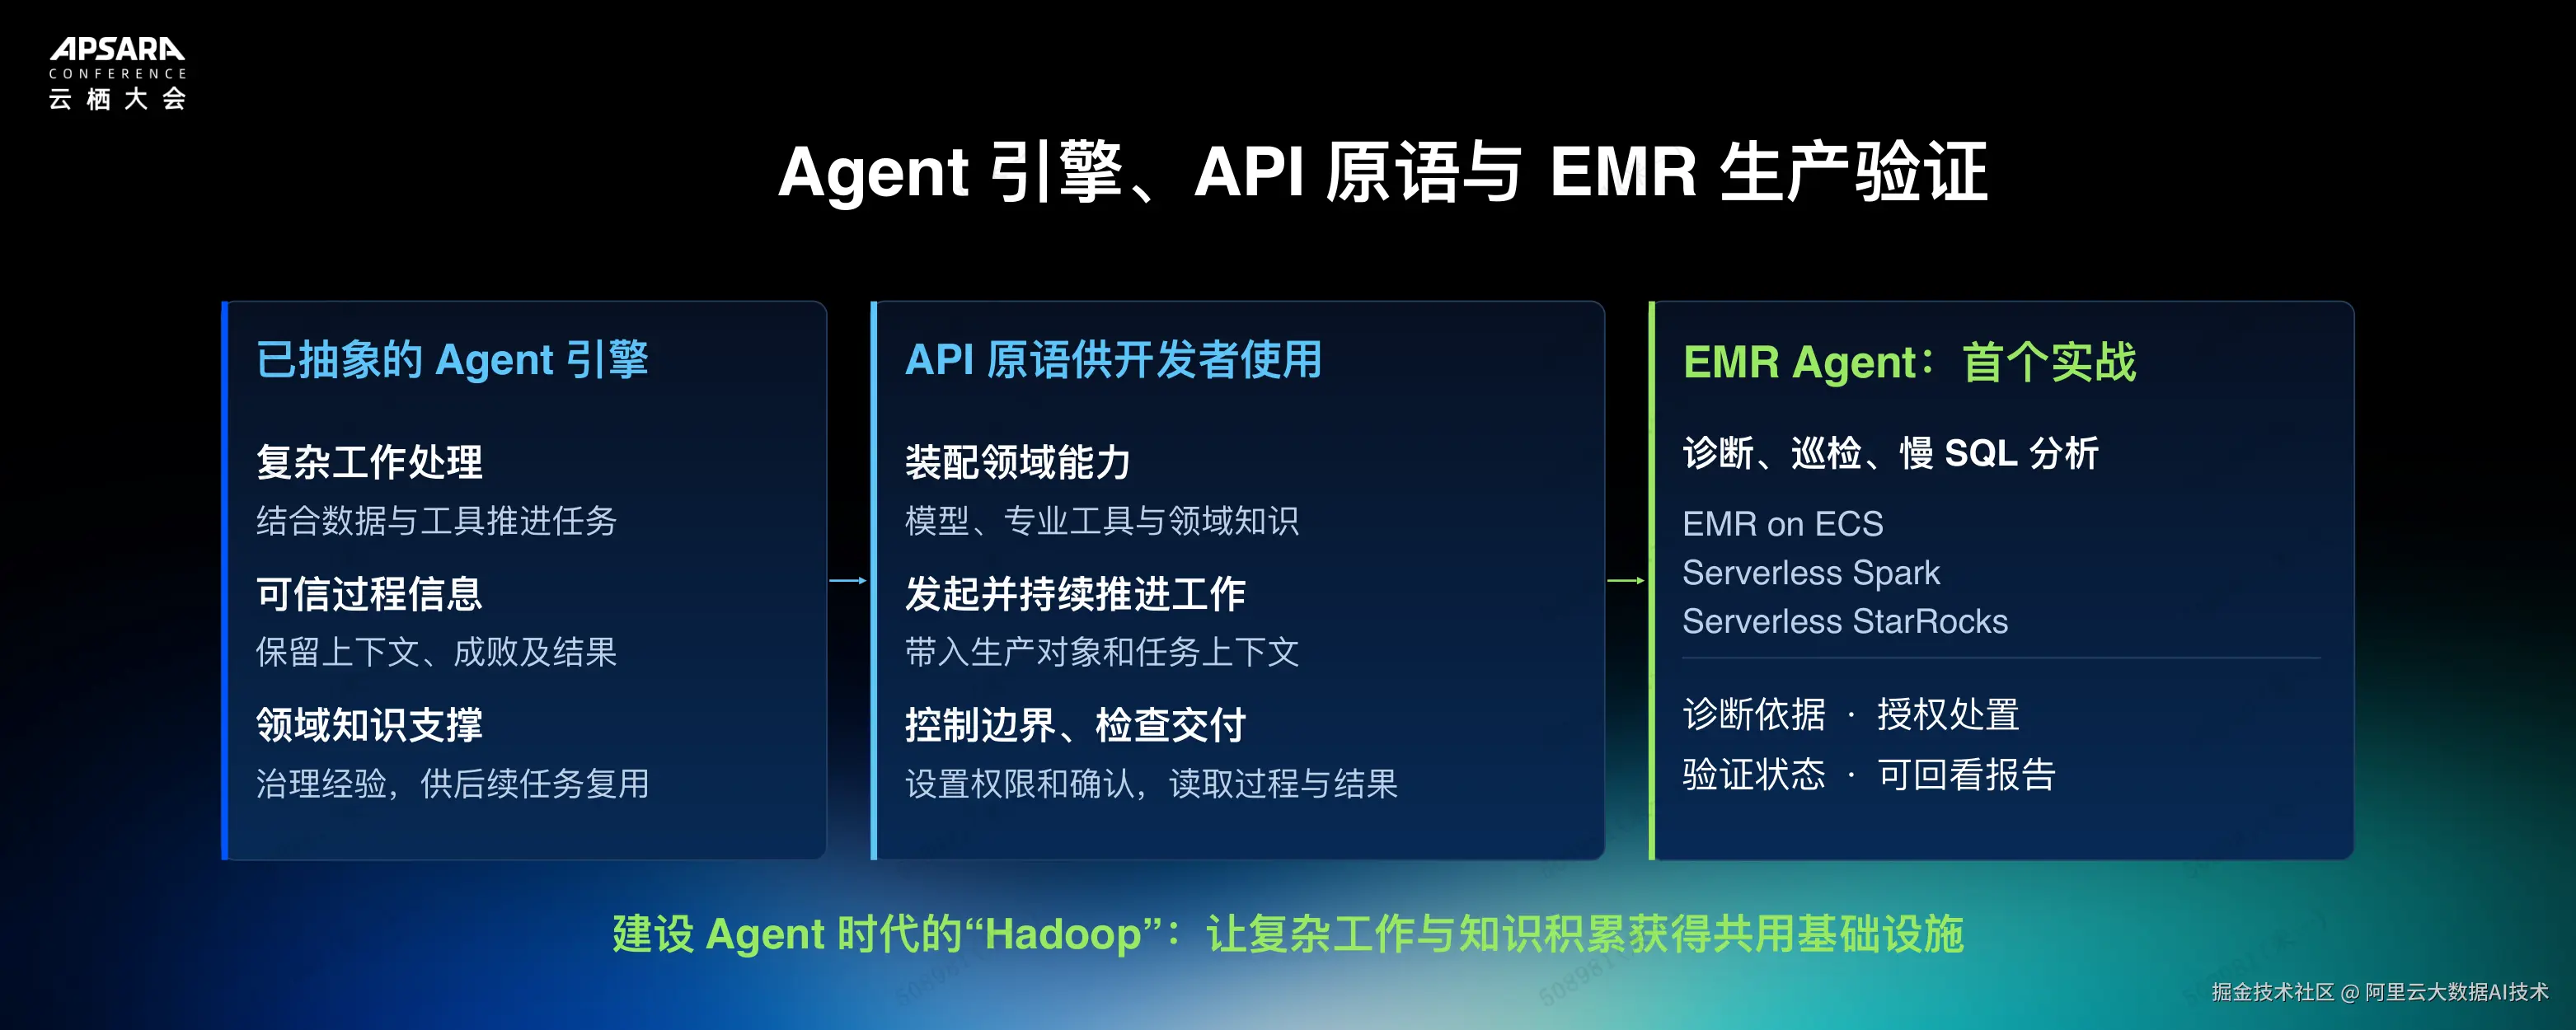
平台通过 API 原语开放 Agent 引擎,开发者可以装配模型、专业工具与领域知识,带入任务上下文,设置执行边界并检查交付。首个实战应用 EMR Agent 覆盖 EMR on ECS、Serverless Spark 和 Serverless StarRocks,提供诊断、巡检、慢 SQL 分析,以及授权处置、验证状态和可回看报告。
李钰将这一目标类比为建设 Agent 时代的"Hadoop":把复杂工作推进、可信信息管理与知识积累封装为共用基础设施,让业务团队聚焦领域建模与 Agent 本体,而不必重复实现底层机制。
从数据供给走向生产能力
今年的 EMR 产品能力升级以开放湖仓为共同基础:Serverless Spark 将真实采集转化为可靠训练资产,Serverless StarRocks 让同一份资产服务分析与检索,Managed Agent 则让可信经验支持持续工作。EMR 通过弹性计算、统一查询和治理复用连接 Model-ready 与 Agent-ready,协同阿里云 Agentic Cloud,支撑模型与智能体进入真实生产环境。