我最初的求职工具链很简单:让 AI 读取招聘页面,遇到登录时自己接手,再把结果汇总成 HTML。随着来源和记录增加,需要解决的问题变成了:换一个网站会不会重写整个流程?一次抓取失败会不会覆盖旧记录?面试复盘能不能用于下一次简历修改?
我把这套流程整理成了 MIT 开源项目 Scientific Interview。目前公开版本为 v0.14.0,包含 Agent Skill、本地 Python 工具、网站和浏览器插槽,以及支持中英文的 HTML 工作台。本文介绍当前实现的取舍和上手方法。
中文 README:github.com/ft1148137/s...
1. 先确定各层负责什么
整个执行关系可以概括为:
text
用户与 AI 对话
    ↓
Skill:组织搜岗、经历访谈、简历和面经复盘流程
    ↓
SiteSlot:理解招聘网站的列表、详情和分页
    ↓
BrowserPort:通过指定宿主观察和操作页面
    ↓
标准扫描结果 → 校验与入档 → 本地 HTML 工作台
Skill 负责告诉 AI 在什么阶段做什么、缺少哪些信息需要问用户、什么时候交还登录。它并不直接承担所有业务逻辑。
Python 核心负责校验、版本保存、简历导出和统计所需记录。网站与浏览器插槽不直接修改主档案;AI 整理出的资料也通过 CLI 校验后保存。这样,换一个页面适配器不需要同时改动简历或投递统计。
目录边界也保持对应关系:skills/ 放流程,slots/ 放适配器,contracts/ 定义协议,job_workbench/ 管理业务和存储,templates/ 展示工作台,examples/ 提供合成演示。
2. 网站和浏览器是两种独立插槽
网站插槽回答"这个页面里的岗位是什么",浏览器插槽回答"通过当前宿主怎样看到和操作这个页面"。
SiteSlot 主要暴露三个入口:
probe(observation):检查页面可读性、登录、验证码和限流状态。discover(query, cursor):发现岗位引用,返回下一游标和覆盖范围。readJob(ref):读取具体岗位,形成包含来源、核验时间、JD 和证据的标准记录。
BrowserPort 则提供 connect、navigate、observe、act、wait 等能力。目前分别接入 Codex Chrome 插件和 Tabbit 官方 CLI。网站声明所需能力,浏览器声明实际能力,运行前检查二者是否匹配。
新网站要增加自己的 manifest 和适配器,并通过协议测试;新浏览器要实现 BrowserPort。两者分别扩展,但仍需要验证真实网站与浏览器的组合,注册成功不代表真实页面已经验证通过。
当前采集读取可见 DOM。动作绑定当前观察的 snapshot_id,页面变化后旧观察失效,避免拿上一页的元素位置操作下一页。该采集端口拒绝密码和文件字段,也拒绝提交申请控件,搜索采集与实际申请分别处理。
完整协议:github.com/ft1148137/s...
3. 把失败类型写进协议
浏览器自动化会遇到登录、验证码、加载延迟、频率限制和页面改版。我没有把这些情况都压成"没有找到岗位",而是使用四类结果:
| 结果 | 处理方式 |
|---|---|
| PASS | 继续当前步骤 |
| WAIT_USER | 保存断点,交还用户处理登录或验证 |
| RETRY | 按等待要求有限重试 |
| REJECT | 记录原因,停止受影响步骤或隔离异常记录 |
断点保存来源、版本、查询条件、游标和已经完成的岗位标识,不保存页面元素句柄。恢复后重新观察,再按稳定 ID 或 URL 去重。限流重试有等待时间与次数上限。
这里还有两个直接影响数据质量的约定:
- 缺少分页边界证据时,覆盖范围保持 partial,不把当前页面当作全部结果。
- 页面打不开或扫描失败,不等于岗位下线;标记停招需要明确的页面证据。
海外来源中,有些支持站内关键词搜索,有些只对当前已经加载的岗位标题做筛选。仓库分别列出范围,避免把有限样本描述成全站搜索。
4. AI 负责分析,记录要能核对
岗位匹配采用 1---5 分,同时保存匹配依据与差距。分数帮助排序,不代表获得面试或 Offer 的概率。
简历支持导入 PDF 后修改,也可以从经历访谈开始创建。经历不足时先提问,确认项目、职责、结果和事实范围,再保存简历版本。申请记录关联当次使用的简历,后续修改不会改写已经投递的版本关系。
面经复盘也沿用这个思路:用户复述问题、自己的回答和面试官反馈,AI 帮忙整理强项、不足与后续准备事项。记录区分用户回忆、据用户复述的面试官反馈和 AI 推断;核对后的复盘可供修改简历与岗位评分参考,不能替代真实经历。
5. 用本地档案支撑持续使用
私人资料、简历原件、投递记录、环境和生成文件统一放在 data/ 中,Git 默认忽略。源码中的示例和宣传截图只使用合成数据。
存储层使用单写入锁,支持 revision 检查;写入时先保存旧版备份,再通过临时文件和原子替换更新主档案。重复运行流程时,业务入口负责去重和保留历史,而不是让 AI 直接覆写整个 JSON 文件。
HTML 工作台提供:
- 投递总览与最新申请状态分布;
- 投递和反馈的每周折线图;
- 公司、岗位方向和行业分布;
- 未投递岗位的"投递候选""不感兴趣"及筛选;
- 简历版本与面经复盘查看。
连续 30 天没有实质变化的岗位可自动标记不活跃,也支持人工标记。不活跃不等于拒绝;原申请状态保留,未结束申请会从"进行中"移出,在状态分布中单列。
v0.14.0 的界面默认英文,可切换中文并记住浏览器中的选择;岗位原文和个人资料保持原语言。统计图表与 CSV 列名跟随界面语言。
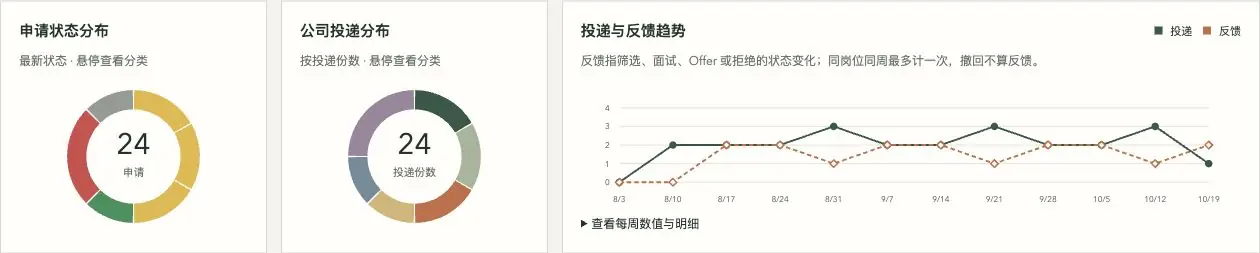
上图是合成统计数据;首次运行演示只有少量岗位,用于体验完整流程,并不包含图中全部记录。
6. 从可运行演示开始
需要 Python 3.10+,从完整源码目录安装。以下命令适用于 macOS / Linux;macOS 已验证,Windows 对应步骤见 README,尚未完成全面验证。
bash
git clone https://github.com/ft1148137/scientific-interview.git
cd scientific-interview
python3 -m venv data/dev/venv
. data/dev/venv/bin/activate
python -m pip install -e ".[resume]"
python -m job_workbench doctor
python -m job_workbench --data data/demo demo
python -m job_workbench --data data/demo serve --port 8877
打开 http://127.0.0.1:8877/index.html。合成演示不需要连接招聘网站,包含两轮扫描、JD 变化、候选、申请记录、简历和面经。终端保持运行,按 Ctrl+C 停止服务。
之后运行 python scripts/install_skill.py 安装 Skill 链接,重新打开 Codex 对话,调用 $scientific-interview。也可以在 Codex 中打开源码项目,要求读取并使用 skills/scientific-interview/SKILL.md。完整项目与 Python 环境需要保留,只复制 SKILL.md 不能运行全部功能。
真实搜岗时再按 README 连接 Codex Chrome 插件或 Tabbit,用户完成登录及验证码。AI 分析依赖自己的宿主账户;本地存档并不意味着模型分析离线,也不会免除宿主的数据处理规则。当前没有内置定时搜岗服务,实际提交申请需要用户授权与结果核验。
这是我的开源项目,欢迎试用。尤其希望收到两类反馈:首次安装在哪一步卡住,以及某个网站在什么浏览器和搜索条件下出现了适配问题。提 Issue 时请去掉简历、联系方式、登录资料和真实投递记录;复现例子可以使用合成数据。