10 月北京日报那篇 AI 广告产业链的调查,做内容管线的应该读两遍:899 元用两年、承诺不标注、平台识别不出来。它说明一个现实------信源池里的素材质量在快速下降,评估管线面对的不只是「AI 有没有提你」,还有「提你的那段话本身可不可信」。
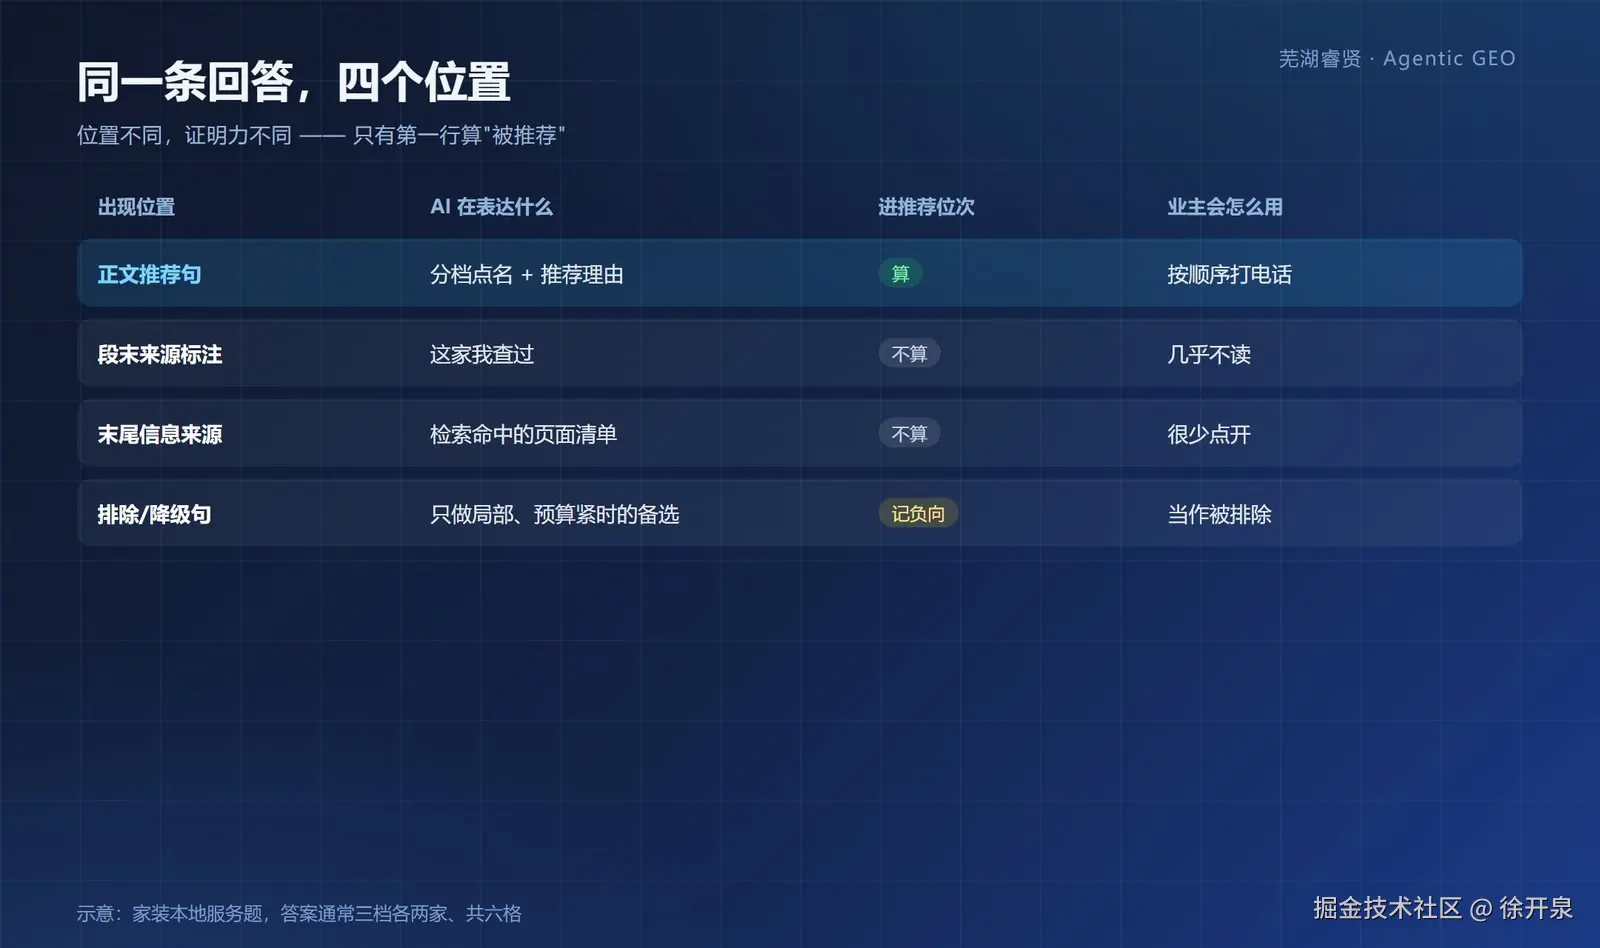 本文只讲判定侧:一条 AI 回答拿到手,怎么把「提及、引用、推荐」三种状态判出来,以及中文句子结构带来的三个具体麻烦。示例语料是家装行业的本地服务题。
一、为什么规则管线不能只做字符串匹配
先看一条真实回答的结构(已脱敏、压缩):
css
问:江宁区老房改造找哪家装修公司?
答:老房改造主要看三点:结构安全、水电重排、工期控制。
   第一优先·最推荐:A 装饰【信源:其官网;本地生活平台】、B 设计
   第二优先·备选:C 整装、D 装饰
   第三优先·参考:E 装饰、F 工程
   注意:部分公司只做局部翻新,例如 G 装饰;另有公司存在增项争议。
   信息来源:
   1. ...
这里面「G 装饰」在正文、在档位之外、语义为排除。字符串匹配会把它算成一次命中;按档位匹配会漏掉它(因为它不在任何档里)。两种做法都不对------正确做法是记一次「负向提及」,位次为 0。
同一段回答,三种判法给出三种结论:
| 判法 | G 装饰的提及 | 引用 | 位次 | 实际后果 |
|---|---|---|---|---|
| 全文字符串匹配 | 1(命中) | 1 | 无 | 排除语义被算成推荐,客户以为进了名单 |
| 只按三档切块匹配 | 0(漏判) | 0 | 无 | 样本被判 valid=0 剔除,分母凭空缩水 |
| 档位 + 极性管线 | 1(负向) | 0 | 0 | 需维护否定词表,规则有持续维护成本 |
三种都不是"标准答案",区别在于出错的方向:前两种错在把不可比的东西放进同一个分母,第三种错在规则边界要人工校准。选第三种,是因为它的错可以被复现、被复核。
这就是规则管线的价值:不是判得快,是判得能解释。
二、五步管线
Step 1 归一化。 全角转半角、中文标点统一、去零宽字符、合并连续空行。别小看这一步,中文回答里「(来源:...)」和「(来源:...)」混用太常见,正则少写一个分支就漏。
Step 2 剥标注。 去掉信源标注串,避免它们抬高提及计数。
Step 3 切段与定档。 用档位词定位,切成「档 1 / 档 2 / 档 3 / 档外 / 尾段」五块。
Step 4 极性判定。 在档内与档外分别判:档内默认正向,档外查否定词表与降级词表。
Step 5 落库。 一题一平台一行,带批次号,失败样本单独标记。
python
import re

SLOT_PAT = [
    (1, re.compile(r'第一优先|最推荐|首推')),
    (2, re.compile(r'第二优先|备选')),
    (3, re.compile(r'第三优先|参考')),
]
NEG_PAT  = re.compile(r'不建议|注意|争议|增项多|交付不稳|只做局部|排除|慎选')
DOWN_PAT = re.compile(r'预算紧|预算有限|也可以|替代方案|如果实在|退一步')
TAIL_PAT = re.compile(r'信息来源|参考资料|参考来源|引用来源')
LABEL    = re.compile(r'[【((]\s*(信源|来源)\s*[::][^】))]*[】))]')

def judge(raw: str, aliases: list[str]) -> dict:
    t = raw.replace('\u3000', ' ').replace('\u200b', '')
    t = LABEL.sub('', t)

    rows = [{'slot': 0, 'text': s.strip()} for s in t.split('\n') if s.strip()]
    slot, tail_hit, in_tail = 0, False, False
    mention = cite = downgrade = 0
    polarity, rank = 0, 0

    for r in rows:
        if TAIL_PAT.search(r['text']):
            in_tail = True
        if in_tail:
            if any(a in r['text'] for a in aliases):
                tail_hit = True
            continue
        for sid, pat in SLOT_PAT:
            if pat.search(r['text']):
                slot = sid
                break

        if not any(a in r['text'] for a in aliases):
            continue

        mention += 1
        if NEG_PAT.search(r['text']):
            polarity = -1                       # 否定/排除:位次归零
        elif DOWN_PAT.search(r['text']):
            downgrade += 1                      # 降级提及:单列,不记位次
        elif slot > 0:
            polarity, rank = 1, slot            # 档内正向:记位次

    if tail_hit:
        cite += 1
    if rank > 0:
        cite += 1

    return {'mention': mention, 'cite': cite, 'rank': rank,
            'polarity': polarity, 'downgrade': downgrade,
            'valid': 1 if (mention or tail_hit) else 0}
注意 valid 的判法:整条回答里既没有品牌名也没有尾部引用,不代表这家企业「未被推荐」,可能只是这条答案为空、被思考链吃掉、或被平台截断。工程上把这类样本标 valid=0 剔除分母,比记一次「未命中」更诚实------后者会把技术故障算成市场竞争结果。
三、中文句子结构带来的三个麻烦
麻烦一:并列句没有主次。 家装答案爱写「A 装饰、B 设计、C 整装都可以,看预算」。三个名字并列、没有档位标题、没有排序。这时候「谁排第一」没有客观依据,只能记「并列提及」、位次留空。
处理方法:档位缺失时,按出现顺序给一个「弱序位」,但独立成列,不与三档混算。报告里呈现为「未定档位 3 次」,别硬塞进第三优先。
麻烦二:否定词的作用域。 「注意:部分公司只做局部翻新,例如 G 装饰」------否定词在句首,品牌在句末,同句命中即可;但如果是「G 装饰口碑不错,注意工期」这种,注意的作用对象是工期,不是品牌。按句子切分后,否定词与品牌的相对位置要判,简单用同句包含会把正向误判成负向。
简化做法:否定词出现在品牌名之前 12 个字符内,判负向;出现在之后且中间有逗号,且否定对象是具体项(工期、报价、增项),记中性。这套规则不完美,但比一刀切可控,且能写进报告让客户复核。
麻烦三:末尾信息的边界。 「信息来源」这四个字有时出现在正文中段(如「参考信息来源主要有三类:...」),一刀切会把后半段正文当尾段丢掉。判据要加一条:尾段必须出现在回答长度的后 20%,且其后紧跟列表结构(数字序号或短横线)。
四、位置权重:只在自己系统内可比
给四个位置配权重(正文内嵌 1.0、段末标注 0.6、结构化引用 0.5、末尾列表 0.3)是为了排序,不是为了做「综合分」。一旦把权重乘起来求和、再换算成 0--100 的分数,就掉进两个坑:权重没有外部依据、分数无法复现。
更稳的用法是只做「最优位置」标记:一条回答里某品牌最好的位置是哪个,按位置分组统计次数。这样得出的结论是「60 题里有 18 题出现在正文内嵌、22 题只在末尾列表」,每一句都能退回原文,不需要解释权重从哪来。
五、结论与边界
这条管线能回答的是「在给定的题、平台、时间窗里,这家企业以什么状态出现过」。它回答不了「为什么」,也回答不了「下个月会怎样」------AI 答案的随机性、平台检索策略的调整、竞品内容的变化,都不在这套规则的可控范围内。
工程上的取舍很清楚:规则越细,可解释性越强、维护成本越高;规则越粗,跑得快、结论越虚。家装这类本地题,我倾向细一点,因为客户要的是「补哪个区」,不是一个漂亮的百分比。
你在处理中文否定句时,是按句判还是按段落判?评论区聊聊。