项目地址:github.com/levihsu/OOT...
信息读取日期:2026-10-27(Asia/Shanghai)。Star 约 6.6k(GitHub API 显示 6,605,截至写作时);Fork 952;License:仓库 LICENSE 为 CC BY-NC-SA 4.0(Hugging Face 权重页同样标注 cc-by-nc-sa-4.0);无 Release;默认分支
main;最近一次提交约在 2024-05-13 16:50(Asia/Shanghai)。下文整理自仓库 README 与run/run_ootd.py,表述为个人重写。本文标注:原创。
一、为什么服装电商关心"虚拟试穿"
服装类目做商品图,最贵的环节往往是上身图:要模特、要场地、要修图,而且每上一个新款、每多一个颜色都要再拍一轮。平铺图便宜,但买家很难从平铺图想象穿上的样子。
虚拟试穿(Virtual Try-on)要解决的就是:给一张人像和一张衣服图,生成这个人穿上这件衣服的图,同时尽量保持衣服的图案、版型和人的姿态不变。
OOTDiffusion(Outfitting Fusion based Latent Diffusion)是这个方向上比较有代表性的开源实现之一,来自小i机器人(Xiao-i Research)的论文,README 标注收录于 AAAI 2025。
二、它是怎么工作的(按推理代码理解)
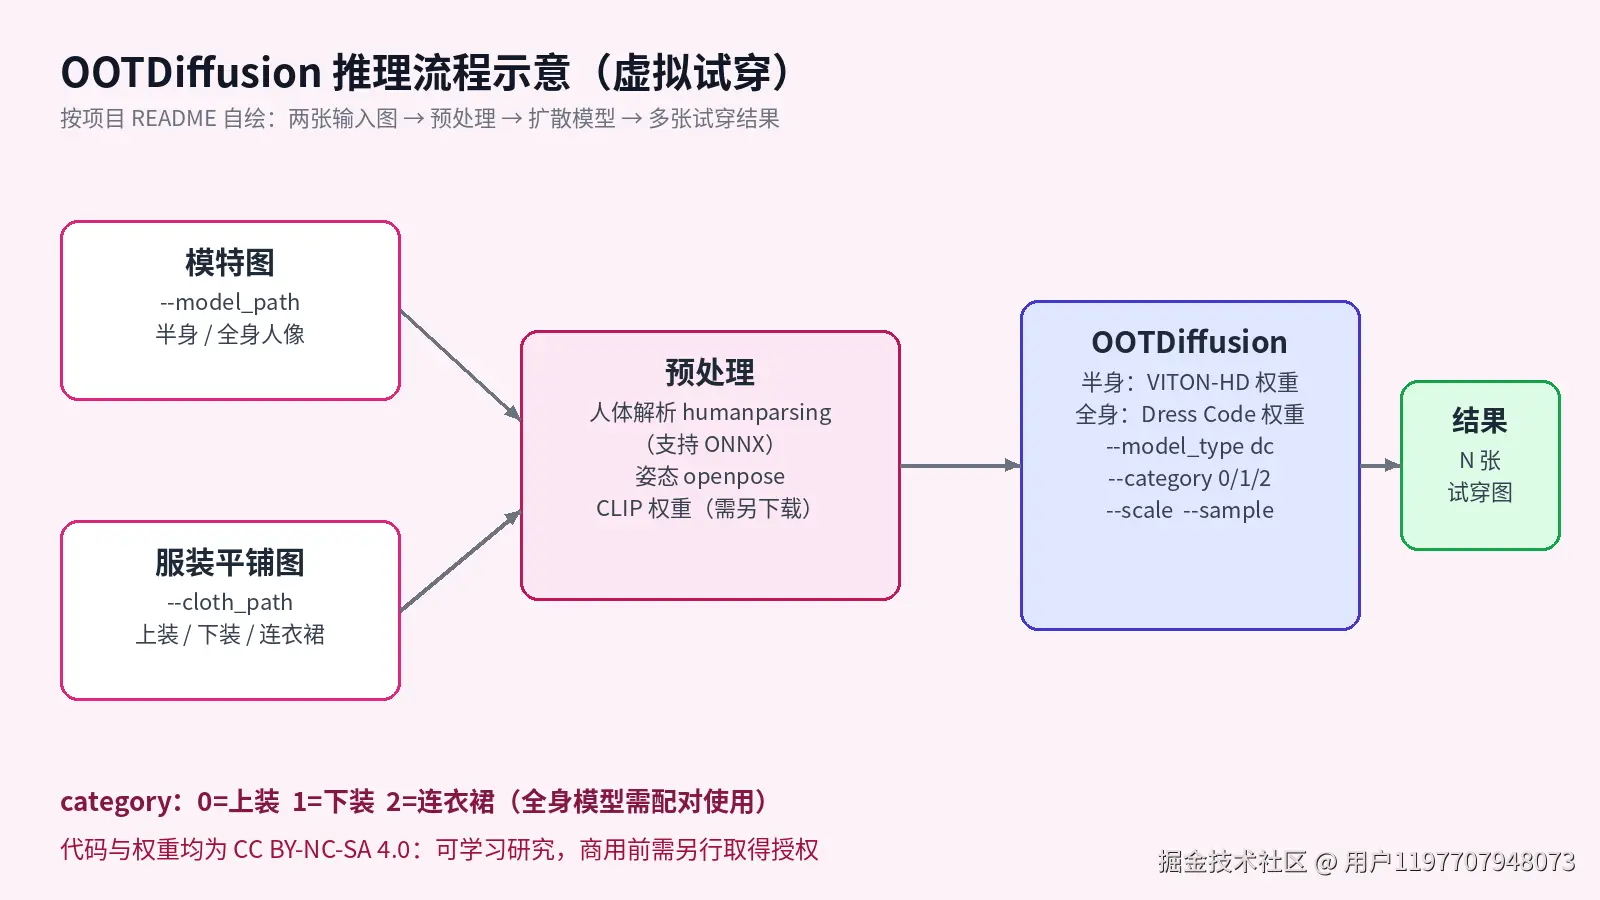
读 run/run_ootd.py 可以把一次推理拆成四步:
- 读图并统一尺寸:服装图和模特图都被 resize 到 768×1024;
- 预处理模特图:用 OpenPose 提取人体关键点,用人体解析(human parsing)分出身体各部位;
- 生成遮罩:根据服装类别(上装/下装/连衣裙)和解析结果,算出模特身上需要"换掉"的区域,把这部分盖住;
- 扩散生成:把服装图、被遮罩的模特图、遮罩和原图一起送进 OOTDiffusion 模型,按设定的步数和引导强度生成若干张结果。
论文名里的 "Outfitting Fusion" 指的是把服装特征融合进去噪 UNet 的方式,具体原理建议直接看 arXiv 论文(2403.01779),这里不展开。
三、两个模型:半身和全身
README 说明发布了两套权重:
| 模型 | 训练数据 | --model_type |
支持的类别 |
|---|---|---|---|
| 半身 | VITON-HD | hd(默认) |
只支持上装(category 0) |
| 全身 | Dress Code | dc |
0 上装 / 1 下装 / 2 连衣裙 |
代码里有一个硬性检查:model_type 为 hd 时,category 必须是 0,否则直接报错。所以做裙装、裤装必须用全身模型,而且 README 特别提示全身模型的服装类别要配对正确。
四、本地安装与推理
README 写明只在 Linux(Ubuntu 22.04)上测试过。安装步骤:
bash
git clone https://github.com/levihsu/OOTDiffusion
cd OOTDiffusion

conda create -n ootd python==3.10
conda activate ootd
pip install torch==2.0.1 torchvision==0.15.2 torchaudio==2.0.2
pip install -r requirements.txt
requirements.txt 里把版本钉得很死(如 diffusers==0.24.0、transformers==4.36.2、gradio==4.16.0、onnxruntime==1.16.2),建议单独开环境,别和其他项目混用。
权重需要另外下载:
- 从 Hugging Face 的
levihsu/OOTDiffusion下载 ootd、humanparsing、openpose 三部分权重,放进checkpoints目录; - 再把
openai/clip-vit-large-patch14也下载到checkpoints目录。
人体解析现在支持 ONNX,README 提到大部分环境问题因此得到缓解。
推理命令:
bash
cd OOTDiffusion/run

# 半身模型(只换上装)
python run_ootd.py --model_path <模特图路径> --cloth_path <服装图路径> --scale 2.0 --sample 4

# 全身模型(category: 0 上装, 1 下装, 2 连衣裙)
python run_ootd.py --model_path <模特图路径> --cloth_path <服装图路径> \
--model_type dc --category 2 --scale 2.0 --sample 4脚本里其他可调参数:--step(去噪步数,默认 20)、--seed(默认 -1 随机)、--gpu_id(默认 0)。--sample 控制一次出几张,--scale 是引导强度。脚本会把中间的遮罩存到 ./images_output/mask.jpg,排查"为什么换错了区域"时很有用。
不想本地部署,可以先在 README 给出的 Hugging Face Space 上体验效果。
五、放到电商场景里,我会怎么评估
把开源试穿模型接进商品图流程前,我会按服装电商最在意的几项去测:
- 图案和文字保真:印花、Logo、刺绣有没有变形、错字;
- 版型和长度:短款会不会被"拉长",宽松款会不会变修身------这直接关系到"货不对版";
- 颜色还原:生成图和平铺实拍图并排对比,有没有偏色;
- 遮罩是否正确 :下装、连衣裙的遮罩区域对不对,可以直接看
mask.jpg; - 人像合规:模特图必须是有授权的人像,不能用明星或他人照片。
我的看法是:这类模型适合做上身示意和内部选款参考,能省下不少前期打样拍摄;但只要涉及给买家看的商品主图,生成结果仍然需要人工逐张核对,衣服本身必须和实物一致。
六、局限
- 许可是非商用的 :代码 LICENSE 和权重都是 CC BY-NC-SA 4.0,不能直接拿来做商业服务或商用出图,商用前需要联系作者另行授权;
- 维护基本停滞:最近一次提交在 2024 年 5 月,README 的 TODO 里训练代码仍未发布,无法用自家数据微调;
- 依赖版本旧:torch 2.0.1、diffusers 0.24.0 等,在新显卡驱动和新 CUDA 上可能需要自己折腾;
- 需要 GPU:README 的在线 Demo 用的是 A100(ZeroGPU),本地推理需要有显卡的环境;
- 输入要求:模特图姿态、遮挡、背景复杂度都会影响结果,电商用最好准备正面、站姿清晰的人像。
七、小结
OOTDiffusion 适合用来理解虚拟试穿的完整链路:姿态和人体解析做遮罩、服装特征融合进扩散模型、按类别切换半身/全身模型。对服装电商的开发者来说,跑通一遍能对"试穿效果能做到什么程度、哪里容易出错"有直观判断;但受限于非商用许可和维护状态,更适合学习和内部评估,而不是直接上生产。
参考: