大家好,我是邵奈一,一个爱折腾的实战派技术博主。 文章对你有帮助是我的荣幸,欢迎评论区交流。
GPT-6.1 Terra 这一代的看点不是跑分涨了多少,而是"便宜"和"快"第一次同时落到了能干活的水准上。 我自己的用量面板里,它的生成速度是 Sol 的 3.4 倍,价格只有一半,这就是换它的全部理由。
0x00 先看这一代到底改了什么
OpenAI 在 2026 年 10 月 26 日发布 GPT-6.1 Terra 并同步开放,对应北京时间 10 月 27 日。开放范围是 Plus、Pro、Enterprise 和 Edu 用户,入口是 ChatGPT Work 和 Codex,API 标识 gpt-6.1-terra。
它接的是 GPT-5.6 Terra 的位置------产品线里的中间层。上一代 8 月发布时,Terra 夹在 Luna( 0.20/1.20)和 Sol( 4/20)之间,定价 2/12。到了 6.1 这一代,Terra 直接压到 1/5,比同代的 GPT-6.1 Sol( 2/10)低整整一半。
官方给的定位很清楚:视觉推理、精确的电脑操作、清晰自然的写作。复杂编程和深度研究仍然让 Sol 和 Astra 去做。这句话不是客套,后面 0x06 会拿实测数据说明它确实有自己的天花板。
本文按下面的顺序展开:
- 0x01 发布与定位,Terra 在产品线里站哪一格
- 0x02 规格与价格,一半的价格砍掉了什么
- 0x03 与 Sol 的两笔账,纸面规格与真实用量
- 0x04 跑分与第三方实测,官方数字之外还有什么
- 0x05 实机验证,5 秒和 6 秒分别能干什么
- 0x06 三个必须提前知道的限制
- 0x07 谁该换、怎么换
0x01 发布与定位:Terra 回到了中间层
先把三代 Terra 放在一起看,变化会非常直观。
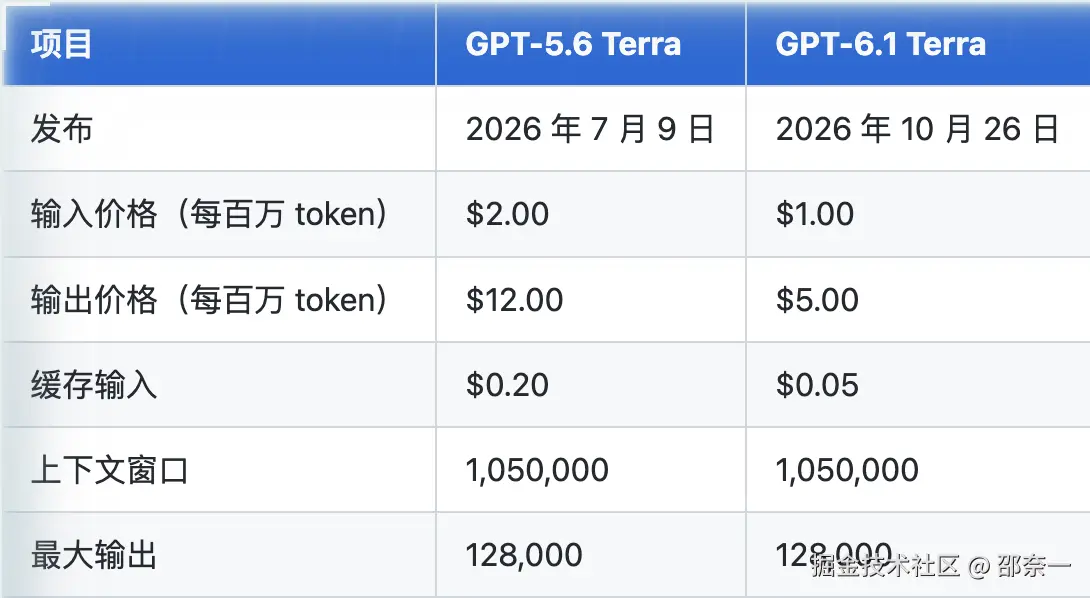
表里的价格降幅比"一半"更狠一点:输入从 2砍到1 是正好一半,输出从 12砍到5 是降了 58%。OpenAI 自己在发布说明里统一表述为"比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%",按 Sol 算确实分毫不差,按 5.6 Terra 算则偏保守。
产品线上,现在的分工是这样的:
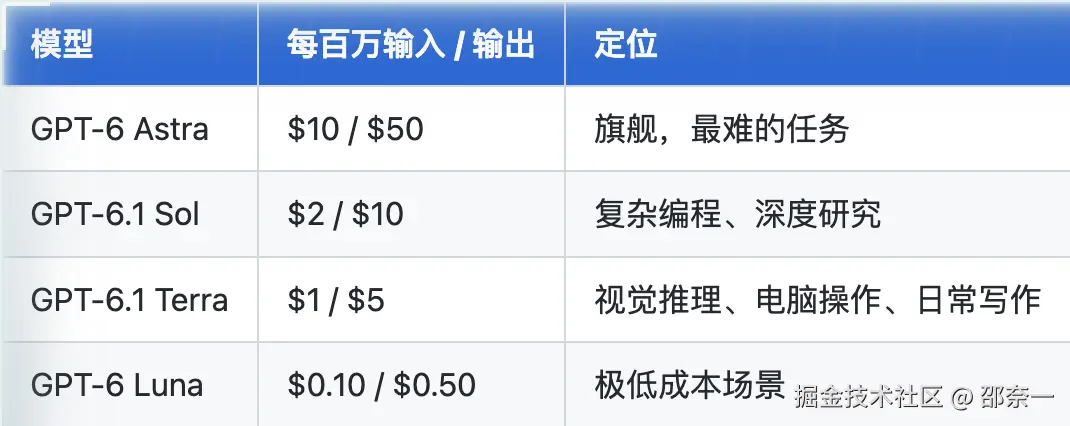
能看出来 OpenAI 在补一个很具体的空档:那些"值得用 AI 做、但用 Sol 做太贵"的日常杂活。读发票、录财务软件、识读技术图纸、剪视频,这些任务的特点是重复量大、单次价值不高,此前卡在成本上,现在卡点松了。
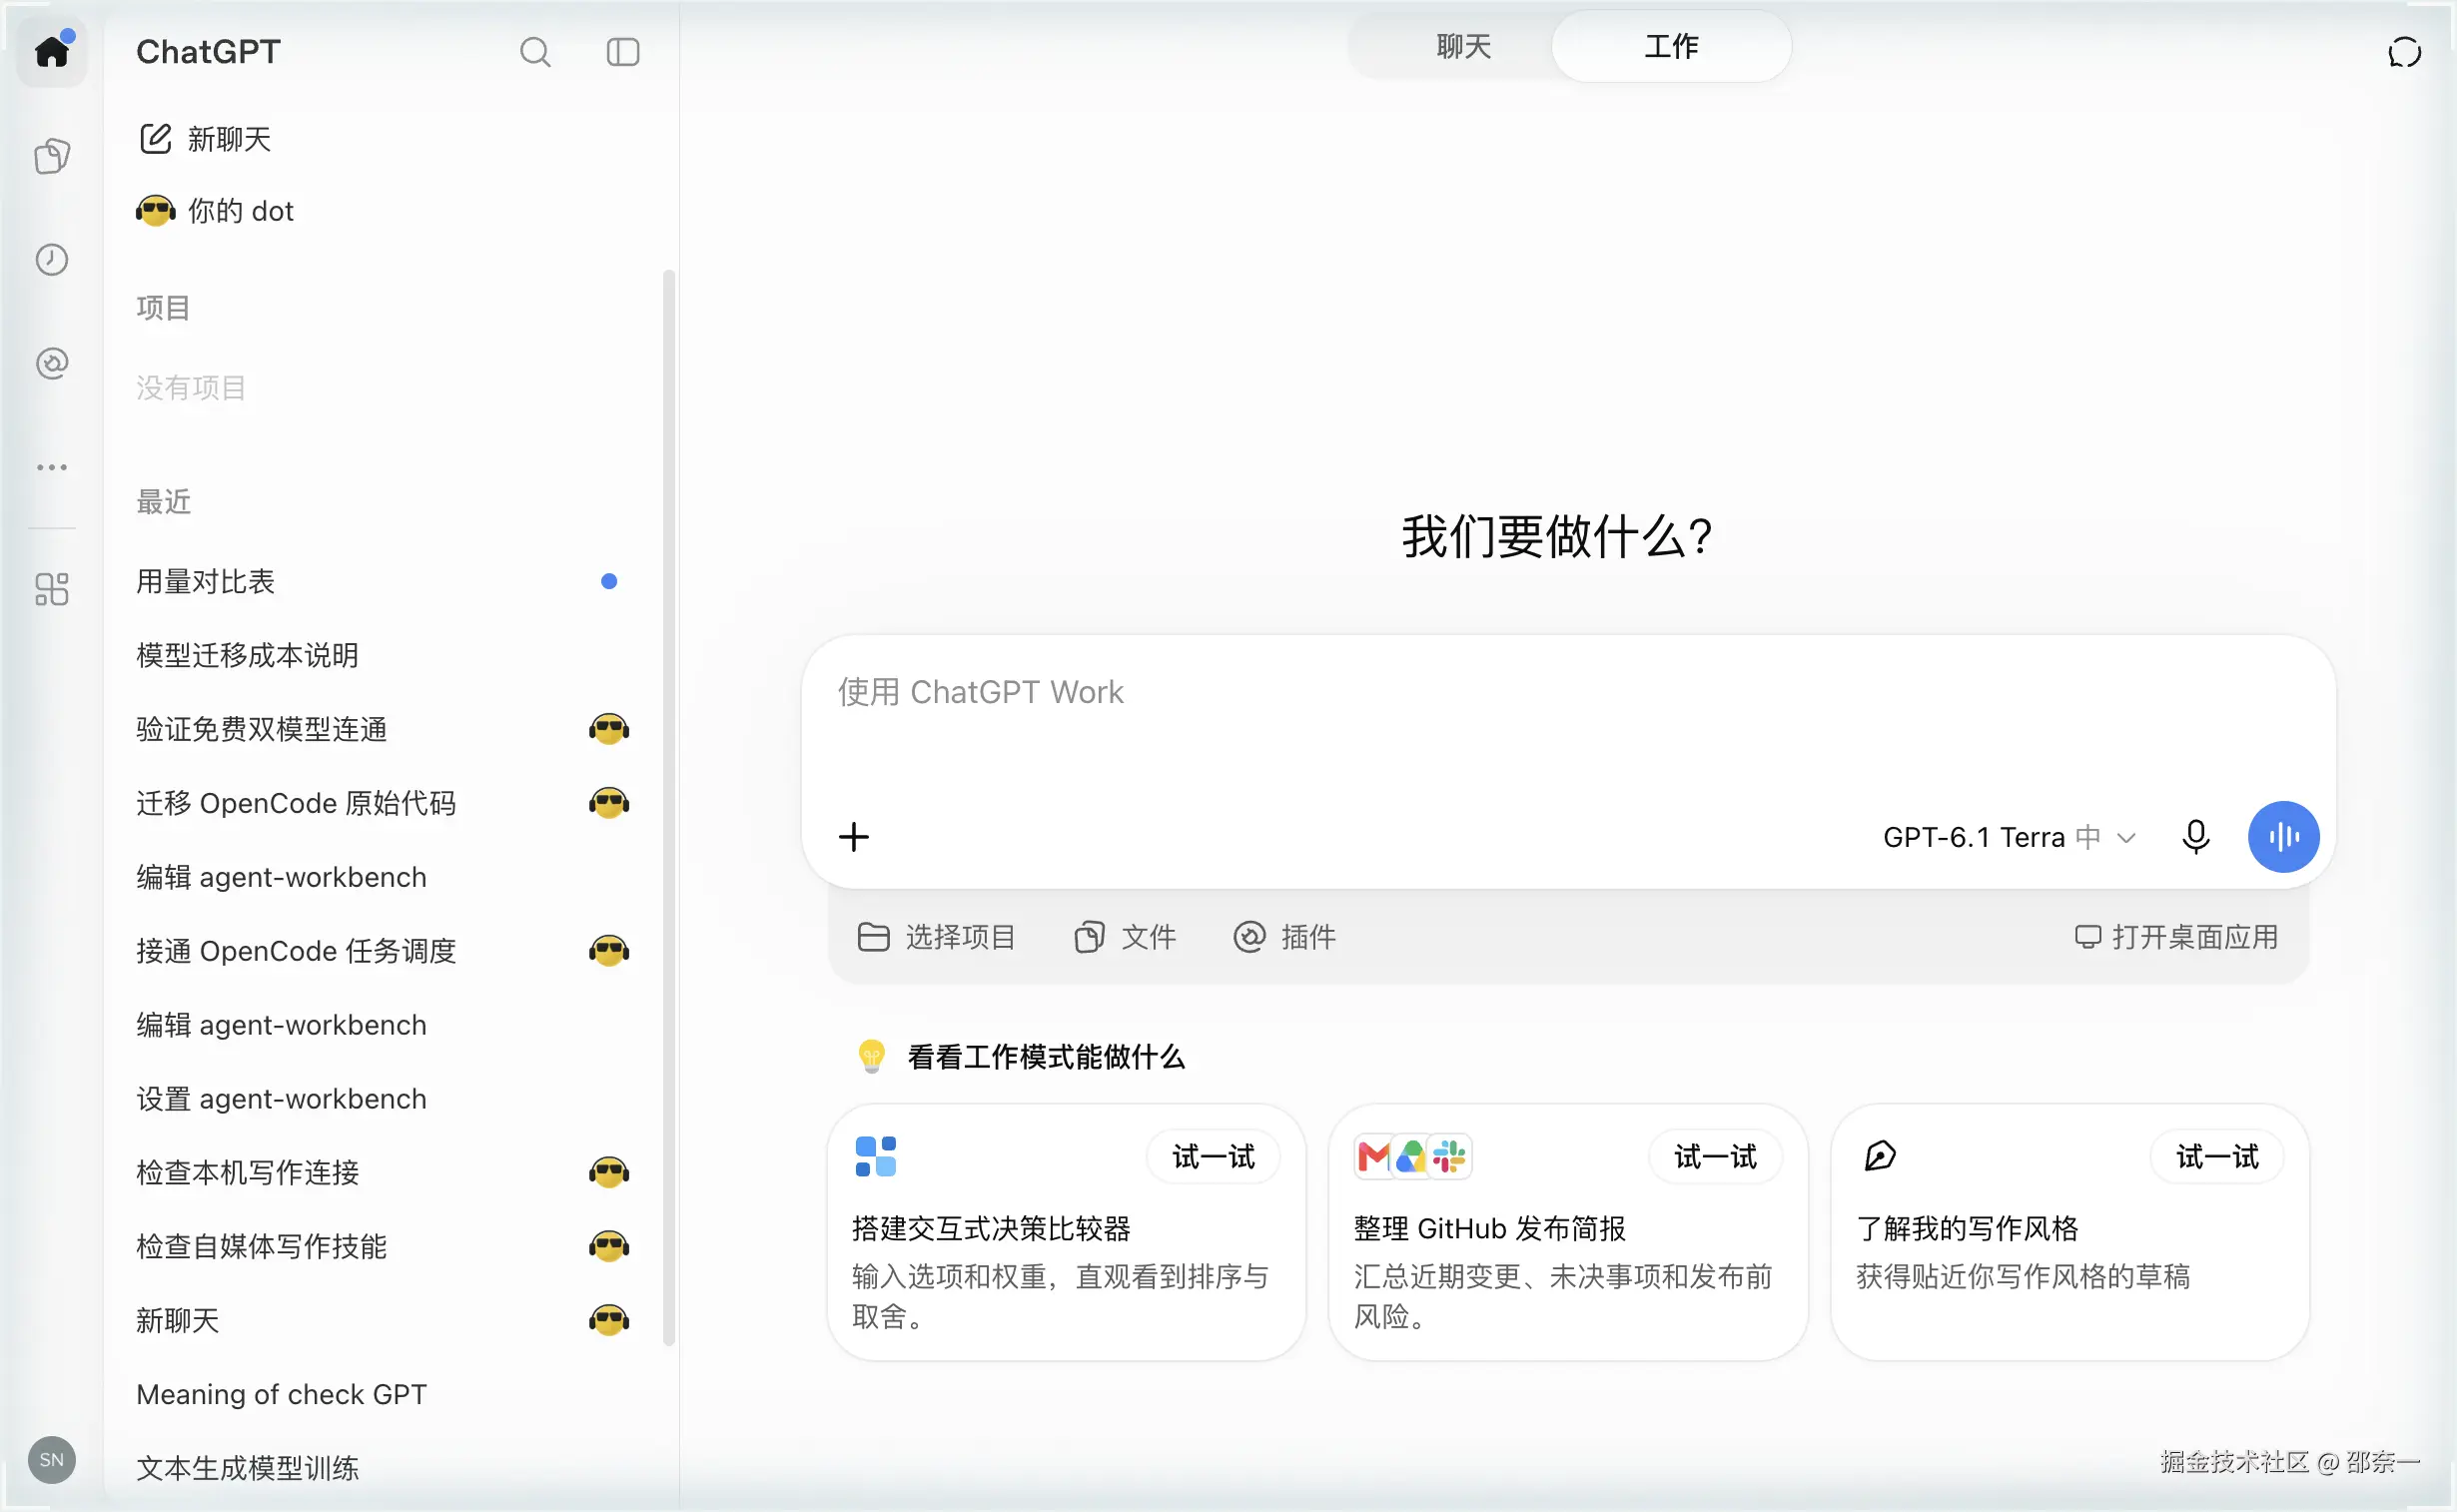
图里是 ChatGPT Work 的新建对话界面,右下角模型选择器默认就是 GPT-6.1 Terra,思考强度默认"中"。这和官方文档里 reasoning effort 默认 medium 的说法对得上。
0x02 规格与价格:一半的价格砍掉了什么
规格表先摆出来,重点项我加粗了。
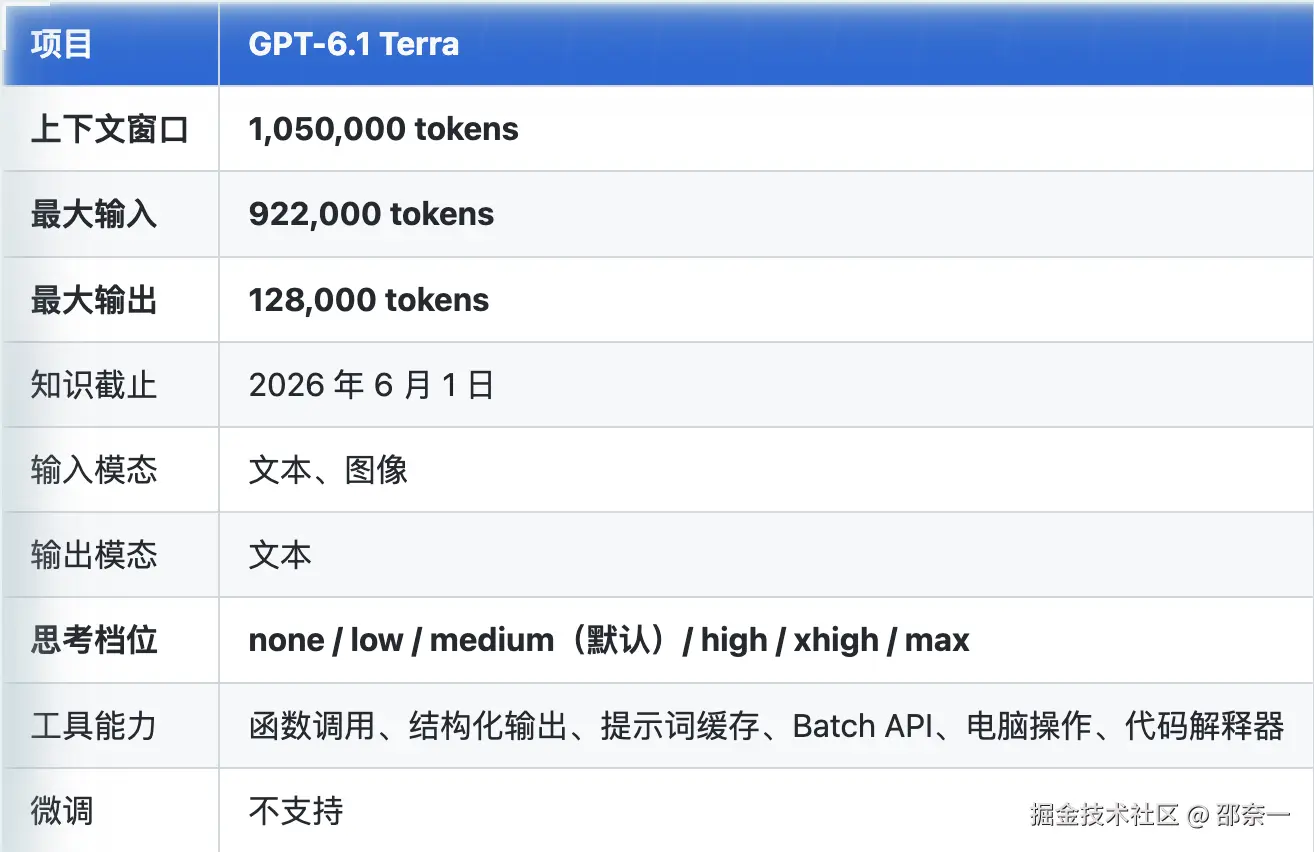
两个细节值得单独拎出来。
第一个是思考档位。六档从 none 一路到 max,默认 medium。这个跨度不是摆设,0x06 会用第三方实测数据说明档位选错要付多少代价,这里先记住它有六档。
第二个是长上下文的加价悬崖。输入超过 272,000 token 之后,输入和缓存按更高费率计费,输出上浮 50% 左右。1.05M 的窗口听着豪气,但真正把百万上下文塞满时,账单不是线性增长的。Batch 和 Flex 通道比标准价再低 50%,批量离线任务走这条线更划算。
放到同价位段横向比一比, 1/5 这个定价的位置很扎眼。
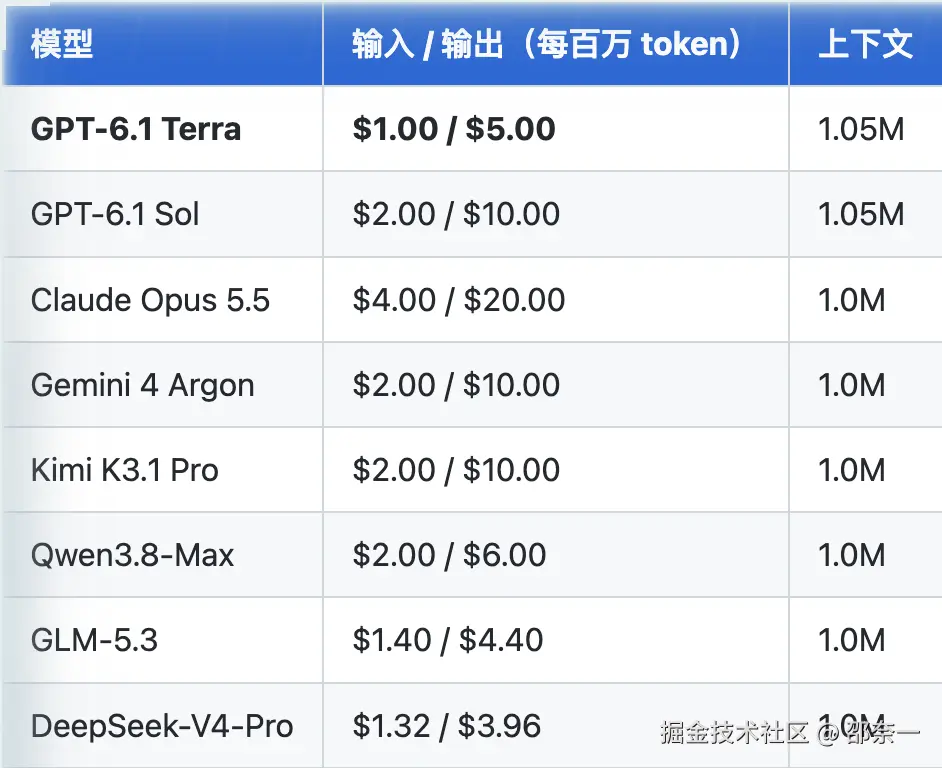
2026 年 10 月这个时间点上,一线厂商的中端档位大多压到" 2输入/10 输出"附近------Sol、Gemini 4 Argon、Kimi K3.1 Pro 都是这个价,Claude Opus 5.5 仍在 4/20。Terra 的 1/5 直接把前一条线打了对折,这也是 The Information 在发布前把它解读为"和 Anthropic 打价格战"的原因。
国产模型在这个价位段的竞争力没掉队:GLM-5.3 和 DeepSeek-V4-Pro 的单价甚至还低于 Terra,Qwen3.8-Max 在输出侧比 Sol 便宜近四成。选型时不该只盯着 OpenAI 一家看。表内价格为 2026 年 10 月下旬第三方聚合站整理,各家调价频繁,下单前以厂商官网为准。
0x03 与 Sol 的两笔账:纸面规格与真实用量
这一代 Terra 被讨论最多的不是它自己,是它和 Sol 的关系。同代、同架构、同上下文窗口,价格砍一半,砍掉的到底是什么。纸面上有一笔账,我自己的用量面板里还有一笔账。
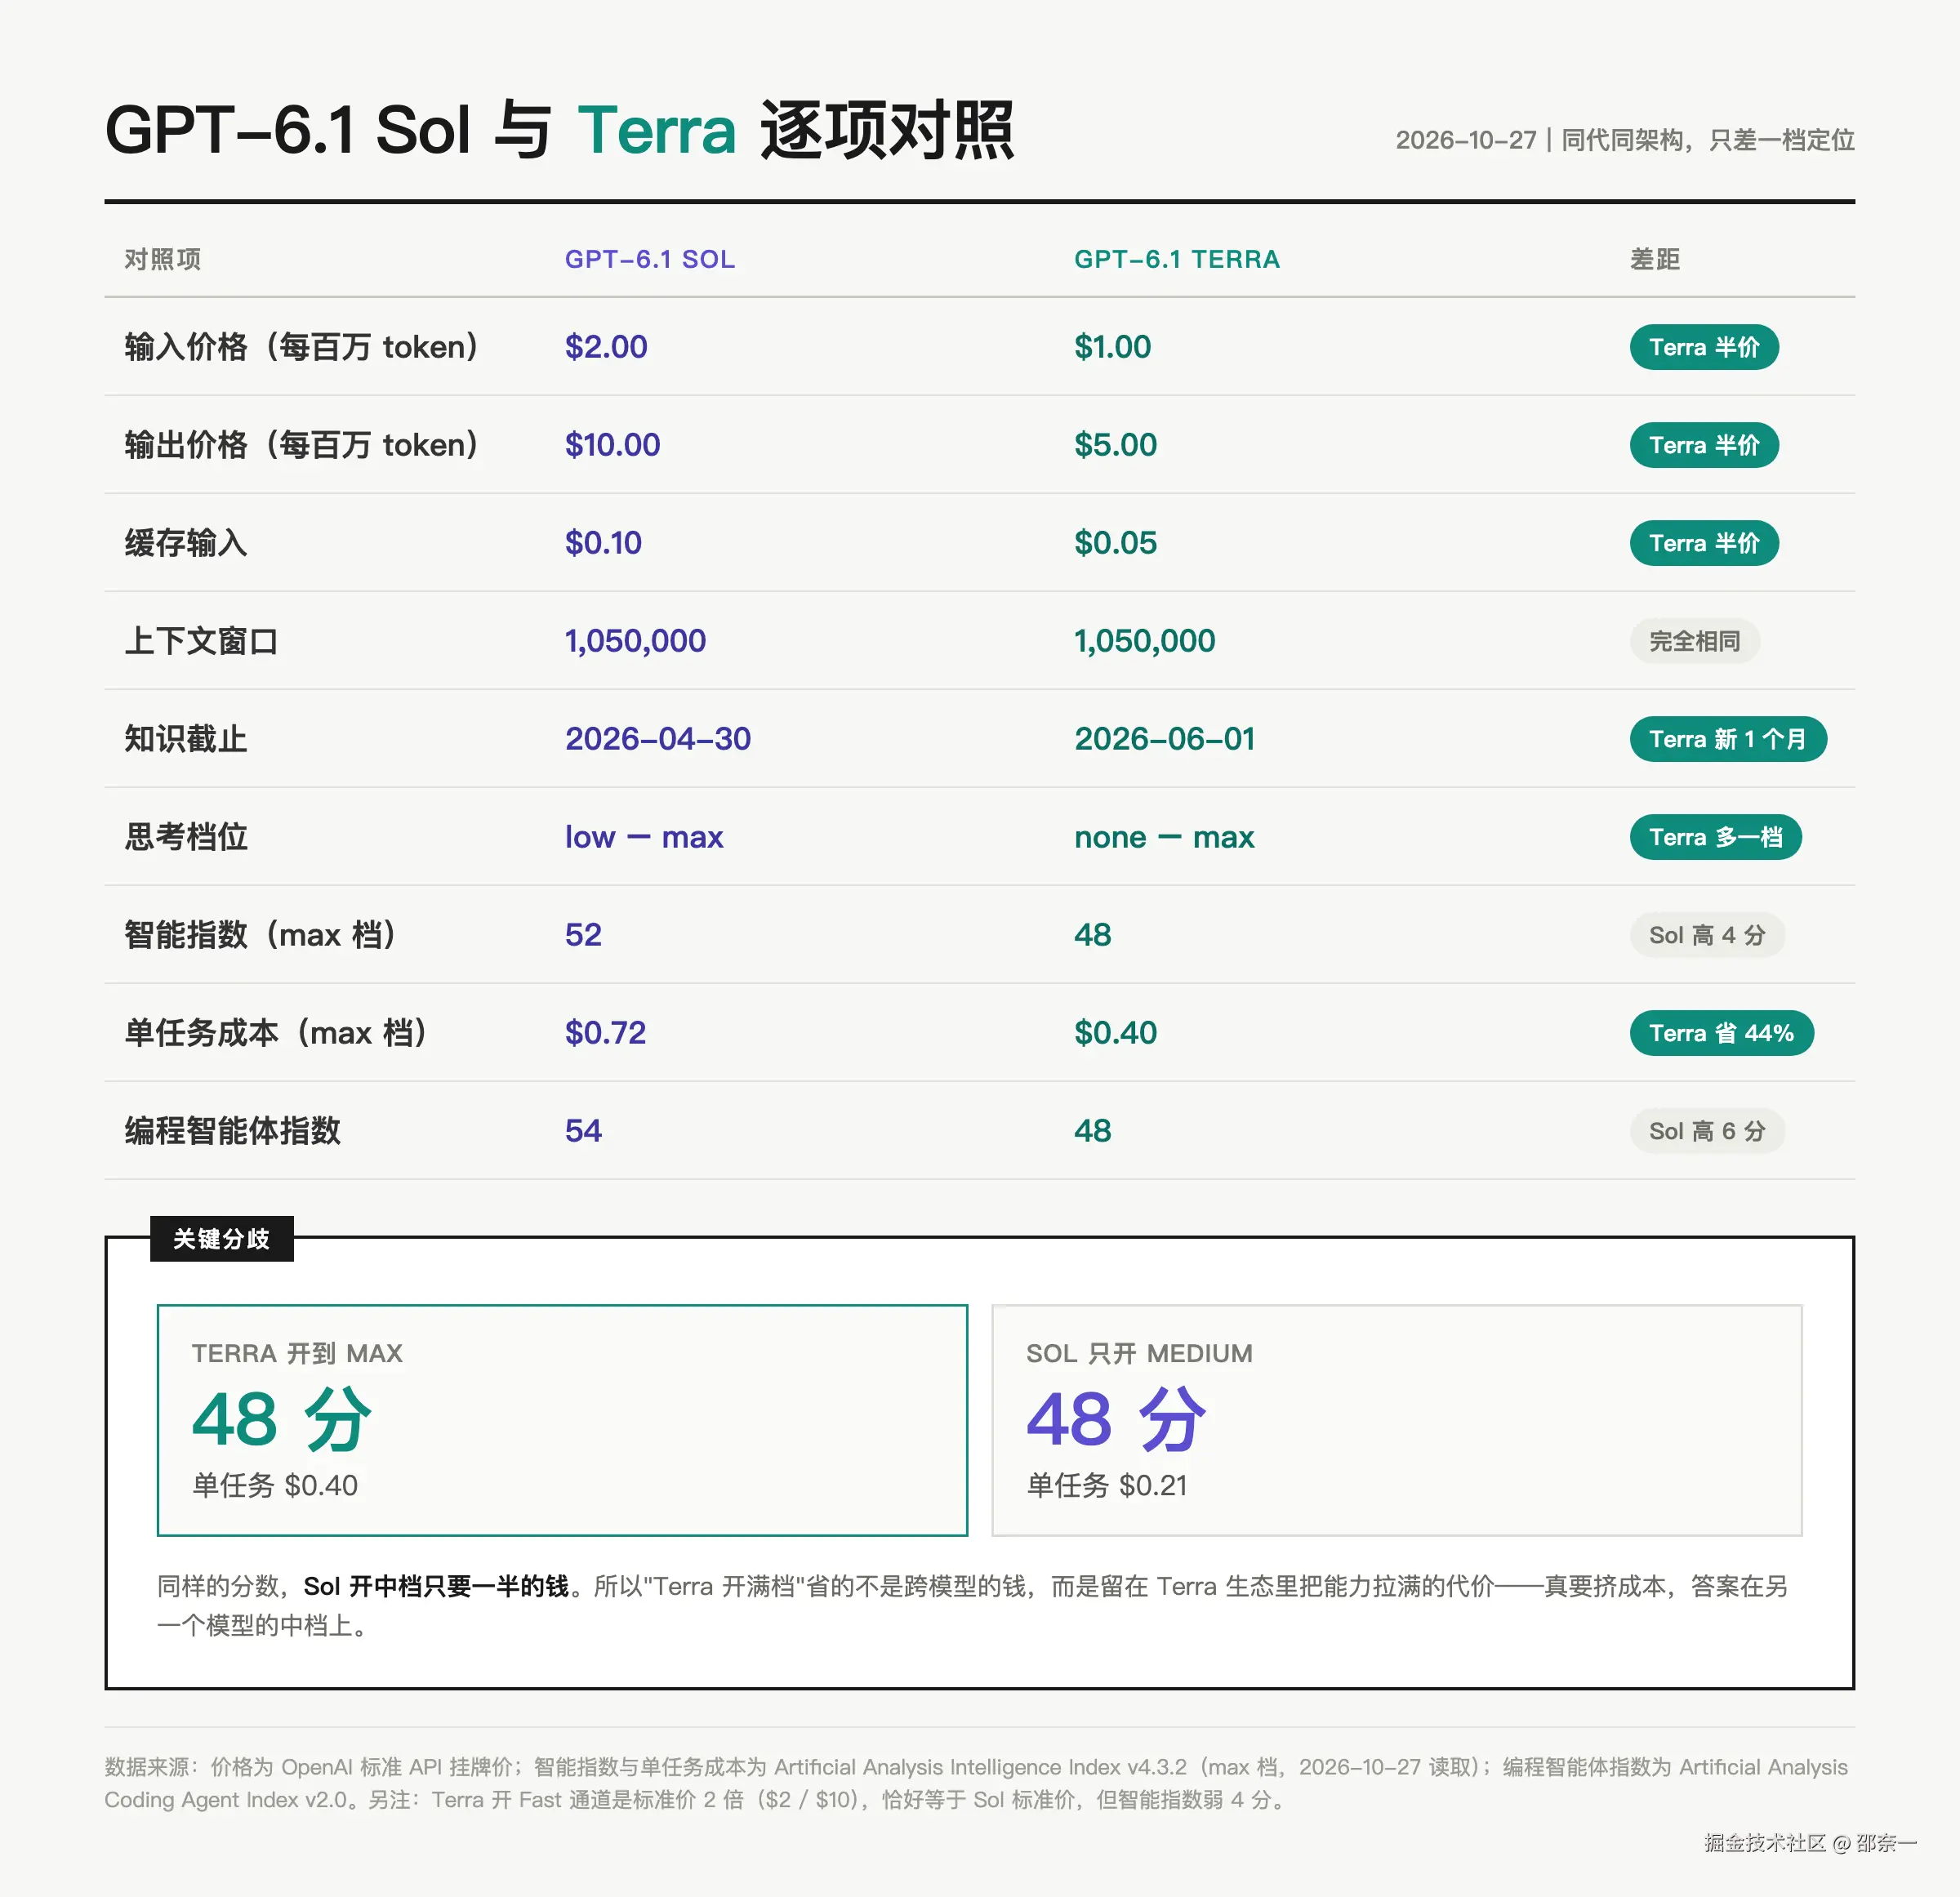
九项里,三项价格砍半,一项原封不动,其余五项各有各的账。
价格三项全是正好一半。 输入 2到1、输出 10到5、缓存输入 0.10到0.05,没有玩"输入降、输出升"的花招。
上下文和工具集完全一致。 1,050,000 上下文、922,000 最大输入、128,000 最大输出,三项一模一样。工具集、端点、不支持微调,也全都一样。换个模型就是改一个 model 字符串。
知识截止反而更新。 Terra 是 2026 年 6 月 1 日,Sol 是 4 月 30 日,便宜的那个新了一个月。对依赖近期 API 和库版本的活,这一个月比那 4 分更值钱。
思考档位是 Terra 多一档,不是少一档。 这一点网上传得有点乱,容易记反。OpenAI 开发者文档的原话是"GPT-6 Astra 与 GPT-6.1 Sol 不支持 none,请改用 low;GPT-6.1 Terra、GPT-6 Sol 和 GPT-6 Luna 支持 none"。所以 Sol 只有 low 到 max 五档,Terra 是 none 到 max 六档,多出来的那一档是 Sol 没有的成本下限。
none 还有一个实用副作用:按官方迁移指引,reasoning effort 不是 none 的时候,temperature、top_p、top_logprobs 都得从请求里删掉。也就是说只有 none 档才开放采样参数------做分类、抽取这类要控温度的任务,这一档不是省钱选项,是唯一选项。
砍掉的是几分。 AA 智能指数 52 对 48,差 4 分;编程智能体指数 54 对 48,差 6 分。不是零,但也不是"旗舰对中端"这个说法暗示的鸿沟。
把档位也算进去,同一个分数有两种买法。
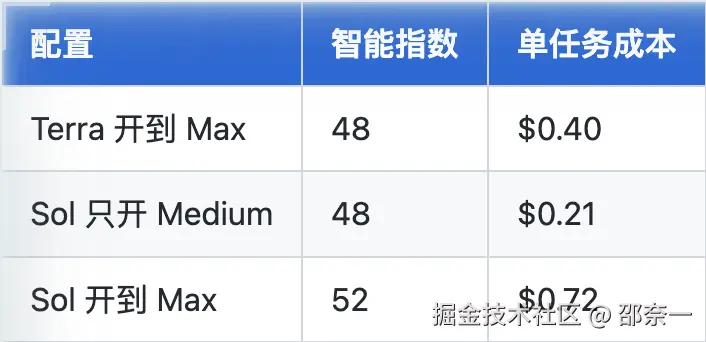
同样是 48 分,Sol 只开中档花 0.21,比Terra开满档的0.40 还便宜一半。
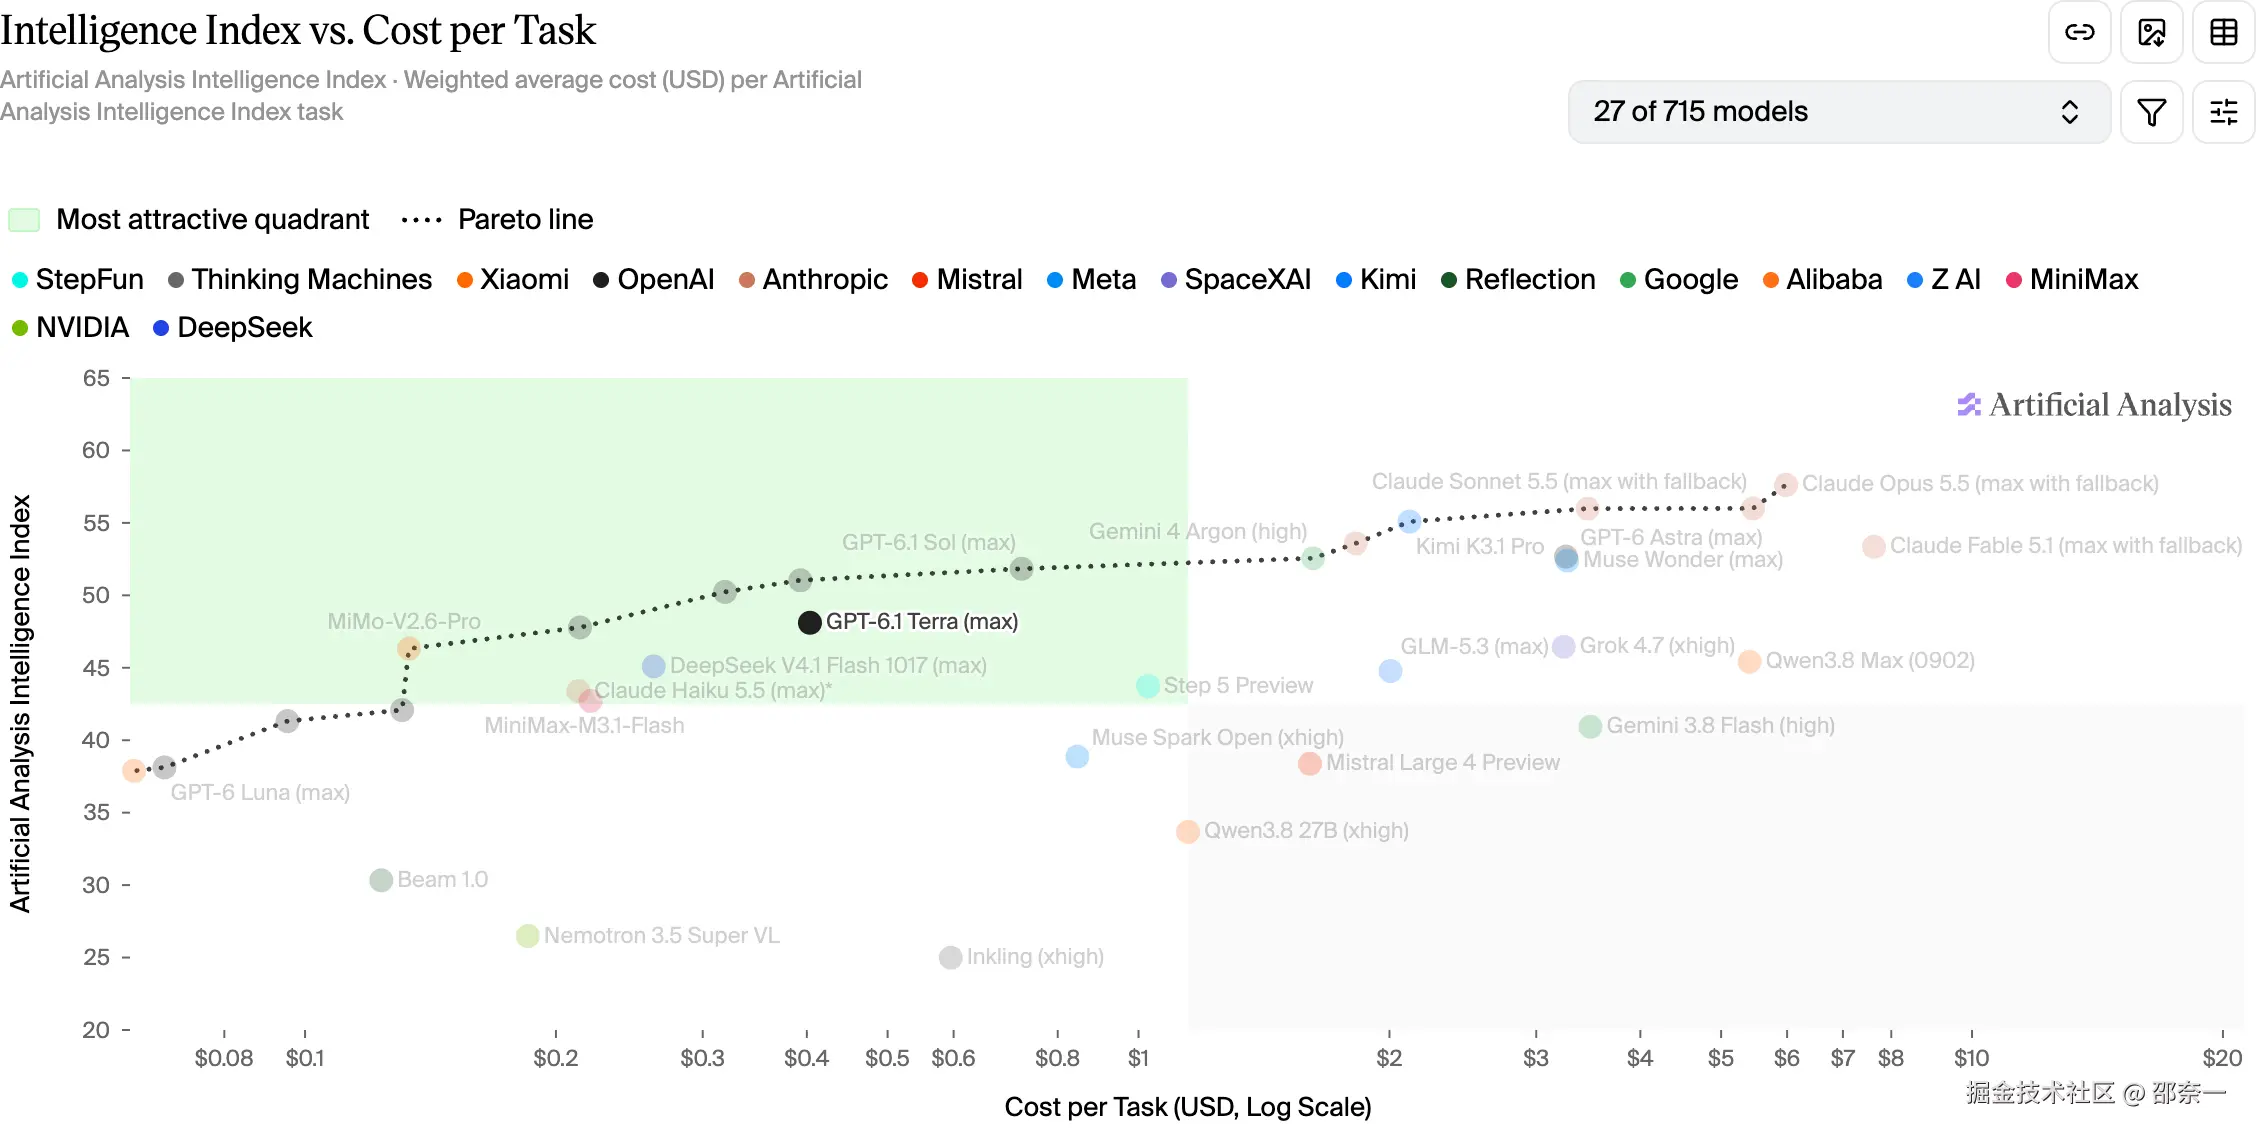
图里绿色那块是 Artificial Analysis 自己标出的"最划算象限",虚线是它的 Pareto 前沿------落在线上意味着同价位没有更好的,同水平没有更便宜的。GPT-6.1 Terra 满档那个点( 0.40/48分)就压在这条线上,Sol满档(0.72 / 52 分)也在线上,多花三毛二买四分。再往右就陡了:Gemini 4 Argon 两块多一个任务拿 53 分,Kimi K3.1 Pro 两块出头 55 分,Claude Opus 5.5 要六块多才到 58。
左下角那个 GPT-6 Luna (max) 值得一提,$0.07 一个任务拿到 36 分左右。纯跑量、结果能自动校验的活,它的账最好算。
三个模型的各档位数据在 0x06 那张六档表里,官方这张图只画了每个模型的最高档。
这条数据把"要不要换 Terra"拆成两个完全不同的问题:
- 留在 Terra 里,档位开到哪一档
- 要不要用 Terra 而不是 Sol
第一个问题在 0x06 展开,第二个问题取决于你要的分数:要的就是 48 分这个水平,Sol 中档更便宜;要的是 Terra 的视觉和电脑操作能力,那四分本来就不是你缺的东西。两个问题混在一起想,会得出"Terra 全面不如 Sol"或者"Terra 全面替代 Sol"这两种都错的结论。
还有一个容易踩的坑:Terra 开 Fast 通道是标准价 2 倍,也就是 2/10------恰好等于 Sol 的标准价,但智能指数弱 4 分。为了速度付这个倍数,价格优势就没了。
纸面之外,我自己的用量面板里还有一笔账。这张表来自本地统计,两个模型都是同一个工具、同一个账号跑出来的。
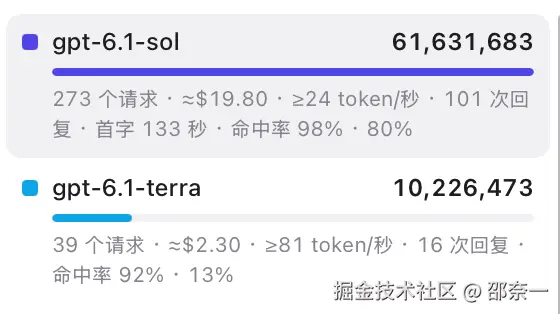
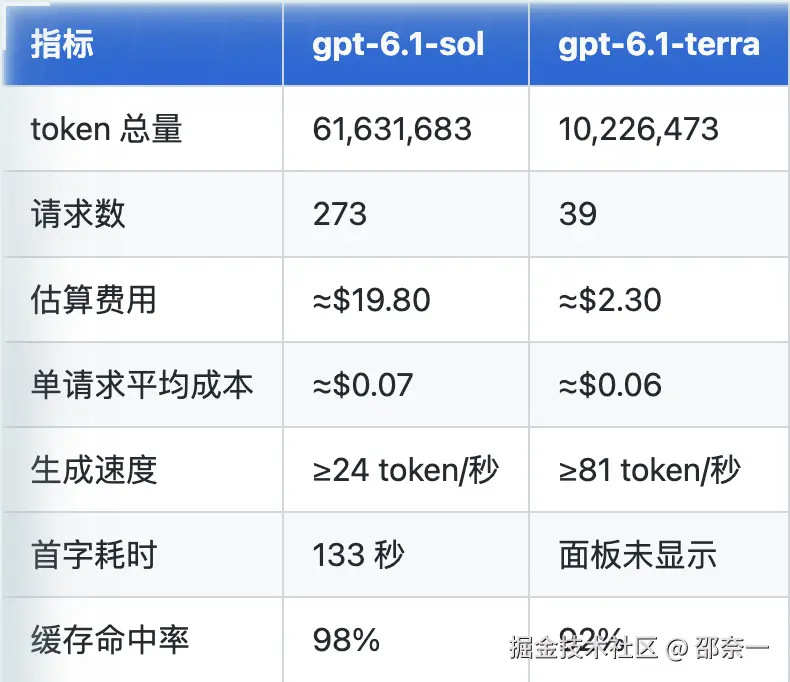
速度差 3.4 倍,这是体感上最先砸过来的变化。 ≥81 对 ≥24,81 ÷ 24 = 3.375。面板给的是"≥",是下限值,实际可能更快。这个倍数不是跑分的抽象差距,是你盯着屏幕等字出来的时候能直接感觉到的差别。用 Sol 时我会切出去干别的事再回来收结果,用 Terra 时基本可以等在那儿看完。
单价便宜一半,实际账单便宜更多。 Sol 花了约 19.80,Terra花了约2.30,账单总额差 8.6 倍。但这个数字不能直接引用------两者跑的不是同一批任务。把 token 量归一再算:Sol 每百万 token 约花 0.32(19.80÷61.63),Terra约0.22(2.30 ÷ 10.23),差距收窄到 1.4 倍。账单差 8.6 倍是任务结构带来的,单价差 1.4 倍才是模型本身带来的。 两个数都得看,只报前者是耍花招。
单请求成本几乎持平,这件事容易被误读。 0.07对0.06,看着没差多少。原因是 Terra 那 39 个请求平均每次吃了 262K token(10,226,473 ÷ 39),比 Sol 的 226K(61,631,683 ÷ 273)还多。它把更大的上下文塞进了更少的请求里。所以"单请求便宜"不等于"便宜一半",真正省钱的地方在总量上,不在单次。
样本量不对等,别把这张表当定论。 Terra 只有 39 个请求、16 次回复,Sol 是 273 个请求、101 次回复,前者样本量只有后者的七分之一。首字耗时那一栏 Terra 干脆没显示------样本不够,工具没算。所以"Terra 首字更快"这个结论,我拿不出数据支持,只能说没测出来。
缓存命中率那栏,Sol 98% 对 Terra 92%,差 6 个百分点。这大概率跟 Terra 上线时间短、缓存还没积累起来有关,属于推测,不是结论。
0x04 跑分与第三方实测:官方数字之外还有什么
先声明口径:下面第一组数字全部来自 OpenAI 自己的发布说明,没有经过独立复现。
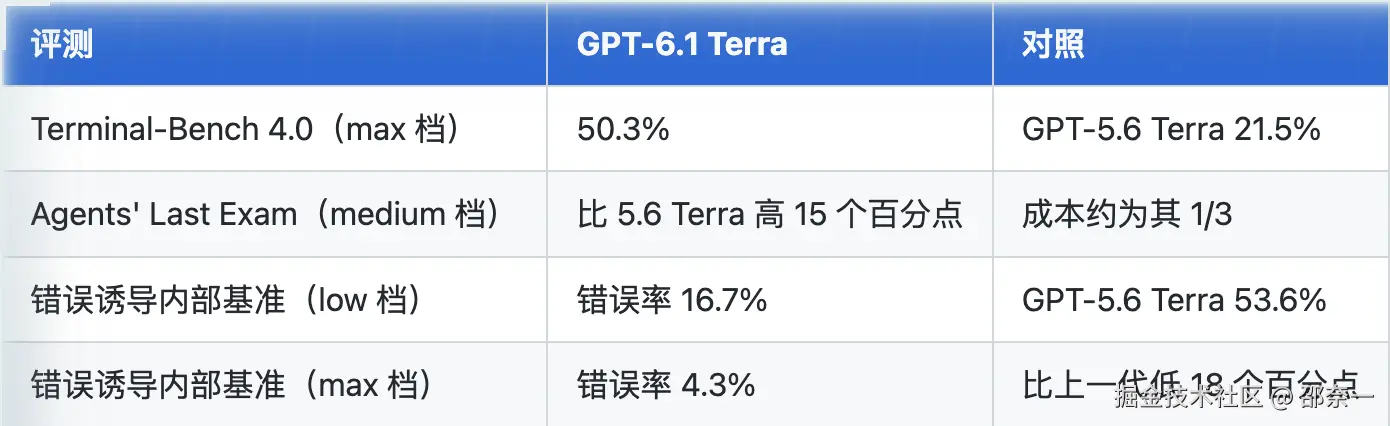
Terminal-Bench 4.0 那行是官方最愿意强调的:命令行任务的完成率从 21.5% 翻到 50.3%,两倍多。这项测的是智能体在终端里干活的能力,比如修一个网页加载时的布局偏移。
官方发布图里还给了同一个模型在各档位上的成绩:low 24.8%、medium 35.8%、high 41.8%、xhigh 46.4%、max 50.3%。默认的 medium 只有 35.8%,和满档差 14.5 个百分点。 换算过来,你不调档位直接用,拿到的是它在终端任务上七成出头的水平。
错误率那两行反而更实用。low 档从 53.6% 降到 16.7%,意味着低思考档位终于能用了------以前开低档基本等于赌运气,现在可以用它跑量。官方把这归功于事实性错误的削减,并称这是为了让自动化流程别被错误回答带偏。
第三方的数据补上了官方不愿多说的部分。
先看幻觉。在 AA-Omniscience 基准里,模型不知道答案却硬答的比例,GPT-5.6 Terra 是 88%,GPT-6.1 Terra 降到 38%。两个数字口径不同,但指向一致------它更愿意承认"这个我不知道"。
Artificial Analysis 的智能指数给 Max 档 48.1 分,平均单任务成本 0.403。同样口径下GPT−6.1Sol是0.72,Claude Opus 5.5 是 $5.98。这个"单任务成本"比"每百万 token 便宜一半"有信息量得多------它把单价、token 消耗量、重试次数一起算进去了,这才是你月底看到的账单。
同一份数据里还有一条更该被记住:48.1 分并不领先。Opus 5.5、Kimi K3.1 Pro 和 GPT-6 Astra 的智能指数都在它之上。 Terra 赢的是"每任务花多少钱",不是"每任务多聪明"。这两件事在选型时不能混。
但把 Sol 和 Terra 的单任务成本摆在一起,会得出一个更实用的结论:Terra 开满档是 0.403一个任务,比Sol满档的0.72 还便宜 44%。 也就是说,你完全可以用满档的 Terra 去接原来交给 Sol 的活,钱还少花一截。这是我个人最看重的一条------它把"要不要开到最高档"这个问题从省钱决策变成了纯技术决策。
据多家媒体报道的公开测试记录,创作者 Mr Tactical 做了一次同题对比:让 Terra 和 Claude Opus 5.5 各在 Blender 里从零搭一座《我的世界》风格的悬浮小岛,带风车和农场,日落场景,两边都开 Extra High 档位。
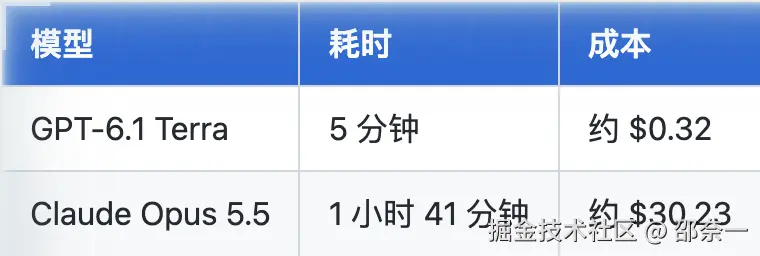
同题、同档,按他公布的数字折算,成本差约 94 倍。这类案例的说服力比跑分强,因为任务本身就是"电脑操作"这个官方定位。
但另一组数据就没这么好看了。同样据媒体报道,开发者 Paweł Huryn 在两个代码仓库里埋了 105 个缺陷,让模型去排查修复:max 档 40.7 分,xhigh 档 11.3 分,high 档 9.7 分。同一模型、同一任务,只换思考档位,最高档和最低档差了四倍多。 而他测的三个档位里最低的是 high,Terra 的默认档位 medium 还在 high 之下。
这条数据的意义不在于"Terra 不行",而在于提醒:在这类任务上,用默认档位去测 Terra,测出来的接近最差的它。
0x05 实机验证:5 秒和 6 秒分别能干什么
用量面板是统计口径,还得有一次能盯着看的实机验证。我在 ChatGPT Work 里用 GPT-6.1 Terra 跑了两个任务,档位留在默认的"中"------这两件事都属于格式约束类,不是满档才做得对的那种活。
任务一:一段有格式约束的写作。 要求 250 字以内、讲清三件事、不列小标题、不分点、写成连贯三段、句子短、不堆形容词。
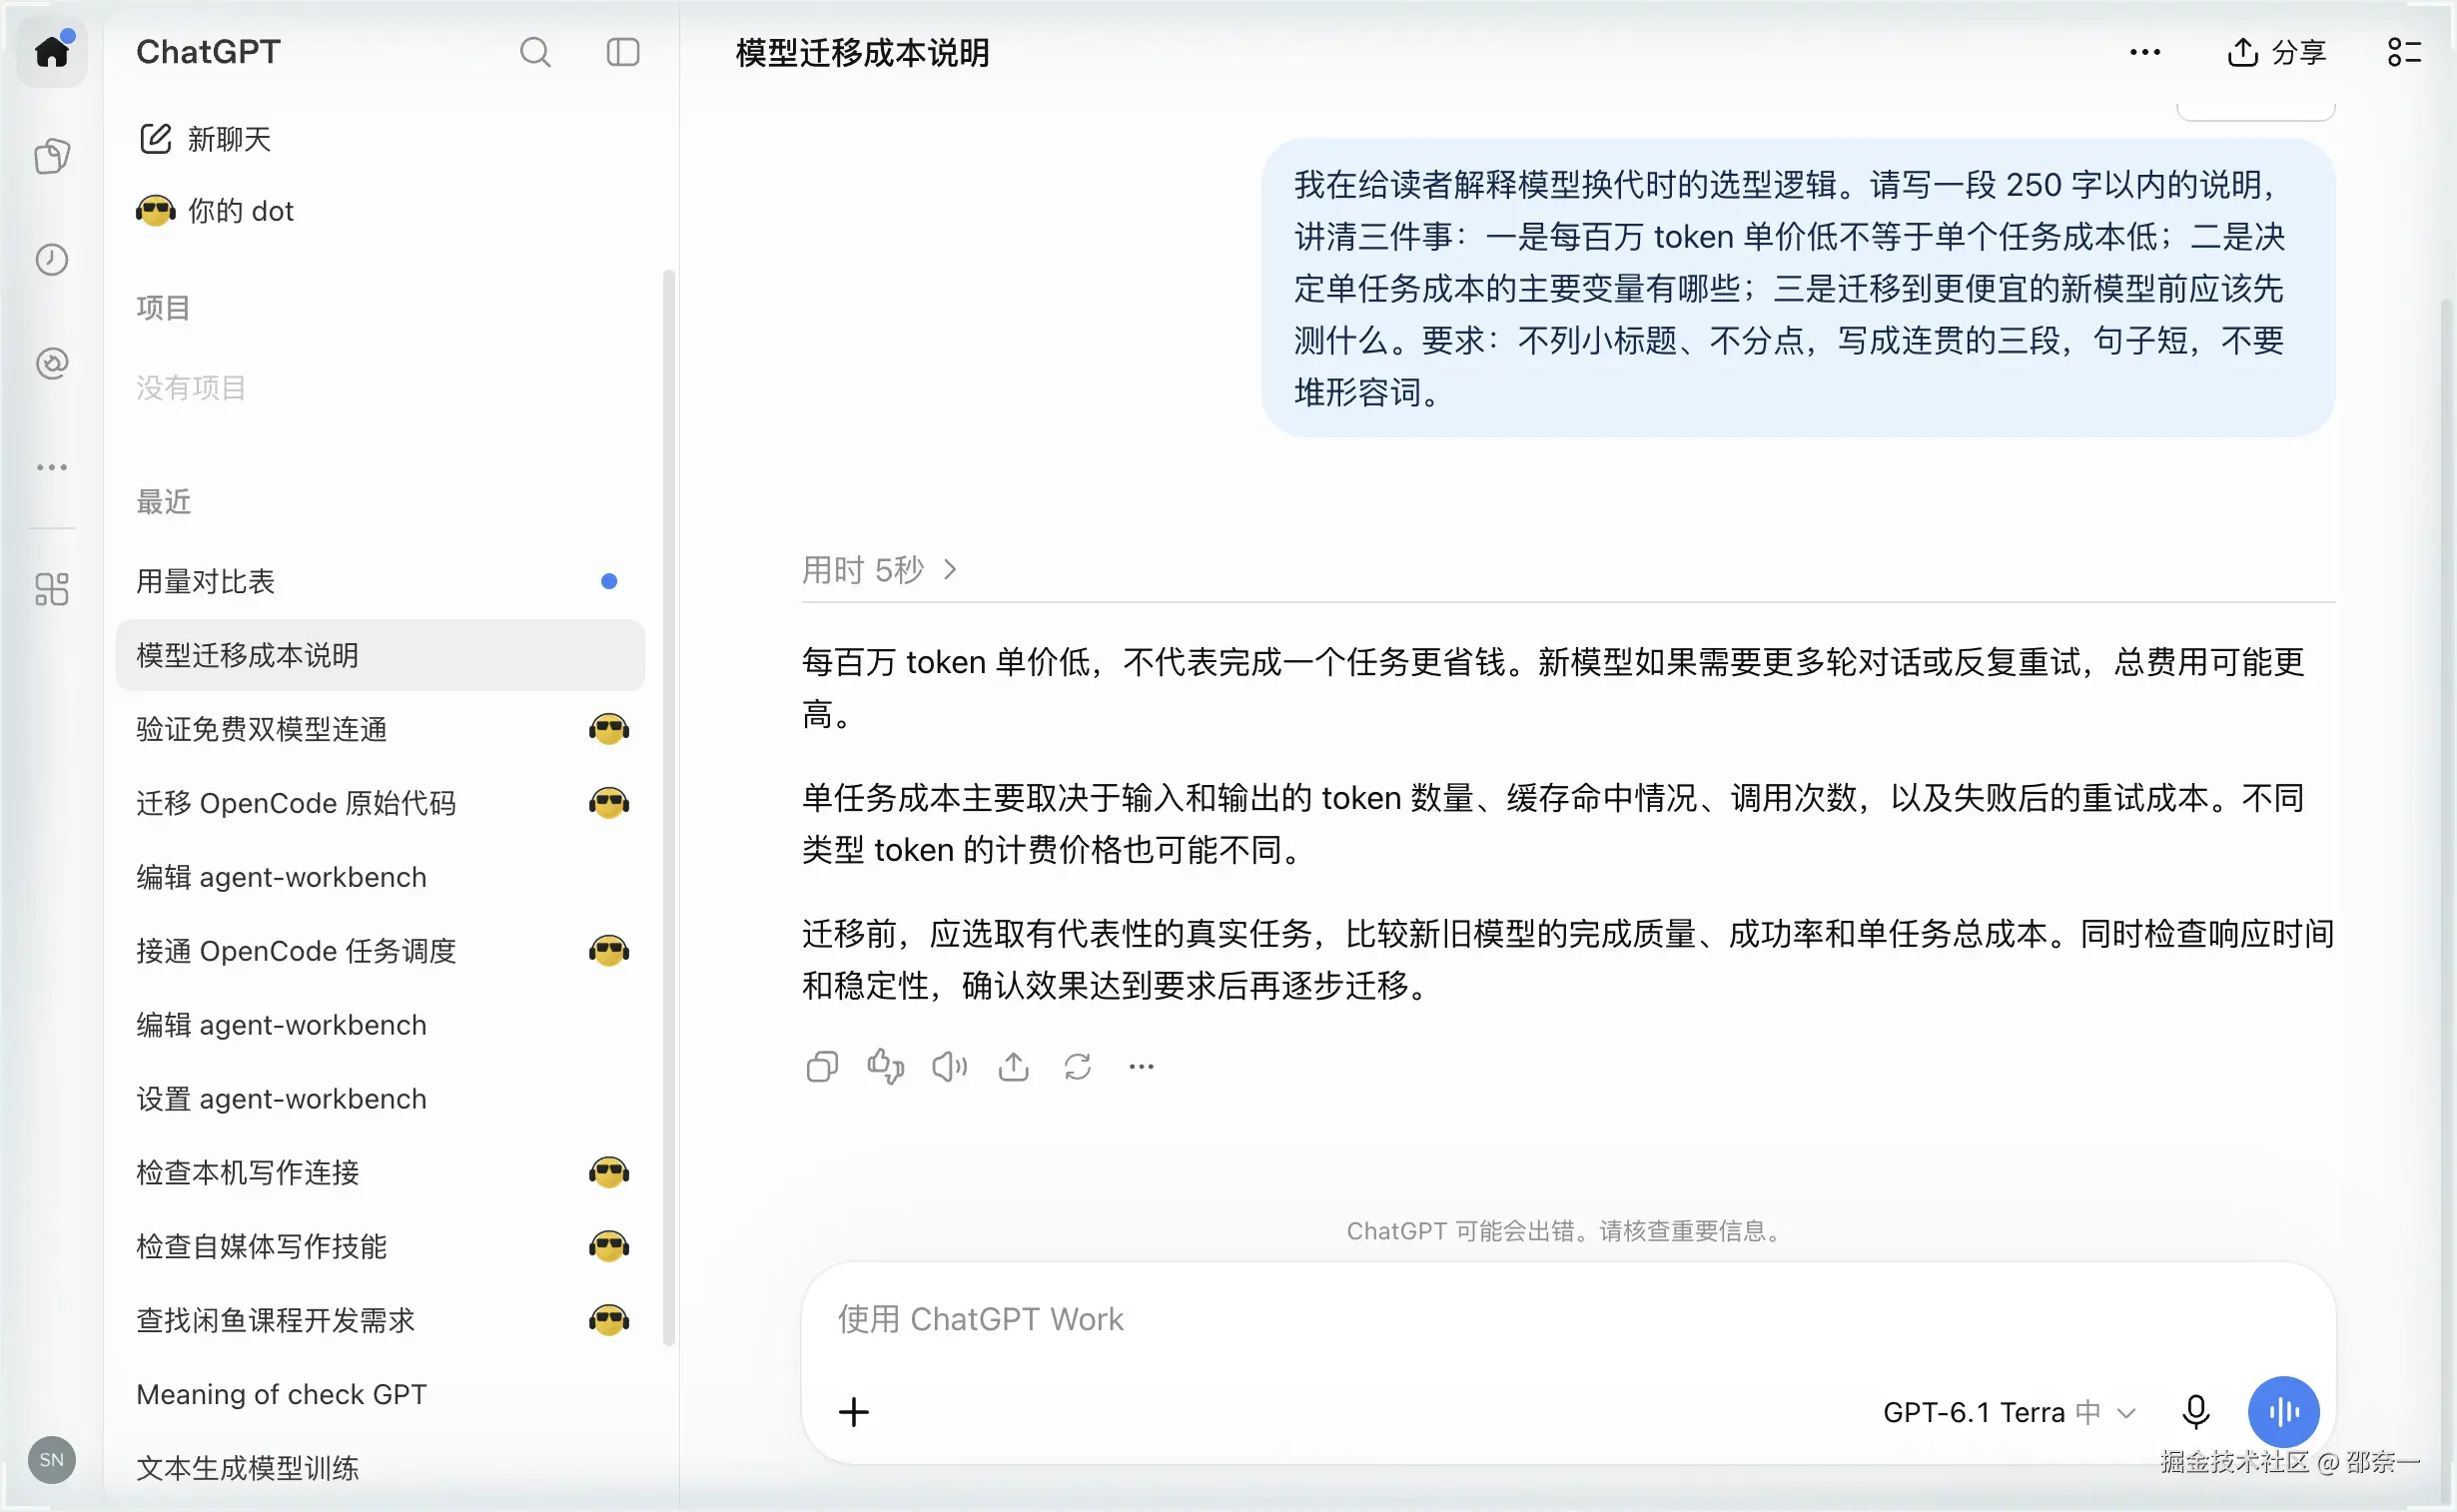
界面标注用时 5 秒。输出的格式约束一条没破:三段、没有小标题、没有分点、每句都短。内容也没跑偏------第一段讲单价低不等于单任务便宜,第二段列成本变量(输入输出 token、缓存命中、调用次数、失败重试),第三段给迁移前的验证动作(代表性任务、完成质量、成功率、单任务总成本、响应时间、稳定性)。
这种"格式约束 + 内容约束"双约束的任务,是检验模型有没有在认真读指令的好办法。约束越具体越容易露怯,它这次没露。
任务二:读一张截图并算数。 我把上面那张用量面板截图丢给它,要求只用一张三列表格输出,行是 token 总量、请求数、估算费用、单请求平均成本、生成速度,单请求成本保留两位小数,数字必须严格来自图里。
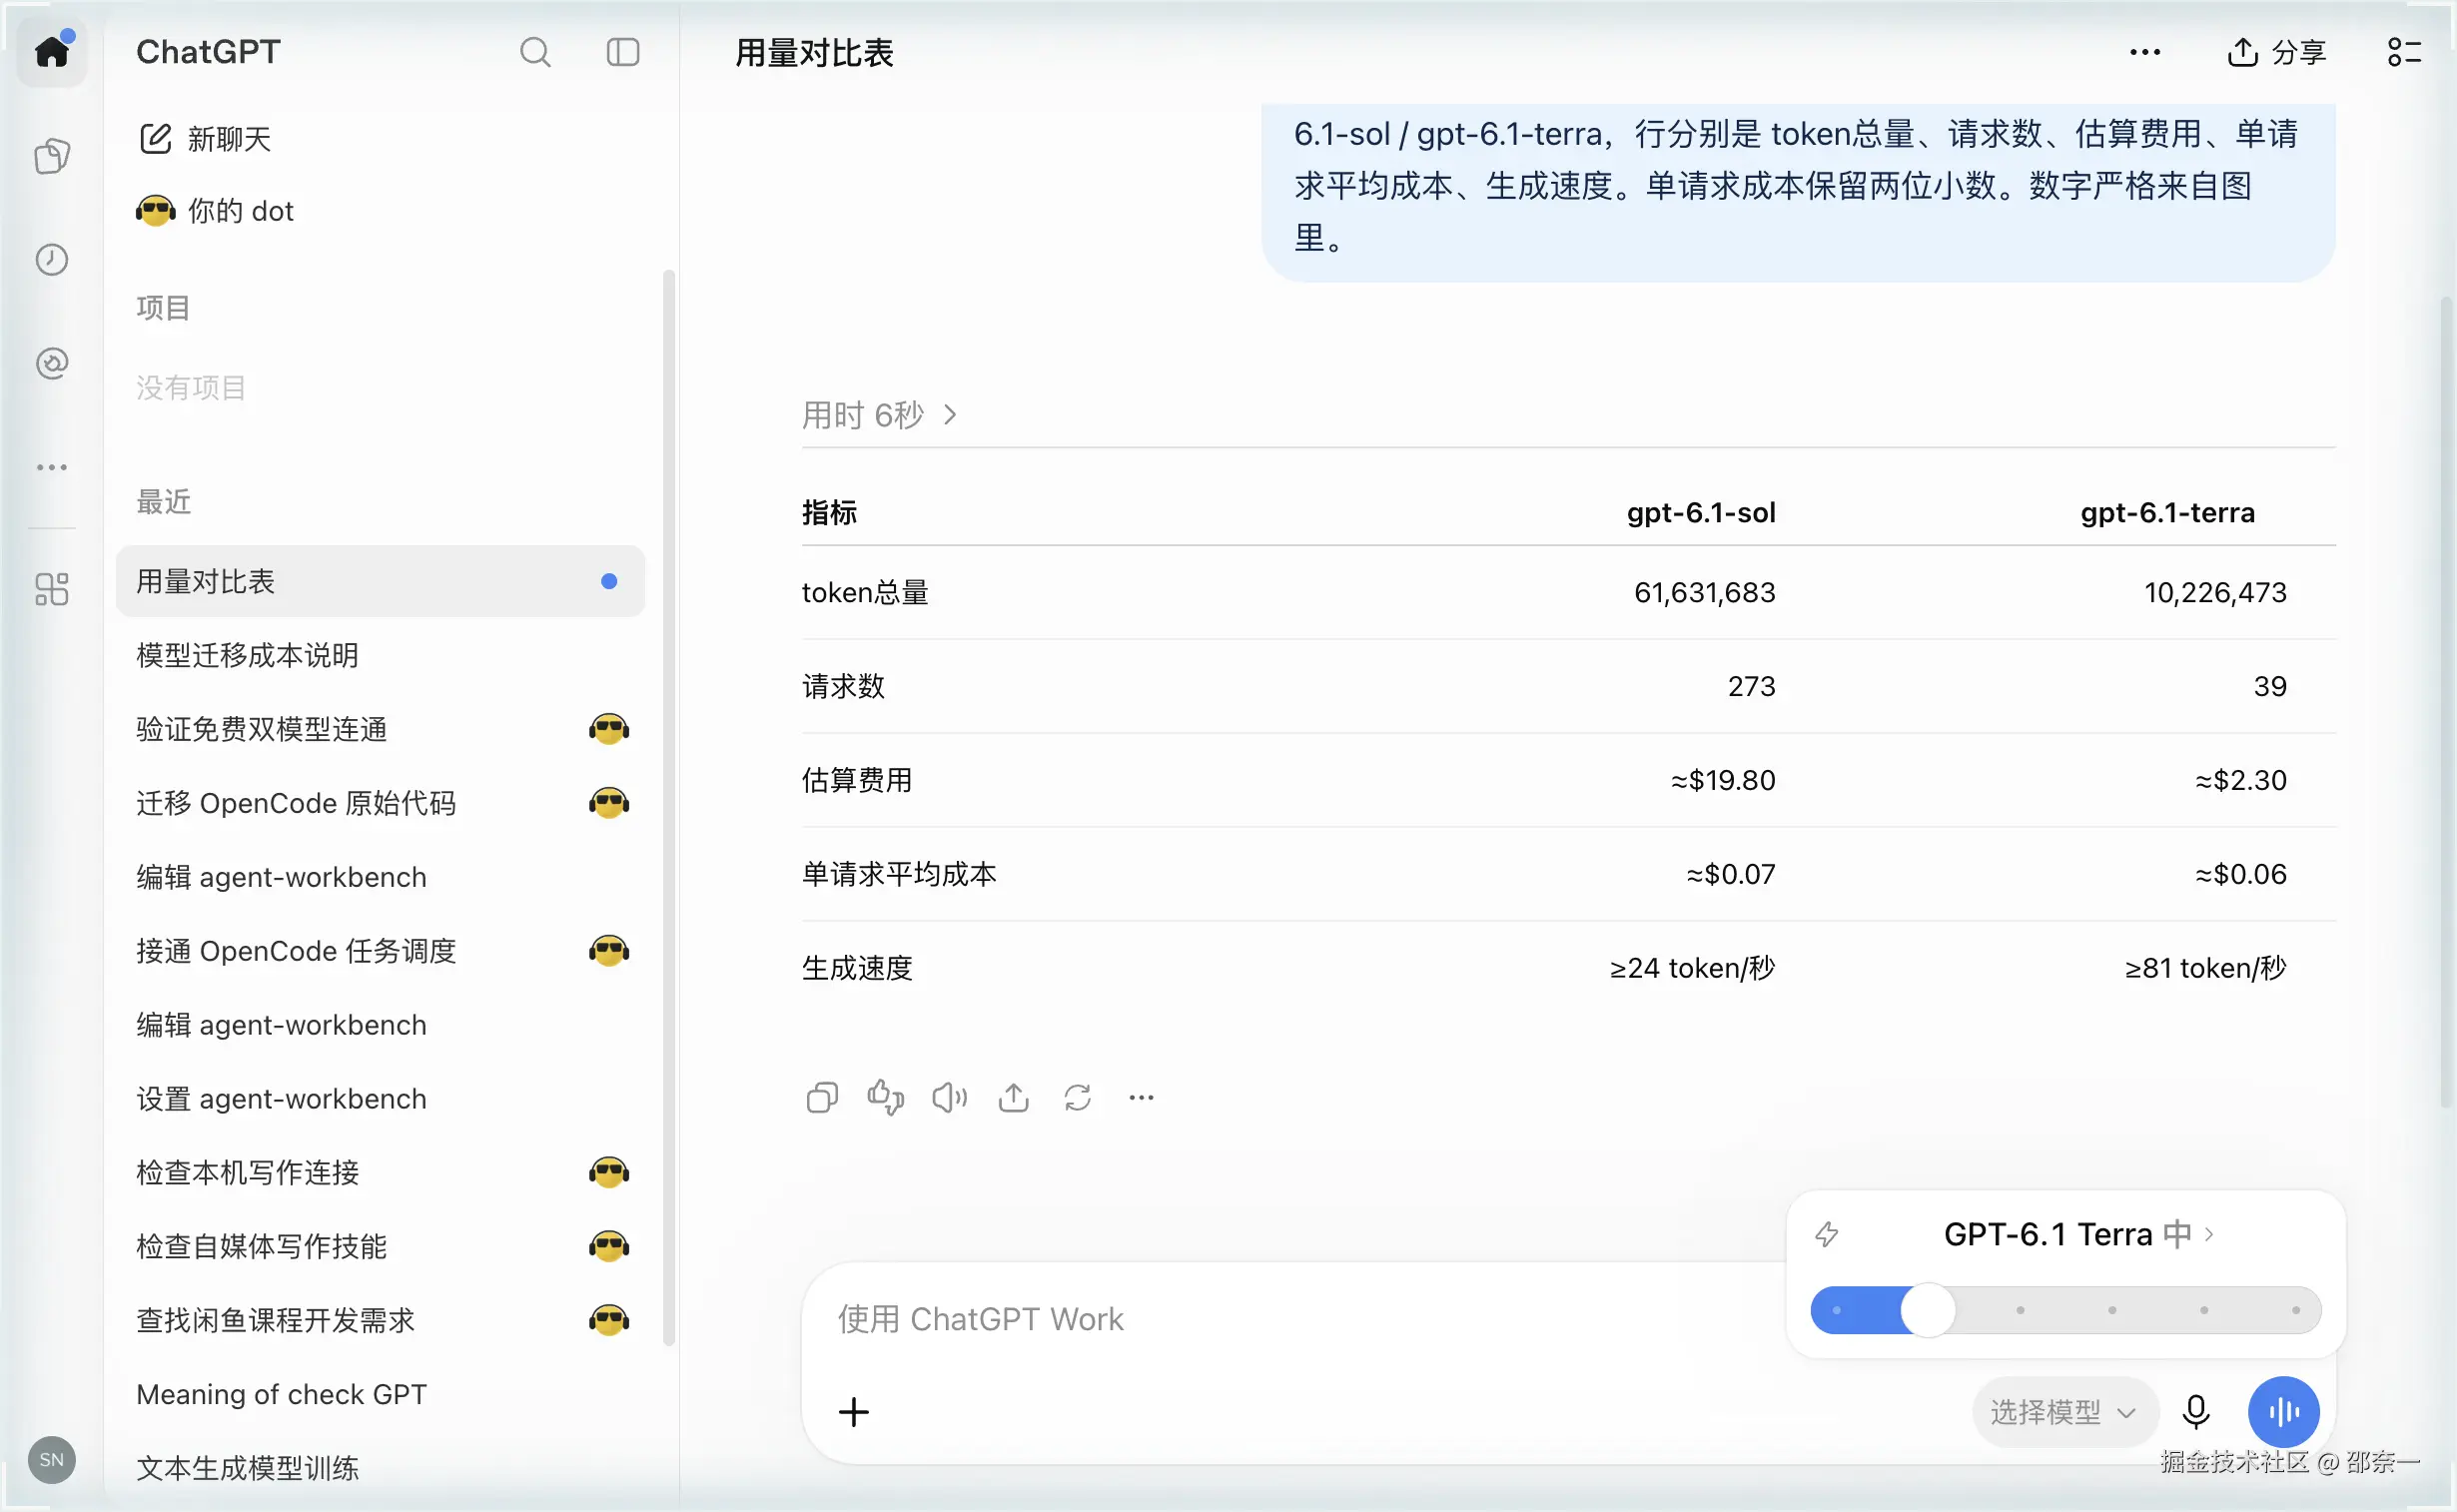
用时 6 秒 ,数字一个没错:61,631,683 / 10,226,473、273 / 39、≈ 19.80/≈2.30、≈ 0.07/≈0.06、≥24 / ≥81。两处除法(19.80 ÷ 273、2.30 ÷ 39)也都算对了,四舍五入到两位小数没有偏。
这个任务的价值在于它同时压了三件事:图像识别(把数字从截图里抠出来)、算术(两处除法)、格式遵循(就要一张三列表,不许发挥)。三件事任何一件掉链子,结果都对不上。
两个任务加起来 11 秒。这个速度意味着什么?意味着它可以被塞进交互流程里,而不是只能当后台批处理用。
但口径要说清:这两个都是简单任务加 medium 档。Artificial Analysis 测的完整回答中位耗时是 137 秒(max 档,含推理),首字 2 秒左右。复杂任务该等还是得等,快的是那类短平快的活。
0x06 三个必须提前知道的限制
限制一:默认档位只给你七成水平。
先看 Artificial Analysis 测出的六档成本曲线,这是全篇最该记住的一张表。
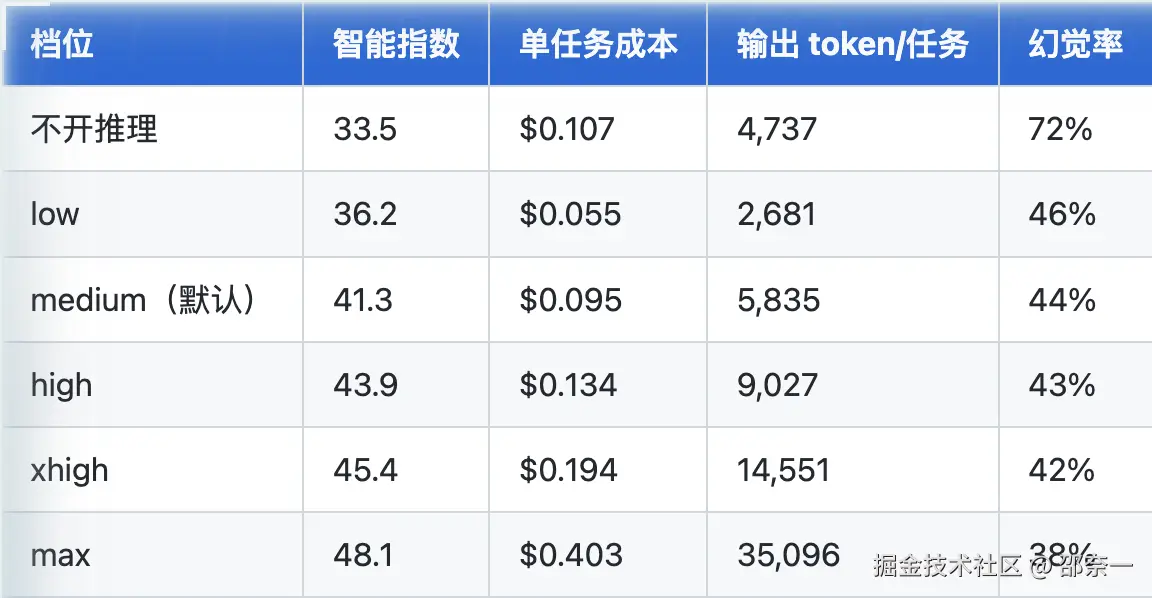
从 low 拉到 max,指数涨 11.9 分,成本涨到 7.3 倍( 0.403÷0.055)。最后一步尤其贵:xhigh 到 max 是 2.1 倍成本换 2.7 分。
所以建议要分场景:
- 修 bug、跑终端任务这种一次做对才值钱的活,拉到 max
- 批量处理、格式转换、日常写作这种错了能立刻看出来的活,留在 low 或 medium
按这张表算账,第二类留在低档最划算------AA 的判断是 low 和 medium 落在成本效率前沿上,在它测过的模型里没有谁比它更便宜又更好。
还有一条反直觉的:不开推理比 low 更贵( 0.107对0.055)。没有思考过程,模型会用更多输出 token 去凑答案,而输出按 $5 每百万计费。省了思考,没省账单。
按成本表算,结论应该是"日常留在 medium"。但我自己用下来,建议是反过来:只要决定用 Terra,默认就把档位拉到 Max。
理由不在 token 账上,在返工账上。低档位省下的那点钱,代价是一次没做对要重来。重试一次的开销往往比整段思考 token 贵得多,更何况你还要花时间判断它错在哪、该改哪一句。Max 档比它自己的 low 档贵七倍,但只要它让你少返工一次,这笔账就翻回来了。
所以我把上面那张表当成本参考,不当成默认配置。要出结果、要给人看、要当结论用的活,一律 Max。 只有那种错了立刻能看出来、重跑一次也不心疼的批量活,才降到 medium 跑量。这个取舍我在 0x07 里给了具体做法。
限制二:复杂编程仍然要交给 Sol 或 Astra。
这条是 OpenAI 自己在发布说明里写的,不是我下的判断:最难的那档编程任务,Sol 和 Astra 依然更强。Terra 的定位是"日常"和"重复",不是"最难"。
落到实际选型上,我的做法是分层:批量、重复、有明确验收标准的活交给 Terra;一次性的硬骨头、牵一发动全身的重构,还是给 Sol。
限制三:长上下文有加价悬崖,1.05M 不等于 1.05M 都一个价。
超过 272,000 输入 token 之后费率上浮。如果你的场景是整库代码、整本年报这种"一塞就是几十万 token"的用法,先算清楚落在悬崖哪一侧,再决定要不要走 Batch 通道(比标准价低 50%)。
还有一条不算限制但值得记一笔:它不支持微调。 想靠微调把某个垂直领域的表现拉上去,这条路走不通,只能靠提示词、检索和结构化输出。
0x07 谁该换、怎么换
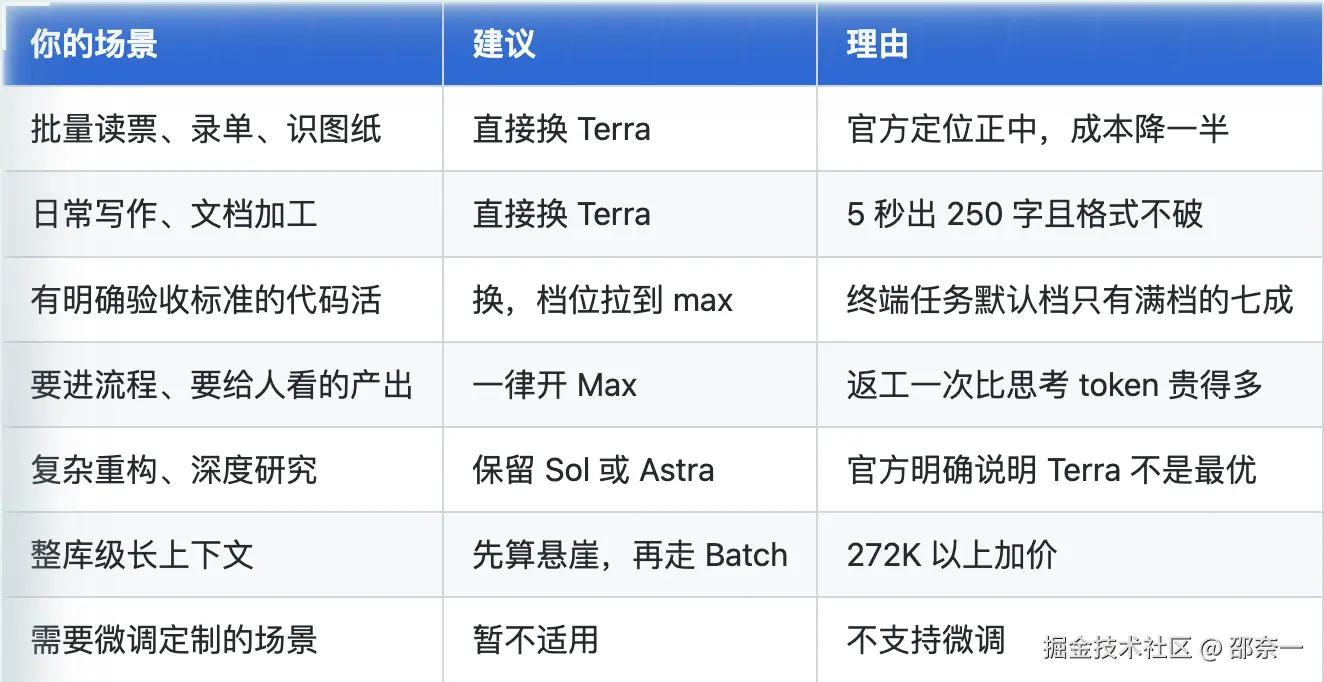
迁移动作我建议分三步走,别一次全切。
第一步,挑一个有代表性的真实任务,不挑最好跑的,挑最容易出事的那种,两个模型各跑五十次,把成功率、完成时间、单任务成本三项记下来。单任务成本要连失败重试一起算,只看单价会骗人。
第二步,先把档位拉到 Max 用一段时间,再考虑往下调。上来就用低档,你测到的是这个模型的下限,不是它的水平。等摸清了 Max 档的能力边界,再逐档往下试,看哪一档开始掉链子------这样定下来的档位是你自己的,不是别人表格算出来的。
第三步,按任务分流而不是按模型一刀切。能在 Terra 上跑出同样结果的就留在 Terra,跑不出来的自动落到 Sol。这套路由逻辑比"全面换模型"稳得多。
0xFF 总结
GPT-6.1 Terra 是一次很务实的发布:上下文没扩、参数没吹、定位没往上抬,就是把价格砍一半、速度提上去、错误率压下来。
从我这边的数据看,它兑现了承诺。速度是 Sol 的 3.4 倍,价格是一半,账单层面的差距更大。两个实机任务 5 秒和 6 秒完成,格式和算术都没出错。
但它是中间层,不是全能选手。档位选错要么白烧钱要么白丢分,最难的编程任务它接不住,长上下文过了 272K 要另算钱,微调这条路直接封死。
如果只记一条操作建议:既然决定用 Terra,就默认开 Max,别在档位上省钱。 比它自己的 low 档贵七倍,但满档单任务仍比 Sol 便宜 44%,省下来的是你返工和判断的时间。
所以换不换,取决于你要的是能力还是分数。要视觉推理、电脑操作、批量重复的活,换 Terra,档位开满。只要一个 48 分的通用水平,Sol 开中档更便宜。一次性的硬骨头、牵扯面大的重构、需要模型自己拿主意的判断,留给 Sol 满档或者 Astra。 中间那条模糊地带,拿五十次真实任务去测,别拿跑分表决定。
邵奈一 三百篇原创沉淀,十万+读者同行。感谢你的阅读,咱们下篇接着聊。