TL;DR :阿里 ATH-MaaS 团队 10 月 20 日挂出 OvisOCR3 技术报告:一个 0.8B 的统一 OCR 模型,单个模型吃下文档解析、通用 OCR、关键信息抽取(KIE)、文档图表描述、跨页表格重建五大任务族。成绩单:OmniDocBench v1.6 总分 96.74 (超 Gemini 3 Pro 的 92.91)、OCRBench v2 英文 65.9 / 中文 61.3 双榜第一、四个 KIE 基准全第一,拍照/退化文档场景掉分只有上代一半。权重已开源 (HuggingFace: ATH-MaaS/OvisOCR3),做 RAG 数据管道的可以直接本地部署。
想看原文?
- 📄 论文:arXiv 2610.33066
为什么「再加几个任务」不等于「统一 OCR」
做过多任务训练的都知道一个坑:把短答案任务和长文档任务混在一个训练集里,样本均衡了,loss 并不均衡。
OvisOCR3 团队把这组数字摆得很清楚:通用 OCR 在混合数据里占 22.8% 的样本 ,但只贡献 5.2% 的监督 token;KIE 更惨,16.1% 的样本只占 2.5% 的 token。原因很简单------一条 KIE 样本的答案可能就几个字段,而一篇整页解析的输出动辄几千 token。在「token 平均损失」下,长响应任务天然嗓门大,短任务直接被淹没。
这个洞察是整篇报告最有味道的部分,解法也直接:并行训练两个分支,一个按 token 归一化损失(长任务友好),一个按样本归一化(短任务友好),训练完把两边权重融合。经验上样本级损失在 OCR/KIE 这类短响应任务上明显更好。短任务按条数说话,长任务按 token 说话,最后各取所长。
四阶段配方:五个 4B 教师「合体」进一个 0.8B 学生
OvisOCR3 基于 Qwen3.5-0.8B,训练分四段:
- 续训预训练:约 7200 万样本(解析 57% / 通用 OCR 29%),视觉编码器、连接器、语言模型联合更新,五大任务打底。
- 域均衡 mid-training:约 880 万样本,各域 16--23%,配上面的双分支损失归一化 + 权重融合。
- 多教师在线蒸馏(MOPD) :为每个域训练一个 4B 教师(Qwen3.5-4B 初始化 + 域 SFT + 域 RL),共五个;学生自己先生成,教师在同一段生成前缀上逐 token 给监督。对比了 policy-gradient 和 top-K 两种蒸馏实现,top-K 胜出------多候选的相对偏好信号更利于小容量学生吸收「文字+结构协同生成」的知识。推理时教师全部退役,只剩 0.8B。
- 混合任务 RL(MixRL) :GRPO 框架下五个域用各自的奖励联合优化。奖励设计相当细:解析用编辑距离 + 表格 TEDS + 公式 CDM;定位任务用 IoU + 重复预测惩罚;KIE 有空字段误填、漏项、串位、超长四类惩罚;跨页表格最讲究------关系优先奖励:只有整组回答对了跨页关联,才有资格用 TEDS 按重建质量打分,否则只按关系对错给分。
这套「域专家教师 → 通用小学生」的蒸馏 + RL 组合,就是 0.8B 能打的关键。
成绩单:通用 VLM 和专用模型两头打
文档解析 (OmniDocBench v1.6,1651 页):OvisOCR3 总分 96.74,五项指标全部前二,表格 TEDS 95.16 / 表格结构 TEDS-S 97.46 双第一。对比:Gemini 3 Pro 92.91、GPT-5.2 86.59、Qwen3.8-Max 93.70;专用模型里 PaddleOCR-VL-1.6 96.34、同尺寸最强对手 Xiaomi-OCR-0 96.83(互有胜负,这榜基本咬死)。
拍照/退化文档 (PureDocBench,含 Clean/Digital/Real 三轨道):这是最接近真实落地的战场,OvisOCR3 82.31 三轨道全第一 ,超过 Qwen3.8-Max(80.56)。更说明问题的是掉分幅度:从 Clean 到 Real,OvisOCR3 只掉 7.84 分,上代 OvisOCR2 掉 15.04------鲁棒性实打实翻倍。专用模型第二名 MinerU2.5-Pro 只有 70.07,被拉开 12 分。
通用 OCR (OCRBench / OCRBench v2):88.8 / 65.9(英)/ 61.3(中)三榜第一;v2 英文榜比参数量 5 倍的 Qwen3.5-4B 高 11.8 分。弱项也不藏:数学计算(英文)只有 34.6,中文元素解析 47.9------手写公式和密集中文版面仍是短板。
KIE:四个基准全第一(OCRBench-KIE 90.50、v2-KIE 83.01、CC-OCR 88.69、自建 KIE Bench 77.73),对最强基线最大领先 9.5 分。
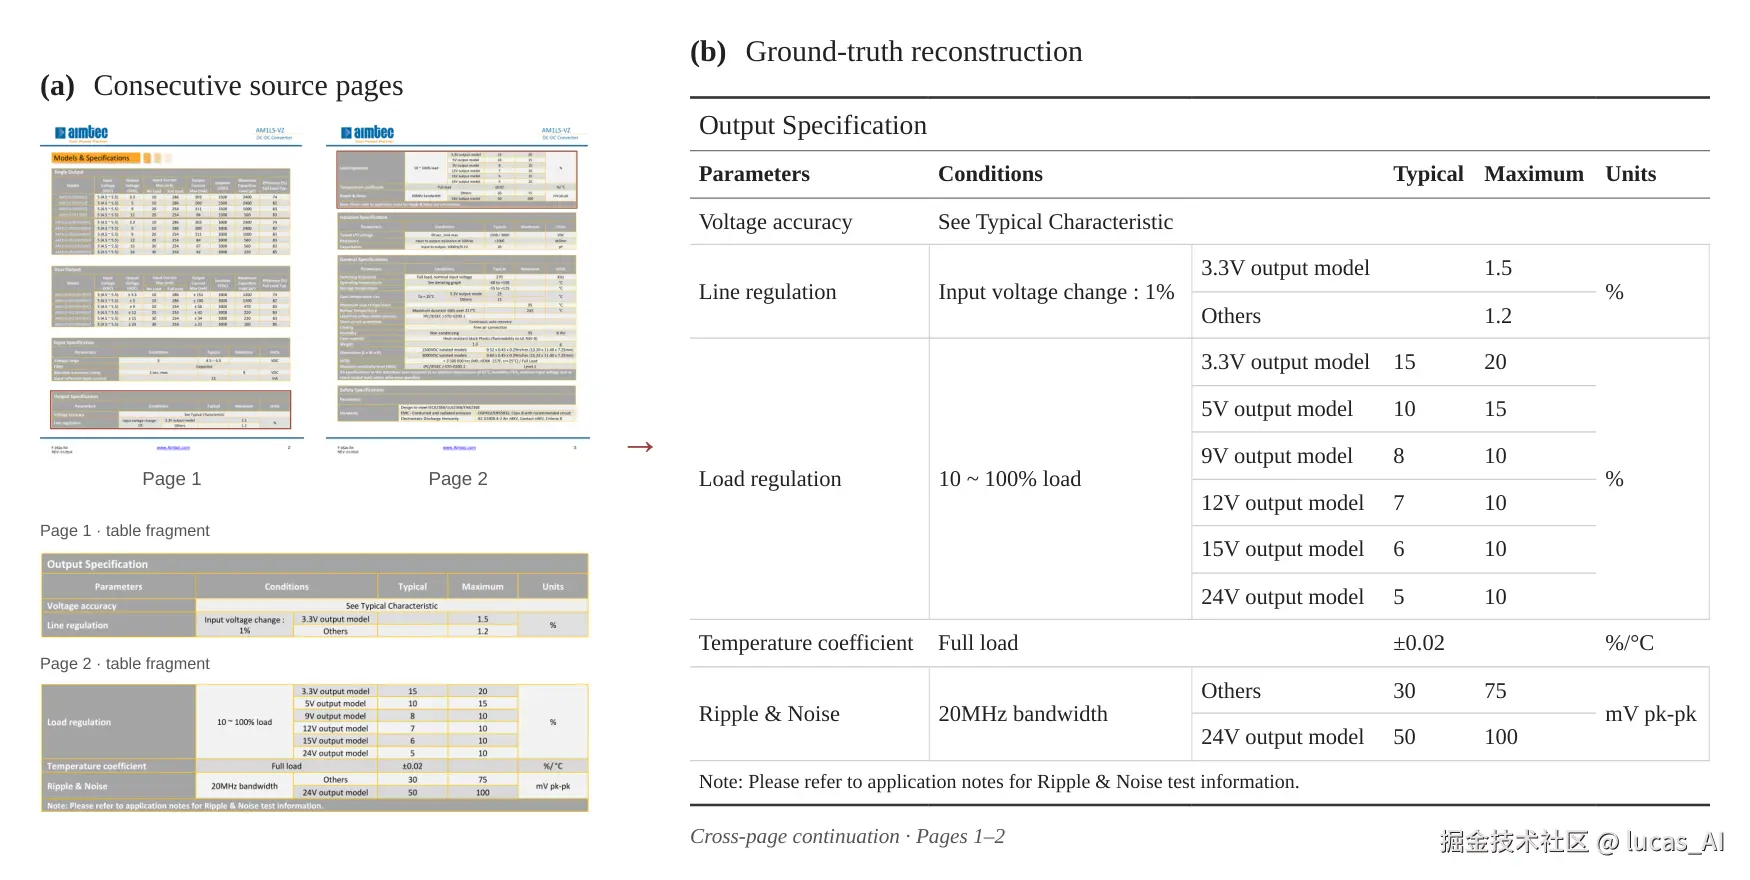
跨页表格:CrossTabBench 关系 F1、MPDocBench-Parse 截断表 TEDS 均领先------多页表格先判「续不续」再重建的范式被验证有效。
冷静看:宣传口径之外的三点
- ⚠️ 两个自建基准(KIE Bench、DocFigCapBench)是主场作战;「图表描述接近 Qwen3.8-Max」这类说法依赖自建基准的度量选择。好在公开基准的领先独立成立,核心结论不靠它们。
- ⚠️ 部分基线分数引自官方 leaderboard 而非本地复测(论文用 † 标注了本地复测项),跨报告协议对齐做得认真但无法根除噪声。
- ⚠️ 四阶段配方没有阶段级消融------蒸馏贡献多少、RL 贡献多少分不出来;训练成本(5 个 4B 教师的算力账)也未披露。
和你有什么关系?
如果你在搭 RAG 管道或数据清洗流水线:0.8B 意味着单卡能跑、可私有化,解析质量已超过一票 3B 级专用模型和 235B 级通用 VLM,直接去 HuggingFace 拉权重试。如果你在做多任务小模型:§3.2 的「双归一化分支 + 权重融合」和「关系优先奖励」都是可以搬走的模式。一句话总结这份报告:OCR 这场仗,拼的已经不是模型大小,而是训练配方。