从一家酒店讲懂Docker
0. 导读:为什么用酒店来比喻
很多 Docker 教程会让你"更快地晕掉":上来就是 namespace、cgroup、OverlayFS、容器运行时,每个词都认识,连起来不知道在说什么。
原因在于:这些概念都长在 Linux 内核里,而很多人对 Linux 本身只有"敲过几条命令"的经验。本文反其道而行------先用一章搭好 Linux 地基(酒店模型),再把 Docker 的所有概念一个个"译"回这个模型。
先宣布全文贯穿的那个比喻,后面会反复用到:
一台 Linux 机器 = 一家酒店。
- 内核 = 酒店唯一的后台总管团队(管水电、仓库、门禁、电话总机)
- 用户程序(进程) = 入住客人(nginx、MySQL、你的 Java 服务、甚至 docker 自己,全是客人)
- 系统调用 = 客人给前台打的电话(客人永远不能自己进配电房,一切需求打电话)
- 容器 = 办了三样"特殊服务"的普通客人:专属楼层 (只能看到自己)、消费限额账本 、一套样板间外观
- Docker = 长驻酒店的金牌代办(它自己也是普通客人,专门替你跑腿办理上述特殊服务)
- 镜像 = 一车自带家具的行李包------唯独不带"总管团队",入住哪家酒店就归哪家总管管
记住这七行,全文的每一次推导,最终都会落回它们。
1. 地基:一台 Linux 就是一家酒店
1.1 三层世界:硬件、内核、用户程序
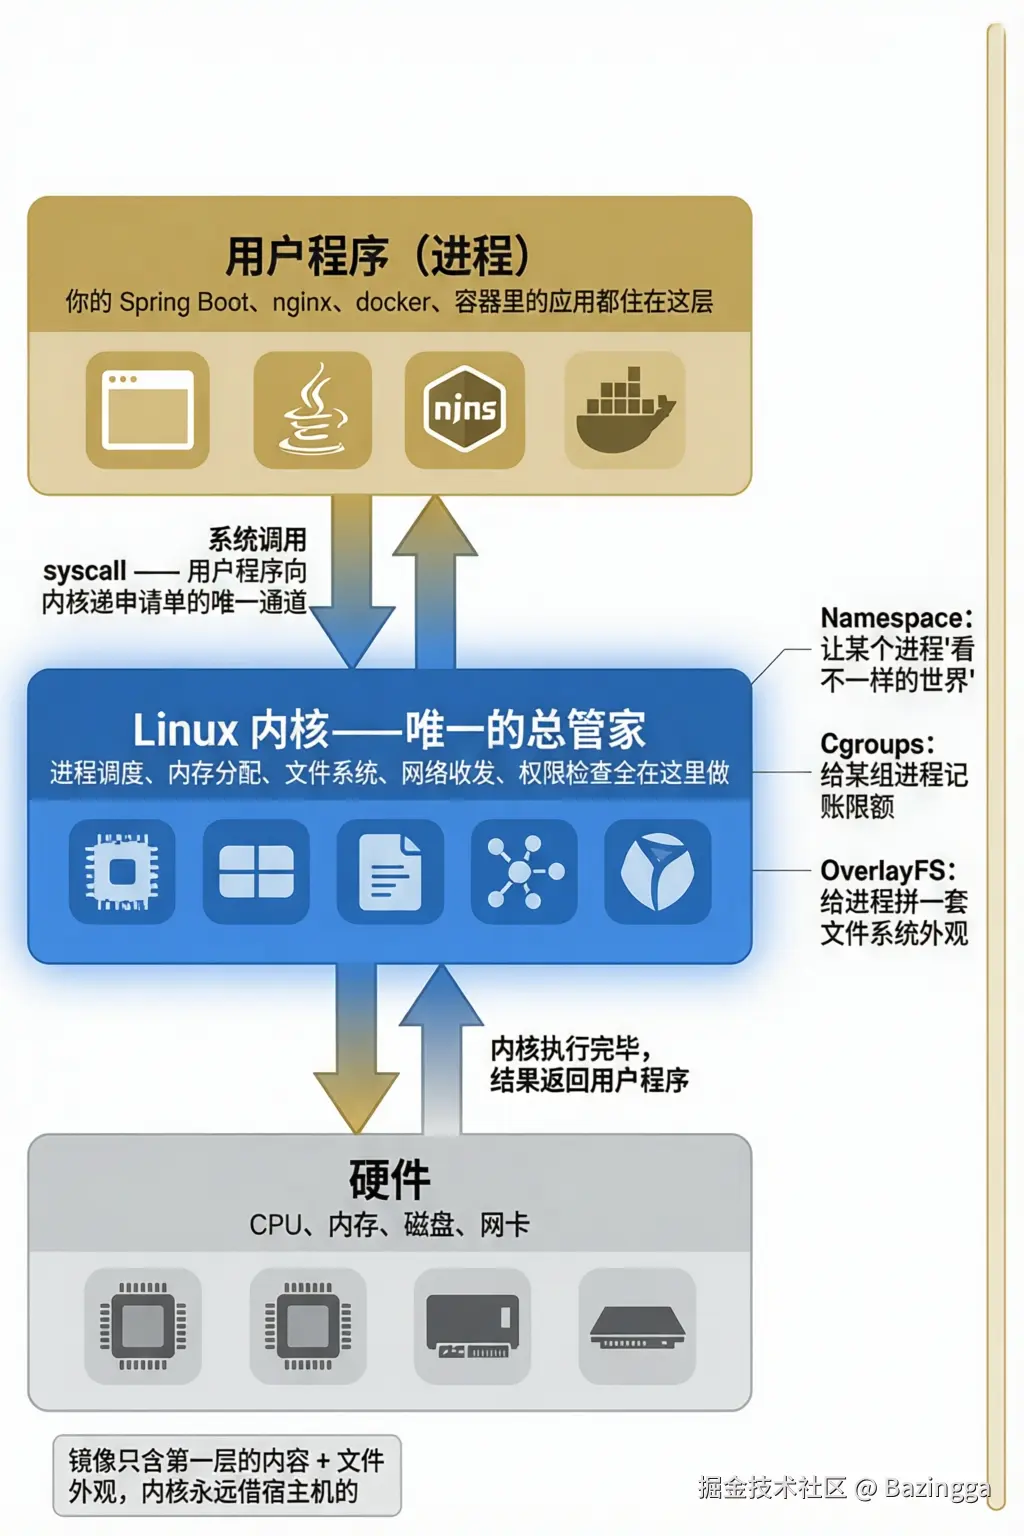
把一台 Linux 机器竖着切成三层:
最底层是硬件 (CPU、内存、磁盘、网卡)------酒店的实体。谁都不能直接碰它,拉闸断电不是客人的事。
中间层是 Linux 内核------酒店唯一的管理团队。它有且只有它有权操作硬件。它管五件事:进程调度(谁先用电梯)、内存分配(房间怎么分)、文件系统(仓库货架)、网络收发(电话总机)、权限检查(房卡验证)。
最上层是用户程序 ------所有入住客人。你平时说的"软件"------浏览器、nginx、MySQL、你的 Spring Boot 服务、甚至 docker 命令本身------全是客人,没有例外。
两层之间只有一条通道:系统调用(syscall)。客人想要任何东西------读个文件、发个网络包、开个新进程------都必须打电话给前台,由内核去办。
为什么这一点如此重要? 因为这是理解容器一切的前提:客人永远不是酒店,客人永远归酒店管。
1.2 内核与 CPU 核心:手册与工人
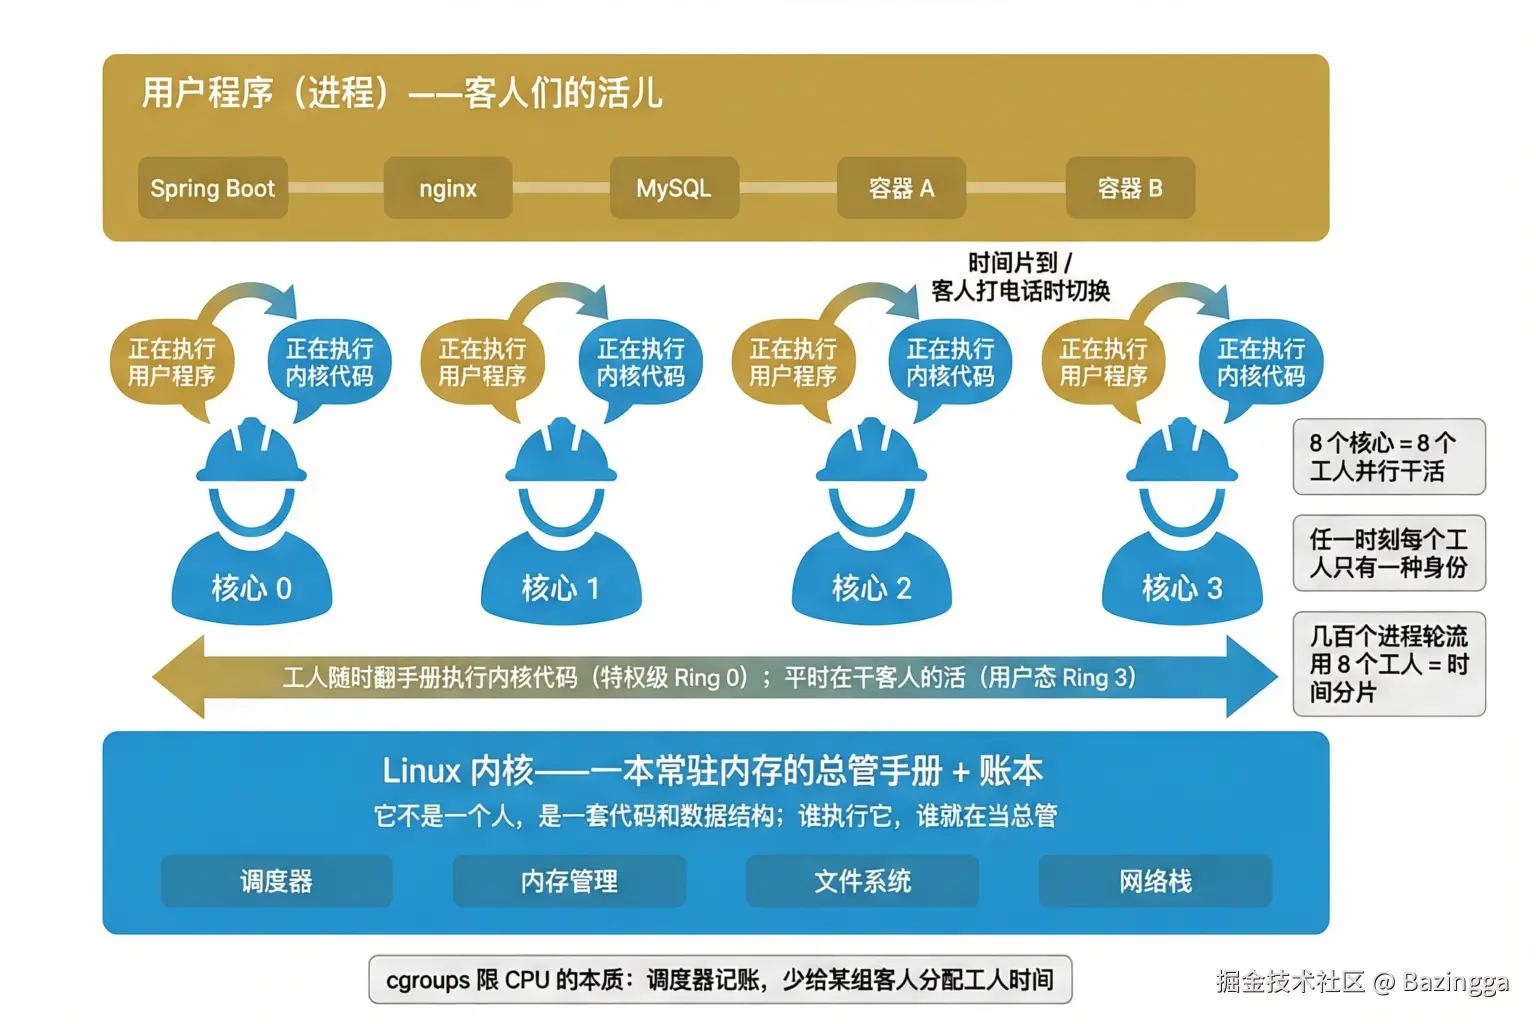
初学 Linux 最常见的误会:"内核是个一直在后台运行的神秘程序,CPU 核心是它手下干活的"。错了一半。
内核是软件,CPU 核心是硬件。内核自己一步都跑不了------它的每条指令,最终都必须由某个 CPU 核心执行。
准确的模型:
- 内核 = 一本常驻内存的《总管手册》+ 一套账本(代码 + 数据结构),不是一群"人";
- CPU 核心 = 真正的工人。4 核机器 = 4 个工人;
- 任一时刻,每个工人只有一种身份:要么在干客人的活(用户态 ,帮你算订单、拼 JSON),要么在翻手册执行内核代码(内核态,分配内存、转发网络包);
- 身份切换的时机:客人打电话(系统调用)、闹钟响(时钟中断)、门铃响(硬件中断)。
于是那句著名的话有了精确含义:"内核在运行"= 此刻某些工人正在执行内核代码。当工人翻到手册的"调度器"一章时,他自己就在当总管,决定接下来换谁上工。几百个进程共享 8 个工人,靠的就是工人们以毫秒级轮换手上的活------轮换快到你以为所有程序"同时在跑"。
这个模型马上要派大用场:后面讲 cgroups 限 CPU 时你会看到,所谓"给容器限 1 个核"不是分走一个工人,而是调度器在账本上给这组客人记工时限额------超了就不给排工。
1.3 文件系统:一棵树、挂载与两场"骗局"
Linux 没有 C 盘 D 盘。 整个磁盘上的所有东西,长在一棵从 /(根目录)出发的树里:
arduino
/
├── bin/     ← 谁都能用的基础命令
├── lib/     ← 公共依赖库(比如 glibc,客人们共用的工具箱)
├── etc/     ← 全酒店配置文件(nginx.conf、hosts 都在这)
├── home/    ← 各客人的私人储物柜
├── var/     ← 运行时产生的杂物(日志、缓存)
├── proc/    ← ★ 一场"骗局",下面单独讲
└── sys/     ← ★ 另一场"骗局"
"挂载(mount)"------接枝,不是拷贝。 酒店仓库有几个货架区(多块磁盘/U 盘)。总管做一次"挂载":把 2 号货架的内容整棵接到树上 /var 这个枝头。此后你逛到 /var 看到的仿佛是天然长在那的东西,实际是另一块盘上接 过来的。要点:数据原地不动,一个字节都不复制 ;U 盘一拔,挂载点瞬间枯萎。牢记这对概念:拷贝 = 数据搬家;挂载 = 换个门牌看同一堆数据。(后面 OverlayFS 靠它理解。)
/proc------一场"伪装成文件的表演"。 内核把自己的账本伪装成文件放在 /proc 下:你想查 PID 12345 的进程信息,不用任何 API,直接 cat /proc/12345/status------内核现场编出 这份"文件"递给你,上一毫秒它还不存在。磁盘上一个字节都不占。理解成:走廊尽头的活页台账,翻开自动浮现实时状态。/sys 同理 ,cgroups 的配置"文件"就在 /sys/fs/cgroup/ 里------所以"写一个文件 = 下达一条配置",这就是后面 cgroups 没有专用 API、全靠读写文件管理的根本原因。
1.4 root:持有万能房卡的特殊客人
每个进程(客人)都持有一张身份卡:一个数字,叫 UID 。UID 0 = root,万能房卡:进任何房间、改任何配置、杀任何进程。
关键认知:权限检查发生在每一次系统调用上------不是文件"长腿挡你",而是你打电话要开门时,内核先验你的房卡够不够格。
后文第 7 章你会看到,这张"万能房卡"其实可以被拆成几十张子卡(capability)------"容器里的 root 为什么缺胳膊少腿",答案就藏在这个拆分里。
1.5 动手热身:三行命令看一眼你的 Linux
以下命令请在 Linux 服务器 (或 Docker Desktop 里随便一个容器)里执行;macOS 用户直接
docker run -it alpine sh进去看也是一样的世界。
bash
# 第一眼:你的"总管团队"是谁(内核版本)
uname -r                    # 例:5.15.0-91-generic

# 第二眼:有哪些"客人"在(进程表)
ps -e -f | head            # PID 1 是 systemd/init,后面全是客人

# 第三眼:那棵"目录树"长什么样
ls /                       # bin、lib、etc、proc、sys......对上了吗?
cat /proc/self/status | head -3   # 看一眼自己的"活页台账"
三行命令看到的东西,就是 1.1~1.3 的全部实体。后面每章的动手环节,都是在这里验证刚学的理论。
2. 容器是什么:被三件套包裹的普通进程
2.1 暴力起点:没有 Docker 的世界
先忘记 Docker 这个词。在 Linux 上裸跑一个进程,它天生长在四种"共享"里:
- 它看到的文件系统 = 整台机器的文件系统 (
/etc、/usr大家共用); - 它看到的进程表 = 整台机器的进程表 (
ps能看到所有进程); - 它能用的资源 = 没人拦它(一个失控进程能吃光 128G 内存);
- 它的网络 = 直插宿主机网卡(大家抢同一个 8080 端口)。
"在我机器上能跑"的全部悲剧------环境不一致、依赖冲突、端口打架------根源就是这四条。而打断这四条,不需要任何虚拟化技术:Linux 内核自己就提供了三件原生工具。
2.2 Namespace:换一副眼睛
内核允许一个进程在创建时,换一副"眼睛"------传几个参数,内核就给它一套全新的"视图":
arduino
新 PID 视图   → 它成了自己世界里的 PID 1,看不到别人的进程
新网络视图    → 它看到一块崭新的空网卡,而不是宿主机 eth0
新挂载视图    → 它有自己的挂载点表,可以被"关"进一个目录里
新主机名视图  → 它可以有自己的 hostname
这就是 namespace 。要点只有一句:namespace 隔离的不是资源,而是"看得见什么" 。宿主机视角里它还是那个普通进程,ps aux 看得清清楚楚------只是它自己看不见别人。
不用 Docker 就能验证------Linux 上一条命令手工造半个"容器":
bash
# 新 PID 空间 + 新挂载空间 + 新 hostname,然后跑个 shell
unshare --pid --fork --mount-proc -u sh
2.3 Cgroups:记账员与限额器
namespace 管"看不见",管不住"吃太多"。cgroups 是内核的另一套机制:把一批进程放进一个组,给这个组记账、上锁:
ini
memory.max = 512M        → 组内所有进程合计最多 512M,超了触发 OOM 杀进程
cpu.max    = 100000/100000 → 每 100ms 窗口内最多累计用 100ms CPU 时间(=1 个核)
三个容易踩的误解,一次说清:
- cgroups 不是"资源调度",是"记账 + 限额"。调度(谁上哪个核心)是调度器的活;cgroups 只管"这组客人的配额是多少、超了怎么办"。
- cgroups 一个字节磁盘都不分 。"容器最多占 10G 磁盘"这种事不归它管(那是存储的事);它管 CPU 工时、内存额度、磁盘 IO 流速------注意是流速不是容量。
- 接口形态就是 1.3 说的"假文件":
echo 512M > /sys/fs/cgroup/xxx/memory.max就是全部 API,任何语言都不需要 SDK。
2.4 OverlayFS:拼房术
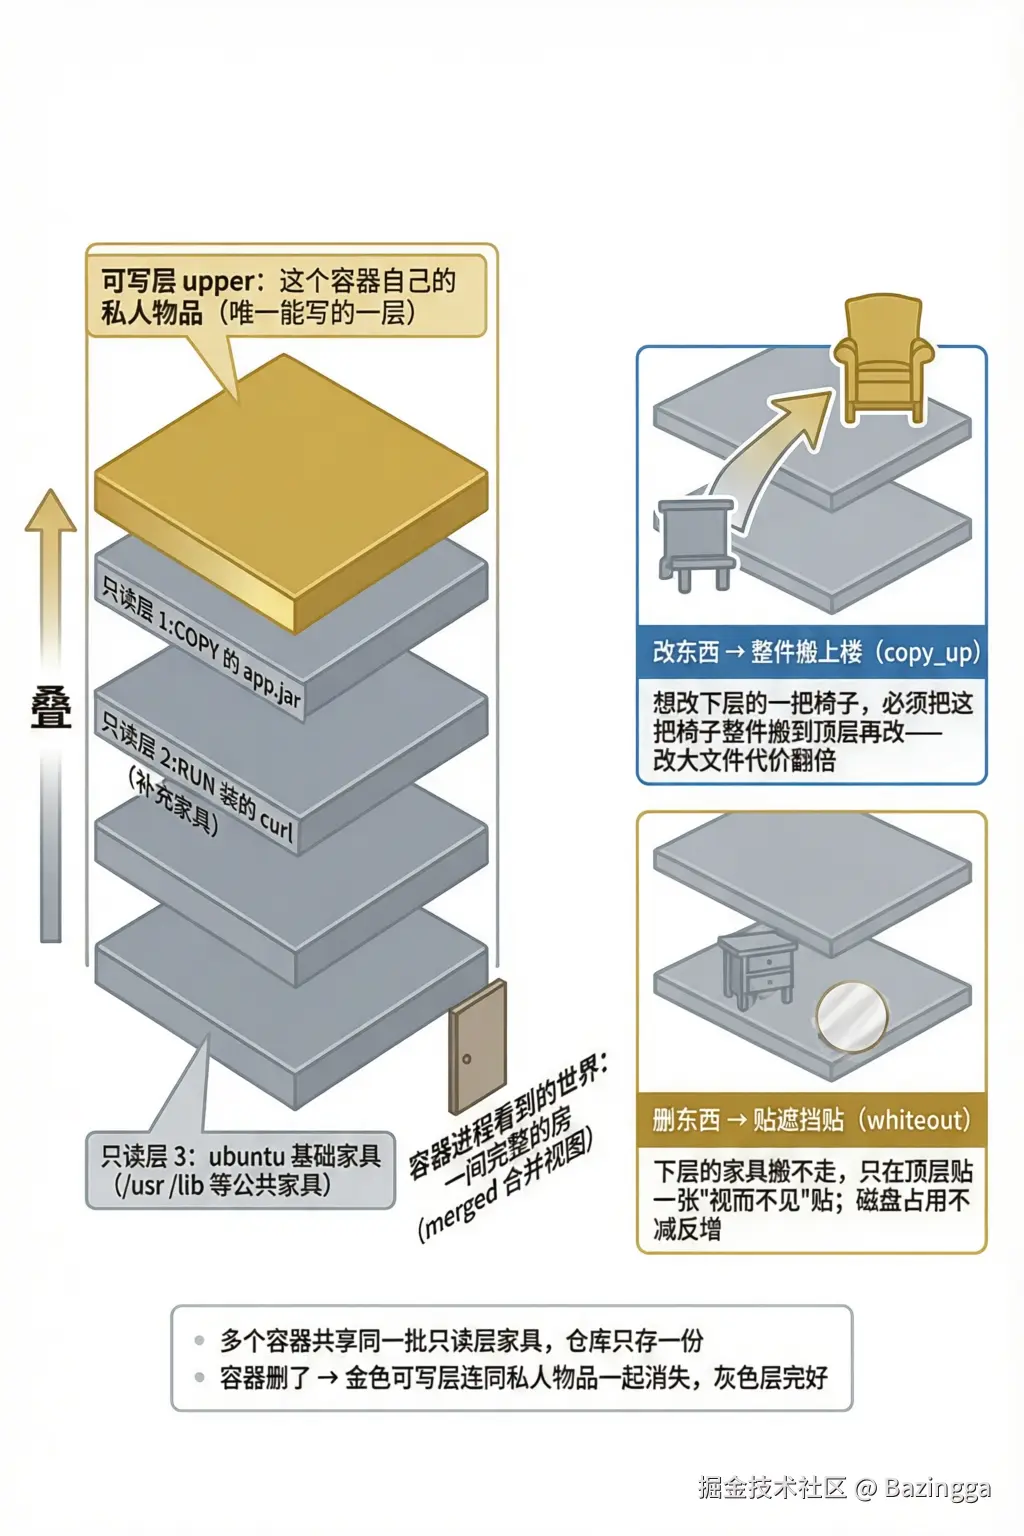
被关进 namespace 的进程,推开窗得看到一套完整的世界 (有 /usr、/bin、/lib),不然 nginx 连启动都做不到。最笨的办法:每个容器复制一整套 Linux 系统文件------一百个容器复制一百份(这就是虚拟机镜像 GB 级的根源)。
OverlayFS 的聪明方案(看图左侧那栋剖面):家具不复制,叠着共享。
- 镜像只读层 = 搬家公司的标准家具包,所有同镜像容器共用一份实物;
- 可写层 = 这个容器自己的私人物品,唯一能动手的一层;
- 两者叠成一个 merged 合并视图,再用 1.3 学的"挂载"接到宿主机目录树上------容器进程看到的就是这间拼出来的完整房间。
由此两条规则(图右侧两张卡):
- 改东西 → 整件搬上楼(copy_up) :想改下层公共家具?先把整件 搬到可写层再改。镜像里一个 100M 大文件,容器里只追加一行,磁盘瞬间多出 100M。推论:频繁写的数据(数据库、日志)必须挂 volume,不要写在容器可写层。
- 删东西 → 贴遮挡贴(whiteout) :公共家具删不得(别的容器还在用),只能在可写层贴一张"视而不见"贴纸。所以容器里删文件,磁盘占用不减反增。
2.5 三个立刻成立的推论
① 为什么容器秒级启动? 因为根本没有"启动"什么------创建一个容器就是 clone() 出一个进程,和 fork() 一样快。虚拟机的分钟级耗时花在引导完整内核上;容器没有内核要引导。
② 为什么容器隔离弱于虚拟机? 所有容器共享同一个内核。内核出漏洞,容器逃逸就可能在宿主机执行代码。这是容器安全边界的根本所在(第 7 章展开)。
③ 为什么 Mac 上跑容器要先起一个 Linux 虚拟机? macOS 内核不是 Linux,没有 namespace/cgroups 这些"服务项目"。所以 Docker Desktop 在 Mac 上先起一台 Linux 轻量虚拟机,你的容器全住在那台 VM 里------容器里 uname -r 看到的 Linux 版本号就是这么来的。
这一章的全部结论浓缩成一句话:容器的隔离能力 100% 由 Linux 内核提供(Namespace 管看得见什么、Cgroups 管记账限额、OverlayFS 管文件系统外观);镜像是"缺了内核的电脑",运行时永远借用宿主机的内核。
2.6 动手:亲手造一个半成品容器
实验 1:容器内外的 PID 是两本账。
bash
docker run -it --name test busybox sh
# 容器里:
ps              # 你是 PID 1!整个世界只有你和 ps
# 开另一个终端,宿主机(或 Docker Desktop 里进 VM)上:
docker inspect test | grep -i pid    # 找到宿主机视角的真实 PID,如 12345
ps -ef | grep 12345                  # 宿主机看得见它,它就是普通进程
同一个进程两本账:容器内叫 1 号,宿主机叫 12345------"隔离的是视角,不是存在"。
实验 2:不用 Docker,内核原生的半成品容器(仅 Linux)。
bash
# unshare = 把自己搬进新的 namespace:新 PID 空间 + 新挂载表 + 新主机名
unshare --pid --fork --mount-proc -u sh
hostname my-mini-container
ps                 # 又是 PID 1
实验 3:cgroups 账本就在 /sys 下。
bash
docker run -d --memory=512m --cpus=1 --name limited nginx
# 宿主机上找到它的 cgroup 目录(Linux;Docker Desktop 需先进 VM),验证限额真实存在:
cat /sys/fs/cgroup/system.slice/docker-*/memory.max   # 536870912 = 512M
实验 4:秒级启动是真的。
bash
time docker run --rm hello-world   # 全程零点几秒
# 对照:任何一台虚拟机从开机到可用,都是分钟级
3. Docker 是什么:三件套与一张行业地图
3.1 最容易混淆的三个角色
"docker 是一个进程""docker 被隔离在容器里"------这类说法错得五花八门,因为它们把三个东西搅在了一起:
| 角色 | 身份 | 酒店版 |
|---|---|---|
docker 命令(CLI) |
普通进程,跑完就退出的临时客人 | 你派去前台递单子的跑腿 |
dockerd 守护进程 |
普通进程,常驻后台、root 权限、从未被隔离 | 长驻酒店的金牌代办 |
| 容器 | 普通进程,被 namespace/cgroups 特殊服务包裹 | 办了特殊服务的普通客人 |
被隔离的从来不是 docker,是容器。 dockerd 恰恰相反------它是隔离服务的"经办人",自己就光天化日站在大厅里(任何宿主机 ps aux | grep dockerd 都能看到它)。它调用内核的 namespace/cgroups 能力,替你把某个新进程办成"隔离客人"。
3.2 一个 dockerd 管理 n 个容器
装一次 Docker = 雇一位 长驻代办,管这台机器上所有 容器------1 对 n,不是一容一 docker。n 个容器各住各的楼层(各自 namespace)、各记各的账(各自 cgroups)、各拼各的房间(各自 OverlayFS),互相不知道彼此存在。
由此推出一个生产要点:dockerd 是管理单点 。它挂了,docker ps 没人应答、新容器没人代办------但已经在跑的容器不会死,因为包裹它们的是内核,不是 dockerd。失去的只是"管理能力",不是"运行能力"。(下一章的 shim 会把这个答案升级到完整版。)
3.3 容器行业版图:四大板块
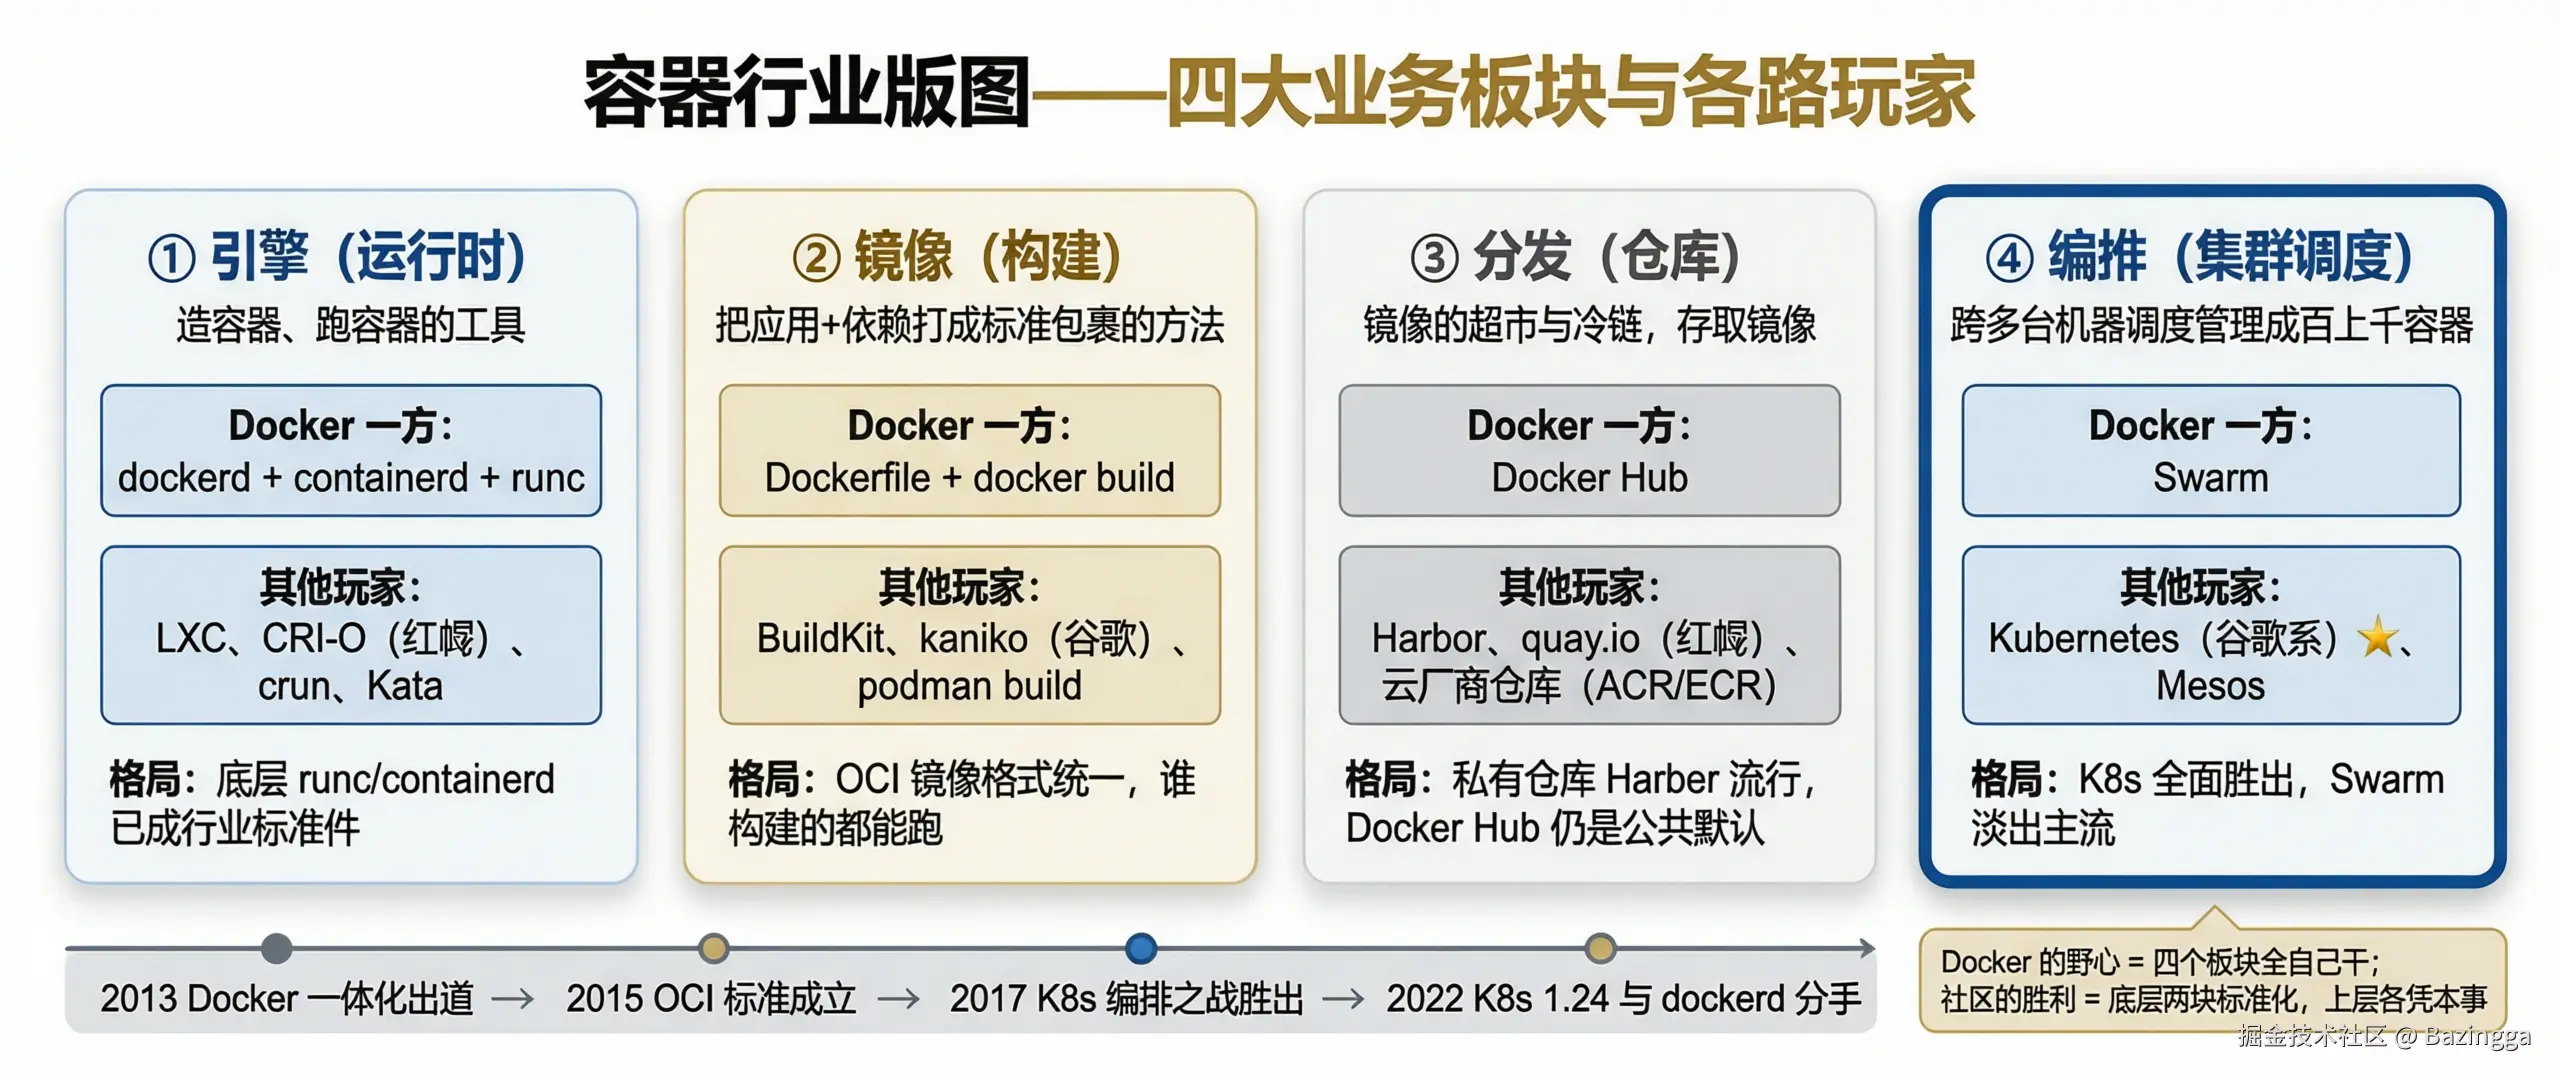
理解 Docker 的前世今生,先看这张地图------容器行业就四块生意 ,判别任何工具属于哪块,只问一句:它是造 包裹的、存 包裹的、跑 包裹的、还是跨机器管包裹的?
| 板块 | 干什么 | Docker 家的产品 | 其他玩家 | 最终格局 |
|---|---|---|---|---|
| ① 引擎(运行时) | 造容器、跑容器 | dockerd + containerd + runc | LXC、podman、CRI-O、Kata | 底层 runc/containerd 已成行业标准件 |
| ② 镜像(构建) | 把应用+依赖打成标准包裹 | Dockerfile + docker build | kaniko、podman build | OCI 镜像格式统一,谁构建的都能跑 |
| ③ 分发(仓库) | 镜像的超市与冷链 | Docker Hub | Harbor、quay.io、云厂商仓库 | 企业私有仓库 Harbor 流行,Hub 仍是公共默认 |
| ④ 编排(集群调度) | 跨多台机器调度管理成百上千容器 | Swarm | Kubernetes★、Mesos | K8s 全面胜出,Swarm 淡出主流 |
2013 年 Docker 出道时四块生意全自己干 ------引擎是它的、Dockerfile 是它的、Docker Hub 是它的、Swarm 也是它的。而谷歌和社区的立场是:底层(引擎、镜像格式)应该像水电一样标准化,上层才允许各凭本事竞争。
结局你已经看到了:runc 交出去(2015)、containerd 交出去(2017)、编排战场正面输给 K8s。一句话史观:容器行业底层能力本来就在内核,Docker 做出了最好的第一代产品;社区把"造容器"和"镜像格式"标准化成了公共品,把"集群调度"的桂冠给了 K8s。Docker 公司输掉了行业,但 Docker 生态赢了世界------你今天用的每一层几乎都是它发明或孵化的。
3.4 动手:在宿主机上找到三件套
bash
# 1. 找 dockerd------光天化日站大堂的金牌代办
ps aux | grep dockerd
#    root ... /usr/bin/dockerd -H fd:// ...   ← 看见了?root 身份、常驻

# 2. 起一个容器,再找它的"楼层管家"
docker run -d --name web nginx
ps aux | grep -E 'containerd-shim'
#    ... containerd-shim-runc-v2 -namespace moby -id <容器ID> ...
#    一个容器一位管家,常驻到容器死亡

# 3. 验证"1 对 n":再起两个容器,shim 变三位,dockerd 还是那一位
docker run -d --name db redis
docker run -d --name mq rabbitmq
ps aux | grep dockerd          # 还是 1 个
ps aux | grep containerd-shim  # 3 个
给 Mac/Docker Desktop 用户 :dockerd 跑在那台 Linux 轻量虚拟机里,宿主机 ps 看不到------用 docker run -it alpine sh 进任意容器,或 docker info 看运行时信息同样能验证。
4. 运行时分层:一次 docker run 的完整链路
4.1 从命令到容器进程:六个方块
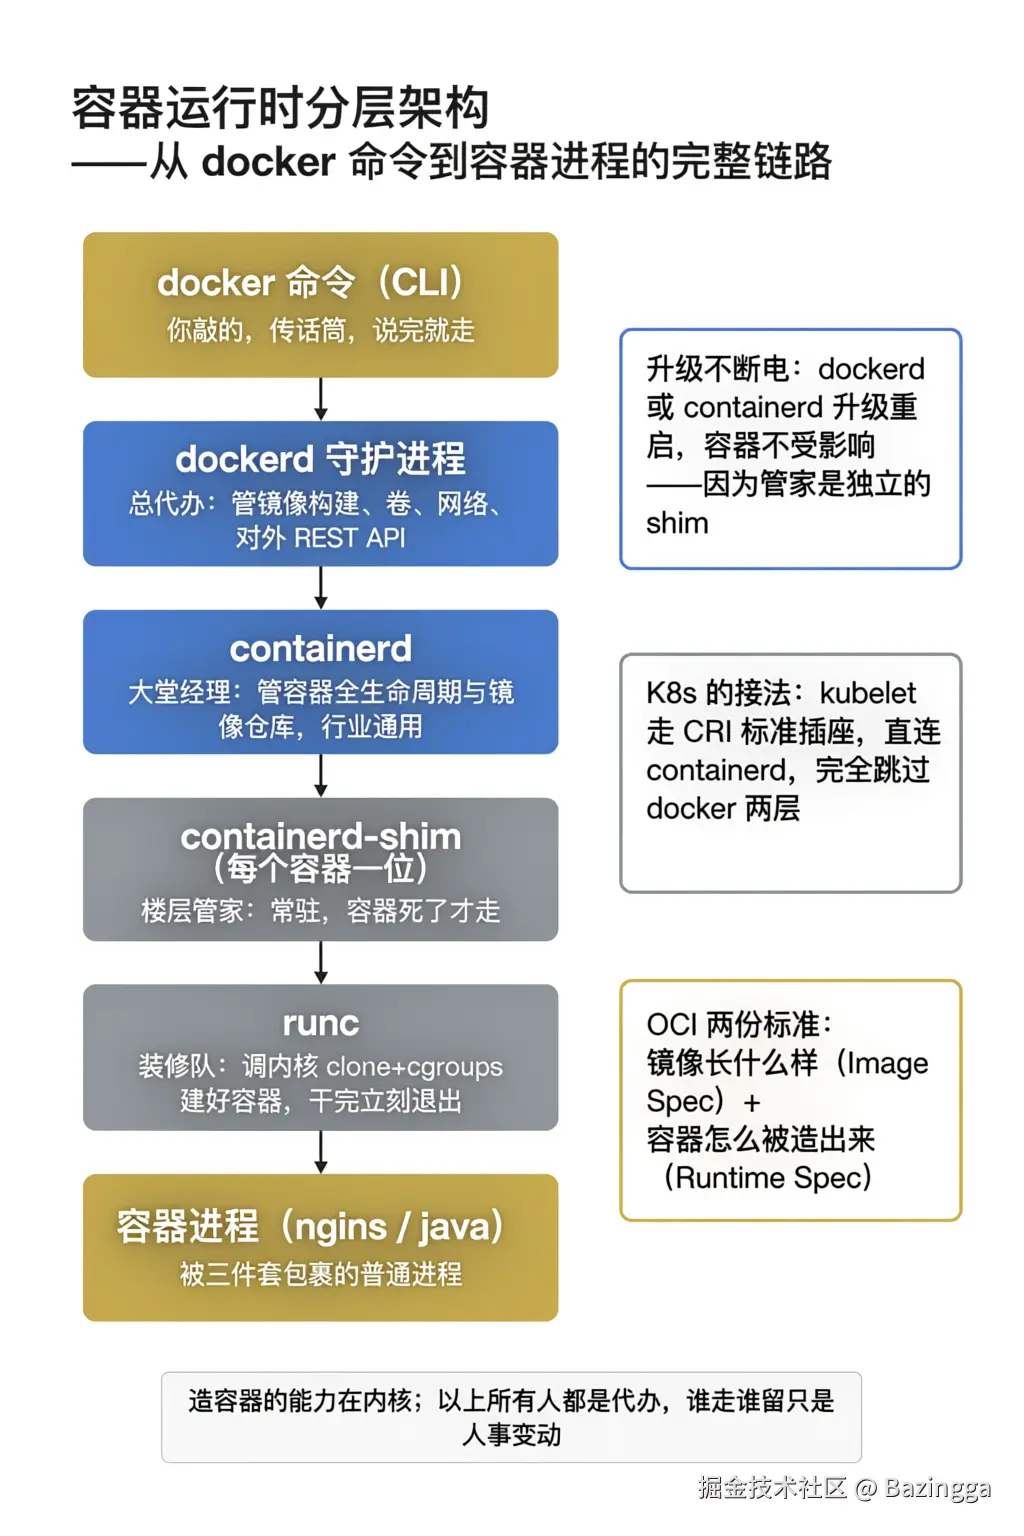
2015 年后,一条 docker run 命令实际要经过六个方块(图左侧链路,自上而下):
- docker CLI(传话筒):你敲的命令。把单子递给 dockerd,然后退出;
- dockerd(总代办) :Docker 公司产品本体。管"增值业务"------镜像构建(Dockerfile)、卷管理、bridge 网络、对外 REST API。注意:容器隔离的核心流程已经不在它手里,它是个转包的包工头;
- containerd(大堂经理) :行业通用的容器生命周期管理者------启停容器、管镜像仓库、收日志。它不姓 Docker,K8s、podman 都在用它;
- containerd-shim(楼层管家,每个容器一位) :runc 建完容器就退场(下一点讲),总得有个常驻的人替容器进程"当爹"------收尸、传信号、上报退出码。这就是 shim,一容器一位,常驻到容器死亡;
- runc(装修队) :最底层、最忠实于内核的施工队。读 OCI 配置 → 调
clone()加 namespace、写 cgroups 文件、挂 OverlayFS → 把容器进程拉起来 → 自己立刻退出; - 容器进程:被三件套包裹的普通进程。
runc 为什么建完就走? 两个原因:容器进程一旦建好,包裹它的 namespace/cgroups 是内核在管 的,不再需要任何用户态进程"维持";且施工队(runc)和当爹的(shim)分离,施工队就能随便升级更换------这就是"dockerd 或 containerd 升级重启,线上容器不受影响"的完整答案:容器进程的爹是独立的 shim。
4.2 OCI:两份"插座标准"
2015 年成立的 OCI(开放容器倡议) 产出了两份规范:
- Runtime Spec:定义"容器运行时"必须怎么造容器(读什么配置、调什么内核接口)------runc 是参考实现;
- Image Spec:定义镜像这个包裹的内部结构(第 5 章拆开看)。
为什么要标准?插座形状统一,电器厂商就自由了:runc 可换成 crun(更快)、Kata(微型虚拟机,堵共享内核的安全洞);镜像在哪家仓库存、被哪家运行时拉起,全都互通。"容器不姓 Docker",制度化保证就是 OCI。
4.3 "K8s 抛弃 Docker"的真相
完整链条(这是高频面试题):
- K8s 要在各节点启停容器,需要统一接口,于是定义了自己的标准插座 CRI;
- Docker 的 dockerd 没有实现 CRI (它有自己的私有 API)。K8s 只好在 kubelet 里塞一块翻译垫片 dockershim,把 CRI 翻译成 Docker API------代价是多绕两层,还夹带一堆 K8s 用不上的功能;
- K8s 1.24(2022 年 5 月)移除 dockershim,kubelet 的 CRI 插座直插 containerd ------从此跳过 docker 两层。
准确翻译:"K8s 抛弃的是 dockerd 这层翻译开销,不是容器、更不是镜像。 容器照样是内核三件套包裹的进程,镜像照样是 OCI 镜像------docker build 构建的镜像在 K8s 上照跑不误。受影响的只是"在 K8s 节点上还依赖 docker 命令做运维操作"的老习惯(替代品 crictl / nerdctl)。
4.4 动手:盯一次 docker run 的完整链路
bash
# 1. 挂一只耳朵听事件流
docker events &

# 2. 另一终端启动容器
docker run -d --name chain nginx

# 3. 看进程树(Linux;Mac 用户进 VM 或跳过这步)
pstree -p $(pidof dockerd)
# dockerd(1234)─┬─containerd(1300)
#               └─containerd-shim(1350)───nginx(1400)─┬─nginx(1401)
#                                                     └─nginx(1402)
这棵进程树就是 4.1 那六个方块的真身:dockerd → containerd → shim → nginx。
最值得观察的一个细节:runc 不在树上。 它建完容器就退出了(4.1 讲过原因)。验证:
bash
docker run --rm -it alpine sh   # 另开一个容器
# 宿主机另开终端,立刻执行:
ps aux | grep runc # 要么刚闪过、要么已经不在------建完就走"升级不断电"实验(生产知识,可放心验证):
bash
# Linux:重启 dockerd(容器进程的爹是 shim,不是 dockerd)
systemctl restart docker
ps aux | grep nginx          # chain 容器的 nginx 还活着!
docker ps                    # 重新接上代办后,容器列表照旧
5. 镜像解剖:拍照、Maven 与一个包裹的一生
这一章有一个给 Java 开发者的免费外挂 :你天天用的 Maven 生态里,装着镜像机制的原型。踩稳它,本章毫无门槛。
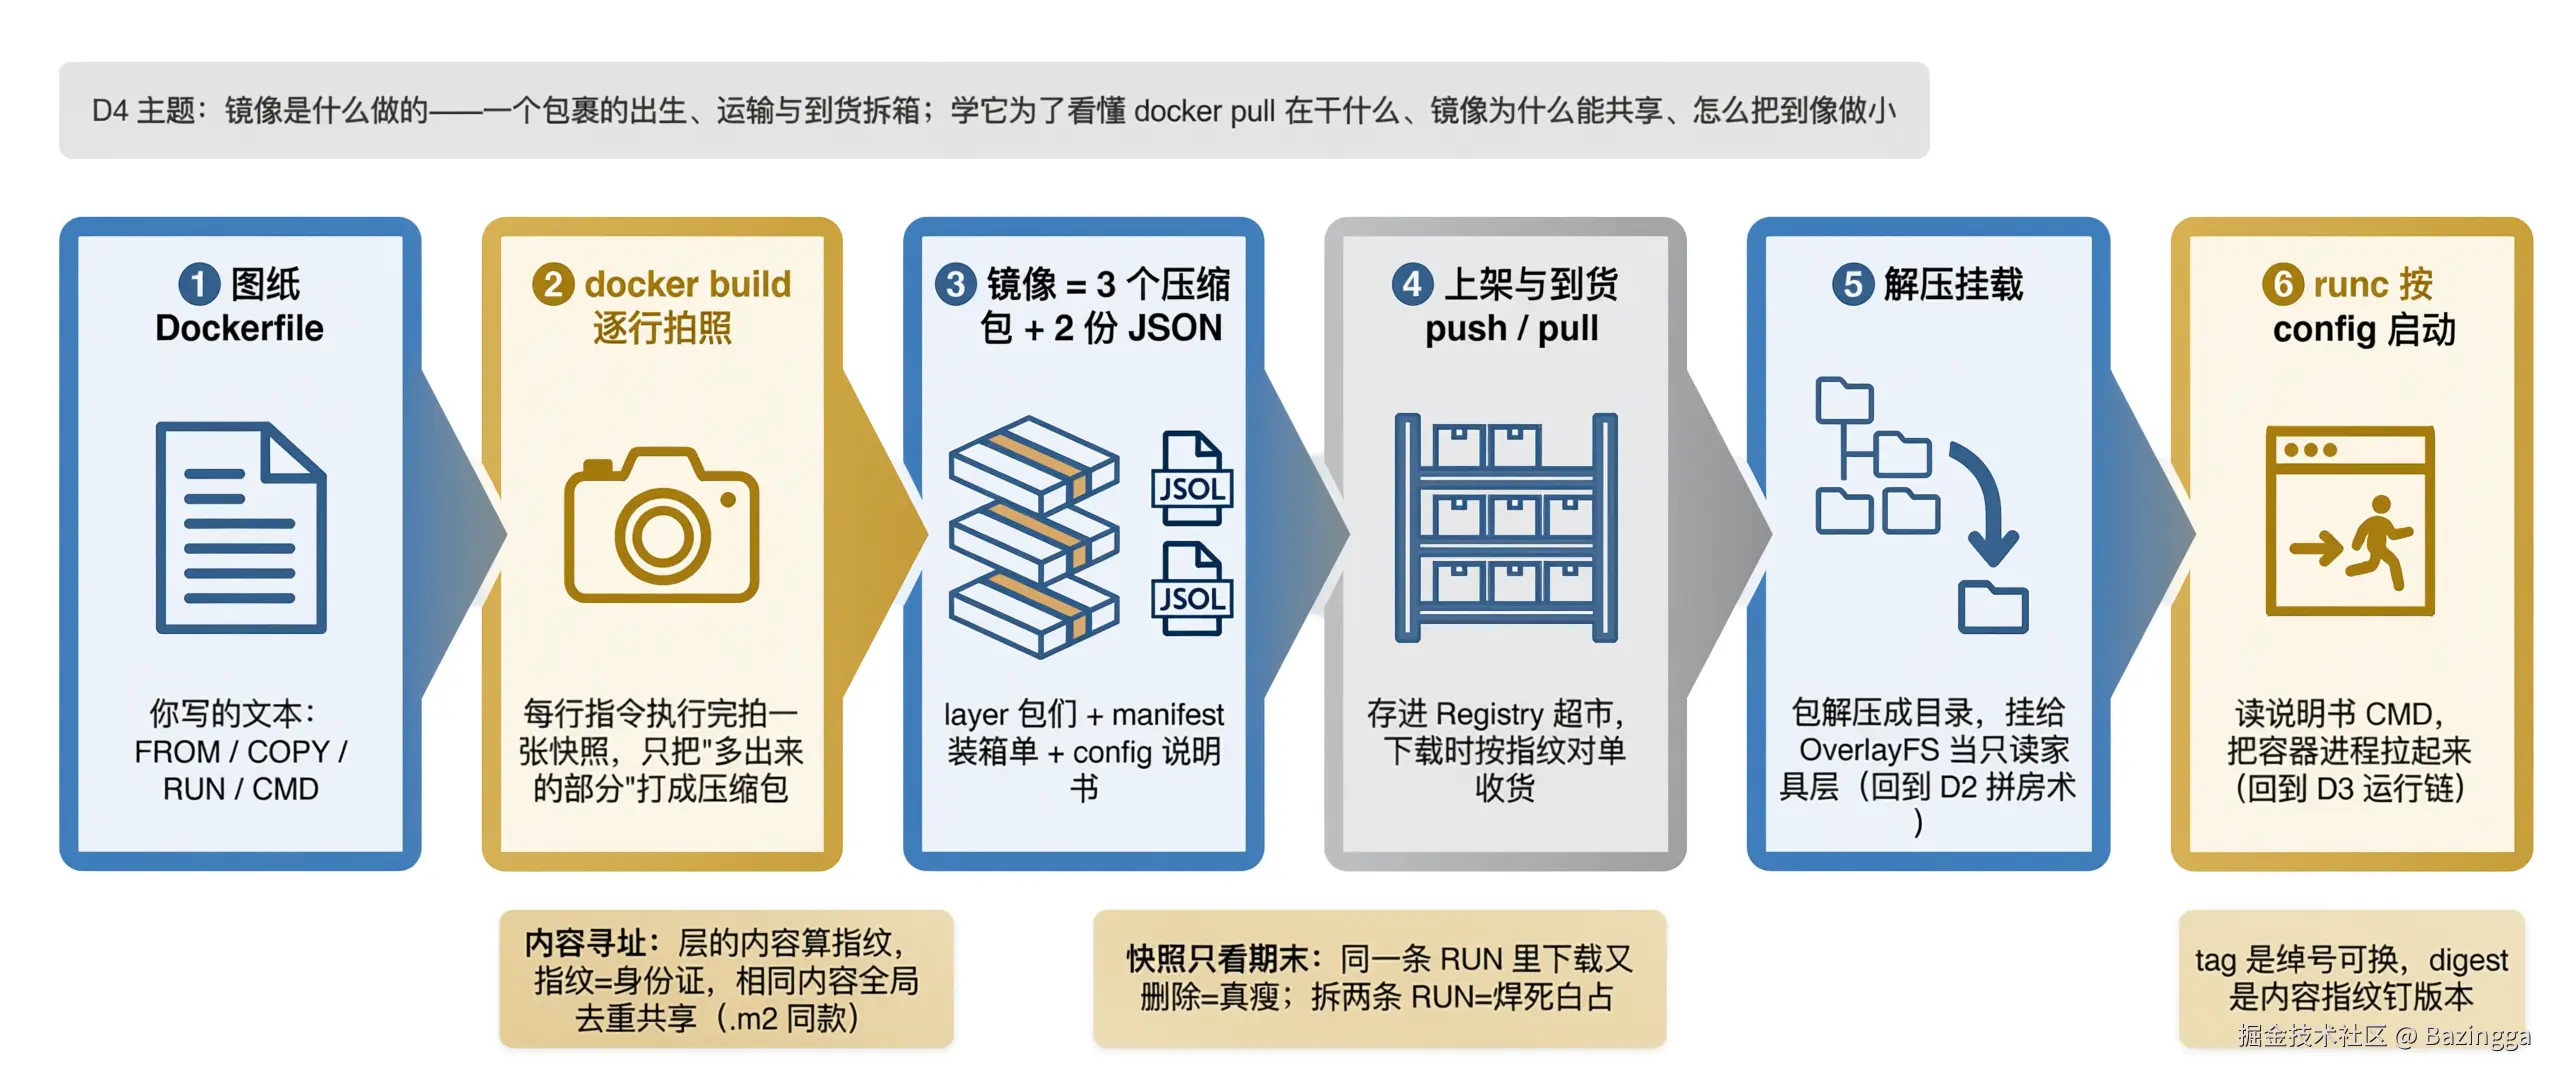
本章主题:镜像这个包裹是怎么被造出来的、里面装了什么、怎么运输到货。上图是全程地图,六步走完。
5.1 Dockerfile:你递给工厂的图纸
Dockerfile 是一个纯文本文件 ,逐行声明"我的镜像怎么组装"。它和 docker 的关系,完全等于 pom.xml 和 Maven 的关系:
| Maven 世界 | Docker 世界 | |
|---|---|---|
| 工具 | mvn |
docker |
| 你写的文本 | pom.xml:描述 jar 怎么组装 |
Dockerfile:描述镜像怎么组装 |
| 执行 | mvn package 读 pom → 产 jar |
docker build 读 Dockerfile → 产镜像 |
| 文件放哪 | 项目根目录 | 项目根目录(和 pom.xml 并排) |
dockerfile
FROM ubuntu:22.04            # 第 1 行:从哪个基础镜像开始
COPY app.jar /app/           # 第 2 行:把我的文件放进去
RUN apt-get install curl     # 第 3 行:装我要的软件
CMD ["java", "-jar", "/app/app.jar"]   # 最后:容器启动时执行什么
整条链用 Java 钉死:Dockerfile ≈ .java 源码,docker build ≈ mvn package,镜像 ≈ jar,docker run ≈ java -jar,容器 ≈ 运行中的 JVM 进程。一个 jar 能跑出很多 JVM 进程;一个镜像能跑出很多容器------一对多关系一模一样。
5.2 docker build 的唯一条规则:拍照
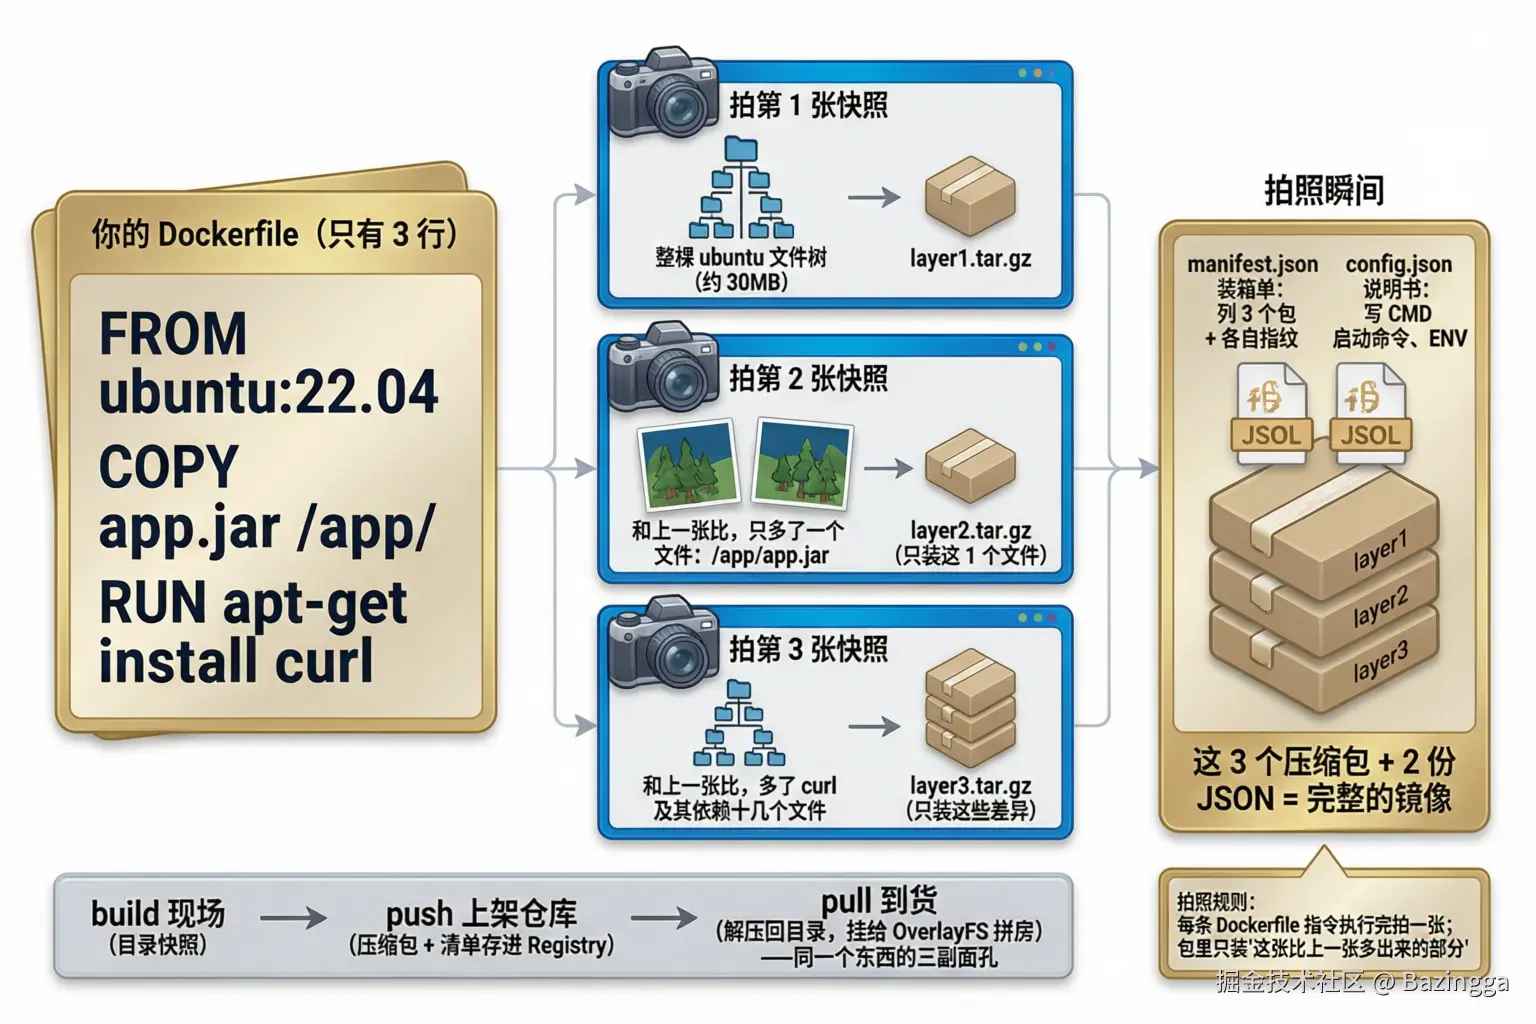
docker build 逐行执行 Dockerfile,规则只有一条:每条指令执行完,给当前整个文件树拍一张快照 ,然后把"这张比上一张多出来的部分"打成一个压缩包:
- 第 1 行拍完 → 照片里是整棵 ubuntu 文件树 →
layer1.tar.gz(约 30MB) - 第 2 行拍完 → 只多了
app.jar→layer2.tar.gz(只装这 1 个文件) - 第 3 行拍完 → 只多了 curl 及依赖 →
layer3.tar.gz(只装这些差异)
"拍照规则"是本章的灵魂,后面所有推论都从它长出来。
为什么要拍照?(三个目的)
- 省空间:每行都存整棵文件树,一个 10 行的镜像会膨胀成几百 MB,99% 是重复内容。只存差异------这就是"容器镜像比虚拟机镜像小"的物理根源;
- 可共享 :差异包的内容算指纹,指纹相同 = 同一个包。如果整个 Dockerfile 只拍一张总照片,A 镜像(ubuntu+redis)和 B 镜像(ubuntu+mysql)整张必然不同,30MB 的 ubuntu 部分一点都共享不了。行级拍照 = 把"共同的部分"切成可独立共享的块(就像 Maven 按 jar 共享而不是按整个项目共享);
- 可缓存 :改第 5 行,前 4 张照片不变 → 直接复用旧照片,只从第 5 行重拍 。这就是
docker build第二次以后明显变快的构建缓存。
顺带:连 git 也是这个思路------git 不存"每次改动的文字记录",而是把文件内容按哈希存成对象(blob),相同内容全仓库只存一份。"内容快照 + 内容指纹"是现代工程界去重共享的标准打法。
5.3 成品:3 个压缩包 + 2 份 JSON
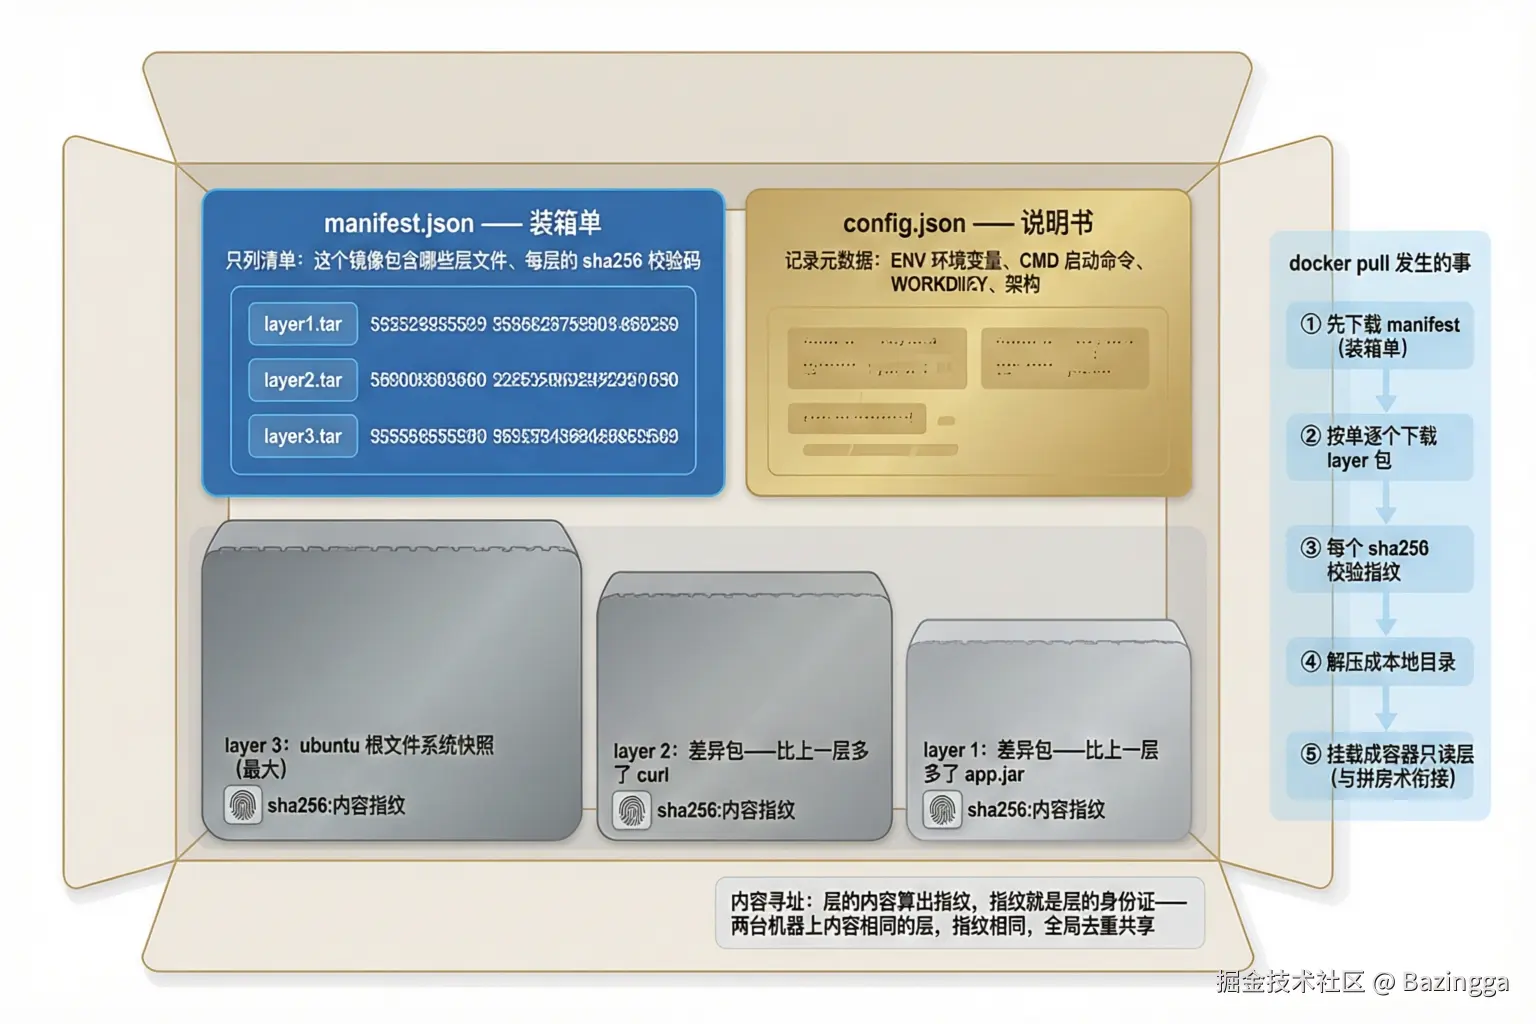
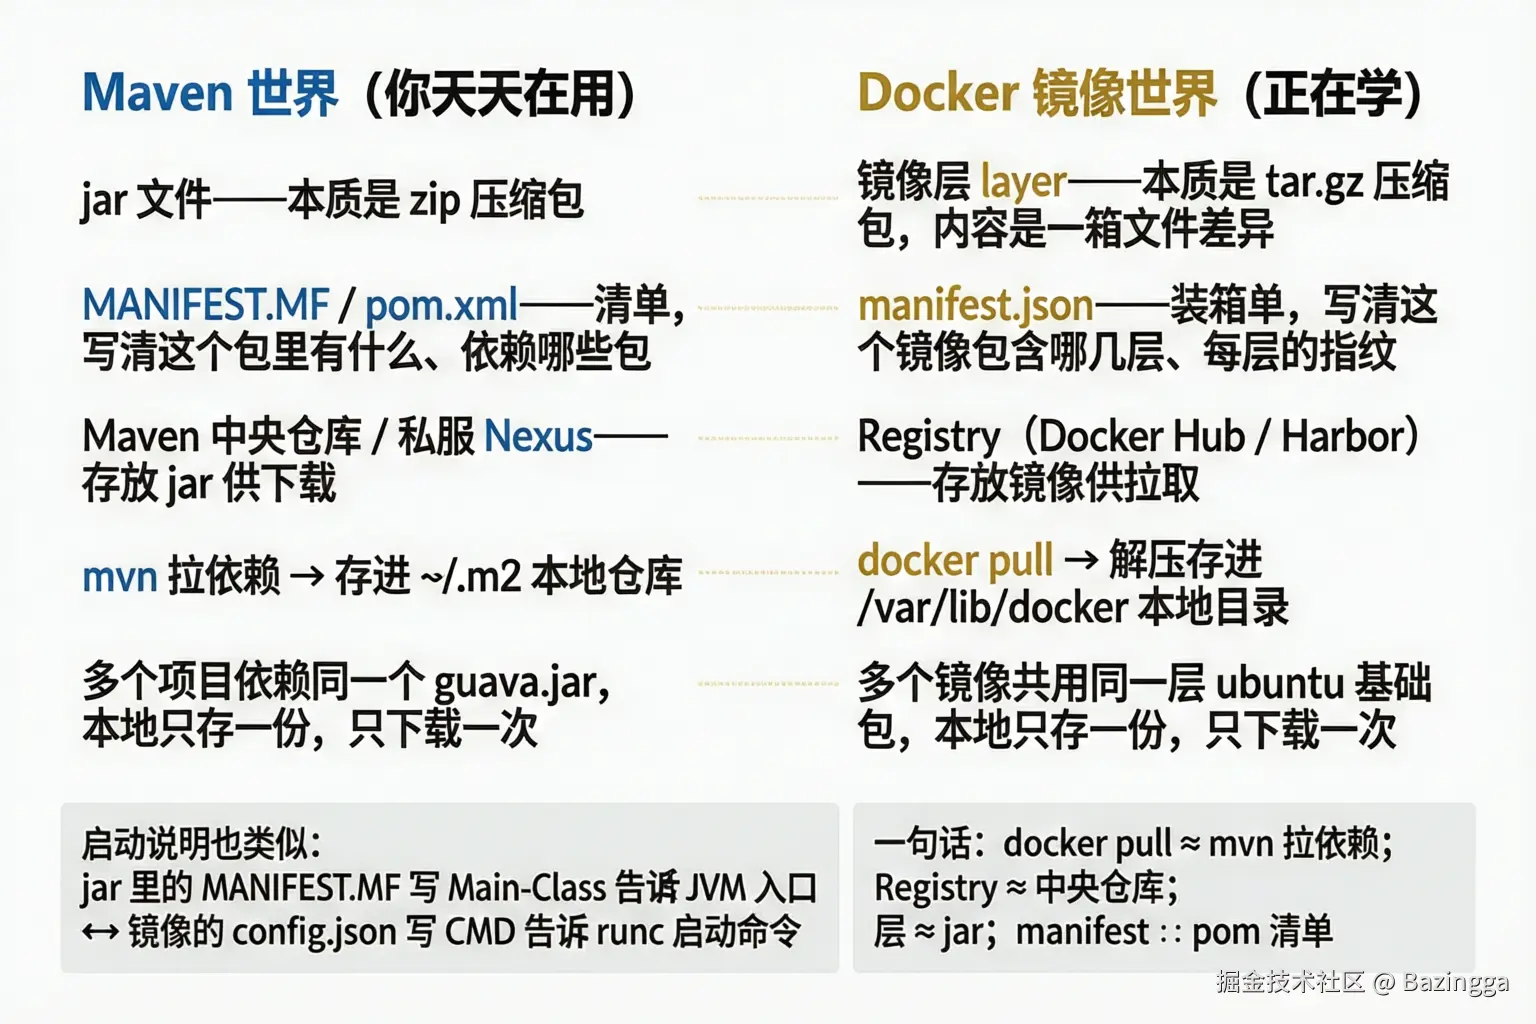
三行 Dockerfile 执行完,docker 收尾写两份 JSON,整个"镜像"就齐了:
arduino
layer1.tar.gz + layer2.tar.gz + layer3.tar.gz   ← 家具包(层层差异快照)
manifest.json                                   ← 装箱单:本镜像 = 这 3 个包,各带指纹
config.json                                     ← 说明书:CMD、ENV、WORKDIR 等启动元数据
对照 Maven 世界(第二张图),就是 3 个 jar + 1 个 pom + 1 个 Main-Class 说明。没有更多东西了:
- layers ≈ jar 文件------都是"压缩包里装一堆文件";
- manifest.json ≈ pom.xml / MANIFEST.MF------写清这个镜像由哪几个包组成;
- config.json ≈ Main-Class------告诉运行时"启动命令是什么"。分工记忆:layer 管"硬盘上有什么",config 管"启动时怎么跑"。
5.4 上架与到货:push / pull
docker push= 把这五样东西存进 Registry(Docker Hub / Harbor)------相当于 Maven deploy 到中央仓库/私服;docker pull= 照单收货四步:先下装箱单(manifest)→ 按单逐箱下载 → 每箱验指纹 → 解压;- 解压出来的目录,就是第 2.4 节拼房术里那些只读家具层 ------
docker run时叠上可写层挂给 OverlayFS,容器进程的房间就拼出来了。镜像解剖与拼房术在此合拢 ;最后 runc 翻开 config 说明书点火启动(第 4 章的链路)。D4 的产物是 D2 的输入,D4 的 config 是 D3 的启动参数。
5.5 内容寻址:为什么 30MB 只下载一次
每个压缩包都有一个 sha256 指纹,指纹是用包的内容算出来的 ------内容不变、指纹不变。这带来一个机制:内容即身份。
镜像 A(ubuntu+redis)和镜像 B(ubuntu+mysql)都用 ubuntu:22.04,那箱 ubuntu 30MB 指纹相同:pull A 下载一次,pull B 时 registry 一对指纹------"这箱你有了,跳过"。和 ~/.m2 里 guava 只下一遍完全同构(Redis 缓存 key、Git 对象哈希,全是这个思想)。
5.6 快照只看期末:一桩悬案的终审
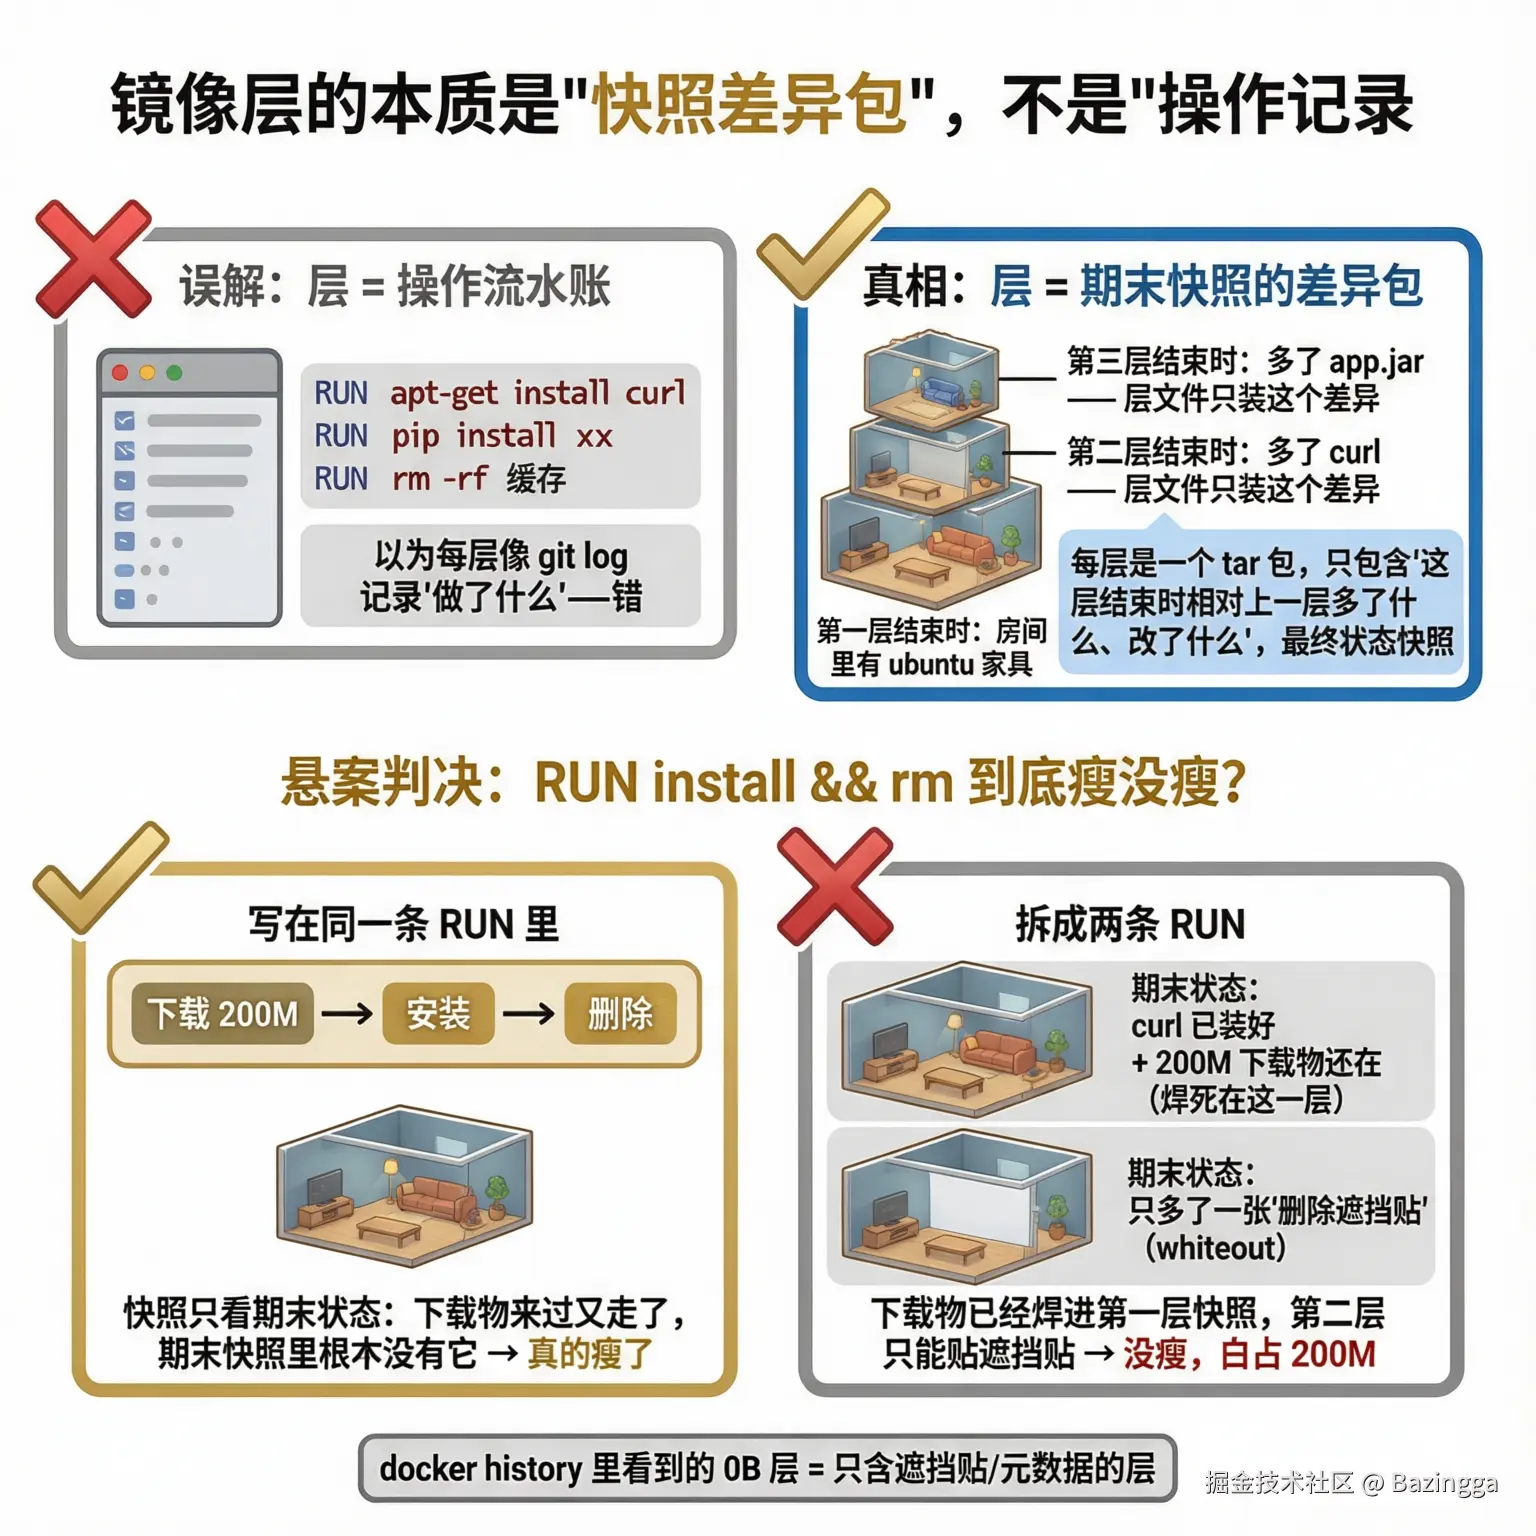
对镜像层最大的误解 :把它当 git log 那样的"操作流水账"。真相:每层是"期末快照的差异包",只看结果不看过程。
由此终审 Dockerfile 经典悬案------"下载的临时文件要在同一条 RUN 里删掉":
arduino
写在同一行:  RUN 下载200M && 安装 && 删除
              → 下载物"来过又走了",拍照时不在画面里 → 这层真小 ✔

拆成两行:    RUN 下载 && 安装
              RUN 删除
              → 第一张照片里 200M 已入镜焊死;第二行只能贴"遮挡贴"(whiteout)
              → 没瘦,200M 白占 ✘
docker history 里那些 0B 的层,就是"这张照片比上一张几乎没多任何文件"的层------ENV 这种只往 config 写元数据、不碰文件树的指令,拍出来的就是 0B。
5.7 tag 是绰号,digest 是身份证
nginx:latest 里的 latest 是可变标签 ------今天拉和明天拉,背后可能不是同一个包裹。而整个镜像还有一个总指纹:nginx@sha256:abc123...(digest),内容一变指纹就变。
latest≈ Maven 的 SNAPSHOT------方便人,但内容可漂移;digest≈ 固定版本 + 内容校验------方便机器,钉死版本、防调包。
生产/CI 锁定镜像用 digest,正如你们从不让 SNAPSHOT 上生产。
5.8 动手:构建、分层、悬案,一次做实
实验 1:亲手打一个包,观察"拍照"现场。 任意目录下新建 Dockerfile:
dockerfile
FROM busybox
ENV TZ=Asia/Shanghai
COPY hello.txt /hello.txt
bash
echo hi > hello.txt
docker build -t my-first-image .
# 输出里每一行 "Step x/3" 就是一次拍照------和 5.2 讲的一一对应:
#   Step 1/3 : FROM busybox        → 复用/拉取基础层
#   Step 2/3 : ENV TZ=Asia/Shanghai
#   Step 3/3 : COPY hello.txt /hello.txt
实验 2:用 docker history 验证"每行一层"与"0B 层"。
bash
docker history my-first-image
# IMAGE          CREATED      CREATED BY                       SIZE
# <镜像ID>       刚刚          COPY hello.txt /hello.txt        3B      ← 只有这个文件
# <层ID>         刚刚          ENV TZ=Asia/Shanghai             0B      ← 5.7 预言:0B!
# <层ID>         1年前         busybox                         1.24MB  ← 基础层
实验 3:悬案终审现场版。 两个 Dockerfile 对比:
dockerfile
# big-bad/Dockerfile(拆两行)          # big-good/Dockerfile(同一行)
FROM alpine                            FROM alpine
RUN dd if=/dev/zero of=/big bs=1M \   RUN dd if=/dev/zero of=/big bs=1M \
    count=100                              count=100 && rm /big
RUN rm /big
bash
docker build -t big-bad big-bad
docker build -t big-good big-good
docker images | grep big
# big-bad   ~100MB   ← 100M 已焊进层快照,删不掉
# big-good  ~7MB     ← 快照里压根没它,真瘦了
实验 4:内容寻址与重复下载。
bash
docker pull alpine         # 第一次:正常下载
# 再 pull 一个同样基于 alpine 的镜像,观察输出:
docker pull nginx:alpine   # 你会看到一行 "Already exists" ------ 30MB 没再下!
docker images --digests    # 顺手看一眼 digest 身份证
6. 容器网络:一次敲门的旅行
6.1 三件新设备:veth、网桥、iptables
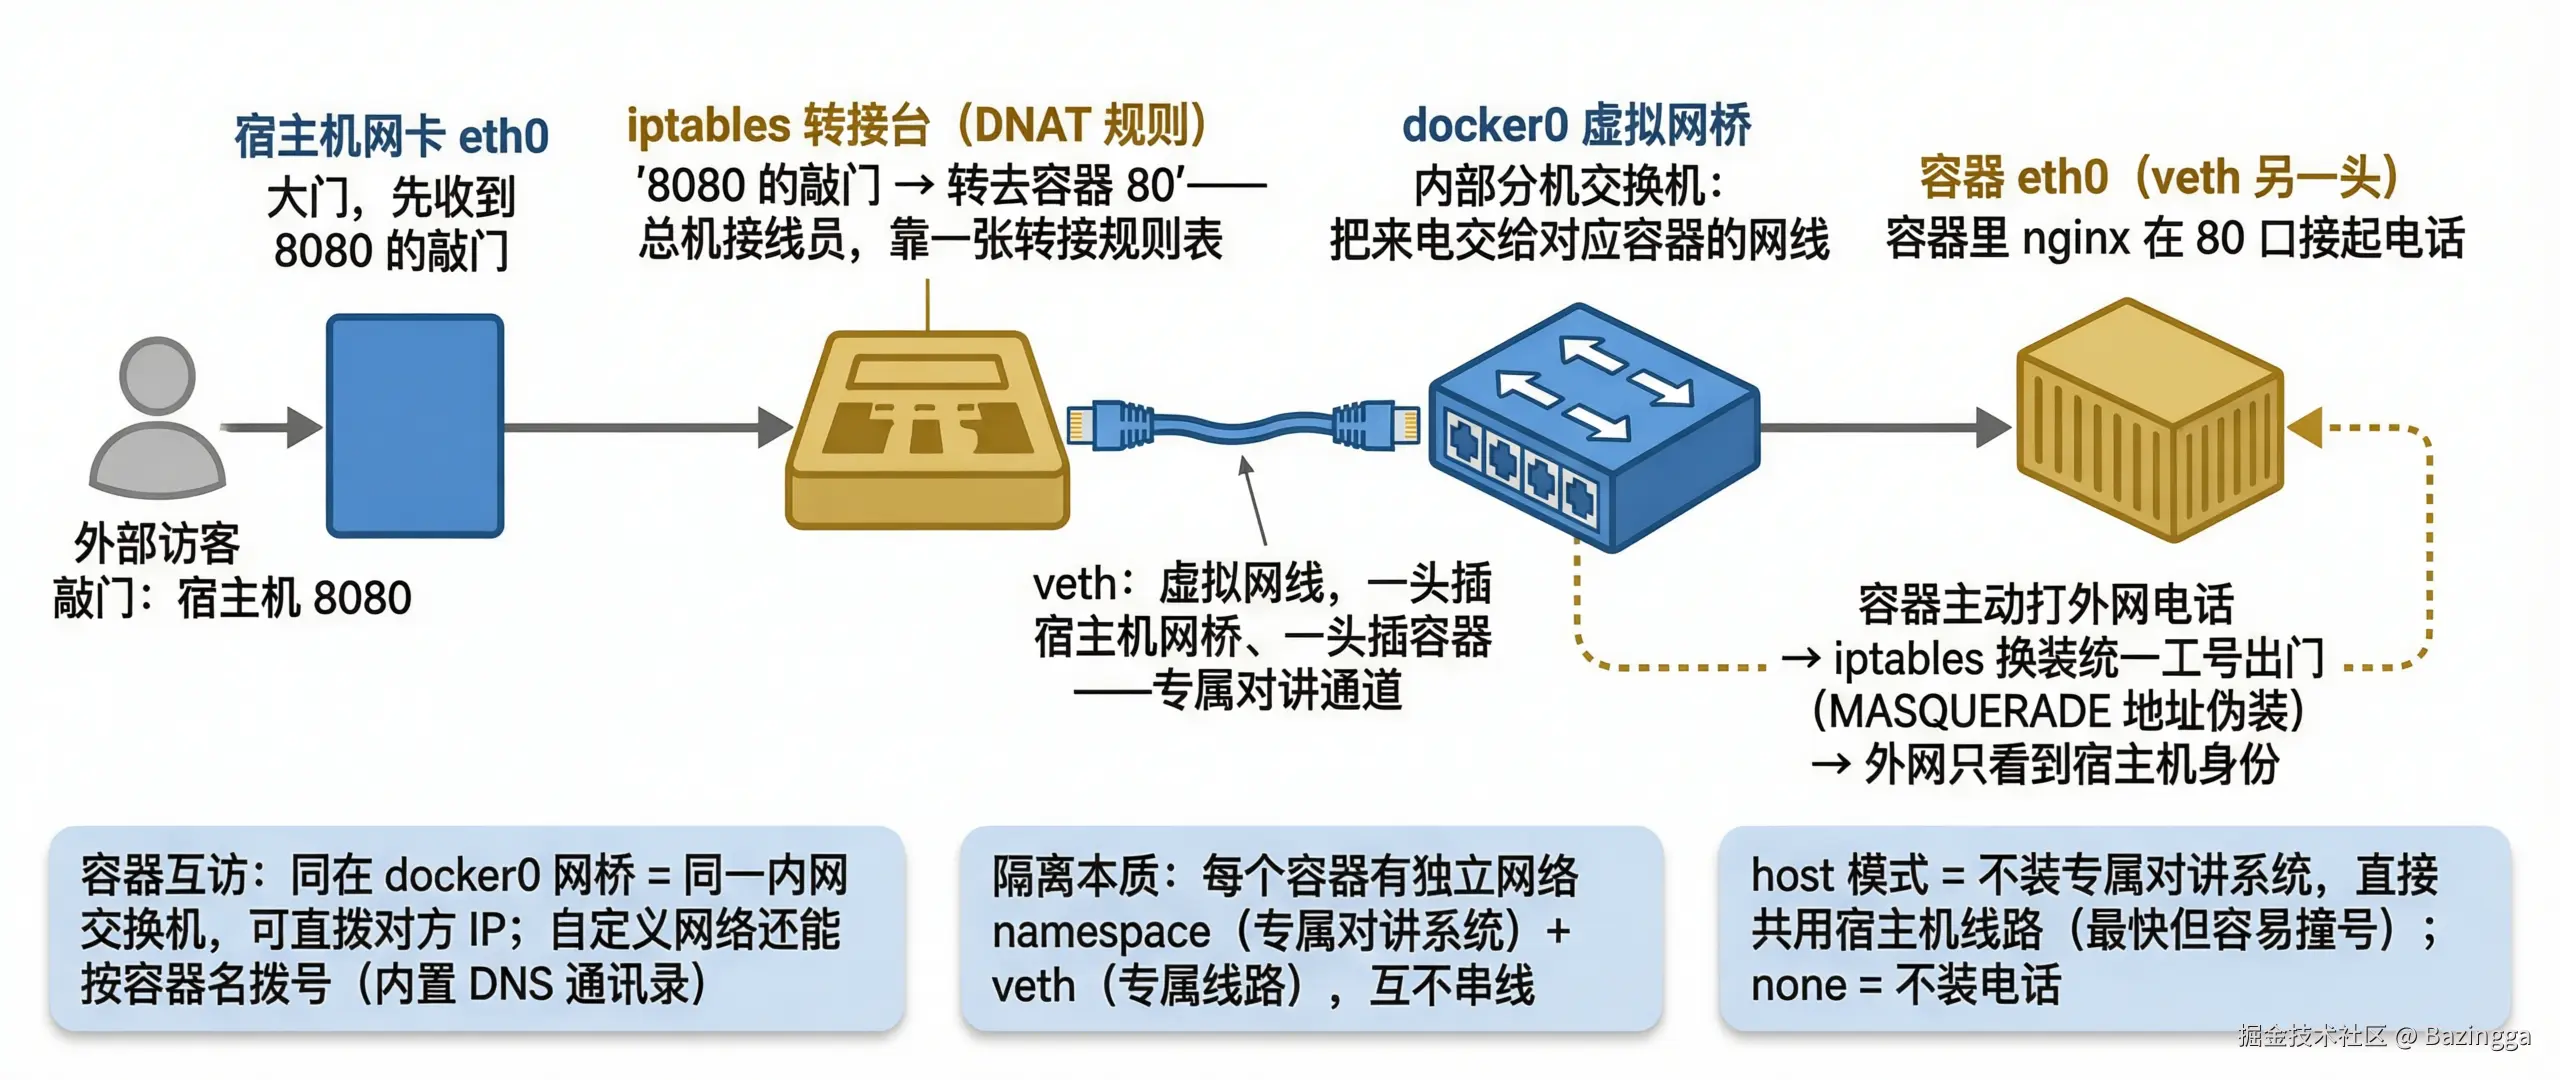
回顾第 2 章:每个容器在创建时拿到一套专属对讲系统 (网络 namespace)------自己的网卡、自己的 IP、自己的端口表。所以两个容器各跑 nginx 都监听 80 端口互不冲突:两套对讲系统里各有一个"80 号分机"。
这套对讲系统靠三件设备接入酒店:
- veth pair(虚拟网线) :内核造的一根"两头都连设备"的网线。一头插宿主机侧,另一头插进容器的网络 namespace(容器里它就叫
eth0)。数据从一头进、另一头必出------容器接入网络的物理形态:没有真网卡真网线,全是虚拟的; - docker0(虚拟网桥) :一台多口交换机。所有容器的 veth 宿主机侧都插在它身上,接到一个口的数据按目标 IP 转给正确的口------容器间通信都靠它交换;
- iptables(总机接线员) :内核网络栈里的规则表,干最关键的活------转接(NAT) 。
docker run -p时,docker 替你往内核写一条转接规则。
6.2 -p 8080:80 完整走查
按图从左到右,一次真实请求的旅行:
arduino
① 外部访客敲宿主机 8080 门
   → 数据包到达宿主机真实网卡 eth0

② iptables 接线员翻规则表:有条 DNAT 规则写着
   "凡是来 8080 的,改写目的地 → 容器 IP 的 80 口"
   (这条规则正是 docker run -p 8080:80 时 docker 替你写的)

③ 改写后的包交给 docker0 网桥交换机
   → 交换机按目标 IP 找到容器插在哪个口

④ 沿 veth 网线送进容器
   → 容器里 eth0 收到,nginx 在 80 分机接起
关键认知:容器在宿主机上没有"真实端口",只有这条转接链。 -p 8080:80 不是"给容器开个 8080",而是"在总机登记一条转接规则"。docker ps 里的 0.0.0.0:8080->80/tcp,本质就是这张转接表的可视化。
6.3 出网与互访
容器主动访问外网 (图里虚线回路):容器内网 IP(172.17.0.x)外面没人认识,iptables 再干一件事------MASQUERADE(换装出厂):出门前把源地址统一改成宿主机 IP,回来再换回。这就是"bridge 网络能上外网"的底层原因。
容器互访 :同在 docker0 上 = 同一交换机内网,用容器 IP 直拨;自定义网络还能按容器名拨号(内置 DNS 通讯录)------这就是"自定义网络比默认 bridge 好用"的 why。
最后两个模式一句话:host 模式 = 不装专属对讲、直插宿主线路(最快但撞号);none = 不发电话(纯离线计算)。
6.4 动手:自定义网络与 Redis 主从
实验 1:同网容器按"名字"互拨(内置 DNS 通讯录)。
bash
docker network create mynet
docker run -d --network mynet --name box1 alpine sleep 3600
docker run -d --network mynet --name box2 alpine sleep 3600
docker exec box1 ping box2     # 通!直接喊名字,不用记 IP
# 而默认 docker0 上则不行------默认 bridge 没有 DNS 通讯录,只能查 IP 再 ping
实验 2:Redis 主从集群(实战高频场景)。
bash
# 主库
docker run -d --network mynet --name redis-master redis
# 从库:启动时喊一句"我跟主库混"
docker run -d --network mynet --name redis-slave \
  redis redis-server --slaveof redis-master 6379
# 验证:主库写、从库读
docker exec redis-master redis-cli set hello world
docker exec redis-slave  redis-cli get hello    # → world
这套实验的每个动作都在验证 6.1:容器间的所有通信,都是 docker0/自定义网桥这台"交换机"+ 每容器一根 veth 网线完成的。
7. 容器安全:被卸了武装的 root
7.1 先回收一颗雷:共享内核
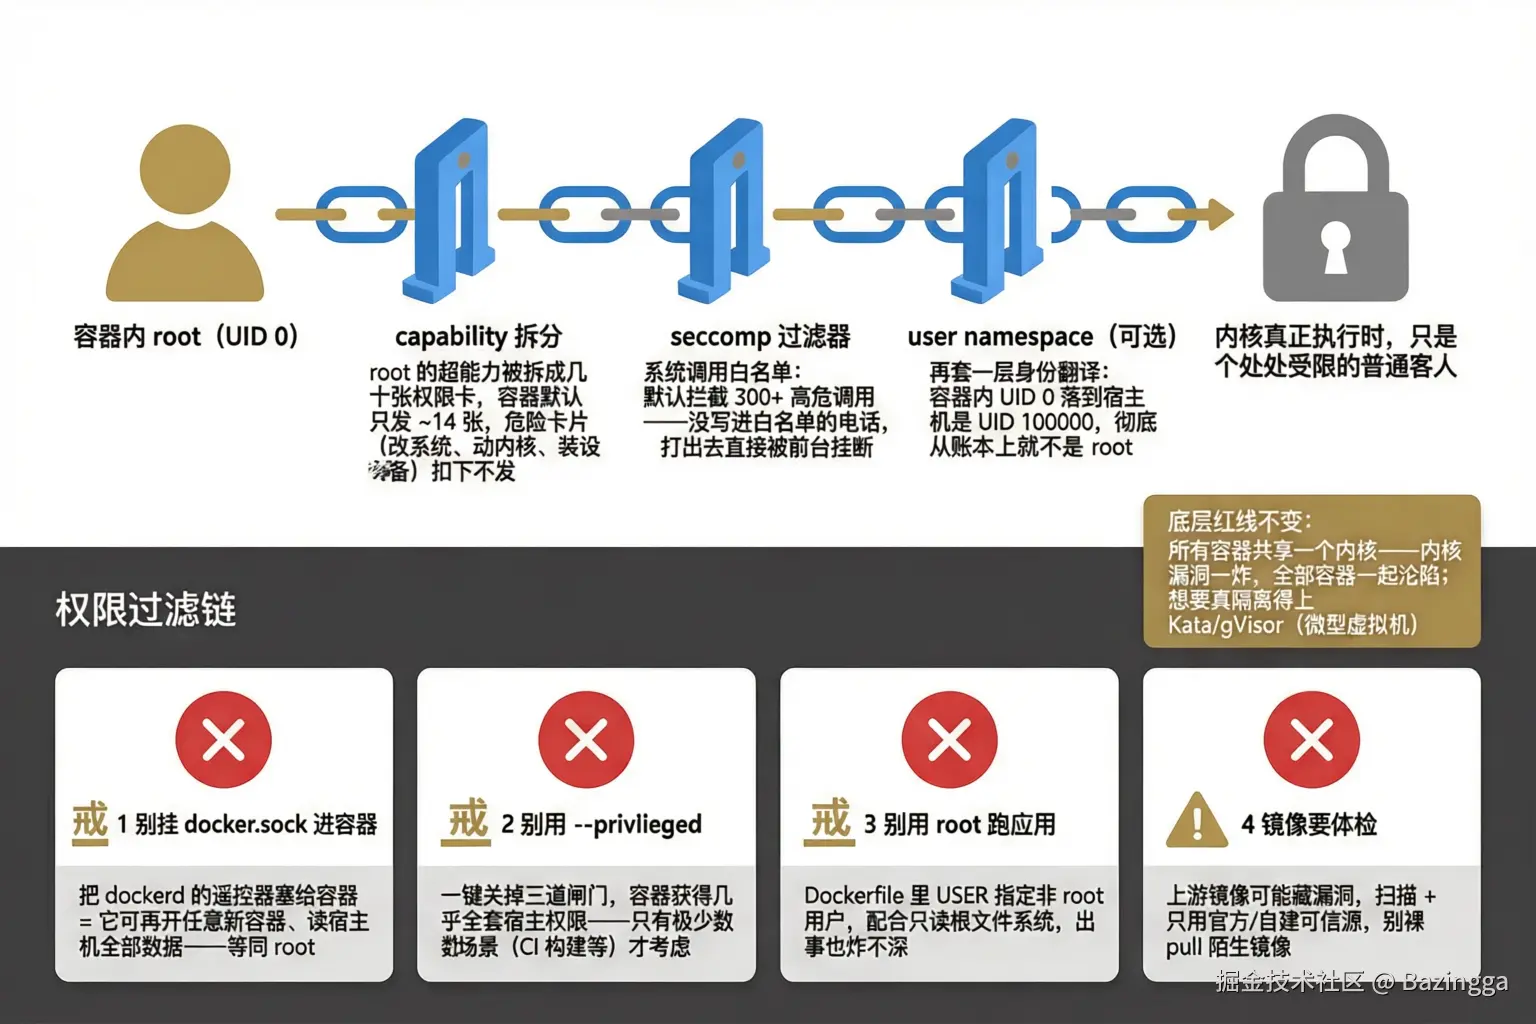
第 2 章埋的雷现在引爆:namespace 和 cgroups 都不是安全屏障 ------它们是资源管理工具,设计初衷不是防坏人。真正要防的是:容器进程利用共享的内核里的漏洞,在宿主机上执行代码(容器逃逸)。
所以本章主题不是"容器有多安全",而是**"既然共享内核,怎么让容器里的进程做不成坏事"------靠限制权限,而不是相信隔离**。
7.2 三道默认闸门
闸门 1:capability------root 的"超能力"被拆成了卡片。 root 的能力不是"一个开关",而是几十张权限卡:CAP_NET_ADMIN(改网络)、CAP_SYS_ADMIN(挂载/改系统)、CAP_SYS_MODULE(动内核模块)......Docker 默认只给容器内的 root 发约 14 张常用卡,最危险的几十张全部扣下。 所以容器里 root 想 mount 文件系统、想改宿主机网络------全被前台拒绝。容器 root 不等于宿主机 root,不是因为中间有墙,而是因为这个 root 是"被卸了武装的 root"。(这解释了第 1.4 节说的"万能房卡可以拆成子卡"。)
闸门 2:seccomp------系统调用的白名单。 capability 管"权限卡",seccomp 管更底层的东西:Docker 默认挂一个过滤器,拦截 300+ 个高危系统调用 (很多历史上出过内核漏洞的调用)。容器进程想打白名单外的电话,前台直接挂断------这是防内核漏洞利用的最后一道大闸。
闸门 3(可选):user namespace------账本上就不是 root。 把容器内 UID 0 翻译成宿主机 UID 100000。哪怕前两道全被攻破逃出来,执行权限也只是个普通用户。代价是文件权限映射麻烦,所以 Docker 默认没开(--userns-remap 显式开启)。
7.3 生产四戒
戒 1:别把 docker.sock 挂进容器。 /var/run/docker.sock 是 dockerd 的遥控器。把它 -v 进容器 = 把遥控器塞给容器里的进程------它可以再开新容器、读宿主机所有容器数据、逃出资源限制。这是真实世界最常见的"容器提权到宿主 root"路径。
戒 2:别用 --privileged。 这个参数等于一键关掉三道闸门:所有 capability 全发、seccomp 全放开。容器几乎裸奔在宿主机上。只有极少数场景(如容器里跑嵌套容器)才考虑,且永远先想替代方案。
戒 3:别用 root 跑应用。 三道闸门防"逃逸",但应用以 root 运行会放大任何漏洞(写错日志路径的 root 能覆盖 /etc)。Dockerfile 里 USER appuser + 只读根文件系统,出事也炸不深。
戒 4:镜像要体检。 镜像 = 别人打好的家具包,可能藏着挖矿木马、过时组件。只 pull 可信源、镜像扫描(Trivy 等)进 CI、latest 换 digest 钉版本。
7.4 终极事实与出路
底层红线不变(图右下角):共享内核意味着内核漏洞一炸,所有容器一起沦陷------三道闸门只是让"炸"的门槛变高,不是不存在。 对隔离要求极高的场景(多租户、跑不可信代码),业界方案是 Kata Containers / gVisor:给每个容器配一个微型虚拟机或用户态内核替身------这时才回到"容器 vs 虚拟机"的对比:安全换代价。
隔离强度光谱:裸进程 < Docker 容器 < Kata/gVisor < 真虚拟机。
7.5 动手:亲手验证"被卸了武装的 root"
bash
# 实验 1:容器里的 root,连"挂载"都干不了
docker run --rm -it alpine sh
whoami                  # root
mount /dev/sda1 /mnt    # mount: permission denied(are you root?)
# ↑ 你是 root,但 CAP_SYS_ADMIN 这张卡被扣下了------"缺胳膊少腿"实锤

# 实验 2:补齐一张卡,能力立刻回来(危险动作示范,看对比即可)
docker run --rm -it --cap-add=SYS_ADMIN alpine sh
mount /dev/sda1 /mnt    # 这次可以了------证明"能力=卡片",与身份无关

# 实验 3:默认允许的卡有哪些(约 14 张)
docker run --rm -it alpine sh -c 'cat /proc/self/status | grep CapEff'
# 对照 root 全集,明显少了一大截

# 实验 4:只读根文件系统(戒 3 的实操)
docker run --rm -it --read-only alpine sh
touch /test             # Read-only file system ------ 应用想乱写也写不了
8. 数据卷与 Docker Compose:补上最后两块拼图
8.1 为什么容器删了数据就没了
第 2.4 节拼房术的直接推论:容器里的一切修改都发生在可写层 (金色那层),而容器删除 = 可写层连同里面的一切消失,公共家具(镜像层)完好无损。所以:
- 一次性任务(跑批处理、编译)→ 可写层随便用,删了正好;
- 任何要活过容器死亡的业务数据(MySQL 的库、Redis 的 RDB、日志)→ 必须放在可写层之外。
把数据放出去的动作,就是挂载(1.3 学过:接枝,不是拷贝)。
8.2 三种挂载:volume、bind mount、tmpfs
| volume(卷) | bind mount(目录挂载) | tmpfs | |
|---|---|---|---|
| 位置 | Docker 管理(/var/lib/docker/volumes/) |
你指定的宿主机路径 | 内存 |
| 谁说了算 | Docker 帮你选、帮你管 | 你指哪接哪 | Docker |
| 跨平台/迁移 | ✅ 干净(不依赖宿主路径) | ❌ 依赖路径存在 | ✅ |
| 生命周期 | 独立于容器,需手动删 | 跟随宿主机目录 | 容器停即消失 |
| 适用 | 生产持久化首选 | 开发时挂代码/配置 | 敏感临时数据 |
一句话选型:生产数据用 volume,开发时挂本地代码用 bind mount,密码类临时文件用 tmpfs。
8.3 动手:MySQL 的数据在容器死后活下来
bash
# 1. 创建卷(相当于申请一个"外部储物柜")
docker volume create mysql-data

# 2. 把卷接到容器的数据目录上跑 MySQL
docker run -d --name mysql -p 3306:3306 \
  -e MYSQL_ROOT_PASSWORD=root \
  -v mysql-data:/var/lib/mysql \
  mysql:8.0

# 3. 写点数据(进容器执行 SQL 建库建表插一行)
docker exec -it mysql mysql -uroot -proot \
  -e "CREATE DATABASE demo; USE demo; CREATE TABLE t(id INT); INSERT INTO t VALUES(1);"

# 4. 删掉容器------按 8.1,可写层没了
docker rm -f mysql

# 5. 换一个全新容器,接上同一个卷
docker run -d --name mysql2 -p 3306:3306 \
  -e MYSQL_ROOT_PASSWORD=root \
  -v mysql-data:/var/lib/mysql \
  mysql:8.0
docker exec -it mysql2 mysql -uroot -proot -e "SELECT * FROM demo.t;"
# → 数据还在。容器死了,储物柜没死。
8.4 Docker Compose:一页 YAML 启动全家桶
单容器一条 docker run 就够;但一个应用 = MySQL + Redis + 应用本身三四个容器,还要网络互联、卷挂载、环境变量------靠手工敲 docker run 会变成一场灾难,且不可重复。
Docker Compose 的解法:把"所有容器怎么启动"写进一个 YAML 文件,一条命令全部拉起。它的角色定位:开发环境与单机部署的编排工具(多机集群的编排是 K8s,行业地图板块④)。
8.5 动手:Compose 一键起 MySQL + Redis + 应用
任意目录新建 docker-compose.yml:
yaml
services:
  mysql:
    image: mysql:8.0
    environment:
      MYSQL_ROOT_PASSWORD: root
      MYSQL_DATABASE: demo
    volumes:
      - mysql-data:/var/lib/mysql      # 卷(8.2 学的)
    networks:
      - appnet

  redis:
    image: redis:7-alpine
    networks:
      - appnet

  app:
    image: your-app:1.0               # 换成你的 Spring Boot 镜像
    ports:
      - "8080:8080"                   # 总机转接(6.2 学的)
    environment:
      DB_HOST: mysql                  # 直呼容器名------自定义网络的 DNS 通讯录
      REDIS_HOST: redis
    depends_on: [mysql, redis]
    networks:
      - appnet

volumes:
  mysql-data:
networks:
  appnet:
bash
docker compose up -d        # 全家桶一键启动(新版命令;老版本 docker-compose up -d)
docker compose ps           # 看状态
docker compose logs -f app  # 盯日志
docker compose down         # 全停全删(卷默认保留,数据不丢)
注意 YAML 里的每一行都能对上前面各章:volumes → 本章 8.2 节、networks + 容器名互访 → 第 6.4 节、ports → 第 6.2 节的转接链。Compose 不是新魔法,它是把已学机制的"填表"自动化。
9. 总图、自测与下篇预告
9.1 全文收成一句话
一台 Linux 就是一家酒店:一个内核总管(被 CPU 工人们轮流执行)、一群进程客人、一棵文件树、一张 root 万能房卡。容器 = 办了三样特殊服务的普通客人------namespace 换眼睛、cgroups 记额度账、OverlayFS 拼样板房;dockerd = 1 对 n 的经办人;镜像 = 缺了内核的行李包(3 个差异压缩包 + 装箱单 + 说明书);网络 = 总机转接链;安全 = 三道闸门下的"卸了武装的 root"。
9.2 自测题(每题一句话,答案在文末)
- 容器里的应用调用
clone(CLONE_NEWPID)------这个系统调用是谁处理的?镜像里的 glibc 还是宿主机内核? - "dockerd 自己住在一个 namespace 里,所以它也被隔离着"------对吗?
- cgroups 能限制"某容器最多占 10GB 磁盘空间"吗?它到底管什么?
ENV TZ=Asia/Shanghai这行 build 完也拍一张快照,docker history里它是多少 B?为什么?- 镜像 A(ubuntu+redis)先 pull,镜像 B(ubuntu+mysql)后 pull------B 的 ubuntu 30MB 会再下载吗?
- 两个容器各跑 nginx 都监听 80 端口互不冲突------这句话成立吗?为什么?
RUN 下载200M && 安装 && 删除写在同一条 RUN 里,镜像会小吗?拆成两条呢?- 容器里的 root 和宿主机 root 差在哪?(提示:不是差"身份",是差"卡片")
9.3 下篇预告
本文解决的是单台机器 上的一切:容器怎么造、镜像怎么运、网络怎么通、安全怎么守。但"一个代办管一台机器"的天花板就是这台机器------50 台服务器、每台各一位代办,谁来回答"新服务放哪台?机器炸了上面的 30 个容器谁来迁移?"这就是 Kubernetes 登场的空位:它不是更强的 docker,而是站在 n 个本地代办之上的集团总部。
附录:术语速查表(酒店对照版)
| 术语 | 酒店版翻译 | 一句话本质 |
|---|---|---|
| Linux 内核 | 酒店唯一的总管团队 | 唯一有权碰硬件的软件,被 CPU 核心轮流执行 |
| 进程 | 入住的客人 | 正在运行的程序实例,有个 PID |
| 系统调用 | 前台电话 | 用户程序向内核请求服务的唯一通道 |
| 挂载 | 把货架接到树上某枝头 | 数据不动,换个门牌看同一堆数据 |
| /proc、/sys | 实时活页台账 | 内核把状态伪装成文件,读它=实时查询 |
| root / UID 0 | 万能房卡 | 权限在内核逐次系统调用时验证 |
| namespace | 专属楼层 | 隔离"看得见什么",不是资源本身 |
| cgroups | 消费限额账本 | 记账+限额:CPU 工时/内存额度/IO 流速 |
| OverlayFS | 拼样板房 | 只读公共家具 + 可写私人物品叠成完整房间 |
| copy_up | 整件家具搬上楼 | 改下层文件必须先完整复制到可写层 |
| whiteout | 遮挡贴纸 | "删除"=贴一张视而不见贴,空间不减反增 |
| 容器 | 办了三样特殊服务的普通客人 | 被三件套包裹的进程,共享宿主机内核 |
| 镜像 | 缺了内核的行李包 | 差异压缩包们 + manifest 装箱单 + config 说明书 |
| dockerd | 金牌代办 | 普通进程、常驻、1 对 n,没被隔离 |
| containerd | 大堂经理 | 行业通用的容器生命周期管理者,不姓 Docker |
| shim | 楼层管家 | 每容器一位,替容器进程"当爹" |
| runc | 装修队 | 调内核造容器,干完就走 |
| OCI | 插座标准 | Runtime Spec + Image Spec,统一后厂商自由竞争 |
| Registry | 镜像超市 | Docker Hub / Harbor,管存与取 |
| veth / bridge / iptables | 网线 / 交换机 / 总机接线员 | 容器网络三件套 |
| capability | root 的子卡 | root 能力被拆成几十张,容器默认只发 ~14 张 |
| seccomp | 电话白名单 | 默认拦 300+ 高危系统调用 |
附:自测题参考答案
- 宿主机内核 。glibc 只是用户态"发起方";容器共享宿主内核,所以老内核跑新镜像会因缺失新系统调用而失败(典型报错
ENOSYS)。反向成立:老镜像跑新内核永远安全。 - 错。dockerd 是"经办人",普通进程,没有任何隔离待遇;被隔离的只有它办出来的容器。
- 不能。cgroups 管 CPU 工时、内存额度、磁盘 IO 流速;磁盘"容量"是存储的事。它的接口长得像文件(/sys/fs/cgroup),不等于功能是分磁盘。
- 0B。ENV 不碰文件树,只往 config.json 写元数据;快照"多出来的文件"为零。
- 不会。两层指纹相同 = 同一个包,本地已解压就跳过------和 .m2 里 guava 只下一遍同构(内容寻址)。
- 成立。各自独立的网络 namespace = 两套对讲系统里各有一个"80 号分机";对外靠 iptables 转接链(DNAT),容器没有宿主机真实端口。
- 同一条 RUN:真瘦(快照只看期末,下载物不在画面里)。拆两条:没瘦(200M 焊死进第一层快照,第二层只能贴遮挡贴)。
- 容器 root 默认只发 ~14 张 capability 卡,最危险的(改系统、动内核、装设备)全被扣下;再加 seccomp 拦截 300+ 高危系统调用。是"被卸了武装的 root",不是"另一个 root"。