💡 一句话总结 :LitTraceQA 是个较真的评测------不只看答案,还要求你说出答案出自哪篇论文的哪一页、哪个表格、哪条公式,三样分开打分。TRACE 系统在这条赛道拿下 0.7606,却在复盘里承认:论文找对率高达 97%,证据定位只有 68%。差距不在模型聪明与否,而在系统接口一次次「偷换身份」------这就是作者命名的 grounding contract gap(接地契约鸿沟)。
导语:语义正确 ≠ 评分可见
先讲一个所有做 RAG 的人都遇到过、但很少有人系统讨论的现象。
你问一个科研问答系统:「方法 A、B、C、D 在指标 X 上的对比数据是什么?」系统其实检索到了全部四篇论文,最后也给出了正确数字。但在中间某一步,它把四篇论文的检索结果混进了一个全局排序------A 论文的相关段落排第 3,D 论文的相关段落被挤到第 35。融合排序看第 35 名:弱证据,丢弃。于是 D 的数据没答上。
信息明明在语料里,系统也明明「看过」它------但它在评分器可见的形式 上消失了。这就是这篇论文的核心概念:grounding contract gap------语料中可得的信息,与系统以正确身份输出到下游(模型、评分器、用户)的信息之间的落差。
这篇文章是 GroundLM 2026(EMNLP 2026 workshop)LitTraceQA 赛道(2.7 万篇论文候选池)的系统报告,作者 Sachin Gupta 和 Divya Godara 是两位独立研究者------上一期我们刚写过他们的姊妹篇 EVICALC(arXiv 2609.39013),那篇的教训是「证据没进来,算术白算」;这一篇更进一步:证据进来了,但身份不对,照样白干。
想自己动手试?
- 📄 论文:arXiv 2609.38861
- 💻 代码:github.com/sachinkg12/...
这篇论文讲的是什么任务?
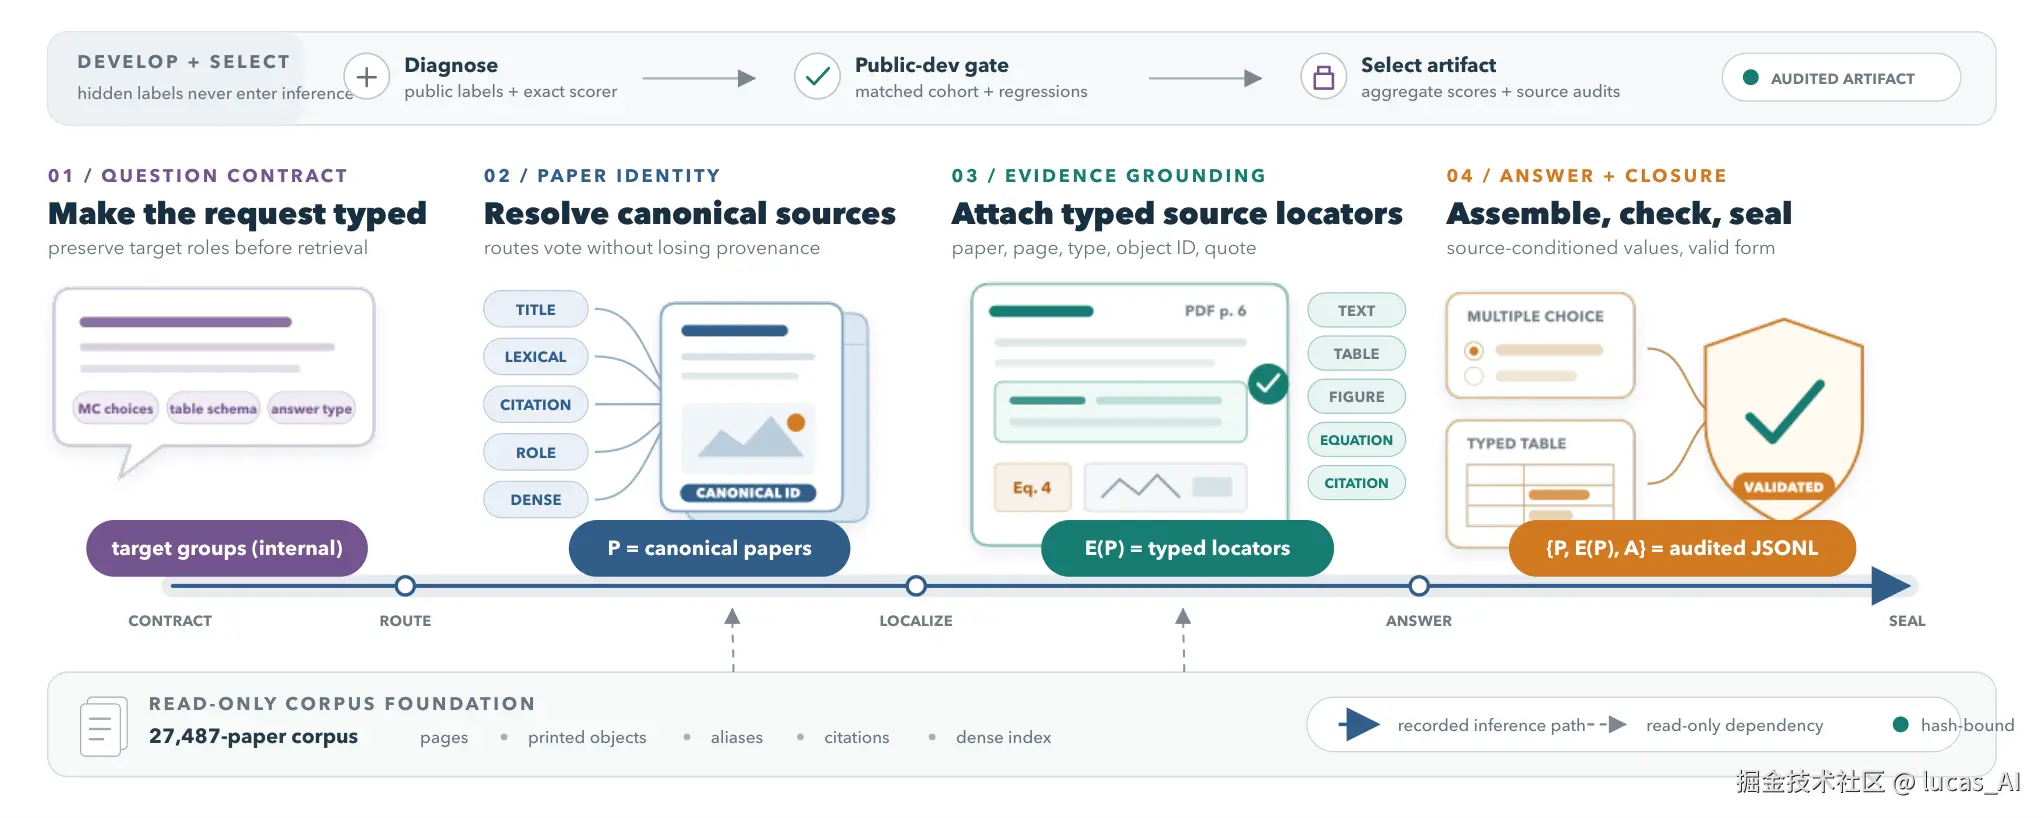
LitTraceQA 的输出不是一段回答,而是一条完整轨迹:
研究问题 → 规范论文 ID 集合 → 这些论文内的类型化证据定位 → 契约一致的类型化答案
证据定位还分类型:文本片段、表格、图、公式/算法、引用上下文,精确到页码或对象 ID。三段轨迹分别计分,证据必须闭合于你选中的论文集合。测试集 71 题(50 道选择题 + 21 道表格题),候选池 27,487 篇论文。
这个设计的杀伤力在于:它惩罚一切「语义上的差不多」。你引到相邻页?错。你把「Eq. (6)」规范化错成另一个公式?错。表格里数字抄对了、但行键用了自己的转述而不是评分器的规范键?还是错。两条轨迹合起来的效果是------模型再聪明,也救不回上游接口丢掉的身份信息。
作者的第一版管线就集齐了三种病:全局排序压扁目标组(上文那个 D 论文的惨案)、只输出答案路径引用过的证据(答案没引用的支持材料全丢)、把每篇论文当一行表格行(把「包含对比的论文」当成了「被对比的方法」)。注意:这三种没有一个是模型能力问题,全是表示失败。
它的思路是什么?
TRACE 的架构可以概括成四件事,每件都在对一种「身份丢失」说不。
第一,目标分组检索:别在排序前抹掉身份。 一个零温度规划器先读题,抽出 venue/年份约束、期望论文数、命名锚点,并给每个提及的名称标注语义角色------是答案目标 、证据锚点 还是约束条件 (比如「只在用了数据集 D 的方法里找」,D 就不该被当成答案返回)。检索走五条路(名称/别名/标题解析、BM25、引用上下文、角色感知信号、密集向量),每条候选都带着完整身份证:哪条路来的、属于哪个目标组、组内第几名、什么角色。组内局部排名是整个设计的命门------全局第 35 名在「第四个方法」的组里可能是第 1 名,平坦融合把这个信息抹掉后,任何加权都救不回来。
第二,独立证据定位:别让答案决定证据。 证据检索与答案生成分开跑:Gemini 2.5 Flash 在有界 PDF 文本上提议类型化定位符(页码 + 规范化的对象 ID,比如「Eq. (6)」「Reference 24」,同时拒绝正文里随便一个数字冒充编号),再按结构有效性、置信度、BM25 相关性排序去重。为什么不用「答案引用了什么就输出什么」?因为那看起来精度很高,实际上把答案没引用的有效支持全砍了------典型的假象精度。
第三,观察单位优先的表格:论文是容器,不是行。 生成表格前先问一个问题:一行代表什么实体 ?从 schema 的行键列判断------键是 Paper Title,这是「论文轴」;键是 Method/Benchmark/Author,这是「实体轴」,此时论文只是承载对比数据的容器。作者举的例子很典型:问四个具名方法的对比,行实体是那四个方法,而不是「恰好包含这张对比表的论文」。提取按源进行、组装按确定性规则进行(键规范化→合并→类型检查→去重),视觉提取的结果要重复一致才被接受。
第四,fail-closed 执行:别让事故悄悄变成提交。 这段是工程党的狂喜:推理前严格预检(71 个唯一查询 ID、27,487 个池 ID、索引字节数、官方文件哈希);只有论文-证据闭合检查和官方验证器都通过,才原子写入结果。为什么这么偏执?因为作者真的踩过坑:空索引、常量标签回退、全空行,这些严重事故产出的都是「schema 合法」的输出------不跑契约检查,你根本分不清「模型答错了」和「管道断了」。
效果到底怎么样?
官方终测(71 题):综合 0.7606。拆开看很有意思:
| 组件 | 得分 | 状态 |
|---|---|---|
| 论文检索 F1 | 0.9728 | 最强组件,未饱和 |
| 选择题准确率 | 0.9800 | 最强组件,未饱和 |
| 证据定位 F1 | 0.6847 | 最大提升空间 |
| 表格行 F1 | 0.5423 | 最大提升空间 |
| 单元格宏平均 | 0.3508 | 最痛的一刀 |
「找到论文」和「给出答案」都接近满分,「证据在哪一行哪一格」却只有三四成------这个断层本身就是论文的论点:拿到源 ≠ 拿到身份。相邻页在语义上没问题,在评分器眼里就是错的定位元组;描述性行键下的正确数字,在评分器眼里就是错的单元格。
开发集上还有个诚实的发现:坐标感知的视觉填充把表格行 F1 从 0.291 提到 0.411,但证据 F1 反而从 0.460 掉到 0.397------收益是有代价的,这种诊断结果拿去当「官方提升」宣传就是造假,作者把它标得清清楚楚。
能拿来做什么?
- 多目标检索系统:检索候选必须携带「哪个目标组 + 组内排名」的完整身份再融合;回答「对比 A/B/C/D」类问题时,先按目标分组配额,再谈全局排序。
- 带引用的问答:证据定位与答案生成分开跑;审引用时要分清「引用文本转写对不对」和「引用的段落选没选对」两件事。
- 表格抽取:动手前先确定行实体;论文/文档是源容器,不一定是观察单位;视觉提取加「重复一致」门控能显著降噪。
- 管道可观测性:数量检查、内容哈希、闭合检查、语义回退遥测------这套 fail-closed 清单可以直接抄进任何「检索 + 托管模型 + 结构化输出」的系统。
泼冷水时间
- 样本很小:表格诊断只有 11 条开发集记录,说明不了官方测试集的提升;71 题的测试集本身也限定了结论强度。
- 不完全可复现:公开配置独立跑只能完整重现 37/71 条记录(差异主要在表格构建),托管 API 的漂移是硬伤;最终 0.7606 的 JSONL 是作为「审计过的 artifact」单独上传的。
- checkpoint 选择用了官方聚合分数:虽然每条修复都只来自源输入(作者特意区分了这两件事),但「看官方分数选版本 + 源证明的增量修复」这套流程,换一个更严格的评测方可能不允许。
- 纯工程系统报告,数字依赖具体任务与评分器;「契约」那套方法论可迁移,分数不可迁移。
理性看待
把这篇和 EVICALC 连起来读会非常有意思------同一对作者,两道题,一个教训的两个面:上一道题里证据从没进来 ,系统对着盆栽花解病毒题;这一道题里证据进来了但身份不对 ,页码差一页、行键换了说法,分数照样归零。合起来的结论朴素得近乎无情:检索-定位-生成这条管道上,模型能力早已不是瓶颈,接口处的表示失败才是。更多模型调用不能可靠地修复身份丢失------作者实测过;显式地把身份信息(目标组、组内排名、规范键、观察单位)做进中间表示,才可以。
评测也在教做人:LitTraceQA 这种「分项计分 + 精确身份」的设计,本质是把「接地」从一句口号变成了可以逐项扣分的契约。当 AI 系统开始被要求「说清楚证据从哪来」时,决定分数的可能不再是模型有多聪明,而是你的管道有没有把每一层身份完整地传递到最后一米。
(数据与结论均来自论文原文,解读部分为作者观点,欢迎交流。)