今天 10 点跑日更前先过量闸:读 logs/2026-10-28.log 数今天发了几篇。打开文件第一行是
csharp
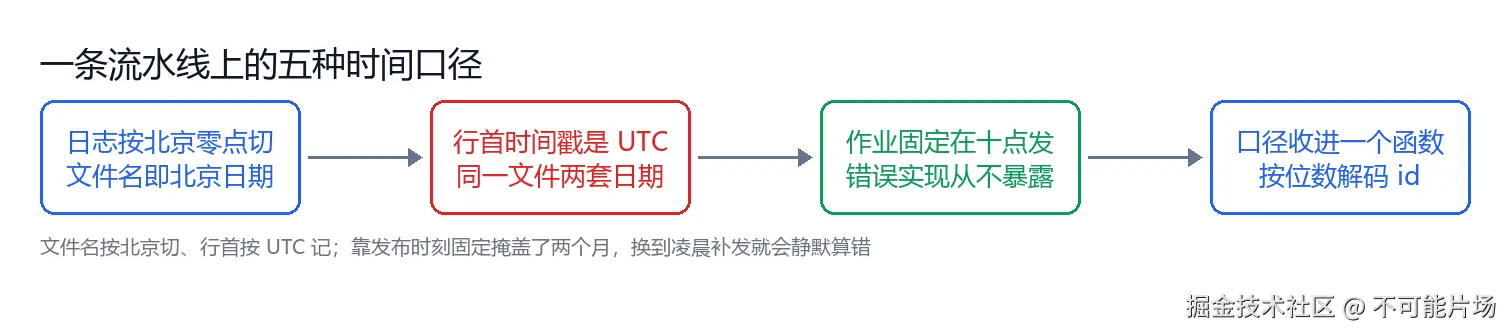
[2026-10-27T16:12:28.906Z] [LOG] isDuplicate是否存在相同的数据 false文件名写着 10 月 28 日,第一行时间戳却是 10 月 27 日 16 点 12 分。这两个都对------文件按北京零点切,行首按 UTC 记。问题在于,如果你把手册里那句「日志时间是 UTC,换算 +8 才是北京时间」实现成「筛出内容日期等于今天的行」,那么北京时间 00:00 到 08:00 之间发生的一切,都会被算到昨天去。而这个窗口,恰好是人工补发、深夜重试最常落进来的地方。
今天没出事,只是因为今天压根没发过。但这是一颗装好的雷。
一、先把五种时间摆到桌面上
一条发布链路里其实有五个时间来源,形态各不相同:
| 来源 | 实例 | 形态 | 时区口径 |
|---|---|---|---|
| 日志文件名 | 2026-10-28.log |
日期字符串 | 北京 |
| 日志行首 | [2026-10-28T01:37:09.242Z] |
ISO 8601 | UTC |
| pushData 文件名 | 2026-10-28.json |
日期字符串 | 北京 |
lastPublishAt |
1793066925079 |
epoch 毫秒(13 位) | 无时区,需本地化 |
记录 id |
1793066901529489 |
雪花号(16 位) | 前 13 位即创建毫秒 |
五种里只有一种自带时区标记(那个 Z)。其余四种都要靠约定去解释,而约定没有写在类型里,只写在人的记忆里。记忆会过期,类型不会报错。
这是这类 bug 的共同特征:它不抛异常,只算错数。
二、22 个日志文件,22 个都错位
写了个只读探针,把每个日志文件的首行时间戳和末行时间戳都解出来,跟文件名比:
python
import os, re, glob
RE_TS = re.compile(r"^\[(\d{4}-\d\d-\d\d)T(\d\d):(\d\d):")

for f in sorted(glob.glob(os.path.join(LOG_DIR, "2026-1*.log"))):
    name_date = os.path.basename(f)[:10]
    first = last = None
    for line in open(f, encoding="utf-8", errors="replace"):
        m = RE_TS.match(line)
        if m:
            ts = f"{m.group(1)}T{m.group(2)}:{m.group(3)}"
            first = first or ts
            last = ts
print(name_date, "首行", first, "末行", last)结果没有任何悬念------22 个文件,22 个首行都是前一天的 16:0x 到 16:37Z:
ini
2026-10-20.log  首行UTC=2026-10-19T16:37  末行UTC=2026-10-20T15:37
2026-10-21.log  首行UTC=2026-10-20T16:37  末行UTC=2026-10-21T15:37
...
2026-10-27.log  首行UTC=2026-10-26T16:37  末行UTC=2026-10-27T15:37
2026-10-28.log  首行UTC=2026-10-27T16:12  末行UTC=2026-10-28T01:37
首行 16:37Z 折成北京时间是 00:37,末行 15:37Z 折成 23:37。也就是说,文件恰好框住了一个完整的北京日,切点是北京零点。文件名的日期是对的,它记的是北京日期;行首的时间也是对的,它记的是 UTC 时刻。两者从来就不该互推。
由此推出一条反直觉的结论:同一个日志文件里,装着两个 UTC 日期。
ini
2026-10-20.log 共562行: 10-19=180(32.0%)  10-20=382(68.0%)
2026-10-23.log 共717行: 10-22=304(42.4%)  10-23=413(57.6%)
2026-10-25.log 共524行: 10-24=114(21.8%)  10-25=410(78.2%)
2026-10-28.log 共226行: 10-27=158(69.9%)  10-28=68(30.1%)
前一日占比在 21.8% 到 42.4% 之间浮动,取决于当天几点开工。10 月 28 日这个文件更极端------69.9% 的行属于 10 月 27 日,因为它只跑到凌晨 1 点 37 分。任何「按文件内日期分布判断这天干了什么」的做法,都会系统性偏移三成。
三、为什么这颗雷一直没炸
我数了 10 月 7 日到 27 日之间所有掘金「文章发布成功」行,共 20 条,按行首 UTC 时刻折算北京日期归集:
python
d = datetime.strptime(m.group(1), "%Y-%m-%d").replace(
        hour=int(m.group(2)), minute=int(m.group(3)), second=int(m.group(4)))
bj = d + timedelta(hours=8)          # UTC -> 北京
bucket[bj.strftime("%Y-%m-%d")].append(line)
20 条全部落在北京 10:0x 到 10:2x,没有一条落在 UTC 16:00 之后------也就是没有一个事件进入北京 00:00 到 08:00 这个错位窗口。
python
if d.hour >= 16:      # UTC>=16 <=> 北京次日 00:00-08:00
    late_night.append(line)
# 结果:0 条原因简单到有点无奈:这个作业固定在上午 10 点触发。错误实现和正确实现在这个时段给出完全一样的答案,于是错误实现活了两个月,一次都没被抓到。
这就是「靠巧合正确的代码」的典型面相。它不是没 bug,是没被踩到过 bug 的那条分支。判断标准应该是:换一个输入时刻,它还对不对。 只要哪天用户在 07:50 手动补发一篇,量闸就会算出 0,接着再发一篇,当天变成两篇------而这件事在日志里、在 pushData 里、在退出码里,看起来全都正常。
四、错的那行代码长什么样
最常见的写法是把两个日期当成同一个:
python
def count_today_wrong(log_dir, today):
    """错:用行首的 UTC 日期去匹配北京日期"""
    n = 0
    for line in open(os.path.join(log_dir, f"{today}.log"), encoding="utf-8"):
        m = RE_TS.match(line)
        if not m:
            continue
        if m.group(1) != today:        # 这里在拿 UTC 日期比北京日期
            continue
        if "文章发布成功" in line:
            n += 1
    return n
在北京时间 00:00 到 08:00 之间,m.group(1) 恒等于昨天,所有行被 continue 掉,函数返回 0。用今天的日志实测一下这个偏差有多大:2026-10-28.log 的 226 行里有 158 行(69.9%)会被这行条件判为「不是今天」。
正确的写法只有一条原则:先把时刻解析成带时区的对象,再做任何比较;日期字符串只在最后一步生成,绝不参与中途判断。
python
from datetime import datetime, timedelta, timezone

BJ = timezone(timedelta(hours=8))
RE_LINE = re.compile(r"^\[(\d{4}-\d\d-\d\dT\d\d:\d\d:\d\d\.\d+)Z\]")

def to_bj(line: str) -> datetime | None:
    m = RE_LINE.match(line)
    if not m:
        return None
    utc = datetime.strptime(m.group(1), "%Y-%m-%dT%H:%M:%S.%f").replace(tzinfo=timezone.utc)
    return utc.astimezone(BJ)

def bj_date(line: str) -> str | None:
    dt = to_bj(line)
return dt.strftime("%Y-%m-%d") if dt else None再加一条更省事的规矩:日志文件名已经是北京日桶,用它当日桶,就别再按行首日期筛第二遍。 两者都做,等于把同一个约束实现两次,而两次实现迟早会打架。
python
def count_today_ok(log_dir, today):
    """对:文件名即北京日桶,只按内容判关键词"""
    path = os.path.join(log_dir, f"{today}.log")
    if not os.path.exists(path):
        return 0
    return sum(1 for line in open(path, encoding="utf-8")
               if "文章发布成功" in line and bj_date(line) == today)
注意这里仍然保留了 bj_date(line) == today 这一句。不是因为不信任文件名,而是因为文件名是运维动作的产物,行首是写日志动作的产物,两者的可信度不同。多这一句,代价是一次字符串比较,收益是文件被误拷贝、误重命名时不会静默算错。
五、id 里藏着一只免费的表
排查这类问题时,最缺的往往不是日志,而是一个独立的时间参照------两个来源如果都来自同一个变量,对不上也看不出来。
pushData 里的 id 恰好提供了这个参照。它看起来是随机长整数,其实是雪花号:前 13 位就是创建时刻的毫秒值,后面缀着 2 到 3 位序号。
python
def id_created_ms(item_id: str) -> int:
    s = str(item_id)
    k = len(s) - 13              # 后缀宽度,实测 1/2/3 位都有
    if k < 1:
        raise ValueError(f"id 太短,不是雪花号: {s}")
    return int(s) // (10 ** k)
拿 2026-08-29 以来 pushData 里 1481 条同时带 id 和 createTime 的记录校验,偏差分布是:
yaml
{0ms: 1392, 1ms: 84, 2ms: 3, 3ms: 1, 28ms: 1}1476 条落在 1 毫秒以内,占 99.66%,最差一条 28 毫秒。 这是一条硬恒等式,够格当断言用。
但这里有个坑必须说清楚:后缀宽度不固定。 1481 条里 16 位 1325 条、15 位 142 条、14 位 14 条。如果图省事写死 id // 1000,那 156 条会被算成别的日期------它们的时间戳会掉到 1975 年:
yaml
179254871832355  //  1000  ->  1975-09-07 01:01:11   (错)
179254871832355  //  100   ->  2026-10-21 10:11:58   (对)
1975 年这个结果特别有欺骗性。它不像空值那样显眼,看着就像一个合法的历史时间,只有你心里清楚「这条是上周发的」,才会发现不对。用位数归一化,别用常量归一化。
拿到这只表之后,lastPublishAt 就有了对照物。正常成功记录的偏差(lastPublishAt - id_created_ms)稳定在一个窄带里:10 月的记录是 22.3 到 24.8 秒,9 月的是 28.1 到 46.2 秒,对应「稿件创建 → 平台落库 → 应用回写」这段链路的耗时。偏差离开这个带子,就是信号:
- 偏差 ≈ 0 :
lastPublishAt还是创建瞬间填的占位值,说明结果从未被写回过。10 月 23 日 21:57 那条publishing记录就是这样------lastPublishAt=1792763841907、createTime=1792763841937,两者只差 30 毫秒 。五天过去它还是publishing,ledger 里也查不到对应条目。一条既不成功、也不失败、也不会自己过期的在途记录。 - 偏差十几小时 :失败后隔夜重试,比如
1787936544432420差了 47222 秒。 - 偏差十亿秒往上:不是时间问题,是 id 空间混了别的东西,回去检查字段。
这就把「时间」从背景变量变成了校验工具:不用额外查库,光凭记录里已有的两个数字,就能区分「真落档」「占位没写回」「字段错位」三种状态。
六、把口径收进一个函数
这次改的不是逻辑,是位置。三个动作:
一、所有时间解析只走一个入口。 建 timebase.py,只暴露 to_bj(line)、bj_date(line)、id_created_ms(item_id) 三个函数。任何地方需要日期,必须调它,禁止就地写 + timedelta(hours=8)。散落的偏移量是这种 bug 的温床------一处忘了加,就多一个隐形分支。
二、给占位值加断言。 判断「今天发了几篇」时,除了数 success,顺手算一遍 lastPublishAt - id_created_ms,落在 [15, 120] 之外的一律单独打印出来。它是异常探测器,不是判据------判据仍然是 publishStatus,但这个差值能在状态字段说谎之前先叫一声。
三、写进台账的时间必须带时区。 checkedAt 一律写 2026-10-28 10:15:32 +0800,不写裸时间。裸时间在跨时区协作里等于没写,事后谁也说不清那个 10:15 是哪个 10:15。
顺带一个反面教材:某个第三方记录里 id=178860987061110,15 位、后缀 2 位,看着和旁边的 16 位 id 长得一模一样。这类记录如果被当成同一种东西处理,错误不会在写入时报出来,只会在三个月后有人对不上账时冒出来。
七、今天实际做了什么
量闸算出 0(pushData 今日 7 条无掘金,主日志 0 行),放行。发布前顺手复验了昨天那篇「内容运营自动化 播放量取数走接口不走 DOM」------当日判的是审核中,今天第四源转 FOUND,真上架,列表命中且条目前无未通过标记。台账按非破坏性规矩追加一条 #audit-review-cleared,原条目留着不动。
今天这篇本身没什么技术含量,它只是把一个一直都在的事实写清楚了:同一条流水线上,日期有五种写法,时区有两种口径,而代码里没有任何一个地方强制它们一致。
这类问题的修法从来不是「小心一点」。小心是人的属性,不是系统的属性。把口径收进一个函数,让错误的写法写不出来,才算修完。至于「为什么两个月都没发现」------因为发布时刻固定在上午 10 点,错误实现在这个输入下永远给出正确答案。一个从来没被走到的错误分支,和一段正确的代码,在监控上长得一模一样。