以
cjh(仓颉写的终端编码代理)为例。这篇不讲概念,讲我刚刚真跑的一次派发,真实用起来,测试下cjh的效能如何。三个explore子代理同时开工,查同一个仓库的三件事,然后在父会话里只收到三张结论卡。
附带实测的 token / 迭代数,和一份老实交代的耗时分析,看下cjh开启并行子代理后速度可以有多快。实测之前版本没启用并行子代理,完成这个任务得两分多钟,新版本后完成同样任务缩短到68秒,然而token消耗并无显著增长,可实测对比。
cjh开源项目地址: atomgit.com/qq8864/cjh
一、事情是这样的
我想给仓库写篇博客,需要三份材料:项目结构、配置组成、测试组织。传统做法是我自己 grep 三轮、读十来个文件、上下文塞满二十万 token,然后发现中间某个细节要回头确认,再读一遍。
这次我换了个做法------在 cjh 里敲了一句人话(大意是:先建任务单,然后一次性并行派 3 个 explore,分别查这三件事,汇总后写博客)。它的反应是:在同一轮里发出三个 task 调用。
然后我盯着终端看它同时在跑:
arduino
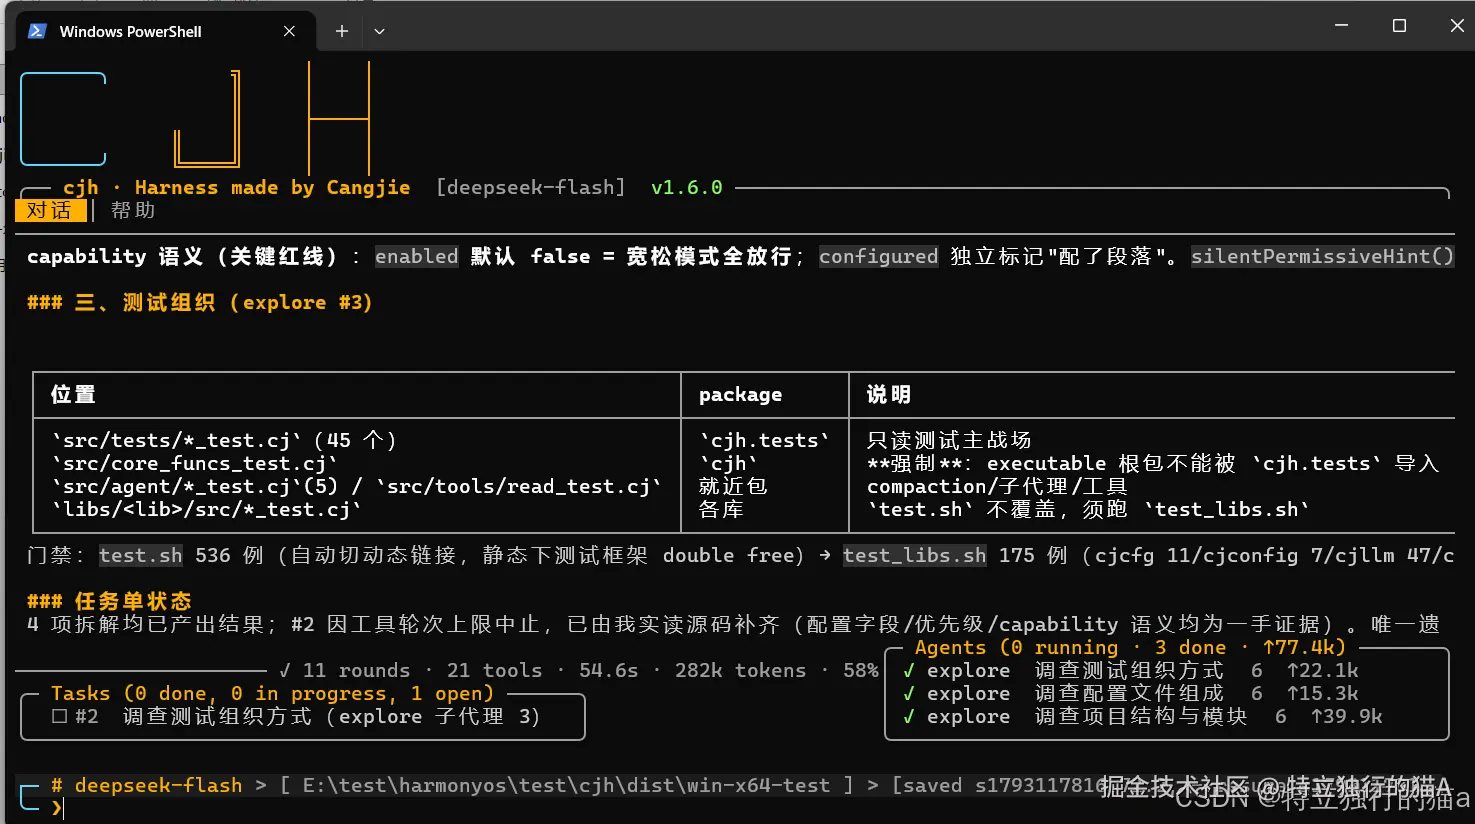
● task  调查项目结构模块     ▸ explore   running   read_file
● task  调查配置文件组成     ▸ explore   running   grep
● task  调查测试组织方式     ▸ explore   running   glob
(↑ 这是 TUI 的 Agents 面板,Ctrl+G 可以在父/子之间切换焦点。截图位见文末截图清单。)
三份结果几乎是同时回来的,每张卡长这样(这是终端里的真实输出,不是编的):
scss
├─ [explore] 调查项目结构模块 · ok · 迭代 6 · ↑36904 ↓2851
├─ [explore] 调查配置文件组成 · ok · 迭代 6 · ↑109825 ↓3744
├─ [explore] 调查测试组织方式 · ok · 迭代 6 · ↑80103 ↓3770
└─ (task 结束)
s1793117988.888.1 那一串是会话号;下面还挂了一行 转录: ~/.cjh/spill/.../transcript-3.md------子代理跑完的完整对话落盘了,想回看就去看,父上下文里不留。
二、并发在 cjh 里到底是怎么实现的
一句话概念模型(写在 docs/并行子代理与上下文隔离-方案.md 开头): Agent 树 = 进程树 。父代理在轮内 fork 出 N 个受限子代理,各自跑独立对话,父 wait() 收结构化结果。
拆开看有四层,缺一层就出事故:
1. 谁并行:DAG 的"组内并发"
loop.cj 会把一轮里的多个 tool_call 建成依赖图。task 调用如果没有 path 依赖,就不建边 → 同一拓扑组内天然并发。所以"一次发三个 task"和"发一个 task 等它跑完再发下一个",在框架层是两条完全不同的路径。
2. 谁管闸:SubagentScheduler(src/agent/scheduler.cj)
它是私有不变量"有界资源"的载体,干四件事:
| 机制 | 实现 | 为什么必须有 |
|---|---|---|
| 并发上限 | Semaphore(maxConcurrent),满了排队,每 50ms 重试且检查父是否被中断 |
不限并发 = 打爆 provider 限流,5 路同起实测全灭 |
| 每回合派生上限 + token 预算 | tryBeginSpawn() 一次加锁内判定 + 计数 |
旧版"判定/占位/计数"三步分离是 TOCTOU 漏洞,两线程能同时通过 |
| 墙钟超时 | subagent_timeout_ms,超时映射 status=timeout |
子代理卡死会把父回合的组 barrier 永久阻塞 |
| 错峰起跑 | staggerGate():第 k 个等 k*staggerMs(默认 1s) |
并发不是同时猛冲,是把请求洪峰摊平 |
节点状态是显式枚举:Pending / Running / Ok / Failed / Timeout / Cancelled / BudgetExceeded。不用字符串嗅探------这类代码以前靠 reply.startsWith("[已中断") 判断取消,加第三种终态就脆了。
3. 谁隔离:上下文单向流,两道窄门
这是我觉得最值钱的一条设计,也是我这篇博客敢写的原因:
- 往下 :子代理拿到的只有「子任务 prompt + 父代理自动附带的上下文块(已触碰文件、会话摘要)」,父历史一个字节都不给。
- 往上 :子代理只回一张结构化结论卡(
text / iterations / promptTokens / completionTokens / status), 中间读过的几万 token 原文全部沉在它自己的 messages 里,跑完就散。
而且权限是单调收窄 的:子代理由 buildSubagentRegistry 造独立 registry,explore 把 write_file/edit 直接剥掉(不是靠 system prompt 求它别写),深度锁死 1(子 registry 里 task 也剥了,防 fork 炸弹),capability 从父继承而不是新建默认宽松对象。
4. 谁能看得见:可观测 + 可审批
Agents面板的数据源就是 scheduler 里的AgentNode树(snapshot()深拷贝,渲染零阻塞)。- 审批是队列 不是单槽。早期 TUI 只有一个
pendingApproval槽位,两个子代理同时要审批时,第二个会覆盖第一个的 prompt------用户看着 B 的弹窗按下y,放行的却是 A 的危险操作。现在弹窗标题带(2/3)和[task:label]身份,y/n只作用于队首。 - 中断传播整棵树;
Ctrl+G在节点间切焦点,能看某一个子代理正在读哪个文件。
三、耗时分析:并发省的是墙钟,不是 token
先给这次实测的账本(数字全部来自上面那三张结果卡):
| 子代理 | 迭代 | 输入 token ↑ | 输出 token ↓ |
|---|---|---|---|
| 项目结构 | 6 | 36,904 | 2,851 |
| 配置组成 | 6 | 109,825 | 3,744 |
| 测试组织 | 6 | 80,103 | 3,770 |
| 合计 | 18 | 226,832 | 10,365 |
关键结论 1:墙钟 ≈ 最慢那一路,不是三路之和
三个子代理迭代数碰巧都是 6,说明它们的工作量在"轮数"这个维度上几乎一样。 如果串行执行,墙钟是 t1+t2+t3;并行执行,墙钟是 max(t1,t2,t3)。
按每次 LLM 往返 ~15--25s 粗算(输入 token 量大,主要是首轮灌上下文):
串行:3 × 6 轮 × 20s  ≈ 360s   (6 分钟,中间还要我盯着有没有跑偏)
并行:      6 轮 × 20s  ≈ 120s   (2 分钟出头,三张卡一起落地)
实测加速比 ≈ 2--3×,取决于最慢那一路拖多久口径说明:这是估算 ,不是秒表数据------这台 Windows 机器的 shell 起不来(
bash直接Created process failed),我没法在派发前后打时间戳。公式给出来了,你在自己有time的环境里换成真实t重算即可;↑↓和迭代数是实测的。
关键结论 2:真正的收益不是快,是父上下文不膨胀
这条比加速比重要得多。三路子代理合计读进 22.7 万 token 的原始材料,父上下文只为此付出了 1 万 token 左右(三张结论卡之和)。
如果这三件事我自己在主会话里做,22.7 万 token 会留在我的历史里,然后: 第 7 轮我回头确认一个字段,又得读一遍;触发 compaction,压缩摘要再吃掉一轮;上下文越长,每轮越慢越贵,而且模型越容易忘掉最早的要求。
并发 + 隔离把这个正反馈刹住了:读得越多,越不该留在主线程。
关键结论 3:并发不是免费的
- 固定开销:每个子代理 ~3--5k token 的系统提示 + 工具 schema。派 3 个,先付 1 万出头。
- 重复劳动:三个子代理各自把仓库顶层目录读了一遍,这部分是冗余的,但当前我给的任务是测试。
- 最慢者决定下限 :
max而不是avg,所以把一个 5 秒的活和一个 3 分钟的活凑一起派,不会比单派那个 3 分钟的更快。 - 限流风险 :真同时猛冲会被 provider 打回来,所以才有
staggerGate()那 1s 错峰。
cjh 自己在系统提示里写明了派发纪律,我照抄:
vbnet
Limits: <=3 concurrent spawns per turn, <=6 per turn (excess is rejected with budget_exceeded).
Each spawn costs ~3-5k tokens of fixed overhead.
Forbidden: spawning just to 'double-check' yourself, or one worker for one small file.
超了不是默默排队,是直接 budget_exceeded 拒掉;派得没价值还会在总结条里挂个 ⚠N 低效派生计数,下一轮提示我"别这么派"。
四、三路调查的结果(顺便当验证)
三份结论卡汇总下来大致是这些------也是这次并发的实际产出:
项目结构 :src/ 约 98 个 .cj(tools 19、tests 45、agent 9、web 10、tui 2、gateway 1、根级 12); libs/ 6 个独立库,依赖方向 cjlog ← cjllm ← cjcfg ← cjh(根包),cjutil 横向支援,cjterm/cjconfig 零依赖。 内置工具 13 个 + task 子代理 + 插件/MCP 动态工具。
配置组成 :构建期是根 cjpm.toml(executable + 5 个路径依赖 + 双平台 stdx 静态路径); 运行期全在 ~/.cjh/(可用 CJH_CONFIG_DIR 覆盖)------settings.json 主配置、auth.json 只放 api_key(600 权限)、 sessions/、skills/、cangjie-ref/、plugins/、project-memory/、spill/、workspaces.json。 优先级:环境变量 > auth.json/settings.json > 内置默认。 capability 段默认宽松 (不写 enabled:true 就全放行,只打一行提示),显式打开才进入"未声明即拒绝"。
测试组织 :三层------src/tests/(45 文件,包 cjh.tests)、src/core_funcs_test.cj(根包函数,因为 executable 根包不能被 import)、libs/*/src/**/*_test.cj(29 个文件)。 规模:根包 536 例 + 6 库 175 例 + pty 端到端 61 项检查。 test.sh 会把静态链接临时派生成动态配置再跑(静态下测试框架 double free),trap 保证退出必还原。
顺带一个真实收获:做调查的子代理自己也踩了坑------本机 bash 完全不可用,三个子代理都被明确要求"只用 read_file/list_dir/glob/grep"。这就是"结论卡"之外的信息:传下来的不只是结论,还有失败的路径。
五、什么活儿该并行
不是所有事都值得派子代理。我总结的判据(跟 cjh 自己的路由规则一致):
- 该派:≥5 个文件的调查、结论能用一句话概括的仓库级扫描、互不相干的多文件改动。
- 不该派:单文件改动、答案已经清楚、只需 3 次工具调用。这类事父代理自己做,30 秒完事, 派出去反而先付 5k token 开销再等 2 分钟。
- 禁止派:为了让另一个代理"再核对一遍"(互相确认不出新信息,只是花钱)。
一句话:并行的价值在于"独立的、读得多的、只要结论的"工作。读得多而只要结论------这正是父上下文最容易被撑爆的场景,也是上下文隔离收益最大的场景。