🖊 人不光是靠他生来就拥有一切,而是靠他从学习中所得到的一切来造就自己。 ------ 歌德
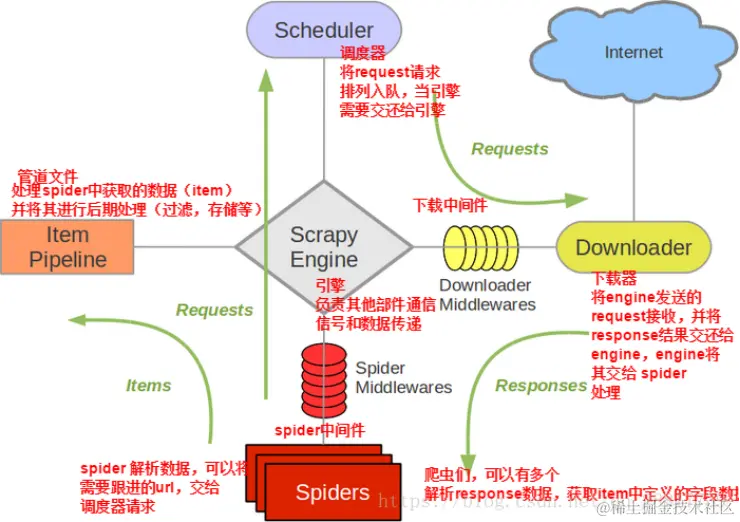
框架原理图
阐述scrapy框架运行逻辑
安装scrapy
- python版本:3.8.12 【linux系统安装教程】
txt
   # 在指定目录下下载python3.8.12安装包
   wget https://www.python.org/ftp/python/3.8.12/Python-3.8.12.tgz
   # 编译python3.8.12安装包
   ./configure --prefix="你要安装的目录"
   # 进入目录下进行编译
   make & make install
   # 将安装的python命令软连接到/usr/bin目录下
   ln -s 安装目录/bin/python3 /usr/bin/python
   ln -s 安装目录/bin/pip3 /usr/bin/pip

   以上是在深度系统下的安装逻辑

   windows下,找官网下载安装exe文件
   https://www.python.org/downloads/windows/
- 安装scrapy:pip install scrapy==2.5.1(需要安装的版本号)
常用命令介绍
- 创建项目: Scrapy startproject 项目名称
txt
scrapy startproject baidu-spider- 创建爬虫: scrapy genspider 爬虫名称 目标网站域名
txt
scrapy genspider baidu-item-spider www.baidu.com- 查看当前项目爬虫: scrapy list
txt
scrapy list- 运行爬虫: scrapy crawl 爬虫名称
txt
scrapy crawl baidu-item-spider目录介绍
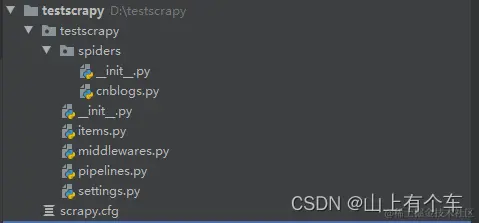
txt
firstscrapy         # 项目名
   firstscrapy     # 文件夹
        spiders     # 文件夹,一个个的爬虫
            cnblogs.py # 其中一个爬虫,重点写代码的地方(解析数据,发起请求)
        items.py    # 类比djagno的models,表模型
        middlewares.py # 中间件:爬虫中间件和下载中间件都在里面
        pipelines.py   # 管道,做持久化需要在这写代码
        settings.py    # 配置文件
   scrapy.cfg    # 上线配置,开发阶段不用
爬虫解析数据
分析数据写在爬虫文件中的parse方法里(spiders下的爬虫文件)
response对象有css方法和xpath方法
- css中写css选择器
- xpath中写xpath选择
- BeautifulSoup选择器(我们一般用的)
示例代码
py
import scrapy

class CnblogsSpider(scrapy.Spider):
    name = 'cnblogs' # 爬虫名字
    allowed_domains = ['cnblogs.com'] #爬取网址名
    start_urls = ['http://cnblogs.com/'] # 爬取的url

    def parse(self, response):
        articles = response.xpath('.//article[@class="post-item"]') # 找到article标签
        for article in articles: # 对每一个article标签中再次查找标签
            title = article.xpath('.//a[@class="post-item-title"]/text()').extract_first()
            url = article.xpath('.//a[@class="post-item-title"]/@href').extract_first()
            desc = article.xpath('.//p[@class="post-item-summary"]/text()').extract()
            author = article.xpath('.//footer[@class="post-item-foot"]/a/span/text()').extract_first()
中间件(middleware)介绍
下载器中间件(downloadmiddleware)
介于Scrapy的request/response处理的钩子框架,是用于全局修改Scrapy request和response的一个轻量、底层的系统(用的多)
ini
DOWNLOADER_MIDDLEWARES = {
    'cnblogs.middlewares.CnblogsDownloaderMiddleware': 543,
}-
process_request(request,spider): 下载器发起请求前被调用(拦截请求)
-
返回值介绍
- None:Scrapy 将继续处理该 request,执行其他的中间件的相应方法,直到合适的下载器处理函数(download handler)被调用,该 request 被执行(其 response 被下载)
- Response 对象:Scrapy 将不会调用 任何 其他的 process_request()或 process_exception()方法,或相应地下载函数; 其将返回该 response。已安装的中间件的 process_response()方法则会在每个 response 返回时被调用
- Request 对象:Scrapy 则停止调用 process_request 方法并重新调度返回的 request。当新返回的 request 被执行后, 相应地中间件链将会根据下载的 response 被调用
- raise IgnoreRequest:如果抛出 一个 IgnoreRequest 异常,则安装的下载中间件的 process_exception() 方法会被调用。如果没有任何一个方法处理该异常, 则 request 的 errback(Request.errback)方法会被调用。如果没有代码处理抛出的异常, 则该异常被忽略且不记录(不同于其他异常那样)
-
-
process_response(request, response, spider): 拦截所有的响应
-
返回值介绍
- Response对象:响应将继续使用 process_response() 链中的下一个中间件
- Request 对象:中间件链将暂停,返回的请求将重新计划为将来下载
- IgnoreRequest异常:请求的errback函数 (Request.errback )。如果没有代码处理引发的异常,则忽略该异常,不记录该异常(与其他异常不同)
-
-
现有的爬虫中间件
- scrapy_scheduler_rabbitmq.middleware.RabbitMQMiddleware:监控rabbtmq队列中间件
- HttpProxy: 代理池中间件
- RandomUserAgent:UA中间件
- gerapy_pyppeteer.downloadermiddlewares.PyppeteerMiddleware:浏览器渲染中间件
爬虫中间件(spidermiddleware)
主要功能是在爬虫运行过程中进行一些处理(了解即可,用的少)
py
SPIDER_MIDDLEWARES = {
    'cnblogs.middlewares.CnblogsSpiderMiddleware': 543,
}-
常见函数
- process_spider_input(response, spider):在spider生成request发送给scheduler之前,对request进行处理
- process_spider_output(response, result, spider):在spider生成request发送给item pipeline之前,对item进行处理
- process_spider_exception(response, exception, spider):处理异常
- process_start_requests(start_requests, spider):在downloader生成request发送给spider之前,对request进行处理
-
注意:该类中间件在目前项目中并没有用到
管道(pipeline)介绍
当Item在Spider中被收集之后,它将会被传递到Item Pipeline,这些Item Pipeline组件按定义的顺序处理Item
应用场景
-
验证爬取的数据(检查item包含某些字段,比如说name字段)
-
查重(并丢弃)
-
将爬取结果保存到文件或者数据库中
配置介绍
- 基础配置
bash
#1  是否遵循爬虫协议,默认为True
ROBOTSTXT_OBEY = False

#2 LOG_LEVEL 日志级别
LOG_LEVEL='ERROR'  # 报错如果不打印日志,在控制台看不到错误

# 3 USER_AGENT
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/103.0.0.0 Safari/537.36'

# 4 DEFAULT_REQUEST_HEADERS 默认请求头
DEFAULT_REQUEST_HEADERS = {
   'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8',
   'Accept-Language': 'en',
}

# 5 SPIDER_MIDDLEWARES 爬虫中间件
SPIDER_MIDDLEWARES = {
    'cnblogs.middlewares.CnblogsSpiderMiddleware': 543,
}
# 6 DOWNLOADER_MIDDLEWARES  下载中间件
DOWNLOADER_MIDDLEWARES = {
    'cnblogs.middlewares.CnblogsDownloaderMiddleware': 543,
}

# 7 ITEM_PIPELINES 持久化配置,配置数据持久化方式(如文件、数据库等)
ITEM_PIPELINES = {
    'cnblogs.pipelines.CnblogsPipeline': 300,
}- 增加效率配置
bash
#1 增加并发:
#默认scrapy开启的并发线程为32个,可以适当进行增加。在settings配置文件中修改
CONCURRENT_REQUESTS = 100
#值为100,并发设置成了为100。

#2 降低日志级别:
#在运行scrapy时,会有大量日志信息的输出,为了减少CPU的使用率。可以设置log输出信息为INFO或者ERROR即可。在配置文件中编写:
LOG_LEVEL = 'INFO'

# 3 禁止cookie:
#如果不是真的需要cookie,则在scrapy爬取数据时可以禁止cookie从而减少CPU的使用率,提升爬取效率。在配置文件中编写:
COOKIES_ENABLED = False

# 4 禁止重试:
#对失败的HTTP进行重新请求(重试)会减慢爬取速度,因此可以禁止重试。在配置文件中编写:
RETRY_ENABLED = False

# 5 减少下载超时:
#如果对一个非常慢的链接进行爬取,减少下载超时可以能让卡住的链接快速被放弃,从而提升效率。在配置文件中进行编写:
DOWNLOAD_TIMEOUT = 10 #超时时间为10s
持久化方案
第一种:parse返回值(很少使用)
解析函数中parse,要return {},{},{},返回一个列表套字典的数据
py
    def parse(self, response):
        articles = response.xpath('.//article[@class="post-item"]')
        article_list = []
        for article in articles:
            item = CnblogsItem()
            title = article.xpath('.//a[@class="post-item-title"]/text()').extract_first()
            url = article.xpath('.//a[@class="post-item-title"]/@href').extract_first()
            desc = article.xpath('.//p[@class="post-item-summary"]/text()').extract()
            author = article.xpath('.//footer[@class="post-item-foot"]/a/span/text()').extract_first()
            article_list.append({'title':title, 'url':url, 'desc':desc, 'desc':desc, 'author':author, })
        return article_list
第二种:pipline模式(通用的)
- 在items.py中写一个类,继承scrapy.Item 在类中编写属性
py
    import scrapy

    class CnblogsItem(scrapy.Item):
        title = scrapy.Field()
        desc = scrapy.Field()
        pub_time = scrapy.Field()
        author = scrapy.Field()
        url = scrapy.Field()
content = scrapy.Field()- 在爬虫中导入类,实例化得到对象,把要保存的数据放到对象中
py
        import scrapy
        from scrapy import Request
        from testscrapy.items import CnblogsItem

        class CnblogsSpider(scrapy.Spider):
            name = 'cnblogs'
            allowed_domains = ['cnblogs.com']
            start_urls = ['http://cnblogs.com/']

            def parse(self, response):
                articles = response.xpath('.//article[@class="post-item"]')
                for article in articles:
                    item = CnblogsItem()
                    title = article.xpath('.//a[@class="post-item-title"]/text()').extract_first()
                    url = article.xpath('.//a[@class="post-item-title"]/@href').extract_first()
                    desc = article.xpath('.//p[@class="post-item-summary"]/text()').extract()
                    author = article.xpath('.//footer[@class="post-item-foot"]/a/span/text()').extract_first()
                    res_desc = desc[0].replace('\n', '').replace(' ', '')
                    if not res_desc:
                        res_desc = desc[1].replace('\n', '').replace(' ', '')
                    item['title'] = title
                    item['url'] = url
                    item['desc'] = desc
                    item['author'] = author
                    item['desc'] = res_desc
                    # 由于需要拿到文章正文,再次发送request,url为request的爬取地址,callback为解析数据的函数,meta为需要传递过去的参数
yield item- 修改配置文件,指定pipline,数字表示优先级,越小越大
py
        ITEM_PIPELINES = {
                   'crawl_cnblogs.pipelines.CrawlCnblogsPipeline': 300,
}-
写一个pipline:CrawlCnblogsPipeline
- open_spider:数据初始化,打开文件,打开数据库链接
- process_item:真正存储的地方
- 一定不要忘了return item,交给后续的pipline继续使用
- close_spider:销毁资源,关闭文件,关闭数据库链接
py
        # 数据持久化文件形式
        class CnblogsFilePipeline:
            def open_spider(self, spider):
                # print(spider)  # 就是爬虫类的对象
                # print(type(spider))  # 就是爬虫类的对象
                print('open')
                # 打开文件,链接数据库
                self.f = open('cnblogs.txt', 'w', encoding='utf-8')

            def close_spider(self, spider):
                # print(spider)  # 就是爬虫类的对象
                # print(type(spider))  # 就是爬虫类的对象
                print('close')
                # 关闭文件,关闭数据库
                self.f.close()

            def process_item(self, item, spider):
                # 具体存数据,存文件
                # with open('cnblog.txt', 'a', encoding='utf-8') as f:
                #     f.write('标题:%s,作者:%s' % (item['title'], item['author']))
                # print(item)
                self.f.write('标题:%s,作者:%s\n' % (item['title'], item['author']))

                return item  # 一定不要忘了返回
py
 import pymysql

        class CnblogsMysqlPipeline:
            def open_spider(self, spider):
                self.conn = pymysql.connect(user='root',
                                            password="密码",
                                            host='127.0.0.1',
                                            port=3306,
                                            database='cnblogs')
                self.cursor = self.conn.cursor()

            def close_spider(self, spider):
                # self.conn.commit()
                self.cursor.close()
                self.conn.close()

            def process_item(self, item, spider):
                sql = 'insert into article (title,`desc`,url,pub_time,author,content) values (%s,%s,%s,%s,%s,%s)'
                self.cursor.execute(sql, args=[item['title'], item['desc'], item['url'], item['pub_time'], item['author'],
                                               item['content']])
                self.conn.commit()

                return item  # 一定不要忘了返回