22 · MoE FFN 位级镜像收口:整模型逐层 L2 全等达成
一句话 :承接 第 18 篇 留下的残项(全 GPU decode 的 MoE FFN 未对齐,L2 对拍断在
t32_l0_x),本篇把差异从「四处」修正为六处 ,再用「按输出行切并行度、行内保留串行链 」的办法一次通过------2120 个 L2 key 全部逐字节等于纯 CPU 参考 ,而且并行度没有丢。 前置 :建议先读 第 18 篇(L2 harness 与注意力路径的位级收口)。 环境 :x86-64 + NVIDIA RTX 5090(CUDA 后端)· Qwen3-30B-A3B q4local · 位级档VLLM_CUDA_L2EXACT=1(opt-in)。
状态:✅ 达成(opt-in VLLM_CUDA_L2EXACT=1)。
一、问题与结论
- 整模型 L2 全等达成 :
DECODE+INFER+FORCE_CPU+L2EXACTvs 纯 CPU,2120 key(48 层逐层量 + 完整 logits)0 不一致 。此前是 2054 个,首个t32_l0_x。 - 残项评价被推翻 :「必须放弃并行度」不成立。六处差异全是浮点结合/归约序 ,与算法无关;用「行切并行、行内串行」即可,并行度实际不丢。
- 差异是六处不是四处 :此前登记的第四条漏了两个归约序 ------CPU 是升序串行链 ,CUDA 原核是树归约(gate/up 的 64 路、down 的 cbe 路)。补上后才一次通过。
- 反证「0 不一致」不是假象 :同档加
VLLM_CUDA_STUB_MOE=1(设备侧跳过 MoE、输出故意错)→ 2110 处不一致 ,首个仍是t32_l0_x⇒ 设备路径确实在跑。 - 代价 (按统一预算口径复测,见 4.4):位级档 9.90 tok/s vs fast 档 94.8 tok/s ⇒ 慢 9.6× ;且这 9.6× 的主项是非 MoE 部分 (
nsplit=1关掉 z 切分并行度),MoE 位级核只占 22.4 ms。与 attention 位级档同性质:验证工具,不是性能路径,故维持 opt-in。 - 默认档零改动 :三个原核一字未动,纯 CPU dump SHA256 不变(
A15A5FB9...)。
二、背景:先读清 CPU 真值轨
第 18 篇的对拍已经把首个差异钉在 t32_l0_x,但「哪几个内核、哪个表达式」还没定。定位的第一件事是确定 CPU 的真值轨 ------x86 上 MoE FFN 有多条轨(f32 精确轨 / int8 近似轨 / s16 整数点积轨),默认走哪条决定了要对齐谁。
日志给出了答案:
ini
[MOEILV512] avx512-path=off
[MOEDNILV] dn k-interleave=4
配合仓库规格里「s16 轨默认已开」的记载 ⇒ 真值是 s16 轨 :st_moe_ffn_sparse_q4 → moe_q4_gu_group_actq16_x86 / moe_q4_down_group_actq16_x86。
2.1 CPU 的精确表达式(逐字摘录)
仓库里 CPU 真值轨的两个函数(src/model/vllm_safetensors.c):
c
/* 文件名:src/model/vllm_safetensors.c,moe_q4_gu_group_actq16_x86() */
float gacc[4] = {0.0f, 0.0f, 0.0f, 0.0f}, uacc[4] = {0.0f, 0.0f, 0.0f, 0.0f};
for (int cb = 0; cb < nbG; cb++) {                       /* ← cb 升序串行链 */
    actq16_block_gu_x86(gb + cb*72, ub + cb*72, xq + cb*32, pgs, pus);  /* 块内 int32 精确点积 */
    for (int ri = 0; ri < 4; ri++) {
        float scg = vq_f16(hg[ri]), scu = vq_f16(hu[ri]), xdc = xd[cb];
        gacc[ri] += (scg * xdc) * (float)pgs[ri];        /* ← 结合序 (s_w*s_a)*dot */
        uacc[ri] += (scu * xdc) * (float)pus[ri];
    }
}
c
/* 文件名:src/model/vllm_safetensors.c,moe_q4_down_group_actq16_x86() */
float acc[4] = {0.0f, 0.0f, 0.0f, 0.0f};
for (int cbi = 0; cbi < cbe; cbi++) {                    /* ← cbi 升序串行链 */
    actq16_block_dn_x86(tile, avq + cbi*32, pas);
    for (int ri = 0; ri < 4; ri++)
        acc[ri] += (vq_f16(hd[ri]) * avd[cbi]) * (float)pas[ri];
}
for (int ri = 0; ri < 4; ri++) y[ri] += p * acc[ri];     /* ← p 只在末尾乘一次 */
silu 与 router:
c
av[i] = (g / (1.0f + expf(-g))) * u;                     /* 表达式与 CUDA 完全相同 */
for (int i = 0; i < d; i++) s += rw[i] * x_ffn[i];        /* router:2048 步串行链 */
2.2 差异表(六处)
| # | 量 | CPU 真值 | CUDA 原核 | 差异性质 |
|---|---|---|---|---|
| ① | router 点积 | d 步串行链 |
64 chunk + 64 路树归约 | 归约序 |
| ② | gate/up 结合序 | (s_w * s_a) * dot |
(dot * s_w) * s_a |
结合序 |
| ③ | gate/up 归约序 | cb 升序串行 += |
一线程一 cb + nbG 路树 | 归约序 |
| ④ | silu / top-k softmax 的 expf |
UCRT | device expf |
函数实现(表达式同) |
| ⑤ | down 的 p |
末尾 y += p * acc |
折叠进每个块项 | 结合序 |
| ⑥ | down 归约序 | cbi 升序串行 += |
cbe 路树 | 归约序 |
③⑥ 是本次新发现的(此前只登记了 ①②④⑤)。它们同属「树 vs 串行链」这一族 ------和 attention 那边 pairwise + nsplit=1 要解决的是同一类问题:并行归约会重排浮点加法,而重排就换位。
一处细节值得记:整数部分(
vc_q4_dot32_s16对 CPUactq16_block_*)本来就逐位一致 ------int32 点积精确且加法可结合,怎么分组都一样。所以只需要修浮点那一层,权重布局、激活量化、tile 结构都不用动。这正是「三维天然一致」的意思。
三、核心机制:行切并行、行内串行
关键设计只有一句话:把并行度切在「输出行」这个维度上,行内保留 CPU 的串行链 。因为不同输出行的归约彼此独立,谁先谁后都不影响结果;而同一行内必须严格照 CPU 的顺序累加。
| 内核 | 并行切分 | 行内串行步数 |
|---|---|---|
k_moe_router_gemm_serial |
一线程一专家(ne=128) | d = 2048 |
k_moe_gate_up_ucrt |
一线程一 (专家 j, 行 row)(tk×ef ≈ 6k) | nbG = 64 |
k_moe_down_ucrt |
一线程一输出行(d = 2048) | tk×cbe = 8×24 = 192 |
仓库里这三个位级核(src/npu/cuda/vllm_cuda_kernels.cu):
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu,k_moe_router_gemm_serial() */
/* ① router:一线程一专家,d 步串行链(与 CPU `s += rw[i]*x[i]` 同序)。 */
__global__ void k_moe_router_gemm_serial(const float *__restrict router,
                                         const float *__restrict x,
                                         float *__restrict logits,
                                         int ne, int d) {
    const int e = blockIdx.x * blockDim.x + threadIdx.x;
    if (e >= ne) return;
    const float *rw = router + (size_t)e * d;
    float s = 0.0f;
    for (int i = 0; i < d; i++) s += rw[i] * x[i];
    logits[e] = s;
}
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu,k_moe_gate_up_ucrt()(节选) */
/* ②③④ gate/up:一线程一 (专家 j, 行 row);行内 cb 升序串行链、
 * `(sw*sa)*dot` 结合序、silu 用 expf_ucrt。 */
const int j = idx / ef, row = idx - j * ef;
float ga = 0.0f, ua = 0.0f;
for (int cb = 0; cb < nbG; cb++) {
    const uint8_t *tg = gt + (size_t)cb * 72;
    const uint8_t *tu = ut + (size_t)cb * 72;
    const int16_t *ab = xq + (size_t)cb * 32;
    const float xdc = xd[cb];
    ga += (vc_q4_scale(tg, ri) * xdc) * (float)vc_q4_dot32_s16(tg, ri, ab);
    ua += (vc_q4_scale(tu, ri) * xdc) * (float)vc_q4_dot32_s16(tu, ri, ab);
}
av[(size_t)j * ef + row] = (ga / (1.0f + expf_ucrt(-ga))) * ua;   /* silu(g)*u */
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu,k_moe_down_ucrt()(节选) */
/* ⑤⑥ down:一线程一输出行;专家 j 升序,每专家行内 cbi 升序串行链,
 * `p` 只在末尾乘一次后累加进 y(与 CPU `y[ri] += p*acc[ri]` 同序)。 */
float yacc = 0.0f;
for (int j = 0; j < tk; j++) {
    const int e = sel[j];
    if (e < 0 || e >= ne) continue;
    const uint8_t *db = D + rgoff + (size_t)((e * ef) >> 5) * 72;
    const int16_t *aqj = avq + (size_t)j * ef;
    const float *adj = avd + (size_t)j * cbe;
    float acc = 0.0f;
    for (int cbi = 0; cbi < cbe; cbi++) {
        const uint8_t *tile = db + (size_t)cbi * 72;
        const int16_t *ab = aqj + (size_t)cbi * 32;
        acc += (vc_q4_scale(tile, ri) * adj[cbi]) * (float)vc_q4_dot32_s16(tile, ri, ab);
    }
    yacc += pr[j] * acc;
}
y[row] = yacc;
两个编译期前提(都已具备,不需要新增开关):
-fmad=false(nvcc 构建参数):否则s += a*b会被融成 FMA,与 CPU 的-ffp-contract=off就不一致了。expf_ucrt:第 18 篇为 attention 做的 UCRTexpf位级复刻,这里直接复用。
位级核在 vc_l2exact() 门内替换默认核(src/npu/cuda/vllm_cuda_kernels.cu):
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu,MoE 段(节选) */
if (vc_l2exact()) {
    /* 位级档①:router 串行链 + UCRT expf 的 top-k。 */
    k_moe_router_gemm_serial<<<(unsigned)((ne + 127) / 128), 128, 0, stream>>>(
        s->d_moe_router + r_loff, s->d_normed, s->d_moe_logits, ne, d);
    k_moe_router_topk_ucrt<<<1, 1, 0, stream>>>(
        s->d_moe_logits, s->d_moe_sel, s->d_moe_pr, ne, tk);
    ...
    k_moe_gate_up_ucrt<<<(unsigned)((ngu + 255) / 256), 256, 0, stream>>>(...);
    k_moe_down_ucrt<<<(unsigned)((d + 255) / 256), 256, 0, stream>>>(...);
} else {
    k_moe_router_gemm<<<...>>>(...);   /* 默认档:3 个原核一字未动 */
    k_moe_gate_up<<<...>>>(...);
    k_moe_down<<<...>>>(...);
}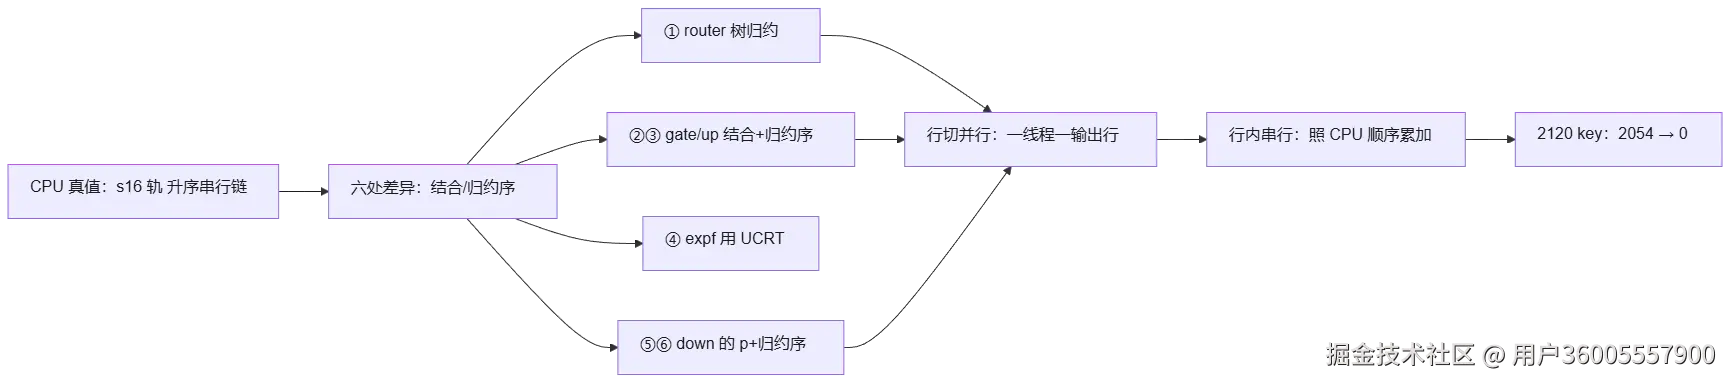
图 1 :MoE FFN 位级收口的因果链。上端是 CPU 真值轨(s16 轨、升序串行链 );六处差异经复核全部是浮点结合/归约序 (① router 的 64 路树归约、②③ gate/up 的结合序与归约序、④
expf实现、⑤⑥ down 的p折叠与归约序------其中 ③⑥ 为本次新发现),与算法无关。解法是「行切并行、行内串行 」:并行度切在输出行维(不同输出行的归约彼此独立),行内严格照 CPU 升序串行累加------因此并行度实际不丢 。结果是 2120 个 L2 key 的不一致数从 2054 降到 0 ;同档加VLLM_CUDA_STUB_MOE=1会打出 2110 处不一致,反证设备路径确实在跑。
四、实测数据
4.1 主判据
ini
$env:VLLM_L2_DUMP="$dir\ref.txt";  <纯 CPU>
$env:VLLM_L2_DUMP="$dir\gpu.txt"; VLLM_CUDA_DECODE=1 VLLM_CUDA_INFER=1 \
                                   VLLM_CUDA_FORCE_CPU=1 VLLM_CUDA_L2EXACT=1
<--cuda ... --stream-test --stream-n 4>| 迁移前 | 本步后 | |
|---|---|---|
| L2 不一致数(2120 key) | 2054 | 0 |
| 首个不一致 | t32_l0_x(MoE FFN 输出) |
--- |
| 纯 CPU 参考 dump | A15A5FB9... |
A15A5FB9...(不变) |
「0 不一致」的覆盖面是:48 层的逐层 hidden / KV 行 / 各阶段中间量 + 完整 logits ,全部逐 uint32 字节相同。
4.2 反证(关键一步)
0 不一致 有一个天然的替代解释:设备路径根本没跑、直接回退 CPU 了。这类「看起来完美」的结果必须反证,否则等于没测。
vc_decode_body 自带一个逃生探针:VLLM_CUDA_STUB_MOE=1 会跳过设备侧 MoE FFN (y <- res,输出故意错)。如果设备路径真的在跑,这个开关必然把对拍打花:
c
/* 文件名:src/npu/cuda/vllm_cuda_kernels.cu */
/* Timing probe (time-only, output intentionally wrong): VLLM_CUDA_STUB_MOE=1
 * skips the MoE FFN (router+gate/up+down) to isolate its share of decode. */
const char *e = getenv("VLLM_CUDA_STUB_MOE");
stub_moe = (e && e[0] && e[0] != '0');
ini
$env:VLLM_CUDA_STUB_MOE='1'   # 同一条命令 + 这个开关
→ L2 不一致 = 2110 个,首个 = t32_l0_x
⇒ 设备路径确实在跑,0 不一致 是真实结论。
4.3 回归
| 项 | 结果 |
|---|---|
| 纯 CPU dump SHA256 | A15A5FB9... 不变 |
| COPYTEST(KV 前缀复用) | diff=0.000e+00 PASS |
| DKVTEST(disk-KV 恢复) | rows_equal=PASS logits_equal=PASS |
--cuda-selftest |
6/6 PASS(int8/int4 × decode/prefill/非整除 N) |
| fast 档(非位级) | 2108 不一致(该档本就是 greedy 级,位级承诺只属 L2EXACT 档) |
4.4 代价(按统一预算口径正式实测)
本节最初给的是 --stream-n 4 的临时横比(fast 52 / 位级 139 ms/tok)。那组数字已作废 :n 太小、预算口径不同,而且当时据以判断「权重缓存不足额」的那条告警经复核是误报 (见下)。下面按仓库 wiki 2.6 的统一口径重测:--stream-test --stream-n 64,tok/s 取精确值 (权威指标),graph off / on 分开;预算 VLLM_CUDA_WCACHE_MB=26000 VLLM_GW_BUDGET_MB=16000 VLLM_GW_SLOTS=512(设备缓存实占 1845.8 MB / 26000 MB ,0 驱逐 ⇒ 足额)。
| 档 | graph off | graph on |
|---|---|---|
| CUDA fast(非位级) | 94.8 tok/s(10.55 ms/tok) | 119.9 tok/s(8.34 ms/tok) |
| CUDA L2EXACT(位级) | 9.90 tok/s(101.0 ms/tok) | 8.45 tok/s(118.4 ms/tok) |
- 位级档比 fast 档慢 9.6×(graph off 口径)。比早期临时轮的 2.7× 大得多:n 从 4 提到 64 后 fast 档的 launch/图摊销更充分,而位级档是纯计算受限。
- fast 档两档都命中仓库 wiki 2.6 的既有数字 (95.48 / 118.79),偏差 −0.7% / +0.9% ⇒ 口径可复现,这组数字与 wiki 同源可比。
这 9.6× 的主项不是 MoE。 用 VLLM_CUDA_STUB_MOE=1(设备侧跳过 MoE)隔离:
| 段 | fast | 位级 | 位级/fast |
|---|---|---|---|
| 全量 | 10.55 ms | 101.0 ms | 9.6× |
| 跳过 MoE | 6.95 ms(144.0 tok/s) | 78.6 ms(12.72 tok/s) | 11.3× |
| MoE 份额 | 3.6 ms(34%) | 22.4 ms(22%) | 6.2× |
位级档多出来的 ~90 ms 里,MoE 位级核只占 22.4 ms,其余 ~68 ms 全在非 MoE 部分 :vc_l2exact() 强制 nsplit=1,把 M=1 GEMV 的 z 切分并行度整个关掉(fast 档 Q/K/V/O 的 nsplit 最高 16 ,网格从 4--5 个 block 扩到 64--80 个),再叠加单线程串行 RMSNorm/QK-norm 与软件 UCRT 超越函数。换句话说:「位级档贵」主要贵在把并行归约序换成 CPU 的顺序链,而不是贵在 MoE 那 6 处对齐本身------这和本篇「行切并行、行内串行 ⇒ 并行度不丢」的结论并不矛盾,因为贵的是 GEMM/norm 那条线,不是 MoE。
一个反直觉结果 :CUDA Graph 在位级档是负收益 (9.90 → 8.45,0.85× ,RSS 亦增 ~16 MB)。位级档 101 ms/tok 已计算受限,launch 开销可忽略,图捕获反而摊上 ~870 节点的重放开销。第 15 篇「graph 是零数值风险的纯加速」只在 launch-bound 的 fast 档成立。
一条误报的澄清 :此前引用的 WARNING: only 241/433 weights stay resident 是误报 。want 用的是稠密公式 nl*9+1,而 MoE 每层只往 wcache 放 5 条(q/k/v/o + fused QKV),gate/up/down 与 fused GU 走独立专家缓冲(d_moe_*)不占 wcache 条目 ⇒ 期望值应为 nl*5+1 = 241。已在 src/main.c 修正为 cfg->is_moe ? 5 : 9,并把「预载调用数」(MoE 每层多 1 次专家缓冲预载 = 289)与「wcache 条目数」分开打印;修正后输出 preload: 289/289 weights warmed ... / 241 entries,告警消失。
c
/* 文件名:src/main.c(修正后) */
const int want_wc  = cfg->n_layers * (cfg->is_moe ? 5 : 9) + 1;
const int want_all = cfg->n_layers * (cfg->is_moe ? 6 : 9) + 1;
fprintf(stderr, "[CUDA] preload: %d/%d weights warmed in %.2fs; "
                "device cache %.1f MB / %d entries\n",
        warmed, want_all, st_now_sec() - tp, dbytes / 1048576.0, dent);
if (dent < want_wc)
    fprintf(stderr, "[CUDA] WARNING: only %d/%d weights stay resident -> ...\n", dent, want_wc);
它不是性能路径,是标尺 ------这正是它维持 opt-in 的原因(与第 18 篇 attention 位级档同一决策逻辑:仓库方法论的默认化门禁要求「位级等价 且 性能领先」,两者缺一即不默认化)。
五、边界与已知限制
- 位级档是验证工具,不是性能路径 :9.90 vs 94.8 tok/s(慢 9.6×),维持 opt-in(
VLLM_CUDA_L2EXACT=1)。 - 位级承诺只属 L2EXACT 档:默认 fast 档仍是 greedy 级(2108 不一致是预期内的)。
- CUDA Graph 在位级档负收益(0.85×),与实际负载相关,未在其它形状上复查。
- 覆盖率 :本轮只覆盖 M=1 decode;prefill/batch 路径的位级未做。整模型 L2 全等是「单段 prompt、
--stream-n 4」口径。 - 口径绑定本机:48 层 Qwen3-30B-A3B q4local + RTX 5090;换模型/换卡需重测。
CPU 对照(迁移前基线)
- CPU 参考 :
kestrel-llm/src/model/vllm_safetensors.c:moe_q4_gu_group_actq16_x86 / moe_q4_down_group_actq16_x86------ MoE gate+up / down 的 CPU 参考;超越函数口径为 UCRTexpf。 - 迁移要点 :「行切并行、行内串行」------并行度切在输出行维,行内保留 CPU 升序串行链;六处差异(router 串行链 / gate-up 结合序+归约序 / down 的 p + 归约序 /
expf_ucrt)全部对齐。 - 真机验证 :未独立复现:需 30B +
VLLM_CUDA_L2EXACT的 2120 key(2054→0)与STUB_MOE反证(2110 处不一致)。
六、小结
- 跨硬件位级一致在整模型尺度上被证明了 。此前导读里那句「一致性面是 PPL/greedy 级,不是位级」需要加一条更强的例外:在 L2EXACT 档下,x86 与 NVIDIA 两条完全不同的指令集/编译器/并行度,能对同一段 prompt 产出逐字节相同的每层 hidden 与完整 logits。 这不是「差不多」,是
memcmp == 0。 - 残项登记要留可复核的规格 。第 18 篇留下的「四处差异」这次被修正为六处,正是因为当时记的是结论 而不是表达式。本篇把 CPU 真值逐字摘录进档(仓库 wiki 3.2),下次任何人(或任何一天的我)都能直接复核。
- 「树 vs 串行链」是这一系列反复出现的同一类坑 :attention 的
pairwise + nsplit=1、router 的 64 路树、gate/up 的 64 路树、down 的 cbe 路树。凡是并行归约,都要问一句「CPU 是什么顺序」。 - 「0 不一致」必须配一个反证 。这次用
STUB_MOE造出 2110 处不一致,把「设备路径没跑」这个替代解释排除掉。完美结果比失败结果更需要怀疑。
至此本系列这条位级线的账目是:attention ✅、全 GPU decode 的注意力路径 ✅、MoE FFN ✅ 、整模型逐层 L2 全等 ✅ (均 opt-in)。仍然位级未对齐的只有 L3/稀疏档与分页(后者已判不作,见 第 21 篇)。
相关篇目:第 15 篇、第 18 篇、第 21 篇 源码与配套资源:本仓库 gitee.com/pei-xiaogua...; CPU 推理源码 gitee.com/pei-xiaogua...