仓储后台的一屏里,常常挤着表单、表格、看板,以及上百个条件显示区块。输入值变了,依赖它的表达式就要重算。但输入变化,不代表界面结果也变了:JSON 配置里的 ${a > 0} 控制区块显隐,a 从 1 变到 100,结果一直是 true。如果每次都通知 React,这个区块就得反复渲染同一个结果。
我们参与共建的搭建引擎,用 JSON 配置组装页面,接入了 4 个组件库、150 种组件,承接仓储系统 50 多个生产页面。这次优化针对的,就是配置驱动下的无效重渲染。
我们用 1000 个挂着 ${a > 0} 的节点做合成压测:输入持续变化,条件一直为 true。同机对照,整树一遍渲染的耗时从 19.25ms 降到 3.07ms,速度约为原来的 6 倍。测量使用 react-test-renderer,不含 DOM、布局和绘制。
思路并不新:比较两次派生结果,没变就不通知 React。难的是把判断放在哪里。我们先后在通知队列、同步通知和组件渲染时尝试拦截,遇到的却不只是性能问题:比较放错地方,还会丢更新,甚至破坏 Hooks 序列。
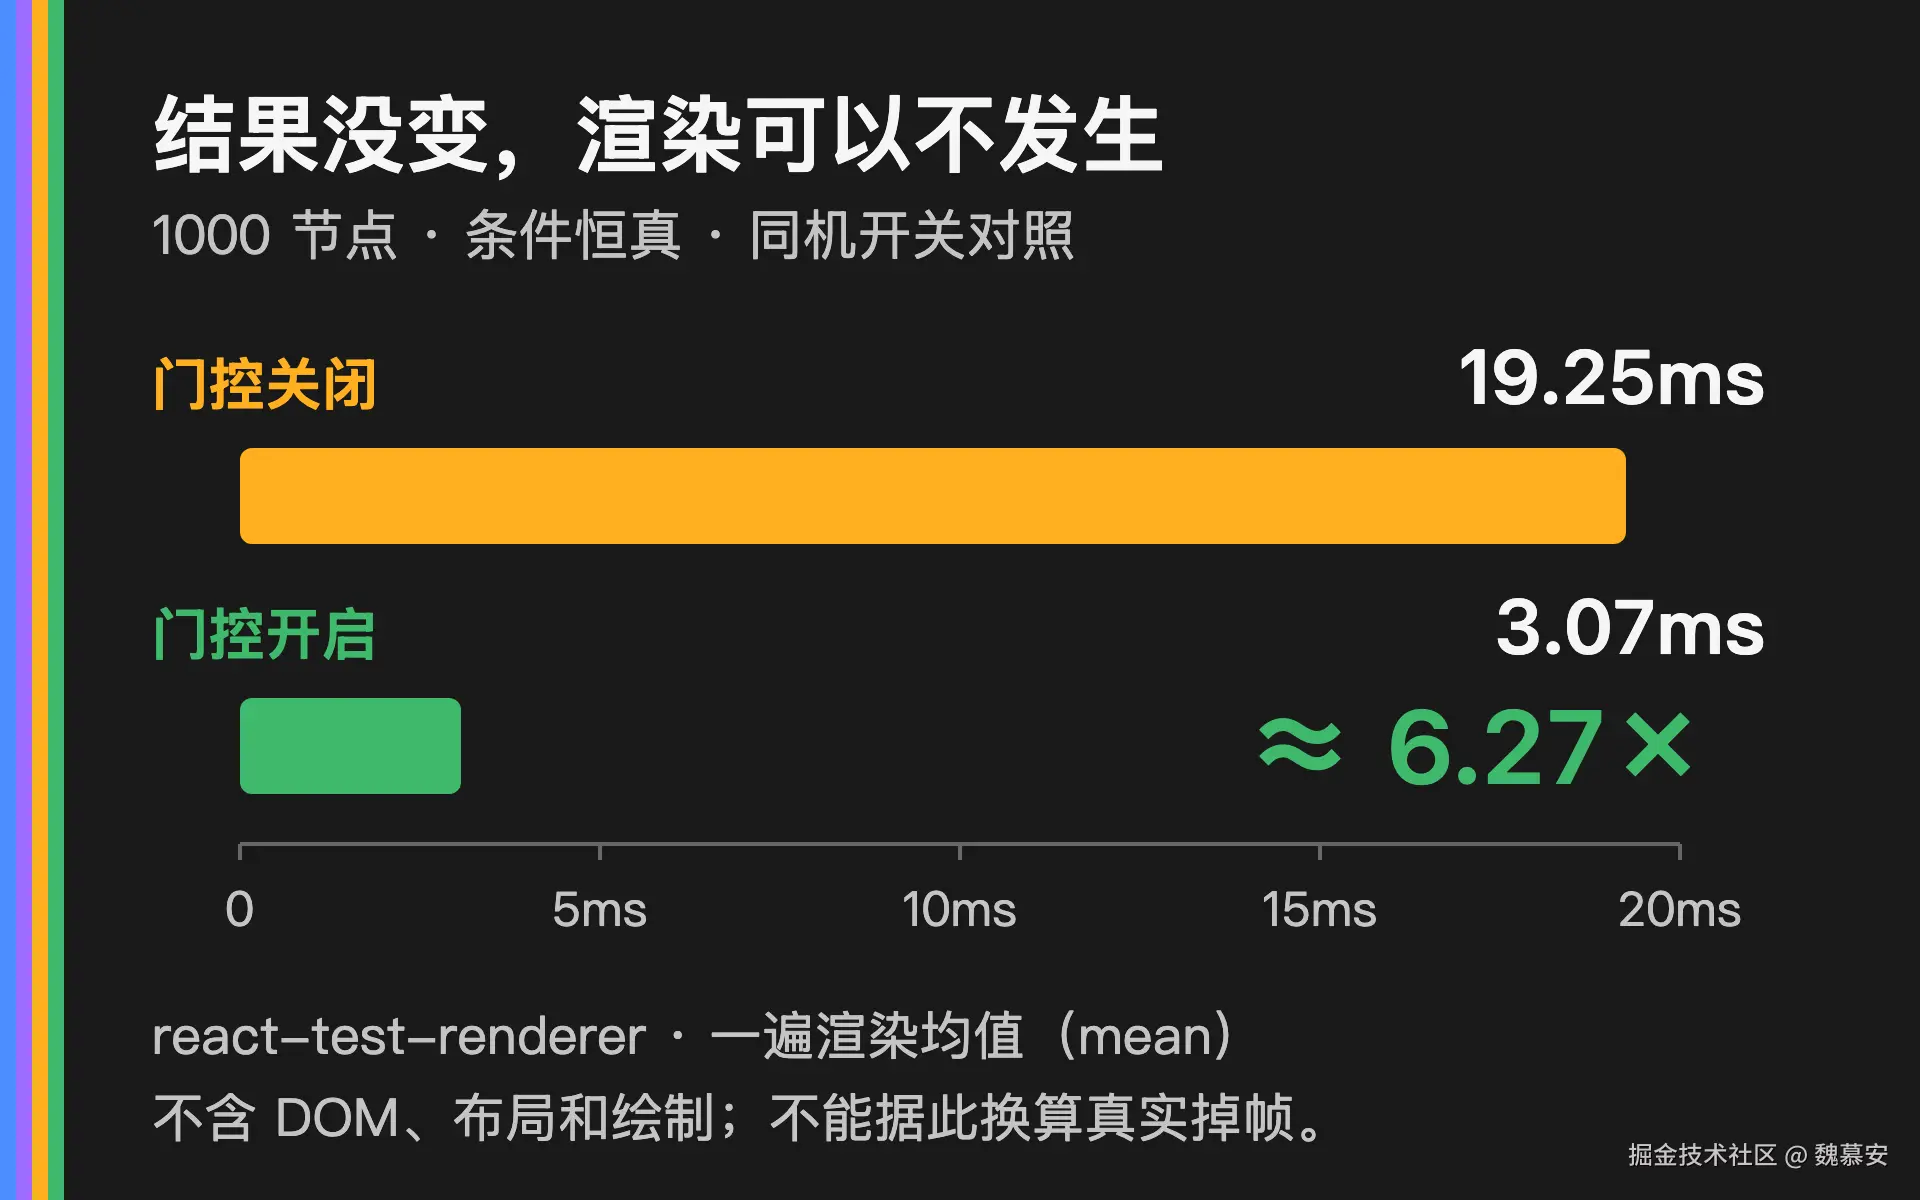
要拦的是无效重渲染
我们把这类场景称为输入频变,结果不动(churn-but-stable)。输入变化后,仍需重新求值;如果结果相同,再执行组件、让 React 做一轮协调(reconcile),就是多余的工作。
React.memo 能跳过 props 未变的组件,但拦截发生在 props 求值之后。即使自定义比较函数判出相等,前面的表达式计算也已经做完。我们要把判断前移:在引擎里比较派生结果,结果没变,就不通知 React。
这里的「没变」有明确定义:Object.is 判定新旧结果相等。我们保留表达式重算和比较,只跳过结果未变时的后续渲染。
这也区别于节流和防抖。录入回显需要及时响应,我们保留输入更新的频率,拦下每次更新中结果未变的那部分渲染。
三次,门都装错了地方
第一次:延迟到队列里比较
第一版把比较推迟到通知队列里。等派生结果可以安全读取,再判断是否需要渲染:既能等到数据稳定,又能拦下无效更新。
问题出在真变更上。一个值真变、1000 个节点都该重渲的广播场景,一遍耗时从 12ms 涨到 105.8ms(同机 A/B,min 读数),耗时增加约 7.8 倍。每条通知都要经过排队、唤醒、重算和比较;结果真变时,这些步骤一个没少,渲染也仍然要做:
markdown
没装门:  通知 → 重渲
排队版:  通知 → 进队列 → 等 microtask
                → 唤醒、重算、比较
                → 没变则拦截,变了仍需重渲
这笔成本我们认得:信号到渲染之间每多绕一站,1000 个节点就多付一千次,正是我们早先从通知链上亲手拆掉的两跳成本。排队等于把它请了回来。
第二次:通知到达时同步重算
第二次去掉队列:通知一到,当场重建节点 props,再和上次比较。这样能省掉调度与唤醒,但也把求值提前到了写入过程中。
业务上是一次写入,引擎里是逐个写、逐个通知:
ts
// 失败版本的时序示意:一次业务写入 { a: 5, b: -1 }
set("a", 5);   // 此刻通知:a 已更新,b 仍是旧值
set("b", -1);  // 两个键现在才都写完
多键写入会暴露中间态;单键也复现了问题:信号已经变化,读取 props 所用的数据视图却还没稳定反映新值。比较器读到旧结果,判成「没变」,把真更新拦掉,节点根本没再渲染。重建 props 还会写入缓存,把错误结果带到后续渲染里。
第一次好歹只是慢,这次直接是错。
第三次:渲染期跳过叶子
第三次躲开数据层,在渲染期动手:先算出节点这次的 props,如果与上次相同,就跳过叶子组件的执行。数据层的两条路都走不通,渲染期看上去是最后一站。
React 报错:Rendered fewer hooks than expected。叶子在宿主组件中内联调用,它的 hooks 也记在宿主身上;跳过叶子,就改变了这一轮的 hooks 序列,违反 Rules of Hooks。
要让 React 安全地跳过叶子,得给它独立的 fiber。而我们此前刚移除一层包装 fiber,换来挂载提速 14~20%(同机 A/B,min)。把包装加回去,可能回吐这项收益。在保留叶子内联调用的前提下,渲染期整体跳过走不通。
门该装在哪
我们沿这条更新链检查了三个阶段:
- 写入时,派生结果还没算出来。比较源值可以去重,却无法判断
${a > 0}是否变化;这条路在动手前就排除了。 - 通知到达时,可以阻止 React 调度,但不能重新拼整节点 props。比较需要一个常驻的派生单元,能安全刷新并保存结果。
- 渲染期,组件执行已经开始;在叶子内联架构下,还受 Hooks 序列约束。
因此,拦截时机要同时满足两条约束:判断所需的结果已经可安全读取,想省掉的渲染尚未开始。还要算比较本身的成本:延迟方案虽然等到了稳定数据,却让真变路径付出了更大的代价。
落点:把门装在 slot 上
要在 React 调度前拿到可比较的结果,就需要改变比较对象。节点 props 在每次渲染时重新拼装,拿它做比较,就得重走构建过程。我们改为给每个表达式字段建立一个常驻的派生单元。
这个单元叫 slot :schema 里每个写着 ${} 的字符串字段,对应一个 slot。每个 slot 绑定一个常驻的 memo,保存求值结果;只有结果变化,版本号才递增。门控由此下沉到每个表达式字段。
前三次尝试都以整个节点为拦截对象。改到 slot 后,前面的三个问题才有了对应的解法:
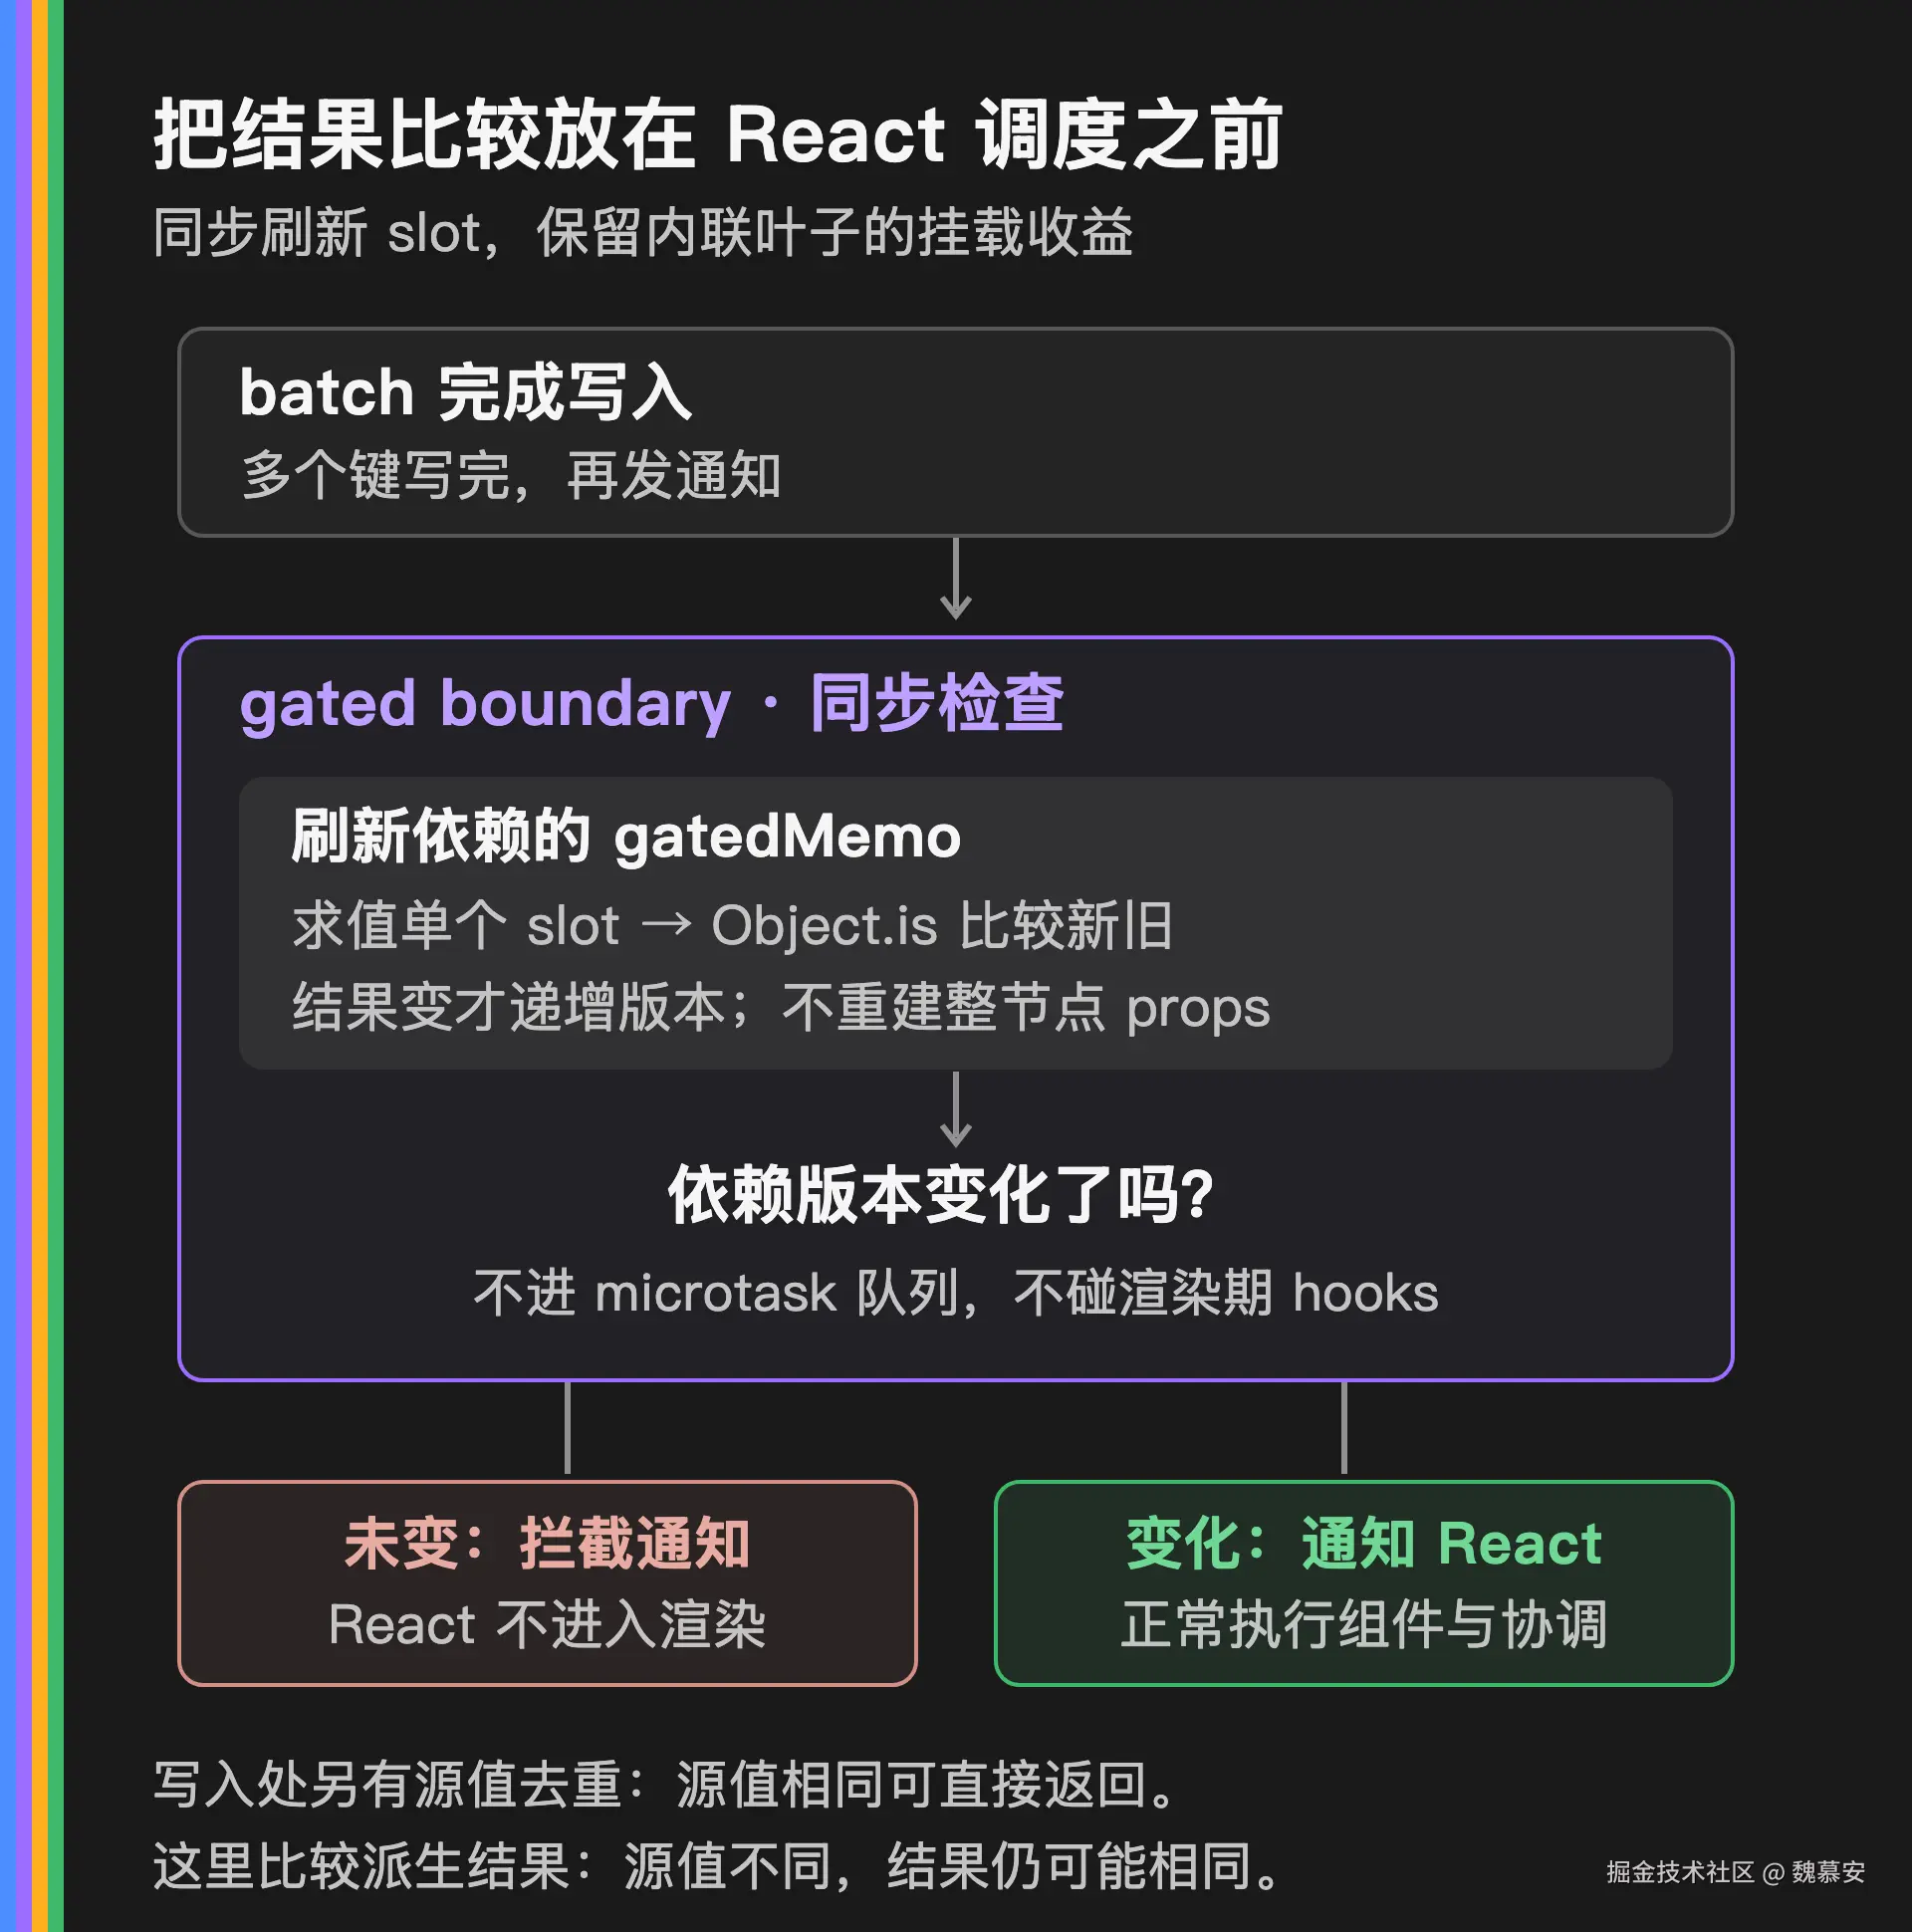
- 省掉调度绕行:在通知的同步路径里刷新 slot、比较版本,不进 microtask 队列。表达式仍要重算,省掉的是排队与后续无效渲染。
- 避开旧数据视图:多键写入用
batch合并,写完再通知;刷新只求单个 slot,不重建整节点 props,也不写那份 props 缓存。 - 保留内联叶子:版本未变,就在 React 调度前拦下通知。组件执行尚未开始,无需跳过 hooks,也无需把包装 fiber 加回去。
我们把这套做法称为值门控派生(VGD)。SolidJS、Vue 3、Preact Signals 都有相关的响应式派生机制;这里要解决的是,如何把结果比较接进这套 React 搭建引擎。实现分成两个部分:
gatedMemo(compute, equals) 负责求值与比较:compute 计算结果,equals 比较新旧值。结果相同就保留版本号,下游据此判断是否需要更新:
ts
// ${a > 0} 这样的 slot,各绑一个 gatedMemo
const visible = gatedMemo(
  () => evalSlot(),                       // 重算这个 slot 的结果
  (prev, next) => Object.is(prev, next),  // 新旧相等就不算变
);
// a 从 1 敲到 100:结果恒为 true → 版本号不动 → 下游收不到通知
gated boundary 是 React 调度前的拦截边界:通知到了,先同步刷新依赖的 slot,再比较版本号。依赖版本都未变,就不向 React 发通知。
6 倍只在这个场景成立
结果稳定时,门控省下组件执行和协调,保留 slot 求值与比较。下面既有门控开关对照,也有开启门控后两种整表更新形态的读数:
| 场景 | 读数 | 统计量 | 说明 |
|---|---|---|---|
条件显隐路:${a > 0} 恒真,1000 个节点 |
19.25ms → 3.07ms(6.27 倍) | mean | 标题的 6 倍;门控关 / 开的对照 |
整表推送 1000 行:${item.qty > 0}、结果不动 |
26.9ms / 一次推送 | min | 门控开启;不是开关对照 |
整表推送 1000 行:${item.qty}、每行都变 |
39.1ms / 一次推送 | min | 门控开启;所有行都需要重渲 |
条件显隐路:${show} 值变、显隐不变,1000 个节点 |
19.83ms → 16.78ms(省 15%) | mean | 门控关 / 开的对照;叶子组件仍重渲一次 |
测量环境:Apple M2、Node 20、生产配置的响应式内核,使用 react-test-renderer 测整树更新,不含 DOM、布局和绘制。mean 行预热 3 次、采样 15 次取均值;min 行取多次单次推送的最小值。
整表推送测的是不同表达式下的更新成本,缺少同场景关闭门控的基线,因此不能用这两行的差值计算门控净收益。
${a > 0} 对照使用条件显隐通道的诊断开关 visGate,生产默认关闭;props 与顶层字段槽的门控默认开启。标题的 6 倍说明这个合成场景的优化空间,真实页面的收益还需要浏览器测量。
这个收益有上限:每次推送至少仍要重算 1000 个条件,求值成本会随节点数增长。要限制屏幕外节点的工作量,还需要虚拟化。
正确性取决于「相等」怎么定义。Object.is 判的是值和引用,界面关心的是显示语义,两者可能错位。显隐真正翻转时,门本来就该放行,卸载重挂属于变化本身的成本。
边界有两种:
- 值变、显隐不变 :
${show}从 1 到 2 到 3,转成布尔值都为真;这里同时存在原始字段求值和布尔派生两条依赖。布尔结果没变,原始 slot 的 1→2 却仍判变,足以触发重渲。仅比较布尔结果,还不足以阻止这类更新。${show}场景实测耗时降低 15%,但这部分收益的来源尚未拆分,不能归因于无效重渲染被拦截。 - 引用变、内容相同 :
Object.is判变,保守不拦。我们选择不做深比较:它可能比省下的渲染更贵,还要处理循环引用、函数和日期等对象的比较语义。这项取舍未做独立性能测量。
slot 默认使用 Object.is,也允许自定义 equals。比较器决定了错误会落在哪一侧:判成不等,只是多渲染一次(漏拦 );实际已变却判成相等,更新就会丢失,界面停在旧值(错拦)。
采用 Object.is 时,避免错拦还依赖两个前提:对象结果按不可变契约重建,内容变则引用变;比较发生在一批写入落定之后。
同期,我们也尝试用 JIT 降低这部分求值开销。
JIT 没快起来
这里的 JIT 不生成机器码,而是在节点首次渲染时编译求值计划:给 slot 分类,区分路径、模板和公式;生成字段表,确定 schema 顶层哪些 key 参与求值。
求值计划缓存的是字段分类和遍历决策,gatedMemo 保存的是派生结果。数据变化后,表达式仍需重新求值。
我们原先预期编译能进一步提速。但字段表路径相对纯解释路径,三个场景的同机对照差距都在 ±4% 以内(mean),没有测出超出基线噪声范围的提速。它省掉了分类和遍历,主要的表达式求值仍然要做。
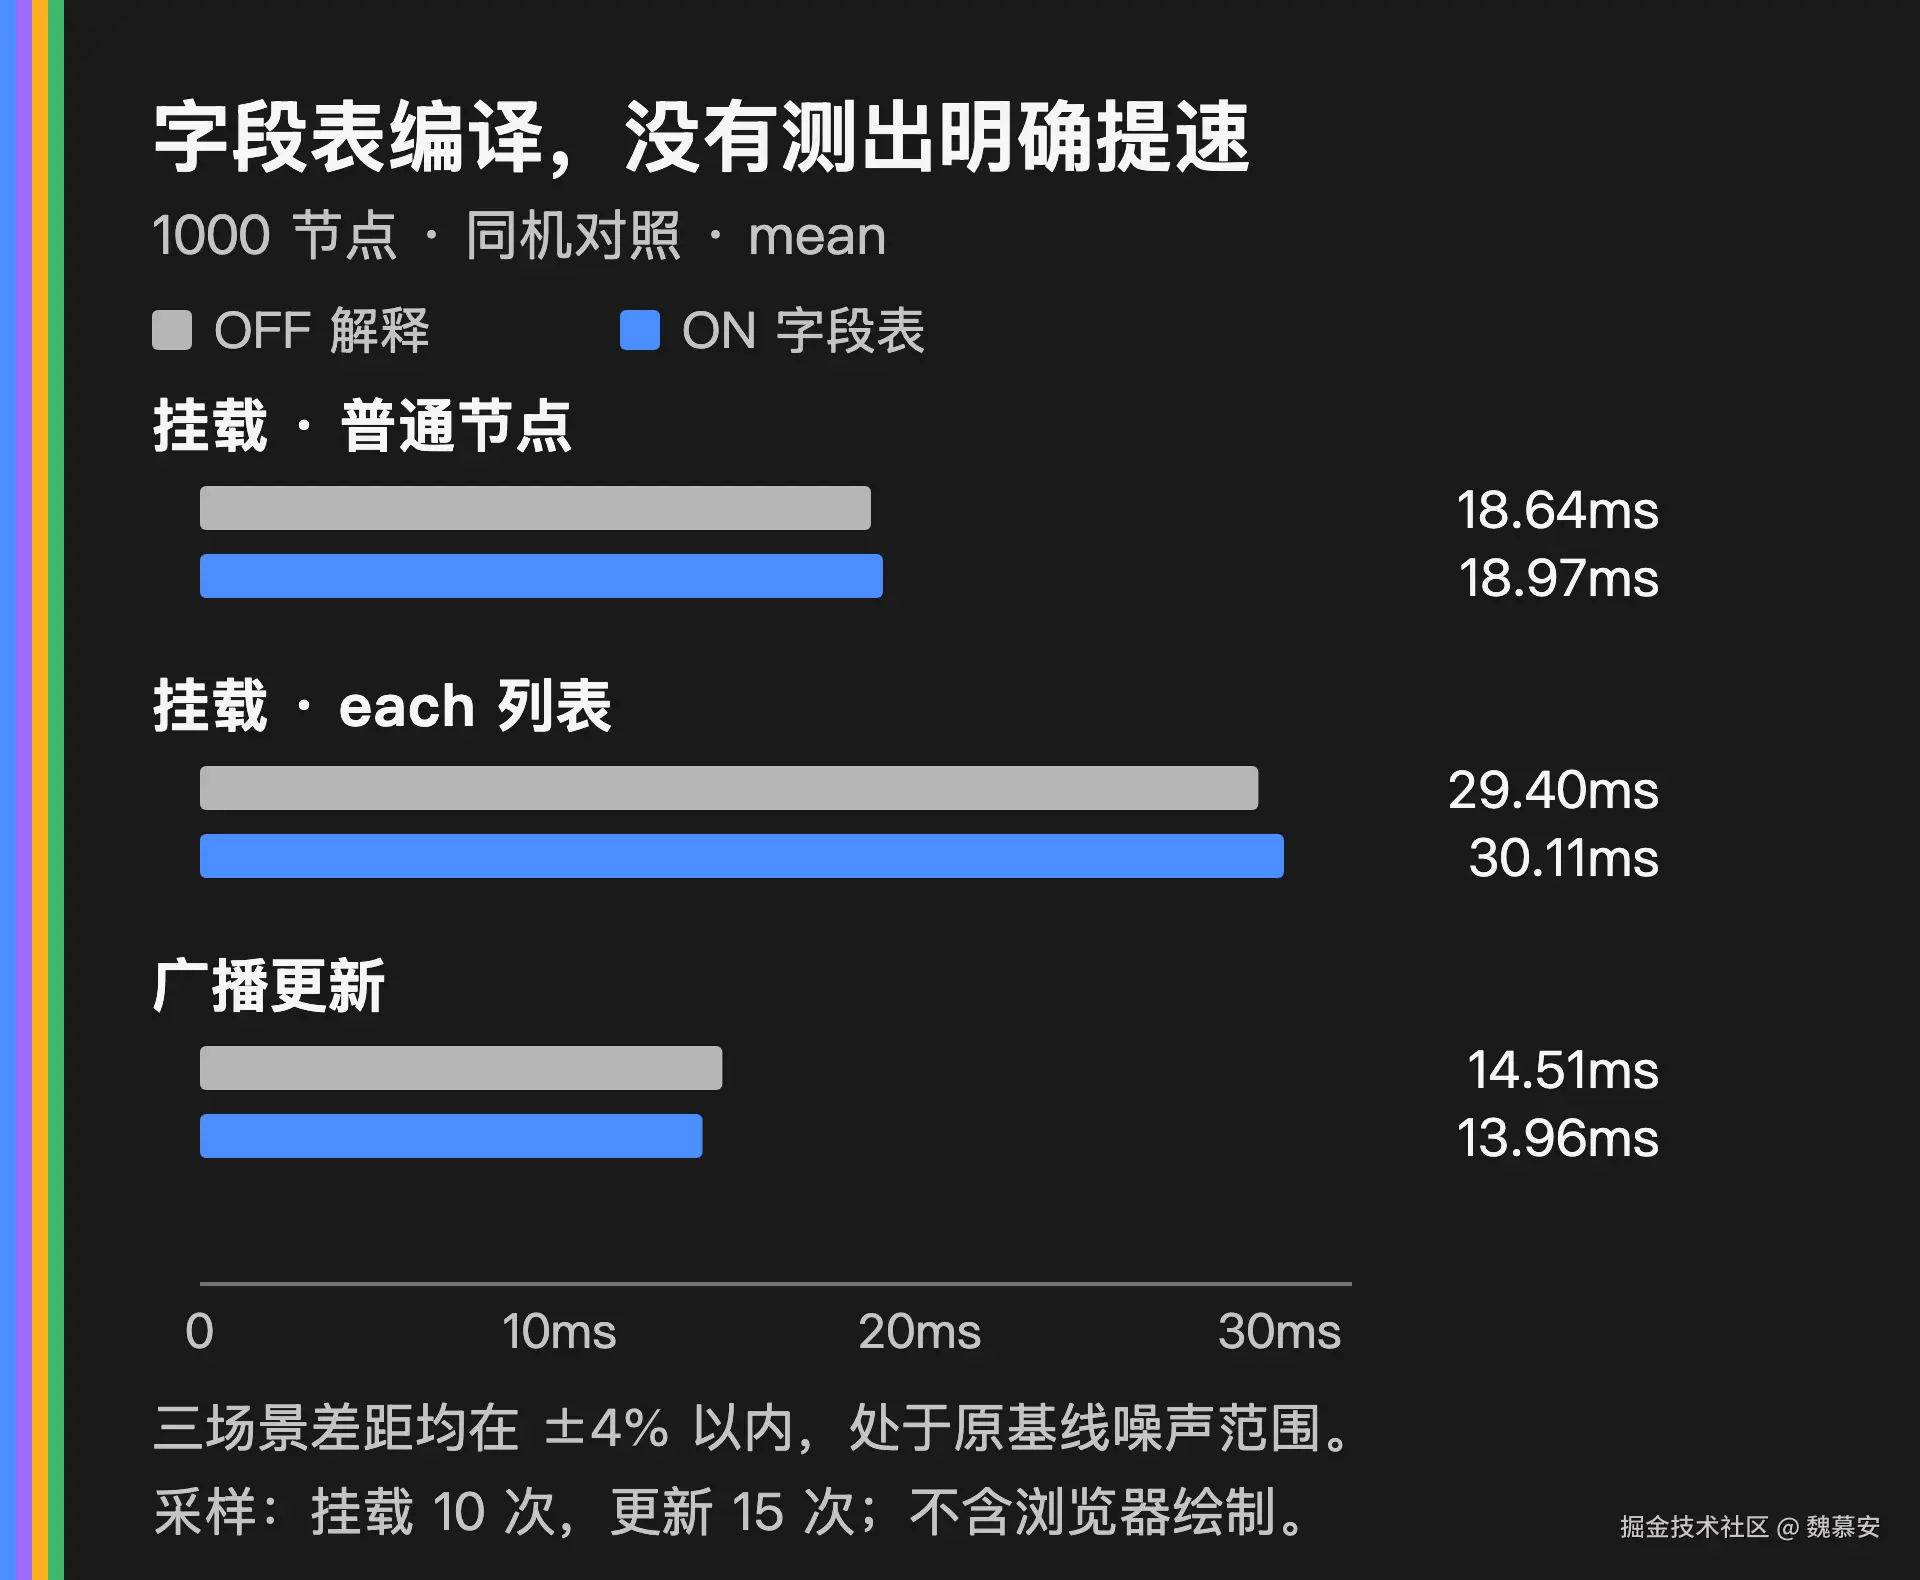
我们仍保留求值计划,生产默认开启。在当前实现中,slot 分类和字段表为门控提供了接入位置,也让解释路径与编译路径可以切换对照。但它们没有消除主要的求值成本,这部分开销仍留在每次更新里。
另一组 ns 级微基准测的是纯路径和模板类 slot 的预绑定。把 key 与 signal 提前绑定到求值路径,运行时省去查找,单次求值省约 880--1300ns(95--97%)。这项局部收益不能换算成整页提速。
为什么我们保留内核的修改权
这轮优化能继续试下去,有一个前提:团队能修改通知、求值和 React 接入的实现。对我们来说,这比「自研」这个标签更重要。这个取舍来自两次选型。
第一次基于开源低代码平台 lowcoder 搭内部产品。上手很快,但当时的数据域能力不满足我们的需求。补齐它要深入调整既有实现,超出了我们愿意在这条路线投入的范围,最终放弃。
第二次评估 amis。我们认可它用 JSON 描述页面结构、数据和交互的方式。我们对其 mobx / mobx-state-tree 数据模型保持谨慎:此前两代产品使用 observable 系状态管理,已经遇到过大数据树带来的性能问题。
这类模型提供了方便的依赖追踪,也需要维护可观测节点和状态树。节点多时,初始化和内存成本值得单独评估。在 MST #1683 提交者的大规模节点复现中,40MB 数据占用了约 16GB 内存。这个个案也是我们评估大树开销时的参考。
评估 amis 时,我们也查了官方 issue。2021 年创建的 #3205 描述了大量字段下的表格、表单输入卡顿。维护者回复:「主要是目前实现会重绘整个表格,改起来得花时间了」,并建议用分页规避。
amis 也持续改进性能,例如 3.4.1 的更新记录包含表单渲染优化。外部 issue 提醒我们检查整表重绘和大树开销,选型仍要回到自己的场景和修改成本。
我们最终把协议与运行时分开评估:沿用熟悉的配置方式,同时保留通知链、求值和渲染接入的修改权。团队选择自研内核,也就接下了正确性、维护和回归验证的责任。
schema 写法与表达式语法以对齐 amis 为目标,运行时独立实现。响应式内核本体约 900 行,不含组件库与接入层。
结语
把比较下沉到 slot 后,三个问题才同时得到解决:真变更不必再排队,比较不再重建未稳定的 props,叶子的 Hooks 序列也得以保留。一次性能退化、一次丢更新和一次报错,逐步限定了这个设计。
6 倍属于特定合成场景;能带到其他性能问题里的,是这条判断顺序:先确认什么结果值得比较,再确认哪里能安全比较,最后验证比较成本是否小于省下的工作。